Programa
Associate AI Engineer para desarrolladores
26 h
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) es el modelo de voz a texto de SpaceXAI. La ruta REST transcribe un archivo finalizado, mientras que la ruta WebSocket gestiona audio en directo.
El anuncio de Grok Voice Transcribe 2.0 de SpaceXAI destaca las llamadas telefónicas, múltiples hablantes, credenciales e idioma múltiple. Para comparativas de benchmarks, consulta nuestro resumen de Grok Voice Transcribe 2.0.
El escenario controlado de Qivora Sync permanece fijo mientras cambian el audio y los ajustes de la API. La llamada incluye un nombre de producto inventado, muletillas, un cambio de idioma, datos de contacto dictados, una pausa durante el dictado y un tercer hablante.
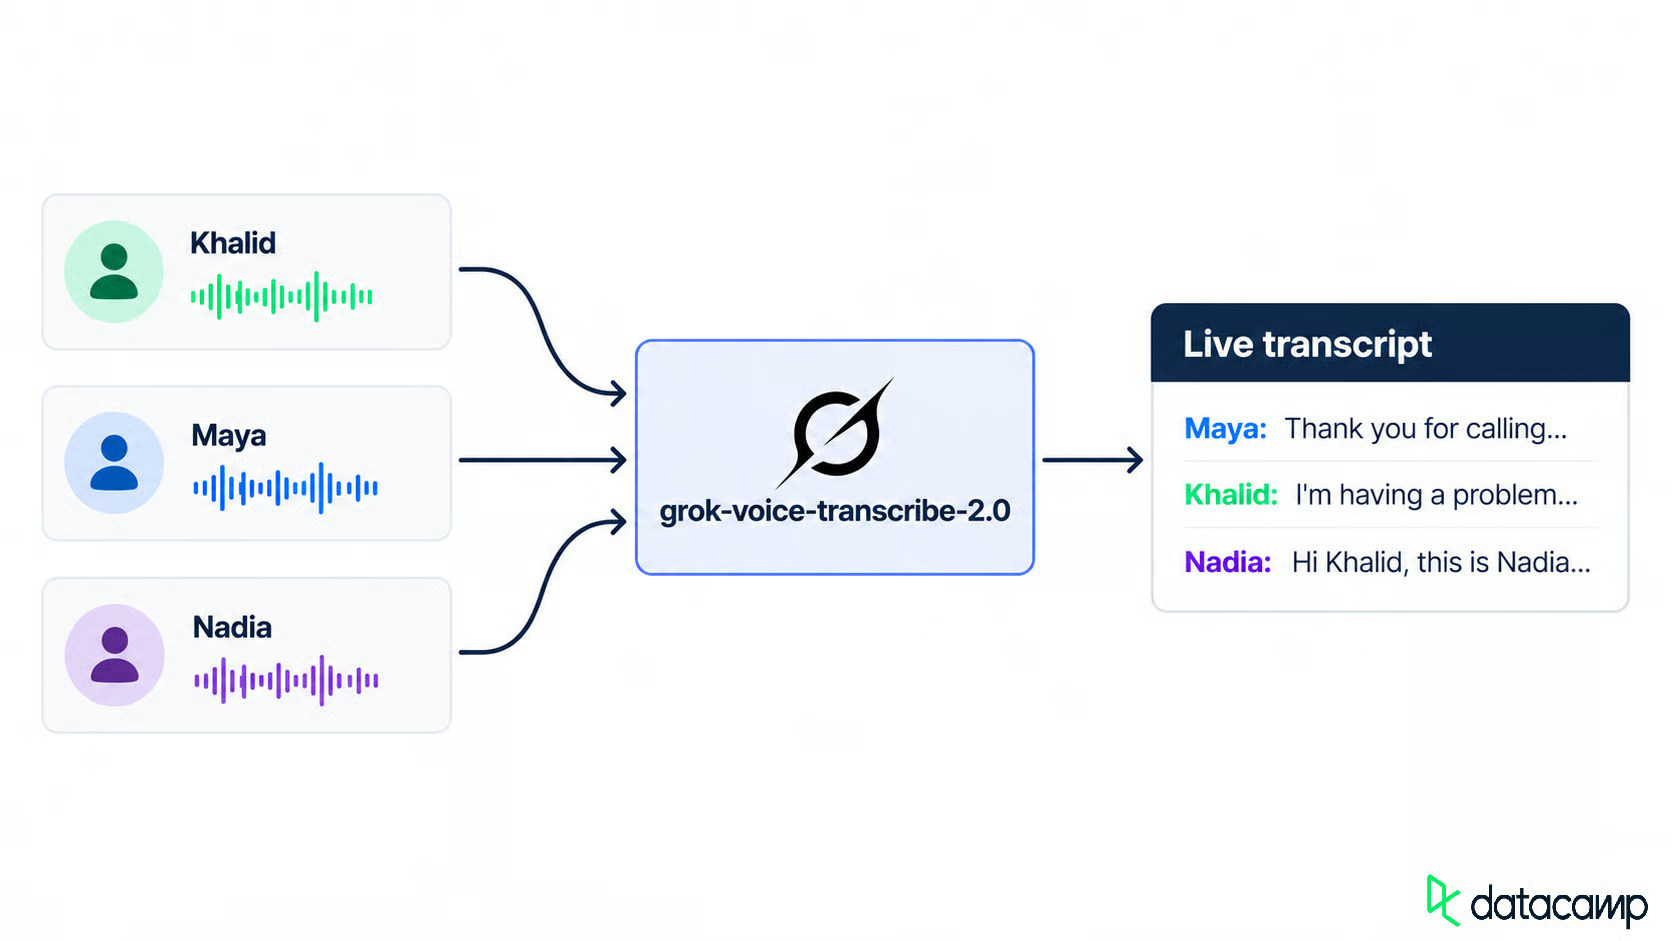
Tres voces se convierten en una transcripción en vivo. Imagen del autor.
El escenario controlado usa tres voces distintas de la API Grok Text to Speech. Cada segmento de idioma se sintetiza por separado y se une con ffmpeg para que los puntos de cambio permanezcan fijos. La API también acepta language=auto; separar las solicitudes es una elección de diseño experimental, no un requisito de la API.
Antes de la primera petición, define el texto esperado, los hablantes, la ortografía del producto, los datos del cliente, las muletillas y las pausas. Así cada configuración tiene el mismo objetivo.
Instala las dependencias antes de enviar audio.
Necesitas Python 3.10 o superior, una clave de API de xAI y ffmpeg para construir el audio. Los clientes de Python usan requests, websockets y python-dotenv.
La documentación de Speech to Text indica que la versión 2.0 es la predeterminada si omites model, y que grok-voice-transcribe-1.0 llegó a su fin de vida el 2 de octubre de 2026. Aun así, yo fijaría el ID de versión.
Clona el repositorio, añade tu clave a .env y construye el audio de ejemplo:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # luego pega tu clave en .env
python project/scripts/make_fixtures.py
El comando de configuración crea el diálogo y los archivos de audio que se usarán más tarde. Si tienes tu propia grabación, omite ese comando.
Un .env escrito en Windows puede dejar un \r en la clave, y requests rechaza la cabecera antes de que llegue nada a SpaceXAI. Elimina ese carácter de la clave antes de añadirla a la cabecera de autorización.
La base de referencia es el modelo sin opciones activadas, para poder comparar cada cambio posterior. La primera petición envía el archivo y un modelo fijado:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
La respuesta incluye text, language detectado, duration y un array de words con tiempos. La referencia REST muestra confidence por palabra, pero no apareció en las respuestas por lotes de este escenario. Trata ese campo como opcional y comprueba cada respuesta de la API antes de usarlo. Pon los campos opcionales antes de file; los posteriores pueden ignorarse.
La base eliminó muletillas, mantuvo el árabe en escritura árabe y dejó los dígitos hablados separados. De forma consistente, escribió mal el nombre inventado del producto.
Una transcripción de soporte necesita etiquetas de hablante, la ortografía correcta del producto y datos de cliente utilizables. Cada ajuste es un campo más del formulario:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # id de hablante en cada palabra
    ("keyterm", "Qivora Sync"),  # repite el campo para más términos
    ("language", "en"),          # requerido por format
    ("format", "true"),          # normalización inversa de texto
    ("filler_words", "false"),   # valor por defecto; true mantiene "uh" y "um"
]
Añade una opción cada vez sobre el mismo audio. Empieza por las etiquetas de hablante.
La diarización de hablantes asigna IDs numéricos a las palabras, no nombres. Agrupa palabras consecutivas con el mismo ID para formar turnos:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Con audio limpio, cada turno previsto mantuvo un ID de hablante coherente. Mapear nombres según el orden de primera aparición solo funciona cuando ya conoces el orden de la llamada; los sistemas en producción necesitan su propio mapeo de hablantes.
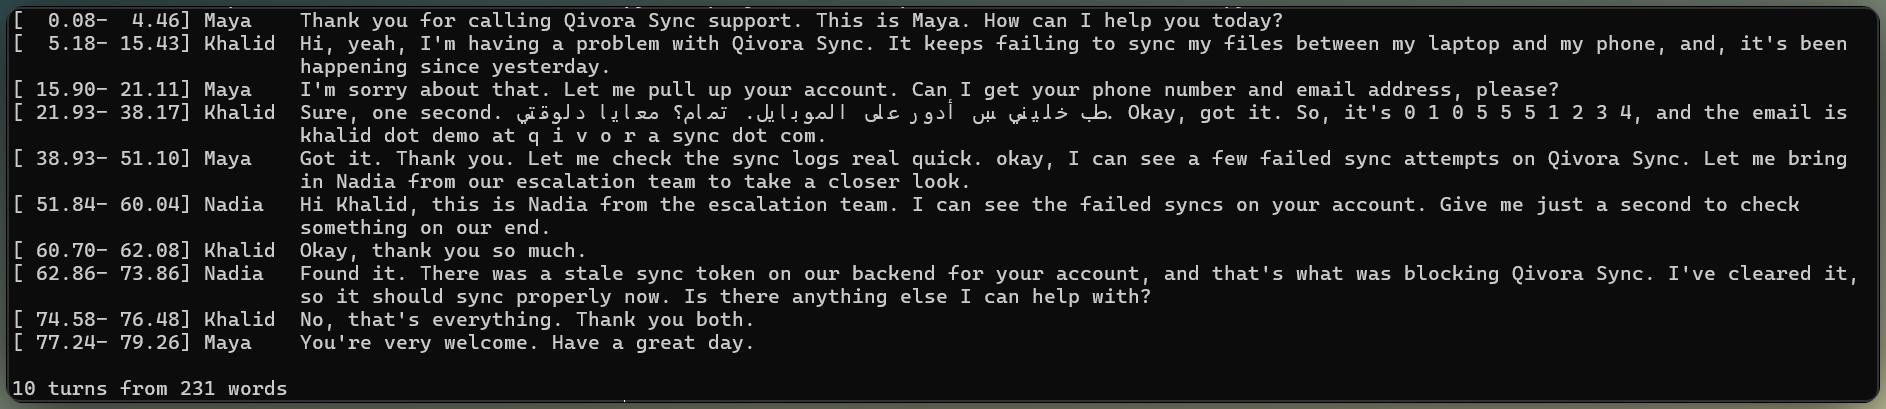
El audio limpio mantiene etiquetas de hablante consistentes. Imagen del autor.
El sesgo por término clave es una pista por petición, no entrenamiento. Pasa keyterm=Qivora Sync (hasta 100 términos, 50 caracteres cada uno), y el modelo tenderá hacia esa ortografía cuando el audio la respalde.
El término clave corrigió el error del nombre del producto en la base, sin cambiar la transcripción circundante.
En una comprobación aparte con hablante en vivo, un vocabulario muy sesgado arrastró un eco tenue hacia el término clave. Eso no significa que los términos clave inventen texto por sí mismos; significa que el audio ambiguo sigue necesitando una comprobación de eco.
Como mostró la base, el árabe de Khalid se mantuvo en escritura árabe. El resultado fue el mismo con detección automática y con language=en, porque language selecciona reglas de formato en lugar de forzar un idioma de salida.
La base mantuvo los dígitos hablados por separado. La normalización inversa de texto (ITN) convierte esas formas habladas en escritas. format=true lo activa y requiere language, o la petición falla con un 400.
El número de teléfono pasó a ser una cadena continua de dígitos. El email solo se normalizó parcialmente: la puntuación mejoró, pero el "arroba" hablado y el dominio deletreado aún necesitaban limpieza.
Ese resultado irregular es frustrante. ITN da formato al texto; no valida datos de contacto. Yo validaría ambos campos antes de almacenarlos.
ITN también puede reescribir duraciones comunes como cantidades abreviadas. En la respuesta formateada por lotes de este escenario, solo se normalizó el text de nivel superior; el array words mantuvo la forma hablada.
Como mostró la base, por defecto se eliminan las muletillas de text y words. filler_words=true trajo de vuelta los "eh" y "um" de Khalid donde correspondía. Déjalas desactivadas para notas de soporte y actívalas para un registro literal de QA.
La salida por lotes cubre hablantes, vocabulario, formato y control de muletillas. A continuación, envía el mismo audio como flujo en vivo.
La ruta en streaming usa parámetros de consulta en lugar de un mensaje de inicio. Espera transcript.created, envía audio binario en crudo (sin base64) y cierra con {"type": "audio.done"}. Nuestro tutorial de GPT Live Transcribe sigue el mismo patrón con otro modelo.
Empieza por los eventos y luego conecta el cliente.
En lotes se usa el format=true documentado junto con language=en. La documentación de streaming dice que language activa ITN, pero en una prueba en vivo, language=en por sí solo no cambió la transcripción. La lista de consulta del WebSocket no incluye format, así que este tutorial trata la ITN en streaming como un comportamiento a verificar, no en el que depender.
Cada actualización de transcripción es un evento transcript.partial con dos booleanos. El texto interino aún puede cambiar. Un bloque final (is_final=true) fija unos 3 segundos de texto mientras el turno sigue abierto, y un final de enunciado (speech_final=true) cierra el turno.
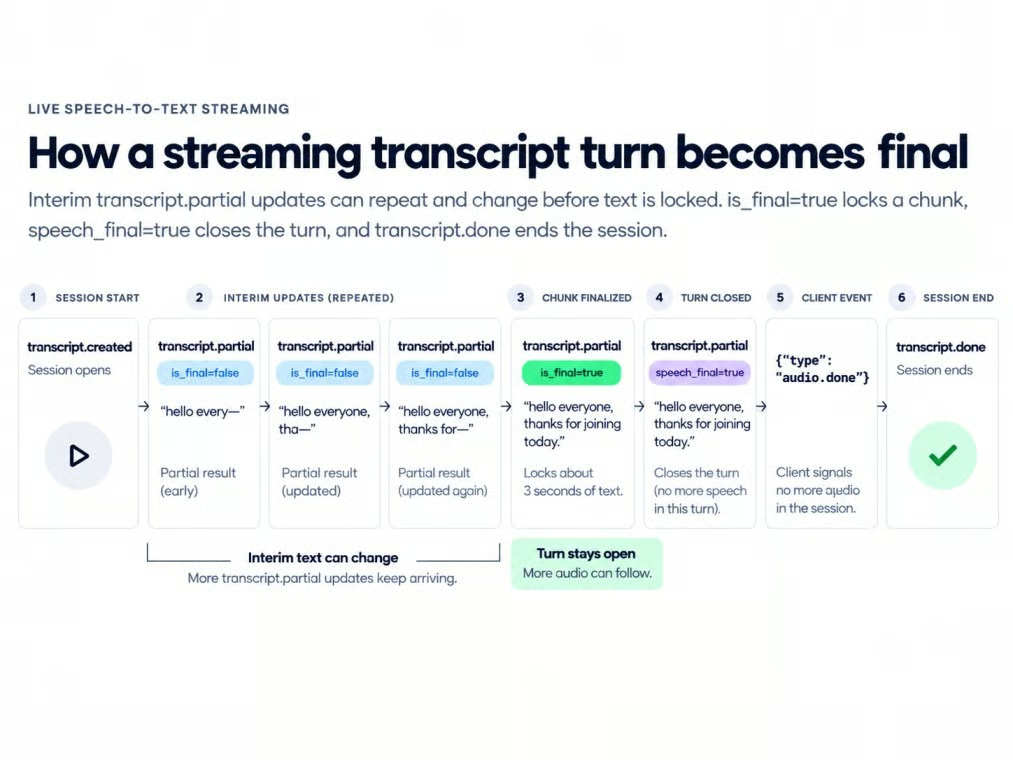
Los estados en streaming llevan el texto hacia su finalización. Imagen del autor.
Para transmitir, remuestrea primero la fuente a PCM mono de 16 bits a 16 kHz. El cliente principal envía bloques de 100 milisegundos al ritmo del tiempo real mientras otra tarea recibe eventos de transcripción:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
El texto interino crecía aproximadamente cada medio segundo. Es una medición local, no latencia oficial.
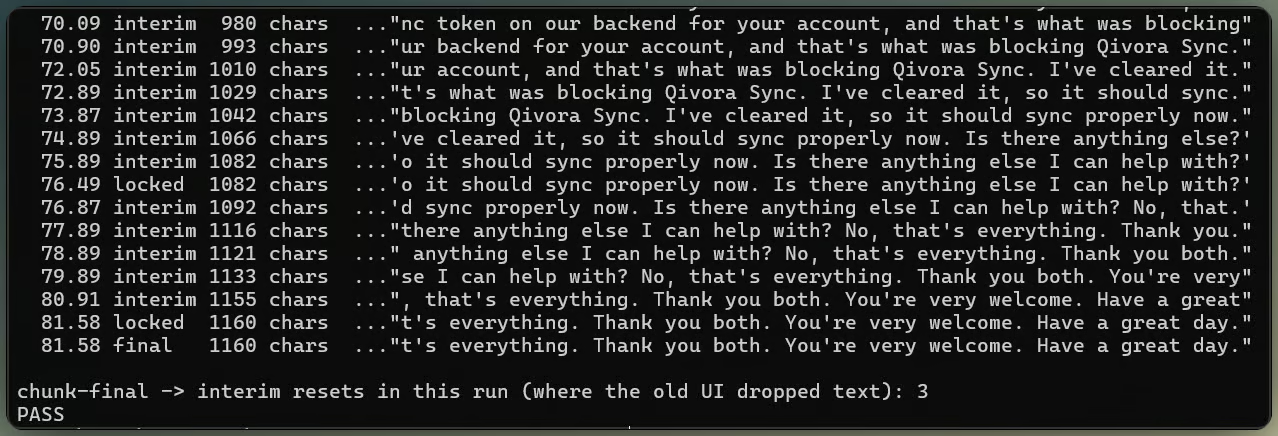
Los subtítulos parciales se asientan en la transcripción final. Imagen del autor.
Los "chunk finals" congelan texto sin cerrar el turno. Smart Turn controla cuándo speech_final lo cierra.
Si solo muestras el evento activo, las palabras anteriores desaparecen tras el final de cada bloque, porque el siguiente interino empieza de nuevo desde el audio entrante.
Conserva cada bloque fijado, añade el interino actual y deja que el final de enunciado sustituya a ambos.
El texto puede crecer sin perder bloques previos. Resuelto el estado de visualización, los límites de turno son el problema pendiente del streaming.
Smart Turn evalúa cada silencio y estima si la persona ha terminado. Existe para casos como el número de Khalid: "cero uno cero, cinco cinco cinco, [pausa], uno dos tres cuatro", donde el silencio por sí solo no distingue una pausa de pensamiento del final.
El umbral no es la confianza de transcripción ni el umbral de VAD. Es la probabilidad de fin de turno que debe superar un silencio para que speech_final dispare; por debajo, el turno sigue abierto. Dos parámetros de consulta lo ajustan:
params += [
    ("smart_turn", "0.7"),           # prob. de fin de turno necesaria para cerrar
    ("smart_turn_timeout", "3000"),  # cerrar de todos modos tras 3 s de silencio
]
La documentación llama 0.5 equilibrado, 0.7 conservador para secuencias numéricas y 0.9 muy conservador. En este escenario, las pausas más cortas que la ventana por defecto de endpointing no produjeron una decisión útil de Smart Turn. Es un resultado observado, no una regla de temporización documentada.
En la prueba en streaming, parar los fotogramas de audio no avanzó el temporizador de silencio observado. Seguir enviando silencio digital permitió a Smart Turn cerrar el enunciado.
Alargar la pausa durante el dictado del número hace visible el comportamiento. Las pausas cortas se mantienen en un mismo turno, mientras que una larga lo divide en todos los umbrales cuando la confianza supera los tres ajustes.
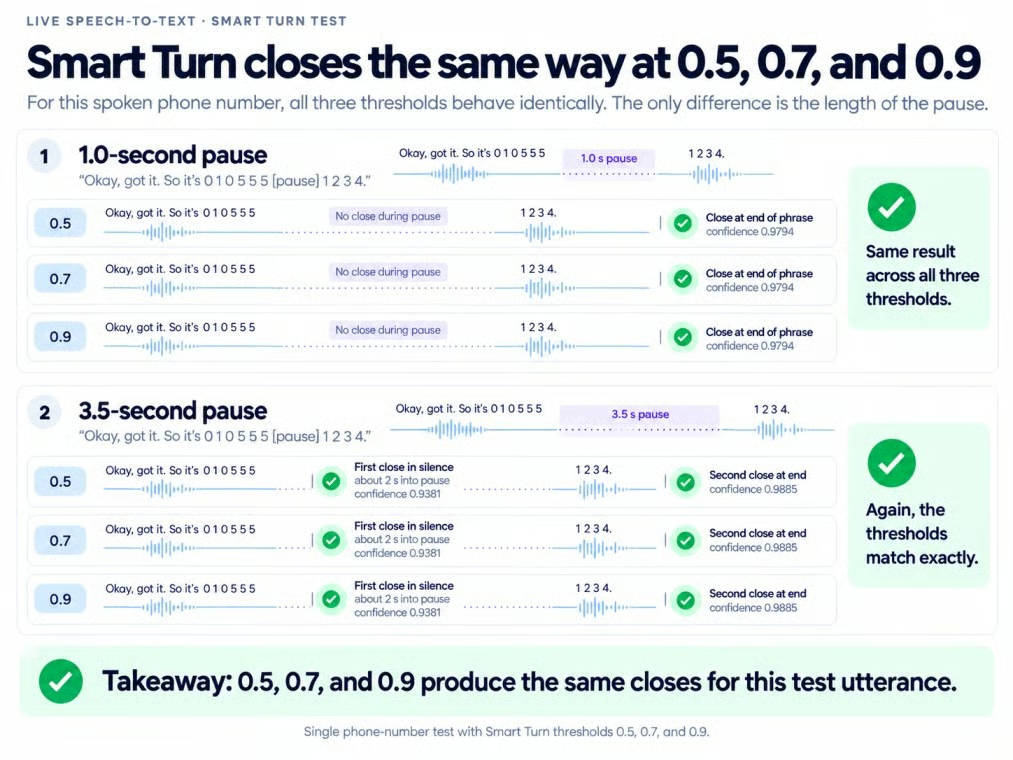
Las pausas largas pueden dividir un dictado de números. Imagen del autor.
Las personas son menos predecibles. Una secuencia corta de dígitos puede parecer terminada. Luego, el interlocutor continúa.
Si Smart Turn cierra durante un dictado de números, espera un instante y fusiona la continuación antes de responder.
smart_turn_timeout cierra un turno tras un silencio fijo, incluso cuando Smart Turn no está seguro. En el flujo rápido de tres hablantes, Smart Turn agrupó varios turnos previstos antes de que un timeout forzara el cierre.
Si ya sabes dónde acaban los turnos, envía {"type": "finalize"} en cada límite; si no, combina Smart Turn con un tiempo de espera.
Una vez bajo control los límites de turno, la misma llamada tiene que sobrevivir a una línea de 8 kHz.
Aquí el audio con calidad telefónica es G.711 mu-law a 8 kHz, generado a partir de la misma llamada:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawEl audio de telefonía en crudo no tiene contenedor, así que indica audio_format=mulaw y sample_rate=8000 en el formulario por lotes, o encoding=mulaw&sample_rate=8000 en el socket. Revisa texto y etiquetas de hablante por separado.
Las conclusiones anteriores sobre términos clave, formato y cambio de idioma cambiaron poco a 8 kHz.
Las etiquetas de hablante fueron menos fiables. La versión telefónica introdujo un ID de hablante extra y asignó un turno de cierre a la persona equivocada. Contar segmentos por sí solo oculta ambos errores.
La versión degradada limita la banda de la llamada a 300-3400 Hz, la codifica como mu-law de 8 kHz y pierde cada paquete de 20 ms con una probabilidad de 0.03. Una semilla aleatoria fija de 7 mantiene los mismos huecos en cada reproducción.
Esa pérdida de paquetes no cambió mucho la transcripción en inglés en esta muestra, y los datos de contacto dictados se mantuvieron en orden. Este resultado solo aplica a esta muestra.
La simulación telefónica estrecha el audio y pierde paquetes. Imagen del autor.
La detección de actividad de voz (VAD) decide si el audio es habla. La documentación sugiere bajar el vad_threshold para habla telefónica tenue, con el riesgo de texto espurio por ruido.
Bajar vad_threshold no cambió nada en audio telefónico limpio porque no había habla tenue que recuperar. El resultado nulo apoya una regla: baja el umbral solo cuando desaparece habla telefónica.
Usa un formulario por lotes nuevo sin diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
La API detecta el número de canales a partir de un WAV u otro contenedor. Para audio multicanal en crudo, añade ("channels", "3"); la entrada multicanal por WebSocket también requiere un número de canales explícito.
Envía el formulario con el archivo multicanal mediante la petición REST mostrada antes y luego lee result["channels"]. Cada elemento contiene un índice, texto de transcripción y palabras temporizadas. En el escenario controlado de tres canales, cada canal contenía solo su hablante asignado. El streaming usa la misma separación y añade channel_index a sus eventos.
Usaría patas separadas siempre que el sistema telefónico las proporcione. A diferencia de la diarización en el apartado de audio telefónico, una separación conocida no infiere hablantes.
El cliente completo expone un grupo de ajustes y luego construye por separado el formulario REST o la URL del WebSocket. Los ajustes compartidos cubren diarización, términos clave, muletillas, codificación de audio y manejo de turnos; el formato sigue las reglas específicas del transporte vistas antes.
Aplica los ajustes finales a una grabación con calidad telefónica y comprueba por separado la ortografía del producto, los cambios de idioma, los datos de contacto y las etiquetas de hablante. En el escenario controlado, las comprobaciones de texto pasaron mientras que una etiqueta de hablante aún requería revisión. Guarda los ajustes y el mapeo de hablantes con cada transcripción para que las comparativas posteriores usen la misma configuración.
El tutorial de transcripción de soporte termina con esa verificación final. El repositorio también contiene una extensión de agente de voz con respuestas generadas, salida hablada, interrupciones y gestión de eco.
Transcribe mantiene el mismo papel en esa demo: produce texto. Un modelo de lenguaje escribe las respuestas y Grok TTS las locuta.
¡Aprende IA con DataCamp!
Programa
Programa
Curso
Tutorial
Abid Ali Awan
9 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Zoumana Keita
12 min
Tutorial
Duong Vu
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
8 min