Program
Insinyur Kecerdasan Buatan (AI) untuk Pengembang
26 jam
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) adalah model ucapan-ke-teks dari SpaceXAI. Jalur REST mentranskripsi file yang sudah selesai, sementara jalur WebSocket menangani audio langsung.
Pengumuman Grok Voice Transcribe 2.0 dari SpaceXAI menyoroti panggilan telepon, banyak pembicara, kredensial, dan ucapan multibahasa. Untuk perbandingan tolok ukur, lihat ikhtisar Grok Voice Transcribe 2.0 kami.
Fixture terkontrol Qivora Sync tetap konstan sementara audio dan setelan API berubah. Panggilan mencakup nama produk yang diada-adakan, kata pengisi, pergantian bahasa, detail kontak yang diucapkan, jeda saat dikte, dan pembicara ketiga.
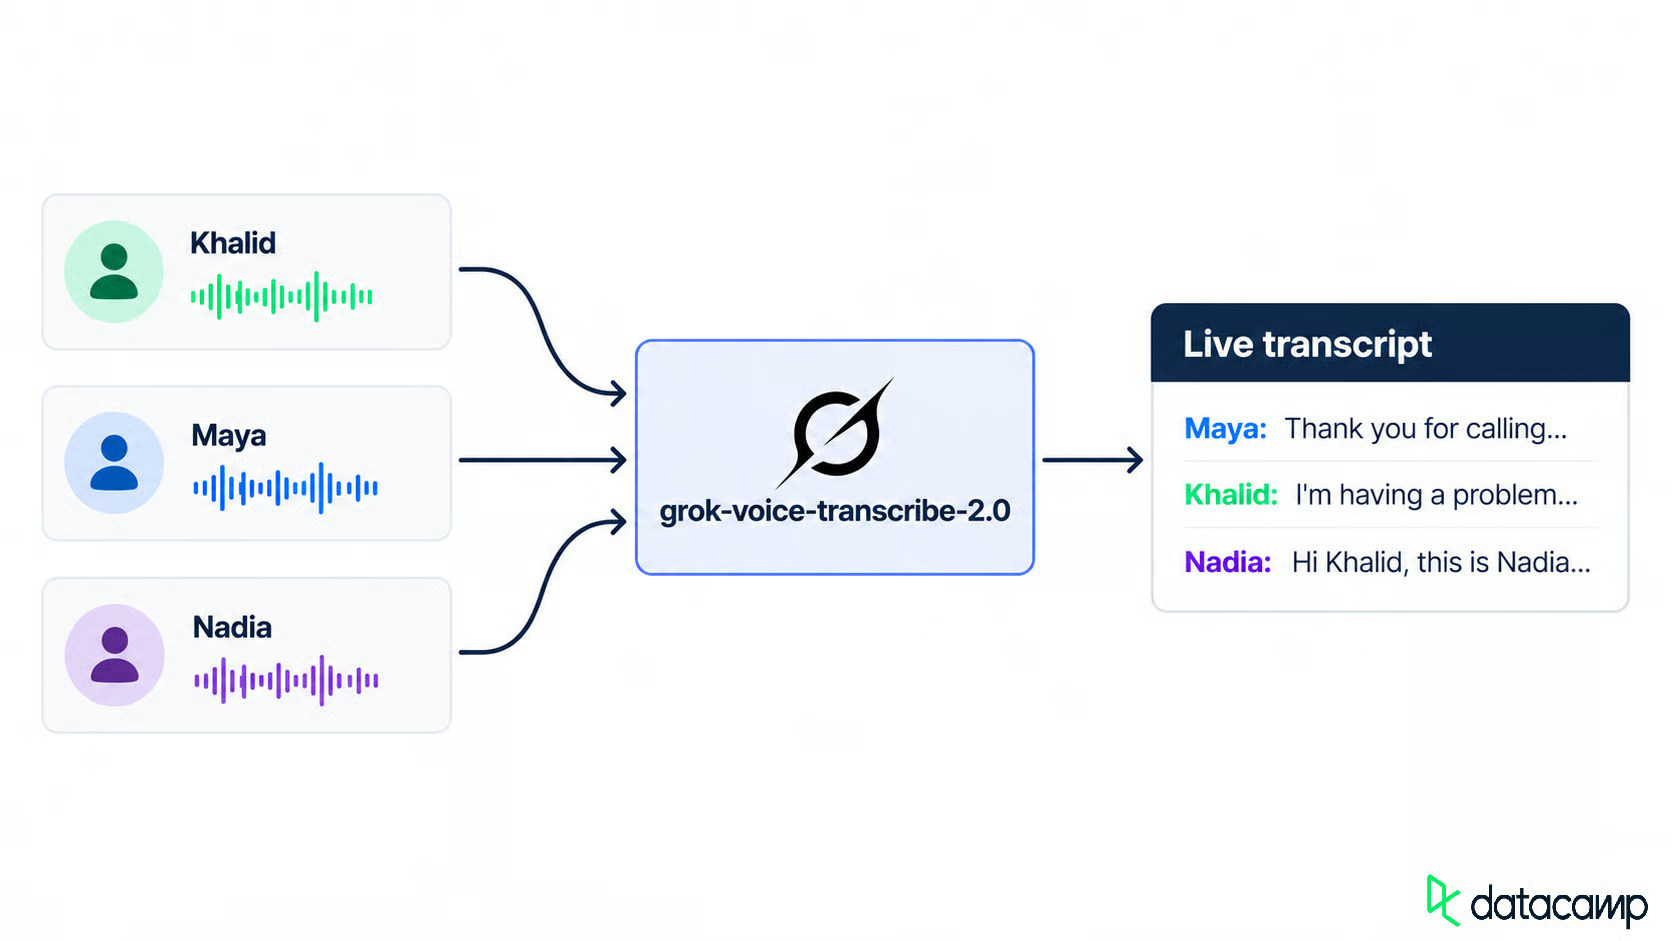
Tiga pembicara menjadi satu transkrip langsung. Gambar oleh Penulis.
Fixture terkontrol menggunakan tiga suara berbeda dari API Grok Text to Speech. Setiap segmen bahasa disintesis secara terpisah dan digabung dengan ffmpeg agar titik pergantian tetap konstan. API juga menerima language=auto; permintaan terpisah adalah pilihan desain eksperimen, bukan persyaratan API.
Sebelum permintaan pertama, tentukan teks yang diharapkan, pembicara, ejaan produk, detail pelanggan, kata pengisi, dan jeda. Setiap setelan kemudian memiliki target yang sama.
Instal dependensi sebelum mengirim audio.
Anda memerlukan Python 3.10 atau yang lebih baru, kunci API xAI, dan ffmpeg untuk membangun audio. Klien Python menggunakan requests, websockets, dan python-dotenv.
Dokumentasi Speech to Text menyebut 2.0 sebagai default saat Anda menghilangkan model, dan grok-voice-transcribe-1.0 mencapai akhir masa pakai pada 2 Oktober 2026. Saya tetap akan memasang ID versi.
Klon repositori, tambahkan kunci Anda ke .env, dan bangun audio contoh:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
Perintah setup membuat dialog dan file audio yang digunakan nanti. Jika Anda memiliki rekaman sendiri, lewati perintah itu.
Sebuah .env yang ditulis di Windows dapat menyisakan \r pada kunci, dan requests menolak header sebelum apa pun mencapai SpaceXAI. Hapus karakter itu dari kunci sebelum menambahkannya ke header otorisasi.
Tolok ukur adalah model dengan semua setelan dimatikan, sehingga setiap perubahan berikutnya punya pembanding. Permintaan pertama mengirim file dan model yang dipatok:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
Respons memuat text, language terdeteksi, duration, dan words yang bertanda waktu. Rujukan REST menunjukkan confidence per kata, tetapi bidang itu tidak muncul dalam respons batch untuk fixture ini. Saya akan memperlakukan bidang tersebut sebagai opsional dan memeriksa setiap respons API sebelum menggunakannya. Letakkan bidang opsi sebelum file; bidang setelahnya bisa diabaikan.
Tolok ukur menghapus kata pengisi, mempertahankan bahasa Arab dalam aksara Arab, dan membiarkan digit yang diucapkan terpisah. Model secara konsisten salah mengeja nama produk yang diada-adakan.
Transkrip dukungan membutuhkan label pembicara, ejaan produk yang benar, dan detail pelanggan yang dapat digunakan. Setiap setelan adalah satu field lagi dalam form:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
Tambahkan satu opsi pada satu waktu ke audio yang sama. Mulailah dengan label pembicara.
Diarization pembicara memberi kata-kata ID pembicara numerik, bukan nama. Kelompokkan kata berurutan dengan ID yang sama untuk membentuk giliran:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Pada audio yang bersih, setiap giliran yang diketahui tetap dengan ID pembicara yang konsisten. Memetakan nama berdasarkan urutan kemunculan pertama hanya berfungsi saat urutan panggilan sudah diketahui; sistem produksi memerlukan pemetaan pembicara sendiri.
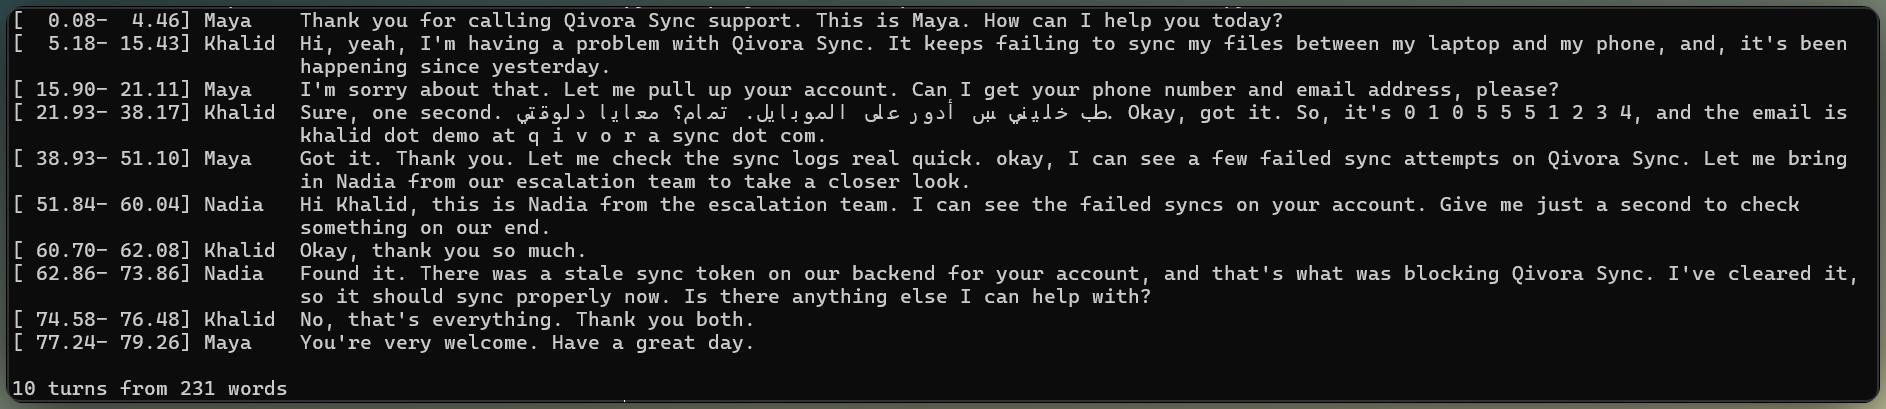
Audio bersih menjaga label pembicara tetap konsisten. Gambar oleh Penulis.
Bias istilah kunci adalah petunjuk per permintaan, bukan pelatihan. Lewatkan keyterm=Qivora Sync (hingga 100 istilah, 50 karakter masing-masing), dan model akan condong ke ejaan itu saat audio mendukungnya.
Istilah kunci memperbaiki kesalahan nama produk pada tolok ukur tanpa mengubah transkrip di sekitarnya.
Dalam pemeriksaan pembicara langsung terpisah, kosakata yang sangat dibiasakan menarik gema samar ke arah istilah kunci. Hasil itu tidak berarti istilah kunci menciptakan teks palsu dengan sendirinya; artinya audio yang ambigu tetap memerlukan pemeriksaan gema.
Seperti yang ditunjukkan tolok ukur, bahasa Arab Khalid tetap dalam aksara Arab. Hasilnya sama dengan deteksi otomatis maupun dengan language=en, karena language memilih aturan pemformatan alih-alih memaksa bahasa keluaran.
Tolok ukur mempertahankan digit yang diucapkan secara terpisah. Inverse Text Normalization (ITN) mengubah bentuk yang diucapkan menjadi bentuk tertulis. format=true menyalakannya dan memerlukan language, jika tidak permintaan gagal dengan 400.
Nomor telepon menjadi satu rangkaian digit berkesinambungan. Email hanya sebagian dinormalisasi: tanda baca membaik, tetapi kata "at" yang diucapkan dan domain yang dieja masih perlu dibersihkan.
Hasil yang tidak merata itu membuat frustrasi. ITN memformat teks; ITN tidak memvalidasi data kontak. Saya akan memvalidasi kedua field sebelum penyimpanan.
ITN juga dapat menulis ulang frasa durasi biasa menjadi kuantitas yang disingkat. Dalam respons batch terformat untuk fixture ini, hanya text tingkat atas yang dinormalisasi; array words mempertahankan bentuk yang diucapkan.
Seperti yang ditunjukkan tolok ukur, kata pengisi dihapus dari text dan words secara default. filler_words=true mengembalikan "uh" dan "um" milik Khalid di tempat yang diharapkan. Matikan untuk catatan dukungan, nyalakan untuk catatan QA verbatim.
Keluaran batch mencakup kontrol pembicara, kosakata, pemformatan, dan kata pengisi. Selanjutnya, kirim audio yang sama sebagai aliran langsung.
Jalur streaming menggunakan parameter kueri, bukan pesan setup. Tunggu transcript.created, kirim audio biner mentah (tanpa base64), dan tutup dengan {"type": "audio.done"}. Tutorial GPT Live Transcribe kami menggunakan pola yang sama dengan model lain.
Mulailah dengan event, lalu sambungkan klien.
Batch menggunakan format=true yang didokumentasikan dengan language=en. Dokumentasi streaming menyatakan bahwa language menyalakan ITN, tetapi dalam uji langsung, language=en saja tidak mengubah transkrip. Daftar kueri WebSocket tidak menyertakan format, jadi tutorial ini memperlakukan ITN streaming sebagai perilaku yang harus diverifikasi, bukan diandalkan.
Setiap pembaruan transkripsi adalah event transcript.partial dengan dua nilai boolean. Teks sementara masih bisa berubah. Final chunk (is_final=true) mengunci sekitar 3 detik teks selama giliran tetap terbuka, dan final ujaran (speech_final=true) menutup giliran.
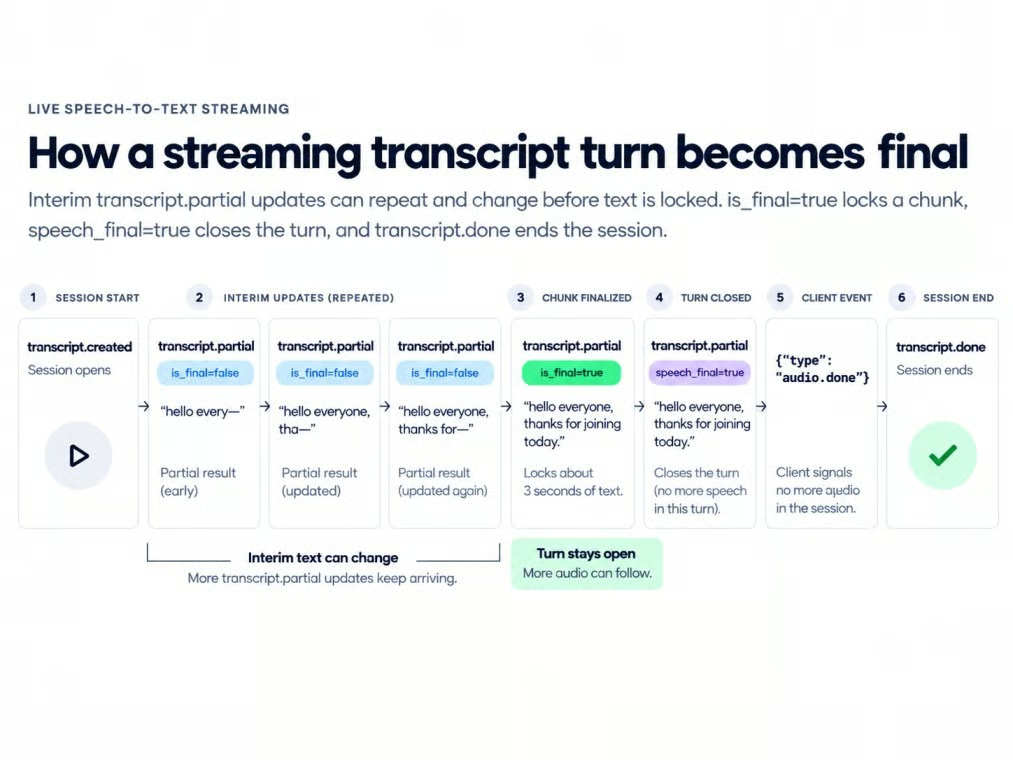
Status streaming menggerakkan teks menuju finalisasi. Gambar oleh Penulis.
Untuk streaming, resampling sumber menjadi mono PCM 16-bit pada 16 kHz terlebih dahulu. Klien inti mengirim potongan 100 milidetik pada kecepatan waktu nyata sementara tugas lain menerima event transkrip:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Teks sementara bertambah sekitar setiap setengah detik. Ini adalah pengukuran lokal, bukan latensi resmi.
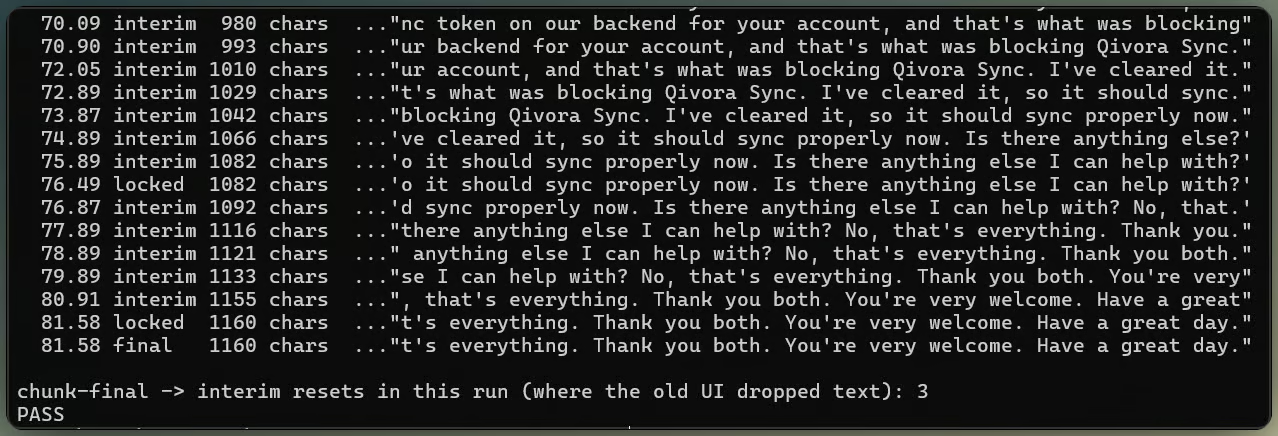
Caption parsial menetap menjadi transkrip final. Gambar oleh Penulis.
Final chunk membekukan teks tanpa menutup giliran. Smart Turn mengontrol kapan speech_final menutupnya.
Hanya menampilkan event aktif membuat kata-kata sebelumnya menghilang setelah setiap final chunk, karena interim berikutnya mulai dari audio yang masuk.
Simpan setiap chunk yang terkunci, tambahkan interim saat ini, dan biarkan final ujaran menggantikan keduanya.
Teks dapat bertambah tanpa kehilangan potongan sebelumnya. Setelah status tampilan tertangani, batas giliran menjadi masalah streaming yang tersisa.
Smart Turn mengevaluasi setiap keheningan dan memperkirakan apakah pembicara telah selesai. Fitur ini ada untuk nomor Khalid, "nol satu nol, lima lima lima, [jeda], satu dua tiga empat," di mana keheningan saja tidak bisa membedakan jeda berpikir dari akhir ujaran.
Ambang ini bukan keyakinan transkripsi atau ambang VAD. Ini adalah probabilitas akhir giliran yang harus dilampaui oleh keheningan sebelum speech_final terjadi; di bawahnya, giliran tetap terbuka. Dua parameter kueri mengaturnya:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
Dokumentasi menyebut 0,5 seimbang, 0,7 konservatif untuk rangkaian angka, dan 0,9 sangat konservatif. Dalam fixture ini, jeda yang lebih pendek dari jendela endpointing default tidak menghasilkan keputusan Smart Turn yang berguna. Itu adalah hasil yang diamati, bukan aturan waktu yang didokumentasikan.
Dalam uji streaming, menghentikan frame audio tidak memajukan timer keheningan yang diamati. Melanjutkan pengiriman keheningan digital memungkinkan Smart Turn menutup ujaran.
Memperpanjang jeda selama dikte nomor membuat perilakunya terlihat. Jeda singkat tetap dalam satu giliran, sementara jeda panjang membaginya pada setiap ambang saat keyakinan melebihi ketiga setelan.
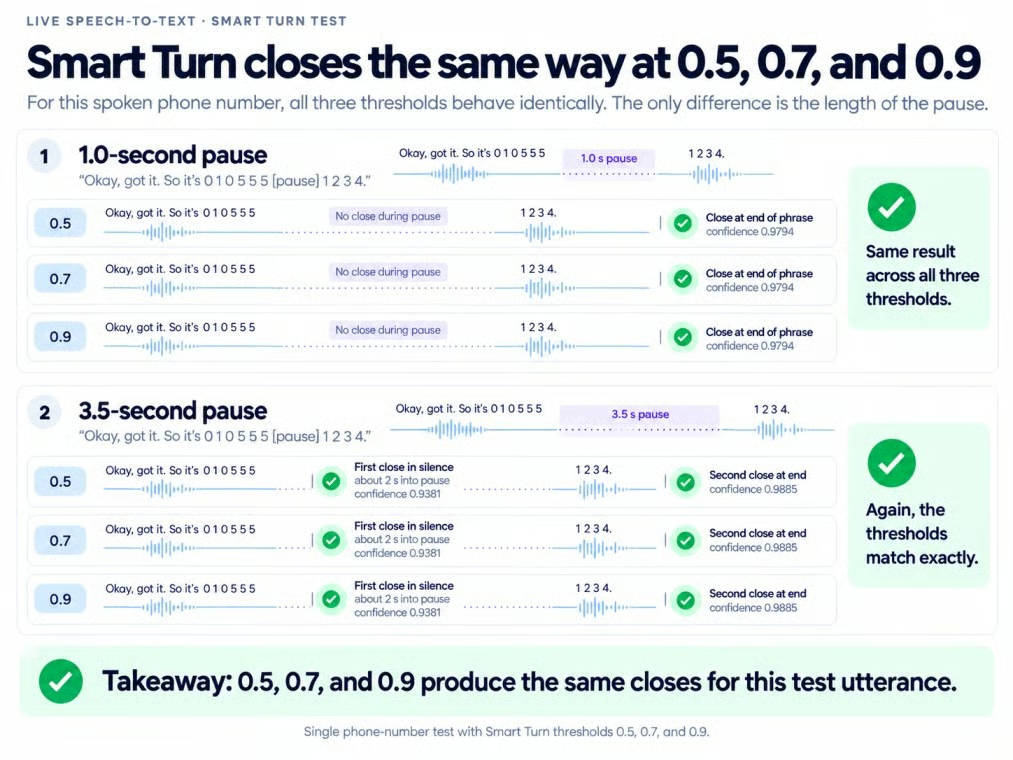
Jeda panjang dapat membagi dikte nomor. Gambar oleh Penulis.
Penelepon manusia kurang dapat diprediksi. Rangkaian digit pendek bisa terlihat selesai. Lalu penelepon melanjutkan.
Jika Smart Turn menutup saat dikte nomor, tunggu sebentar dan gabungkan kelanjutannya sebelum membalas.
smart_turn_timeout menutup giliran setelah keheningan tetap, bahkan ketika Smart Turn ragu. Pada aliran cepat tiga pembicara, Smart Turn mengelompokkan beberapa giliran yang diketahui sebelum timeout memaksakan penutupan.
Jika Anda sudah tahu di mana giliran berakhir, kirim {"type": "finalize"} di setiap batas; jika tidak, pasangkan Smart Turn dengan timeout.
Setelah batas giliran terkendali, penelepon yang sama harus bertahan di saluran 8 kHz.
Audio berkualitas telepon di sini adalah G.711 mu-law 8 kHz, dibuat dari panggilan yang sama:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawAudio telepon mentah tidak punya kontainer, jadi setel audio_format=mulaw dan sample_rate=8000 dalam form batch, atau encoding=mulaw&sample_rate=8000 pada soket. Periksa teks dan label pembicara secara terpisah.
Temuan istilah kunci, pemformatan, dan pergantian bahasa sebelumnya berubah sedikit pada 8 kHz.
Label pembicara menjadi kurang andal. Versi telepon memperkenalkan ID pembicara tambahan dan menetapkan giliran penutup ke orang yang salah. Menghitung segmen saja menyamarkan kedua kesalahan.
Versi tidak stabil membatasi pita panggilan ke 300–3400 Hz, mengkodekannya sebagai mu-law 8 kHz, dan menjatuhkan setiap paket 20 milidetik dengan probabilitas 0,03. Seed acak tetap sebesar 7 menjaga celah yang sama pada setiap pemutaran ulang.
Kehilangan paket itu tidak banyak mengubah transkrip bahasa Inggris dalam sampel ini, dan detail kontak yang diucapkan tetap berurutan. Hasil ini hanya berlaku untuk sampel ini.
Simulasi telepon mempersempit audio, menjatuhkan paket. Gambar oleh Penulis.
Deteksi aktivitas suara (VAD) memutuskan apakah audio merupakan ucapan. Dokumentasi menyarankan menurunkan vad_threshold untuk ucapan telepon yang pelan, dengan risiko teks menyimpang dari noise.
Menurunkan vad_threshold tidak mengubah apa pun pada audio telepon bersih karena tidak ada ucapan pelan untuk dipulihkan. Hasil nol ini mendukung satu aturan: turunkan ambang hanya ketika ucapan telepon hilang.
Gunakan form batch baru tanpa diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API mendeteksi jumlah saluran dari WAV atau kontainer lain. Untuk audio multisaluran mentah, tambahkan ("channels", "3"); input multisaluran WebSocket juga memerlukan jumlah saluran eksplisit.
Kirim form dengan file multisaluran melalui permintaan REST yang ditunjukkan sebelumnya, lalu baca result["channels"]. Setiap item memuat indeks, teks transkrip, dan kata bertanda waktu. Dalam fixture tiga saluran terkontrol, setiap saluran hanya berisi pembicaranya yang ditetapkan. Streaming menggunakan pembagian yang sama dan menambahkan channel_index ke event-nya.
Saya akan menggunakan jalur terpisah kapan pun sistem telepon menyediakannya. Tidak seperti diarization pada bagian audio telepon, pemisahan yang diketahui tidak menyimpulkan pembicara.
Klien lengkap mengekspos satu grup setelan, lalu membangun form REST atau URL WebSocket secara terpisah. Setelan bersama mencakup diarization, istilah kunci, kata pengisi, pengodean audio, dan penanganan giliran; pemformatan mengikuti aturan khusus transport yang dibahas sebelumnya.
Terapkan setelan akhir ke rekaman berkualitas telepon, lalu periksa ejaan produk, pergantian bahasa, detail kontak, dan label pembicara secara terpisah. Dalam fixture terkontrol, pemeriksaan teks lolos sementara satu label pembicara masih perlu ditinjau. Simpan setelan dan pemetaan pembicara dengan setiap transkrip agar perbandingan nanti menggunakan setup yang sama.
Tutorial transkripsi dukungan berakhir dengan pemeriksaan akhir itu. Repositori juga memuat ekstensi agen suara terpisah dengan balasan yang dihasilkan, keluaran suara, interupsi, dan penanganan gema.
Transcribe mempertahankan peran yang sama dalam demo tersebut: menghasilkan teks. Model bahasa menulis balasan, dan Grok TTS mengucapkannya.
Belajar AI Bersama DataCamp!
Program
Program
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt