แทร็ก
วิศวกร AI ระดับ Associate สำหรับนักพัฒนา
26 ชม.
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) คือโมเดลถอดเสียงเป็นข้อความของ SpaceXAI เส้นทาง REST ใช้ถอดเสียงไฟล์ที่เสร็จแล้ว ส่วนเส้นทาง WebSocket ใช้กับเสียงสด
ประกาศ Grok Voice Transcribe 2.0 ของ SpaceXAI เน้นสายโทรศัพท์ หลายผู้พูด ข้อมูลยืนยันตัวตน และเสียงหลายภาษา สำหรับการเปรียบเทียบเบนช์มาร์ก ดู ภาพรวม Grok Voice Transcribe 2.0 ของเรา
ฟิกซ์เจอร์ Qivora Sync ที่ควบคุมได้ยังคงเดิม ขณะปรับออดิโอและการตั้งค่า API สายนี้มีชื่อผลิตภัณฑ์ที่แต่งขึ้น ฟิลเลอร์ การสลับภาษา รายละเอียดการติดต่อที่พูดสะกด ช่วงหยุดระหว่างการคีย์ด้วยคำพูด และผู้พูดคนที่สาม
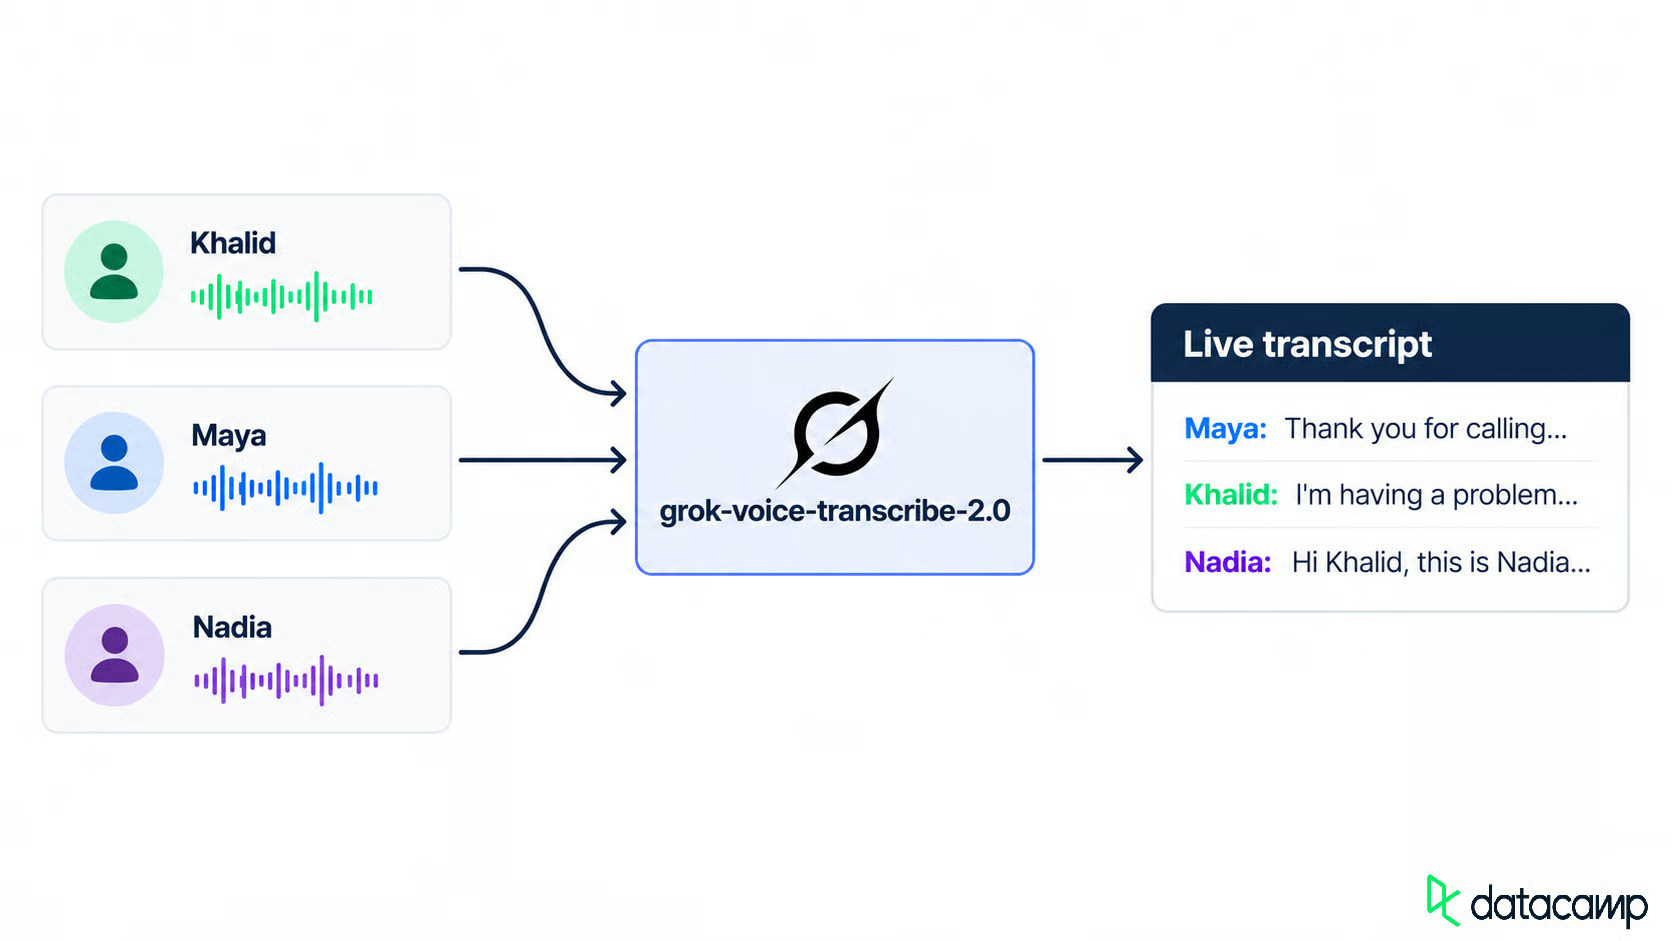
สามผู้พูดรวมเป็นทรานสคริปต์สดเดียว ภาพโดยผู้เขียน
ฟิกซ์เจอร์ที่ควบคุมได้ใช้เสียงสามแบบที่แตกต่างกันจาก Grok Text to Speech API แต่ละช่วงภาษาถูกสังเคราะห์แยกกันและรวมด้วย ffmpeg เพื่อให้จุดสลับคงที่ API ยังรับ language=auto; การแยกคำขอเป็นการเลือกเพื่อการทดลอง ไม่ใช่ข้อบังคับของ API
ก่อนคำขอแรก ให้กำหนดข้อความที่คาดหวัง ผู้พูด การสะกดชื่อผลิตภัณฑ์ รายละเอียดลูกค้า ฟิลเลอร์ และช่วงหยุด จากนั้นทุกการตั้งค่าจะมีเป้าหมายเดียวกัน
ติดตั้งไลบรารีที่ต้องใช้ก่อนส่งออดิโอ
ต้องมี Python 3.10 ขึ้นไป คีย์ API ของ xAI และ ffmpeg สำหรับสร้างออดิโอ ไคลเอนต์ Python ใช้ requests, websockets และ python-dotenv
เอกสาร Speech to Text ระบุว่า 2.0 เป็นค่าเริ่มต้นเมื่อไม่ระบุ model และ grok-voice-transcribe-1.0 หมดอายุเมื่อ 2 ตุลาคม 2026 แนะนำให้ปักหมุด ID เวอร์ชันไว้
โคลนที่เก็บ ใส่คีย์ลงใน .env และสร้างออดิโอตัวอย่าง:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
คำสั่งตั้งค่าสร้างบทสนทนาและไฟล์ออดิโอที่ใช้ภายหลัง หากมีไฟล์บันทึกของตนเอง ให้ข้ามคำสั่งนั้น
ไฟล์ .env ที่เขียนบน Windows อาจทิ้ง \r ไว้ต่อท้ายคีย์ และ requests จะปฏิเสธเฮดเดอร์ก่อนส่งถึง SpaceXAI ให้ลบอักขระนั้นออกก่อนใส่คีย์ลงในเฮดเดอร์ Authorization
ฐานเปรียบเทียบคือโมเดลโดยไม่เปิดตัวเลือกใดๆ เพื่อให้ทุกการเปลี่ยนแปลงภายหลังมีสิ่งให้เทียบ คำขอแรกส่งไฟล์และรุ่นโมเดลที่ปักหมุด:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
การตอบกลับมี text, languageที่ตรวจจับได้ duration และอาร์เรย์ words ที่มีเวลาเป็นคำ เอกสารอ้างอิง REST แสดง confidence รายคำ แต่ไม่ปรากฏในคำตอบแบบแบตช์ของฟิกซ์เจอร์นี้ แนะนำให้ถือว่าฟิลด์นี้เป็นตัวเลือก และตรวจสอบการตอบกลับของ API ทุกครั้งก่อนใช้งาน วางฟิลด์ตัวเลือกไว้ก่อน file; ฟิลด์ที่ตามหลังอาจถูกละเลย
ฐานเปรียบเทียบลบฟิลเลอร์ คงข้อความอาหรับเป็นตัวอักษรอาหรับ และเว้นตัวเลขที่พูดออกจากกัน ทั้งยังสะกดชื่อผลิตภัณฑ์ที่แต่งขึ้นผิดอย่างสม่ำเสมอ
ทรานสคริปต์สำหรับสนับสนุนต้องมีป้ายผู้พูด การสะกดชื่อผลิตภัณฑ์ให้ถูก และรายละเอียดลูกค้าที่ใช้การได้ แต่ละการตั้งค่าเป็นอีกหนึ่งฟิลด์แบบฟอร์ม:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
เพิ่มตัวเลือกทีละรายการกับออดิโอชุดเดิม เริ่มจากป้ายผู้พูด
การแยกผู้พูด ให้คำมีไอดีผู้พูดแบบตัวเลข ไม่ใช่ชื่อ จัดกลุ่มคำที่ต่อเนื่องกันและมีไอดีเดียวกันเพื่อสร้างช่วงการพูด:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
บนเสียงสะอาด แต่ละช่วงที่ทราบคงไอดีผู้พูดสม่ำเสมอ การแมปชื่อด้วยลำดับการปรากฏครั้งแรกใช้ได้เฉพาะเมื่อทราบลำดับการพูดอยู่แล้ว ระบบจริงควรมีการแมปผู้พูดของตนเอง
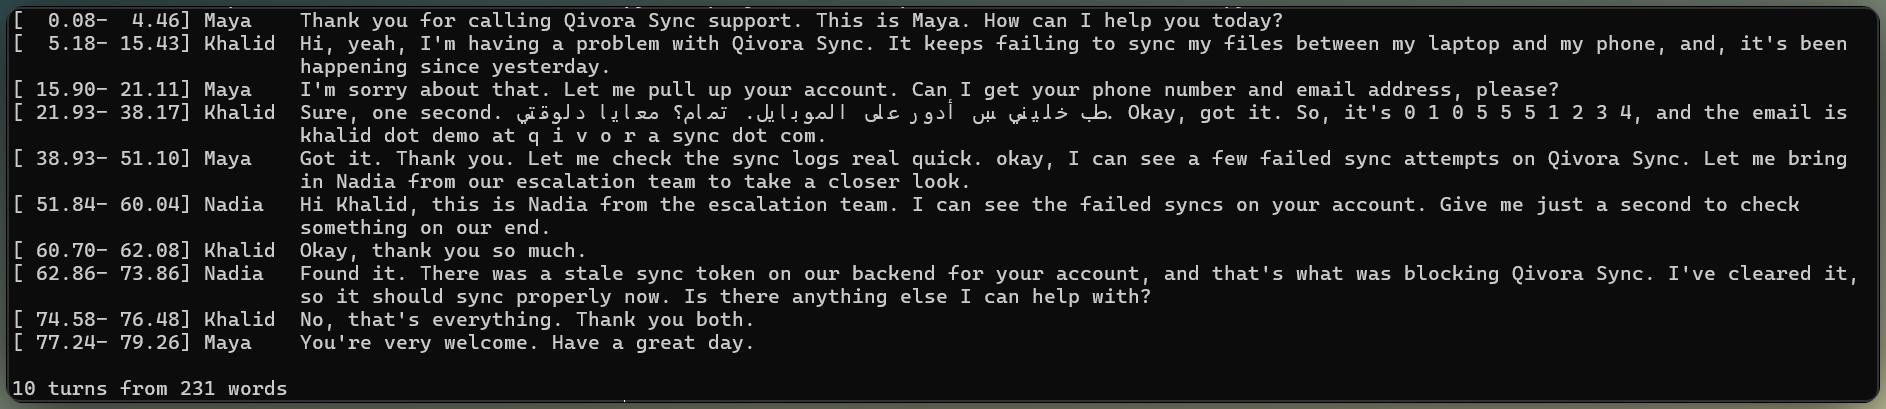
เสียงสะอาดช่วยให้ป้ายผู้พูดสม่ำเสมอ ภาพโดยผู้เขียน
การเอนเอียงคำสำคัญเป็นคำใบ้ระดับคำขอ ไม่ใช่การเทรน ส่งผ่าน keyterm=Qivora Sync (ได้สูงสุด 100 คำ สูงสุด 50 อักขระต่อคำ) โมเดลจะโน้มเอียงไปทางการสะกดนั้นเมื่อเสียงสนับสนุน
คำสำคัญช่วยแก้ข้อผิดพลาดชื่อผลิตภัณฑ์ของฐานเปรียบเทียบโดยไม่เปลี่ยนทรานสคริปต์ส่วนรอบข้าง
ในการตรวจสอบเสียงสดแยกต่างหาก พจนานุกรมที่เอนเอียงแรงดึงเสียงสะท้อนแผ่วๆ ให้เข้าใกล้คำสำคัญ ผลนั้นไม่ได้หมายความว่าคำสำคัญทำให้เกิดข้อความเท็จด้วยตัวมันเอง; แต่หมายความว่าเสียงกำกวมยังต้องตรวจเช็คเสียงสะท้อน
อย่างที่ฐานเปรียบเทียบแสดง ภาษาอาหรับของ Khalid ยังคงเป็นตัวอักษรอาหรับ ผลลัพธ์เหมือนกันทั้งกับการตรวจจับอัตโนมัติและกับ language=enเพราะ language เลือกกฎการจัดรูปแบบ ไม่ได้บังคับภาษาผลลัพธ์
ฐานเปรียบเทียบเว้นตัวเลขที่พูดออกจากกัน Inverse Text Normalization (ITN) แปลงรูปแบบคำพูดให้เป็นรูปแบบตัวเขียน format=true เปิดใช้และต้องมี language มิฉะนั้นคำขอจะล้มเหลวด้วย 400
หมายเลขโทรศัพท์ถูกร้อยเป็นสตริงตัวเลขเดียว อีเมลถูกทำให้เป็นปกติแค่บางส่วน: เครื่องหมายวรรคตอนดีขึ้น แต่คำว่า "at" ที่พูด และโดเมนที่สะกดยังต้องเกลา
ผลที่ไม่สม่ำเสมอนั้นน่าหงุดหงิด ITN จัดรูปแบบข้อความ ไม่ได้ตรวจสอบความถูกต้องของข้อมูลการติดต่อ แนะนำให้ตรวจสอบทั้งสองฟิลด์ก่อนจัดเก็บ
ITN ยังสามารถเขียนวลีบอกระยะเวลาให้เป็นคำย่อเชิงปริมาณได้ด้วย ในคำตอบแบบแบตช์ที่จัดรูปแบบของฟิกซ์เจอร์นี้ เฉพาะ text ระดับบนสุดเท่านั้นที่ถูกทำให้เป็นปกติ; อาร์เรย์ words ยังคงรูปแบบคำพูด
อย่างที่ฐานเปรียบเทียบแสดง ฟิลเลอร์ถูกลบออกจาก text และ words ตามค่าเริ่มต้น filler_words=true นำ "uh" และ "um" ของ Khalid กลับมาตามที่คาด ไว้ปิดสำหรับโน้ตสนับสนุน และเปิดสำหรับบันทึกคำต่อคำสำหรับ QA
เอาต์พุตแบบแบตช์รองรับผู้พูด พจนานุกรม การจัดรูปแบบ และการควบคุมคำฟิลเลอร์ ต่อไปให้ส่งออดิโอเดียวกันเป็นสตรีมสด
เส้นทางสตรีมใช้พารามิเตอร์คิวรีแทนข้อความตั้งค่า รอ transcript.created ส่งออดิโอบิตนารีดิบ (ไม่ใช่ base64) และปิดด้วย {"type": "audio.done"} บทเรียน GPT Live Transcribe ของเราใช้รูปแบบเดียวกันกับโมเดลอื่น
เริ่มจากอีเวนต์ จากนั้นเชื่อมต่อไคลเอนต์
แบบแบตช์ใช้ format=true ตามเอกสารคู่กับ language=en เอกสารสตรีมระบุว่า language เปิด ITN แต่ในการทดสอบสด language=en เพียงอย่างเดียวไม่เปลี่ยนทรานสคริปต์ รายการคิวรีของ WebSocket ไม่มี format ดังนั้นบทเรียนนี้จึงถือว่า ITN บนสตรีมเป็นพฤติกรรมที่ต้องตรวจสอบ ไม่ใช่พึ่งพา
ทุกการอัปเดตทรานสคริปต์คืออีเวนต์ transcript.partial ที่มีบูลีนสองตัว ข้อความชั่วคราวอาจยังเปลี่ยนได้ เมื่อเป็นชิ้นสุดท้าย (is_final=true) จะล็อกข้อความราว 3 วินาทีในขณะที่เทิร์นยังเปิดอยู่ และเมื่อเป็นอุตเทอแรนซ์สุดท้าย (speech_final=true) จะปิดเทิร์น
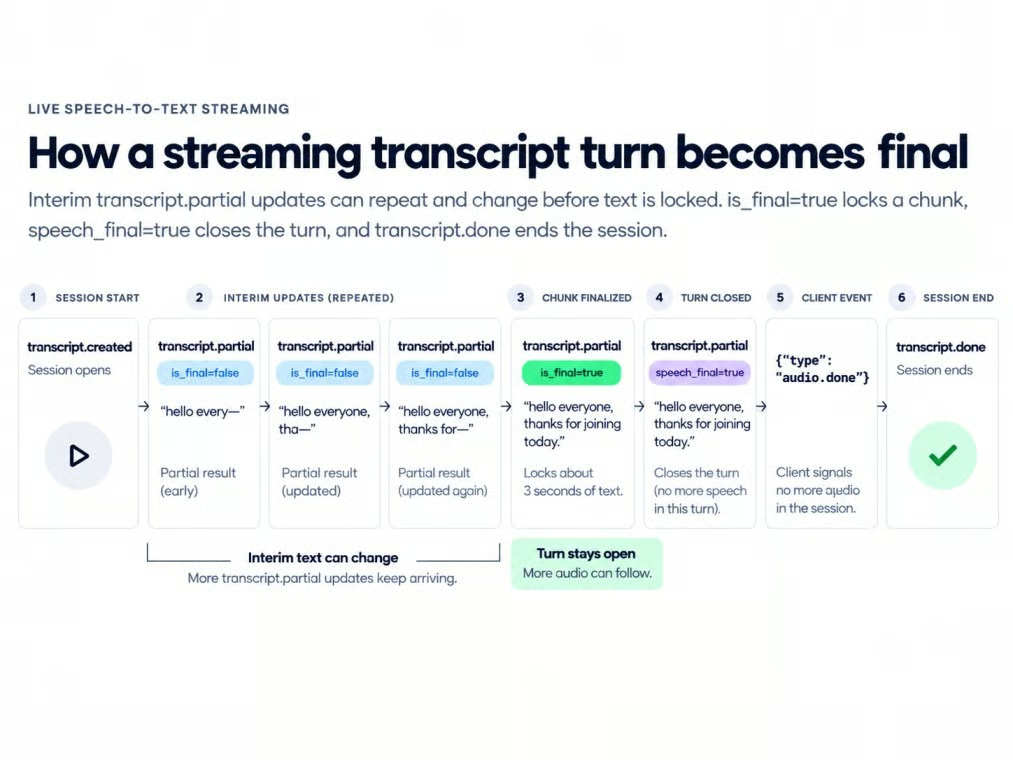
สถานะสตรีมพาเนื้อความไปสู่ความเป็นที่สุดท้าย ภาพโดยผู้เขียน
สำหรับสตรีม ให้แปลงต้นทางเป็นโมโน PCM 16 บิตที่ 16 kHz ก่อน ไคลเอนต์หลักส่งทีละชิ้นความยาว 100 มิลลิวินาทีในจังหวะเวลาเรียลไทม์ ขณะที่งานอีกตัวรับอีเวนต์ทรานสคริปต์:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
ข้อความชั่วคราวเพิ่มขึ้นราวทุกครึ่งวินาที นี่เป็นการวัดในเครื่อง ไม่ใช่ค่าหน่วงเวลาทางการ
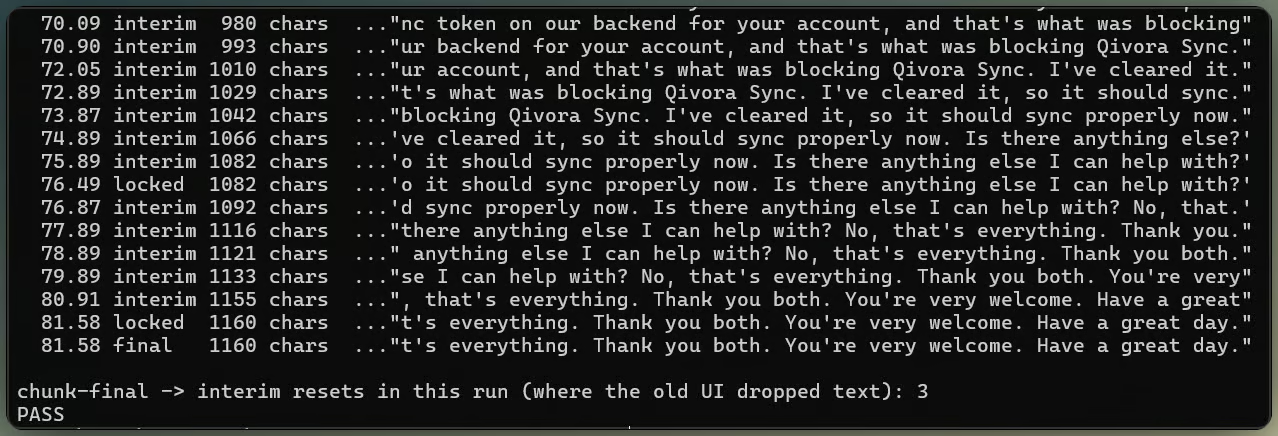
คำบรรยายชั่วคราวนิ่งกลายเป็นทรานสคริปต์สุดท้าย ภาพโดยผู้เขียน
ชิ้นสุดท้ายช่วยตรึงข้อความโดยไม่ปิดเทิร์น Smart Turn ควบคุมว่าเมื่อไร speech_final จะปิด
การแสดงเฉพาะอีเวนต์ที่กำลังทำงานทำให้คำก่อนหน้าหายไปหลังชิ้นสุดท้ายของแต่ละชิ้น เพราะข้อความชั่วคราวถัดไปเริ่มใหม่จากเสียงที่เข้ามา
เก็บทุกชิ้นที่ล็อกไว้ เพิ่มข้อความชั่วคราวปัจจุบัน และปล่อยให้อุตเทอแรนซ์สุดท้ายแทนที่ทั้งสอง
ข้อความสามารถเติบโตโดยไม่สูญเสียชิ้นก่อนหน้า เมื่อจัดการสถานะการแสดงผลแล้ว เส้นเขตเทิร์นคือปัญหาสตรีมที่เหลือ
Smart Turn ประเมินทุกความเงียบและคาดการณ์ว่าผู้พูดพูดจบหรือยัง ใช้แก้กรณีหมายเลขของ Khalid อย่าง "ศูนย์ หนึ่ง ศูนย์, ห้า ห้า ห้า, [หยุด], หนึ่ง สอง สาม สี่" ที่ความเงียบอย่างเดียวบอกไม่ได้ว่าเป็นช่วงคิดหรือจบแล้ว
ธรณีไม่ได้หมายถึงความมั่นใจในการถอดความ หรือ ธรณี VAD แต่คือความน่าจะเป็นว่าเทิร์นจบ ที่ความเงียบต้องผ่านก่อนที่ speech_final จะยิง; ต่ำกว่านั้น เทิร์นยังเปิดอยู่ ตั้งค่าด้วยพารามิเตอร์คิวรีสองตัว:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
เอกสารระบุว่า 0.5 สมดุล 0.7 ระมัดระวังสำหรับลำดับตัวเลข และ 0.9 ระมัดระวังมาก ในฟิกซ์เจอร์นี้ ช่วงหยุดที่สั้นกว่าหน้าต่าง endpointing ค่าเริ่มต้น ไม่ให้ผลตัดสิน Smart Turn ที่เป็นประโยชน์ นี่เป็นผลการสังเกต ไม่ใช่กฎเวลาในเอกสาร
ในการทดสอบสตรีม การหยุดส่งเฟรมเสียงไม่ทำให้ตัวจับเวลาความเงียบที่สังเกตเห็นเดินต่อ การส่งความเงียบดิจิทัลต่อไปทำให้ Smart Turn ปิดอุตเทอแรนซ์ได้
ยืดช่วงหยุดระหว่างการคีย์ด้วยคำพูดของหมายเลขเพื่อให้เห็นพฤติกรรมชัดขึ้น ช่วงหยุดสั้นยังอยู่ในเทิร์นเดียว ขณะที่ช่วงหยุดยาวจะแบ่งออกที่ทุกค่าธรณีเมื่อความมั่นใจเกินทั้งสามค่า
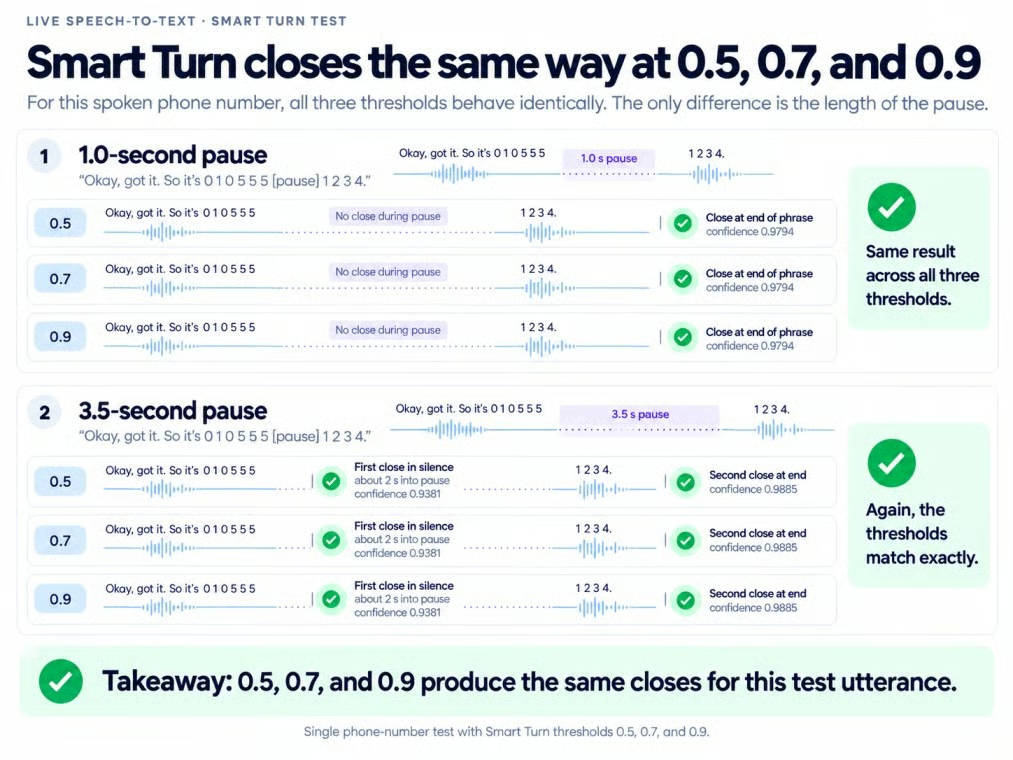
ช่วงหยุดยาวอาจแบ่งการคีย์ตัวเลขด้วยคำพูด ภาพโดยผู้เขียน
ผู้โทรที่เป็นมนุษย์คาดเดายากกว่า ลำดับตัวเลขสั้นๆ อาจดูเสร็จแล้ว จากนั้นผู้โทรพูดต่อ
หาก Smart Turn ปิดระหว่างการคีย์ตัวเลขด้วยคำพูด ให้รอสั้นๆ และรวมส่วนต่อเนื่องก่อนตอบกลับ
smart_turn_timeout ปิดเทิร์นหลังความเงียบคงที่ แม้ Smart Turn จะไม่แน่ใจ บนสตรีมสามผู้พูดที่เร็ว Smart Turn จัดกลุ่มหลายช่วงที่ทราบก่อนที่ timeout จะบังคับปิด
หากทราบจุดจบเทิร์นอยู่แล้ว ให้ส่ง {"type": "finalize"} ที่แต่ละขอบเขต; หากไม่ ให้ใช้ Smart Turn คู่กับ timeout
เมื่อควบคุมขอบเขตเทิร์นได้แล้ว ผู้โทรคนเดิมยังต้องผ่านสาย 8 kHz ให้ได้
ออดิโอคุณภาพโทรศัพท์ที่นี่คือ G.711 mu-law 8 kHz ทำจากสายเดียวกัน:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawออดิโอโทรศัพท์แบบดิบไม่มีคอนเทนเนอร์ ดังนั้นให้ตั้ง audio_format=mulaw และ sample_rate=8000 ในฟอร์มแบบแบตช์ หรือ encoding=mulaw&sample_rate=8000 บนซ็อกเก็ต ตรวจสอบข้อความและป้ายผู้พูดแยกกัน
ข้อค้นพบเรื่องคำสำคัญ การจัดรูปแบบ และการสลับภาษาก่อนหน้า เปลี่ยนแปลงเล็กน้อยที่ 8 kHz
ป้ายผู้พูดไม่น่าเชื่อถือมากขึ้น เวอร์ชันโทรศัพท์เพิ่มไอดีผู้พูดพิเศษ และกำหนดช่วงปิดให้คนผิด การนับจำนวนช่วงอย่างเดียวซ่อนข้อผิดพลาดทั้งสอง
เวอร์ชันที่ไม่นิ่งจะจำกัดย่านสัญญาณของสายไว้ที่ 300–3400 Hz เข้ารหัสเป็น mu-law 8 kHz และดรอปแพ็กเก็ต 20 มิลลิวินาทีแต่ละแพ็กเก็ตด้วยความน่าจะเป็น 0.03 ใช้ค่า seed แบบสุ่มคงที่ 7 เพื่อให้ช่องว่างเดิมซ้ำได้ทุกครั้ง
การสูญเสียแพ็กเก็ตนั้นไม่ได้เปลี่ยนทรานสคริปต์ภาษาอังกฤษมากในตัวอย่างนี้ และรายละเอียดการติดต่อที่พูดยังคงเรียงลำดับถูกต้อง ผลนี้ใช้ได้เฉพาะตัวอย่างนี้เท่านั้น
การจำลองโทรศัพท์ทำให้ย่านเสียงแคบลงและดรอปแพ็กเก็ต ภาพโดยผู้เขียน
การตรวจจับกิจกรรมเสียง (VAD) ตัดสินว่าออดิโอเป็นเสียงพูดหรือไม่ เอกสารแนะนำให้ลด vad_threshold สำหรับเสียงโทรศัพท์ที่เบา โดยเสี่ยงต่อการเกิดข้อความจากเสียงรบกวน
การลด vad_threshold ไม่เปลี่ยนแปลงอะไรบนเสียงโทรศัพท์ที่สะอาด เพราะไม่มีเสียงเบาให้กู้คืน ผลลัพธ์ว่างนี้สนับสนุนกฎหนึ่งข้อ: ลดธรณีเฉพาะเมื่อเสียงโทรศัพท์หายไป
ใช้ฟอร์มแบบแบตช์ใหม่โดยไม่ใส่ diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API ตรวจจับจำนวนแชนเนลจาก WAV หรือคอนเทนเนอร์อื่น สำหรับออดิโอดิบหลายแชนเนล ให้เพิ่ม ("channels", "3"); อินพุต WebSocket แบบหลายแชนเนลต้องระบุจำนวนแชนเนลอย่างชัดเจนด้วย
ส่งฟอร์มพร้อมไฟล์หลายแชนเนลผ่านคำขอ REST ที่แสดงก่อนหน้า แล้วอ่าน result["channels"] แต่ละรายการมีดัชนี ข้อความทรานสคริปต์ และคำที่มีเวลา ในฟิกซ์เจอร์สามแชนเนลที่ควบคุมได้ แต่ละแชนเนลมีเฉพาะผู้พูดที่กำหนดไว้ สตรีมมิงใช้การแยกแบบเดียวกันและเพิ่ม channel_index ในอีเวนต์
แนะนำให้ใช้ขาแยกเมื่อระบบโทรศัพท์มีให้ แตกต่างจากการแยกผู้พูดในส่วนเสียงโทรศัพท์ การแยกที่ทราบแน่ชัดไม่ต้องอนุมานผู้พูด
ไคลเอนต์แบบครบชุดเผยชุดการตั้งค่าเดียว จากนั้นสร้างฟอร์ม REST หรือ URL WebSocket แยกกัน การตั้งค่าร่วมครอบคลุมการแยกผู้พูด คำสำคัญ คำฟิลเลอร์ การเข้ารหัสออดิโอ และการจัดการเทิร์น; การจัดรูปแบบเป็นไปตามกฎเฉพาะทรานสปอร์ตที่กล่าวไป
ใช้การตั้งค่าท้ายสุดกับการบันทึกคุณภาพโทรศัพท์ แล้วตรวจสอบการสะกดชื่อผลิตภัณฑ์ การสลับภาษา รายละเอียดการติดต่อ และป้ายผู้พูดแยกกัน ในฟิกซ์เจอร์ที่ควบคุมได้ การตรวจข้อความผ่านทั้งหมด แต่ยังมีป้ายผู้พูดหนึ่งป้ายที่ต้องทบทวน บันทึกการตั้งค่าและการแมปผู้พูดพร้อมทรานสคริปต์แต่ละรายการ เพื่อให้การเปรียบเทียบภายหลังใช้ชุดเดียวกัน
บทเรียนถอดความเพื่อสนับสนุนจบลงที่การตรวจสุดท้าย ที่เก็บยังมีส่วนขยายเอเจนต์เสียงแยกต่างหาก ซึ่งมีการสร้างคำตอบ เอาต์พุตเสียง การขัดจังหวะ และการจัดการเสียงสะท้อน
Transcribe คงบทบาทเดิมในเดโมนั้น: สร้างข้อความ โมเดลภาษาช่วยเขียนคำตอบ และ Grok TTS พูดคำตอบออกมา
เรียนรู้ AI กับ DataCamp!
แทร็ก
แทร็ก
คอร์ส