
Cursus
Associate AI Engineer pour développeurs
26 h
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) est le modèle speech-to-text de SpaceXAI. Le chemin REST transcrit un fichier terminé, tandis que le WebSocket gère l’audio en direct.
L’annonce de Grok Voice Transcribe 2.0 de SpaceXAI met en avant les appels téléphoniques, les multiples intervenants, les identifiants, et la parole multilingue. Pour des comparaisons de benchmarks, consultez notre aperçu de Grok Voice Transcribe 2.0.
Le scénario contrôlé Qivora Sync reste identique tandis que l’audio et les réglages API varient. L’appel inclut un nom de produit inventé, des hésitations, un changement de langue, des coordonnées dictées, une pause pendant la dictée et un troisième intervenant.
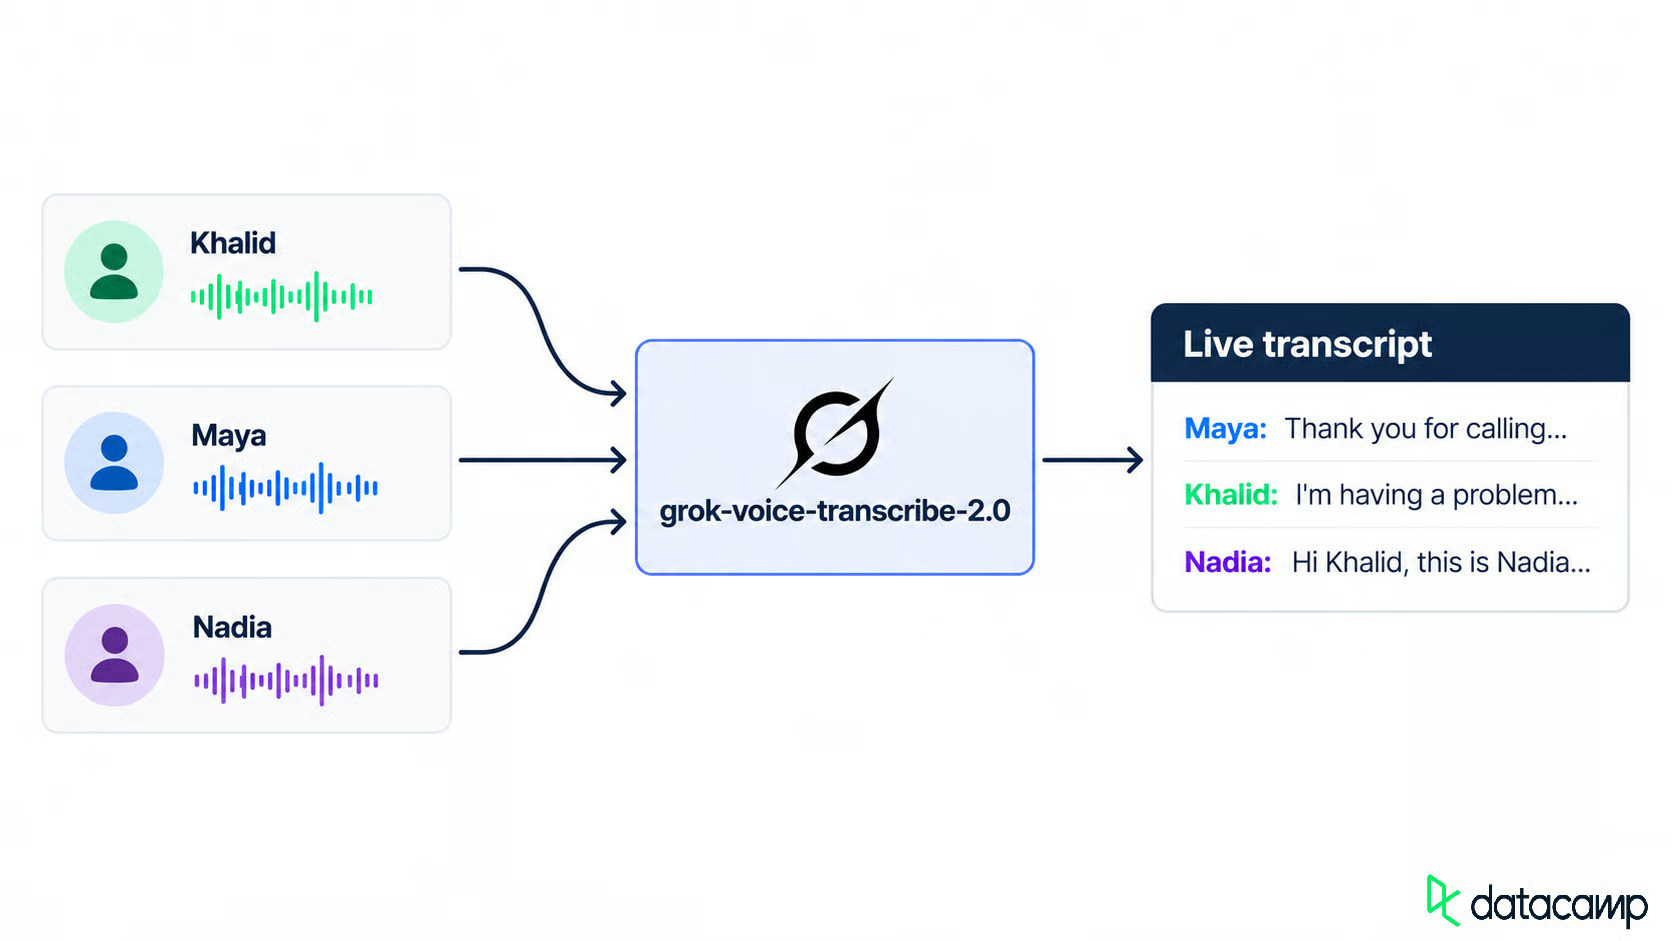
Trois intervenants deviennent un transcript en direct. Image par l’auteur.
Le scénario contrôlé utilise trois voix distinctes provenant de l’API Grok Text to Speech. Chaque segment de langue est synthétisé séparément puis assemblé avec ffmpeg pour conserver des points de bascule fixes. L’API accepte aussi language=auto ; des requêtes séparées relèvent ici d’un choix expérimental, pas d’une exigence de l’API.
Avant la première requête, définissez le texte attendu, les intervenants, l’orthographe du produit, les coordonnées, les hésitations et les pauses. Chaque configuration vise alors la même cible.
Installez les dépendances avant d’envoyer de l’audio.
Vous avez besoin de Python 3.10 ou plus récent, d’une clé API xAI, et de ffmpeg pour construire l’audio. Les clients Python utilisent requests, websockets et python-dotenv.
La documentation Speech to Text indique que la version 2.0 est la valeur par défaut si vous omettez model, et que grok-voice-transcribe-1.0 a atteint sa fin de vie le 2 octobre 2026. Je vous recommande tout de même d’épingler l’identifiant de version.
Clonez le dépôt, ajoutez votre clé dans .env, puis générez l’audio d’exemple :
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # puis collez votre clé dans .env
python project/scripts/make_fixtures.py
La commande d’installation crée le dialogue et les fichiers audio utilisés ensuite. Si vous avez votre propre enregistrement, ignorez cette commande.
Un .env écrit sous Windows peut laisser un \r dans la clé, et requests rejette l’en-tête avant que quoi que ce soit n’atteigne SpaceXAI. Supprimez ce caractère avant d’ajouter la clé à l’en-tête d’autorisation.
La référence est le modèle sans options activées, afin que chaque changement ultérieur ait un point de comparaison. La première requête envoie le fichier et un modèle épinglé :
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
La réponse contient text, la language détectée, la duration, et un tableau words horodaté. La référence REST indique une confidence par mot, mais ce champ n’est pas apparu dans les réponses batch pour ce scénario. Traitez ce champ comme optionnel et vérifiez chaque réponse d’API avant de l’utiliser. Placez les champs d’options avant file ; les champs placés après peuvent être ignorés.
La référence a supprimé les hésitations, conservé l’arabe en écriture arabe, et laissé les chiffres prononcés séparés. Elle a systématiquement mal orthographié le nom de produit inventé.
Un transcript d’assistance a besoin d’étiquettes de locuteurs, de l’orthographe correcte du produit et de coordonnées exploitables. Chaque réglage est un champ de formulaire supplémentaire :
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # un id locuteur sur chaque mot
    ("keyterm", "Qivora Sync"),  # répétez le champ pour d'autres termes
    ("language", "en"),          # requis par format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # par défaut ; true garde "euh" et "hum"
]
Ajoutez une option à la fois sur le même audio. Commencez par les étiquettes de locuteurs.
La diarisation des locuteurs attribue aux mots des ID numériques, pas des noms. Regroupez les mots consécutifs partageant le même ID pour former des tours :
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Sur un audio propre, chaque tour attendu est resté associé à un ID de locuteur cohérent. Mapper les noms par ordre d’apparition ne fonctionne que lorsque l’ordre de l’appel est déjà connu ; un système en production doit gérer sa propre correspondance des locuteurs.
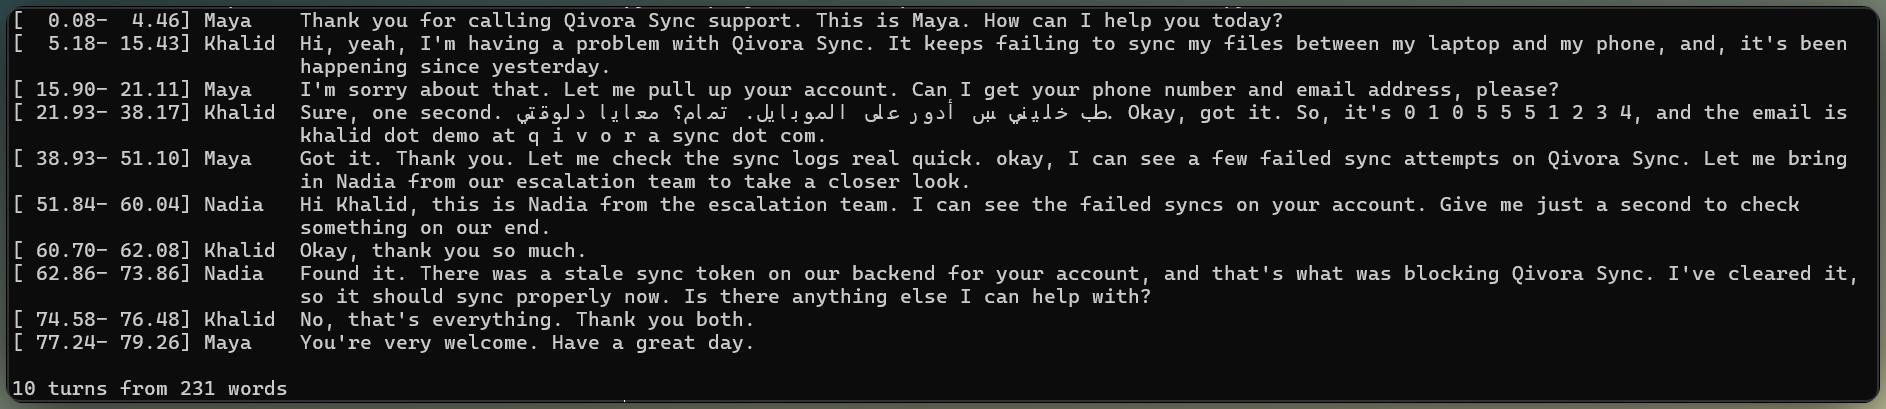
Un audio propre conserve des étiquettes de locuteurs cohérentes. Image par l’auteur.
Le biais de terme clé est un indice par requête, pas un entraînement. Passez keyterm=Qivora Sync (jusqu’à 100 termes, 50 caractères chacun), et le modèle privilégiera cette orthographe lorsque l’audio l’appuie.
Le terme clé a corrigé l’erreur d’orthographe du nom de produit de la référence sans modifier le reste du transcript.
Dans un contrôle séparé avec un locuteur en direct, un vocabulaire fortement biaisé a attiré un léger écho vers le terme clé. Cela ne signifie pas que les termes clés créent du faux texte par eux-mêmes ; cela signifie qu’un audio ambigu nécessite encore une détection d’écho.
Comme l’a montré la référence, l’arabe de Khalid est resté en écriture arabe. Le résultat a été le même avec détection automatique et avec language=en, car language sélectionne des règles de formatage plutôt que d’imposer une langue de sortie.
La référence a conservé les chiffres prononcés séparés. L’Inverse Text Normalization (ITN) convertit ces formes orales en formes écrites. format=true l’active et nécessite language, sinon la requête échoue en 400.
Le numéro de téléphone est devenu une suite continue de chiffres. L’e-mail n’a été normalisé qu’en partie : la ponctuation s’est améliorée, mais le « at » prononcé et le domaine épelé demandaient encore un nettoyage.
Ce résultat inégal est frustrant. L’ITN formate le texte ; elle ne valide pas les coordonnées. Je validerais les deux champs avant stockage.
L’ITN peut aussi réécrire des durées en quantités abrégées. Dans la réponse batch formatée de ce scénario, seul le text de haut niveau a été normalisé ; le tableau words a conservé la forme prononcée.
Comme la référence l’a montré, les hésitations sont supprimées de text et de words par défaut. filler_words=true a bien réintroduit les « euh » et « hum » de Khalid là où attendu. Désactivez-les pour des notes de support, activez-les pour un relevé verbatim en QA.
La sortie batch couvre les locuteurs, le vocabulaire, le formatage et le contrôle des hésitations. Ensuite, envoyez le même audio en flux.
Le mode streaming utilise des paramètres de requête plutôt qu’un message d’initialisation. Attendez transcript.created, envoyez de l’audio binaire brut (pas de base64), et terminez par {"type": "audio.done"}. Notre tutoriel GPT Live Transcribe suit le même schéma avec un autre modèle.
Commencez par les événements, puis connectez le client.
En batch, on utilise le format=true documenté avec language=en. La doc streaming indique que language active l’ITN, mais dans un test en direct, language=en seul n’a pas modifié le transcript. La liste des paramètres de requête WebSocket n’inclut pas format, donc ce tutoriel considère l’ITN en streaming comme un comportement à vérifier plutôt qu’à présumer.
Chaque mise à jour de transcription est un événement transcript.partial avec deux booléens. Le texte intermédiaire peut encore changer. Un bloc final (is_final=true) verrouille environ 3 secondes de texte tant que le tour reste ouvert, et un final d’énoncé (speech_final=true) clôt le tour.
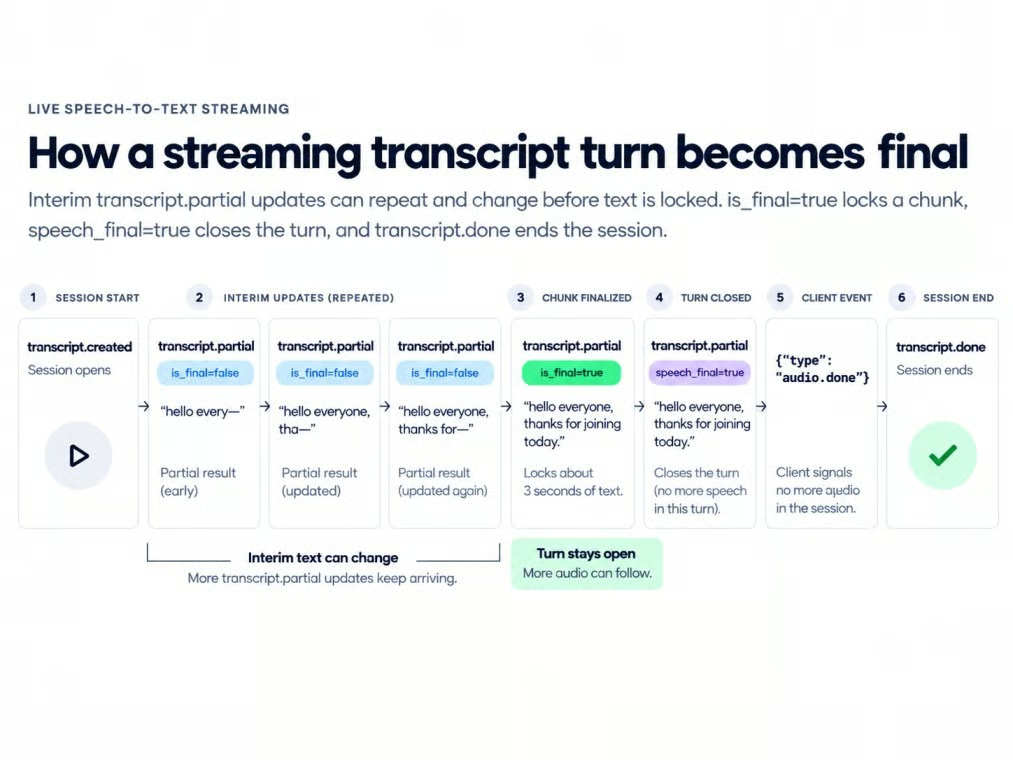
Les états de streaming mènent le texte vers la finalisation. Image par l’auteur.
Pour le streaming, rééchantillonnez d’abord la source en mono PCM 16 bits à 16 kHz. Le client central envoie des blocs de 100 millisecondes au rythme du temps réel tandis qu’une autre tâche reçoit les événements de transcript :
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Le texte intermédiaire s’est enrichi environ toutes les demi-secondes. C’est une mesure locale, pas une latence officielle.
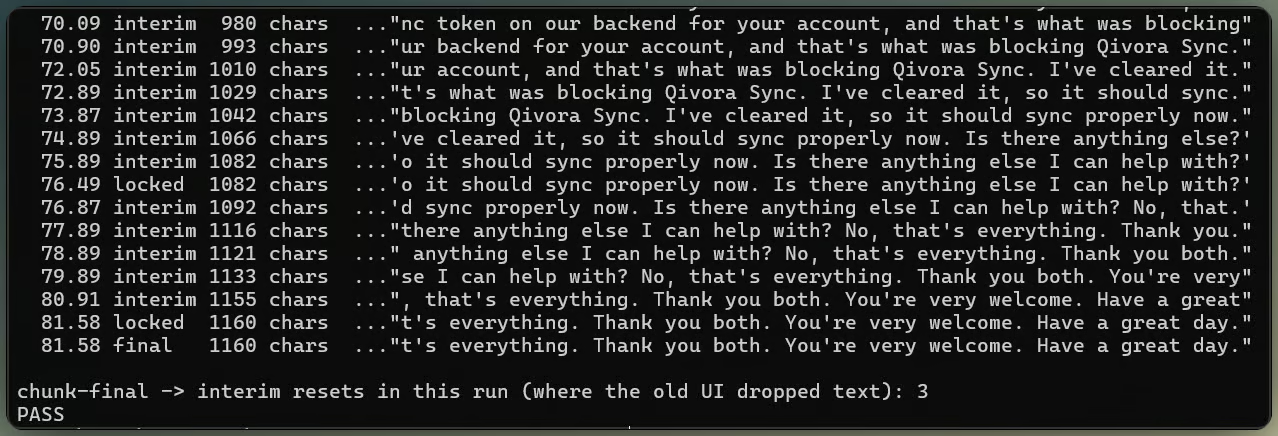
Les légendes partielles se stabilisent en transcript final. Image par l’auteur.
Les blocs finaux figent le texte sans fermer le tour. Smart Turn contrôle le moment où speech_final le clôt.
N’afficher que l’événement actif fait disparaître les mots précédents après le final du bloc, car l’intermédiaire suivant repart de l’audio entrant.
Conservez chaque bloc verrouillé, ajoutez l’intermédiaire courant, et laissez le final d’énoncé remplacer les deux.
Le texte peut grandir sans perdre les blocs précédents. Une fois l’affichage géré, les limites de tours restent le défi du streaming.
Smart Turn évalue chaque silence et estime si le locuteur a terminé. Il existe pour le numéro de Khalid : « zéro un zéro, cinq cinq cinq, [pause], un deux trois quatre », où le silence seul ne distingue pas une pause de réflexion d’une fin.
Le seuil n’est ni la confiance de transcription ni le seuil VAD. C’est la probabilité de fin de tour qu’un silence doit dépasser pour que speech_final se déclenche ; en dessous, le tour reste ouvert. Deux paramètres de requête le règlent :
params += [
    ("smart_turn", "0.7"),           # probabilité de fin de tour nécessaire pour fermer
    ("smart_turn_timeout", "3000"),  # fermer quand même après 3 s de silence
]
La doc qualifie 0,5 d’équilibré, 0,7 de conservateur pour des suites de chiffres, et 0,9 de très conservateur. Dans ce scénario, les pauses plus courtes que la fenêtre par défaut d’endpointing n’ont pas produit de décision Smart Turn utile. C’est un constat, pas une règle de temporisation documentée.
Dans le test en streaming, arrêter l’envoi d’images audio n’a pas fait avancer le minuteur de silence observé. Continuer d’envoyer un silence numérique permet à Smart Turn de clore l’énoncé.
Allonger la pause pendant la dictée du numéro rend le comportement visible. Les pauses courtes restent dans un seul tour, tandis qu’une longue pause le scinde à chaque seuil lorsque la confiance dépasse les trois réglages.
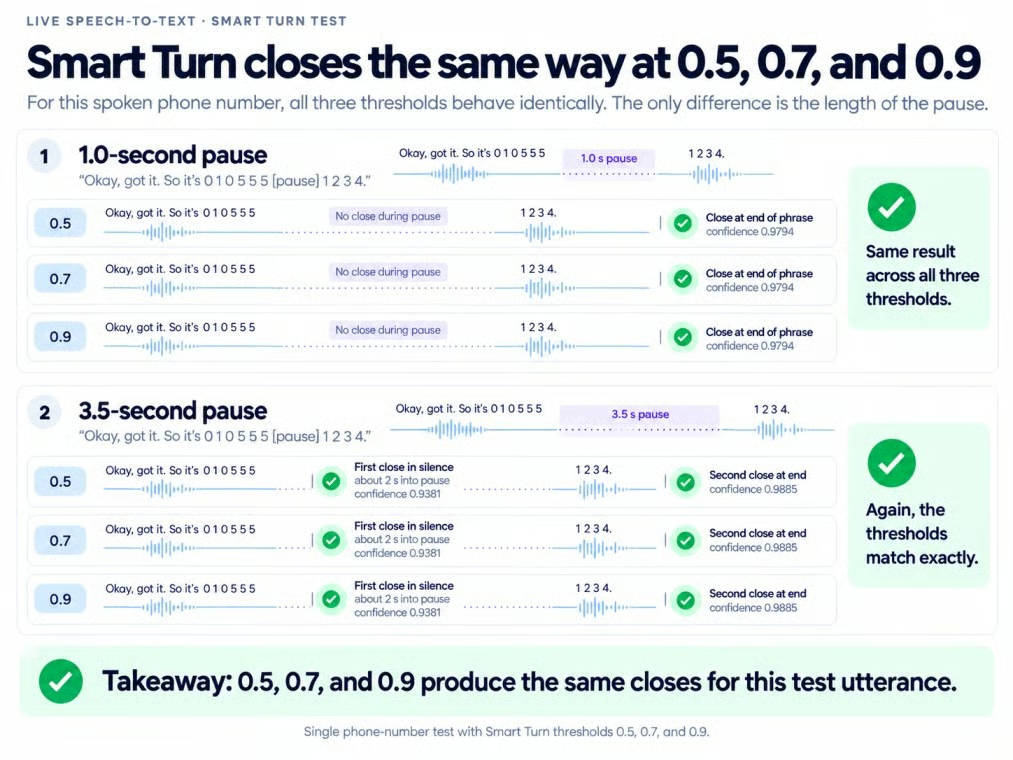
De longues pauses peuvent scinder une dictée de numéro. Image par l’auteur.
Les appelants humains sont moins prévisibles. Une courte suite de chiffres peut sembler terminée. Puis l’appelant continue.
Si Smart Turn ferme pendant une dictée de numéro, patientez un instant et fusionnez une éventuelle continuation avant de répondre.
smart_turn_timeout ferme un tour après un silence fixe, même lorsque Smart Turn hésite. Sur le flux rapide à trois intervenants, Smart Turn a regroupé plusieurs tours connus avant qu’un délai n’impose la clôture.
Si vous connaissez déjà la fin des tours, envoyez {"type": "finalize"} à chaque frontière ; sinon, associez Smart Turn à un délai.
Une fois les frontières de tours maîtrisées, le même appelant doit survivre à une ligne 8 kHz.
Ici, l’audio de qualité téléphonique est du G.711 mu-law en 8 kHz, produit à partir du même appel :
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawL’audio téléphonique brut n’a pas de conteneur, donc renseignez audio_format=mulaw et sample_rate=8000 dans le formulaire batch, ou encoding=mulaw&sample_rate=8000 sur le socket. Vérifiez séparément le texte et les étiquettes de locuteurs.
Les constats précédents sur les termes clés, le formatage et le changement de langue ont peu varié à 8 kHz.
Les étiquettes de locuteurs sont devenues moins fiables. La version téléphonique a introduit un ID de locuteur supplémentaire et attribué un tour de clôture à la mauvaise personne. Compter les segments masque ces deux erreurs.
La version dégradée limite la bande passante entre 300 et 3400 Hz, encode en mu-law 8 kHz, et supprime chaque paquet de 20 millisecondes avec une probabilité de 0,03. Une graine aléatoire fixe de 7 conserve les mêmes coupures à chaque relecture.
Cette perte de paquets n’a pas beaucoup changé le transcript anglais de cet exemple, et les coordonnées dictées sont restées dans l’ordre. Ce résultat ne vaut que pour cet exemple.
La simulation téléphonique rétrécit la bande et perd des paquets. Image par l’auteur.
La détection d’activité vocale (VAD) détermine si un segment est de la parole. La doc suggère d’abaisser vad_threshold pour une parole téléphonique faible, au risque de texte parasite dû au bruit.
L’abaissement de vad_threshold n’a rien changé sur un audio téléphonique propre, car il n’y avait pas de parole faible à récupérer. Ce résultat nul confirme une règle : ne baissez le seuil que lorsque de la parole téléphonique disparaît.
Utilisez un nouveau formulaire batch sans diarize :
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
L’API détecte le nombre de canaux à partir d’un WAV ou autre conteneur. Pour de l’audio multicanal brut, ajoutez ("channels", "3") ; l’entrée multicanale via WebSocket nécessite aussi un nombre de canaux explicite.
Envoyez le formulaire avec le fichier multicanal via la requête REST montrée plus haut, puis lisez result["channels"]. Chaque élément contient un index, le transcript texte et les mots horodatés. Dans le scénario contrôlé à trois canaux, chaque canal ne contenait que son locuteur assigné. Le streaming applique la même séparation et ajoute channel_index à ses événements.
J’utiliserais des voies séparées dès que le système téléphonique les fournit. À la différence de la diarisation sur audio téléphonique, une séparation connue n’infère pas les locuteurs.
Le client complet expose un groupe unique de réglages, puis construit séparément le formulaire REST ou l’URL WebSocket. Les réglages communs couvrent la diarisation, les termes clés, les hésitations, l’encodage audio et la gestion des tours ; le formatage suit les règles spécifiques au transport abordées plus haut.
Appliquez les réglages finaux à un enregistrement de qualité téléphonique, puis vérifiez séparément l’orthographe produit, les changements de langue, les coordonnées et les étiquettes de locuteurs. Dans le scénario contrôlé, les vérifications de texte étaient conformes tandis qu’une étiquette de locuteur nécessitait encore un contrôle. Enregistrez les réglages et la correspondance des locuteurs avec chaque transcript pour des comparaisons ultérieures cohérentes.
Le tutoriel de transcription d’assistance se termine avec cette dernière vérification. Le dépôt contient aussi une extension d’agent vocal avec réponses générées, sortie vocale, interruptions et gestion de l’écho.
Transcribe conserve le même rôle dans cette démo : il produit le texte. Un modèle de langage rédige les réponses, et Grok TTS les prononce.
Apprenez l’IA avec DataCamp !
Cursus
Cursus
Cours
Tutoriel
Tutoriel
Satyabrata Pal
15 min
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Sejal Jaiswal
24 min
Tutoriel
Moez Ali
6 min
Tutoriel
Aditya Sharma
5 min



