Lärstig
Associate AI Engineer för utvecklare
26 tim
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) är SpaceXAIs tal‑till‑text‑modell. REST‑sökvägen transkriberar en färdig fil, medan WebSocket‑sökvägen hanterar live‑ljud.
SpaceXAIs tillkännagivande av Grok Voice Transcribe 2.0 lyfter fram telefonsamtal, flera talare, inloggningsuppgifter och flerspråkigt tal. För benchmark‑jämförelser, se vår översikt av Grok Voice Transcribe 2.0.
Det kontrollerade Qivora Sync‑scenariot ligger fast medan ljud och API‑inställningar varierar. Samtalet innehåller ett påhittat produktnamn, utfyllnadsord, ett språkskifte, uppdiktade kontaktuppgifter, en paus under diktering och en tredje talare.
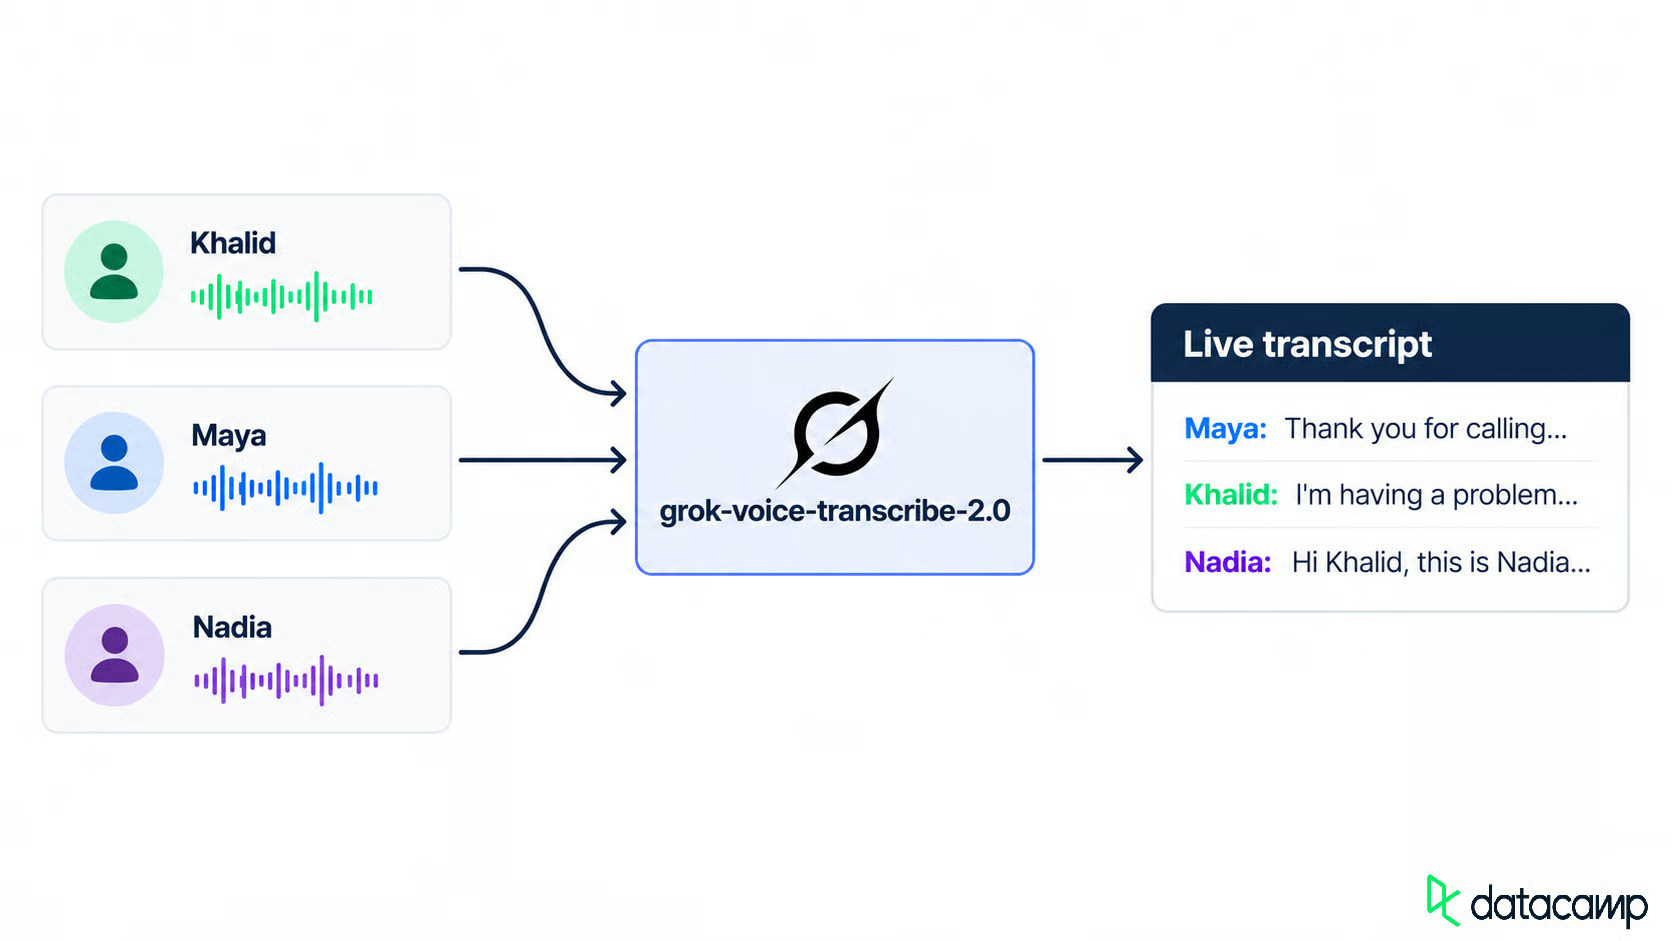
Tre talare blir en live‑transkription. Bild av författaren.
Det kontrollerade scenariot använder tre distinkta röster från Grok Text to Speech API. Varje språkavsnitt syntetiseras separat och fogas samman med ffmpeg så att skiftpunkterna ligger fast. API:et accepterar även language=auto; separata förfrågningar är ett experimentdesignval, inte ett API‑krav.
Innan första begäran, definiera den förväntade texten, talare, produktstavning, kunduppgifter, utfyllnadsord och pauser. Varje uppsättning får då samma mål.
Installera beroenden innan du skickar ljud.
Du behöver Python 3.10 eller senare, en xAI API‑nyckel och ffmpeg för att bygga ljudet. Python‑klienterna använder requests, websockets och python-dotenv.
Dokumentationen för tal till text anger att 2.0 är standard när du utelämnar model, och att grok-voice-transcribe-1.0 nådde slut på livscykeln den 2 oktober 2026. Jag skulle ändå låsa den versionsangerade ID:n.
Klona repo:t, lägg till din nyckel i .env och bygg exempelljudet:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
Setup‑kommandot skapar dialogen och ljudfilerna som används senare. Om du har en egen inspelning, hoppa över det kommandot.
En .env som skrivs på Windows kan lämna ett \r i nyckeln, och requests avvisar headern innan något når SpaceXAI. Rensa nyckeln innan du lägger till den i auktoriseringsheadern.
En baslinje är modellen med allt avstängt, så att varje senare ändring har något att jämföra med. Den första begäran skickar filen och en låst modell:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
Svaret innehåller text, detekterat language, duration och en tidsatt words array. REST‑referensen visar per‑ords‑confidence, men den dök inte upp i batchsvaren för detta scenario. Jag skulle betrakta fältet som valfritt och kontrollera varje API‑svar innan användning. Lägg valfria fält före file; senare fält kan ignoreras.
Baslinjen tog bort utfyllnadsord, behöll arabiskan i arabisk skrift och lämnade de upplästa siffrorna separata. Det påhittade produktnamnet stavades konsekvent fel.
En supporttranskription behöver talaretiketter, korrekt produktstavning och användbara kunduppgifter. Varje inställning är ytterligare ett formfält:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
Lägg till ett alternativ i taget på samma ljud. Börja med talaretiketter.
Talar‑diarisation ger ord numeriska talar‑ID:n, inte namn. Gruppera efterföljande ord med samma ID för att bygga turer:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
På rent ljud höll varje känd tur sig till ett konsekvent talar‑ID. Att mappa namn efter första förekomstens ordning fungerar bara när samtalsordningen redan är känd; produktionssystem behöver sin egen talarmappning.
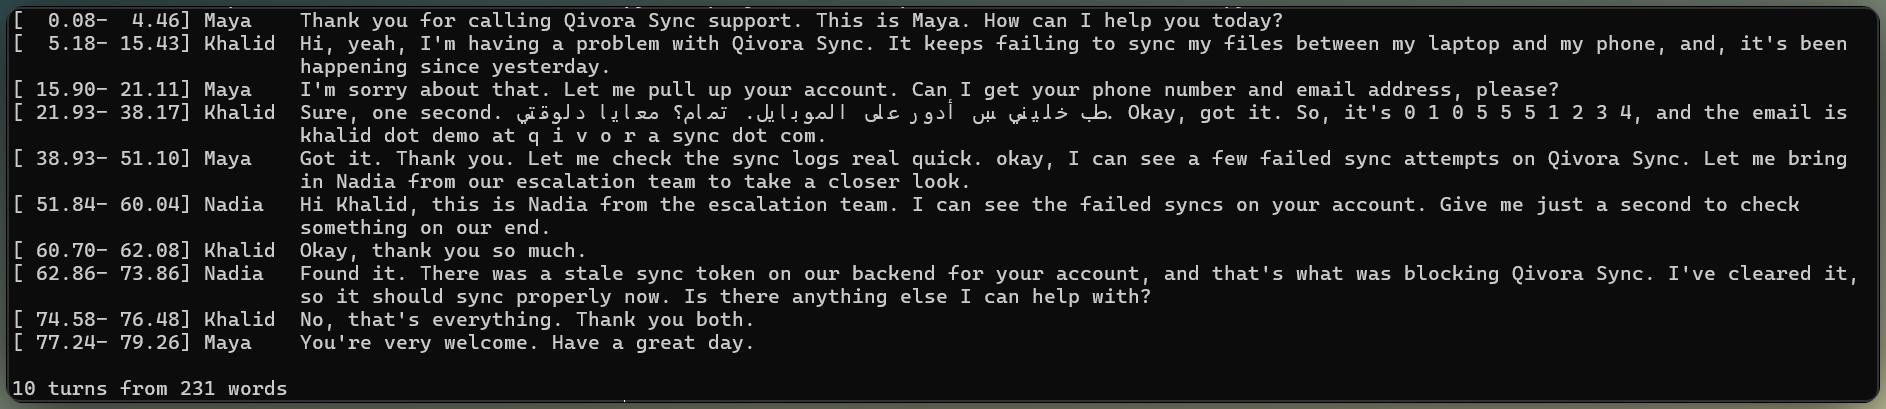
Rent ljud håller talaretiketter konsekventa. Bild av författaren.
Nyckelterms‑bias är en ledtråd per begäran, inte träning. Skicka keyterm=Qivora Sync (upp till 100 termer, 50 tecken vardera), så lutar modellen mot den stavningen när ljudet stödjer det.
Nyckeltermen rättade baslinjens fel i produktnamnet utan att ändra den omgivande transkriptionen.
I en separat live‑talartest drog starkt partisk vokabulär ett svagt eko mot nyckeltermen. Det innebär inte att nyckeltermer skapar falsk text av sig själva; det betyder att tvetydigt ljud fortfarande behöver en ekokontroll.
Som baslinjen visade förblev Khalids arabiska i arabisk skrift. Resultatet var detsamma med automatisk detektion och med language=en, eftersom language väljer formateringsregler snarare än att tvinga ett utdata‑språk.
Baslinjen behöll upplästa siffror separata. Inverse Text Normalization (ITN) gör om dessa talade former till skriftliga. format=true slår på detta och kräver language, annars misslyckas begäran med 400.
Telefonnumret blev en sammanhängande siffersträng. E‑posten normaliserades bara delvis: interpunktionen förbättrades, men det upplästa ”at” och bokstaverade domänen behövde fortfarande städas.
Det ojämna resultatet är frustrerande. ITN formaterar text; det validerar inte kontaktdata. Jag skulle validera båda fälten innan lagring.
ITN kan också skriva om vanliga tidsuttryck till förkortade enheter. I det formaterade batchsvaret för detta scenario normaliserades bara översta text; words‑arrayen behöll den talade formen.
Som baslinjen visade tas utfyllnadsord bort från text och words som standard. filler_words=true tog tillbaka Khalids ”eh” och ”öhm” där de förväntades. Ha dem av för supportanteckningar och på för en ordagrann QA‑logg.
Batchutdata täcker talare, vokabulär, formatering och kontroll av utfyllnadsord. Skicka nu samma ljud som en liveström.
Strömningsvägen använder frågeparametrar snarare än ett setup‑meddelande. Vänta på transcript.created, skicka rått binärt ljud (ingen base64) och stäng med {"type": "audio.done"}. Vår handledning om GPT Live Transcribe använder samma mönster med en annan modell.
Börja med händelserna och anslut sedan klienten.
Batch använder dokumenterade format=true med language=en. Strömningsdokumentationen säger att language slår på ITN, men i ett live‑test ändrade language=en ensamt inte transkriptionen. WebSocket‑frågelistan innehåller inte format, så denna handledning behandlar strömmande ITN som ett beteende att verifiera snarare än att förlita sig på.
Varje transkriptionsuppdatering är en transcript.partial‑händelse med två booleans. Interimtext kan fortfarande ändras. En chunk‑final (is_final=true) låser cirka 3 sekunders text medan turen är öppen, och en yttrande‑final (speech_final=true) stänger turen.
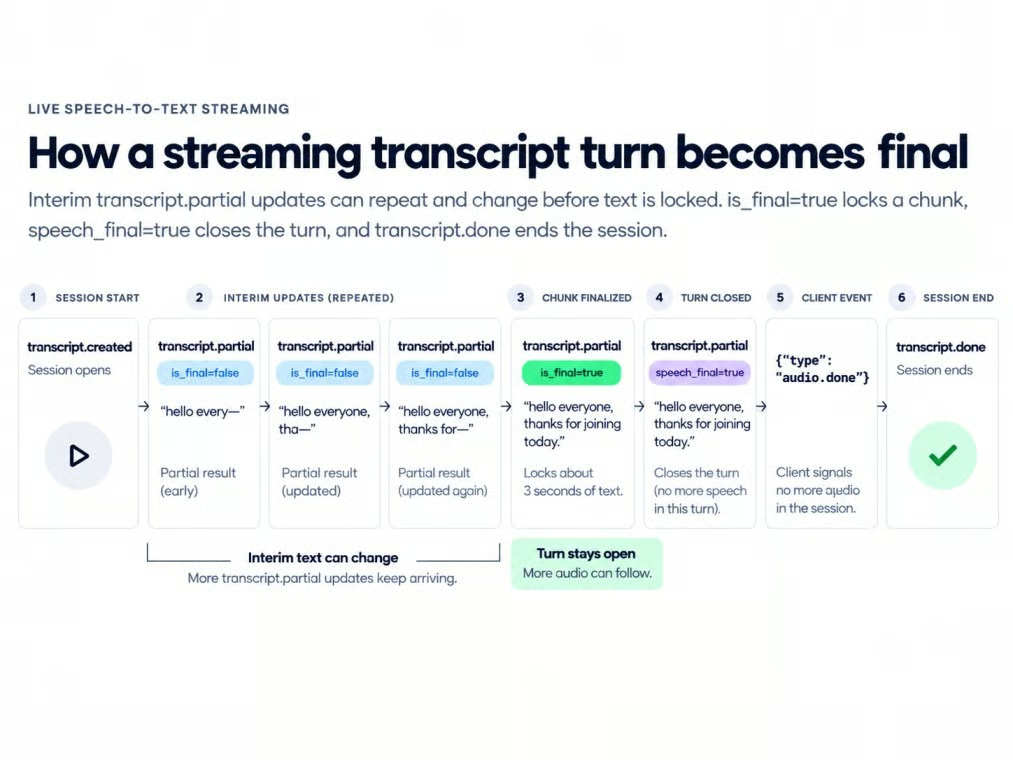
Strömningslägen för texten mot slutgiltighet. Bild av författaren.
För strömning, resampla först källan till mono 16‑bitars PCM vid 16 kHz. Kärnklienten skickar 100‑millisekunders block i realtidstakt medan en annan uppgift tar emot transkriptionshändelser:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Interimtext växte ungefär var halva sekund. Detta är en lokal mätning, inte officiell latens.
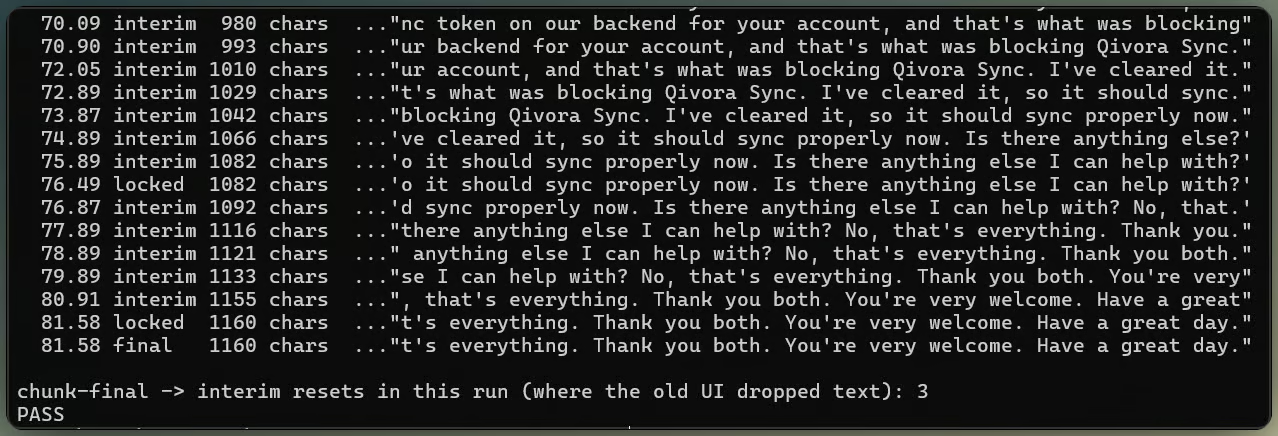
Partiella bildtexter stabiliseras till slutlig transkription. Bild av författaren.
Chunk‑finaler fryser text utan att stänga turen. Smart Turn styr när speech_final stänger den.
Att bara visa den aktiva händelsen får tidigare ord att försvinna efter varje block‑final, eftersom nästa interim börjar om från inkommande ljud.
Behåll varje låst block, lägg till nuvarande interim och låt yttrande‑finalen ersätta båda.
Texten kan växa utan att tappa tidigare block. När visningsläget är hanterat återstår gränserna mellan turer som strömningsproblem.
Smart Turn utvärderar varje tystnad och uppskattar om talaren är klar. Den finns för Khalids nummer, ”zero one zero, five five five, [paus], one two three four”, där tystnad ensam inte kan avgöra en tankepaus från ett slut.
Tröskeln är inte transkriptionssäkerhet eller VAD‑tröskeln. Det är sannolikheten för tur‑slut som en tystnad måste passera innan speech_final avfyras; under den förblir turen öppen. Två frågeparametrar sätter den:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
Dokumentationen kallar 0,5 balanserad, 0,7 konservativ för nummerserier och 0,9 mycket konservativ. I detta scenario gav pauser kortare än standardfönstret för endpointing ingen användbar Smart Turn‑bedömning. Det är ett observerat resultat, inte en dokumenterad tidsregel.
I strömningstestet fortsatte inte den observerade tystnadstimern när ljudramar stoppades. Att fortsätta skicka digital tystnad låter Smart Turn stänga yttrandet.
Att förlänga pausen under numrerdiktering gör beteendet synligt. Korta pauser stannar inom en tur, medan en lång paus delar upp den vid varje tröskel när förtroendet överstiger alla tre inställningar.
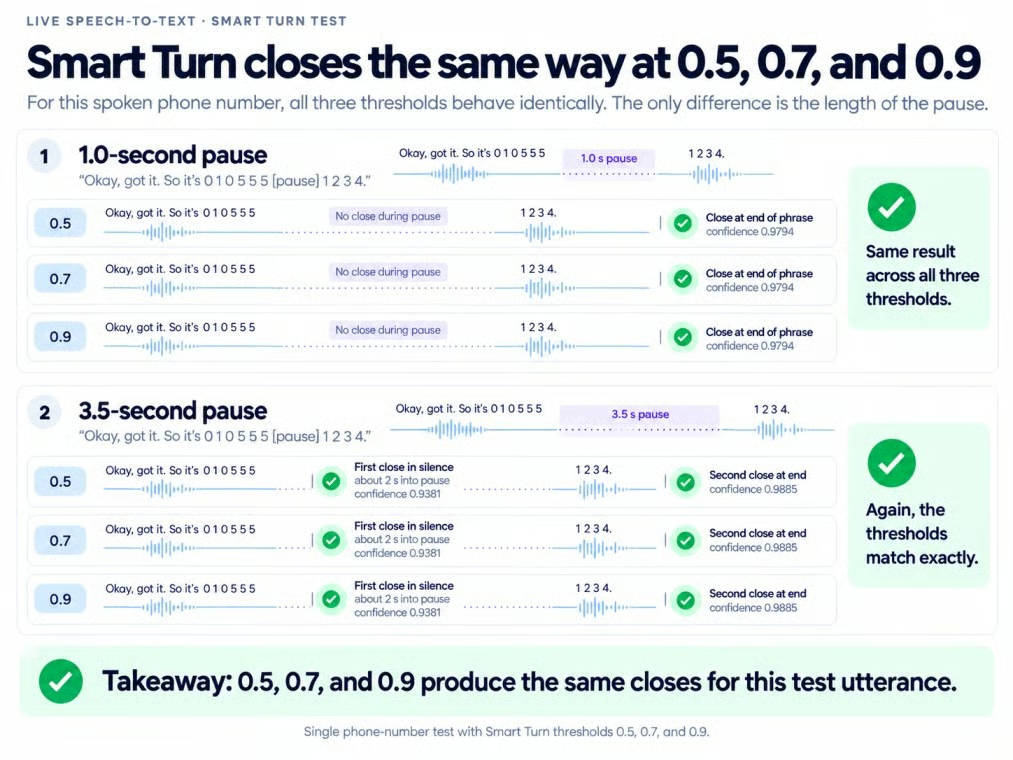
Långa pauser kan dela upp numrerdiktering. Bild av författaren.
Mänskliga uppringare är mindre förutsägbara. En kort sifferföljd kan se färdig ut. Sedan fortsätter uppringaren.
Om Smart Turn stänger under numrerdiktering, vänta kort och slå ihop en fortsättning innan du svarar.
smart_turn_timeout stänger en tur efter en fast tystnad, även när Smart Turn är osäker. På den snabba tre‑talar‑strömmen grupperade Smart Turn flera kända turer innan en timeout tvingade stängningen.
Om du redan vet var turer slutar, skicka {"type": "finalize"} vid varje gräns; annars, para ihop Smart Turn med en timeout.
När gränserna är under kontroll måste samma uppringare klara en 8 kHz‑lina.
Telefonljud här är 8 kHz G.711 mu‑law, skapat från samma samtal:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawRått telefoni‑ljud har ingen container, så ange audio_format=mulaw och sample_rate=8000 i batchformuläret, eller encoding=mulaw&sample_rate=8000 på socketen. Kontrollera text och talaretiketter separat.
De tidigare fynden om nyckeltermer, formatering och språkskifte ändrades lite vid 8 kHz.
Talaretiketter blev mindre tillförlitliga. Telefonversionen införde ett extra talar‑ID och tilldelade en avslutande tur till fel person. Att bara räkna segment döljer båda misstagen.
Den fladdriga versionen bandbegränsar samtalet till 300–3400 Hz, kodar det som 8 kHz mu‑law och tappar varje 20‑millisekunders paket med sannolikheten 0,03. Ett fast slumpfrö på 7 behåller samma luckor vid varje uppspelning.
Den paketförlusten ändrade inte den engelska transkriptionen mycket i detta exempel, och de upplästa kontaktuppgifterna förblev i ordning. Detta resultat gäller endast detta exempel.
Telefonsimulering smalnar av ljudet och tappar paket. Bild av författaren.
Voice activity detection (VAD) avgör om ljudet är tal alls. Dokumentationen föreslår att sänka vad_threshold för svagt telefon‑tal, med risk för strötext från brus.
Att sänka vad_threshold ändrade inget på rent telefonljud eftersom det inte fanns något svagt tal att återvinna. Nollresultatet stödjer en regel: sänk tröskeln bara när telefon‑tal försvinner.
Använd ett nytt batchformulär utan diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API:et detekterar kanalantal från en WAV eller annan container. För rått multikanalsljud, lägg till ("channels", "3"); WebSocket‑multikanalsinmatning kräver också ett uttryckligt kanalantal.
Skicka formuläret med multikanalsfilen via REST‑begäran som visats tidigare, läs sedan result["channels"]. Varje element innehåller ett index, transkriptionstext och tidsatta ord. I det kontrollerade trekanals‑scenariot innehöll varje kanal bara sin tilldelade talare. Strömning använder samma uppdelning och lägger till channel_index i sina händelser.
Jag skulle använda separata ben när telefonsystemet tillhandahåller dem. Till skillnad från diarisationen i avsnittet om telefonljud, drar en känd uppdelning inte slutsatser om talare.
Den kompletta klienten exponerar en grupp inställningar och bygger sedan REST‑formulär eller WebSocket‑URL separat. Delade inställningar omfattar diarisation, nyckeltermer, utfyllnadsord, ljudkodning och turhantering; formatering följer de transportspecifika regler som täckts tidigare.
Tillämpa slutinställningarna på en telefonkvalitetsinspelning och kontrollera sedan produktstavning, språkskiften, kontaktuppgifter och talaretiketter separat. I det kontrollerade scenariot klarade textkontrollerna medan en talaretikett fortfarande krävde granskning. Spara inställningar och talarmappning med varje transkription så att senare jämförelser använder samma setup.
Supporttranskriptions‑handledningen slutar med den slutliga kontrollen. Repo:t innehåller också en separat röstagent‑utbyggnad med genererade svar, uppläst utdata, avbrott och ekohantering.
Transcribe behåller samma roll i den demon: den producerar text. En språkmodell skriver svaren, och Grok TTS läser upp dem.
Lär dig AI med DataCamp!
Lärstig
Lärstig
Kurs