Ścieżka
Inżynier AI Associate dla programistów
26 godz.
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) to model zamiany mowy na tekst od SpaceXAI. Ścieżka REST transkrybuje gotowy plik, a ścieżka WebSocket obsługuje dźwięk na żywo.
W zapowiedzi Grok Voice Transcribe 2.0 SpaceXAI podkreśla połączenia telefoniczne, wielu mówców, dane uwierzytelniające i mowę wielojęzyczną. Porównania benchmarków znajdziesz w naszym przeglądzie Grok Voice Transcribe 2.0.
Kontrolowana aranżacja Qivora Sync pozostaje stała, podczas gdy zmienia się dźwięk i ustawienia API. Połączenie zawiera zmyśloną nazwę produktu, wypełniacze, przełączenie języka, mówione dane kontaktowe, pauzę w trakcie dyktowania oraz trzeciego rozmówcę.
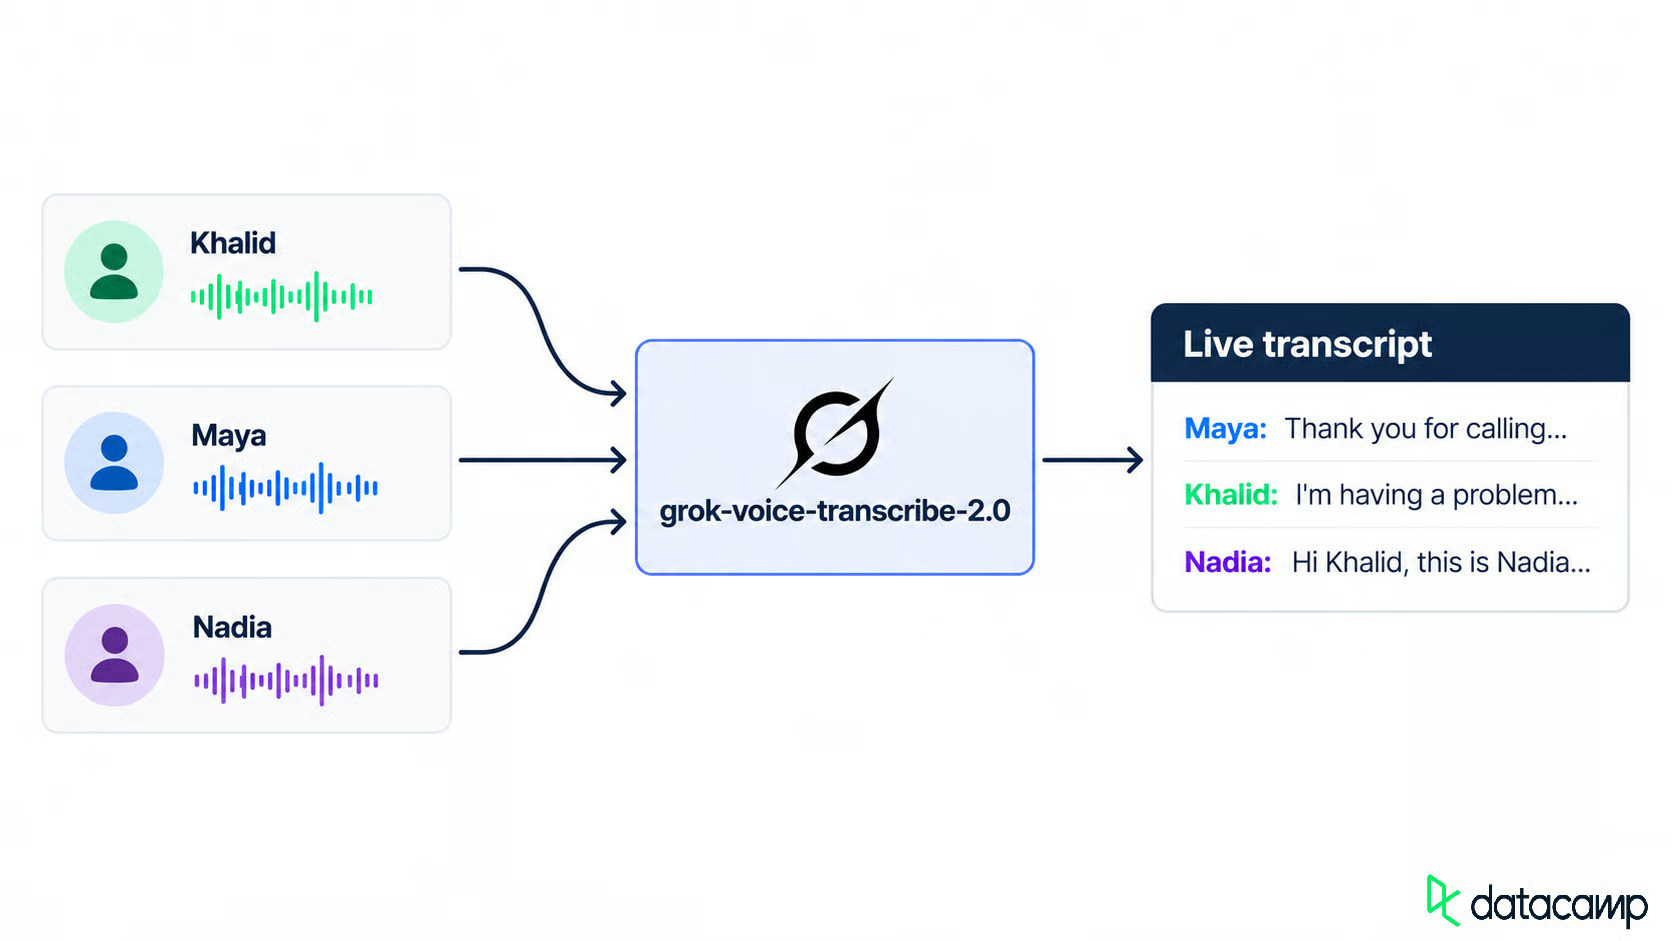
Trzech mówców zamienia się w jedną transkrypcję na żywo. Obraz: autor.
Kontrolowana aranżacja używa trzech różnych głosów z API Grok Text to Speech. Każdy segment językowy jest syntezowany osobno i łączony w ffmpeg, aby punkty przełączeń pozostały stałe. API akceptuje też language=auto; osobne żądania to wybór projektowy eksperymentu, a nie wymaganie API.
Przed pierwszym żądaniem zdefiniuj oczekiwany tekst, mówców, pisownię produktu, dane klienta, wypełniacze i pauzy. Każda konfiguracja ma wtedy ten sam cel.
Zainstaluj zależności przed wysłaniem dźwięku.
Potrzebujesz Pythona 3.10 lub nowszego, klucza API xAI i ffmpeg do budowy dźwięku. Klienci w Pythonie używają requests, websockets oraz python-dotenv.
Dokumentacja Speech to Text wskazuje, że wersja 2.0 jest domyślna, gdy pominiesz model, a grok-voice-transcribe-1.0 osiągnął koniec życia 2 października 2026 r. Mimo to przypiąłbym wersję identyfikatora.
Sklonuj repozytorium, dodaj swój klucz do .env i zbuduj przykładowy dźwięk:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
Polecenie setup tworzy dialog i pliki audio użyte później. Jeśli masz własne nagranie, pomiń to polecenie.
Plik .env zapisany w Windows może zostawić \r w kluczu, a requests odrzuci nagłówek, zanim cokolwiek dotrze do SpaceXAI. Usuń znaki z klucza przed dodaniem go do nagłówka autoryzacji.
Punkt odniesienia to model z niczym włączonym, aby każda kolejna zmiana miała z czym porównać. Pierwsze żądanie wysyła plik i przypięty model:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
Odpowiedź zawiera text, wykryty language, duration i tabelę words z czasami. Dokumentacja REST pokazuje dla każdego słowa confidence, ale w odpowiedziach wsadowych dla tej aranżacji pole się nie pojawiło. Traktowałbym je jako opcjonalne i sprawdzał każdą odpowiedź API przed użyciem. Umieszczaj pola opcji przed file; dalsze pola mogą być ignorowane.
W punkcie odniesienia usunięto wypełniacze, arabski pozostał w piśmie arabskim, a mówione cyfry były rozdzielone. Zmyślona nazwa produktu była konsekwentnie błędnie zapisana.
Transkrypcja wsparcia potrzebuje etykiet mówców, poprawnej pisowni produktu i użytecznych danych klienta. Każde ustawienie to jeszcze jedno pole formularza:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
Dodawaj jedną opcję naraz do tego samego dźwięku. Zacznij od etykiet mówców.
Diarizacja mówców nadaje słowom numeryczne identyfikatory, nie nazwy. Grupuj kolejne słowa z tym samym ID, aby budować wypowiedzi:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
Na czystym dźwięku każda znana wypowiedź zachowywała spójny identyfikator mówcy. Mapowanie nazw według kolejności pierwszego pojawienia działa tylko wtedy, gdy kolejność rozmowy jest z góry znana; systemy produkcyjne potrzebują własnego mapowania mówców.
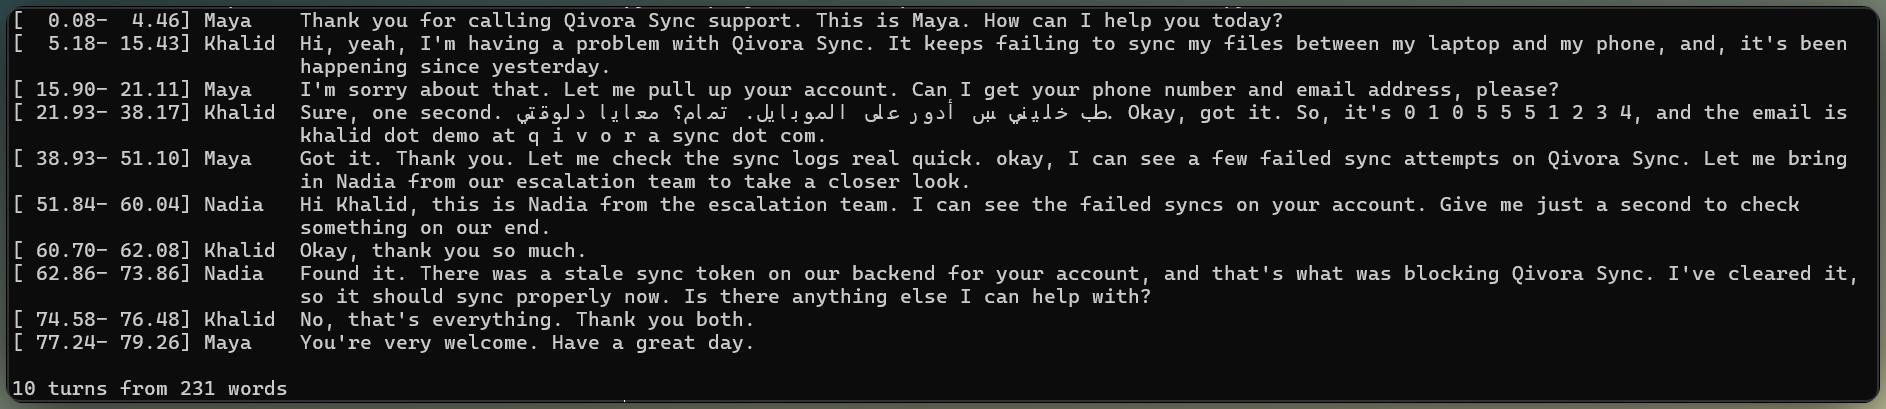
Czysty dźwięk utrzymuje spójne etykiety mówców. Obraz: autor.
Keyterm biasing to podpowiedź na żądanie, a nie trening. Przekaż keyterm=Qivora Sync (do 100 terminów, po 50 znaków), a model skłoni się ku tej pisowni, gdy audio to wspiera.
Słowo kluczowe poprawiło błąd pisowni nazwy produktu z punktu odniesienia bez zmiany otaczającej transkrypcji.
W osobnym teście mówcy na żywo silnie uprzedzone słownictwo ściągnęło słaby pogłos w stronę słowa kluczowego. To nie znaczy, że słowa kluczowe same tworzą fałszywy tekst; znaczy, że niejednoznaczne audio nadal wymaga sprawdzenia echa.
Jak pokazał punkt odniesienia, arabski Khalida pozostał w piśmie arabskim. Wynik był taki sam przy automatycznym wykrywaniu i z language=en, bo language wybiera reguły formatowania zamiast wymuszać język wyjściowy.
Punkt odniesienia zachował mówione cyfry rozdzielone. Inverse Text Normalization (ITN) zamienia te formy mówione na pisemne. format=true włącza ITN i wymaga language, inaczej żądanie zwróci 400.
Numer telefonu stał się jednym ciągiem cyfr. E-mail został tylko częściowo znormalizowany: interpunkcja się poprawiła, ale mówione „at” i literowana domena nadal wymagały czyszczenia.
Ten nierówny wynik jest frustrujący. ITN formatuje tekst; nie weryfikuje danych kontaktowych. Zweryfikowałbym oba pola przed zapisaniem.
ITN może też przepisywać zwykłe frazy czasu trwania na skrócone ilości. W sformatowanej odpowiedzi wsadowej dla tej aranżacji znormalizowany był tylko text najwyższego poziomu; tablica words zachowała formę mówioną.
Jak pokazał punkt odniesienia, wypełniacze są domyślnie usuwane z text i words. filler_words=true przywróciło „uh” i „um” Khalida tam, gdzie się ich spodziewano. Zostaw je wyłączone do notatek wsparcia i włączone do dosłownego zapisu QA.
Wyjście wsadowe obejmuje mówców, słownictwo, formatowanie i kontrolę wypełniaczy. Teraz wyślij ten sam dźwięk jako strumień na żywo.
Ścieżka strumieniowa używa parametrów zapytania zamiast wiadomości inicjalizującej. Poczekaj na transcript.created, wysyłaj surowy binarny dźwięk (bez base64) i zamknij {"type": "audio.done"}. Nasz samouczek GPT Live Transcribe używa tego samego schematu z innym modelem.
Zacznij od zdarzeń, potem podłącz klienta.
Wsad używa udokumentowanego format=true z language=en. Dokumentacja strumieniowania mówi, że language włącza ITN, ale w teście na żywo samo language=en nie zmieniło transkrypcji. Lista zapytań WebSocket nie zawiera format, więc ten samouczek traktuje strumieniowe ITN jako zachowanie do weryfikacji, a nie jako pewnik.
Każda aktualizacja transkrypcji to zdarzenie transcript.partial z dwiema wartościami bool. Tekst przejściowy może się jeszcze zmieniać. Finalizacja fragmentu (is_final=true) blokuje ok. 3 sekundy tekstu, gdy wypowiedź pozostaje otwarta, a finalizacja wypowiedzi (speech_final=true) zamyka ją.
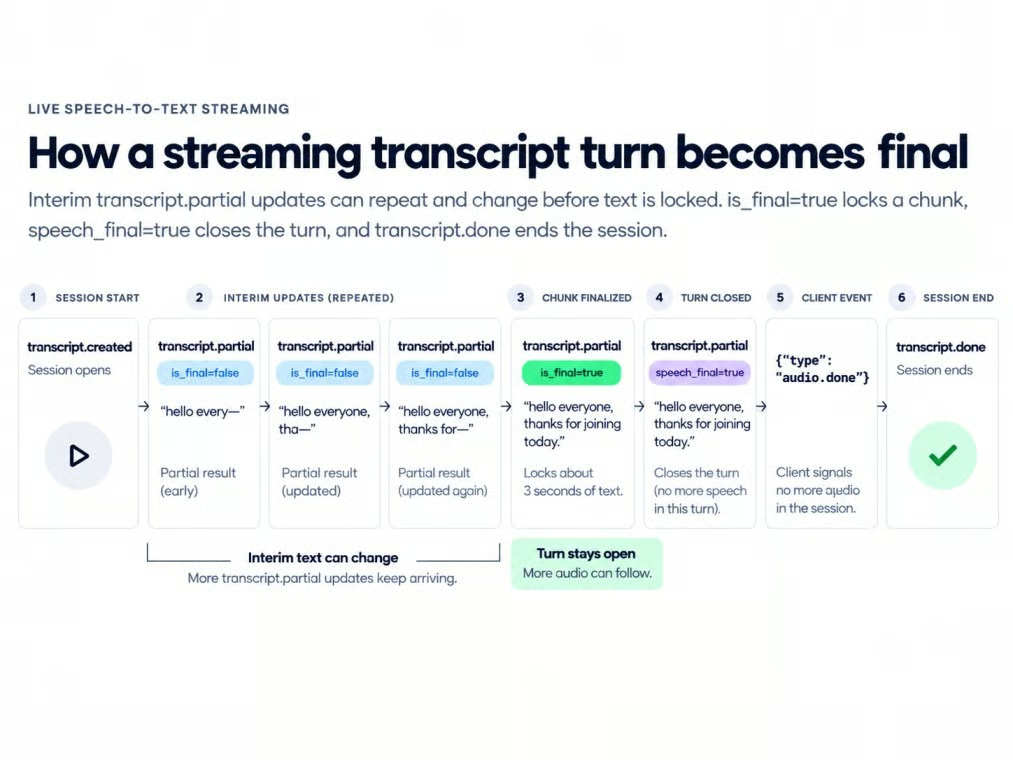
Stany strumieniowania prowadzą tekst do finalizacji. Obraz: autor.
Do strumieniowania najpierw przeresampluj źródło do mono 16-bit PCM 16 kHz. Klient rdzeniowy wysyła 100-milisekundowe fragmenty w tempie rzeczywistym, podczas gdy inne zadanie odbiera zdarzenia transkryptu:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Tekst przejściowy przyrastał mniej więcej co pół sekundy. To lokalny pomiar, nie oficjalna latencja.
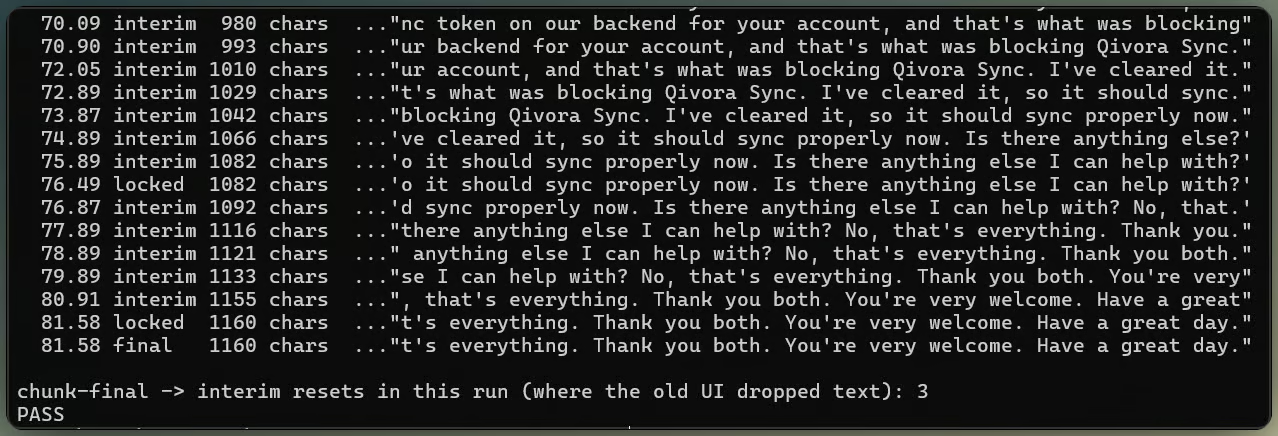
Częściowe podpisy stabilizują się w finalny transkrypt. Obraz: autor.
Finalizacje fragmentów zamrażają tekst bez zamykania wypowiedzi. Smart Turn decyduje, kiedy speech_final ją zamyka.
Pokazywanie tylko aktywnego zdarzenia sprawia, że wcześniejsze słowa znikają po każdym finalu fragmentu, ponieważ kolejny interim zaczyna od nowa od przychodzącego dźwięku.
Zachowuj każdy zablokowany fragment, dołącz obecny interim, a finalizacja wypowiedzi niech zastąpi oba.
Tekst może rosnąć bez utraty wcześniejszych fragmentów. Gdy stan wyświetlania jest opanowany, granice wypowiedzi pozostają problemem strumieniowym.
Smart Turn ocenia każdą ciszę i szacuje, czy mówca skończył. Powstało na potrzeby numeru Khalida: „zero one zero, five five five, [pauza], one two three four”, gdzie sama cisza nie odróżnia pauzy na zastanowienie od końca.
Próg to nie ufność transkrypcji ani próg VAD. To prawdopodobieństwo końca wypowiedzi, które cisza musi przekroczyć, zanim speech_final zadziała; poniżej progu wypowiedź pozostaje otwarta. Dwa parametry zapytania go ustawiają:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
Dokumentacja nazywa 0,5 wartością zbalansowaną, 0,7 zachowawczą dla sekwencji numerów i 0,9 bardzo zachowawczą. W tej aranżacji pauzy krótsze niż domyślne okno endpointing nie dawały użytecznej decyzji Smart Turn. To wynik obserwowany, nie udokumentowana reguła czasowa.
W teście strumieniowym zatrzymanie ramek audio nie zwiększało obserwowanego licznika ciszy. Kontynuowanie wysyłania cyfrowej ciszy pozwala Smart Turn zamknąć wypowiedź.
Wydłużenie pauzy podczas dyktowania numeru uwidacznia to zachowanie. Krótkie pauzy pozostają w jednej wypowiedzi, a długa pauza dzieli ją przy każdym progu, gdy ufność przekracza wszystkie trzy ustawienia.
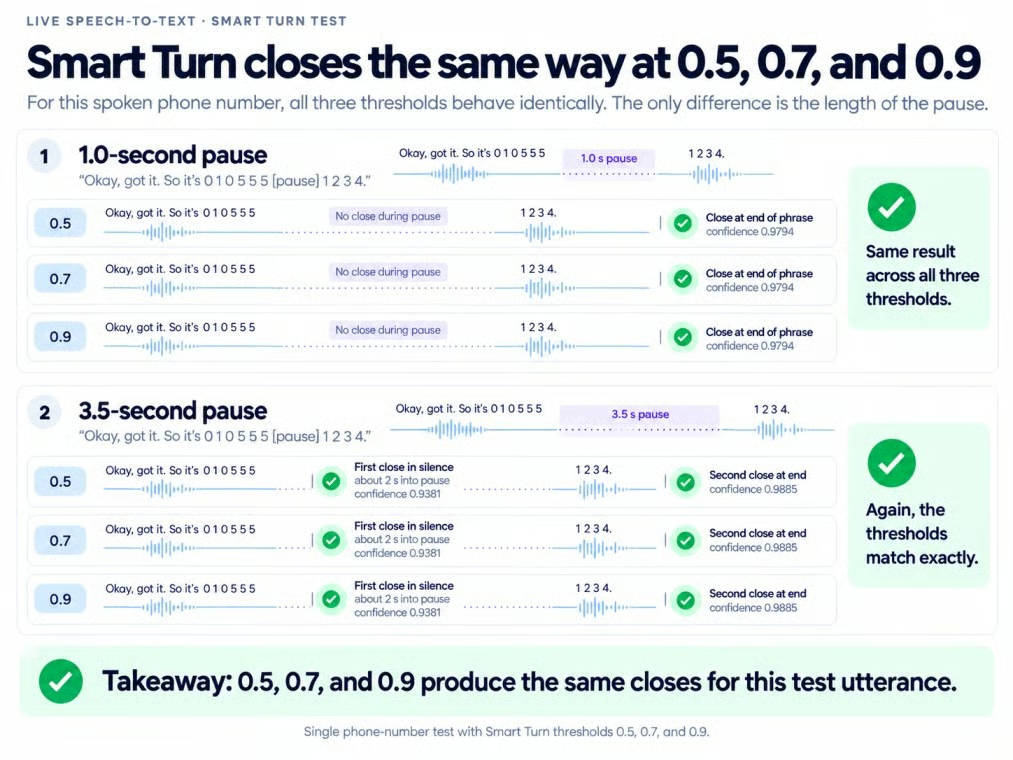
Długie pauzy mogą podzielić dyktowanie numeru. Obraz: autor.
Ludzkie rozmowy są mniej przewidywalne. Krótka sekwencja cyfr może wyglądać na zakończoną. Potem dzwoniący ciągnie dalej.
Jeśli Smart Turn zamknie wypowiedź podczas dyktowania numeru, poczekaj chwilę i połącz kontynuację przed odpowiedzią.
smart_turn_timeout zamyka wypowiedź po stałej ciszy, nawet gdy Smart Turn nie jest pewny. W szybkim strumieniu trzech mówców Smart Turn pogrupował kilka znanych wypowiedzi, zanim limit czasu wymusił zamknięcie.
Jeśli już wiesz, gdzie kończą się wypowiedzi, wysyłaj {"type": "finalize"} na każdej granicy; w przeciwnym razie połącz Smart Turn z limitem czasu.
Gdy granice wypowiedzi są pod kontrolą, ten sam rozmówca musi przetrwać linię 8 kHz.
Jakość telefoniczna tutaj to 8 kHz G.711 mu-law, zrobiona z tego samego połączenia:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawSurowe audio telefoniczne nie ma kontenera, więc ustaw audio_format=mulaw i sample_rate=8000 w formularzu wsadowym, albo encoding=mulaw&sample_rate=8000 na gnieździe. Sprawdzaj tekst i etykiety mówców osobno.
Wcześniejsze obserwacje dotyczące słowa kluczowego, formatowania i przełączania języka niewiele się zmieniły przy 8 kHz.
Etykiety mówców stały się mniej wiarygodne. Wersja telefoniczna wprowadziła dodatkowy identyfikator mówcy i przypisała zamykającą wypowiedź złej osobie. Samo liczenie segmentów ukrywa oba błędy.
„Flaky” wersja ogranicza pasmo połączenia do 300–3400 Hz, koduje jako 8 kHz mu-law i upuszcza każdy 20-milisekundowy pakiet z prawdopodobieństwem 0,03. Stałe ziarno losowe 7 utrzymuje te same luki przy każdym odtworzeniu.
Ten ubytek pakietów niewiele zmienił angielską transkrypcję w tej próbce, a mówione dane kontaktowe pozostały w kolejności. Ten wynik dotyczy tylko tej próbki.
Symulacja telefonu zawęża pasmo audio i gubi pakiety. Obraz: autor.
Detekcja aktywności głosu (VAD) decyduje, czy dźwięk to w ogóle mowa. Dokumentacja sugeruje obniżenie vad_threshold dla cichej mowy telefonicznej, kosztem zbędnego tekstu z szumu.
Obniżenie vad_threshold nic nie zmieniło na czystym dźwięku telefonicznym, bo nie było cichej mowy do odzyskania. Ten zerowy wynik wspiera jedną zasadę: obniżaj próg tylko wtedy, gdy mowa telefoniczna znika.
Użyj świeżego formularza wsadowego bez diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API wykrywa liczbę kanałów z pliku WAV lub innego kontenera. Dla surowego audio wielokanałowego dodaj ("channels", "3"); wejście wielokanałowe WebSocket także wymaga jawnej liczby kanałów.
Wyślij formularz z plikiem wielokanałowym przez wcześniejsze żądanie REST, a potem odczytaj result["channels"]. Każda pozycja zawiera indeks, tekst transkrypcji i słowa z czasami. W kontrolowanej aranżacji trzykanałowej każdy kanał zawierał tylko przypisanego mówcę. Strumieniowanie używa tego samego podziału i dodaje channel_index do swoich zdarzeń.
Używałbym oddzielnych ścieżek, gdy system telefoniczny je zapewnia. W przeciwieństwie do diarizacji w sekcji telefonicznej, znany podział nie wnioskuje mówców.
Kompletny klient udostępnia jedną grupę ustawień, a następnie osobno buduje formularz REST lub URL WebSocket. Wspólne ustawienia obejmują diarizację, słowa kluczowe, wypełniacze, kodowanie audio i obsługę granic wypowiedzi; formatowanie podąża za zasadami specyficznymi dla transportu omówionymi wcześniej.
Zastosuj finalne ustawienia do nagrania w jakości telefonicznej, a następnie osobno sprawdź pisownię produktu, przełączenia języka, dane kontaktowe i etykiety mówców. W kontrolowanej aranżacji testy tekstu przeszły, podczas gdy jedna etykieta mówcy nadal wymagała przeglądu. Zapisz ustawienia i mapowanie mówców z każdą transkrypcją, aby późniejsze porównania używały tej samej konfiguracji.
Samouczek transkrypcji wsparcia kończy się na tym finalnym sprawdzeniu. Repozytorium zawiera też osobne rozszerzenie agenta głosowego z generowanymi odpowiedziami, mową na wyjściu, przerywaniem i obsługą pogłosów.
Transcribe zachowuje tę samą rolę w tym demie: produkuje tekst. Model językowy pisze odpowiedzi, a Grok TTS je czyta.
Ucz się AI z DataCamp!
Ścieżka
Ścieżka
Kurs