Трек
Ассоциированный AI-инженер для разработчиков
26 ч
Grok Voice Transcribe 2.0 (grok-voice-transcribe-2.0) — это модель преобразования речи в текст от SpaceXAI. Путь REST транскрибирует готовый файл, а путь WebSocket обрабатывает живое аудио.
В анонсе Grok Voice Transcribe 2.0 от SpaceXAI выделены телефонные звонки, несколько говорящих, учетные данные и многоязычная речь. Сравнение бенчмарков см. в нашем обзоре Grok Voice Transcribe 2.0.
Контролируемый стенд Qivora Sync остаётся неизменным, а аудио и настройки API меняются. В звонке есть выдуманное имя продукта, слова‑паразиты, языковой переключатель, продиктованные контакты, пауза во время диктовки и третий говорящий.
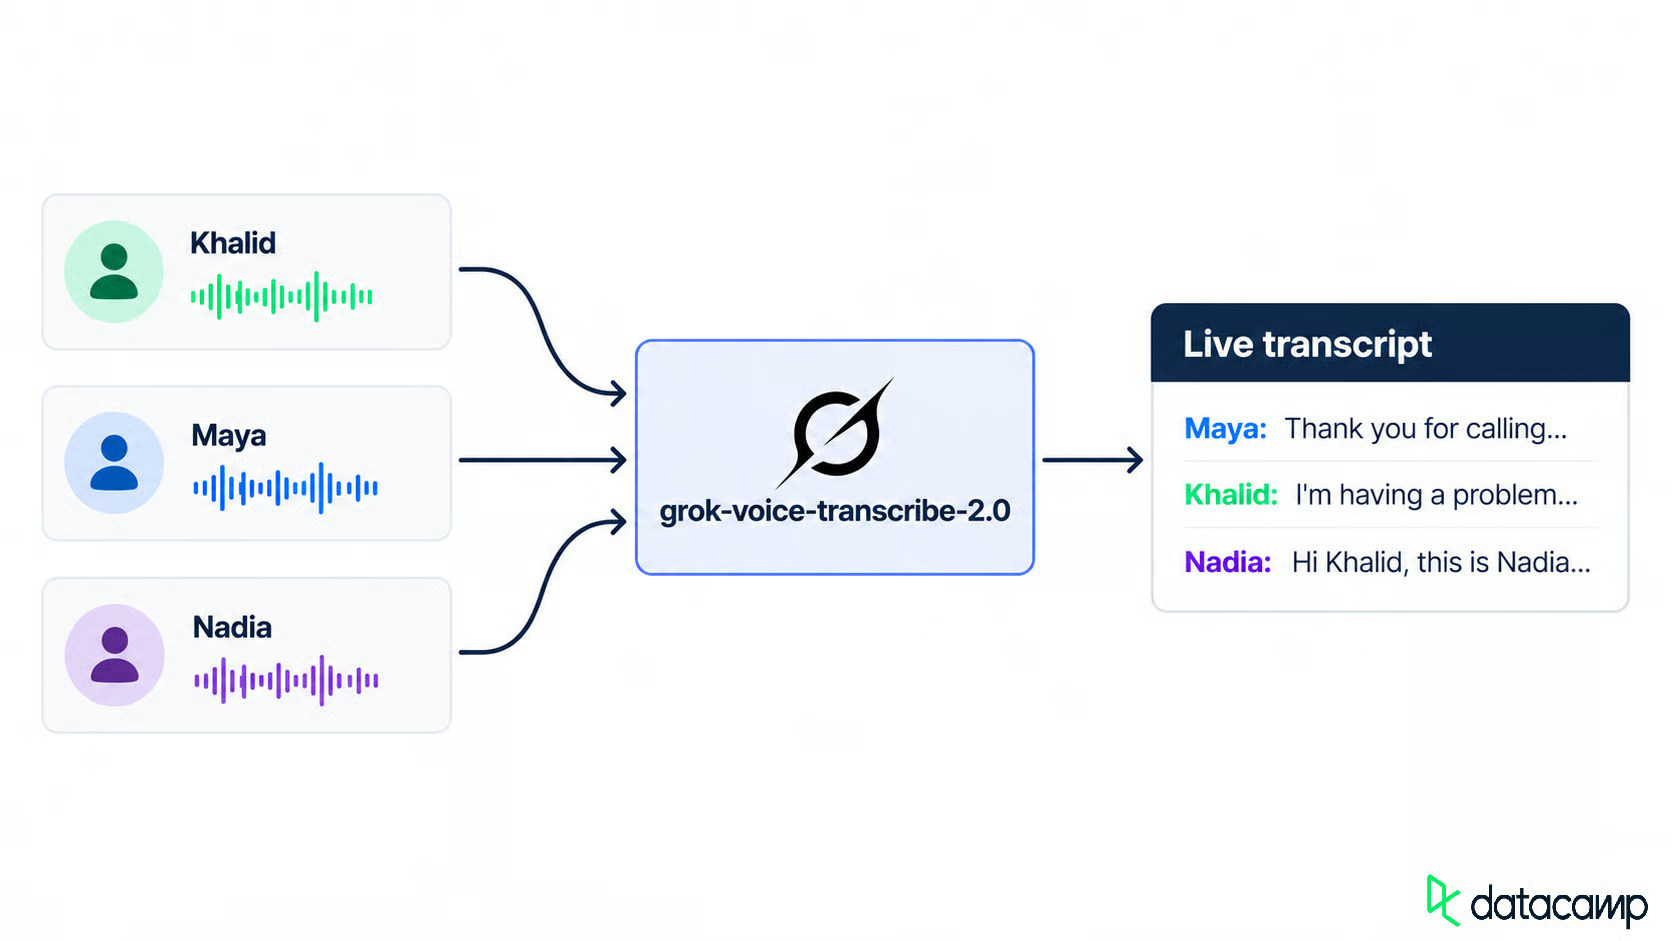
Три говорящих превращаются в одну живую транскрипцию. Изображение автора.
Контролируемый стенд использует три разных голоса из Grok Text to Speech API. Каждый языковой фрагмент синтезируется отдельно и соединяется с помощью ffmpeg, чтобы точки переключения оставались фиксированными. API также принимает language=auto; отдельные запросы — это выбор планирования эксперимента, а не требование API.
До первого запроса задайте ожидаемый текст, говорящих, написание продукта, данные клиента, слова‑паразиты и паузы. Тогда у каждой конфигурации будет одна и та же цель.
Установите зависимости перед отправкой аудио.
Вам понадобится Python 3.10 или новее, API‑ключ xAI и ffmpeg для сборки аудио. Python‑клиенты используют requests, websockets и python-dotenv.
Документация по Speech to Text сообщает, что версия 2.0 используется по умолчанию, если опустить model, а grok-voice-transcribe-1.0 достиг конца жизненного цикла 2 октября 2026 года. Тем не менее версию я бы закрепил явным ID.
Клонируйте репозиторий, добавьте ключ в .env и соберите образцы аудио:
git clone https://github.com/KhalidAbdelaty/grok-voice-transcribe-2.0.git
cd grok-voice-transcribe-2.0
pip install -r requirements.txt
cp .env.example .env    # then paste your key into .env
python project/scripts/make_fixtures.py
Команда настройки создаст диалоги и аудиофайлы, используемые далее. Если у вас есть собственная запись, этот шаг можно пропустить.
Файл .env, записанный в Windows, может оставить \r в конце ключа, и requests отклонит заголовок прежде, чем что‑либо дойдёт до SpaceXAI. Уберите лишние символы из ключа перед добавлением в заголовок авторизации.
Базовый ориентир — это модель без включённых опций, чтобы каждому последующему изменению было с чем сравнить. Первый запрос отправляет файл и закреплённую модель:
import os
import requests
from dotenv import load_dotenv

load_dotenv()
api_key = os.environ["XAI_API_KEY"].strip()

with open("support_call.wav", "rb") as audio_file:
    response = requests.post(
        "https://api.x.ai/v1/stt",
        headers={"Authorization": f"Bearer {api_key}"},
        data=[("model", "grok-voice-transcribe-2.0")],
        files={"file": ("support_call.wav", audio_file, "audio/wav")},
    )

response.raise_for_status()
result = response.json()
Ответ содержит text, определённый language, duration и массив words с пометками времени. В справочнике REST указано поле confidence для каждого слова, но в пакетных ответах для этого стенда оно не появлялось. Относитесь к полю как к необязательному и проверяйте каждый ответ API перед использованием. Размещайте опциональные поля перед file; поля после могут быть проигнорированы.
Базовый ответ убрал слова‑паразиты, сохранил арабский — арабским письмом, а произнесённые цифры — раздельно. Последовательно ошибался в написании выдуманного названия продукта.
Транскрипт звонка поддержке нуждается в метках спикеров, корректном написании продукта и пригодных для работы контактах. Каждая настройка — это ещё одно поле формы:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("diarize", "true"),         # a speaker id on every word
    ("keyterm", "Qivora Sync"),  # repeat the field for more terms
    ("language", "en"),          # required by format
    ("format", "true"),          # inverse text normalization
    ("filler_words", "false"),   # the default; true keeps "uh" and "um"
]
Добавляйте по одной опции за раз к одному и тому же аудио. Начните с меток спикеров.
Диаризация присваивает словам числовые ID говорящих, а не имена. Группируйте подряд идущие слова с одним и тем же ID, чтобы собрать реплики:
def group_turns(words):
    turns = []
    for word in words:
        if turns and turns[-1]["speaker"] == word.get("speaker"):
            turns[-1]["words"].append(word["text"])
            turns[-1]["end"] = word["end"]
        else:
            turns.append({"speaker": word.get("speaker"), "start": word["start"],
                          "end": word["end"], "words": [word["text"]]})
    for turn in turns:
        turn["text"] = " ".join(turn.pop("words"))
    return turns
На чистом аудио каждая известная реплика оставалась с неизменным ID говорящего. Привязка имён по порядку первого появления работает только тогда, когда порядок реплик уже известен; в продакшене потребуется собственное сопоставление говорящих.
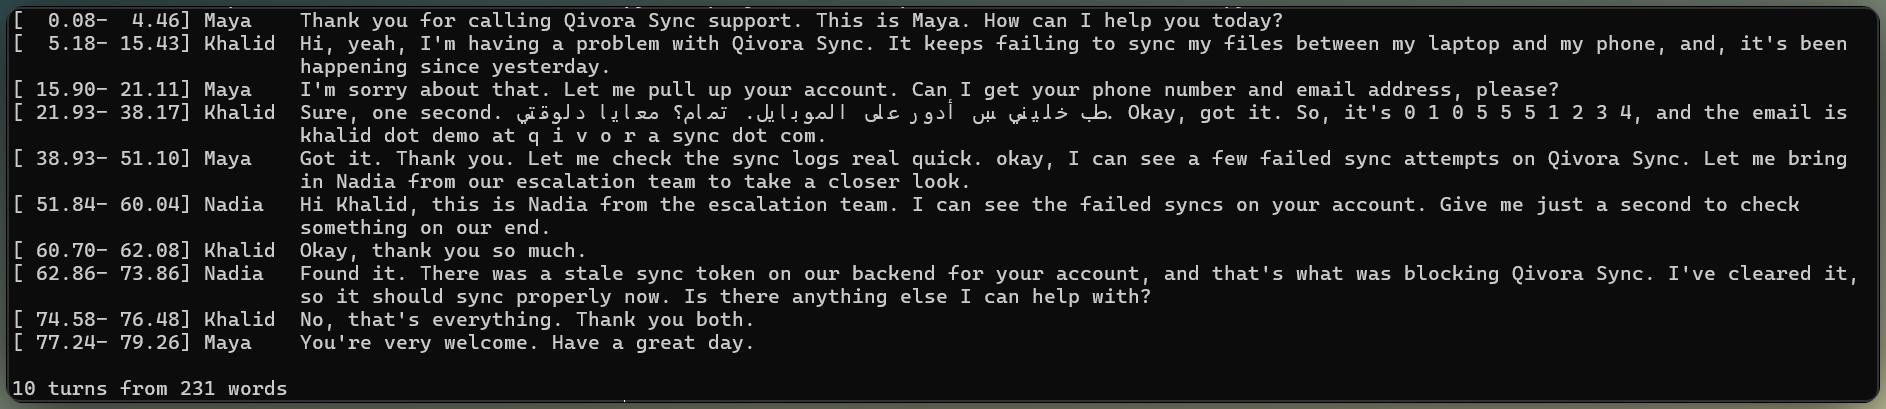
Чистое аудио сохраняет стабильные метки говорящих. Изображение автора.
Смещение по ключевым терминам — это подсказка для конкретного запроса, а не обучение. Передайте keyterm=Qivora Sync (до 100 терминов по 50 символов), и модель склонится к этому написанию, если аудио его поддерживает.
Ключевой термин исправил ошибку базового варианта в названии продукта без изменений в окружающем тексте.
В отдельной проверке с живым спикером сильно смещённый словарь потянул слабое эхо к ключевому термину. Это не значит, что ключевые термины сами по себе порождают ложный текст; это значит, что неоднозначное аудио всё ещё требует проверки на эхо.
Как показал базовый вариант, арабская речь Халида осталась арабским письмом. Результат был тем же и при автоматическом определении, и при language=en, потому что language задаёт правила форматирования, а не принудительно выбирает язык вывода.
Базовый вариант оставил цифры раздельно. Инверсная текстовая нормализация (ITN) превращает устные формы в письменные. format=true включает её и требует language, иначе запрос завершится 400.
Номер телефона стал одной непрерывной последовательностью цифр. Email был нормализован лишь частично: пунктуация улучшилась, но произнесённое «at» и продиктованный домен всё ещё потребовали ручной правки.
Такой неравномерный результат неприятен. ITN форматирует текст; она не валидирует контактные данные. Оба поля лучше валидировать перед сохранением.
ITN также может переписывать обычные фразы длительности в сокращённые количества. В отформатированном пакетном ответе для этого стенда нормализован был только верхнеуровневый text; массив words сохранил устную форму.
Как показал базовый вариант, слова‑паразиты по умолчанию удаляются из text и words. filler_words=true вернул «uh» и «um» Халида там, где ожидается. Оставляйте их выключенными для рабочих заметок и включайте для дословной записи QA.
Пакетный вывод покрывает говорящих, словарь, форматирование и контроль слов‑паразитов. Далее отправим то же аудио как поток.
Потоковый путь использует параметры запроса вместо сообщения инициализации. Дождитесь transcript.created, отправляйте сырое двоичное аудио (не base64) и закрывайте {"type": "audio.done"}. Наш учебник GPT Live Transcribe использует тот же шаблон с другой моделью.
Начните с событий, затем подключите клиента.
В пакетном режиме используется документированное format=true вместе с language=en. В потоковой документации сказано, что language включает ITN, но в пробном запуске language=en само по себе не изменило транскрипт. В списке параметров WebSocket нет format, поэтому в этом учебнике ITN в потоковом режиме рассматривается как поведение, которое следует проверять, а не полагаться на него.
Каждое обновление транскрипции — это событие transcript.partial с двумя булевыми флагами. Промежуточный текст ещё может меняться. Финализация фрагмента (is_final=true) «замораживает» около 3 секунд текста, пока реплика открыта, а финализация высказывания (speech_final=true) закрывает реплику.
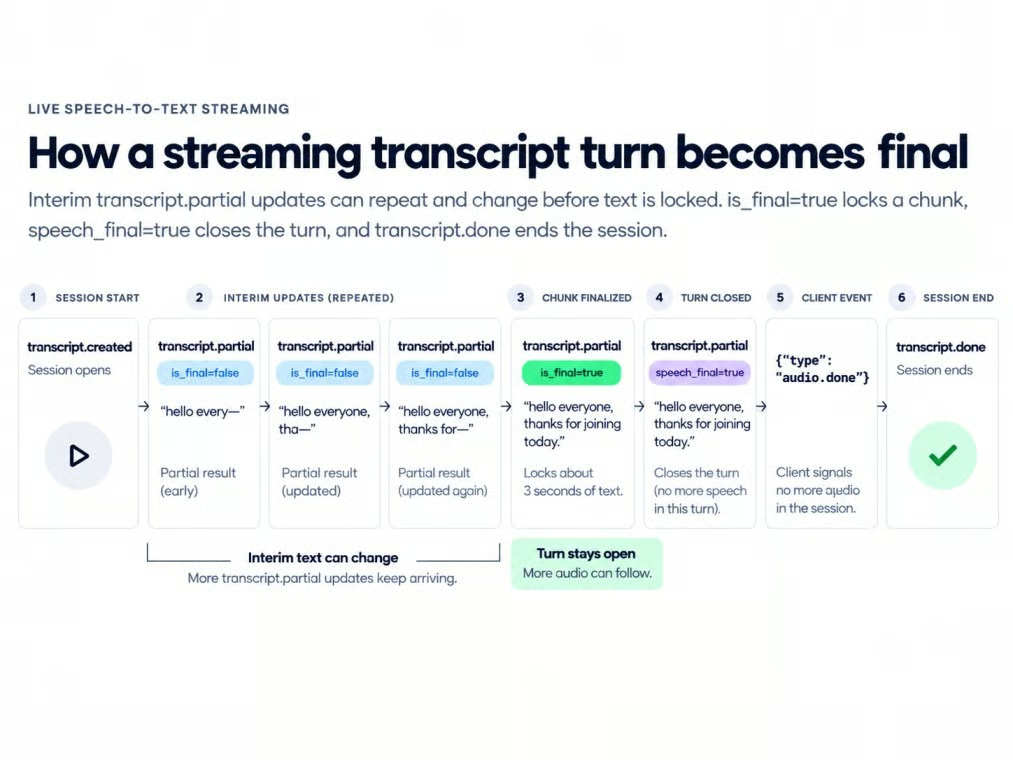
Потоковые состояния ведут текст к финализации. Изображение автора.
Для потоковой передачи сначала пересэмплируйте источник в моно 16‑битный PCM на 16 кГц. Базовый клиент отправляет 100‑миллисекундные фрагменты в реальном времени, пока другая задача принимает события транскрипта:
import asyncio, json, os, wave
import websockets
from dotenv import load_dotenv

load_dotenv()

url = ("wss://api.x.ai/v1/stt?model=grok-voice-transcribe-2.0"
       "&sample_rate=16000&encoding=pcm&interim_results=true&diarize=true")
headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY'].strip()}"}

async def stream_call(path):
    async with websockets.connect(url, additional_headers=headers) as ws:
        assert json.loads(await ws.recv())["type"] == "transcript.created"

        async def send():
            with wave.open(path, "rb") as wf:
                assert wf.getframerate() == 16000
                assert wf.getnchannels() == 1
                assert wf.getsampwidth() == 2
                while chunk := wf.readframes(1600):
                    await ws.send(chunk)
                    await asyncio.sleep(0.1)
            await ws.send(json.dumps({"type": "audio.done"}))

        async def receive():
            async for raw in ws:
                event = json.loads(raw)
                if event["type"] == "transcript.partial":
                    print(event["text"])
                elif event["type"] == "transcript.done":
                    break

        await asyncio.gather(send(), receive())
Промежуточный текст обновлялся примерно каждые полсекунды. Это локальное наблюдение, не официальная задержка.
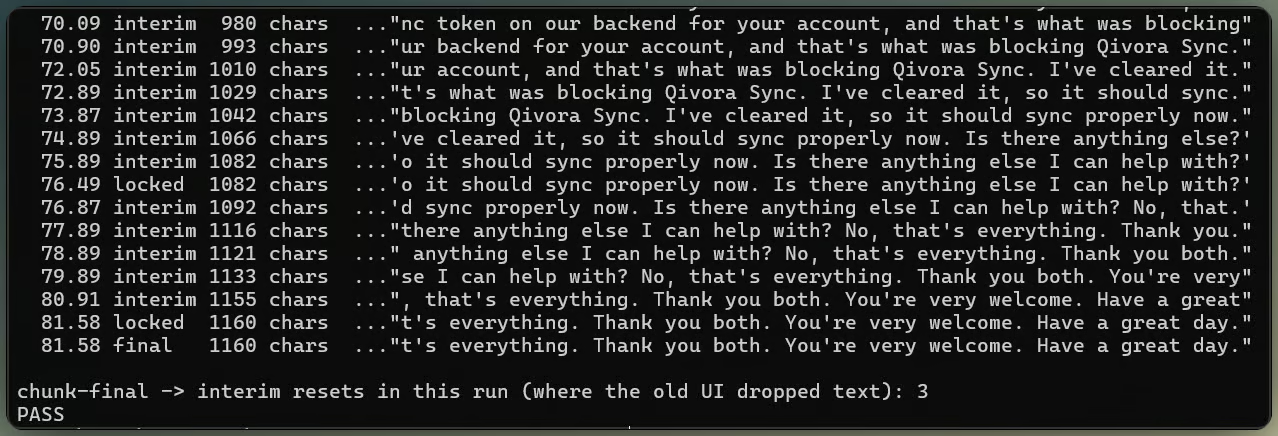
Промежуточные подписи «оседают» в финальном тексте. Изображение автора.
Финализация фрагмента фиксирует текст, не закрывая реплику. Smart Turn управляет тем, когда speech_final её закрывает.
Если показывать только активное событие, предыдущие слова исчезают после финализации каждого фрагмента, потому что следующий промежуточный начинает сначала от входящего аудио.
Сохраняйте каждый зафиксированный фрагмент, добавляйте текущий промежуточный и позвольте финалу высказывания заменить оба.
Так текст может расти, не теряя прежние части. Когда состояние отображения решено, остаётся проблема границ реплик в потоке.
Smart Turn оценивает каждую паузу и предполагает, закончил ли говорящий. Она нужна для номера Халида: «ноль один ноль, пять пять пять, [пауза], один два три четыре», где по одной лишь тишине нельзя отличить паузу на обдумывание от конца.
Порог — это не доверие транскрипции и не порог VAD. Это та вероятность конца реплики, которую тишина должна превысить, прежде чем speech_final сработает; ниже — реплика остаётся открытой. Два параметра запроса это настраивают:
params += [
    ("smart_turn", "0.7"),           # end-of-turn probability needed to close
    ("smart_turn_timeout", "3000"),  # close anyway after 3 s of silence
]
В документации 0.5 называется сбалансированным, 0.7 — консервативным для числовых последовательностей, а 0.9 — очень консервативным. В этом стенде паузы короче стандартного окна endpointing не давали полезного решения Smart Turn. Это наблюдение, а не документированное правило тайминга.
В потоковом тесте остановка аудиокадров не продвигала наблюдаемый таймер тишины. Продолжение отправки «цифровой тишины» позволяет Smart Turn закрыть высказывание.
Удлинение паузы при диктовке номера делает поведение наглядным. Короткие паузы остаются внутри одной реплики, длинная — делит её при каждом пороге, когда уверенность превышает все три настройки.
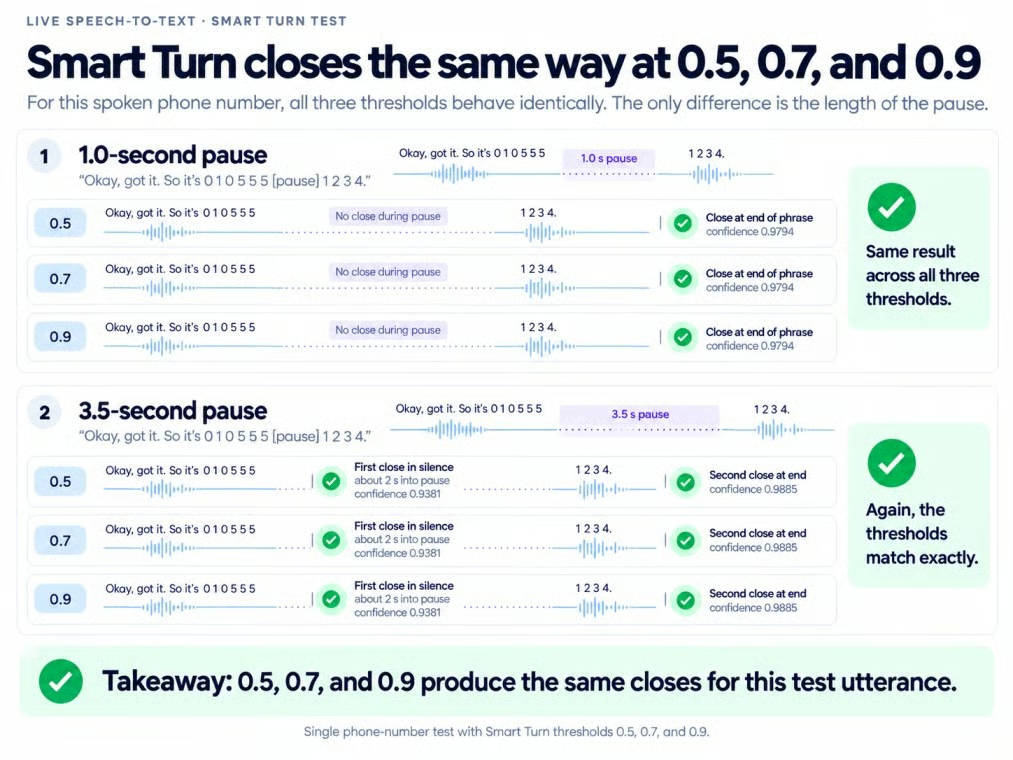
Длинные паузы могут разрезать диктовку номера. Изображение автора.
Люди менее предсказуемы. Короткая последовательность цифр может выглядеть завершённой. Затем абонент продолжает.
Если Smart Turn закрывается во время диктовки номера, подождите немного и объедините продолжение перед ответом.
smart_turn_timeout закрывает реплику после фиксированной тишины, даже если Smart Turn не уверен. В быстром трёхголосом потоке Smart Turn сгруппировал несколько известных реплик, прежде чем таймаут принудительно закрыл её.
Если границы реплик уже известны, отправляйте {"type": "finalize"} на каждой из них; иначе сочетайте Smart Turn с таймаутом.
Когда границы под контролем, того же абонента нужно «провести» через линию 8 кГц.
Телефонное качество здесь — 8 кГц G.711 mu‑law, полученное из того же звонка:
ffmpeg -i support_call.wav -ar 8000 -ac 1 -f mulaw support_call_8k.rawСырое телефонийное аудио не имеет контейнера, поэтому задайте audio_format=mulaw и sample_rate=8000 в пакетной форме, или encoding=mulaw&sample_rate=8000 в параметрах сокета. Проверяйте текст и метки говорящих отдельно.
Ранее замеченные эффекты ключевых терминов, форматирования и языкового переключения на 8 кГц изменились мало.
Метки говорящих стали менее надёжными. Телефонная версия ввела дополнительный ID спикера и приписала финальную реплику не тому человеку. Простое подсчёт фрагментов скрывает обе ошибки.
Ненадёжная версия ограничивает полосу до 300–3400 Гц, кодирует на 8 кГц mu‑law и отбрасывает каждый 20‑мс пакет с вероятностью 0.03. Фиксированное случайное зерно 7 сохраняет те же разрывы при каждом воспроизведении.
Эта потеря пакетов в данном примере мало изменила английский транскрипт, а продиктованные контакты остались в порядке. Результат относится только к этому примеру.
Телефонная симуляция сужает полосу и теряет пакеты. Изображение автора.
Обнаружение голосовой активности (VAD) решает, есть ли в аудио речь вообще. В документации предлагается снизить vad_threshold для тихой телефонной речи — с риском появления лишнего текста из шума.
Снижение vad_threshold ничего не изменило на чистом телефонном аудио, потому что «тихой речи» не было. Этот нулевой результат подтверждает правило: снижайте порог только тогда, когда телефонная речь пропадает.
Используйте свежую пакетную форму без diarize:
data = [
    ("model", "grok-voice-transcribe-2.0"),
    ("multichannel", "true"),
]
API определяет число каналов из WAV или другого контейнера. Для сырого многоканального аудио добавьте ("channels", "3"); потоковый многоканальный ввод через WebSocket тоже требует явного указания числа каналов.
Отправьте форму с многоканальным файлом через REST‑запрос, показанный выше, затем читайте result["channels"]. Каждый элемент содержит индекс, текст транскрипта и слова с таймингами. В контролируемом трёхканальном стенде каждый канал содержал только своего говорящего. Потоковый режим использует тот же разрез и добавляет channel_index к событиям.
Я бы использовал отдельные «ноги» всегда, когда телефонная система их предоставляет. В отличие от диаризации в разделе о телефонном аудио, известное разбиение не делает выводов о говорящих.
Полный клиент предоставляет одну группу настроек, а затем отдельно формирует REST‑форму или URL WebSocket. Общие настройки охватывают диаризацию, ключевые термины, слова‑паразиты, кодирование аудио и обработку границ реплик; форматирование следует правилам транспорта, описанным выше.
Примените финальные настройки к телефонной записи, затем отдельно проверьте написание продукта, языковые переключения, контакты и метки говорящих. В контролируемом стенде текстовые проверки прошли, тогда как одну метку говорящего всё ещё нужно было перепроверить. Сохраняйте настройки и сопоставление говорящих вместе с каждой транскрипцией, чтобы последующие сравнения использовали ту же конфигурацию.
Учебник по транскрипции поддержки заканчивается этой финальной проверкой. В репозитории также есть отдельное расширение голосового агента с сгенерированными ответами, озвучкой, прерываниями и обработкой эха.
В том демо Transcribe сохраняет ту же роль: он производит текст. Языковая модель пишет ответы, а Grok TTS их озвучивает.
Изучайте ИИ с DataCamp!
Трек
Трек
Курс