

이는 개념적 예시에 불과하며, Mercury 3의 정확한 내부 표현은 아닙니다.
Inception의 API는 이러한 중간 상태를 노출할 수 있습니다. 일반 스트리밍에서는 응답에 덧붙일 수 있는 정련된 텍스트 블록을 반환합니다. diffusing=True를 사용하면, 각 청크에는 모델이 정련하는 과정에서의 현재 답변 전체 버전이 담깁니다.
곧 차이를 확인해 보겠습니다.
데모: 실시간 지원 에스컬레이션 어시스턴트 만들기
데모를 만들기 전에, 모델 설정을 지원 애플리케이션 자체와 분리해 봅시다.
지원 케이스는 단지 Mercury 3를 실험하기 위한 입력일 뿐입니다. 중요한 모델 측 제어 요소는 추론 예산, 완성 예산, 스트리밍 모드입니다.
|
설정 |
사용 값 |
중요한 이유 |
|
온도 |
0.75 |
모드 비교 시 샘플링이 바뀌지 않도록 고정 |
|
추론 노력 |
low, high |
숨은 추론 사용량과 지연 시간을 비교 가능 |
|
완성 예산 |
8192 |
측정된 데모 실행에 충분 |
|
표준 스트리밍 |
stream=True |
덧붙일 수 있는 텍스트 블록 반환 |
|
확산 스트리밍 |
stream=True, diffusing=True |
연속적인 전체 텍스트 정련 상태 반환 |
|
프롬프트 |
고정된 지원 케이스 |
모델 설정이 변해도 작업은 일정하게 유지 |
|
반복 |
조건당 5회 |
단일 요청에 의존하지 않고 실행 간 변동 확인 |
이는 이 실험을 위한 실무 설정일 뿐, Mercury 3의 전역 최적 설정은 아닙니다.
1단계: 준비 사항
Mercury 3는 시작까지 몇 단계면 충분합니다. 따라하려면 다음이 필요합니다.
- Inception API 키
- Python 3
- inceptionai 패키지
case_support.json으로 저장된 지원 케이스
먼저 Inception 플랫폼에 가입하고 API 키를 받으세요. Get Started를 클릭하고 정보를 입력합니다.
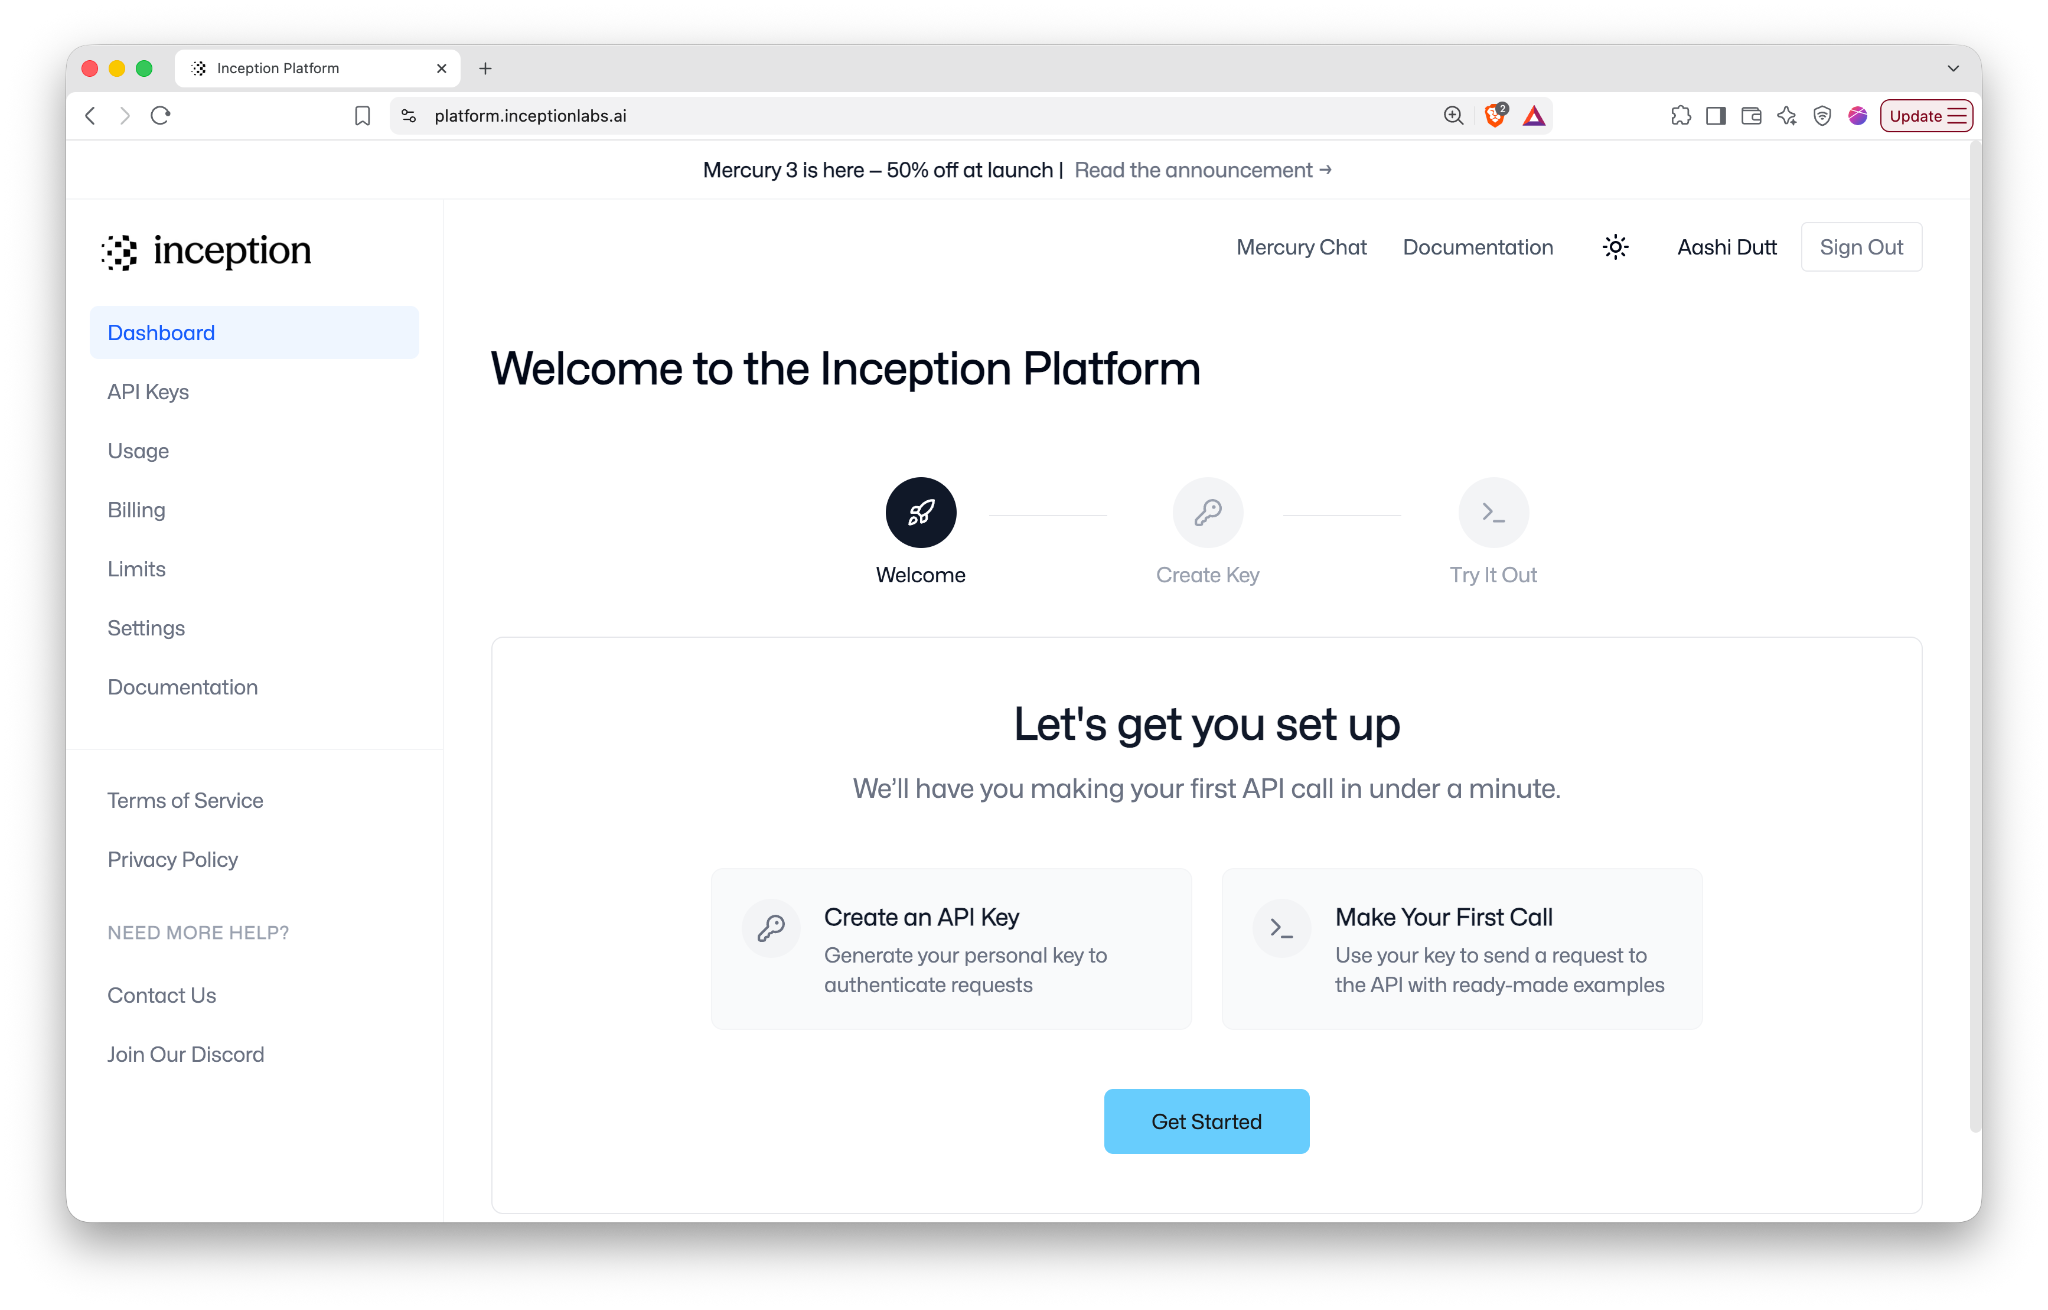
참고: 작성 시점 기준, Inception은 신규 계정에 API 체험용으로 1억 개의 무료 토큰을 제공합니다.
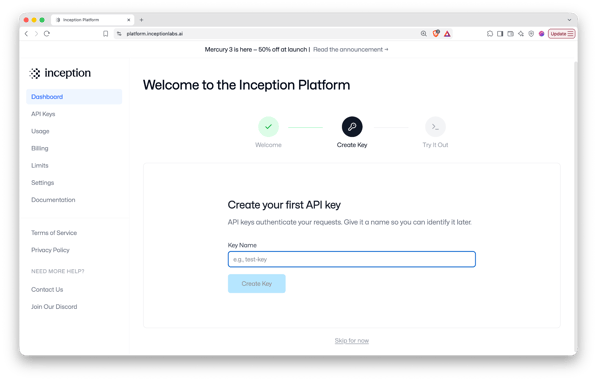
API 키의 이름을 지정하거나 이 단계를 건너뛰고 Create Key를 클릭해도 됩니다.
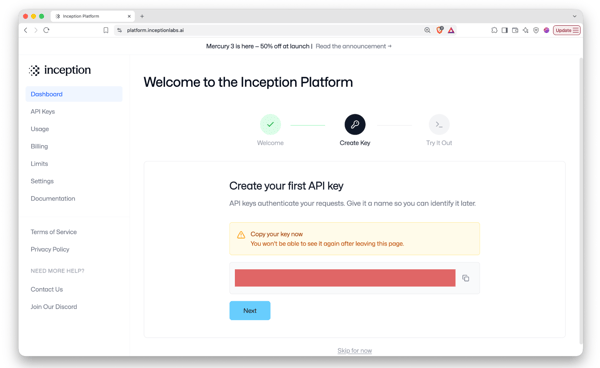
이제 API 키를 복사하고 첫 번째 API 호출을 해 보세요.
2단계: Mercury 3 체험
코드를 작성하기 전에 Inception 플랫폼에서 직접 Mercury 3를 테스트할 수 있습니다. API 키를 만든 뒤 Next를 클릭하고 Try It Out 탭에서 Run it now 버튼을 선택하세요.
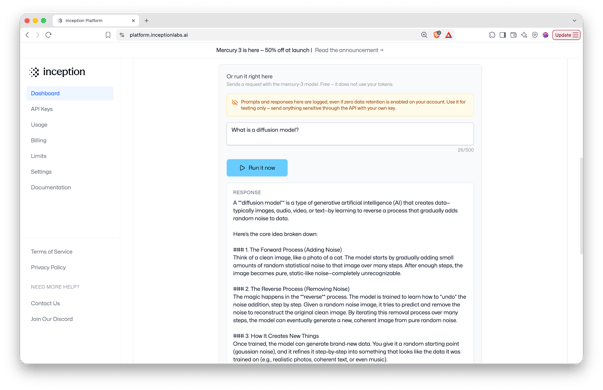
이는 애플리케이션에 옮기기 전에 프롬프트와 모델 설정을 빠르게 시험해 보는 데 유용합니다.
3단계: 환경 준비 및 API 호출
튜토리얼의 나머지 부분에서는 Python에서 Mercury 3를 호출합니다. 먼저 inception SDK를 설치하고 아래와 같이 API 키를 내보냅니다.
!pip install -q inceptionai그런 다음 데모에서 사용하는 패키지를 임포트합니다.
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass는 에코 없이 API 키를 묻고, os는 SDK가 찾는 위치에 키를 설정합니다. Path와 json은 case_support.json을 로드해 프롬프트로 직렬화하며, time.perf_counter()는 각 응답과 정련 상태가 도착한 시점을 기록합니다.
difflib는 연속된 확산 상태를 비교하고, clear_output()은 셀 출력을 교체하여 재생이 페이지 아래로 누적되지 않고 제자리에서 이뤄지도록 합니다.
API 키가 아직 설정되지 않았다면 대화형으로 입력받을 수 있습니다.
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception()은 환경변수에서 API 키를 읽습니다. 다른 임포트들 가운데 time은 정련 상태 도착 시점을 기록하고, difflib는 중간 텍스트 비교를 돕고, clear_output()은 확산 과정을 제자리에서 재생하도록 합니다.
4단계: 모델 메시지 구성
지원 케이스는 case_support.json에 별도로 저장되어 있습니다. 케이스 파일에는 고객 메시지, 주문 정보, 결제 기록, 풀필먼트 로그, 지원 정책, 그리고 이 시나리오에서 사용할 프롬프트가 들어 있습니다.
직접 만들어도 되고, 그대로 사용해도 됩니다.
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}이제 JSON 파일을 로드해 봅시다.
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Mercury 3에 보내기 전에 프롬프트 구성과 증거를 분리합니다.
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]system_prompt, task_prompt, packet_label 키는 Mercury에 대한 지시 방법을 제어하므로, 케이스 자체를 직렬화하기 전에 증거에서 제외됩니다. 이제 최종 메시지를 준비할 수 있습니다.
messages = build_messages(case)여기에는 검색 시스템이나 외부 도구가 관여하지 않습니다. 이번 분석에 필요한 것은 모두 요청 본문으로 직접 제공합니다.
5단계: Mercury 3에 요청 보내기
스트리밍을 테스트하기 전에 일반 비스트리밍 요청을 먼저 실행해 봅니다. 다음 헬퍼는 Mercury API 호출을 래핑하고 응답 메타데이터를 기록합니다.
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)이제 모델 호출을 정의합니다.
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}주요 모델 측 제어는 다음과 같습니다.
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokens이제 기준 호출을 수행합니다.
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury는 전체 지원 케이스를 수신하고, 가장 그럴듯한 설명, 이를 뒷받침하는 증거, 대안적 설명과 불확실성, 권장 다음 조치 등을 포함한 요청된 분석을 반환합니다.
함수는 elapsed_s와 usage 필드도 기록합니다. 전자는 요청의 종단 간 시간을, 후자는 토큰 집계를 포함해 보고된 추론 토큰 사용량 등을 담습니다.
이 튜토리얼의 실행 전반에서 Mercury는 두 번째 결제 항목을 확정된 두 번째 주문의 증거가 아니라 보류 중인 승인(pending authorization)일 가능성이 가장 높은 것으로 일관되게 식별했습니다. 다만, 케이스에는 그 보류 승인(authorization)이 결국 사라질지 정산(settle)될지 판단하기에 충분한 정보가 의도적으로 부족합니다.
6단계: 표준 스트리밍 추가
일반 요청은 Mercury가 완료될 때까지 기다린 후 전체 답변을 반환합니다. 응답을 점진적으로 수신하려면 stream=True를 활성화해야 합니다. 표준 스트리밍 함수는 다음과 같습니다.
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}여기서 중요한 동작은 표준 스트리밍에서 각 청크가 응답의 다음 부분을 포함하고 chunks.append(content)로 누적된다는 점입니다. 따라서 "".join(chunks)로 청크를 합쳐 최종 답변을 재구성할 수 있습니다.
참고: 중간값 기준 최초 가시 출력까지 2.903초, 총 지연 시간은 3.375초였습니다.
7단계: 확산 스트리밍으로 전환
확산 스트리밍을 활성화하려면 다음 매개변수를 True로 설정합니다.
stream=True
diffusing=TrueAPI 호출은 diffusing=True 하나의 인자만 추가된 점을 제외하면 표준 스트리밍과 동일합니다.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}표준 스트리밍에서는 청크를 덧붙입니다. 그러나 확산 스트리밍에서는 최신의 비어 있지 않은 청크가 현재 답변의 전체 버전을 나타냅니다. 따라서 덧붙이지 않고 이전에 표시된 내용을 대체해야 합니다.
또한 반환된 상태를 보관하여 정련 상태 수를 측정하고, 이후 상태가 이전에 표시된 텍스트를 실제로 수정하는지 확인합니다.
5회 실행에서 확산 스트리밍은 가시 정련 상태의 중앙값 9개(범위 7–12)를 반환했습니다. 최초 가시 상태까지의 중앙값 시간은 1.896초, 총 지연 시간의 중앙값은 2.560초였습니다.
8단계: 표준 스트리밍과 확산 스트리밍 비교
두 코드 경로를 이해했으니, 측정된 동작을 비교해 보겠습니다.
|
지표 |
표준 |
확산 |
|
중앙값 청크/상태 수 |
6 |
9 |
|
범위 |
5–7 |
7–12 |
|
중앙값 최초 가시 출력 |
2.903 s |
1.896 s |
|
중앙값 총 지연 |
3.375 s |
2.560 s |
이 특정 지원 프롬프트에서는 확산이 더 낮은 중앙값 지연을 보였지만, 범위가 상당히 겹칩니다. 따라서 확산 스트리밍이 본질적으로 더 빠르다고 결론지어서는 안 됩니다.
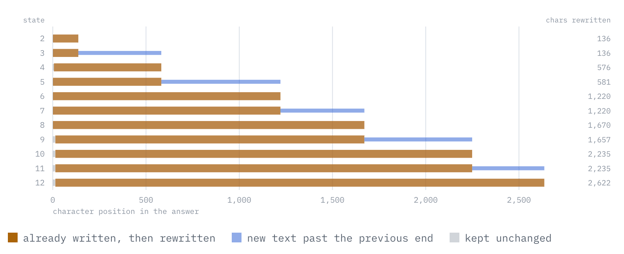
그림: 12개 상태 실행, 전이별. 갈색 막대는 Mercury 3가 이미 작성했다가 교체한 텍스트이며, 파란 막대는 이전 끝 이후의 새 텍스트입니다. 순수한 추가(append)만 있었다면 갈색은 전혀 보이지 않았을 것입니다.
제 실행에서는 반환된 확산 상태가 추가 전용 청크처럼 동작하기보다 이전에 보였던 텍스트를 수정했습니다. 위 실행에서는 11번의 상태 전이 중 어느 것도 순수 추가가 아니었고, 모두 이전 상태와 처음 14자 이내에서 달라졌습니다.
9단계: 완성 예산 테스트
다음으로, 추론 토큰이 완성 예산과 상호작용하는 Mercury 3의 동작을 살펴봅니다. 위의 일반 호출은 max_completion_tokens=8192를 사용했지만, 동작을 더 분명히 드러내려면 max_completion_tokens를 1600으로 줄여야 합니다.
이제 동일한 요청을 낮은 추론 노력과 높은 추론 노력으로 각각 한 번씩 실행합니다. 측정 결과는 다음과 같습니다.
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: none높음에서는 1,539개의 완성 토큰이 모두 추론 토큰으로 보고되었습니다. 따라서 모델은 가시적인 답변 텍스트를 반환하기 전에 완성 한도에 도달했습니다.
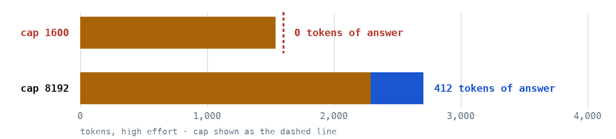
그림: 1,600 및 8,192 토큰 상한에서의 높은 노력 완성 예산
1,600 상한에서는 전체 예산이 추론에 쓰여 아무 출력도 내보낼 수 없었습니다. 8,192에서는 높은 노력 실행의 중앙값이 2,292개 토큰을 추론에 사용했으며, 412개 토큰의 답변을 낼 여유가 남았습니다. 8,192 상한은 이 스케일의 오른쪽 끝을 벗어나 있으므로, 위 그림에서 점선 상한선이 보이는 행은 첫째 줄뿐입니다.
실패한 높은 노력 요청에서 중요한 신호는 response.choices[0].finish_reason이 반환한 length입니다. 이는 요청이 최대 완성 토큰 예산(max_completion_tokens)에 도달했음을 의미합니다. 이 예산에는 추론 토큰과 가시 출력 토큰이 모두 포함됩니다. 이번 실행에서 Mercury 3는 1,539개 완성 토큰 전부를 추론 토큰으로 보고했기 때문에, 가시 답변을 생성하기 전에 완성 한도에 도달했습니다.
참고: 이 데모에서는 max_completion_tokens=8192가 이후 실행에 충분했지만, 이를 보편적 최소치로 간주해서는 안 됩니다.
10단계: 낮음과 높음 추론 노력 비교
이제 일반적인 8192 완성 예산으로 돌아가 reasoning_effort만 낮음과 높음으로 바꿉니다. 5단계의 run_nonstream() 헬퍼를 사용해 낮은 노력으로 한 번, 높은 노력으로 한 번 요청합니다.
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)보고된 결과를 위해 각 구성을 단일 요청에 의존하지 않고 5회씩 반복했습니다.
중앙값은 다음과 같습니다.
|
지표 |
낮음 |
높음 |
|
종단 간 지연 |
2.936 s |
8.146 s |
|
완성 토큰 |
1312 |
2723 |
|
추론 토큰 |
828 |
2292 |
|
대략적 가시 토큰 |
468 |
412 |
|
추론 비중 |
63% |
84% |
중앙값 기준 추론 사용량은 828에서 2,292 토큰으로 증가했고, 지연 시간은 2.936초에서 8.146초(약 2.77배)로 늘었습니다.
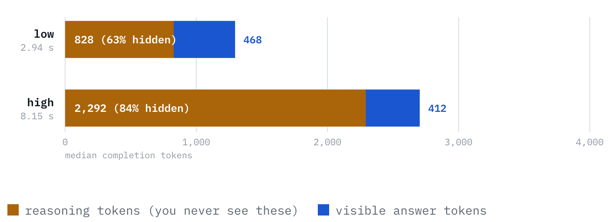
그림: 노력 수준별로 완성 예산은 어디에 쓰였는가?
가시 답변 길이는 크게 변하지 않았습니다.
- 낮음: 중앙값 468 토큰
- 높음: 중앙값 412 토큰
관측 범위도 겹쳤습니다.
- 낮음: 393–494
- 높음: 356–469
따라서 이 실행들만으로는 추론 노력을 높인다고 해서 가시 답변이 짧아진다고 주장할 수 없습니다. 지연 시간 범위도 왜 단 한 번의 실행으로는 충분하지 않은지 보여줍니다.
- 낮음: 1.602–4.993 s
- 높음: 4.102–9.068 s
참고: 가장 빠른 높은 노력 요청이 가장 느린 낮은 노력 요청보다 실제로 더 빨랐습니다.
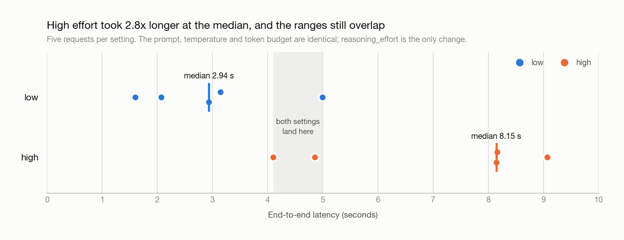
그림: 지연 시간별 10개 모든 추론 노력 요청
따라서 이 실험에서 reasoning_effort="high"는 보고된 추론 토큰 사용량과 지연 시간을 크게 늘렸고, 가시 답변 길이는 대체로 유사하게 유지되었습니다.
마무리
Mercury 3의 실용적 동작은 다음 세 가지입니다.
-
확산 스트리밍은 다른 출력 계약을 사용합니다. 표준 스트리밍은 새 텍스트를 덧붙이지만, 확산 스트리밍은 이전 것을 대체해야 하는 연속적인 전체 응답 상태를 반환합니다.
-
추론 토큰은 완성 예산을 공유합니다.
max_completion_tokens값이 작으면, Mercury 3가 가시 답변을 생성하기 전에 추론으로 예산을 소진할 수 있습니다. -
더 높은 추론 노력은 더 많은 연산과 지연 시간의 교환입니다. 제 실행에서는 예상대로 높은 노력에서 보고된 추론 토큰이 크게 늘고 더 오래 걸렸지만, 가시 답변 길이는 대체로 유사했습니다.
이 결과는 하나의 합성 지원 케이스에서 소수의 실행으로 얻은 관찰이므로, Mercury 3에 대한 일반적 성능 주장으로 받아들이기보다는 데모의 관찰로 보아야 합니다.
Mercury 3 자주 묻는 질문(FAQs)
Mercury 3에서 표준 스트리밍과 확산 스트리밍의 핵심 차이는 무엇인가요?
표준 스트리밍에서는 응답이 서로 덧붙일 수 있는 텍스트 청크로 도착합니다. 확산 스트리밍에서는 API가 현재 응답의 연속적인 개정본을 노출하므로, 최신 상태는 이전 것에 덧붙이지 말고 대체해야 합니다.
reasoning_effort="high"가 항상 더 나은 답변을 제공하나요?
아니요. 더 높은 추론 노력은 Mercury에 더 많은 추론 여지를 제공하지만, 모든 작업에서 더 나은 응답을 보장하지는 않습니다. 이 데모에서 높은 노력은 추론 토큰을 크게 더 사용하고 시간이 더 걸렸으며, 가시 답변 길이는 유사하게 유지되었습니다. 또한 누락된 한 가지 증거를 드러내는 데 더 일관적이었지만, 실험 규모가 작아 품질에 대한 광범위한 주장으로 삼기 어렵습니다.
max_completion_tokens이 너무 작을 때 Mercury 3가 가시 답변을 반환하지 않을 수 있는 이유는 무엇인가요?
추론 토큰은 가시 답변과 동일한 완성 토큰 예산을 공유합니다. 모델이 추론 중 그 예산 대부분 또는 전부를 소진하면, 가시 출력을 생성하기 전에 완성 한도에 도달할 수 있습니다. 이 경우 finish_reason과 보고된 추론 토큰 사용량을 확인하면 상황을 설명하는 데 도움이 됩니다.
확산 스트리밍이 항상 표준 스트리밍보다 빠른가요?
아니요. 이 데모에서는 확산 스트리밍이 최초 가시 출력까지의 중앙값 시간과 총 지연 중앙값이 더 낮았지만, 범위가 겹쳤고 다른 프롬프트에서는 반대 결과가 나왔습니다. 더 신뢰할 수 있는 차이는 스트리밍 동작이지, 지연 시간 개선의 보장은 아닙니다.
언제 Mercury 3를 사용해야 하나요?
Mercury 3는 사용자가 빠른 응답의 이점을 누리면서도 모델이 비트리비얼한 추론을 수행해야 하는 레이턴시 민감형 애플리케이션에서 특히 흥미롭습니다. 적절한 추론 노력과 완성 예산은 작업에 따라 다르므로, 지연 시간과 답변 품질을 모두 고려해 튜닝해야 합니다.
Mercury 3는 Inception.ai의 확산(디퓨전) 대형 언어 모델입니다. 토큰을 한 번에 하나씩 생성하는 기존의 자기회귀 LLM과 달리, Mercury는 확산을 통해 응답의 여러 부분을 반복적으로 정련합니다. 이 모델은 GPT-6 Luna와 Claude Haiku 5.5보다 뛰어난 성능을 보이며, NVIDIA GPU에서 초당 1,000+ 토큰 기준으로 4–8배 더 빠르게 실행되고 100만 토큰 컨텍스트 윈도우를 지원합니다.
이 튜토리얼에서는 애플리케이션 로그, 배포 정보, GPU 메트릭, 요청 트레이스를 입력받는 소규모 인시던트 분석 어시스턴트를 만들어 보겠습니다. 그런 다음 동일한 작업으로 Mercury 3의 두 가지 특성을 살펴봅니다.
확산 스트리밍이 일반 LLM 스트리밍과 어떻게 다른가
reasoning_effort를 낮음에서 높음으로 올리면 무엇이 달라지는가진행하면서 Mercury의 추론 모드를 사용할 때 중요한 토큰 예산 문제도 마주하게 됩니다. 이 글을 마치면 다음을 할 수 있습니다.
전체 코드 리포지토리.
Mercury 3란?
왼쪽에서 오른쪽으로만 응답을 생성하는 기존 자기회귀 LLM과 달리, Mercury는 생성 중 여러 토큰 위치를 반복적으로 정련하는 계열의 모델에 속합니다. Inception의 접근 방식은 에이전트, 검색, 고객 지원, 교육 등과 같이 레이턴시에 민감한 워크로드에 적합하며, 반복적인 모델 호출이 빠르게 누적될 수 있는 애플리케이션에 특히 유리합니다.
Mercury 3는 확산 기반 생성 과정을 장기 컨텍스트 입력, 추론 제어, 도구 호출, 구조화된 출력, OpenAI 호환 엔드포인트 등 범용 API 모델에서 기대하는 기능과 결합합니다. 또한
diffusing=True스트리밍 모드를 제공하여, 애플리케이션이 추가 전용 블록만 받는 대신 모델의 중간 전체 텍스트 정련 상태를 수신할 수 있습니다.작성 시점 기준, Mercury 3는 다음을 지원합니다.
속성
Mercury 3
컨텍스트 윈도우
100만 토큰
최대 출력
131,072 토큰
추론 노력
instant, low, medium, high
도구 호출
지원됨
구조화된 출력
지원됨
스트리밍
지원됨
확산 스트리밍
지원됨
온도
0.5–1.0
API
OpenAI 호환
Inception은 현재 Mercury 3의 출시가를 입력 100만 토큰당 $0.10, 캐시된 입력 100만 토큰당 $0.01, 출력 100만 토큰당 $0.35로 제시하고 있습니다. 캐시된 토큰은 입력 가격 대비 90% 할인입니다.
Mercury 3는 Mercury 1보다 40배 더 크고 훨씬 더 지능적이지만, 속도는 동일합니다.
그림: 모델 품질 vs 모델 크기(출처)
Mercury 3는 어떻게 동작하나요?
대부분의 LLM은 텍스트를 왼쪽에서 오른쪽으로, 한 번에 한 토큰씩 자기회귀적으로 생성합니다. 전통적인 LLM이 텍스트를 생성하는 방식은 다음과 같습니다.
각 새 토큰은 이전에 생성된 모든 것에 의존합니다.
Mercury는 대신 확산을 사용합니다.
Inception은 자사의 확산 LLM을, 여러 토큰을 병렬로 수정하여 출력을 점진적으로 개선하는 Transformer 기반 모델로 설명합니다. 이전 Mercury 연구에서는 이를 엄격한 좌→우 다음 토큰 예측이 아닌, 거칠게 시작해 정교해지는(coarse-to-fine) 생성 과정으로 묘사했습니다.
단순화한 예시는 다음과 같을 수 있습니다.