

Dit is slechts een conceptueel voorbeeld, niet de exacte interne representatie van Mercury 3.
De API van Inception kan deze tussentijdse staten zichtbaar maken. Met normale streaming retourneert Mercury blokken verfijnde tekst die aan het antwoord kunnen worden toegevoegd. Met diffusing=True bevat elk chunk in plaats daarvan de complete huidige versie van het antwoord terwijl het model het verfijnt.
We zien het verschil zo meteen.
Demo: een realtime assistent voor support-escalaties bouwen
Voordat we de demo bouwen, scheiden we de modelinstellingen van de supportapplicatie zelf.
De supportcase is alleen de input die we gebruiken om Mercury 3 te testen. De belangrijke modelzijde-instellingen zijn het redeneerbudget, het completionbudget en de streamingmodus.
|
Instelling |
Gebruikte waarde |
Waarom het telt |
|
Temperatuur |
0,75 |
Vastgezet zodat we de sampling niet veranderen bij het vergelijken van modi |
|
Redeneereffort |
low, high |
Laat ons verborgen redeneergebruik en latency vergelijken |
|
Completionbudget |
8192 |
Groot genoeg voor de gemeten demoruns |
|
Standaard streaming |
stream=True |
Retourneert appendbare tekstblokken |
|
Diffusiestreaming |
stream=True, diffusing=True |
Retourneert opeenvolgende full-text verfijningsstaten |
|
Prompt |
Vaste supportcase |
Houdt de taak constant terwijl de modelinstellingen veranderen |
|
Herhalingen |
5 per conditie |
Toont variatie tussen runs in plaats van te vertrouwen op één request |
Dit zijn werkende instellingen voor dit experiment, niet globaal optimale Mercury 3-instellingen.
Stap 1: Vereisten
Met Mercury 3 ben je in een paar stappen klaar. Om mee te doen heb je nodig:
- Een Inception API-sleutel
- Python 3
- Het pakket inceptionai
- De supportcase opgeslagen als
case_support.json
Begin met je aan te melden voor het inceptionplatform en de API-sleutel op te halen. Klik op Get Started en vul je gegevens in:
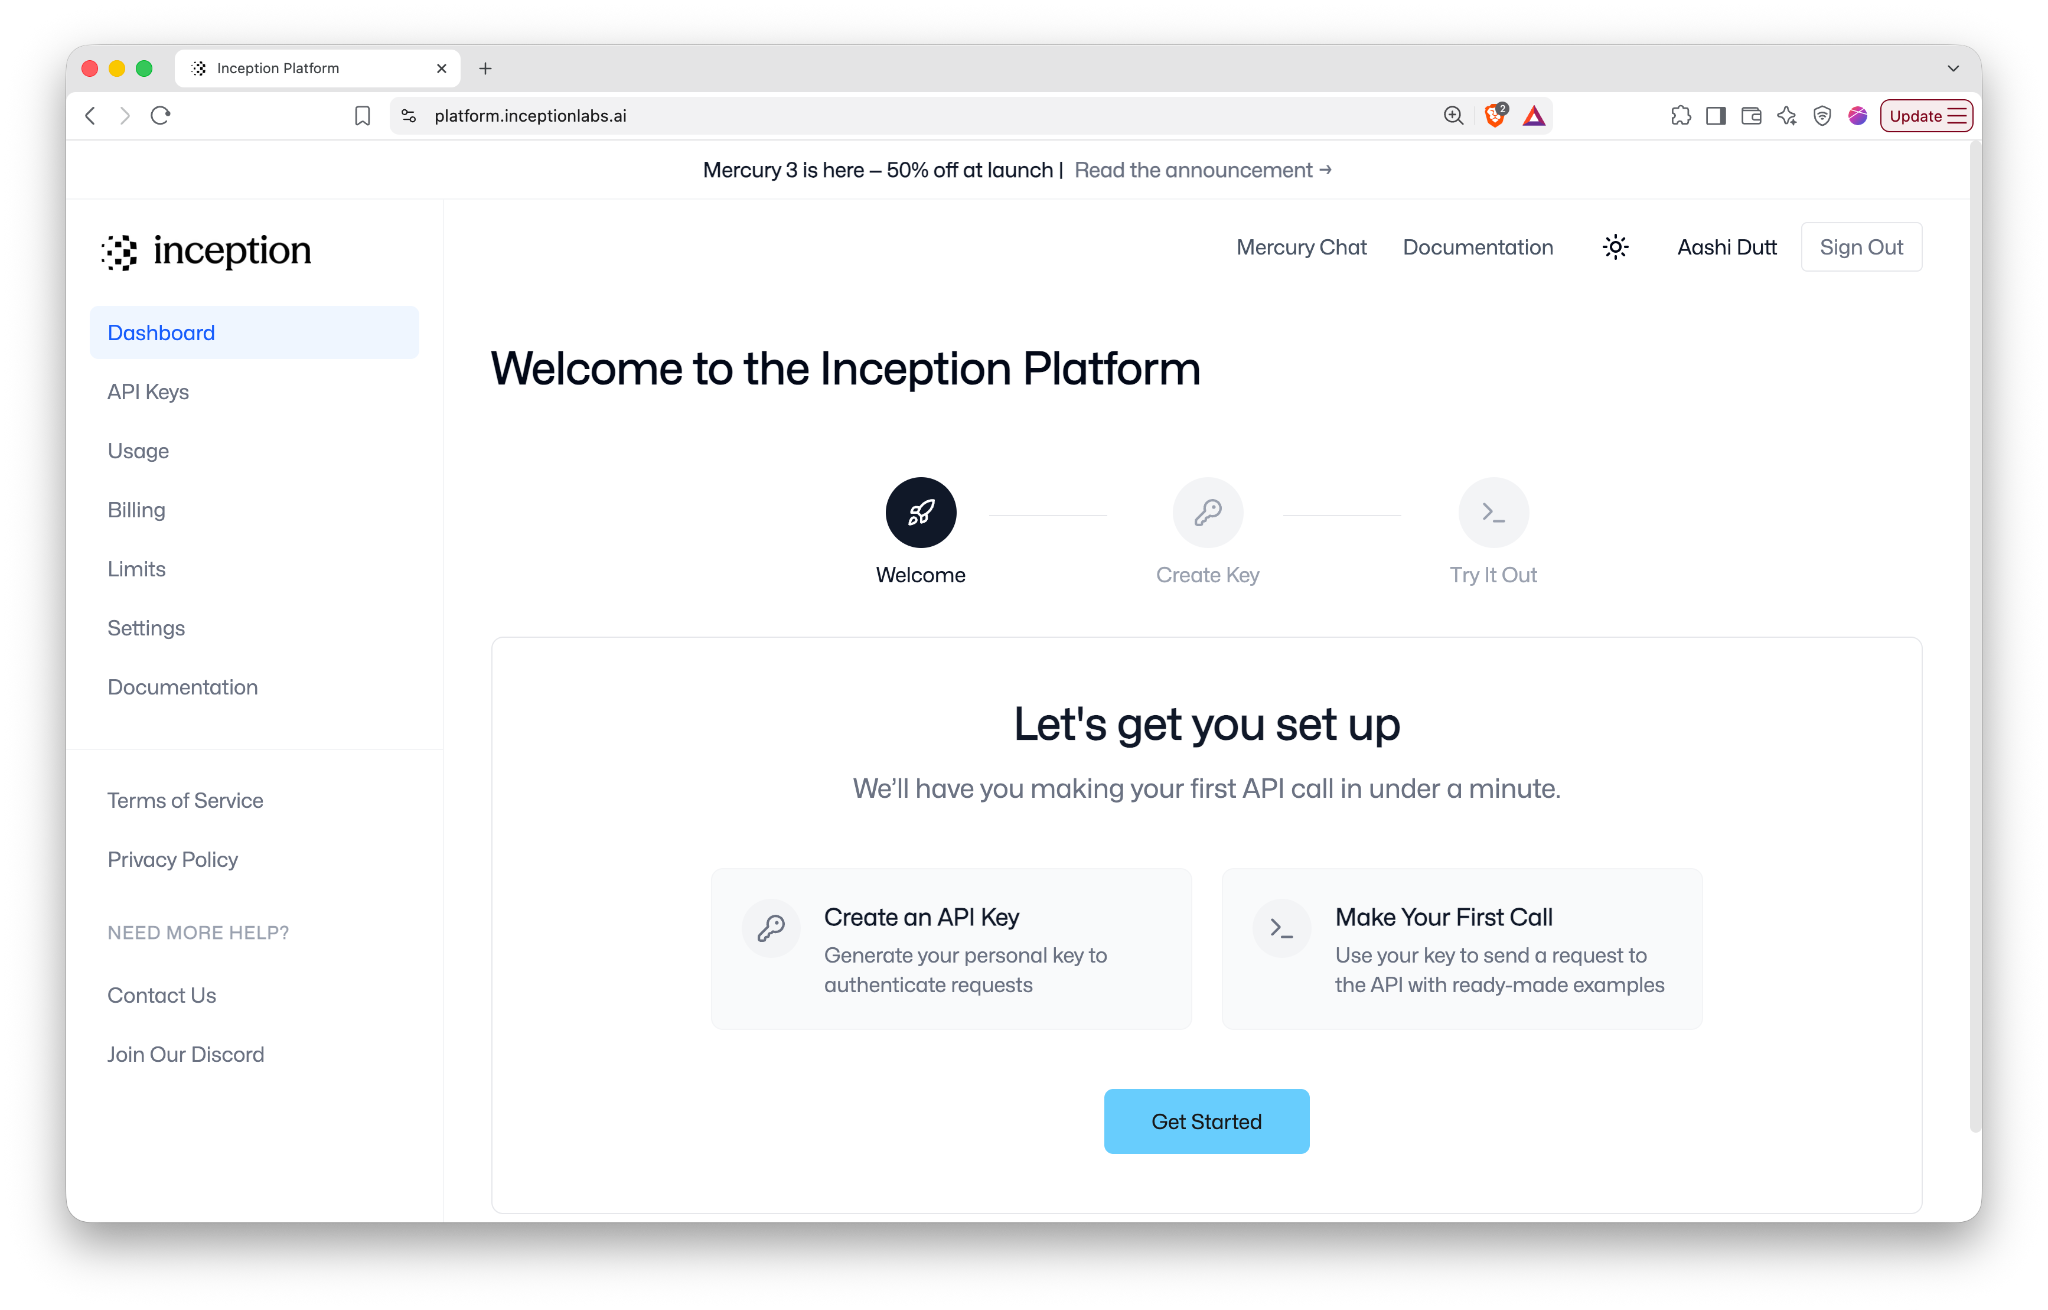
Let op: Op het moment van schrijven biedt Inception 100 miljoen gratis tokens aan nieuwe accounts om de API uit te proberen.
Je kunt je API-sleutel een naam geven of deze stap overslaan en op Create Key klikken.
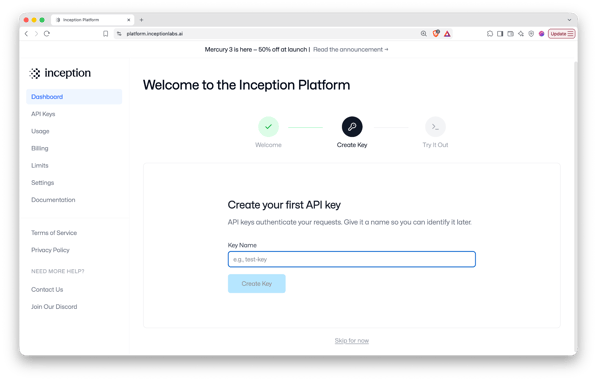
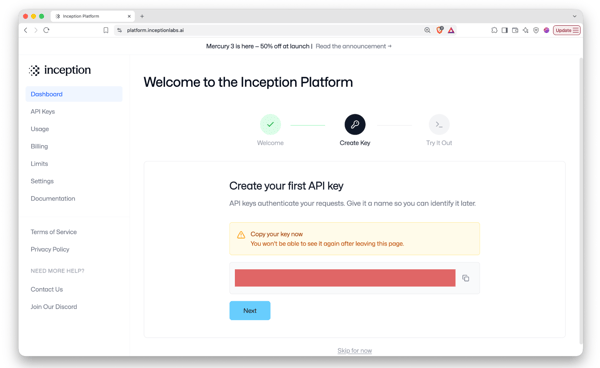
Kopieer vervolgens de API-sleutel en doe je eerste API-call.
Stap 2: Probeer Mercury 3 uit
Voordat je code schrijft, kun je Mercury 3 direct testen vanuit het Inception Platform. Nadat je je API-sleutel hebt gemaakt, klik je op Next en selecteer je de knop Run it now op het tabblad Try It Out.
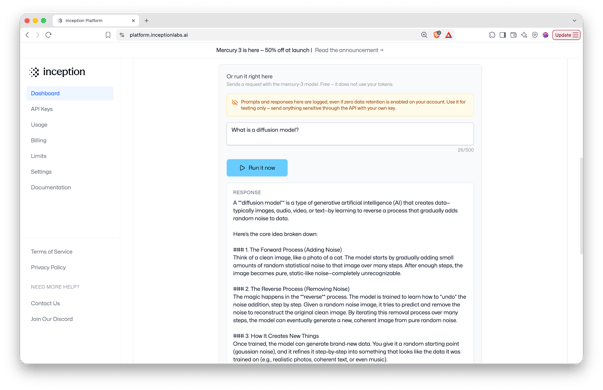
Dit is handig om snel prompts en modelinstellingen te testen voordat je ze in een applicatie zet.
Stap 3: Bereid de omgeving voor en doe een API-call
Voor de rest van deze tutorial roepen we Mercury 3 aan vanuit Python. Begin met het installeren van de inception-SDK en het exporteren van de API-sleutel als volgt:
!pip install -q inceptionaiImporteer vervolgens de pakketten die de demo gebruikt:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass vraagt om de API-sleutel zonder die te tonen, os zet hem waar de SDK hem verwacht, Path en json laden case_support.json en serialiseren dit naar de prompt, en time.perf_counter() registreert wanneer elk antwoord en elke verfijningsstaat binnenkomt.
difflib vergelijkt opeenvolgende diffusiestaten en clear_output() vervangt de celoutput zodat de replay op dezelfde plek gebeurt in plaats van naar beneden te stapelen op de pagina.
Als de API-sleutel nog niet is ingesteld, kun je er interactief om vragen:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() leest de API-sleutel uit de omgeving. Terwijl de andere imports, zoals time registreren wanneer verfijningsstaten arriveren, helpt difflib tussentijdse tekst te vergelijken, en met clear_output() kunnen we het diffusieproces ter plekke afspelen.
Stap 4: Bouw de modelberichten
De supportcase wordt apart opgeslagen in case_support.json. Het casebestand bevat het klantbericht, bestelinformatie, betalingsgegevens, fulfillmentlogs, supportbeleid en de prompts die we voor dit scenario willen gebruiken.
Je kunt je eigen maken of deze zo gebruiken:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Laten we nu het JSON-bestand laden:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Voordat we het naar Mercury 3 sturen, scheiden we de promptconfiguratie van het bewijs:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]De sleutels system_prompt, task_prompt en packet_label bepalen hoe we Mercury instrueren, dus ze worden uit het bewijs verwijderd voordat de case zelf wordt geserialiseerd. We kunnen nu de definitieve berichten voorbereiden:
messages = build_messages(case)Er is hier geen retrievalsysteem of externe tool betrokken. Alles wat Mercury nodig heeft voor deze analyse wordt rechtstreeks in het verzoek meegegeven.
Stap 5: Doe een verzoek aan Mercury 3
Voordat we streaming testen, doen we eerst een normaal, niet-streamend verzoek. De volgende helper wikkelt de Mercury API-call in en registreert de response-metadata:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Laten we nu een modelaanroep definiëren:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}De belangrijkste modelzijde-instellingen zijn:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensWe kunnen nu een baseline-call doen:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury ontvangt de volledige supportcase en retourneert de gevraagde analyse, inclusief de meest waarschijnlijke verklaring, ondersteunend bewijs, alternatieve verklaringen, onzekerheden en aanbevolen vervolgstappen.
De functie registreert ook de velden elapsed_s en usage. De eerste meet de end-to-end tijd van het verzoek, terwijl de andere de tokenadministratie bevat, inclusief het gerapporteerde gebruik van redeneertokens.
Over de runs in deze tutorial identificeerde Mercury consequent de tweede betalingsregel als hoogstwaarschijnlijk een pending autorisatie in plaats van bewijs voor een bevestigde tweede bestelling. De case bevat echter opzettelijk niet genoeg informatie om te weten of die pending autorisatie uiteindelijk verdwijnt of wordt afgeschreven.
Stap 6: Voeg standaard streaming toe
Een normaal verzoek wacht tot Mercury klaar is voordat het het volledige antwoord retourneert. Om het antwoord incrementeel te ontvangen, moeten we stream=True inschakelen. De standaard streamingfunctie ziet er zo uit:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Het belangrijke gedrag hier is chunks.append(content) in standaard streaming, waarbij elke chunk het volgende stuk van het antwoord bevat, zodat de chunks kunnen worden opgehoopt en met "".join(chunks) tot het eindantwoord kunnen worden opgebouwd.
Opmerking: De mediane tijd tot de eerste zichtbare output was 2,903 seconden, terwijl de mediane totale latency 3,375 seconden was.
Stap 7: Schakel over naar diffusiestreaming
Om diffusiestreaming in te schakelen, zet je de volgende parameters op True:
stream=True
diffusing=TrueDe API-call verschilt van standaard streaming door slechts één extra argument, namelijk diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}Bij standaard streaming worden chunks toegevoegd. Bij diffusiestreaming vertegenwoordigt de laatste niet-lege chunk echter de huidige volledige versie van het antwoord. In plaats van hem toe te voegen, vervangen we dus wat eerder werd weergegeven.
We bewaren de teruggegeven staten ook om het aantal verfijningsstaten te meten en te controleren of latere staten daadwerkelijk tekst herzien die eerder verscheen.
Over vijf runs leverde diffusiestreaming een mediaan van 9 zichtbare verfijningsstaten op, met een bereik van 7–12. De mediane tijd tot de eerste zichtbare staat was 1,896 seconden en de mediane totale latency 2,560 seconden.
Stap 8: Vergelijk standaard en diffusiestreaming
Nu we beide codepaden begrijpen, kunnen we het gemeten gedrag vergelijken.
|
Metriek |
Standaard |
Diffusie |
|
Mediane chunks/staten |
6 |
9 |
|
Bereik |
5–7 |
7–12 |
|
Mediane eerste zichtbare output |
2,903 s |
1,896 s |
|
Mediane totale latency |
3,375 s |
2,560 s |
Diffusie had een lagere mediane latency voor deze specifieke supportprompt, maar de bereiken overlappen aanzienlijk. We moeten dus niet concluderen dat diffusiestreaming inherent sneller is.
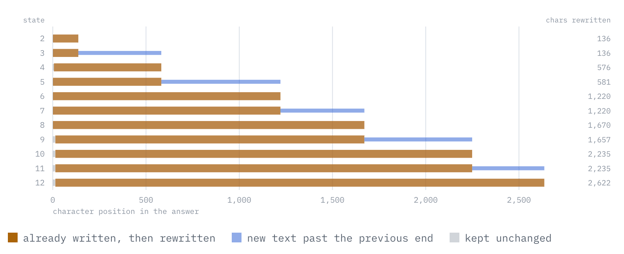
Figuur: run met 12 staten, transitie voor transitie. De bruine balk is tekst die Mercury 3 al had geschreven en vervolgens verving, terwijl de blauwe balk de nieuwe tekst na het vorige einde is. Bij puur toevoegen zou er helemaal geen bruin te zien zijn.
In mijn runs herzien de geretourneerde diffusiestaten eerder zichtbare tekst in plaats van zich te gedragen als append-only chunks. In de run hierboven was geen van de 11 staatsovergangen een pure append, en elke overgang week af van de voorafgaande staat binnen de eerste 14 tekens.
Stap 9: Test het completionbudget
Laten we vervolgens kijken naar het gedrag van Mercury 3 bij de interactie tussen redeneertokens en het completionbudget. De normale aanroepen hierboven gebruiken max_completion_tokens=8192, maar om het gedrag duidelijker te tonen, moeten we max_completion_tokens verlagen naar 1600.
Voer nu hetzelfde verzoek één keer uit met laag en één keer met hoog redeneereffort. Hier is het gemeten resultaat:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneBij hoog werden alle 1.539 completiontokens gerapporteerd als redeneertokens. Het model bereikte daardoor de completielimiet voordat het zichtbare antwoordtekst teruggaf.
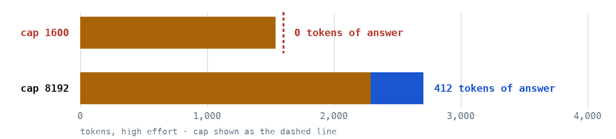
Figuur: hoog effort-completionbudget bij een limiet van 1.600 en 8.192 tokens
Bij de cap van 1.600 ging het hele budget naar redeneren en bleef er niets over om uit te geven. Bij 8.192 besteedde de mediane run met hoog effort 2.292 tokens aan redeneren en was er nog ruimte voor een antwoord van 412 tokens. De cap van 8.192 ligt buiten de rechterrand van deze schaal, daarom toont alleen de eerste rij in de afbeelding hierboven een gestreepte cap-lijn.
Het belangrijke signaal in het mislukte hoge verzoek is response.choices[0].finish_reason, dat length teruggaf. Dit betekent dat het verzoek zijn maximale completion-tokenbudget (max_completion_tokens) bereikte. Dit budget omvat zowel redeneertokens als zichtbare outputtokens. In deze run rapporteerde Mercury 3 alle 1.539 completiontokens als redeneertokens, waardoor het verzoek de completielimiet bereikte voordat er een zichtbaar antwoord werd geproduceerd.
Opmerking: Voor deze demo was max_completion_tokens=8192 voldoende voor de resterende runs, maar dit moet niet als een universeel minimum worden gezien.
Stap 10: Vergelijk laag en hoog redeneereffort
Ga nu terug naar het normale completionbudget van 8192 en varieer alleen de reasoning_effort tussen laag en hoog. We gebruiken de helper run_nonstream() uit stap 5 om één verzoek te doen met laag redeneereffort en één met hoog:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Voor de gerapporteerde resultaten heb ik elke configuratie vijf keer herhaald in plaats van op één verzoek te vertrouwen.
De medianen waren:
|
Metriek |
Laag |
Hoog |
|
End-to-end latency |
2,936 s |
8,146 s |
|
Completiontokens |
1312 |
2723 |
|
Redeneertokens |
828 |
2292 |
|
Geschatte zichtbare tokens |
468 |
412 |
|
Aandeel redeneren |
63% |
84% |
Het mediane redeneergebruik steeg van 828 naar 2.292 tokens, terwijl de mediane latency toenam van 2,936 naar 8,146 seconden (ongeveer 2,77x).
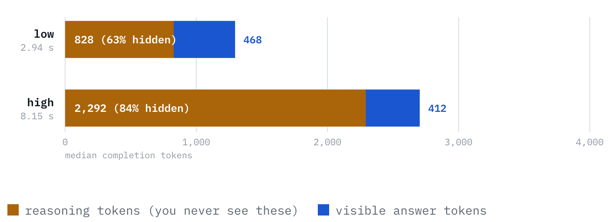
Figuur: Waar gaat het completionbudget heen bij elk effortniveau?
De lengte van het zichtbare antwoord veranderde lang niet zo veel:
- Laag: mediaan 468 tokens
- Hoog: mediaan 412 tokens
en de waargenomen bereiken overlapten:
- Laag: 393–494
- Hoog: 356–469
Deze runs ondersteunen dus niet de claim dat een hoger redeneereffort het zichtbare antwoord korter maakt. De latencybereiken laten ook zien waarom één run niet genoeg is:
- Laag: 1,602–4,993 s
- Hoog: 4,102–9,068 s
Opmerking: De snelste hoge run was zelfs sneller dan de langzaamste lage run.
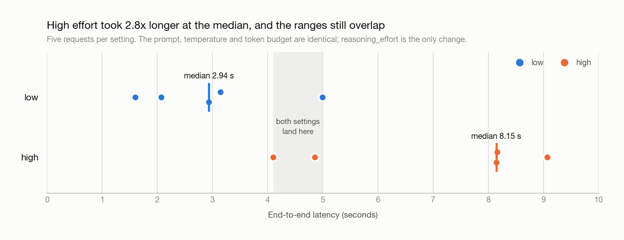
Figuur: alle tien de redeneereffort-requests uitgezet naar latency
Dus, reasoning_effort="high" verhoogde in dit experiment het gerapporteerde gebruik van redeneertokens en de latency aanzienlijk, terwijl de lengte van het zichtbare antwoord grofweg gelijk bleef.
Slotgedachten
Er zijn drie praktische gedragingen van Mercury 3:
-
Diffusiestreaming hanteert een ander outputcontract. Standaard streaming voegt nieuwe tekst toe, terwijl diffusiestreaming opeenvolgende full-response-staten retourneert die de vorige moeten vervangen.
-
Redeneertokens delen het completionbudget. Een kleine waarde voor
max_completion_tokenskan door redeneren worden opgebruikt voordat Mercury 3 een zichtbaar antwoord produceert. -
Hoger redeneereffort ruilt extra rekenwerk in voor latency. In mijn runs gebruikte hoog aanzienlijk meer gerapporteerde redeneertokens en duurde langer, zoals verwacht, terwijl de lengte van het zichtbare antwoord grofweg gelijk bleef.
Deze resultaten komen uit een klein aantal runs op één synthetische supportcase, dus ze moeten worden gezien als observaties uit deze demo en niet als algemene prestatieclaims over Mercury 3.

Ik ben een Google Developers Expert in ML (Gen AI), een Kaggle 3x Expert en een Women Techmakers Ambassador met meer dan 3 jaar ervaring in tech. In 2020 heb ik een healthtech-startup mee opgericht en ik volg een master computer science aan Georgia Tech, met als specialisatie machine learning.
Mercury 3 FAQ’s
Wat is het belangrijkste verschil tussen standaard streaming en diffusiestreaming in Mercury 3?
Bij standaard streaming komt de response binnen als tekstchunks die aan elkaar worden toegevoegd. Bij diffusiestreaming toont de API opeenvolgende revisies van de huidige response, dus de laatste staat moet de vorige vervangen in plaats van eraan te worden toegevoegd.
Levert reasoning_effort="high" altijd een beter antwoord op?
Nee. Een hoger redeneereffort geeft Mercury meer ruimte om te redeneren, maar dat garandeert niet voor elke taak een beter antwoord. In deze demo gebruikte hoog aanzienlijk meer redeneertokens en duurde langer, terwijl de lengte van het zichtbare antwoord vergelijkbaar bleef. Het was ook consequenter in het benoemen van één ontbrekend stuk bewijs, maar het experiment was te klein om bredere kwaliteitsclaims te doen.
Waarom kan Mercury 3 geen zichtbaar antwoord teruggeven als max_completion_tokens te klein is?
Redeneertokens tellen mee voor hetzelfde completion-tokenbudget als het zichtbare antwoord. Als het model het grootste deel of al dat budget tijdens het redeneren verbruikt, kan het de completielimiet bereiken voordat er zichtbare output is. In dat geval helpt het controleren van finish_reason en het gerapporteerde gebruik van redeneertokens om te verklaren wat er gebeurde.
Is diffusiestreaming altijd sneller dan standaard streaming?
Nee. In deze demo had diffusiestreaming een lagere mediane tijd tot eerste zichtbare output en lagere mediane totale latency, maar de bereiken overlapten en een andere prompt gaf de tegenovergestelde volgorde. Het betrouwbaardere verschil is het streaminggedrag, niet gegarandeerde latencyverbetering.
Wanneer moet ik Mercury 3 gebruiken?
Mercury 3 is vooral interessant voor latency-gevoelige applicaties waarbij gebruikers baat hebben bij snelle responses terwijl het model nog steeds niet-triviaal redeneert. Het juiste redeneereffort en completionbudget hangen af van de taak, dus die moeten worden afgestemd op zowel latency als antwoordkwaliteit.


Mercury 3 is een diffusie-LLM (Large Language Model) van Inception.ai. In tegenstelling tot conventionele autoregressieve LLM’s die tekst token voor token genereren, gebruikt Mercury diffusie om meerdere delen van zijn antwoord iteratief te verfijnen. Het model presteert beter dan GPT-6 Luna en Claude Haiku 5.5, draait 4–8x sneller met 1.000+ tokens per seconde op NVIDIA GPU’s en ondersteunt een contextvenster van 1M tokens.
In deze tutorial bouwen we een kleine assistent voor incidentanalyse die applicatielogs, deploymentinformatie, GPU-metrics en requesttraces ontvangt. Vervolgens gebruiken we dezelfde taak om twee eigenschappen van Mercury 3 te verkennen:
Hoe diffusiestreaming verschilt van normale LLM-streaming
Wat er verandert als we
reasoning_effortverhogen van laag naar hoogOnderweg komen we ook een belangrijk tokenbudget-probleem tegen dat van belang is bij het gebruik van Mercury’s redeneermodi. Aan het eind weet je hoe je:
Volledige code-repository.
Wat is Mercury 3?
In tegenstelling tot conventionele autoregressieve LLM’s die strikt van links naar rechts een antwoord genereren, behoort Mercury tot een familie modellen die tijdens het genereren meerdere tokenposities iteratief verfijnen. De aanpak van Inception is bij uitstek geschikt voor latency-gevoelige workloads zoals agents, zoeken, klantenservice, onderwijs en andere toepassingen waar herhaalde modelcalls snel kunnen optellen.
Mercury 3 combineert dat diffusiegebaseerde generatieproces met mogelijkheden die je verwacht van een algemene API, waaronder long-contextinput, besturing van redeneren, tool-calling, gestructureerde output en OpenAI-compatibele endpoints. Het biedt ook een streamingmodus
diffusing=Truewaarmee applicaties de tussentijdse full-text verfijningsstaten van het model kunnen ontvangen in plaats van alleen append-only outputblokken.Op het moment van schrijven ondersteunt Mercury 3 het volgende:
Eigenschap
Mercury 3
Contextvenster
1M tokens
Maximale output
131.072 tokens
Redeneereffort
instant, low, medium, high
Tool-calling
Ondersteund
Gestructureerde output
Ondersteund
Streaming
Ondersteund
Diffusiestreaming
Ondersteund
Temperatuur
0,5–1,0
API
OpenAI-compatibel
Inception vermeldt Mercury 3 momenteel voor een lanceringsprijs van $0,10 per miljoen inputtokens, $0,01 per miljoen gecachte inputtokens en $0,35 per miljoen outputtokens. De gecachte tokens zijn ook 90% goedkoper dan de inputprijs.
Mercury 3 is 40x groter dan Mercury 1 en veel intelligenter, maar net zo snel.
Figuur: Modelkwaliteit vs. modelgrootte (Bron)
Hoe werkt Mercury 3?
De meeste LLM’s genereren tekst autoregressief van links naar rechts, één token per keer. Zo genereren traditionele LLM’s tekst:
Elke nieuwe token hangt af van alles wat ervoor is gegenereerd.
Mercury gebruikt in plaats daarvan diffusie.
Inception beschrijft zijn diffusie-LLM’s als Transformer-gebaseerde modellen die een output stapsgewijs verbeteren door meerdere tokens parallel aan te passen. Eerder Mercury-onderzoek beschrijft dit als een coarse-to-fine generatieproces in plaats van strikt links-naar-rechts next-tokenvoorspelling.
Een vereenvoudigde illustratie zou er zo uit kunnen zien: