

Это лишь концептуальный пример, а не точное внутреннее представление Mercury 3.
API Inception может предоставлять эти промежуточные состояния. При обычном стриминге Mercury возвращает блоки уточнённого текста, которые можно добавлять к ответу. При diffusing=True каждый фрагмент вместо этого содержит полную текущую версию ответа по мере его уточнения моделью.
Скоро увидим разницу.
Демо: создаём помощника эскалации обращений в реальном времени
Перед созданием демо отделим настройки модели от самого приложения поддержки.
Случай поддержки — это лишь входные данные для проверки Mercury 3. Важные настройки на стороне модели — бюджет рассуждений, бюджет завершения и режим стриминга.
|
Настройка |
Используемое значение |
Почему это важно |
|
Температура |
0,75 |
Фиксируем, чтобы не менять сэмплирование при сравнении режимов |
|
Степень рассуждений |
low, high |
Позволяет сравнить скрытое использование рассуждений и задержку |
|
Бюджет завершения |
8192 |
Достаточен для измерений в демо-запусках |
|
Обычный стриминг |
stream=True |
Возвращает добавляемые текстовые блоки |
|
Диффузионный стриминг |
stream=True, diffusing=True |
Возвращает последовательные состояния уточнения полного текста |
|
Промпт |
Фиксированный случай поддержки |
Сохраняет задачу неизменной при смене настроек модели |
|
Повторы |
5 на условие |
Показывает вариативность между запусками вместо опоры на один запрос |
Это рабочие настройки для этого эксперимента, а не глобально оптимальные параметры Mercury 3.
Шаг 1. Предварительные требования
Начать работу с Mercury 3 — это всего несколько шагов. Чтобы повторить примеры, вам понадобится:
- Ключ API Inception
- Python 3
- Пакет inceptionai
- Случай поддержки, сохранённый как
case_support.json
Начните с регистрации на платформе Inception и получения ключа API. Нажмите Get Started и заполните данные:
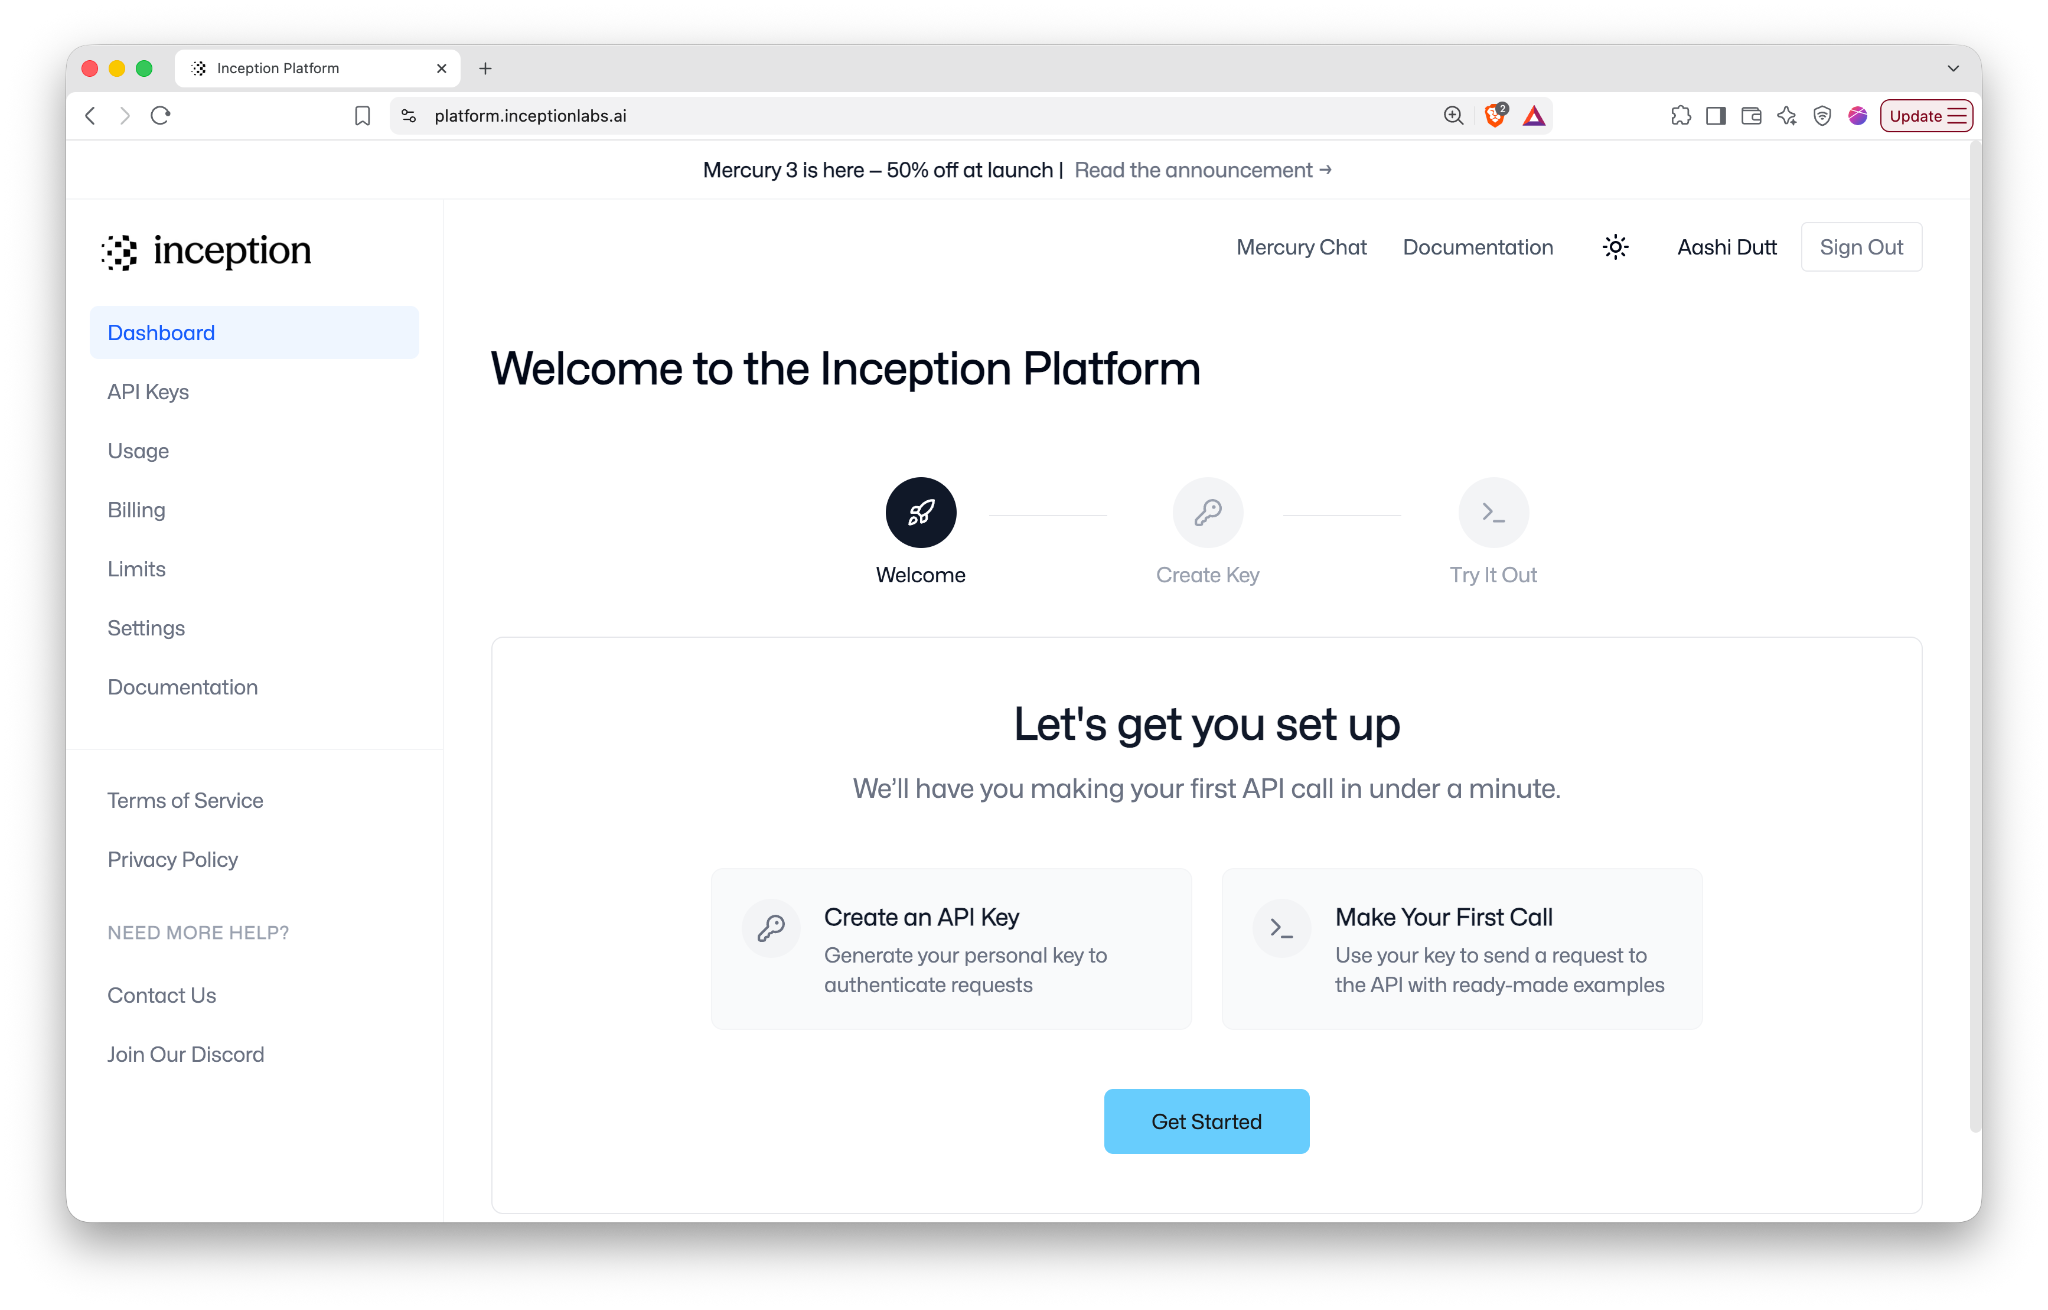
Примечание: на момент написания Inception предоставляет 100 миллионов бесплатных токенов новым аккаунтам для тестирования API.
Вы можете назвать свой ключ API или просто пропустить этот шаг и нажать Create Key.
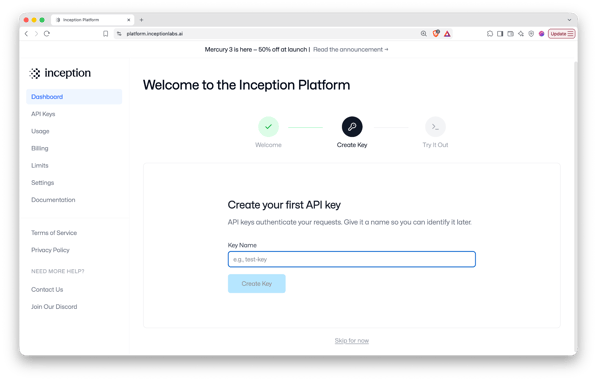
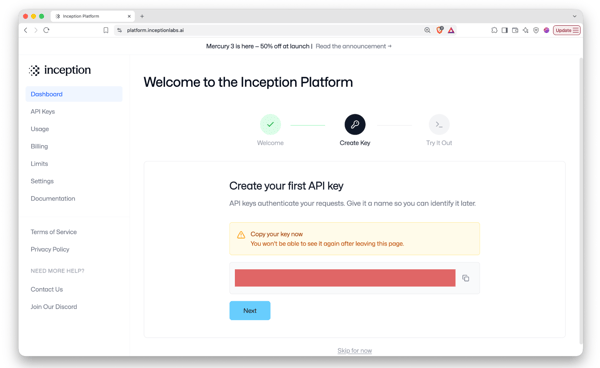
Далее скопируйте ключ API и выполните первый вызов API.
Шаг 2. Попробуйте Mercury 3
До написания кода вы можете протестировать Mercury 3 прямо на платформе Inception. После создания ключа API нажмите Next и выберите кнопку Run it now на вкладке Try It Out.
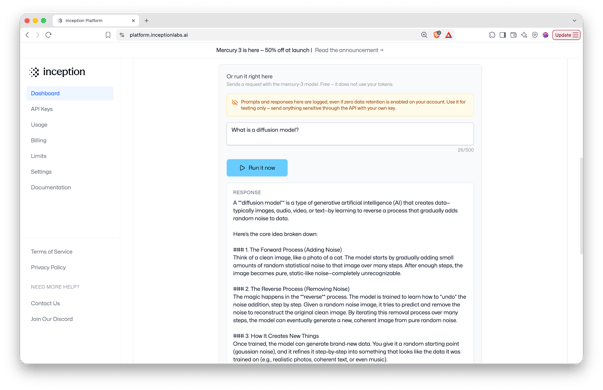
Это полезно для быстрой проверки промптов и настроек модели перед их переносом в приложение.
Шаг 3. Подготовьте окружение и выполните вызов API
Далее в руководстве мы будем вызывать Mercury 3 из Python. Начните с установки SDK inception и экспорта ключа API следующим образом:
!pip install -q inceptionaiЗатем импортируйте пакеты, используемые в демо:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass запрашивает ключ API без его отображения, os помещает его туда, где SDK его ожидает, Path и json загружают case_support.json и сериализуют его в промпт, а time.perf_counter() фиксирует момент поступления каждого ответа и состояния уточнения.
difflib сравнивает последовательные диффузионные состояния, а clear_output() заменяет вывод ячейки, чтобы проигрывание происходило на месте, а не накапливалось вниз по странице.
Если ключ API ещё не задан, можно запросить его интерактивно:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() считывает ключ API из окружения. Прочие импорты: time фиксирует моменты поступления состояний уточнения, difflib помогает сравнивать промежуточный текст, а clear_output() позволяет воспроизводить процесс диффузии на месте.
Шаг 4. Сформируйте сообщения для модели
Случай поддержки хранится отдельно в case_support.json. Файл содержит сообщение клиента, информацию о заказе, записи платежей, логи исполнения, политику поддержки и промпты, которые мы хотим использовать в этом сценарии.
Можно создать свой файл или использовать приведённый:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Теперь загрузим JSON-файл:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Перед отправкой в Mercury 3 отделим конфигурацию промпта от доказательной базы:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]Ключи system_prompt, task_prompt и packet_label управляют тем, как мы инструктируем Mercury, поэтому они удаляются из доказательной базы перед сериализацией самого кейса. Теперь можно подготовить итоговые сообщения:
messages = build_messages(case)Здесь нет системы извлечения или внешних инструментов. Всё, что нужно Mercury для анализа, передаётся непосредственно в запросе.
Шаг 5. Выполните запрос к Mercury 3
Перед тестированием стриминга сделаем обычный несмежный (нестриминговый) запрос. Следующий помощник оборачивает вызов API Mercury и записывает метаданные ответа:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Теперь определим вызов модели:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}Основные настройки на стороне модели:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensТеперь можно сделать базовый вызов:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury получает полный кейс поддержки и возвращает запрошенный анализ, включая наиболее вероятное объяснение, подтверждающие доказательства, альтернативные объяснения, неопределённости и рекомендуемые следующие действия.
Функция также записывает поля elapsed_s и usage. Первое измеряет общее время запроса от начала до конца, второе — включает учёт токенов, в том числе сообщаемое использование токенов рассуждения.
Во всех запусках для этого руководства Mercury стабильно определял вторую платёжную запись как наиболее вероятную ожидающую авторизацию, а не доказательство подтверждённого второго заказа. Однако в кейсе намеренно недостаточно информации, чтобы понять, исчезнет ли эта ожидающая авторизация или будет захвачена.
Шаг 6. Добавьте стандартный стриминг
Обычный запрос ждёт завершения Mercury перед возвратом полного ответа. Чтобы получать ответ постепенно, нужно включить stream=True. Функция стандартного стриминга выглядит так:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Здесь важно поведение chunks.append(content) при стандартном стриминге: каждый фрагмент содержит следующую часть ответа, поэтому фрагменты можно накапливать и собирать финальный ответ с помощью "".join(chunks).
Примечание: медиана времени до первого видимого вывода — 2,903 секунды, медианная общая задержка — 3,375 секунды.
Шаг 7. Переключитесь на диффузионный стриминг
Чтобы включить диффузионный стриминг, установите следующие параметры в True:
stream=True
diffusing=TrueВызов API отличается от стандартного стриминга лишь одним дополнительным аргументом — diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}При стандартном стриминге фрагменты добавляются. При диффузионном же последний непустой фрагмент представляет текущую полную версию ответа. Поэтому вместо добавления мы заменяем ранее отображённый текст.
Мы также сохраняем возвращённые состояния, чтобы измерить их количество и проверить, действительно ли более поздние состояния пересматривают ранее показанный текст.
За пять запусков диффузионный стриминг вернул медиану из 9 видимых состояний уточнения (диапазон 7–12). Медиана времени до первого видимого состояния — 1,896 секунды, медианная общая задержка — 2,560 секунды.
Шаг 8. Сравните стандартный и диффузионный стриминг
Поняв оба варианта, можно сравнить измеренное поведение.
|
Метрика |
Стандарт |
Диффузия |
|
Медиана фрагментов/состояний |
6 |
9 |
|
Диапазон |
5–7 |
7–12 |
|
Медиана времени до первого вывода |
2,903 с |
1,896 с |
|
Медианная общая задержка |
3,375 с |
2,560 с |
Для этого конкретного промпта диффузия показала меньшую медианную задержку, но диапазоны существенно перекрываются. Поэтому не стоит делать вывод, что диффузионный стриминг по природе быстрее.
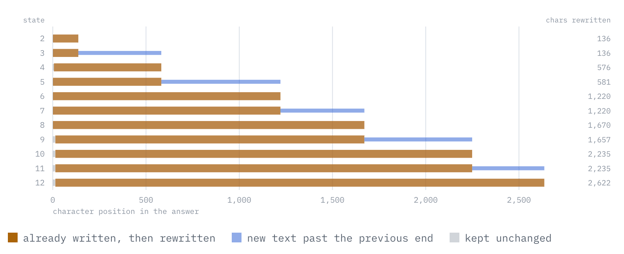
Рисунок: запуск с 12 состояниями, переход за переходом. Коричневая полоса — текст, который Mercury 3 уже написал и затем заменил, синяя полоса — новый текст за предыдущим концом. При чистом добавлении коричневого не было бы вовсе.
В моих запусках возвращаемые диффузионные состояния пересматривали ранее видимый текст, а не вели себя как фрагменты только для добавления. В приведённом запуске ни один из 11 переходов состояний не был чистым добавлением, и каждый расходился с предыдущим состоянием в пределах первых 14 символов.
Шаг 9. Протестируйте бюджет завершения
Далее посмотрим на поведение Mercury 3 с точки зрения того, как токены рассуждений взаимодействуют с бюджетом завершения. В обычных вызовах выше используется max_completion_tokens=8192, но чтобы нагляднее показать поведение, снизим max_completion_tokens до 1600.
Теперь выполните тот же запрос один раз с низкой и один раз с высокой степенью рассуждений. Вот измеренный результат:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneПри высокой степени все 1 539 токенов завершения были отмечены как токены рассуждения. Следовательно, модель достигла лимита завершения до возврата видимого текста ответа.
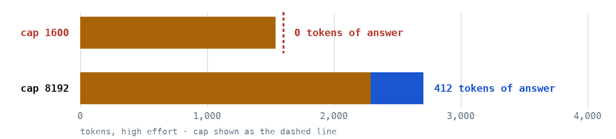
Рисунок: Бюджет завершения при высокой степени при лимитах 1 600 и 8 192 токена
При лимите 1 600 весь бюджет ушёл на рассуждения, и ничего не осталось для вывода. При 8 192 медианный запуск с высокой степенью потратил 2 292 токена на рассуждения и всё ещё оставил место для ответа в 412 токенов. Лимит 8 192 выходит за правый край этой шкалы, поэтому пунктирная линия лимита показана только в первой строке на изображении выше.
Важный сигнал в неудачном запросе с высокой степенью — response.choices[0].finish_reason, вернувший length. Это означает, что запрос достиг максимального бюджета токенов завершения (max_completion_tokens). Этот бюджет включает и токены рассуждения, и видимые токены вывода. В этом запуске Mercury 3 отметил все 1 539 токенов завершения как токены рассуждения, поэтому запрос достиг лимита завершения до генерации видимого ответа.
Примечание: для этого демо max_completion_tokens=8192 было достаточно для оставшихся запусков, но не стоит рассматривать это как универсальный минимум.
Шаг 10. Сравните низкую и высокую степень рассуждений
Вернёмся к обычному бюджету завершения 8192 и будем менять только reasoning_effort между low и high. Используем помощник run_nonstream() из шага 5, чтобы сделать один запрос с низкой степенью рассуждений и другой — с высокой:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Для представленных результатов каждая конфигурация повторялась пять раз, а не полагалась на один запрос.
Медианные значения:
|
Метрика |
Low |
High |
|
Сквозная задержка |
2,936 с |
8,146 с |
|
Токены завершения |
1312 |
2723 |
|
Токены рассуждения |
828 |
2292 |
|
Примерно видимых токенов |
468 |
412 |
|
Доля рассуждений |
63% |
84% |
Медианное использование рассуждений выросло с 828 до 2 292 токенов, а медианная задержка — с 2,936 до 8,146 секунды (примерно в 2,77 раза).
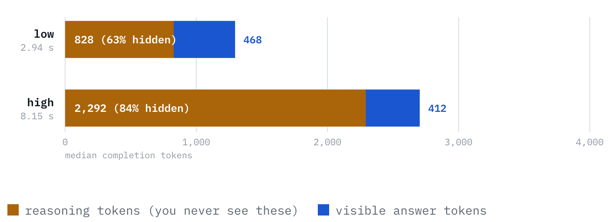
Рисунок: Куда уходит бюджет завершения на каждом уровне усилия?
Длина видимого ответа изменилась не так сильно:
- Low: медиана 468 токенов
- High: медиана 412 токенов
и наблюдаемые диапазоны перекрывались:
- Low: 393–494
- High: 356–469
Таким образом, эти запуски не подтверждают утверждение, что повышение степени рассуждений делает видимый ответ короче. Диапазоны задержек также показывают, почему одного запуска недостаточно:
- Low: 1,602–4,993 с
- High: 4,102–9,068 с
Примечание: самый быстрый запрос с высокой степенью оказался быстрее самого медленного с низкой.
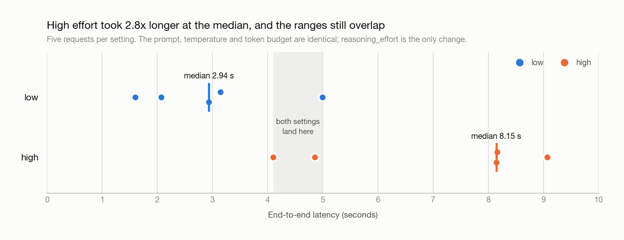
Рисунок: Все десять запросов с разной степенью рассуждений, распределение по задержке
Итак, reasoning_effort="high" существенно увеличил сообщаемое использование токенов рассуждения и задержку в этом эксперименте, в то время как длина видимого ответа в целом осталась схожей.
Заключение
Есть три практических поведения Mercury 3:
-
Диффузионный стриминг использует иной контракт вывода. Обычный стриминг добавляет новый текст, тогда как диффузионный возвращает последовательные состояния полного ответа, которые должны заменять предыдущее.
-
Токены рассуждения делят бюджет завершения. Малое значение
max_completion_tokensможет быть исчерпано рассуждениями до того, как Mercury 3 выдаст видимый ответ. -
Более высокая степень рассуждений меняет вычислительные затраты на задержку. В моих запусках высокая степень заметно увеличивала сообщаемые токены рассуждения и время, как и ожидалось, при этом длина видимого ответа оставалась в целом схожей.
Эти результаты получены на небольшом числе запусков с одним синтетическим кейсом поддержки, поэтому их следует рассматривать как наблюдения из этого демо, а не как общие утверждения о производительности Mercury 3.
Частые вопросы о Mercury 3
В чём основное отличие стандартного стриминга от диффузионного в Mercury 3?
При стандартном стриминге ответ приходит в виде текстовых фрагментов, которые добавляются друг к другу. При диффузионном стриминге API предоставляет последовательные редакции текущего ответа, поэтому последнее состояние должно заменять предыдущее, а не добавляться к нему.
Гарантирует ли reasoning_effort="high" всегда лучший ответ?
Нет. Более высокая степень рассуждений даёт Mercury больше пространства для рассуждений, но это не гарантирует лучший ответ для каждой задачи. В этом демо высокая степень заметно увеличила число токенов рассуждения и время, а длина видимого ответа осталась похожей. Она также последовательнее указывала на один недостающий фрагмент доказательств, однако эксперимент слишком мал, чтобы делать широкие выводы о качестве.
Почему Mercury 3 может не вернуть видимый ответ, если max_completion_tokens слишком мал?
Токены рассуждения засчитываются в тот же бюджет токенов завершения, что и видимый ответ. Если модель расходует большую часть или весь бюджет на рассуждения, она может достичь лимита завершения до вывода видимого текста. В таком случае проверка finish_reason и отчёта по использованию токенов рассуждения помогает понять, что произошло.
Всегда ли диффузионный стриминг быстрее стандартного?
Нет. В этом демо диффузионный стриминг показал меньшую медиану времени до первого видимого вывода и меньшую медианную общую задержку, но диапазоны перекрывались, а другой промпт дал обратный порядок. Более надёжное отличие — поведение стриминга, а не гарантированное улучшение задержки.
Когда стоит использовать Mercury 3?
Mercury 3 особенно интересен для приложений, чувствительных к задержке, где пользователям важны быстрые ответы при нетривиальных рассуждениях модели. Подходящая степень рассуждений и бюджет завершения зависят от задачи, поэтому их стоит настраивать с учётом и задержки, и качества ответа.
Mercury 3 — это диффузионная большая языковая модель от Inception.ai. В отличие от традиционных авторегрессионных LLM, которые генерируют текст по одному токену за раз, Mercury использует диффузию, итеративно уточняя несколько частей ответа. Модель превосходит GPT-6 Luna и Claude Haiku 5.5, при этом работает в 4–8 раз быстрее со скоростью более 1 000 токенов в секунду на GPU NVIDIA и поддерживает контекстное окно в 1 млн токенов.
В этом руководстве мы создадим небольшого помощника для анализа инцидентов, который получает журналы приложений, информацию о развёртывании, метрики GPU и трассировки запросов. Затем на той же задаче изучим две особенности Mercury 3:
Чем потоковая передача при диффузии отличается от обычного стриминга LLM
Что меняется при повышении параметра
reasoning_effortс низкого на высокий?По пути мы также столкнёмся с важной проблемой бюджета токенов, которая имеет значение при использовании режимов рассуждения Mercury. К концу вы узнаете, как:
Полный репозиторий с кодом.
Что такое Mercury 3?
В отличие от традиционных авторегрессионных LLM, которые генерируют ответ строго слева направо, Mercury относится к семейству моделей, итеративно уточняющих несколько позиций токенов в процессе генерации. Подход Inception лучше всего подходит для задач, чувствительных к задержке, таких как агенты, поиск, поддержка клиентов, образование и другие приложения, где повторные вызовы модели быстро накапливаются.
Mercury 3 сочетает диффузионную генерацию с возможностями, ожидаемыми от универсальной API-модели: поддержка длинного контекста, управление рассуждениями, вызов инструментов, структурированные ответы и совместимость с конечными точками OpenAI. Также доступен режим стриминга
diffusing=True, позволяющий приложениям получать промежуточные состояния полного текста уточнения модели, а не только добавляемые блоки.На момент написания Mercury 3 поддерживает следующее:
Свойство
Mercury 3
Контекстное окно
1M токенов
Максимальный вывод
131 072 токена
Степень рассуждений
instant, low, medium, high
Вызов инструментов
Поддерживается
Структурированный вывод
Поддерживается
Стриминг
Поддерживается
Диффузионный стриминг
Поддерживается
Температура
0,5–1,0
API
Совместим с OpenAI
Inception сейчас указывает цену запуска Mercury 3: $0,10 за миллион входных токенов, $0,01 за миллион кэшированных входных токенов и $0,35 за миллион выходных токенов. Кэшированные токены также стоят на 90% дешевле входных.
Mercury 3 в 40 раз больше Mercury 1 и значительно умнее, но столь же быстр.
Рисунок: Качество модели vs размер модели (Источник)
Как работает Mercury 3?
Большинство LLM генерируют текст авторегрессионно слева направо, по одному токену. Вот как традиционные LLM генерируют текст:
Каждый новый токен зависит от всего ранее сгенерированного.
Mercury же использует диффузию.
Inception описывает свои диффузионные LLM как модели на базе Transformer, которые постепенно улучшают выходной текст, изменяя несколько токенов параллельно. Более ранние исследования Mercury называют это процессом генерации от грубого к тонкому, а не строго левонаправленным предсказанием следующего токена.
Упрощённая иллюстрация может выглядеть так: