

Esto es solo un ejemplo conceptual, no la representación interna exacta de Mercury 3.
La API de Inception puede exponer estos estados intermedios. Con el streaming normal, Mercury devuelve bloques de texto refinado que se pueden anexar a la respuesta. Con diffusing=True, cada fragmento contiene en su lugar la versión completa actual de la respuesta a medida que el modelo la refina.
Veremos la diferencia en un momento.
Demo: crea un asistente de escalado de soporte en tiempo real
Antes de construir la demo, separemos la configuración del modelo de la propia aplicación de soporte.
El caso de soporte es solo la entrada que usamos para poner a prueba Mercury 3. Los controles importantes del lado del modelo son el presupuesto de razonamiento, el presupuesto de finalización y el modo de streaming.
|
Ajuste |
Valor usado |
Por qué importa |
|
Temperatura |
0,75 |
Se mantiene fija para no cambiar el muestreo al comparar modos |
|
Esfuerzo de razonamiento |
low, high |
Nos permite comparar uso de razonamiento oculto y latencia |
|
Presupuesto de finalización |
8192 |
Suficiente para las ejecuciones medidas de la demo |
|
Streaming estándar |
stream=True |
Devuelve bloques de texto anexables |
|
Streaming por difusión |
stream=True, diffusing=True |
Devuelve sucesivos estados de refinamiento de texto completo |
|
Prompt |
Caso de soporte fijo |
Mantiene la tarea constante mientras cambian los ajustes del modelo |
|
Repeticiones |
5 por condición |
Muestra la variación entre ejecuciones en lugar de depender de una sola petición |
Estos son ajustes de trabajo para este experimento, no configuraciones óptimas globales de Mercury 3.
Paso 1: requisitos previos
Empezar con Mercury 3 lleva solo unos pasos. Para seguirlo, necesitas:
- Una clave de API de Inception
- Python 3
- El paquete inceptionai
- El caso de soporte guardado como
case_support.json
Empieza registrándote en la plataforma de Inception y obteniendo la clave de API. Haz clic en Get Started y completa tus datos:
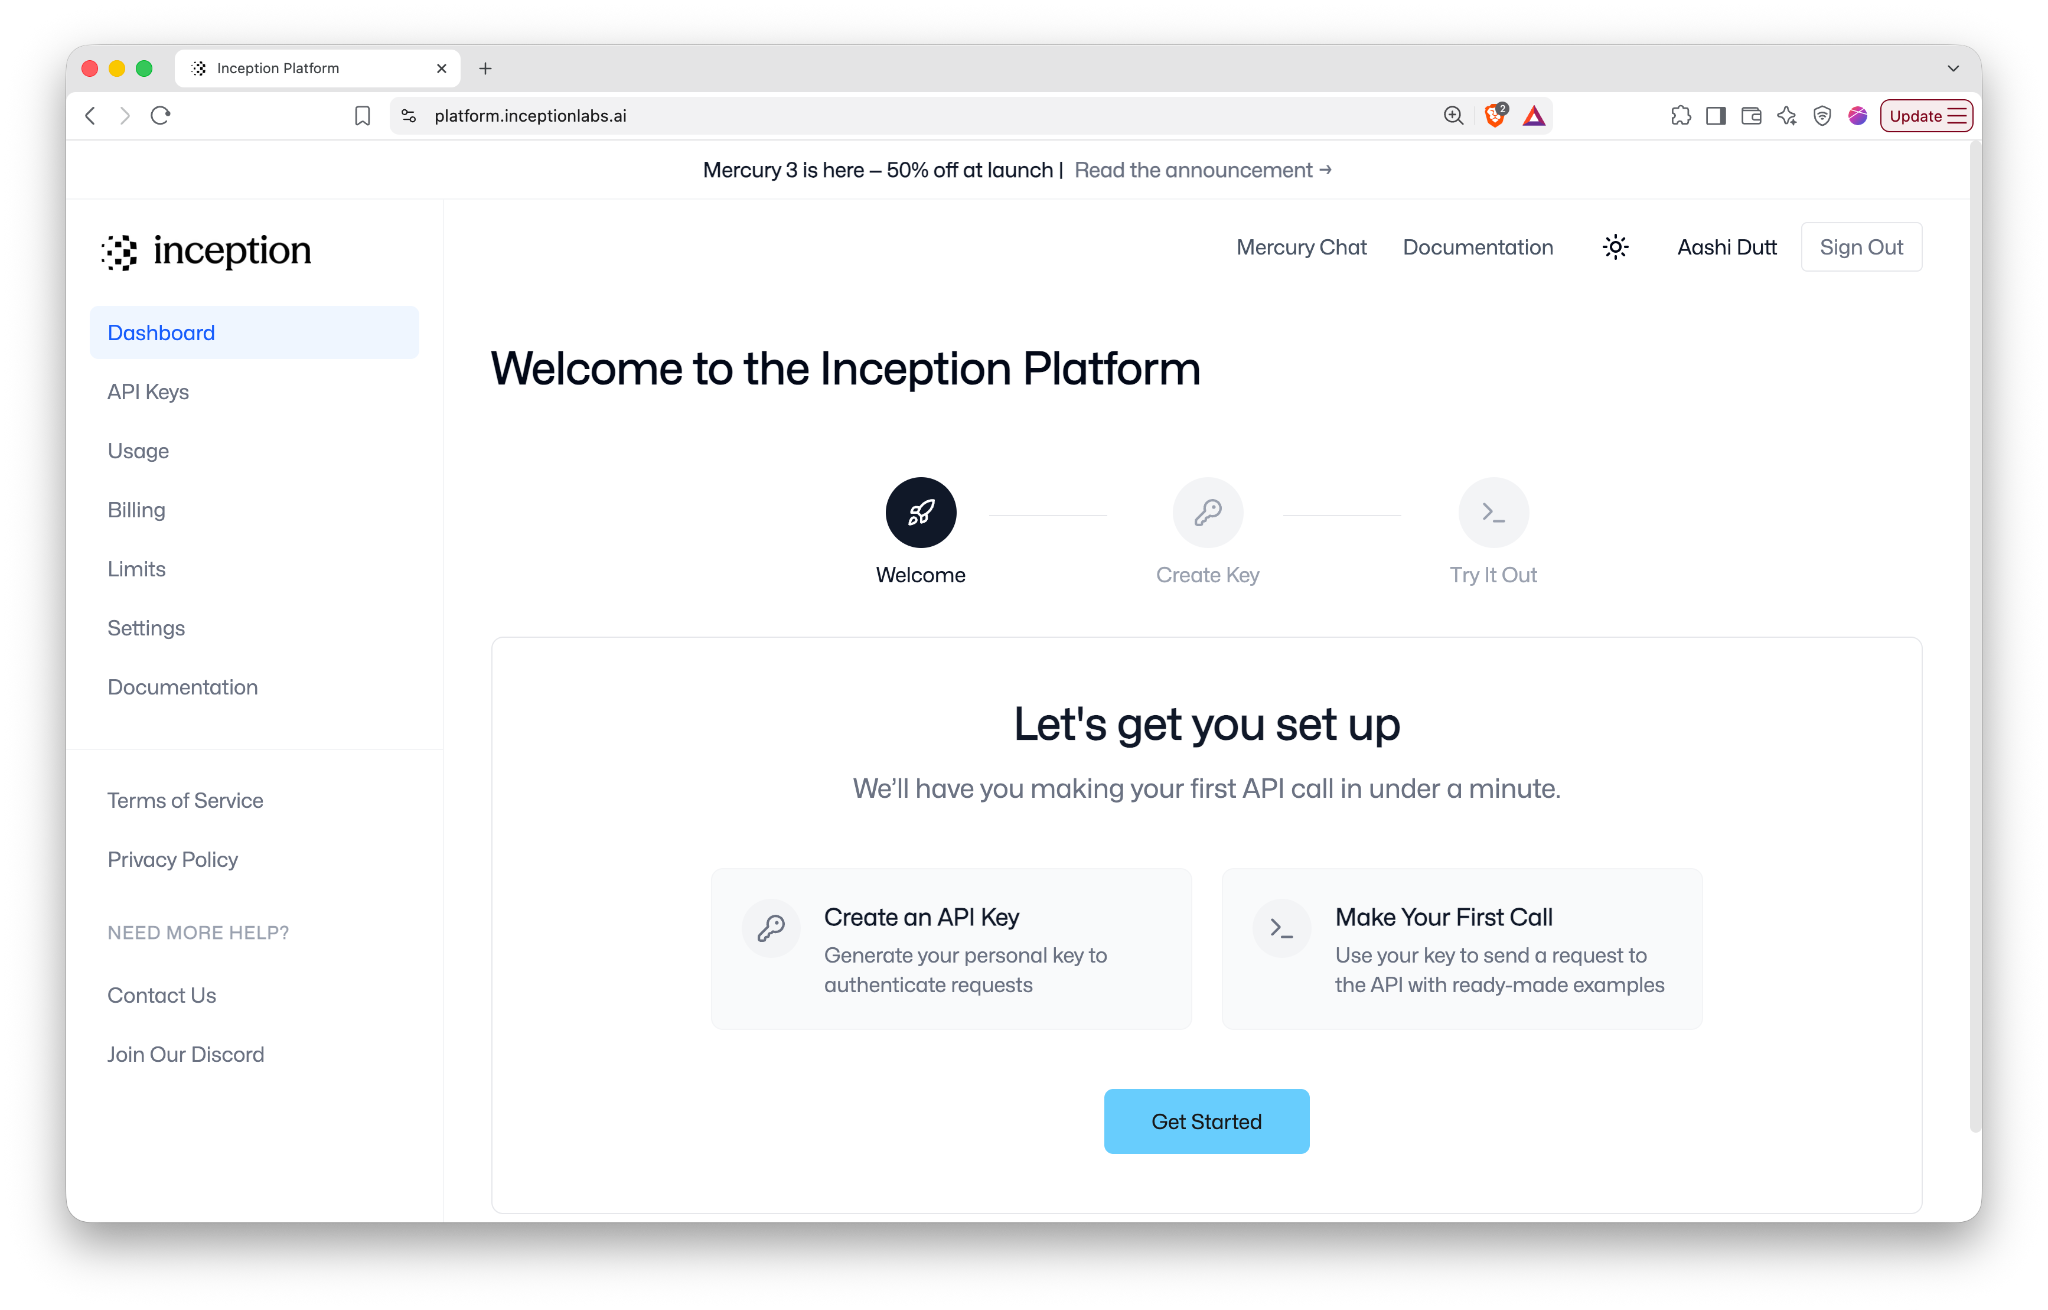
Nota: en el momento de escribir esto, Inception ofrece 100 millones de tokens gratis a las cuentas nuevas para probar la API.
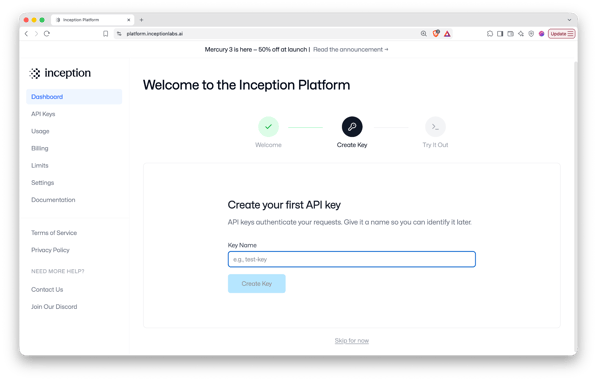
Puedes ponerle nombre a tu clave de API o simplemente saltarte este paso y hacer clic en Create Key.
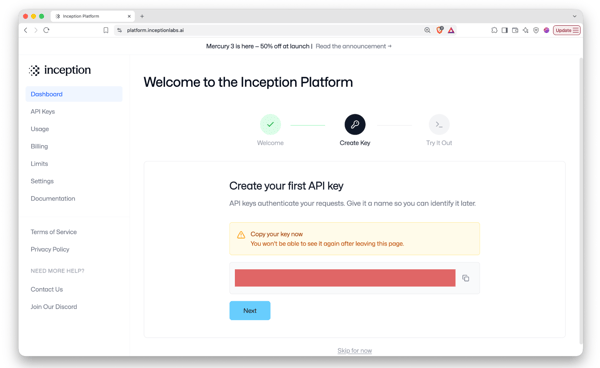
A continuación, copia la clave de API y haz tu primera llamada a la API.
Paso 2: prueba Mercury 3
Antes de escribir código, puedes probar Mercury 3 directamente desde la plataforma de Inception. Tras crear tu clave de API, haz clic en Next y selecciona el botón Run it now en la pestaña Try It Out.
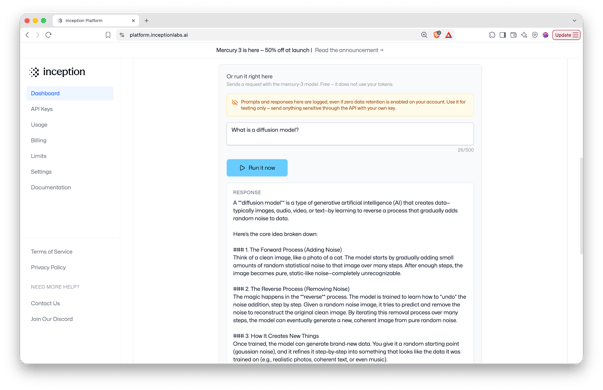
Esto es útil para probar rápidamente prompts y ajustes del modelo antes de llevarlos a una aplicación.
Paso 3: prepara el entorno y haz una llamada a la API
Para el resto del tutorial, llamaremos a Mercury 3 desde Python. Empieza instalando el SDK de Inception y exportando la clave de API así:
!pip install -q inceptionaiDespués importa los paquetes que usa la demo:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass pide la clave de API sin mostrarla, os la coloca donde el SDK la busca, Path y json cargan case_support.json y lo serializan en el prompt, y time.perf_counter() registra cuándo llega cada respuesta y estado de refinamiento.
difflib compara estados de difusión consecutivos y clear_output() sustituye la salida de la celda para que la reproducción ocurra en el mismo sitio en lugar de apilarse hacia abajo.
Si la clave de API no está ya definida, puedes pedirla de forma interactiva:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() lee la clave de API del entorno. Mientras que el resto de importaciones, como time, registran cuándo llegan los estados de refinamiento, difflib ayuda a comparar texto intermedio y clear_output() permite reproducir el proceso de difusión en el mismo sitio.
Paso 4: construye los mensajes del modelo
El caso de soporte se guarda por separado en case_support.json. El archivo del caso contiene el mensaje del cliente, la información del pedido, los registros de pago, los logs de fulfillment, la política de soporte y los prompts que queremos usar para este escenario.
Puedes crear el tuyo o usarlo tal cual:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Ahora, carguemos el archivo JSON:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Antes de enviarlo a Mercury 3, separamos la configuración del prompt de las evidencias:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]Las claves system_prompt, task_prompt y packet_label controlan cómo instruimos a Mercury, por lo que se eliminan de las evidencias antes de serializar el propio caso. Ya podemos preparar los mensajes finales:
messages = build_messages(case)Aquí no hay sistema de recuperación ni herramienta externa. Todo lo que Mercury necesita para este análisis se suministra directamente en la petición.
Paso 5: haz una petición a Mercury 3
Antes de probar el streaming, hagamos una petición normal sin streaming. El siguiente helper envuelve la llamada a la API de Mercury y registra los metadatos de la respuesta:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Ahora definamos una llamada al modelo:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}Los principales controles del lado del modelo son:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensYa podemos hacer una llamada de referencia:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury recibe el caso de soporte completo y devuelve el análisis solicitado, incluida la explicación más probable, evidencias que la respaldan, explicaciones alternativas, incertidumbres y las próximas acciones recomendadas.
La función también registra los campos elapsed_s y usage. El primero mide el tiempo total de la petición de extremo a extremo, mientras que el otro incluye la contabilidad de tokens, incluido el uso informado de tokens de razonamiento.
En las ejecuciones usadas en este tutorial, Mercury identificó de forma consistente que el segundo registro de pago probablemente era una autorización pendiente y no evidencia de un segundo pedido confirmado. Sin embargo, el caso carece deliberadamente de información suficiente para saber si esa autorización pendiente desaparecerá o se capturará.
Paso 6: añade streaming estándar
Una petición normal espera a que Mercury termine antes de devolver la respuesta completa. Para recibir la respuesta de forma incremental, debemos activar stream=True. La función de streaming estándar es así:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}El comportamiento importante aquí es chunks.append(content) en el streaming estándar, donde cada fragmento contiene la siguiente parte de la respuesta, por lo que los fragmentos pueden acumularse y reconstruirse en la respuesta final con "".join(chunks).
Nota: la mediana del tiempo hasta la primera salida visible fue de 2,903 segundos, mientras que la mediana de la latencia total fue de 3,375 segundos.
Paso 7: cambia al streaming por difusión
Para activar el streaming por difusión, establece los siguientes parámetros en True:
stream=True
diffusing=TrueLa llamada a la API difiere del streaming estándar solo en un argumento adicional, es decir, diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}Con el streaming estándar, los fragmentos se van anexando. Sin embargo, con el streaming por difusión, el último fragmento no vacío representa la versión completa actual de la respuesta. Así que, en lugar de anexarlo, sustituimos lo que se mostró antes.
También guardamos los estados devueltos para medir el número de estados de refinamiento y comprobar si los estados posteriores realmente revisan texto que apareció antes.
En cinco ejecuciones, el streaming por difusión devolvió una mediana de 9 estados de refinamiento visibles, con un rango de 7–12. La mediana del tiempo hasta el primer estado visible fue de 1,896 segundos, y la latencia total mediana fue de 2,560 segundos.
Paso 8: compara el streaming estándar y el de difusión
Ahora que entendemos ambas rutas de código, podemos comparar el comportamiento medido.
|
Métrica |
Estándar |
Difusión |
|
Mediana de fragmentos/estados |
6 |
9 |
|
Rango |
5–7 |
7–12 |
|
Mediana primer resultado visible |
2,903 s |
1,896 s |
|
Mediana latencia total |
3,375 s |
2,560 s |
La difusión tuvo menor latencia mediana para este prompt de soporte en particular, pero los rangos se solapan bastante. Así que no deberíamos concluir que el streaming por difusión es intrínsecamente más rápido.
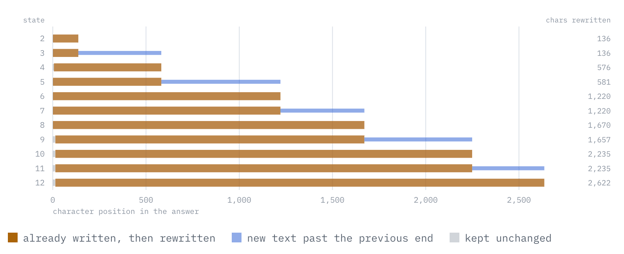
Figura: ejecución de 12 estados, transición a transición. La barra marrón es texto que Mercury 3 ya había escrito y después sustituyó, mientras que la barra azul es el texto nuevo más allá del final previo. Un anexo puro no mostraría nada de marrón.
En mis ejecuciones, los estados de difusión devueltos revisaron texto mostrado previamente, en lugar de comportarse como fragmentos solo anexables. En la ejecución anterior, ninguna de las 11 transiciones de estado fue un anexo puro, y todas divergieron del estado anterior dentro de los primeros 14 caracteres.
Paso 9: pon a prueba el presupuesto de finalización
Ahora veamos el comportamiento de Mercury 3 respecto a cómo los tokens de razonamiento interactúan con el presupuesto de finalización. Las llamadas normales anteriores usan max_completion_tokens=8192, pero para exponer el comportamiento más claramente, debemos reducir max_completion_tokens a 1600.
Ahora, ejecuta la misma petición una vez con esfuerzo bajo y otra con esfuerzo alto de razonamiento. Este es el resultado medido:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneEn alto, los 1.539 tokens de finalización se informaron como tokens de razonamiento. Por tanto, el modelo alcanzó el límite de finalización antes de devolver texto visible de respuesta.
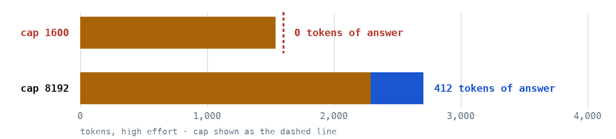
Figura: presupuesto de finalización con esfuerzo alto a un tope de 1.600 y de 8.192 tokens
Con el tope de 1.600, todo el presupuesto se destinó al razonamiento y no quedó nada para emitir. Con 8.192, la mediana de ejecuciones con esfuerzo alto empleó 2.292 tokens en razonar y aún tuvo margen para una respuesta de 412 tokens. El tope de 8.192 queda fuera del borde derecho de esta escala, por eso solo la primera fila en la imagen anterior muestra una línea discontinua de tope.
La señal importante en la petición fallida en alto es response.choices[0].finish_reason, que devolvió length. Esto significa que la petición alcanzó su presupuesto máximo de tokens de finalización (max_completion_tokens). Este presupuesto incluye tanto los tokens de razonamiento como los tokens de salida visible. En esta ejecución, Mercury 3 informó todos los 1.539 tokens de finalización como tokens de razonamiento, por lo que la petición llegó al límite de finalización antes de producir una respuesta visible.
Nota: para esta demo, max_completion_tokens=8192 fue suficiente para el resto de ejecuciones, pero no debe tratarse como un mínimo universal.
Paso 10: compara esfuerzo de razonamiento bajo y alto
Ahora vuelve al presupuesto normal de 8192 de finalización y varía solo reasoning_effort entre bajo y alto. Usaremos el helper run_nonstream() del Paso 5 para hacer una petición con esfuerzo de razonamiento bajo y otra con alto:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Para los resultados reportados, repetí cada configuración cinco veces en lugar de depender de una sola petición.
Las medianas fueron:
|
Métrica |
Bajo |
Alto |
|
Latencia de extremo a extremo |
2,936 s |
8,146 s |
|
Tokens de finalización |
1312 |
2723 |
|
Tokens de razonamiento |
828 |
2292 |
|
Tokens visibles aprox. |
468 |
412 |
|
Proporción de razonamiento |
63% |
84% |
El uso mediano de razonamiento aumentó de 828 a 2.292 tokens, mientras que la latencia mediana creció de 2,936 a 8,146 segundos (aprox. 2,77x).
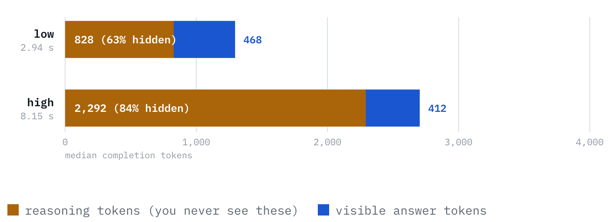
Figura: ¿en qué se gasta el presupuesto de finalización en cada nivel de esfuerzo?
La longitud de la respuesta visible no cambió tanto:
- Bajo: mediana de 468 tokens
- Alto: mediana de 412 tokens
y los rangos observados se solaparon:
- Bajo: 393–494
- Alto: 356–469
Así que estas ejecuciones no apoyan la afirmación de que aumentar el esfuerzo de razonamiento haga más corta la respuesta visible. Los rangos de latencia también muestran por qué una sola ejecución no basta:
- Bajo: 1,602–4,993 s
- Alto: 4,102–9,068 s
Nota: la petición más rápida en alto fue, de hecho, más rápida que la más lenta en bajo.
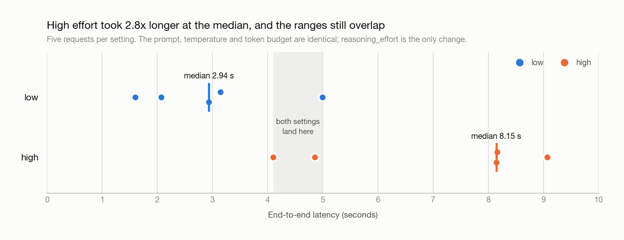
Figura: las diez peticiones con distintos esfuerzos de razonamiento trazadas por latencia
Así, reasoning_effort="high" incrementó sustancialmente los tokens de razonamiento reportados y la latencia en este experimento, mientras que la longitud de la respuesta visible se mantuvo en términos generales similar.
Reflexiones finales
Hay tres comportamientos prácticos de Mercury 3:
-
El streaming por difusión usa un contrato de salida distinto. El streaming estándar anexa texto nuevo, mientras que el streaming por difusión devuelve estados sucesivos de la respuesta completa que deben sustituir al anterior.
-
Los tokens de razonamiento comparten el presupuesto de finalización. Un valor pequeño de
max_completion_tokenspuede agotarse en el razonamiento antes de que Mercury 3 produzca una respuesta visible. -
Un mayor esfuerzo de razonamiento intercambia cómputo adicional por latencia. En mis ejecuciones, el nivel alto usó muchos más tokens de razonamiento reportados y tardó más, como era de esperar, mientras que la longitud de la respuesta visible se mantuvo en líneas generales similar.
Estos resultados proceden de un número pequeño de ejecuciones sobre un caso de soporte sintético, así que deben tratarse como observaciones de esta demo y no como afirmaciones generales de rendimiento sobre Mercury 3.

Soy experta Google Developers en ML (Gen AI), triple experta en Kaggle y embajadora de Women Techmakers, con más de tres años de experiencia en el sector tecnológico. Cofundé una startup de salud en 2020 y actualmente curso un máster en informática en Georgia Tech, con especialización en aprendizaje automático.
Preguntas frecuentes sobre Mercury 3
¿Cuál es la diferencia principal entre el streaming estándar y el streaming por difusión en Mercury 3?
Con el streaming estándar, la respuesta llega en fragmentos de texto que se van anexando. Con el streaming por difusión, la API expone revisiones sucesivas de la respuesta actual, por lo que el último estado debe sustituir al anterior en lugar de añadirse al final.
¿reasoning_effort="high" siempre produce una mejor respuesta?
No. Un mayor esfuerzo de razonamiento le da a Mercury más margen para razonar, pero eso no garantiza una mejor respuesta para cada tarea. En esta demo, el modo alto usó sustancialmente más tokens de razonamiento y tardó más, mientras que la longitud de la respuesta visible se mantuvo similar. También fue más consistente al señalar una pieza de evidencia que faltaba, pero el experimento fue demasiado pequeño para hacer afirmaciones más amplias sobre calidad.
¿Por qué puede Mercury 3 no devolver una respuesta visible cuando max_completion_tokens es demasiado pequeño?
Los tokens de razonamiento cuentan para el mismo presupuesto de tokens de finalización que la respuesta visible. Si el modelo consume la mayor parte o todo ese presupuesto al razonar, puede alcanzar el límite de finalización antes de producir salida visible. En ese caso, comprobar finish_reason y el uso de tokens de razonamiento reportado ayuda a explicar lo ocurrido.
¿El streaming por difusión es siempre más rápido que el streaming estándar?
No. En esta demo, el streaming por difusión tuvo una mediana menor de tiempo hasta la primera salida visible y de latencia total, pero los rangos se solaparon, y otro prompt produjo el orden contrario. La diferencia más fiable es el comportamiento del streaming, no una mejora garantizada de la latencia.
¿Cuándo debería usar Mercury 3?
Mercury 3 es especialmente interesante para aplicaciones sensibles a la latencia, donde las personas se benefician de respuestas rápidas mientras el modelo realiza razonamiento no trivial. El nivel adecuado de esfuerzo de razonamiento y el presupuesto de finalización dependen de la tarea, así que conviene ajustarlos en función de la latencia y la calidad de la respuesta.






Mercury 3 es un modelo de lenguaje grande por difusión desarrollado por Inception.ai. A diferencia de los LLM autoregresivos convencionales que generan texto un token cada vez, Mercury usa difusión para refinar iterativamente varias partes de su respuesta. El modelo supera a GPT-6 Luna y Claude Haiku 5.5, al tiempo que funciona entre 4 y 8 veces más rápido a más de 1.000 tokens por segundo en GPUs de NVIDIA y admite una ventana de contexto de 1 M de tokens.
En este tutorial, crearemos un pequeño asistente de análisis de incidencias que recibe logs de aplicación, información de despliegue, métricas de GPU y trazas de peticiones. Luego usaremos la misma tarea para explorar dos propiedades de Mercury 3:
Cómo el streaming por difusión se diferencia del streaming normal de LLM
¿Qué cambia cuando aumentamos
reasoning_effortde bajo a alto?Por el camino, también nos toparemos con un importante aspecto del presupuesto de tokens que importa al usar los modos de razonamiento de Mercury. Al final, sabrás cómo:
Código completo en el repositorio.
¿Qué es Mercury 3?
A diferencia de los LLM autoregresivos convencionales que generan una respuesta estrictamente de izquierda a derecha, Mercury pertenece a una familia de modelos que refinan iterativamente múltiples posiciones de tokens durante la generación. El enfoque de Inception es ideal para cargas de trabajo sensibles a la latencia como agentes, búsqueda, atención al cliente, educación y otras aplicaciones donde las llamadas repetidas al modelo se acumulan rápido.
Mercury 3 combina ese proceso de generación basado en difusión con capacidades esperables de un modelo de API de propósito general, como entrada de largo contexto, controles de razonamiento, llamadas a herramientas, salidas estructuradas y endpoints compatibles con OpenAI. También expone un modo de streaming
diffusing=Trueque permite a las aplicaciones recibir los estados intermedios de refinamiento de texto completo del modelo en lugar de solo bloques de salida anexables.En el momento de escribir esto, Mercury 3 admite lo siguiente:
Propiedad
Mercury 3
Ventana de contexto
1M tokens
Salida máxima
131.072 tokens
Esfuerzo de razonamiento
instant, low, medium, high
Llamada a herramientas
Admitida
Salida estructurada
Admitida
Streaming
Admitido
Streaming por difusión
Admitido
Temperatura
0,5–1,0
API
Compatible con OpenAI
Inception actualmente ofrece Mercury 3 a un precio de lanzamiento de 0,10 $ por millón de tokens de entrada, 0,01 $ por millón de tokens de entrada en caché y 0,35 $ por millón de tokens de salida. Los tokens en caché tienen un 90% de descuento sobre el precio de entrada.
Mercury 3 es 40 veces más grande que Mercury 1 y muchísimo más inteligente, pero igual de rápido.
Figura: calidad del modelo vs. tamaño del modelo (Fuente)
¿Cómo funciona Mercury 3?
La mayoría de LLM generan texto de forma autoregresiva de izquierda a derecha, un token cada vez. Así generan texto los LLM tradicionales:
Cada nuevo token depende de todo lo generado antes.
Mercury, en cambio, usa difusión.
Inception describe sus LLM por difusión como modelos basados en Transformer que mejoran progresivamente una salida modificando múltiples tokens en paralelo. Investigaciones previas sobre Mercury describen esto como un proceso de generación de grueso a fino, en lugar de una predicción estricta del siguiente token de izquierda a derecha.
Una ilustración simplificada podría ser: