

Dies ist nur ein konzeptionelles Beispiel, nicht Mercurys 3 exakte interne Darstellung.
Die API von Inception kann diese Zwischenzustände bereitstellen. Beim normalen Streaming liefert Mercury Blöcke verfeinerten Texts, die an die Antwort angehängt werden können. Mit diffusing=True enthält jeder Chunk stattdessen die vollständige aktuelle Version der Antwort, während das Modell sie weiter verfeinert.
Den Unterschied sehen wir gleich in der Praxis.
Demo: Einen Echtzeit-Assistenten für Support-Eskalationen bauen
Bevor wir die Demo bauen, trennen wir die Modelleinstellungen von der eigentlichen Support-Anwendung.
Der Support-Fall ist lediglich die Eingabe, mit der wir Mercury 3 testen. Die wichtigen Modell-Parameter sind das Reasoning-Budget, das Completion-Budget und der Streaming-Modus.
|
Einstellung |
Verwendeter Wert |
Warum das wichtig ist |
|
Temperatur |
0,75 |
Fix gehalten, damit wir beim Modusvergleich das Sampling nicht ändern |
|
Reasoning-Aufwand |
low, high |
Ermöglicht den Vergleich von versteckter Reasoning-Nutzung und Latenz |
|
Completion-Budget |
8192 |
Groß genug für die gemessenen Demoläufe |
|
Standard-Streaming |
stream=True |
Gibt anhängbare Textblöcke zurück |
|
Diffusion-Streaming |
stream=True, diffusing=True |
Liefert aufeinanderfolgende Volltext-Verfeinerungszustände |
|
Prompt |
Fester Support-Fall |
Hält die Aufgabe konstant, während sich die Modelleinstellungen ändern |
|
Wiederholungen |
5 pro Bedingung |
Zeigt Lauf-zu-Lauf-Variation statt sich auf eine Anfrage zu verlassen |
Das sind funktionierende Einstellungen für dieses Experiment, nicht global optimale Mercury-3-Defaults.
Schritt 1: Voraussetzungen
Mercury 3 ist in wenigen Schritten einsatzbereit. Um mitzumachen, brauchst du:
- Einen Inception-API-Schlüssel
- Python 3
- Das Paket inceptionai
- Den Support-Fall als
case_support.json
Beginne mit der Registrierung auf der Inception-Plattform und hole dir den API-Schlüssel. Klicke auf Get Started und fülle die Angaben aus:
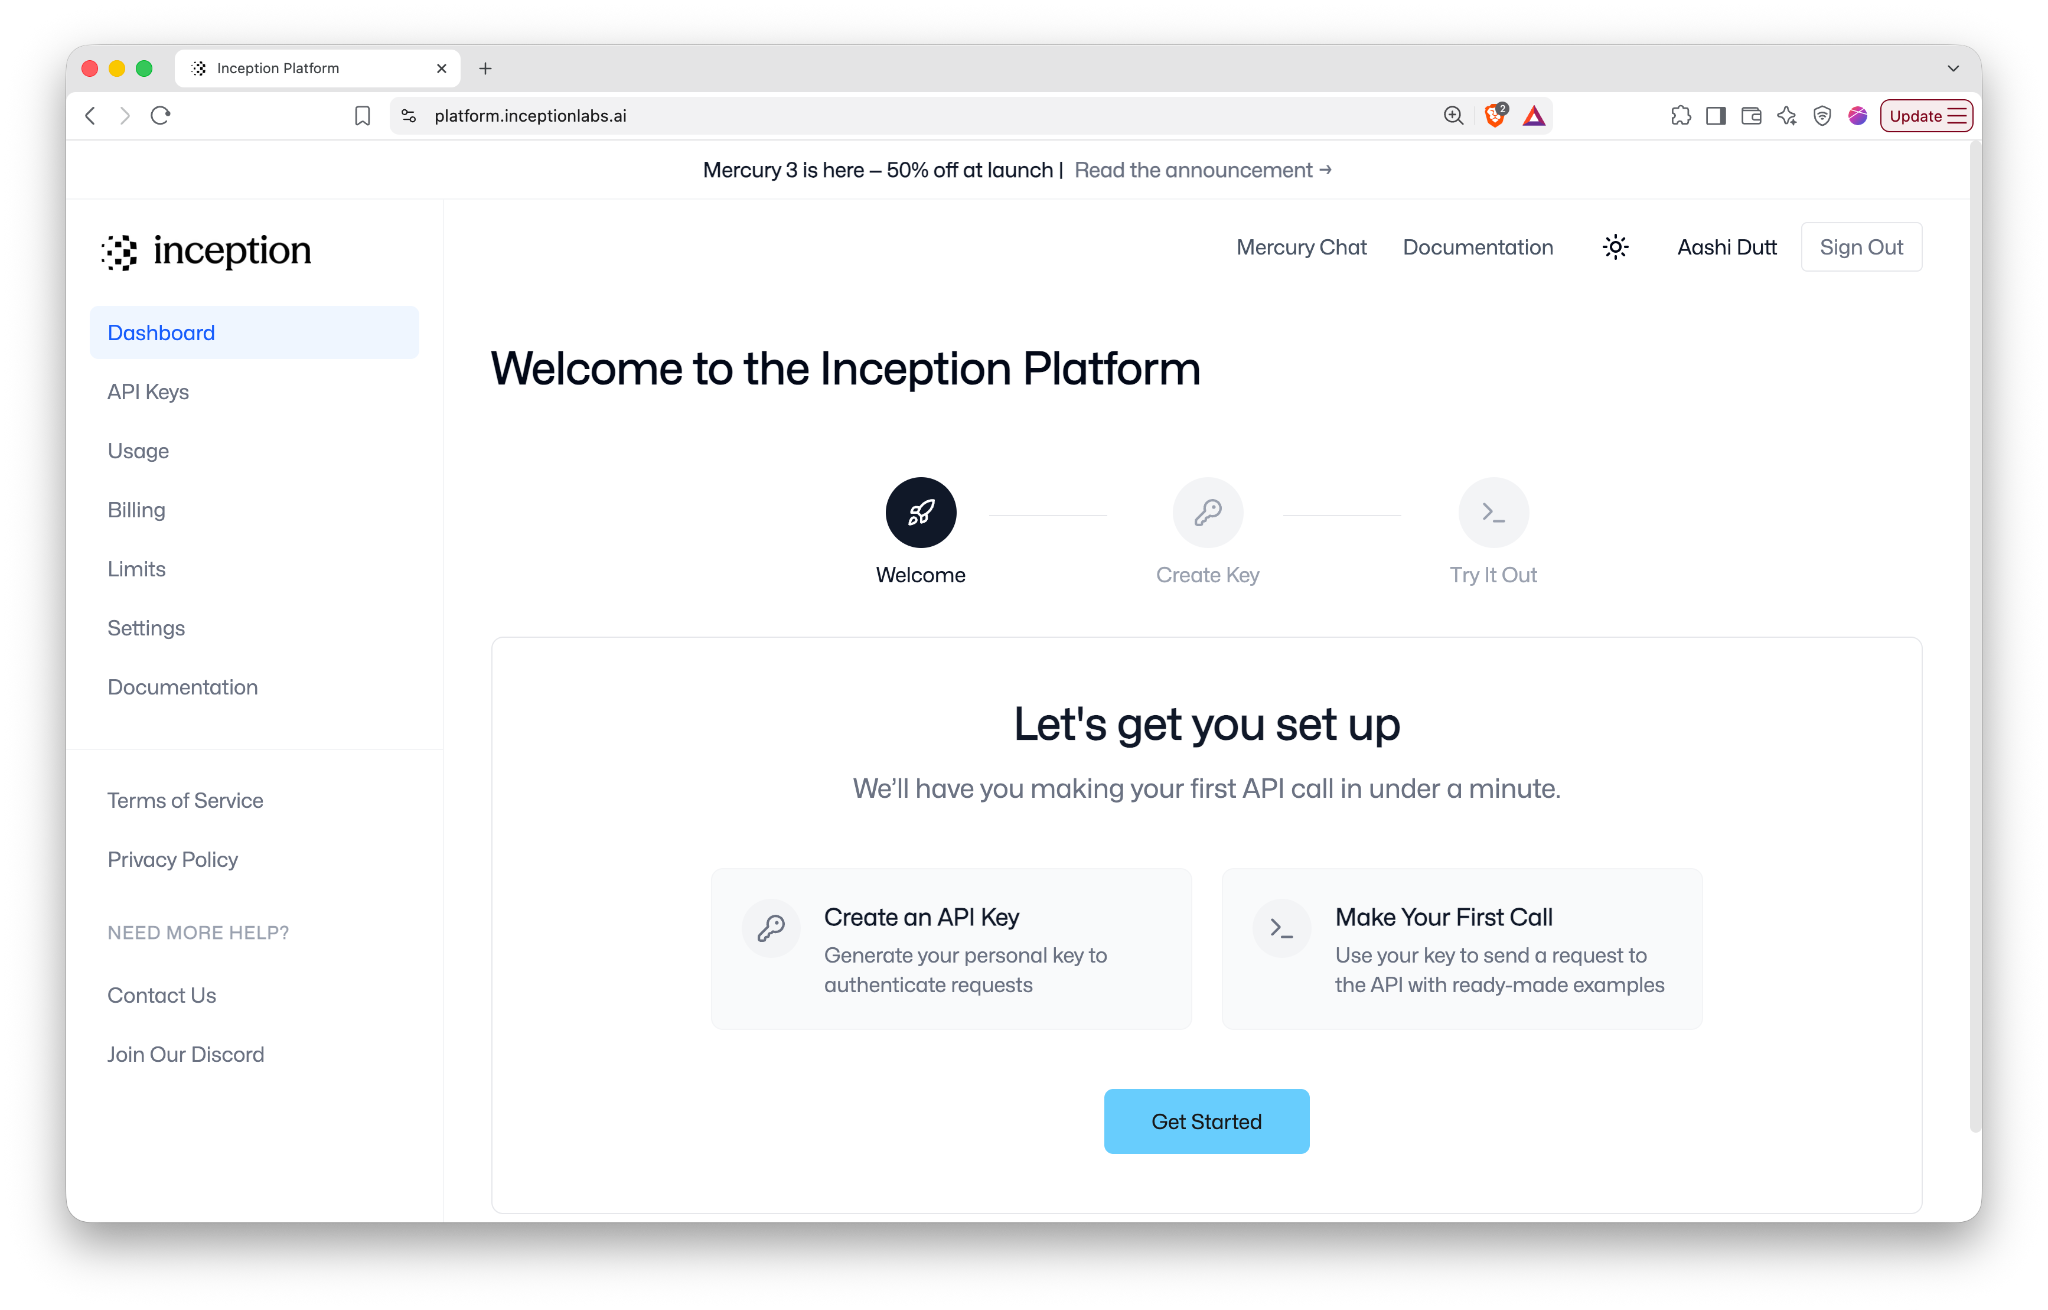
Hinweis: Zum Zeitpunkt der Erstellung stellt Inception 100 Millionen kostenlose Tokens für neue Accounts zum Ausprobieren der API bereit.
Du kannst deinen API-Schlüssel benennen oder diesen Schritt überspringen und auf Create Key klicken.
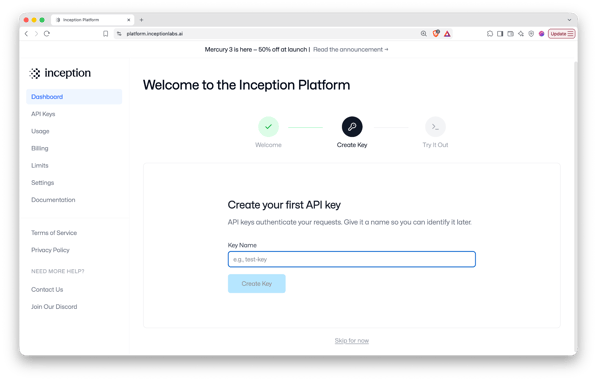
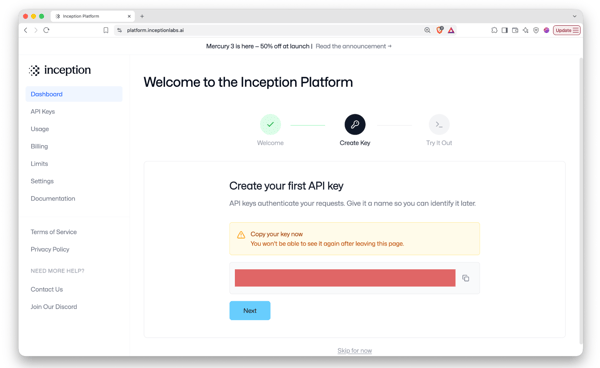
Kopiere anschließend den API-Schlüssel und tätige deinen ersten API-Call.
Schritt 2: Probiere Mercury 3 aus
Bevor du Code schreibst, kannst du Mercury 3 direkt in der Inception-Plattform testen. Nachdem du deinen API-Schlüssel erstellt hast, klicke auf Next und wähle den Button Run it now im Tab Try It Out.
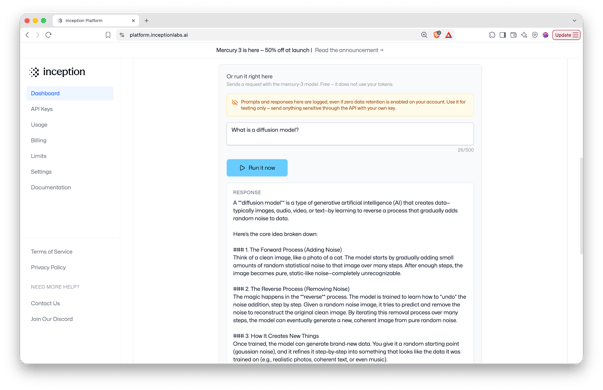
Das ist nützlich, um Prompts und Modelleinstellungen schnell zu testen, bevor du sie in eine Anwendung übernimmst.
Schritt 3: Umgebung vorbereiten und einen API-Call ausführen
Für den Rest des Tutorials rufen wir Mercury 3 aus Python auf. Installiere zunächst das Inception-SDK und exportiere den API-Schlüssel wie folgt:
!pip install -q inceptionaiImportiere dann die Pakete, die die Demo verwendet:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass fragt nach dem API-Schlüssel, ohne ihn anzuzeigen, os legt ihn dort ab, wo das SDK ihn erwartet, Path und json laden case_support.json und serialisieren es in den Prompt, und time.perf_counter() zeichnet auf, wann jede Antwort und jeder Verfeinerungszustand eintrifft.
difflib vergleicht aufeinanderfolgende Diffusionszustände und clear_output() ersetzt die Zellenausgabe, sodass das Replay an Ort und Stelle erfolgt statt die Seite nach unten zu stapeln.
Wenn der API-Schlüssel noch nicht gesetzt ist, kannst du interaktiv danach fragen:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() liest den API-Schlüssel aus der Umgebung. Während die anderen Importe, wie time den Zeitpunkt des Eintreffens von Verfeinerungszuständen erfassen, hilft difflib beim Vergleich von Zwischenständen, und clear_output() ermöglicht uns, den Diffusionsprozess an Ort und Stelle abzuspielen.
Schritt 4: Die Modellnachrichten aufbauen
Der Support-Fall liegt separat in case_support.json vor. Die Datei enthält die Kundenmeldung, Bestellinformationen, Zahlungsdatensätze, Fulfillment-Logs, Support-Richtlinien und die Prompts, die wir in diesem Szenario verwenden möchten.
Du kannst deinen eigenen Fall erstellen oder diese Vorlage verwenden:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Lade nun die JSON-Datei:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Bevor wir sie an Mercury 3 senden, trennen wir die Prompt-Konfiguration von den Belegen:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]Die Schlüssel system_prompt, task_prompt und packet_label steuern, wie wir Mercury anweisen. Daher werden sie vor der Serialisierung des Falls aus den Belegen entfernt. Jetzt können wir die finalen Nachrichten vorbereiten:
messages = build_messages(case)Es ist kein Retrieval-System oder externes Tool beteiligt. Alles, was Mercury für diese Analyse benötigt, schicken wir direkt in der Anfrage mit.
Schritt 5: Eine Anfrage an Mercury 3 stellen
Bevor wir Streaming testen, machen wir eine normale, nicht-streamende Anfrage. Der folgende Helper kapselt den Mercury-API-Call und zeichnet die Antwort-Metadaten auf:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Definieren wir nun einen Modellaufruf:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}Die wichtigsten Modellparameter sind:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensJetzt können wir einen Baseline-Call machen:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury erhält den vollständigen Support-Fall und liefert die gewünschte Analyse zurück, einschließlich der wahrscheinlichsten Erklärung, stützender Belege, alternativer Erklärungen, Unsicherheiten und empfohlener nächster Schritte.
Die Funktion zeichnet außerdem die Felder elapsed_s und usage auf. Ersteres misst die End-to-End-Zeit der Anfrage, letzteres enthält die Token-Abrechnung, einschließlich der gemeldeten Reasoning-Token-Nutzung.
Über die Läufe in diesem Tutorial hinweg identifizierte Mercury konsequent den zweiten Zahlungseintrag am ehesten als ausstehende Autorisierung und nicht als Hinweis auf eine bestätigte zweite Bestellung. Allerdings fehlen im Fall bewusst genügend Informationen, um zu wissen, ob diese ausstehende Autorisierung letztlich verschwindet oder verbucht wird.
Schritt 6: Standard-Streaming hinzufügen
Eine normale Anfrage wartet, bis Mercury fertig ist, und gibt dann die vollständige Antwort zurück. Um die Antwort schrittweise zu erhalten, müssen wir stream=True aktivieren. Die Standard-Streaming-Funktion sieht so aus:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Das entscheidende Verhalten ist chunks.append(content) beim Standard-Streaming: Jeder Chunk enthält das nächste Stück der Antwort, sodass die Chunks gesammelt und mit "".join(chunks) zur endgültigen Antwort zusammengesetzt werden können.
Hinweis: Die mediane Zeit bis zur ersten sichtbaren Ausgabe lag bei 2,903 Sekunden, während die mediane Gesamtlatenz 3,375 Sekunden betrug.
Schritt 7: Auf Diffusion-Streaming umstellen
Um Diffusion-Streaming zu aktivieren, setze diese Parameter auf True:
stream=True
diffusing=TrueDer API-Call unterscheidet sich vom Standard-Streaming nur um ein zusätzliches Argument, nämlich diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}Beim Standard-Streaming werden Chunks angehängt. Beim Diffusion-Streaming hingegen repräsentiert der jeweils letzte nicht-leere Chunk die aktuelle Vollversion der Antwort. Statt anzuhängen, ersetzen wir also die zuvor angezeigte Version.
Wir speichern die zurückgegebenen Zustände außerdem, um die Anzahl der Verfeinerungszustände zu messen und zu prüfen, ob spätere Zustände Text überarbeiten, der zuvor schon sichtbar war.
Über fünf Läufe lieferte das Diffusion-Streaming im Median 9 sichtbare Verfeinerungszustände (Spanne 7–12). Die mediane Zeit bis zum ersten sichtbaren Zustand lag bei 1,896 Sekunden, die mediane Gesamtlatenz bei 2,560 Sekunden.
Schritt 8: Standard- und Diffusion-Streaming vergleichen
Da wir beide Codepfade verstehen, können wir das gemessene Verhalten vergleichen.
|
Metrik |
Standard |
Diffusion |
|
Median Chunks/Zustände |
6 |
9 |
|
Spanne |
5–7 |
7–12 |
|
Median erstes sichtbares Output |
2,903 s |
1,896 s |
|
Median Gesamtlatenz |
3,375 s |
2,560 s |
Diffusion hatte für dieses spezielle Support-Prompt eine niedrigere Medianlatenz, die Spannweiten überlappen jedoch stark. Daher sollten wir nicht schlussfolgern, dass Diffusion-Streaming per se schneller ist.
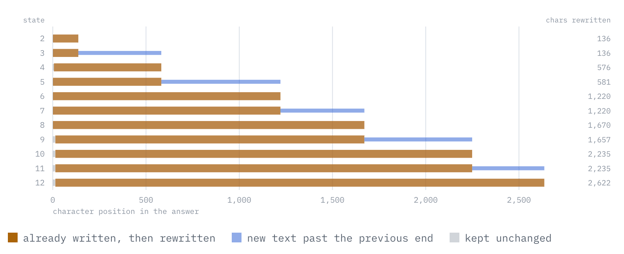
Abbildung: 12-Zustands-Lauf, Übergang für Übergang. Der braune Balken ist Text, den Mercury 3 bereits geschrieben und dann ersetzt hat, der blaue Balken ist der neue Text hinter dem bisherigen Ende. Ein reines Anhängen würde gar kein Braun zeigen.
In meinen Läufen überarbeiteten die zurückgegebenen Diffusionszustände zuvor sichtbaren Text statt sich wie reine Append-Chunks zu verhalten. Im Lauf oben war keiner der 11 Zustandswechsel ein reines Anhängen, und jeder wich innerhalb der ersten 14 Zeichen vom vorherigen Zustand ab.
Schritt 9: Das Completion-Budget testen
Als Nächstes betrachten wir das Verhalten von Mercury 3, wenn Reasoning-Tokens mit dem Completion-Budget interagieren. Die obigen normalen Aufrufe nutzen max_completion_tokens=8192, aber um das Verhalten deutlicher zu zeigen, reduzieren wir max_completion_tokens auf 1600.
Führe nun dieselbe Anfrage einmal mit niedrigem und einmal mit hohem Reasoning-Aufwand aus. Hier ist das Messergebnis:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneBei „high“ wurden alle 1.539 Completion-Tokens als Reasoning-Tokens gemeldet. Das Modell erreichte daher das Completion-Limit, bevor es sichtbaren Antworttext zurückgeben konnte.
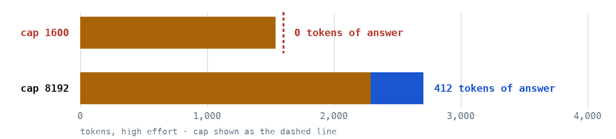
Abbildung: High-Aufwand: Completion-Budget bei einem 1.600- und einem 8.192-Token-Limit
Beim 1.600er-Limit ging das gesamte Budget ins Reasoning, es blieb nichts zum Ausgeben übrig. Bei 8.192 verbrauchte der Medianlauf mit hohem Aufwand 2.292 Tokens fürs Reasoning und hatte dennoch Platz für eine 412-Token-Antwort. Das 8.192-Limit liegt rechts außerhalb der Skala, daher zeigt nur die erste Zeile oben eine gestrichelte Cap-Linie.
Das wichtigste Signal in der fehlgeschlagenen High-Anfrage ist response.choices[0].finish_reason, das „length“ zurückgab. Das bedeutet, die Anfrage erreichte ihr maximales Completion-Token-Budget (max_completion_tokens). Dieses Budget umfasst sowohl Reasoning-Tokens als auch sichtbare Output-Tokens. In diesem Lauf meldete Mercury 3 alle 1.539 Completion-Tokens als Reasoning, sodass das Limit erreicht war, bevor eine sichtbare Antwort erzeugt wurde.
Hinweis: Für diese Demo reichten max_completion_tokens=8192 für die restlichen Läufe aus, das ist jedoch kein universelles Minimum.
Schritt 10: Niedrigen und hohen Reasoning-Aufwand vergleichen
Kehre nun zum normalen Completion-Budget von 8192 zurück und variiere nur reasoning_effort zwischen low und high. Wir verwenden den Helper run_nonstream() aus Schritt 5, um eine Anfrage mit niedrigem und eine mit hohem Reasoning-Aufwand zu stellen:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Für die berichteten Ergebnisse habe ich jede Konfiguration fünfmal wiederholt, statt mich auf eine einzelne Anfrage zu stützen.
Die Mediane waren:
|
Metrik |
Low |
High |
|
End-to-End-Latenz |
2,936 s |
8,146 s |
|
Completion-Tokens |
1312 |
2723 |
|
Reasoning-Tokens |
828 |
2292 |
|
Ca. sichtbare Tokens |
468 |
412 |
|
Reasoning-Anteil |
63% |
84% |
Die mediane Reasoning-Nutzung stieg von 828 auf 2.292 Tokens, während die mediane Latenz von 2,936 auf 8,146 Sekunden zunahm (etwa 2,77×).
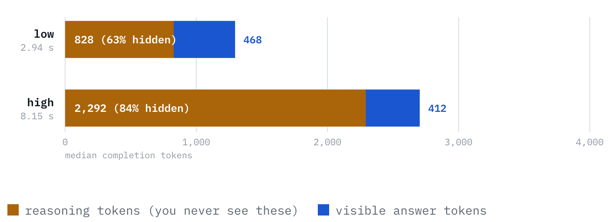
Abbildung: Wohin fließt das Completion-Budget je Aufwandstufe?
Die Länge der sichtbaren Antwort änderte sich hingegen kaum:
- Low: Median 468 Tokens
- High: Median 412 Tokens
und die beobachteten Spannweiten überlappten:
- Low: 393–494
- High: 356–469
Diese Läufe stützen also nicht die Behauptung, dass höherer Reasoning-Aufwand die sichtbare Antwort verkürzt. Die Latenzspannen zeigen zudem, warum ein einzelner Lauf nicht ausreicht:
- Low: 1,602–4,993 s
- High: 4,102–9,068 s
Hinweis: Die schnellste High-Anfrage war tatsächlich schneller als die langsamste Low-Anfrage.
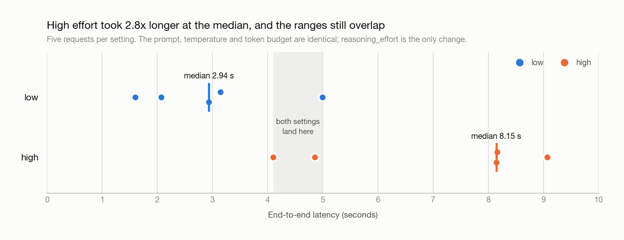
Abbildung: Alle zehn Reasoning-Aufwand-Anfragen nach Latenz
Damit erhöhte reasoning_effort="high" in diesem Experiment die gemeldete Reasoning-Token-Nutzung und die Latenz deutlich, während die Länge der sichtbaren Antwort insgesamt ähnlich blieb.
Fazit
Es gibt drei praktische Verhaltensweisen von Mercury 3:
-
Diffusion-Streaming folgt einem anderen Output-Vertrag. Standard-Streaming hängt neuen Text an, während Diffusion-Streaming aufeinanderfolgende Vollantwort-Zustände liefert, die den vorherigen ersetzen sollten.
-
Reasoning-Tokens teilen sich das Completion-Budget. Ein kleines
max_completion_tokenskann durch Reasoning aufgebraucht werden, bevor Mercury 3 eine sichtbare Antwort erzeugt. -
Höherer Reasoning-Aufwand tauscht zusätzliche Rechenarbeit gegen Latenz. In meinen Läufen nutzte „high“ deutlich mehr gemeldete Reasoning-Tokens und dauerte länger, wie erwartet, während die sichtbare Antwortlänge insgesamt ähnlich blieb.
Diese Ergebnisse stammen aus wenigen Läufen mit einem synthetischen Support-Fall und sind daher als Beobachtungen aus dieser Demo zu verstehen, nicht als allgemeine Leistungsbehauptungen zu Mercury 3.

Ich bin Google Developers Expertin für ML (Gen AI), dreifache Kaggle-Expertin und Women-Techmakers-Botschafterin mit über drei Jahren Erfahrung in der Tech-Branche. 2020 habe ich ein Health-Tech-Startup mitgegründet und absolviere derzeit einen Master in Informatik an der Georgia Tech mit Schwerpunkt Machine Learning.
Mercury 3 FAQs
Was ist der Hauptunterschied zwischen Standard-Streaming und Diffusion-Streaming in Mercury 3?
Beim Standard-Streaming kommt die Antwort in Text-Chunks an, die aneinander angehängt werden. Beim Diffusion-Streaming gibt die API aufeinanderfolgende Überarbeitungen der aktuellen Antwort frei, daher sollte der neueste Zustand den vorherigen ersetzen statt angehängt zu werden.
Erzeugt reasoning_effort="high" immer eine bessere Antwort?
Nein. Höherer Reasoning-Aufwand gibt Mercury mehr Spielraum fürs Nachdenken, garantiert aber nicht in jeder Aufgabe eine bessere Antwort. In dieser Demo nutzte „high“ deutlich mehr Reasoning-Tokens und dauerte länger, während die Länge der sichtbaren Antwort ähnlich blieb. Es war zudem konsistenter darin, ein fehlendes Beweisstück zu benennen, aber das Experiment ist zu klein für allgemeingültige Qualitätsaussagen.
Warum kann Mercury 3 keine sichtbare Antwort zurückgeben, wenn max_completion_tokens zu klein ist?
Reasoning-Tokens zählen auf dasselbe Completion-Budget wie die sichtbare Antwort. Wenn das Modell den Großteil oder das gesamte Budget fürs Reasoning verbraucht, kann es das Completion-Limit erreichen, bevor sichtbarer Output entsteht. In diesem Fall hilft der Blick auf finish_reason und die gemeldete Reasoning-Token-Nutzung zu verstehen, was passiert ist.
Ist Diffusion-Streaming immer schneller als Standard-Streaming?
Nein. In dieser Demo hatte Diffusion-Streaming eine geringere mediane Zeit bis zur ersten sichtbaren Ausgabe und eine niedrigere mediane Gesamtlatenz, aber die Spannweiten überlappten, und ein anderes Prompt lieferte die umgekehrte Reihenfolge. Der verlässlichere Unterschied betrifft das Streaming-Verhalten, nicht eine garantierte Latenzverbesserung.
Wann sollte ich Mercury 3 verwenden?
Mercury 3 ist besonders spannend für latenzkritische Anwendungen, bei denen Nutzer von schnellen Antworten profitieren, während das Modell dennoch nicht triviales Reasoning ausführt. Der richtige Reasoning-Aufwand und das passende Completion-Budget hängen von der Aufgabe ab und sollten sowohl gegen Latenz als auch Antwortqualität abgestimmt werden.


Mercury 3 ist ein Diffusions-LLM von Inception.ai. Anders als klassische autoregressive LLMs, die Text Token für Token erzeugen, nutzt Mercury Diffusion, um mehrere Teile seiner Antwort iterativ zu verfeinern. Das Modell übertrifft GPT-6 Luna und Claude Haiku 5.5, läuft dabei 4–8× schneller mit 1.000+ Tokens pro Sekunde auf NVIDIA-GPUs und unterstützt ein Kontextfenster von 1 Mio. Tokens.
In diesem Tutorial bauen wir einen kleinen Assistenten zur Incident-Analyse, der Anwendungslogs, Deployment-Informationen, GPU-Metriken und Request-Traces erhält. Anschließend nutzen wir dieselbe Aufgabe, um zwei Eigenschaften von Mercury 3 zu untersuchen:
Wie sich Diffusion-Streaming von normalem LLM-Streaming unterscheidet
Was sich ändert, wenn wir
reasoning_effortvon niedrig auf hoch stellen?Unterwegs stoßen wir außerdem auf ein wichtiges Token-Budget-Thema, das bei der Nutzung von Mercurys Reasoning-Modi eine Rolle spielt. Am Ende weißt du, wie du:
Komplettes Code-Repository.
Was ist Mercury 3?
Anders als klassische autoregressive LLMs, die strikt von links nach rechts eine Antwort erzeugen, gehört Mercury zu einer Modellfamilie, die während der Generierung mehrere Token-Positionen iterativ verfeinert. Inceptions Ansatz eignet sich besonders für latenzkritische Workloads wie Agents, Suche, Kundensupport, Bildung und andere Anwendungen, bei denen sich wiederholte Modellaufrufe schnell summieren.
Mercury 3 kombiniert diesen diffusionsbasierten Generierungsprozess mit den Fähigkeiten, die man von einem Allzweck-API-Modell erwartet, darunter Long-Context-Eingaben, Reasoning-Steuerung, Toolaufrufe, strukturierte Ausgaben und OpenAI-kompatible Endpunkte. Außerdem gibt es einen Streaming-Modus
diffusing=True, mit dem Anwendungen die vollständigen Zwischenzustände der Textverfeinerung erhalten statt nur fortlaufend angehängter Textblöcke.Zum Zeitpunkt der Erstellung unterstützt Mercury 3 Folgendes:
Eigenschaft
Mercury 3
Kontextfenster
1 Mio. Tokens
Maximaler Output
131.072 Tokens
Reasoning-Aufwand
instant, low, medium, high
Toolaufrufe
Unterstützt
Strukturierte Ausgabe
Unterstützt
Streaming
Unterstützt
Diffusion-Streaming
Unterstützt
Temperatur
0,5–1,0
API
OpenAI-kompatibel
Inception listet Mercury 3 aktuell zum Einführungspreis von $0,10 pro eine Million Eingabetokens, $0,01 pro eine Million gecachter Eingabetokens und $0,35 pro eine Million Ausgabetokens. Die gecachten Tokens sind ebenfalls 90 % günstiger als der Input-Preis.
Mercury 3 ist 40× größer als Mercury 1 und deutlich intelligenter, aber genauso schnell.
Abbildung: Modellqualität vs. Modellgröße (Quelle)
Wie funktioniert Mercury 3?
Die meisten LLMs generieren Text autoregressiv von links nach rechts, Token für Token. So erzeugen traditionelle LLMs Text:
Jedes neue Token hängt von allem zuvor Generierten ab.
Mercury nutzt stattdessen Diffusion.
Inception beschreibt seine Diffusions-LLMs als Transformer-basierte Modelle, die einen Output schrittweise verbessern, indem sie mehrere Tokens parallel verändern. Frühere Mercury-Forschung bezeichnet dies als einen grob-zu-fein Generierungsprozess statt einer strikt links-nach-rechts Next-Token-Vorhersage.
Eine vereinfachte Darstellung könnte so aussehen: