

นี่เป็นเพียงตัวอย่างเชิงแนวคิด ไม่ใช่การแทนค่าภายในจริงของ Mercury 3
API ของ Inception สามารถเปิดเผยสถานะกลางเหล่านี้ได้ ด้วยการสตรีมแบบปกติ Mercury จะส่งบล็อกข้อความที่ปรับแต่งแล้วซึ่งสามารถต่อท้ายคำตอบได้ ส่วนเมื่อใช้ diffusing=True แต่ละชิ้นจะเป็นเวอร์ชันปัจจุบันฉบับเต็มของคำตอบในขณะที่โมเดลกำลังปรับแต่ง
เดี๋ยวจะเห็นความแตกต่างในอีกสักครู่
เดโม: สร้างผู้ช่วยยกระดับเคสซัพพอร์ตแบบเรียลไทม์
ก่อนสร้างเดโม มาแยกการตั้งค่าโมเดลออกจากตัวแอปซัพพอร์ตกันก่อน
เคสซัพพอร์ตเป็นเพียงอินพุตที่ใช้ทดสอบ Mercury 3 การควบคุมฝั่งโมเดลที่สำคัญคือ งบให้เหตุผล งบคำตอบ และโหมดสตรีมมิ่ง
|
การตั้งค่า |
ค่าที่ใช้ |
เหตุผลที่สำคัญ |
|
อุณหภูมิ |
0.75 |
ตรึงไว้เพื่อไม่ให้การสุ่มเปลี่ยนระหว่างโหมด |
|
ความพยายามในการให้เหตุผล |
low, high |
เพื่อเทียบการใช้เหตุผลที่ซ่อนอยู่และระยะหน่วง |
|
งบคำตอบ |
8192 |
ใหญ่พอสำหรับการรันทดลองที่วัดผล |
|
การสตรีมมาตรฐาน |
stream=True |
ส่งคืนบล็อกข้อความที่ต่อท้ายได้ |
|
การสตรีมแบบ diffusion |
stream=True, diffusing=True |
ส่งคืนสถานะการปรับแต่งข้อความฉบับเต็มต่อเนื่อง |
|
พรอมต์ |
เคสซัพพอร์ตคงที่ |
ทำให้ภารกิจคงเดิมระหว่างปรับการตั้งค่าโมเดล |
|
ทำซ้ำ |
5 ครั้งต่อเงื่อนไข |
แสดงความแปรผันระหว่างการรัน แทนการพึ่งคำขอครั้งเดียว |
นี่เป็นค่าทดลองสำหรับงานนี้ ไม่ใช่การตั้งค่า Mercury 3 ที่เหมาะสมทั่วไป
ขั้นตอนที่ 1: ข้อกำหนดเบื้องต้น
เริ่มใช้ Mercury 3 ได้เพียงไม่กี่ขั้นตอน หากต้องการทำตาม ต้องมี:
- คีย์ API ของ Inception
- Python 3
- แพ็กเกจ inceptionai
- ไฟล์เคสซัพพอร์ตที่บันทึกเป็น
case_support.json
เริ่มจากสมัครใช้ แพลตฟอร์ม Inception และรับคีย์ API คลิก Get Started แล้วกรอกรายละเอียด:
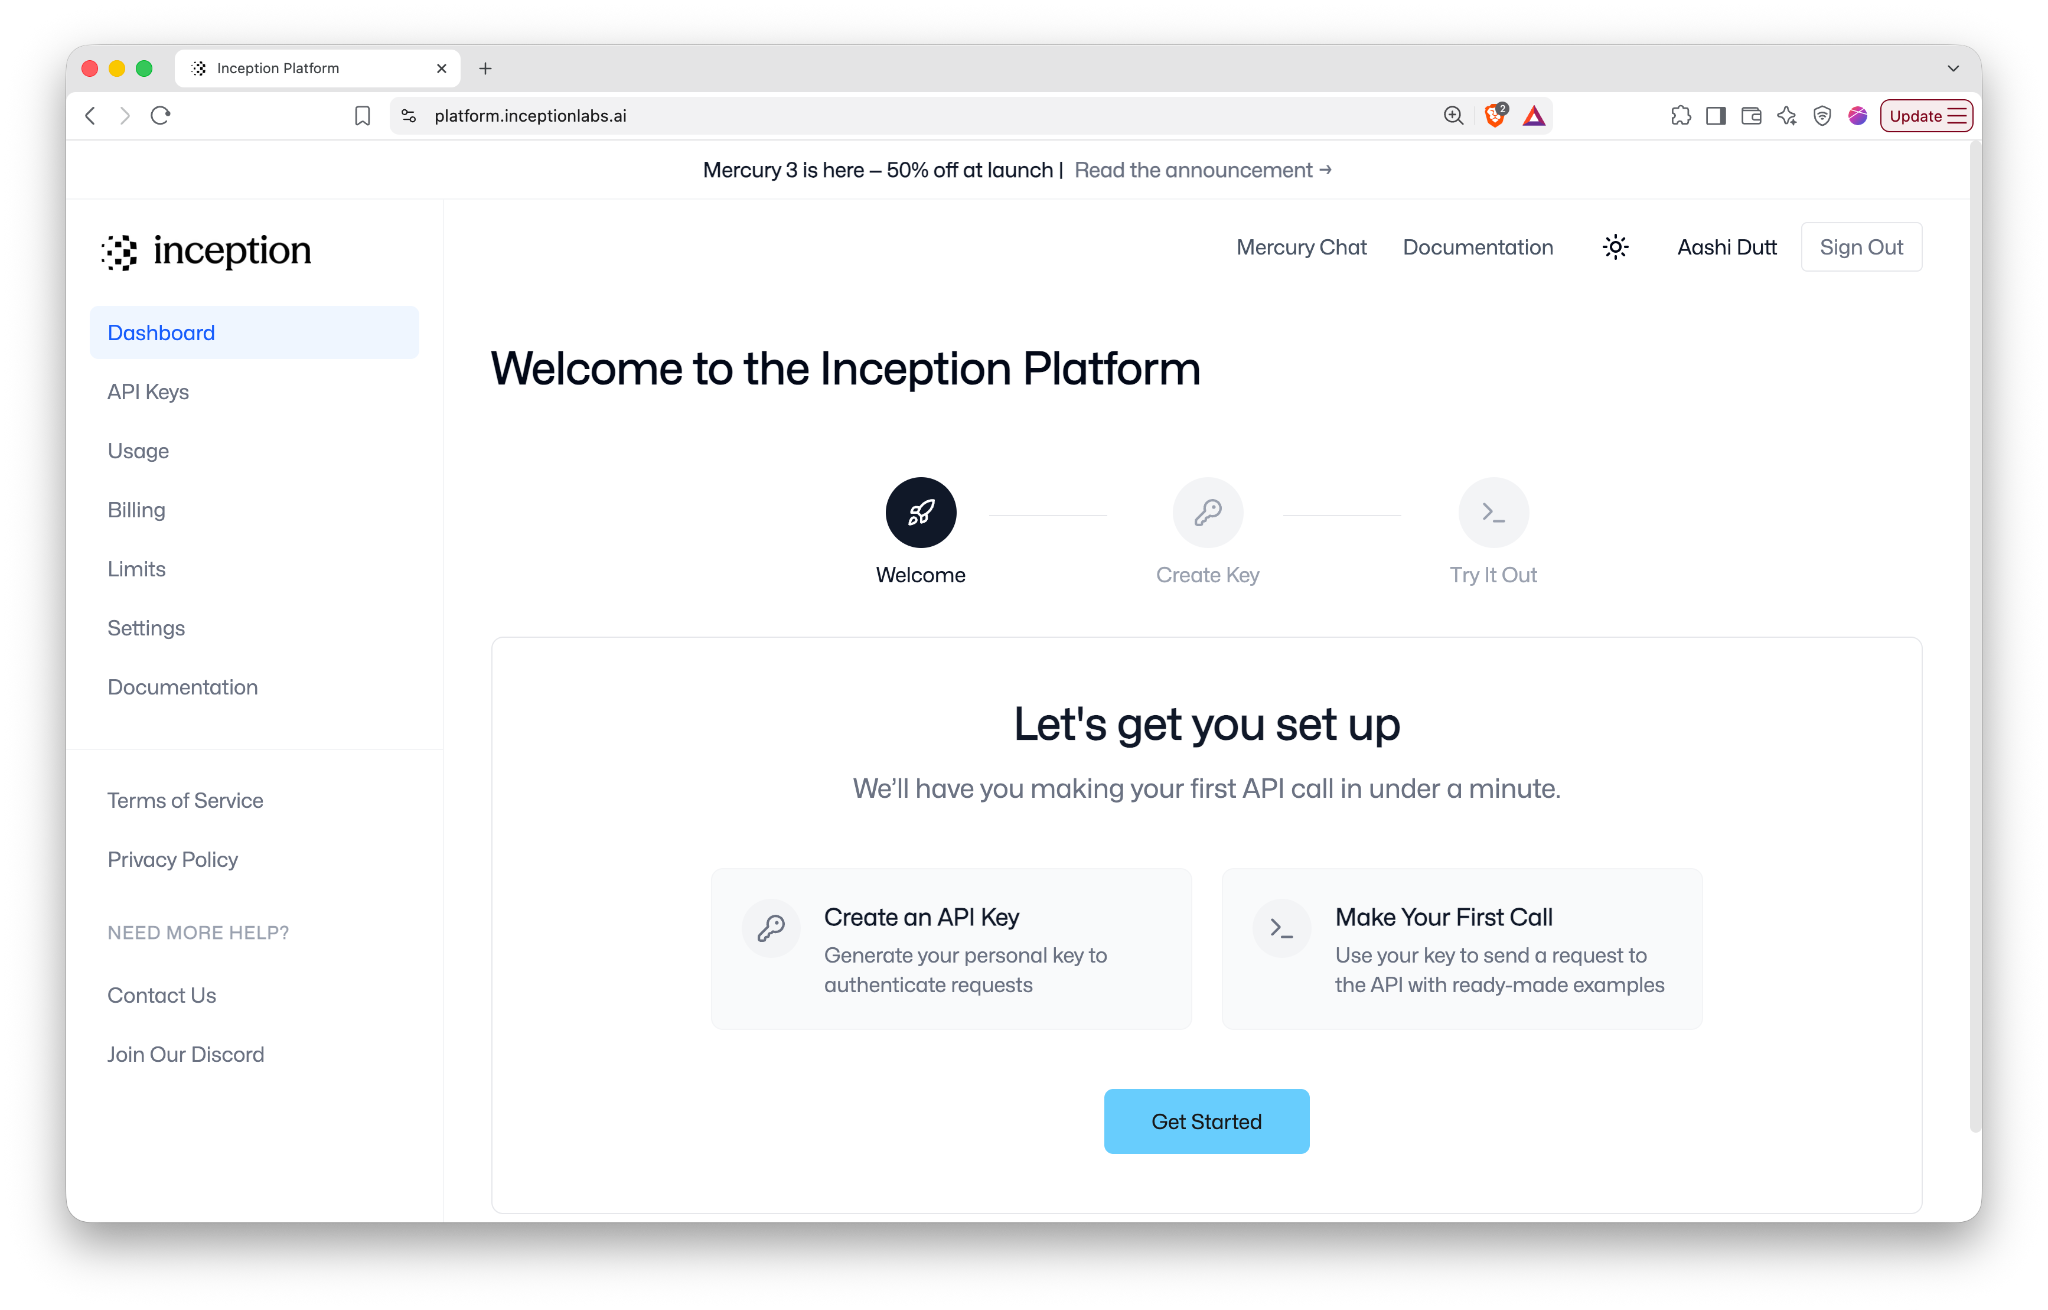
หมายเหตุ: ขณะเขียนบทความนี้ Inception มอบ โทเค็นฟรี 100 ล้านโทเค็น ให้บัญชีใหม่เพื่อทดลองใช้ API
สามารถตั้งชื่อคีย์ API หรือข้ามขั้นตอนนี้ แล้วคลิก Create Key ได้เลย
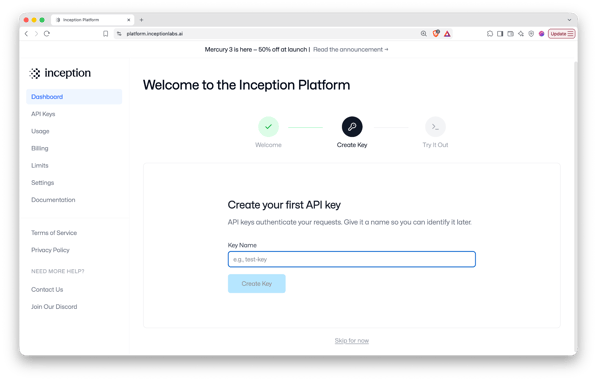
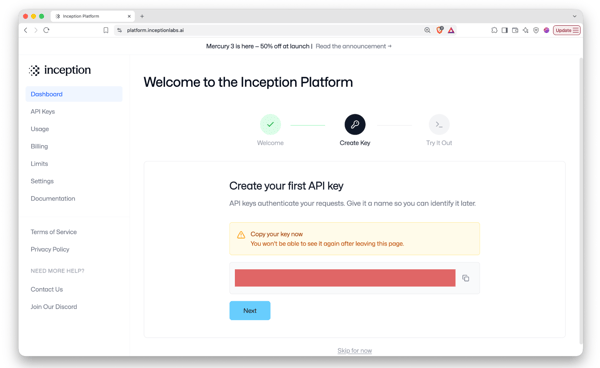
ถัดไป คัดลอกคีย์ API และทำการเรียก API ครั้งแรก
ขั้นตอนที่ 2: ทดลองใช้ Mercury 3
ก่อนเขียนโค้ด สามารถทดสอบ Mercury 3 ได้โดยตรงจาก Inception Platform หลังสร้างคีย์ API คลิก Next แล้วเลือกปุ่ม Run it now ในแท็บ Try It Out
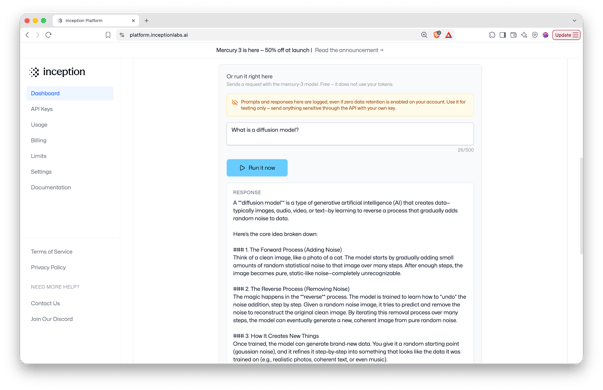
วิธีนี้สะดวกสำหรับทดสอบพรอมต์และการตั้งค่าโมเดลอย่างรวดเร็วก่อนย้ายเข้าแอปพลิเคชัน
ขั้นตอนที่ 3: เตรียมสภาพแวดล้อมและเรียก API
ในส่วนที่เหลือของบทช่วยสอน จะเรียก Mercury 3 จาก Python เริ่มด้วยติดตั้ง SDK ของ Inception และส่งออกคีย์ API ดังนี้:
!pip install -q inceptionaiจากนั้นนำเข้าแพ็กเกจที่ใช้ในเดโม:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass ใช้ถามคีย์ API โดยไม่แสดงผลบนหน้าจอ os วางคีย์ไว้ในตำแหน่งที่ SDK ค้นหา Path และ json โหลด case_support.json และทำซีเรียไลซ์เข้าไปในพรอมต์ และ time.perf_counter() บันทึกเวลาที่คำตอบและสถานะการปรับแต่งแต่ละรายการมาถึง
difflib ใช้เปรียบเทียบสถานะ diffusion ต่อเนื่อง และ clear_output() แทนที่เอาต์พุตของเซลล์เพื่อให้เล่นซ้ำการ diffusion ในที่เดิมแทนการซ้อนลงหน้า
หากยังไม่ได้ตั้งค่าคีย์ API สามารถถามแบบโต้ตอบได้:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() อ่านคีย์ API จากตัวแปรสภาพแวดล้อม ขณะที่อิมพอร์ตอื่น ๆ เช่น time บันทึกเวลาที่สถานะการปรับแต่งมาถึง difflib ช่วยเทียบข้อความระหว่างทาง และ clear_output() ช่วยให้เล่นซ้ำกระบวนการ diffusion ในที่เดิม
ขั้นตอนที่ 4: สร้างข้อความสำหรับโมเดล
เก็บเคสซัพพอร์ตไว้แยกต่างหากใน case_support.json ไฟล์เคสมีข้อความลูกค้า ข้อมูลออเดอร์ บันทึกการชำระเงิน ล็อกการดำเนินการจัดส่ง นโยบายซัพพอร์ต และพรอมต์ที่ต้องการใช้ในสถานการณ์นี้
สามารถสร้างของตนเองหรือใช้ตามนี้ได้:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}ตอนนี้มาโหลดไฟล์ JSON กัน:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")ก่อนส่งให้ Mercury 3 แยกค่าตั้งค่าพรอมต์ออกจากหลักฐาน:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]คีย์ system_prompt, task_prompt และ packet_label ควบคุมวิธีการสั่งงาน Mercury จึงถูกตัดออกจากหลักฐานก่อนซีเรียไลซ์ตัวเคสเอง ตอนนี้เตรียมข้อความสุดท้ายได้แล้ว:
messages = build_messages(case)ที่นี่ไม่มีระบบค้นคืนหรือเครื่องมือภายนอก ทุกอย่างที่ Mercury ต้องใช้เพื่อการวิเคราะห์นี้ถูกส่งมาในคำขอโดยตรง
ขั้นตอนที่ 5: ส่งคำขอไปยัง Mercury 3
ก่อนทดสอบการสตรีม มาลองคำขอแบบไม่สตรีมปกติก่อน ฟังก์ชันช่วยเหลือต่อไปนี้ห่อการเรียก API ของ Mercury และบันทึกเมตาดาตาของคำตอบ:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)ตอนนี้มานิยามการเรียกโมเดล:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}การควบคุมหลักฝั่งโมเดลคือ:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensตอนนี้ทำการเรียกฐานได้แล้ว:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury รับเคสซัพพอร์ตทั้งหมดและส่งคืนการวิเคราะห์ตามที่ร้องขอ รวมถึงคำอธิบายที่เป็นไปได้มากที่สุด หลักฐานสนับสนุน คำอธิบายทางเลือก ความไม่แน่นอน และการดำเนินการถัดไปที่แนะนำ
ฟังก์ชันยังบันทึกฟิลด์ elapsed_s และ usage ฟิลด์แรกวัดเวลาแบบปลายทางถึงปลายทาง ส่วนอีกอันรวมการนับโทเค็น รวมถึงการใช้โทเค็นเพื่อการให้เหตุผลตามที่รายงาน
ในการรันที่ใช้ในบทช่วยสอนนี้ Mercury ระบุต่อเนื่องว่ารายการชำระเงินรายการที่สองน่าจะเป็นการกันวงเงินที่รอดำเนินการ มากกว่าหลักฐานของออเดอร์ที่ยืนยันแล้วรายการที่สอง อย่างไรก็ดี เคสนี้ตั้งใจเว้นข้อมูลไม่พอที่จะรู้ได้ว่าการกันวงเงินนั้นจะหายไปเองหรือจะถูกเรียกเก็บในภายหลัง
ขั้นตอนที่ 6: เพิ่มการสตรีมมาตรฐาน
คำขอปกติจะรอให้ Mercury สร้างคำตอบเสร็จแล้วจึงส่งกลับ หากต้องการรับคำตอบแบบเพิ่มทีละส่วน ต้องเปิดใช้ stream=True ฟังก์ชันสตรีมมาตรฐานเป็นดังนี้:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}พฤติกรรมสำคัญที่นี่คือ chunks.append(content) ในการสตรีมมาตรฐาน ซึ่งแต่ละชิ้นคือส่วนถัดไปของคำตอบ จึงสามารถสะสมและประกอบกลับเป็นคำตอบสุดท้ายด้วย "".join(chunks)
หมายเหตุ: เวลากลางถึงเอาต์พุตที่มองเห็นครั้งแรกคือ 2.903 วินาที ขณะที่ระยะหน่วงรวมมัธยฐานคือ 3.375 วินาที
ขั้นตอนที่ 7: สลับไปใช้การสตรีมแบบ Diffusion
เพื่อเปิดใช้การสตรีมแบบ diffusion กำหนดพารามิเตอร์ต่อไปนี้เป็น True:
stream=True
diffusing=Trueการเรียก API แตกต่างจากการสตรีมมาตรฐานเพียงอาร์กิวเมนต์เดียว คือ diffusing=True
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}ในการสตรีมมาตรฐาน จะต่อชิ้นส่วนเข้าด้วยกัน แต่ในการสตรีมแบบ diffusion ชิ้นล่าสุดที่ไม่ว่างคือเวอร์ชันปัจจุบันฉบับเต็มของคำตอบ ดังนั้นแทนที่จะต่อท้าย เราจะแทนที่สิ่งที่แสดงก่อนหน้า
ยังเก็บสถานะที่ส่งคืนไว้เพื่อวัดจำนวนสถานะการปรับแต่ง และตรวจว่าช่วงหลัง ๆ ปรับแก้ข้อความที่ปรากฏก่อนหน้าหรือไม่
จากการรัน 5 ครั้ง การสตรีมแบบ diffusion ส่งคืนสถานะการปรับแต่งที่มองเห็นได้มัธยฐาน 9 สถานะ ช่วง 7–12 เวลากลางถึงสถานะที่มองเห็นครั้งแรก 1.896 วินาที และระยะหน่วงรวมมัธยฐาน 2.560 วินาที
ขั้นตอนที่ 8: เปรียบเทียบการสตรีมมาตรฐานและแบบ Diffusion
เมื่อเข้าใจโค้ดทั้งสองแบบแล้ว มาลองเทียบพฤติกรรมที่วัดได้
|
เมตริก |
มาตรฐาน |
Diffusion |
|
มัธยฐานจำนวนชิ้น/สถานะ |
6 |
9 |
|
ช่วง |
5–7 |
7–12 |
|
มัธยฐานเวลาเอาต์พุตแรกที่มองเห็น |
2.903 s |
1.896 s |
|
มัธยฐานระยะหน่วงรวม |
3.375 s |
2.560 s |
สำหรับพรอมต์ซัพพอร์ตนี้ การสตรีมแบบ diffusion มีระยะหน่วงมัธยฐานต่ำกว่า แต่ช่วงทับซ้อนกันมาก จึงไม่ควรสรุปว่าการสตรีมแบบ diffusion เร็วกว่าโดยเนื้อแท้
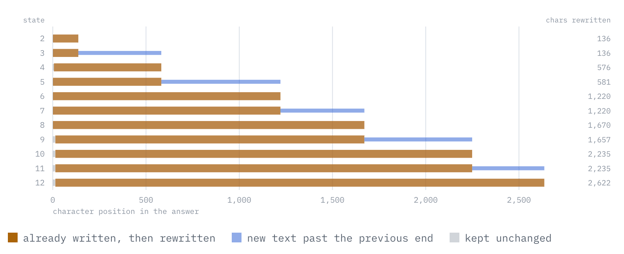
ภาพ: การรัน 12 สถานะ ไล่ดูการเปลี่ยนผ่านทีละช่วง แถบสีน้ำตาลคือข้อความที่ Mercury 3 เคยเขียนแล้วถูกแทนที่ ส่วนแถบสีน้ำเงินคือตัวอักษรใหม่หลังจากจุดสิ้นสุดก่อนหน้า หากเป็นการต่อท้ายล้วน ๆ จะไม่เห็นสีน้ำตาลเลย
ในการรันของผู้เขียน สถานะ diffusion ที่ส่งคืนจะแก้ไขข้อความที่แสดงก่อนหน้า แทนที่จะทำงานเหมือนชิ้นส่วนที่ต่อท้ายอย่างเดียว ในการรันข้างต้น ไม่มีการเปลี่ยนผ่านทั้ง 11 ครั้งที่เป็นการต่อท้ายล้วน และทุกครั้งเริ่มต่างจากสถานะก่อนหน้าภายใน 14 อักขระแรก
ขั้นตอนที่ 9: ทดสอบงบคำตอบ
ต่อไปมาดูพฤติกรรมของ Mercury 3 ว่าโทเค็นเพื่อการให้เหตุผลโต้ตอบกับงบคำตอบอย่างไร คำขอปกติด้านบนใช้ max_completion_tokens=8192 แต่เพื่อให้เห็นชัดขึ้น ต้องลด max_completion_tokens เหลือ 1600
ตอนนี้รันคำขอเดียวกันครั้งหนึ่งที่ความพยายามต่ำ และครั้งหนึ่งที่สูง ผลที่วัดได้คือ:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneที่ระดับสูง โทเค็นคำตอบ 1,539 ทั้งหมดถูกรายงานว่าเป็นโทเค็นสำหรับการให้เหตุผล โมเดลจึงชนขีดจำกัดคำตอบก่อนส่งคืนข้อความคำตอบที่มองเห็นได้
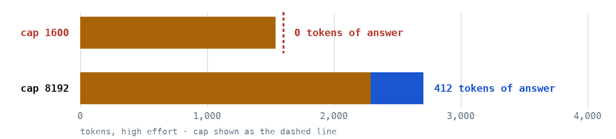
ภาพ: งบคำตอบเมื่อความพยายามสูงที่เพดาน 1,600 และ 8,192 โทเค็น
ที่เพดาน 1,600 งบทั้งหมดไปกับการให้เหตุผล จึงไม่เหลือให้ปล่อยเอาต์พุต ที่ 8,192 รันมัธยฐานระดับสูงใช้โทเค็นให้เหตุผล 2,292 และยังเหลือพื้นที่สำหรับคำตอบ 412 โทเค็น เพดาน 8,192 อยู่นอกสเกลรูปนี้ทางขวา จึงมีเส้นเพดานประเพียงแถวแรกในภาพด้านบน
สัญญาณสำคัญในคำขอระดับสูงที่ล้มเหลวคือ response.choices[0].finish_reason ซึ่งคืนค่า length แปลว่าคำขอถึงขีดจำกัดงบโทเค็นคำตอบ (max_completion_tokens) งบนี้รวมทั้งโทเค็นให้เหตุผลและโทเค็นเอาต์พุตที่มองเห็น ในการรันนี้ Mercury 3 รายงานว่าโทเค็นคำตอบ 1,539 ทั้งหมดเป็นโทเค็นให้เหตุผล จึงถึงขีดจำกัดก่อนผลิตคำตอบที่มองเห็น
หมายเหตุ: สำหรับเดโมนี้ max_completion_tokens=8192 เพียงพอสำหรับการรันที่เหลือ แต่ไม่ควรถูกมองว่าเป็นค่าต่ำสุดสากล
ขั้นตอนที่ 10: เปรียบเทียบความพยายามในการให้เหตุผลแบบต่ำและสูง
กลับไปใช้งบคำตอบปกติ 8192 และปรับเฉพาะ reasoning_effort ระหว่างต่ำกับสูง จะใช้ตัวช่วย run_nonstream() จากขั้นตอนที่ 5 เพื่อทำคำขอหนึ่งครั้งที่ความพยายามต่ำ และอีกครั้งที่สูง:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)สำหรับผลลัพธ์ที่รายงานนี้ ทำซ้ำแต่ละการตั้งค่า 5 ครั้ง แทนที่จะพึ่งคำขอเดียว
ค่ามัธยฐานคือ:
|
เมตริก |
ต่ำ |
สูง |
|
ระยะหน่วงปลายถึงปลาย |
2.936 s |
8.146 s |
|
โทเค็นคำตอบ |
1312 |
2723 |
|
โทเค็นให้เหตุผล |
828 |
2292 |
|
โทเค็นที่มองเห็นโดยประมาณ |
468 |
412 |
|
สัดส่วนการให้เหตุผล |
63% |
84% |
การใช้เหตุผลมัธยฐานเพิ่มจาก 828 เป็น 2,292 โทเค็น ขณะที่ระยะหน่วงมัธยฐานเพิ่มจาก 2.936 เป็น 8.146 วินาที (ประมาณ 2.77 เท่า)
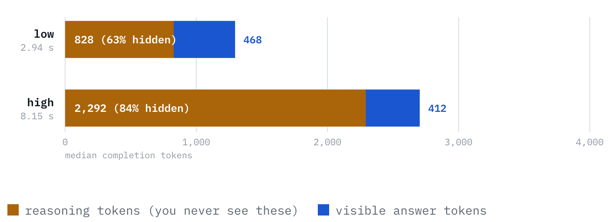
ภาพ: งบคำตอบถูกใช้ไปที่ไหนในแต่ละระดับความพยายาม?
ความยาวคำตอบที่มองเห็นไม่ได้เปลี่ยนมากนัก:
- ต่ำ: มัธยฐาน 468 โทเค็น
- สูง: มัธยฐาน 412 โทเค็น
และช่วงที่สังเกตซ้อนทับกัน:
- ต่ำ: 393–494
- สูง: 356–469
ดังนั้น การรันเหล่านี้ไม่สนับสนุนข้ออ้างว่าการเพิ่มความพยายามในการให้เหตุผลทำให้คำตอบที่มองเห็นสั้นลง ช่วงระยะหน่วงยังแสดงว่าการรันเดียวไม่พอ:
- ต่ำ: 1.602–4.993 s
- สูง: 4.102–9.068 s
หมายเหตุ: คำขอระดับสูงที่เร็วที่สุดยังเร็วกว่า คำขอระดับต่ำที่ช้าที่สุด
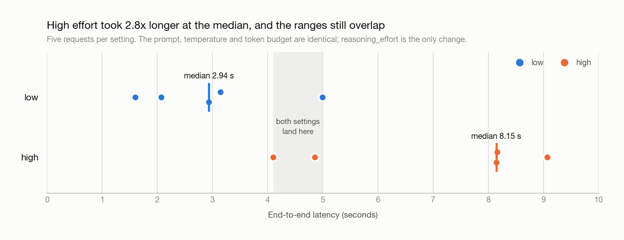
ภาพ: คำขอความพยายามในการให้เหตุผลทั้งสิบรายการ แสดงตามระยะหน่วง
ดังนั้น reasoning_effort="high" เพิ่มการใช้โทเค็นเพื่อการให้เหตุผลและระยะหน่วงอย่างมากในงานนี้ ตามคาด ขณะที่ความยาวคำตอบที่มองเห็นยังใกล้เคียงกันโดยรวม
บทสรุป
มีพฤติกรรมเชิงปฏิบัติ 3 ข้อของ Mercury 3:
-
การสตรีมแบบ diffusion ใช้สัญญาเอาต์พุตที่ต่างออกไป. การสตรีมมาตรฐานจะต่อข้อความใหม่เข้าไป ส่วนการสตรีมแบบ diffusion จะส่งคืนสถานะคำตอบฉบับเต็มต่อเนื่อง ซึ่งควรแทนที่ของเดิม
-
โทเค็นเพื่อการให้เหตุผลใช้ร่วมงบคำตอบ
max_completion_tokensที่เล็กอาจถูกใช้หมดไปกับการให้เหตุผล ก่อนที่ Mercury 3 จะสร้างคำตอบที่มองเห็นได้ -
ความพยายามในการให้เหตุผลที่สูงขึ้นแลกการคำนวณเพิ่มกับระยะหน่วง ในการรันของผู้เขียน ระดับสูงใช้โทเค็นให้เหตุผลมากขึ้นอย่างชัดเจนและใช้เวลานานขึ้นตามคาด ขณะที่ความยาวคำตอบที่มองเห็นยังใกล้เคียงกันโดยรวม
ผลเหล่านี้มาจากจำนวนน้อยของการรันในเคสซัพพอร์ตสังเคราะห์หนึ่งเคส จึงควรมองเป็นข้อสังเกตจากเดโมนี้ ไม่ใช่การอ้างประสิทธิภาพทั่วไปของ Mercury 3
คำถามที่พบบ่อยเกี่ยวกับ Mercury 3
ความแตกต่างหลักระหว่างการสตรีมมาตรฐานกับการสตรีมแบบ diffusion ใน Mercury 3 คืออะไร?
สำหรับการสตรีมมาตรฐาน คำตอบจะมาถึงเป็นชิ้นข้อความที่ต่อท้ายกัน ส่วนการสตรีมแบบ diffusion API จะเปิดเผยการแก้ไขของคำตอบปัจจุบันแบบต่อเนื่อง ดังนั้นสถานะล่าสุดควรแทนที่สถานะก่อนหน้า ไม่ใช่ต่อท้าย
reasoning_effort="high" ให้คำตอบที่ดีกว่าเสมอหรือไม่?
ไม่เสมอไป ความพยายามในการให้เหตุผลที่สูงขึ้นเปิดพื้นที่ให้ Mercury ใช้เหตุผลได้มากขึ้น แต่ไม่ได้การันตีคำตอบที่ดีกว่าสำหรับทุกงาน ในเดโมนี้ ระดับสูงใช้โทเค็นให้เหตุผลมากขึ้นอย่างมากและใช้เวลานานขึ้น ขณะที่ความยาวคำตอบที่มองเห็นใกล้เคียงกัน นอกจากนี้ยังสม่ำเสมอขึ้นในการชี้ให้เห็นหลักฐานที่ขาดหาย แต่การทดลองมีขนาดเล็กเกินไปที่จะสรุปเรื่องคุณภาพในวงกว้าง
ทำไม Mercury 3 อาจไม่ส่งคืนคำตอบที่มองเห็นได้เมื่อกำหนด max_completion_tokens ไว้เล็กเกินไป?
โทเค็นเพื่อการให้เหตุผลถูกนับรวมในงบโทเค็นคำตอบเดียวกับคำตอบที่มองเห็น หากโมเดลใช้เกือบทั้งหมดหรือทั้งหมดไปกับการให้เหตุผล อาจถึงขีดจำกัดก่อนสร้างเอาต์พุตที่มองเห็นได้ ในกรณีนั้น การตรวจค่า finish_reason และการใช้โทเค็นเพื่อการให้เหตุผลที่รายงานจะช่วยอธิบายสิ่งที่เกิดขึ้น
การสตรีมแบบ diffusion เร็วกว่าแบบมาตรฐานเสมอหรือไม่?
ไม่เสมอไป ในเดโมนี้ การสตรีมแบบ diffusion มีเวลามัธยฐานถึงเอาต์พุตแรกและระยะหน่วงรวมต่ำกว่า แต่ช่วงทับซ้อนกัน และพรอมต์อื่นก่อให้เกิดการจัดอันดับตรงข้าม ความแตกต่างที่เชื่อถือได้กว่าคือพฤติกรรมการสตรีม ไม่ใช่การปรับปรุงระยะหน่วงที่รับประกัน
ควรใช้ Mercury 3 เมื่อใด?
Mercury 3 น่าสนใจเป็นพิเศษสำหรับแอปที่ไวต่อระยะหน่วง ซึ่งผู้ใช้ได้ประโยชน์จากการตอบสนองเร็ว ในขณะที่โมเดลยังทำการให้เหตุผลที่ไม่เล็กน้อย ระดับความพยายามในการให้เหตุผลและงบคำตอบที่เหมาะสมขึ้นอยู่กับงาน จึงควรปรับให้เหมาะทั้งด้านระยะหน่วงและคุณภาพคำตอบ
Mercury 3 เป็นโมเดลภาษาขนาดใหญ่แบบ diffusion โดย Inception.ai แตกต่างจาก LLM แบบ autoregressive ทั่วไปที่สร้างข้อความทีละโทเค็น Mercury ใช้ diffusion เพื่อปรับแต่งหลายส่วนของคำตอบแบบวนซ้ำ โมเดลทำผลงานได้ดีกว่า GPT-6 Luna และ Claude Haiku 5.5 พร้อมทำงานเร็วกว่า 4–8 เท่า ที่มากกว่า 1,000 โทเค็นต่อวินาทีบน GPU ของ NVIDIA และรองรับหน้าต่างบริบท 1 ล้านโทเค็น
ในบทช่วยสอนนี้ จะสร้างผู้ช่วยวิเคราะห์เหตุขัดข้องขนาดเล็กที่รับบันทึกการทำงานของแอป ข้อมูลการดีพลอย เมตริก GPU และทรานซ์ของคำขอ จากนั้นจะใช้ภารกิจเดียวกันเพื่อสำรวจ 2 คุณสมบัติของ Mercury 3:
ความแตกต่างระหว่างการสตรีมแบบ diffusion กับการสตรีม LLM ปกติ
จะเกิดอะไรขึ้นเมื่อเพิ่ม
reasoning_effortจากต่ำเป็นสูง?ระหว่างทางจะพบปัญหาสำคัญเรื่องงบโทเค็นที่ส่งผลเมื่อใช้โหมดให้เหตุผลของ Mercury เมื่อจบ คุณจะรู้วิธี:
โค้ดทั้งหมดอยู่ที่ repository.
Mercury 3 คืออะไร?
ต่างจาก LLM แบบ autoregressive ทั่วไปที่สร้างคำตอบจากซ้ายไปขวาอย่างเคร่งครัด Mercury อยู่ในตระกูลโมเดลที่ปรับแต่งตำแหน่งโทเค็นหลายตำแหน่งระหว่างการสร้างแบบวนซ้ำ วิธีของ Inception เหมาะกับงานที่ไวต่อระยะหน่วง เช่น เอเจนต์ ค้นหา งานซัพพอร์ต การศึกษา และแอปอื่นที่การเรียกโมเดลซ้ำ ๆ อาจสะสมเวลาเร็ว
Mercury 3 ผสานกระบวนการสร้างแบบ diffusion เข้ากับความสามารถที่คาดหวังจากโมเดล API ใช้งานทั่วไป รวมถึงอินพุตบริบทยาว การควบคุมการให้เหตุผล การเรียกใช้เครื่องมือ เอาต์พุตแบบโครงสร้าง และปลายทางที่เข้ากันได้กับ OpenAI นอกจากนี้ยังมีโหมดสตรีมมิ่ง
diffusing=Trueที่ให้แอปพลิเคชันรับสถานะการปรับแต่งข้อความฉบับเต็มระหว่างทาง แทนที่จะรับเฉพาะบล็อกเอาต์พุตที่ต่อท้ายเท่านั้นขณะเขียนบทความนี้ Mercury 3 รองรับดังนี้:
คุณสมบัติ
Mercury 3
หน้าต่างบริบท
1M โทเค็น
เอาต์พุตสูงสุด
131,072 โทเค็น
ความพยายามในการให้เหตุผล
instant, low, medium, high
การเรียกใช้เครื่องมือ
รองรับ
เอาต์พุตแบบโครงสร้าง
รองรับ
การสตรีม
รองรับ
การสตรีมแบบ diffusion
รองรับ
อุณหภูมิ
0.5–1.0
API
เข้ากันได้กับ OpenAI
Inception ระบุราคาเปิดตัวของ Mercury 3 ที่ $0.10 ต่อหนึ่งล้านโทเค็นอินพุต, $0.01 ต่อหนึ่งล้านโทเค็นอินพุตที่แคชแล้ว และ $0.35 ต่อหนึ่งล้านโทเค็นเอาต์พุต โทเค็นที่แคชแล้วลด 90% จากราคาอินพุตด้วย
Mercury 3 มีขนาดใหญ่กว่า Mercury 1 ถึง 40 เท่า ฉลาดกว่ามาก แต่ยังคงเร็วเท่าเดิม
ภาพ: คุณภาพโมเดลเทียบกับขนาดโมเดล (ที่มา)
Mercury 3 ทำงานอย่างไร?
LLM ส่วนใหญ่สร้างข้อความแบบ autoregressive จากซ้ายไปขวา ทีละโทเค็น แบบดั้งเดิมทำงานดังนี้:
โทเค็นใหม่แต่ละตัวขึ้นกับทุกอย่างที่ถูกสร้างมาก่อนหน้า
Mercury ใช้ diffusion แทน
Inception อธิบาย LLM แบบ diffusion ว่าเป็นโมเดลฐาน Transformer ที่ค่อย ๆ ปรับปรุงเอาต์พุตโดยแก้ไขโทเค็นหลายตัวแบบขนาน งานวิจัย Mercury ก่อนหน้านี้อธิบายว่าเป็นกระบวนการสร้างจากหยาบไปละเอียด มากกว่าการทำนายโทเค็นถัดไปจากซ้ายไปขวาอย่างเคร่งครัด
ภาพประกอบแบบย่ออาจมีหน้าตาแบบนี้: