

Acesta este doar un exemplu conceptual, nu reprezentarea internă exactă a Mercury 3.
API-ul Inception poate expune aceste stări intermediare. Cu streamingul normal, Mercury returnează blocuri de text rafinat care pot fi adăugate la răspuns. Cu diffusing=True, fiecare fragment conține în schimb versiunea completă curentă a răspunsului, pe măsură ce modelul o rafinează.
Vom vedea imediat diferența.
Demo: Construirea unui asistent de escaladare pentru suport, în timp real
Înainte de a construi demonstrația, să separăm setările modelului de aplicația de suport propriu-zisă.
Cazul de suport este doar inputul pe care îl folosim pentru a pune la lucru Mercury 3. Controalele importante din partea modelului sunt bugetul de raționare, bugetul de completare și modul de streaming.
|
Setare |
Valoare folosită |
De ce contează |
|
Temperatură |
0,75 |
Păstrată fixă pentru a nu schimba eșantionarea când comparăm moduri |
|
Efort de raționare |
low, high |
Ne permite să comparăm folosirea raționării ascunse și latența |
|
Buget de completare |
8192 |
Suficient de mare pentru rulările măsurate în demo |
|
Streaming standard |
stream=True |
Returnează blocuri de text ce pot fi adăugate |
|
Streaming prin difuzie |
stream=True, diffusing=True |
Returnează stări succesive de rafinare a textului complet |
|
Prompt |
Caz de suport fix |
Păstrează sarcina constantă în timp ce setările modelului se schimbă |
|
Repetări |
5 per condiție |
Arată variația între rulări, fără a depinde de o singură cerere |
Acestea sunt setări de lucru pentru acest experiment, nu setări Mercury 3 optimizate la nivel general.
Pasul 1: Cerințe preliminare
Cu Mercury 3 e nevoie de doar câțiva pași pentru a începe. Ca să urmărești, ai nevoie de:
- O cheie API Inception
- Python 3
- Pachetul inceptionai
- Cazul de suport salvat ca
case_support.json
Începe prin a te înscrie pe platforma Inception și a obține cheia API. Dă click pe Get Started și completează detaliile:
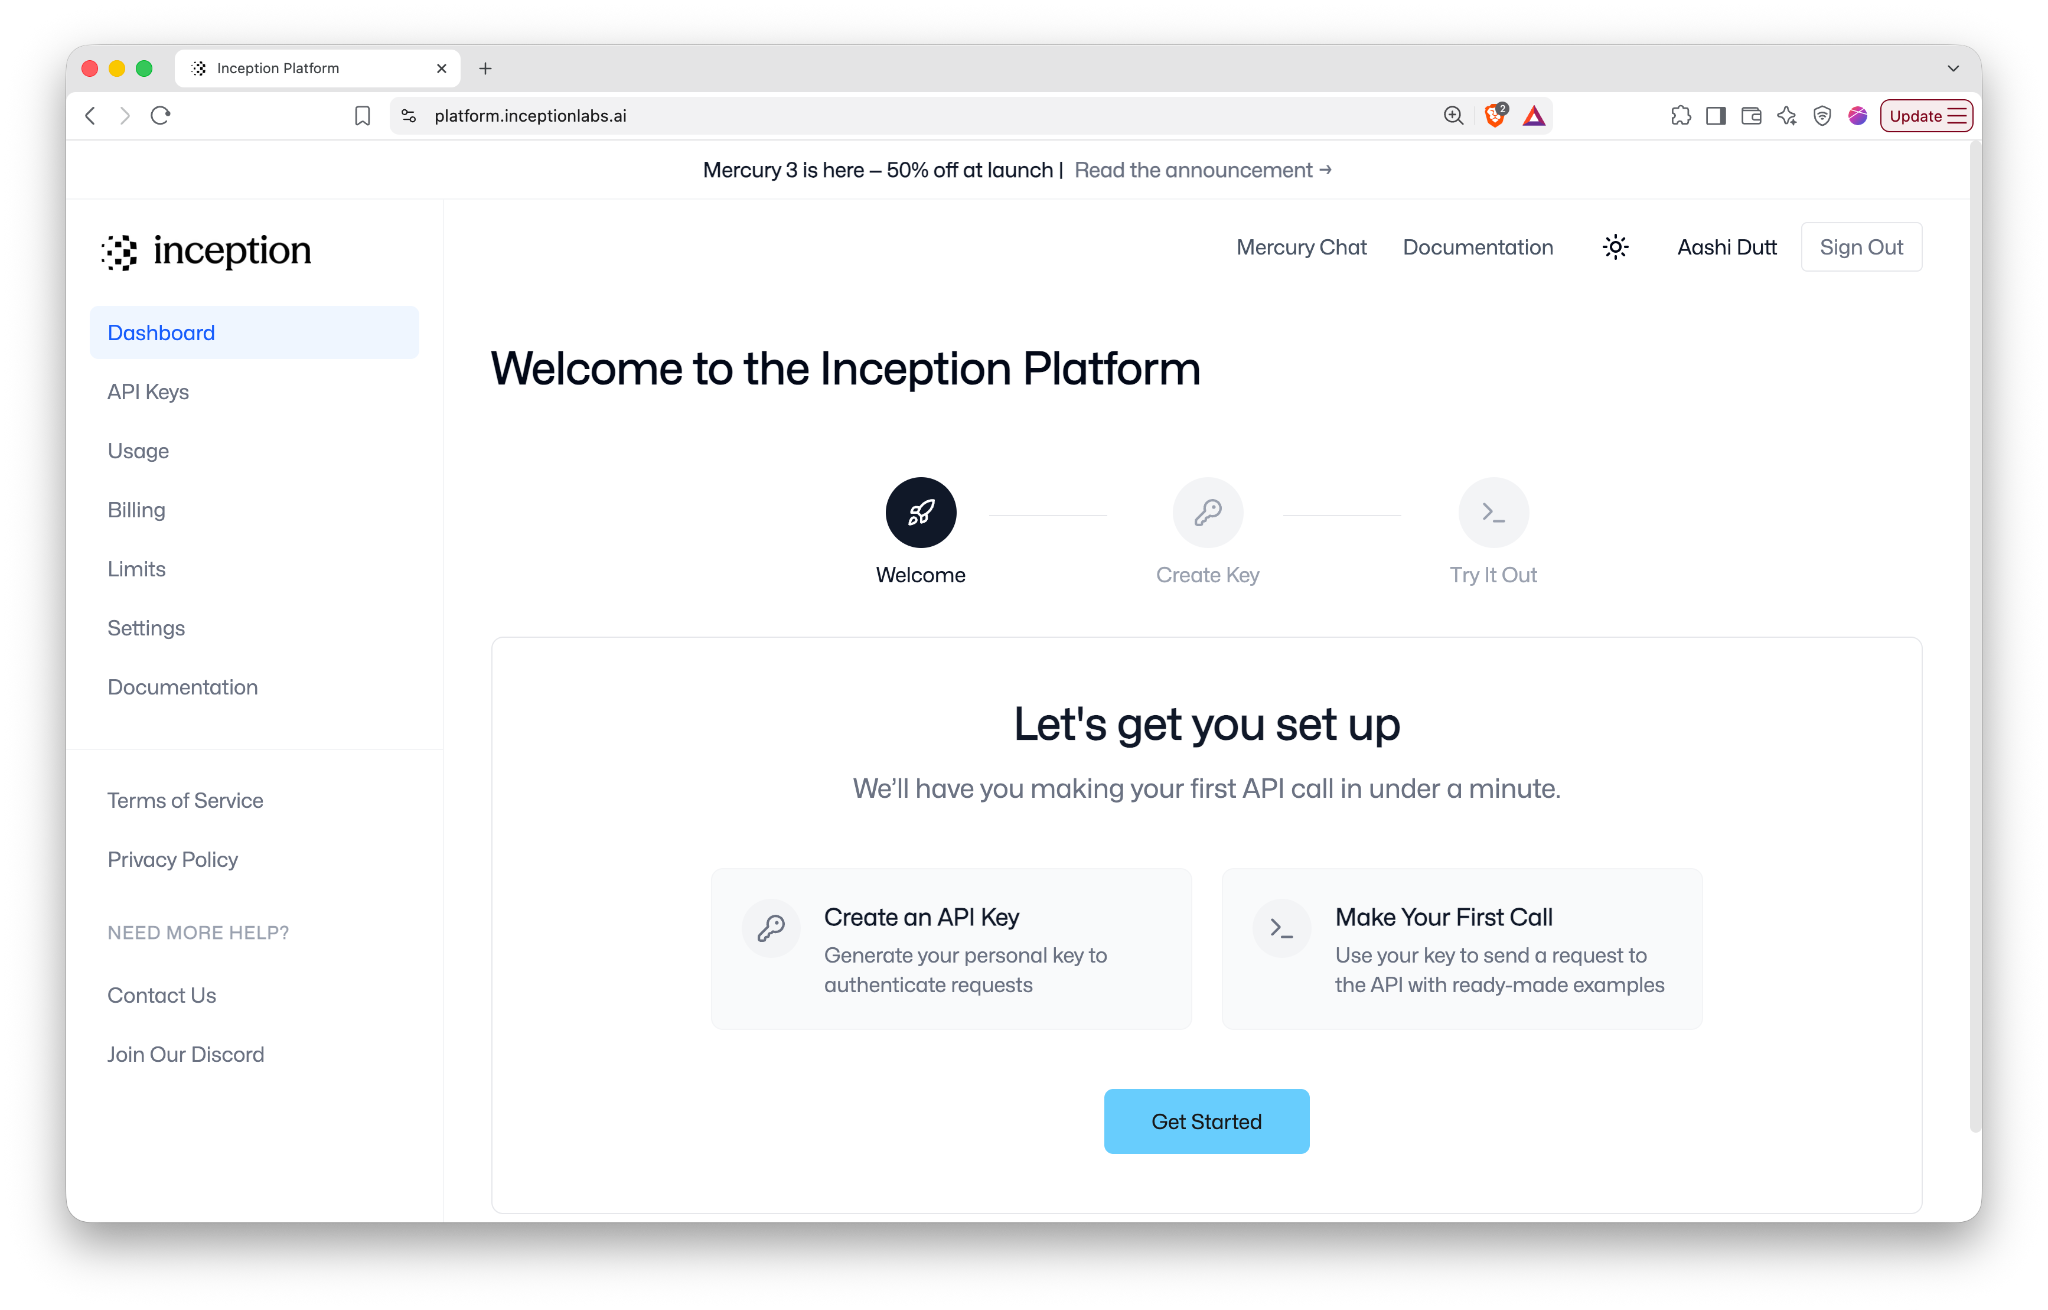
Notă: La momentul scrierii, Inception oferă 100 de milioane de tokeni gratuiți pentru conturile noi, pentru testarea API-ului.
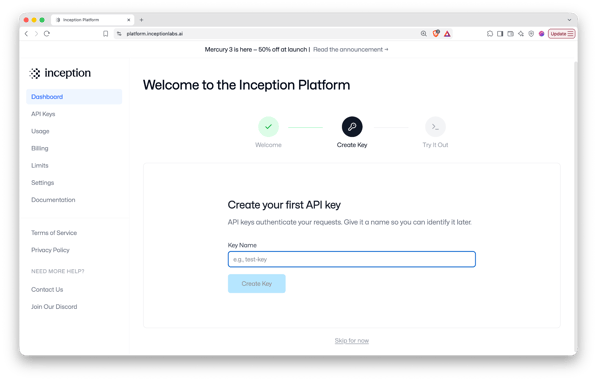
Îți poți denumi cheia API sau poți sări peste acest pas și să dai click pe Create Key.
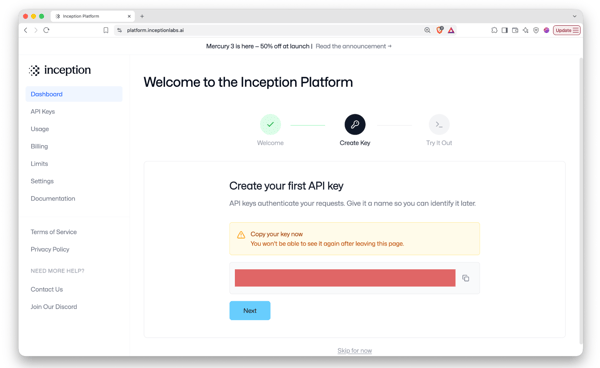
Apoi, copiază cheia API și fă primul tău apel la API.
Pasul 2: Testează Mercury 3
Înainte de a scrie cod, poți testa Mercury 3 direct din Platforma Inception. După ce creezi cheia API, dă click pe Next și selectează butonul Run it now din fila Try It Out.
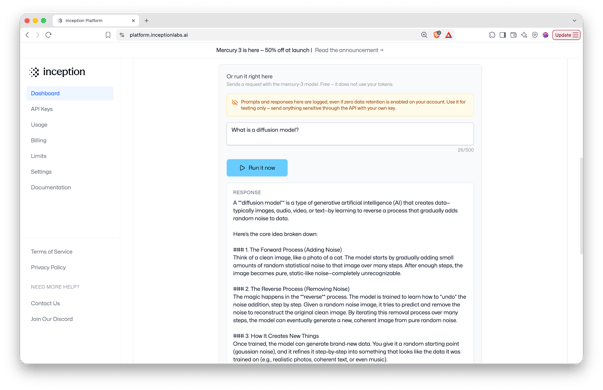
Acest lucru e util pentru a testa rapid prompturi și setări ale modelului înainte de a le muta într-o aplicație.
Pasul 3: Pregătește mediul și fă un apel la API
Pentru restul acestui tutorial, vom apela Mercury 3 din Python. Începe prin a instala SDK-ul inception și exportă cheia API astfel:
!pip install -q inceptionaiApoi importă pachetele folosite de demo:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass cere cheia API fără a o afișa, os o plasează acolo unde SDK-ul o caută, Path și json încarcă case_support.json și îl serializează în prompt, iar time.perf_counter() înregistrează când ajunge fiecare răspuns și stare de rafinare.
difflib compară stările de difuzie consecutive, iar clear_output() înlocuiește outputul celulei, astfel încât reluarea să se întâmple în același loc, nu în cascadă pe pagină.
Dacă cheia API nu este deja setată, o poți solicita interactiv:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() citește cheia API din mediul de lucru. În timp ce celelalte importuri, precum time, înregistrează când sosesc stările de rafinare, difflib ajută la compararea textelor intermediare, iar clear_output() ne permite să rederulăm procesul de difuzie în același loc.
Pasul 4: Construiește mesajele Modelului
Cazul de suport este stocat separat în case_support.json. Fișierul caz conține mesajul clientului, informații despre comandă, înregistrări de plată, loguri de îndeplinire, politica de suport și prompturile pe care vrem să le folosim pentru acest scenariu.
Îți poți construi propriul caz sau îl poți folosi ca atare:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Acum, hai să încărcăm fișierul JSON:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Înainte de a-l trimite către Mercury 3, separăm configurația promptului de evidențe:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]Cheile system_prompt, task_prompt și packet_label controlează modul în care instruim Mercury, așa că sunt eliminate din evidențe înainte ca dosarul cazului să fie serializat. Putem acum pregăti mesajele finale:
messages = build_messages(case)Aici nu este implicat niciun sistem de regăsire sau tool extern. Tot ce are nevoie Mercury pentru această analiză este furnizat direct în cerere.
Pasul 5: Fă o cerere către Mercury 3
Înainte de a testa streamingul, să facem o cerere normală, fără streaming. Helperul următor învelește apelul către API-ul Mercury și înregistrează metadatele răspunsului:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Acum să definim un apel de model:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}Principalele controale din partea modelului sunt:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensPutem acum face un apel de bază:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury primește întregul caz de suport și returnează analiza cerută, inclusiv cea mai probabilă explicație, dovezile care o susțin, explicații alternative, incertitudini și următoarele acțiuni recomandate.
Funcția înregistrează, de asemenea, câmpurile elapsed_s și usage. Primul măsoară timpul end-to-end al cererii, în timp ce celălalt include contabilitatea tokenilor, inclusiv folosirea raportată a tokenilor de raționare.
Pe parcursul rulărilor folosite în acest tutorial, Mercury a identificat în mod constant a doua înregistrare de plată ca fiind cel mai probabil o autorizare în așteptare, mai degrabă decât dovada unei a doua comenzi confirmate. Totuși, în mod deliberat cazul nu are suficiente informații pentru a ști dacă acea autorizare în așteptare va dispărea sau se va deconta în final.
Pasul 6: Adaugă streaming standard
O cerere normală așteaptă ca Mercury să termine înainte de a returna răspunsul complet. Pentru a primi răspunsul incremental, trebuie să activăm stream=True. Funcția de streaming standard arată astfel:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Comportamentul important aici este chunks.append(content) în streamingul standard, unde fiecare fragment conține următoarea bucată din răspuns, astfel încât fragmentele pot fi acumulate și reconstruite în răspunsul final cu "".join(chunks).
Notă: Timpul median până la primul output vizibil a fost 2,903 secunde, în timp ce latența totală mediană a fost 3,375 secunde.
Pasul 7: Comută la streaming prin difuzie
Pentru a activa streamingul prin difuzie, setează următorii parametri la True:
stream=True
diffusing=TrueApelul API diferă de streamingul standard printr-un singur argument în plus, adică diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}Cu streamingul standard, fragmentele sunt adăugate. Însă cu streamingul prin difuzie, cel mai recent fragment nenul reprezintă versiunea completă curentă a răspunsului. Așadar, în loc să-l adăugăm, înlocuim ceea ce a fost afișat anterior.
Păstrăm și stările returnate pentru a măsura numărul de stări de rafinare și pentru a verifica dacă stările ulterioare chiar revizuiesc textul apărut anterior.
Pe cinci rulări, streamingul prin difuzie a returnat o mediană de 9 stări de rafinare vizibile, cu un interval 7–12. Timpul median până la prima stare vizibilă a fost 1,896 secunde, iar latența totală mediană a fost 2,560 secunde.
Pasul 8: Compară streamingul standard cu cel prin difuzie
Acum că înțelegem ambele căi de cod, putem compara comportamentul măsurat.
|
Metrică |
Standard |
Difuzie |
|
Mediana fragmente/stări |
6 |
9 |
|
Interval |
5–7 |
7–12 |
|
Mediană primul output vizibil |
2,903 s |
1,896 s |
|
Latență totală mediană |
3,375 s |
2,560 s |
Pentru acest prompt de suport, difuzia a avut o latență mediană mai mică, dar intervalele se suprapun substanțial. Așadar, nu ar trebui să concluzionăm că streamingul prin difuzie este inerent mai rapid.
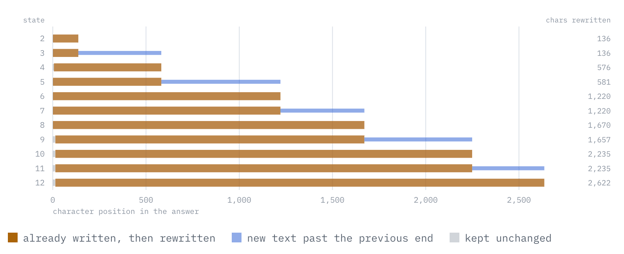
Figura: Rulare cu 12 stări, tranziție cu tranziție. Bara maro este text pe care Mercury 3 îl scrisese deja și apoi l-a înlocuit, în timp ce bara albastră este textul nou după capătul anterior. Un append pur nu ar arăta deloc maro.
În rulările mele, stările de difuzie returnate au revizuit textul vizibil anterior, mai degrabă decât să se comporte ca fragmente doar de adăugat. În runda de mai sus, niciuna dintre cele 11 tranziții de stare nu a fost un append pur, iar fiecare a deviat de la starea anterioară în primele 14 caractere.
Pasul 9: Testează bugetul de completare
În continuare, să analizăm comportamentul Mercury 3 privind interacțiunea tokenilor de raționare cu bugetul de completare. Apelurile normale de mai sus folosesc max_completion_tokens=8192, dar pentru a evidenția mai clar comportamentul, trebuie să reducem max_completion_tokens la 1600.
Acum, rulează aceeași cerere o dată cu efort de raționare scăzut și o dată cu ridicat. Iată rezultatul măsurat:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneLa ridicat, toți cei 1.539 tokeni de completare au fost raportați ca tokeni de raționare. Prin urmare, modelul a atins limita de completare înainte de a returna text de răspuns vizibil.
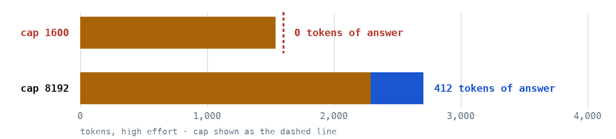
Figura: Buget de completare la efort ridicat, cu plafon de 1.600 și 8.192 tokeni
La plafonul de 1.600, întregul buget a mers pe raționare și nu a mai rămas nimic pentru emitere. La 8.192, rularea mediană cu efort ridicat a cheltuit 2.292 tokeni pentru raționare și tot a mai avut loc pentru un răspuns de 412 tokeni. Plafonul de 8.192 se află în afara marginii din dreapta a acestei scale, motiv pentru care doar primul rând din imaginea de mai sus arată o linie punctată a plafonului.
Semnalul important în cererea eșuată la ridicat este response.choices[0].finish_reason, care a returnat length. Asta înseamnă că cererea a atins bugetul maxim de tokeni de completare (max_completion_tokens). Acest buget include atât tokenii de raționare, cât și tokenii de output vizibil. În această rulare, Mercury 3 a raportat toți cei 1.539 tokeni de completare ca tokeni de raționare, așa că cererea a atins limita de completare înainte de a produce un răspuns vizibil.
Notă: Pentru acest demo, max_completion_tokens=8192 a fost suficient pentru rulările rămase, dar nu ar trebui tratat ca un minim universal.
Pasul 10: Compară efortul de raționare scăzut și ridicat
Revenim acum la bugetul normal de completare 8192 și variem doar reasoning_effort între scăzut și ridicat. Vom folosi helperul run_nonstream() din Pasul 5 pentru a face o cerere cu efort scăzut și alta cu efort ridicat:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Pentru rezultatele raportate, am repetat fiecare configurație de cinci ori, nu m-am bazat pe o singură cerere.
Medianele au fost:
|
Metrică |
Scăzut |
Ridicat |
|
Latență end-to-end |
2,936 s |
8,146 s |
|
Tokeni de completare |
1312 |
2723 |
|
Tokeni de raționare |
828 |
2292 |
|
Aprox. tokeni vizibili |
468 |
412 |
|
Pondere raționare |
63% |
84% |
Folosirea mediană a raționării a crescut de la 828 la 2.292 tokeni, în timp ce latența mediană a crescut de la 2,936 la 8,146 secunde (aprox. 2,77x).
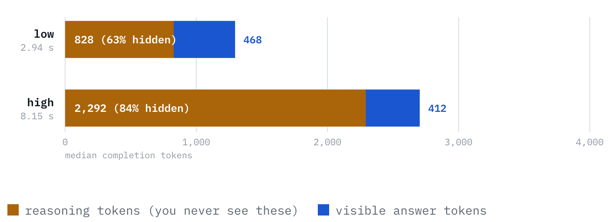
Figura: Unde merge bugetul de completare la fiecare nivel de efort?
Lungimea răspunsului vizibil nu s-a schimbat nici pe departe la fel de mult:
- Scăzut: mediană 468 tokeni
- Ridicat: mediană 412 tokeni
iar intervalele observate s-au suprapus:
- Scăzut: 393–494
- Ridicat: 356–469
Așadar, aceste rulări nu susțin afirmația că mărirea efortului de raționare face răspunsul vizibil mai scurt. Intervalele de latență arată, de asemenea, de ce o singură rulare nu e suficientă:
- Scăzut: 1,602–4,993 s
- Ridicat: 4,102–9,068 s
Notă: Cea mai rapidă cerere la ridicat a fost de fapt mai rapidă decât cea mai lentă la scăzut.
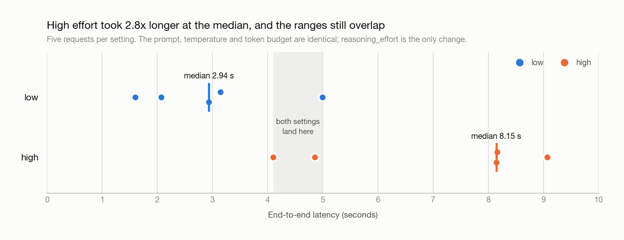
Figura: Toate cele zece cereri cu efort de raționare, reprezentate după latență
Așadar, reasoning_effort="high" a crescut substanțial folosirea raportată a tokenilor de raționare și latența în acest experiment, în timp ce lungimea răspunsului vizibil a rămas în linii mari similară.
Gânduri finale
Există trei comportamente practice ale Mercury 3:
-
Streamingul prin difuzie folosește un contract de output diferit. Streamingul standard adaugă text nou, în timp ce streamingul prin difuzie returnează stări succesive ale răspunsului complet, care ar trebui să înlocuiască starea anterioară.
-
Tokenii de raționare împart bugetul de completare. O valoare mică pentru
max_completion_tokenspoate fi epuizată de raționare înainte ca Mercury 3 să producă un răspuns vizibil. -
Un efort de raționare mai mare schimbă latența contra calcule suplimentare. În rulările mele, modul ridicat a folosit mult mai mulți tokeni de raționare raportați și a durat mai mult, așa cum era de așteptat, în timp ce lungimea răspunsului vizibil a rămas în linii mari similară.
Aceste rezultate provin dintr-un număr mic de rulări pe un caz sintetic de suport, deci ar trebui tratate ca observații ale acestui demo, nu ca afirmații generale despre performanța Mercury 3.
Întrebări frecvente despre Mercury 3
Care este principala diferență între streamingul standard și cel prin difuzie în Mercury 3?
Cu streamingul standard, răspunsul sosește ca fragmente de text care se adaugă unul altuia. Cu streamingul prin difuzie, API-ul expune revizuiri succesive ale răspunsului curent, astfel încât cea mai recentă stare ar trebui să o înlocuiască pe cea anterioară, nu să fie adăugată la ea.
Produce întotdeauna reasoning_effort="high" un răspuns mai bun?
Nu. Un efort de raționare mai mare îi oferă lui Mercury mai mult spațiu pentru raționare, dar asta nu garantează un răspuns mai bun pentru fiecare sarcină. În acest demo, modul ridicat a folosit semnificativ mai mulți tokeni de raționare și a durat mai mult, în timp ce lungimea răspunsului vizibil a rămas similară. A fost, de asemenea, mai consecvent în a evidenția o piesă lipsă de dovadă, dar experimentul a fost prea mic pentru a formula afirmații mai largi despre calitate.
De ce poate Mercury 3 să nu returneze niciun răspuns vizibil atunci când max_completion_tokens este prea mic?
Tokenii de raționare se contabilizează în același buget de tokeni de completare ca și răspunsul vizibil. Dacă modelul consumă cea mai mare parte sau întregul buget în timp ce raționează, poate atinge limita de completare înainte de a produce output vizibil. În acest caz, verificarea finish_reason și a folosirii raportate a tokenilor de raționare ajută la explicarea situației.
Este streamingul prin difuzie întotdeauna mai rapid decât streamingul standard?
Nu. În acest demo, streamingul prin difuzie a avut un timp median mai mic până la primul output vizibil și o latență totală mediană mai mică, dar intervalele s-au suprapus, iar un alt prompt a produs ordonarea opusă. Diferența mai fiabilă este comportamentul la streaming, nu o îmbunătățire garantată a latenței.
Când ar trebui să folosesc Mercury 3?
Mercury 3 este deosebit de interesant pentru aplicațiile sensibile la latență, unde utilizatorii beneficiază de răspunsuri rapide, în timp ce modelul efectuează totuși raționare non-trivială. Efortul de raționare și bugetul de completare potrivite depind de sarcină, așa că ar trebui ajustate atât în raport cu latența, cât și cu calitatea răspunsului.
Mercury 3 este un model lingvistic mare bazat pe difuzie, creat de Inception.ai. Spre deosebire de LLM-urile autoregresive convenționale care generează text câte un token pe rând, Mercury folosește difuzia pentru a rafina iterativ mai multe părți ale răspunsului. Modelul depășește GPT-6 Luna și Claude Haiku 5.5, rulând totodată de 4–8 ori mai rapid la peste 1.000 de tokeni pe secundă pe GPU-uri NVIDIA și acceptând o fereastră de context de 1M tokeni.
În acest tutorial, vom construi un mic asistent de analiză a incidentelor care primește loguri de aplicație, informații despre deployment, metrici GPU și urme de cereri. Apoi vom folosi aceeași sarcină pentru a explora două proprietăți ale Mercury 3:
Cum diferă streamingul prin difuzie de streamingul obișnuit al LLM-urilor
Ce se schimbă atunci când creștem
reasoning_effortde la scăzut la ridicat?Pe parcurs, vom întâlni și o problemă importantă de buget de tokeni, care contează când folosești modurile de raționare ale lui Mercury. La final, vei ști cum să:
Cod complet în repository.
Ce este Mercury 3?
Spre deosebire de LLM-urile autoregresive convenționale, care generează un răspuns strict de la stânga la dreapta, Mercury aparține unei familii de modele care rafinează iterativ mai multe poziții de tokeni în timpul generării. Abordarea Inception este ideală pentru sarcini sensibile la latență precum agenți, căutare, suport clienți, educație și alte aplicații unde apelurile repetate la model se pot aduna rapid.
Mercury 3 combină acest proces de generare bazat pe difuzie cu capabilități așteptate de la un model API de uz general, inclusiv input cu context lung, controale de raționare, apelare de tool-uri, ieșiri structurate și endpointuri compatibile cu OpenAI. Oferă, de asemenea, un mod de streaming
diffusing=Truecare permite aplicațiilor să primească stările intermediare de rafinare a textului complet al modelului, nu doar blocuri de ieșire adăugate incremental.La momentul scrierii, Mercury 3 acceptă următoarele:
Proprietate
Mercury 3
Fereastră de context
1M tokeni
Ieșire maximă
131.072 tokeni
Efort de raționare
instant, low, medium, high
Apelare de tool-uri
Acceptată
Ieșire structurată
Acceptată
Streaming
Acceptat
Streaming prin difuzie
Acceptat
Temperatură
0,5–1,0
API
Compatibil OpenAI
Inception listează în prezent Mercury 3 la un preț de lansare de 0,10 USD per milion de tokeni de input, 0,01 USD per milion de tokeni de input din cache și 0,35 USD per milion de tokeni de output. Tokenii din cache au, de asemenea, o reducere de 90% față de prețul de input.
Mercury 3 este de 40 de ori mai mare decât Mercury 1 și mult mai inteligent, dar la fel de rapid.
Figura: Calitatea modelului vs Dimensiunea modelului (Sursa)
Cum funcționează Mercury 3?
Majoritatea LLM-urilor generează text autoregresiv de la stânga la dreapta, câte un token pe rând. Iată cum generează text LLM-urile tradiționale:
Fiecare nou token depinde de tot ce a fost generat înainte.
Mercury folosește în schimb difuzia.
Inception își descrie LLM-urile cu difuzie ca modele bazate pe Transformer care îmbunătățesc progresiv un output prin modificarea în paralel a mai multor tokeni. Cercetările anterioare Mercury descriu acest lucru ca pe un proces de generare de la „grosier la fin”, mai degrabă decât o prezicere strictă a următorului token de la stânga la dreapta.
O ilustrare simplificată ar putea arăta astfel: