

Il s'agit uniquement d'un exemple conceptuel, pas de la représentation interne exacte de Mercury 3.
L'API d'Inception peut exposer ces états intermédiaires. Avec le streaming standard, Mercury renvoie des blocs de texte raffinés qui peuvent être ajoutés à la réponse. Avec diffusing=True, chaque fragment contient au contraire la version complète actuelle de la réponse telle que le modèle l'affine.
Nous verrons la différence dans un instant.
Démo : créer un assistant d'escalade support en temps réel
Avant de construire la démo, séparons les paramètres du modèle de l'application de support elle-même.
Le cas support n'est que l'entrée que nous utilisons pour mettre Mercury 3 à l'épreuve. Les contrôles côté modèle importants sont le budget de raisonnement, le budget de complétion et le mode de streaming.
|
Réglage |
Valeur utilisée |
Pourquoi c'est important |
|
Température |
0,75 |
Maintenue fixe pour ne pas changer l'échantillonnage lors de la comparaison des modes |
|
Effort de raisonnement |
low, high |
Nous permet de comparer l'usage de raisonnement caché et la latence |
|
Budget de complétion |
8192 |
Assez grand pour les exécutions de démo mesurées |
|
Streaming standard |
stream=True |
Renvoie des blocs de texte ajoutables |
|
Streaming par diffusion |
stream=True, diffusing=True |
Renvoie des états successifs de raffinage du texte complet |
|
Invite |
Cas support fixe |
Maintient la tâche constante pendant que les réglages du modèle varient |
|
Répétitions |
5 par condition |
Montre la variation d'une exécution à l'autre au lieu de s'appuyer sur une seule requête |
Ce sont des réglages de travail pour cette expérimentation, pas des paramètres Mercury 3 optimaux en général.
Étape 1 : prérequis
La prise en main de Mercury 3 tient en quelques étapes. Pour suivre, il vous faut :
- Une clé API Inception
- Python 3
- Le package inceptionai
- Le cas support enregistré sous
case_support.json
Commencez par vous inscrire sur la plateforme Inception et récupérer la clé API. Cliquez sur Get Started et renseignez les informations :
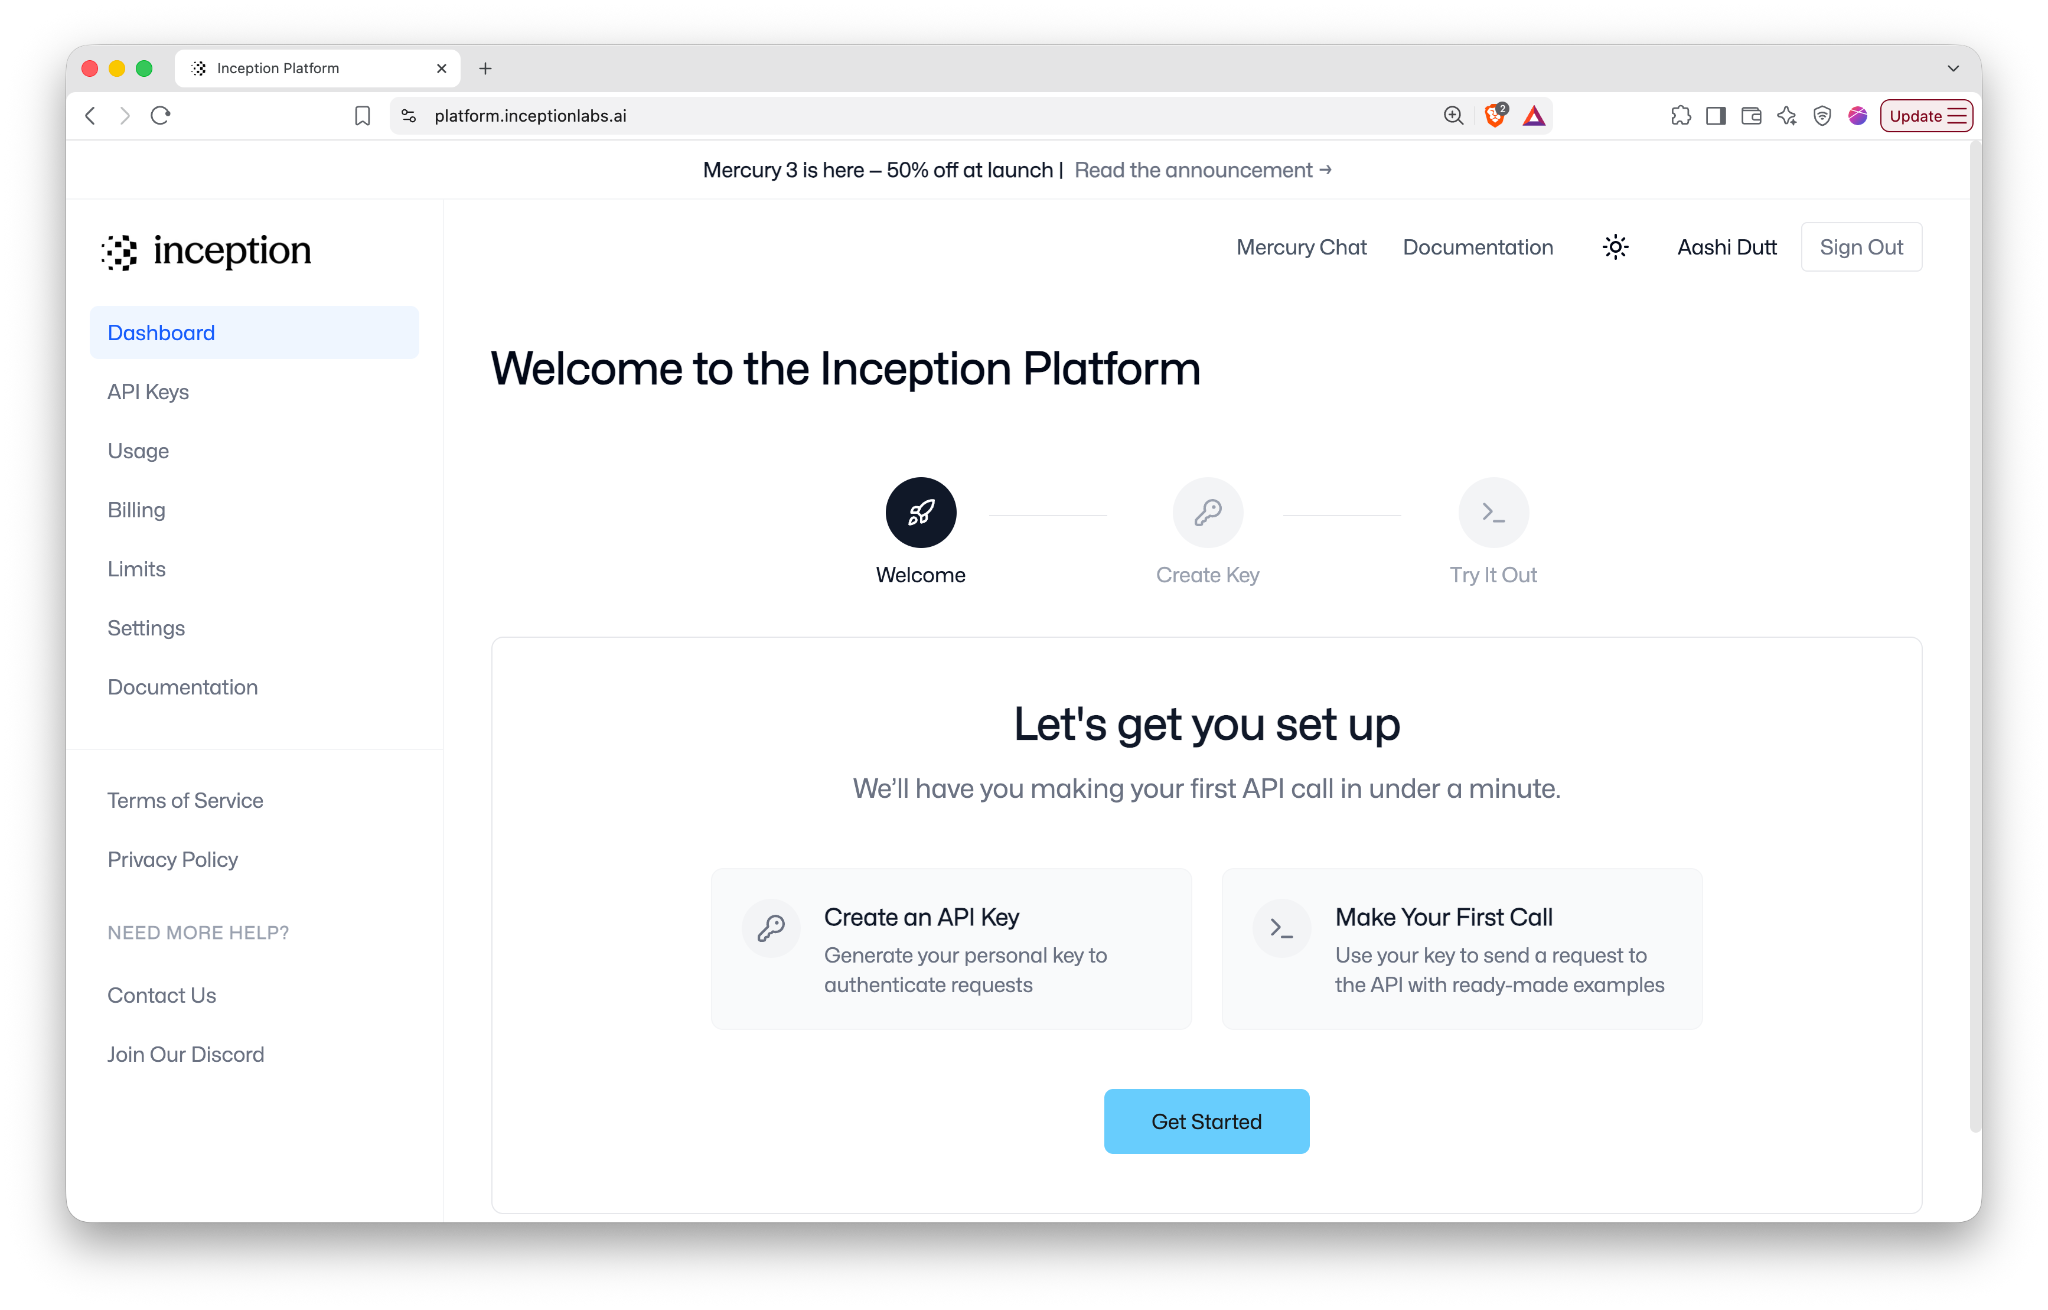
Remarque : au moment de la rédaction, Inception offre 100 millions de jetons gratuits aux nouveaux comptes pour tester l'API.
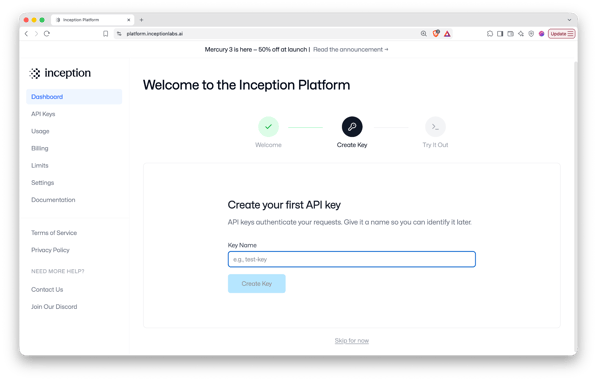
Vous pouvez nommer votre clé API ou simplement passer cette étape et cliquer sur Create Key.
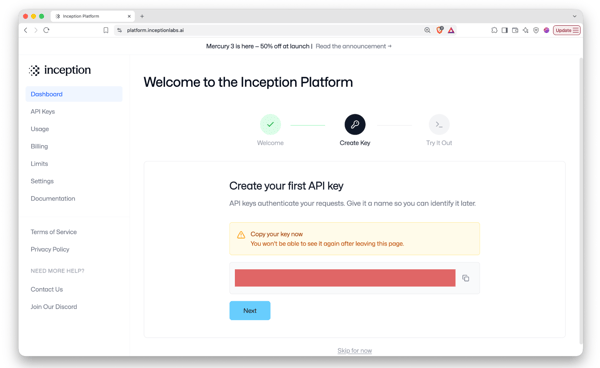
Copiez ensuite la clé API et effectuez votre premier appel.
Étape 2 : essayer Mercury 3
Avant d'écrire du code, vous pouvez tester Mercury 3 directement depuis la plateforme Inception. Après avoir créé votre clé API, cliquez sur Next puis sélectionnez le bouton Run it now dans l'onglet Try It Out.
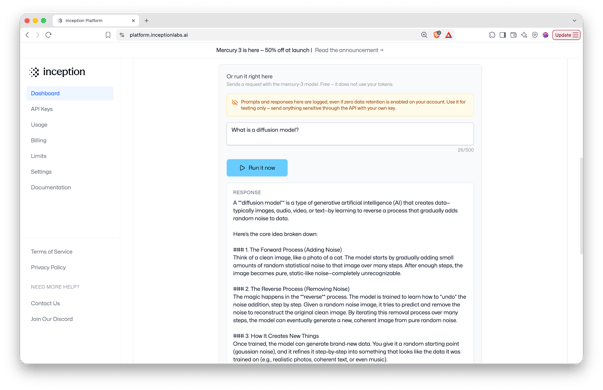
C'est utile pour tester rapidement des invites et des réglages de modèle avant de les intégrer à une application.
Étape 3 : préparer l'environnement et effectuer un appel API
Pour la suite de ce tutoriel, nous appellerons Mercury 3 depuis Python. Commencez par installer le SDK Inception et exporter la clé API comme suit :
!pip install -q inceptionaiImportez ensuite les packages utilisés par la démo :
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass demande la clé API sans l'afficher, os la place là où le SDK va la chercher, Path et json chargent case_support.json et le sérialisent dans l'invite, et time.perf_counter() enregistre le moment d'arrivée de chaque réponse et état de raffinage.
difflib compare des états de diffusion consécutifs et clear_output() remplace la sortie de cellule pour rejouer l'affinage sur place, plutôt que d'empiler les états vers le bas de la page.
Si la clé API n'est pas déjà définie, vous pouvez la demander de manière interactive :
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() lit la clé API depuis l'environnement. Les autres imports servent, par exemple time à chronométrer l'arrivée des états, difflib à comparer le texte intermédiaire, et clear_output() à rejouer le processus de diffusion en place.
Étape 4 : construire les messages du modèle
Le cas support est stocké séparément dans case_support.json. Le fichier contient le message client, les informations de commande, les enregistrements de paiement, les journaux de fulfillment, la politique de support et les invites à utiliser pour ce scénario.
Vous pouvez créer le vôtre ou utiliser celui-ci tel quel :
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Chargeons maintenant le fichier JSON :
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Avant de l'envoyer à Mercury 3, nous séparons la configuration de l'invite des éléments de preuve :
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]Les clés system_prompt, task_prompt et packet_label pilotent la façon dont nous instruisons Mercury ; elles sont donc retirées des éléments de preuve avant la sérialisation du cas. Nous pouvons maintenant préparer les messages finaux :
messages = build_messages(case)Il n'y a ici aucun système de recherche ni outil externe. Tout ce dont Mercury a besoin pour cette analyse est fourni directement dans la requête.
Étape 5 : effectuer une requête vers Mercury 3
Avant de tester le streaming, faisons une requête classique non diffusée. L'aide suivante encapsule l'appel à l'API Mercury et enregistre les métadonnées de réponse :
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Définissons maintenant un appel au modèle :
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}Les principaux contrôles côté modèle sont :
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensNous pouvons maintenant effectuer un appel de référence :
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury reçoit l'intégralité du cas support et renvoie l'analyse demandée, notamment l'explication la plus probable, les preuves à l'appui, des hypothèses alternatives, les incertitudes et les prochaines actions recommandées.
La fonction enregistre également les champs elapsed_s et usage. Le premier mesure le temps de bout en bout de la requête, tandis que le second inclut la comptabilisation des jetons, dont l'usage rapporté des jetons de raisonnement.
Dans les exécutions de ce tutoriel, Mercury a systématiquement identifié la seconde entrée de paiement comme étant très probablement une autorisation en attente plutôt qu'une preuve d'une deuxième commande confirmée. Toutefois, le cas manque volontairement d'informations suffisantes pour savoir si cette autorisation en attente disparaîtra ou se réglera.
Étape 6 : ajouter le streaming standard
Une requête classique attend que Mercury ait terminé avant de renvoyer la réponse complète. Pour recevoir la réponse de manière incrémentale, il faut activer stream=True. La fonction de streaming standard ressemble à ceci :
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Le comportement clé ici est chunks.append(content) en streaming standard : chaque fragment contient la suite de la réponse, de sorte qu'on peut les accumuler et reconstruire la réponse finale avec "".join(chunks).
Remarque : la médiane du délai jusqu'au premier affichage était de 2,903 secondes, tandis que la latence totale médiane était de 3,375 secondes.
Étape 7 : passer au streaming par diffusion
Pour activer le streaming par diffusion, définissez les paramètres suivants sur True :
stream=True
diffusing=TrueL'appel d'API ne diffère du streaming standard que par un argument supplémentaire, à savoir diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}Avec le streaming standard, on ajoute les fragments à la suite. Avec le streaming par diffusion, le dernier fragment non vide représente la version courante complète de la réponse. Il faut donc remplacer l'affichage précédent plutôt que l'allonger.
Nous conservons également les états renvoyés pour mesurer le nombre d'états de raffinage et vérifier si les états ultérieurs révisent effectivement du texte déjà affiché.
Sur cinq exécutions, le streaming par diffusion a renvoyé une médiane de 9 états visibles (plage : 7–12). La médiane du délai jusqu'au premier état visible était de 1,896 seconde, et la latence totale médiane de 2,560 secondes.
Étape 8 : comparer le streaming standard et par diffusion
Maintenant que nous comprenons les deux chemins, comparons les comportements mesurés.
|
Métrique |
Standard |
Diffusion |
|
Médiane fragments/états |
6 |
9 |
|
Plage |
5–7 |
7–12 |
|
Médiane du premier affichage |
2,903 s |
1,896 s |
|
Latence totale médiane |
3,375 s |
2,560 s |
La diffusion a présenté une latence médiane plus faible pour cette invite support particulière, mais les plages se recouvrent largement. Il ne faut donc pas conclure que le streaming par diffusion est intrinsèquement plus rapide.
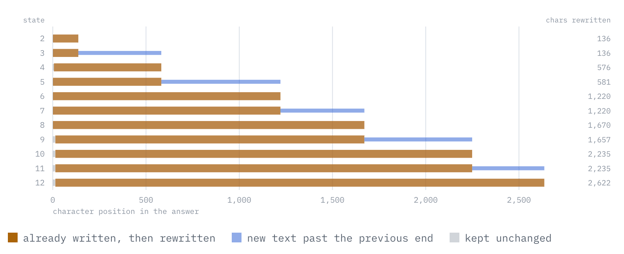
Figure : exécution à 12 états, transition par transition. La barre brune indique le texte que Mercury 3 avait déjà écrit puis remplacé, tandis que la barre bleue indique le nouveau texte au-delà de la fin précédente. Un simple ajout n'afficherait aucune section brune.
Dans mes exécutions, les états de diffusion renvoyés révisaient du texte déjà visible, plutôt que de se comporter comme des fragments en ajout seulement. Dans l'exécution ci-dessus, aucune des 11 transitions d'état n'était un ajout pur, et chacune divergeait de l'état précédent dans les 14 premiers caractères.
Étape 9 : tester le budget de complétion
Examinons à présent le comportement de Mercury 3 quand les jetons de raisonnement interagissent avec le budget de complétion. Les appels normaux ci-dessus utilisent max_completion_tokens=8192, mais pour mettre le phénomène en évidence, il faut réduire max_completion_tokens à 1600.
Relancez maintenant la même requête une fois avec un effort faible et une fois avec un effort de raisonnement élevé. Voici le résultat mesuré :
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneAvec un effort élevé, les 1 539 jetons de complétion ont été rapportés comme jetons de raisonnement. Le modèle a donc atteint la limite de complétion avant de renvoyer du texte visible.
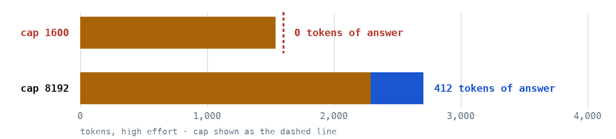
Figure : budget de complétion en effort élevé avec un plafond de 1 600 et 8 192 jetons
Au plafond de 1 600, tout le budget est parti dans le raisonnement et il ne restait rien à émettre. À 8 192, l'exécution médiane en effort élevé a consacré 2 292 jetons au raisonnement et disposait encore d'une réponse de 412 jetons. Le plafond à 8 192 déborde à droite de cette échelle, c'est pourquoi seule la première ligne de l'image ci-dessus affiche une ligne de plafond en pointillé.
Le signal important dans la requête échouée en effort élevé est response.choices[0].finish_reason, qui renvoie length. Cela signifie que la requête a atteint son budget maximal de jetons de complétion (max_completion_tokens). Ce budget inclut à la fois les jetons de raisonnement et les jetons de sortie visible. Dans cette exécution, Mercury 3 a indiqué que les 1 539 jetons de complétion étaient du raisonnement, de sorte que la limite a été atteinte avant toute réponse visible.
Remarque : pour cette démo, max_completion_tokens=8192 a suffi pour les autres exécutions, mais cela ne doit pas être considéré comme un minimum universel.
Étape 10 : comparer un effort de raisonnement faible et élevé
Revenons maintenant au budget de complétion normal de 8 192 et faisons varier uniquement reasoning_effort entre low et high. Nous utiliserons l'aide run_nonstream() de l'étape 5 pour effectuer une requête en effort faible puis une en effort élevé :
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Pour les résultats rapportés, j'ai répété chaque configuration cinq fois au lieu de m'appuyer sur une seule requête.
Les médianes étaient :
|
Métrique |
Faible |
Élevé |
|
Latence de bout en bout |
2,936 s |
8,146 s |
|
Jetons de complétion |
1312 |
2723 |
|
Jetons de raisonnement |
828 |
2292 |
|
Approx. jetons visibles |
468 |
412 |
|
Part du raisonnement |
63 % |
84 % |
L'usage médian de raisonnement est passé de 828 à 2 292 jetons, tandis que la latence médiane est passée de 2,936 à 8,146 secondes (soit environ × 2,77).
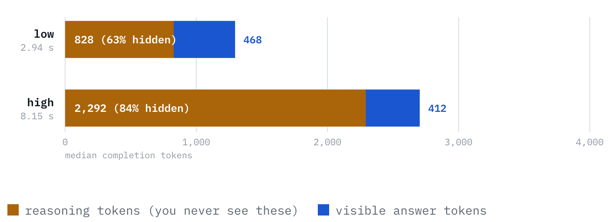
Figure : où va le budget de complétion selon le niveau d'effort ?
La longueur de la réponse visible a beaucoup moins varié :
- Faible : médiane de 468 jetons
- Élevé : médiane de 412 jetons
et les plages observées se recoupaient :
- Faible : 393–494
- Élevé : 356–469
Ces exécutions n'accréditent donc pas l'idée qu'augmenter l'effort de raisonnement raccourcit la réponse visible. Les plages de latence montrent aussi pourquoi une seule exécution ne suffit pas :
- Faible : 1,602–4,993 s
- Élevé : 4,102–9,068 s
Remarque : la requête la plus rapide en effort élevé était en fait plus rapide que la plus lente en effort faible.
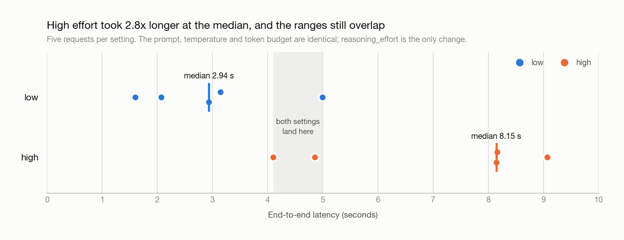
Figure : les dix requêtes par niveau d'effort, tracées par latence
Ainsi, reasoning_effort="high" a nettement augmenté l'usage rapporté des jetons de raisonnement et la latence dans cette expérience, tandis que la longueur de la réponse visible est restée globalement similaire.
Conclusion
Retenez trois comportements pratiques de Mercury 3 :
-
Le streaming par diffusion a un contrat de sortie différent. Le streaming standard ajoute du texte à la suite, tandis que le streaming par diffusion renvoie des états successifs de la réponse complète qui doivent remplacer le précédent.
-
Les jetons de raisonnement partagent le budget de complétion. Une valeur
max_completion_tokenstrop petite peut être épuisée par le raisonnement avant que Mercury 3 ne produise une réponse visible. -
Un effort de raisonnement plus élevé échange du calcul supplémentaire contre de la latence. Dans mes exécutions, l'effort élevé a utilisé nettement plus de jetons de raisonnement rapportés et a pris plus longtemps, comme attendu, tandis que la longueur de la réponse visible est restée globalement similaire.
Ces résultats proviennent d'un petit nombre d'exécutions sur un cas support synthétique unique ; ils doivent être considérés comme des observations de démo, pas comme des revendications générales de performance sur Mercury 3.

Je suis experte Google Developers en ML (Gen AI), triple experte Kaggle et ambassadrice Women Techmakers, avec plus de trois ans d’expérience dans la tech. J’ai cofondé une startup dans le domaine de la santé en 2020 et je poursuis actuellement un master en informatique à Georgia Tech, avec une spécialisation en apprentissage automatique.
Mercury 3 : FAQ
Quelle est la principale différence entre le streaming standard et le streaming par diffusion dans Mercury 3 ?
Avec le streaming standard, la réponse arrive par fragments de texte qui s'ajoutent les uns aux autres. Avec le streaming par diffusion, l'API expose des révisions successives de la réponse courante : le dernier état doit donc remplacer le précédent, et non s'y ajouter.
Est-ce que reasoning_effort=« high » produit toujours une meilleure réponse ?
Non. Un effort de raisonnement plus élevé donne à Mercury plus de marge pour raisonner, mais cela ne garantit pas une meilleure réponse pour chaque tâche. Dans cette démo, le mode élevé a nettement consommé plus de jetons de raisonnement et pris plus de temps, tandis que la longueur de la réponse visible est restée similaire. Il a également été plus constant pour faire ressortir un élément de preuve manquant, mais l'expérience est trop restreinte pour en tirer des conclusions globales sur la qualité.
Pourquoi Mercury 3 peut-il ne renvoyer aucune réponse visible quand max_completion_tokens est trop petit ?
Les jetons de raisonnement sont pris sur le même budget de complétion que la réponse visible. Si le modèle consomme la majeure partie, voire tout ce budget en raisonnant, il peut atteindre la limite de complétion avant de produire une sortie visible. Dans ce cas, vérifier finish_reason et l'usage rapporté des jetons de raisonnement aide à comprendre ce qui s'est passé.
Le streaming par diffusion est-il toujours plus rapide que le streaming standard ?
Non. Dans cette démo, le streaming par diffusion présentait une médiane plus faible pour le premier affichage et pour la latence totale, mais les plages se recoupaient, et une autre invite a produit l'ordre inverse. La différence la plus fiable tient au comportement de streaming, pas à une amélioration garantie de la latence.
Quand utiliser Mercury 3 ?
Mercury 3 est particulièrement intéressant pour les applications sensibles à la latence, qui bénéficient de réponses rapides tout en conservant un raisonnement non trivial. Le bon niveau d'effort de raisonnement et le budget de complétion dépendent de la tâche ; il faut donc les ajuster en fonction de la latence et de la qualité de réponse.





Mercury 3 est un grand modèle de langage par diffusion conçu par Inception.ai. Contrairement aux LLMs autorégressifs classiques qui génèrent le texte un jeton à la fois, Mercury utilise la diffusion pour affiner itérativement plusieurs parties de sa réponse. Le modèle surpasse GPT-6 Luna et Claude Haiku 5.5, tout en fonctionnant 4–8 fois plus vite à plus de 1 000 jetons par seconde sur des GPU NVIDIA, et il prend en charge une fenêtre de contexte d'un million de jetons.
Dans ce tutoriel, nous allons créer un petit assistant d'analyse d'incidents qui reçoit des journaux applicatifs, des informations de déploiement, des métriques GPU et des traces de requêtes. Nous utiliserons ensuite la même tâche pour explorer deux propriétés de Mercury 3 :
En quoi le streaming par diffusion diffère du streaming LLM classique
Que se passe-t-il quand on augmente
reasoning_effortde faible à élevé ?Au passage, nous tomberons aussi sur un point important autour du budget de jetons, crucial avec les modes de raisonnement de Mercury. À la fin, vous saurez :
Code complet sur le référentiel.
Qu'est-ce que Mercury 3 ?
Contrairement aux LLMs autorégressifs traditionnels qui génèrent une réponse strictement de gauche à droite, Mercury appartient à une famille de modèles qui affinent itérativement plusieurs positions de jetons pendant la génération. L'approche d'Inception convient aux charges sensibles à la latence, comme les agents, la recherche, le support client, l'éducation et d'autres applications où les appels répétés au modèle s'additionnent vite.
Mercury 3 combine ce processus de génération par diffusion avec les capacités attendues d'un modèle API généraliste : long contexte en entrée, contrôles de raisonnement, appel d'outils, sorties structurées et points de terminaison compatibles OpenAI. Il expose également un mode de streaming
diffusing=Truequi permet aux applications de recevoir les états intermédiaires de raffinage en plein texte, et pas seulement des blocs à ajouter en fin de sortie.Au moment de la rédaction, Mercury 3 prend en charge :
Propriété
Mercury 3
Fenêtre de contexte
1 million de jetons
Sortie maximale
131 72 jetons
Effort de raisonnement
instant, low, medium, high
Appel d'outils
Pris en charge
Sortie structurée
Pris en charge
Streaming
Pris en charge
Streaming par diffusion
Pris en charge
Température
0,5–1,0
API
Compatible OpenAI
Inception affiche actuellement Mercury 3 au tarif de lancement de 0,10 $ par million de jetons en entrée, 0,01 $ par million de jetons en entrée mis en cache, et 0,35 $ par million de jetons en sortie. Les jetons mis en cache bénéficient également de 90 % de remise par rapport au prix d'entrée.
Mercury 3 est 40 fois plus grand que Mercury 1 et nettement plus intelligent, tout en restant aussi rapide.
Figure : qualité du modèle vs taille du modèle (source)
Comment fonctionne Mercury 3 ?
La plupart des LLMs génèrent du texte de manière autorégressive, de gauche à droite, un jeton à la fois. Voici comment les LLMs traditionnels génèrent du texte :
Chaque nouveau jeton dépend de tout ce qui a été généré avant lui.
Mercury utilise à la place la diffusion.
Inception décrit ses LLMs par diffusion comme des modèles basés sur des Transformers qui améliorent progressivement une sortie en modifiant plusieurs jetons en parallèle. Les premiers travaux sur Mercury décrivent cela comme un processus de génération du grossier au fin, plutôt qu'une stricte prédiction du prochain jeton de gauche à droite.
Une illustration simplifiée pourrait ressembler à ceci :