

Đây chỉ là ví dụ mang tính khái niệm, không phải biểu diễn nội bộ chính xác của Mercury 3.
API của Inception có thể phơi bày các trạng thái trung gian này. Với streaming thông thường, Mercury trả về các khối văn bản đã tinh chỉnh có thể nối thêm vào phản hồi. Với diffusing=True, mỗi khối thay vào đó chứa phiên bản hoàn chỉnh hiện tại của câu trả lời khi mô hình tinh chỉnh nó.
Chúng ta sẽ sớm thấy sự khác biệt.
Demo: Xây dựng Trợ lý Leo thang Hỗ trợ Thời gian Thực
Trước khi xây dựng bản demo, hãy tách cài đặt mô hình khỏi chính ứng dụng hỗ trợ.
Tình huống hỗ trợ chỉ là đầu vào chúng ta dùng để vận hành Mercury 3. Các điều khiển phía mô hình quan trọng là ngân sách suy luận, ngân sách hoàn thành và chế độ streaming.
|
Thiết lập |
Giá trị dùng |
Vì sao quan trọng |
|
Nhiệt độ |
0,75 |
Giữ cố định để không đổi cách lấy mẫu khi so sánh các chế độ |
|
Nỗ lực suy luận |
low, high |
Cho phép so sánh mức dùng suy luận ẩn và độ trễ |
|
Ngân sách hoàn thành |
8192 |
Đủ lớn cho các lượt chạy demo được đo |
|
Streaming tiêu chuẩn |
stream=True |
Trả về các khối văn bản có thể nối thêm |
|
Streaming khuếch tán |
stream=True, diffusing=True |
Trả về các trạng thái tinh chỉnh toàn văn liên tiếp |
|
Prompt |
Tình huống hỗ trợ cố định |
Giữ tác vụ bất biến trong khi thay đổi cài đặt mô hình |
|
Lặp lại |
5 mỗi điều kiện |
Hiển thị biến thiên giữa các lượt chạy thay vì dựa vào một yêu cầu |
Đây là các thiết lập vận hành cho thí nghiệm này, không phải thiết lập tối ưu chung cho Mercury 3.
Bước 1: Điều kiện tiên quyết
Mercury 3 chỉ cần vài bước để bắt đầu. Để thực hiện theo, bạn cần:
- Một khóa API Inception
- Python 3
- Gói inceptionai
- Tệp tình huống hỗ trợ lưu dưới dạng
case_support.json
Bắt đầu bằng cách đăng ký nền tảng inception và lấy API Key. Nhấp vào Get Started và điền thông tin:
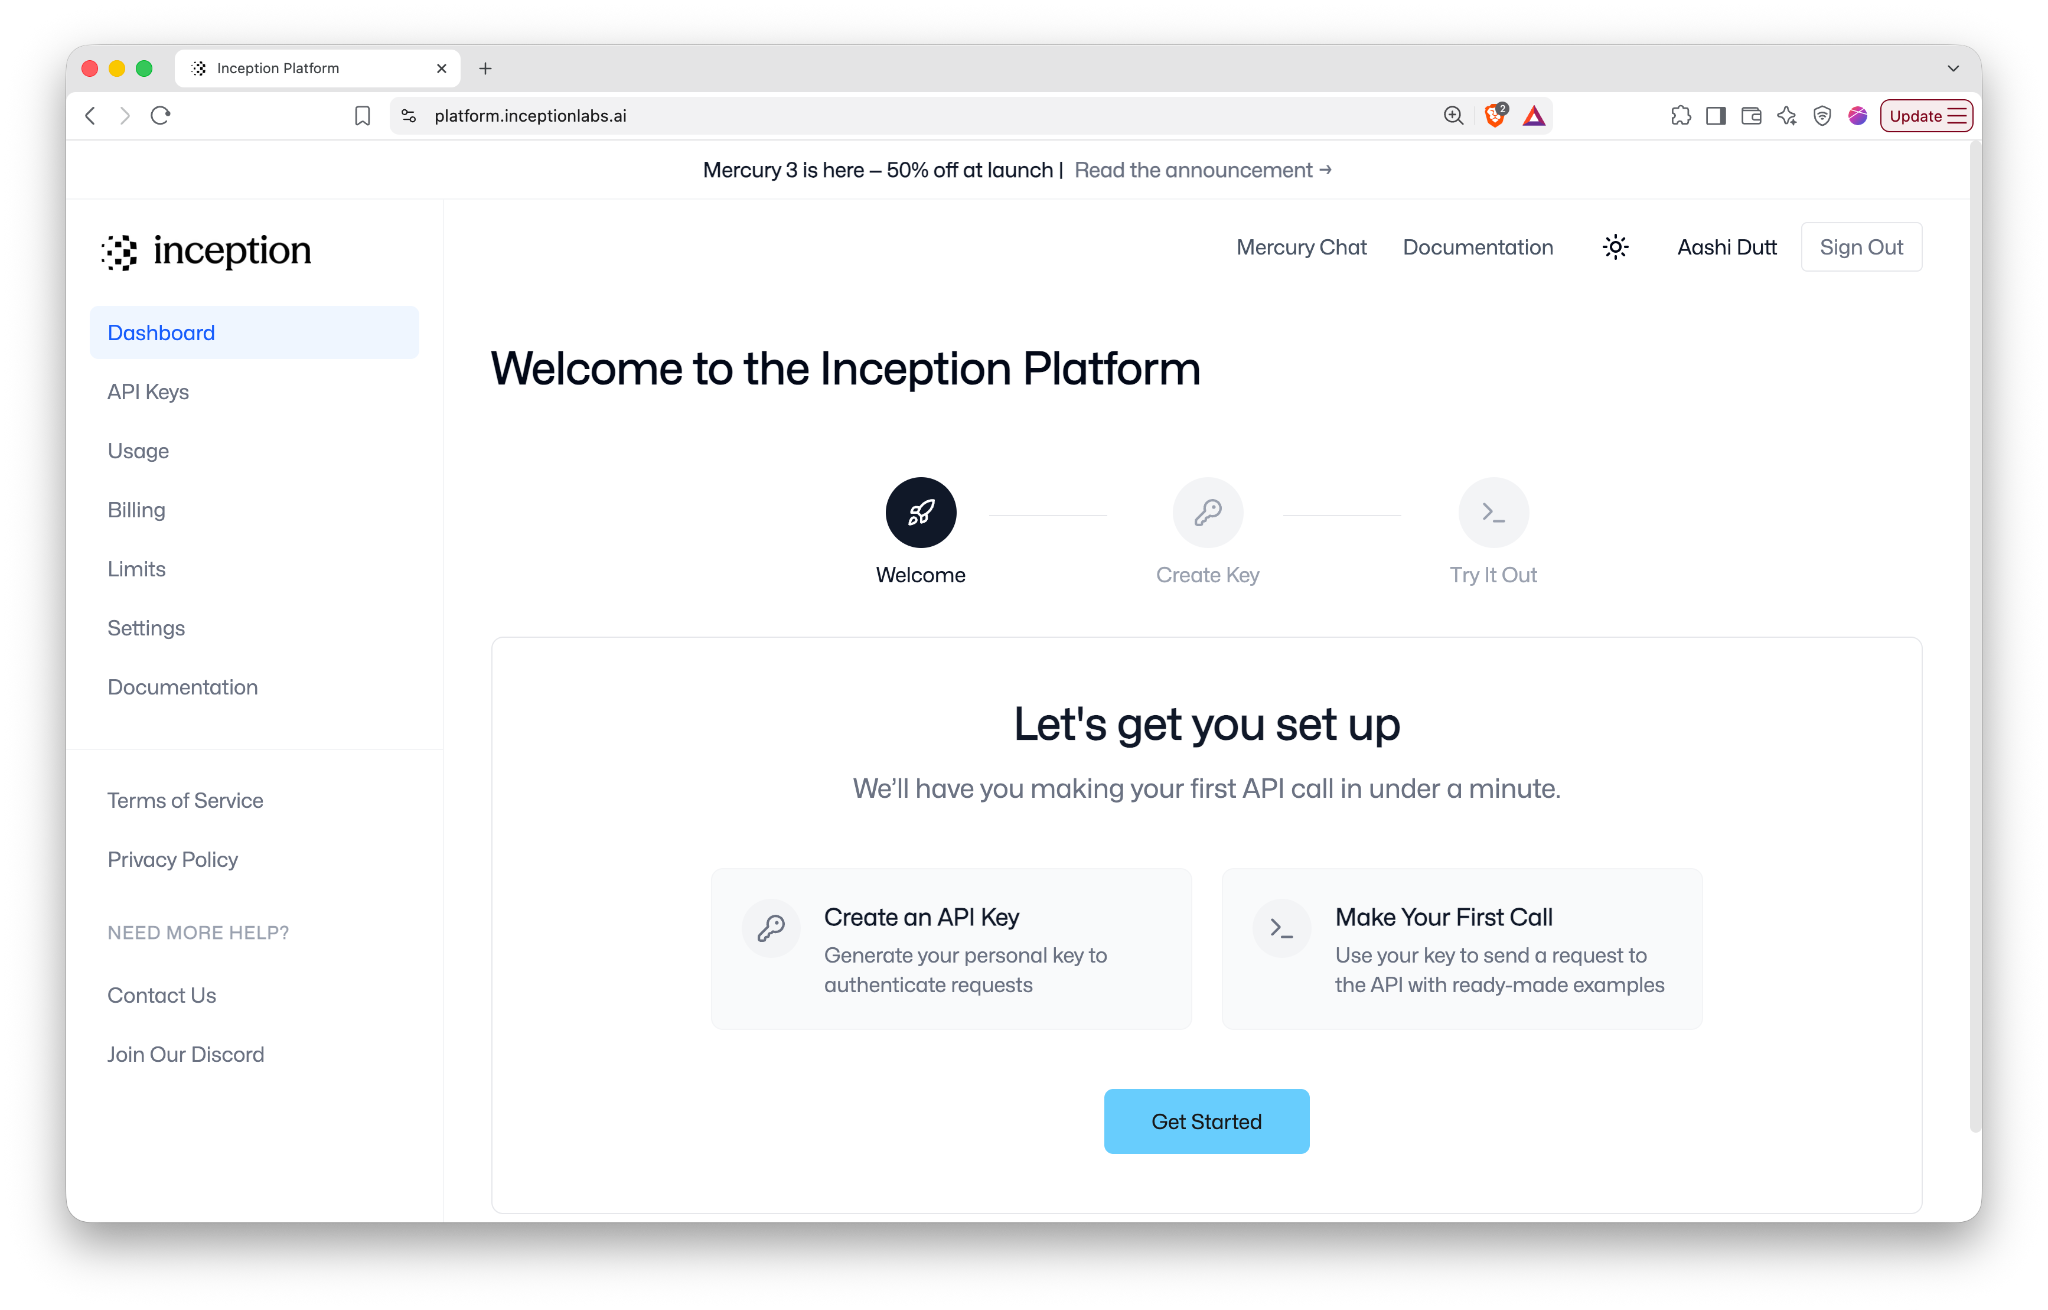
Lưu ý: Tại thời điểm viết, Inception cung cấp 100 triệu token miễn phí cho tài khoản mới thử API.
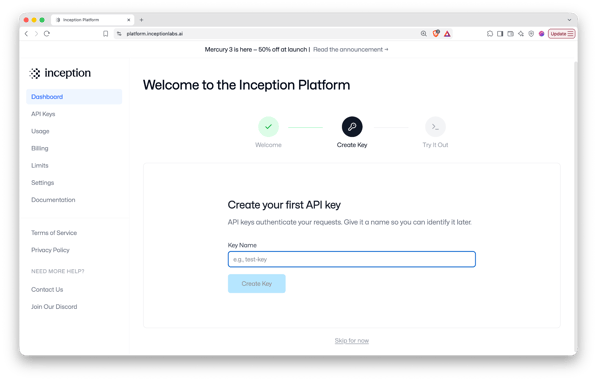
Bạn có thể đặt tên cho API Key hoặc đơn giản bỏ qua bước này và nhấp Create Key.
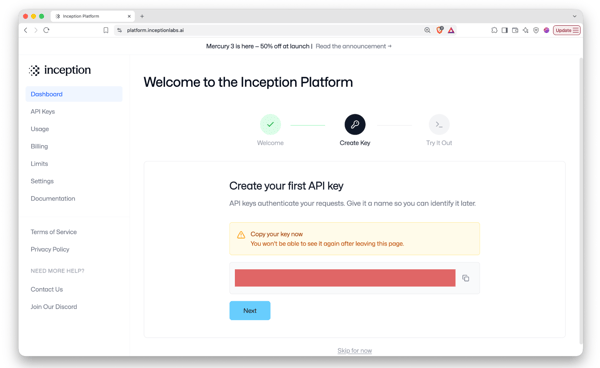
Tiếp theo, sao chép API Key và thực hiện cuộc gọi API đầu tiên của bạn.
Bước 2: Dùng thử Mercury 3
Trước khi viết bất kỳ mã nào, bạn có thể thử Mercury 3 trực tiếp từ Nền tảng Inception. Sau khi tạo khóa API, nhấp Next và chọn nút Run it now trên thẻ Try It Out.
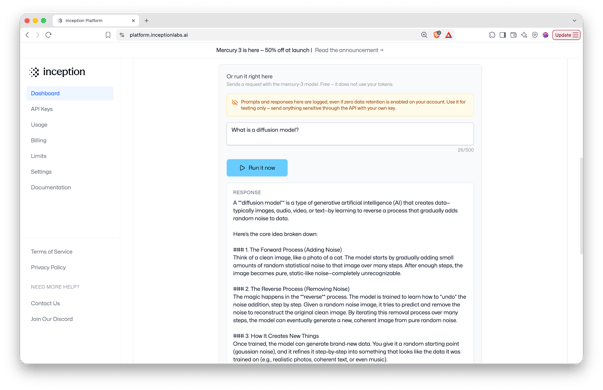
Điều này hữu ích để nhanh chóng thử nghiệm prompt và cài đặt mô hình trước khi đưa vào ứng dụng.
Bước 3: Chuẩn bị môi trường và thực hiện cuộc gọi API
Trong phần còn lại của hướng dẫn, chúng ta sẽ gọi Mercury 3 từ Python. Bắt đầu bằng cách cài đặt SDK inception và xuất khóa API như sau:
!pip install -q inceptionaiSau đó nhập các gói được bản demo sử dụng:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass yêu cầu nhập API key mà không hiển thị, os đặt nó ở nơi SDK tìm, Path và json tải case_support.json và tuần tự hóa nó vào prompt, và time.perf_counter() ghi lại thời điểm mỗi phản hồi và trạng thái tinh chỉnh đến.
difflib so sánh các trạng thái khuếch tán liên tiếp và clear_output() thay thế đầu ra cell để quá trình phát lại diễn ra tại chỗ thay vì chồng xuống trang.
Nếu API key chưa được đặt, bạn có thể yêu cầu nhập tương tác:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() đọc API key từ biến môi trường. Trong khi các import khác, như time ghi lại thời điểm trạng thái tinh chỉnh đến, difflib giúp so sánh văn bản trung gian, và clear_output() cho phép phát lại quá trình khuếch tán tại chỗ.
Bước 4: Xây dựng thông điệp cho Mô hình
Tình huống hỗ trợ được lưu riêng trong case_support.json. Tệp này chứa thông điệp của khách hàng, thông tin đơn hàng, bản ghi thanh toán, log thực hiện, chính sách hỗ trợ và các prompt chúng ta muốn dùng cho kịch bản này.
Bạn có thể tự xây dựng hoặc dùng như sẵn có:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Giờ, hãy tải tệp JSON:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Trước khi gửi tới Mercury 3, chúng ta tách cấu hình prompt khỏi phần bằng chứng:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]Các khóa system_prompt, task_prompt và packet_label kiểm soát cách chúng ta hướng dẫn Mercury, vì vậy chúng được loại khỏi phần bằng chứng trước khi chính tình huống được tuần tự hóa. Giờ ta có thể chuẩn bị thông điệp cuối cùng:
messages = build_messages(case)Không có hệ thống truy xuất hay công cụ bên ngoài ở đây. Mọi thứ Mercury cần cho phân tích này đều được cung cấp trực tiếp trong yêu cầu.
Bước 5: Gửi yêu cầu tới Mercury 3
Trước khi thử streaming, hãy thực hiện một yêu cầu thông thường không streaming. Trình trợ giúp sau bao bọc cuộc gọi API Mercury và ghi lại siêu dữ liệu phản hồi:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Giờ hãy định nghĩa một cuộc gọi mô hình:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}Các điều khiển chính phía mô hình là:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensGiờ ta có thể thực hiện cuộc gọi đường cơ sở:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury nhận toàn bộ tình huống hỗ trợ và trả về phân tích được yêu cầu, gồm lời giải thích có khả năng nhất, bằng chứng hỗ trợ, các lời giải thích thay thế, điểm còn chưa chắc chắn và hành động tiếp theo được đề xuất.
Hàm cũng ghi các trường elapsed_s và usage. Trường đầu đo thời gian yêu cầu đầu-cuối, còn trường kia bao gồm tính toán token, trong đó có báo cáo sử dụng token suy luận.
Trong các lượt chạy dùng cho hướng dẫn này, Mercury nhất quán xác định mục thanh toán thứ hai nhiều khả năng là ủy quyền đang chờ xử lý thay vì bằng chứng về một đơn hàng thứ hai đã xác nhận. Tuy nhiên, tình huống cố ý thiếu thông tin đủ để biết liệu ủy quyền đang chờ này sẽ biến mất hay sẽ được chốt trong tương lai.
Bước 6: Thêm streaming tiêu chuẩn
Một yêu cầu thông thường chờ Mercury hoàn tất trước khi trả về câu trả lời đầy đủ. Để nhận phản hồi dần dần, chúng ta cần bật stream=True. Hàm streaming tiêu chuẩn trông như sau:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Hành vi quan trọng ở đây là chunks.append(content) trong streaming tiêu chuẩn, trong đó mỗi khối chứa phần tiếp theo của phản hồi, vì vậy có thể tích lũy các khối và dựng lại câu trả lời cuối bằng "".join(chunks).
Lưu ý: Thời gian trung vị đến đầu ra hiển thị đầu tiên là 2,903 giây, trong khi độ trễ tổng trung vị là 3,375 giây.
Bước 7: Chuyển sang Streaming Khuếch tán
Để bật streaming khuếch tán, đặt các tham số sau thành True:
stream=True
diffusing=TrueCuộc gọi API chỉ khác streaming tiêu chuẩn ở một đối số bổ sung, tức diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}Với streaming tiêu chuẩn, các khối được nối thêm. Tuy nhiên, với streaming khuếch tán, khối không rỗng mới nhất đại diện cho phiên bản đầy đủ hiện tại của câu trả lời. Vì vậy thay vì nối thêm, chúng ta thay thế những gì đã hiển thị trước đó.
Chúng ta cũng giữ các trạng thái trả về để đo số trạng thái tinh chỉnh và kiểm tra liệu các trạng thái sau có thực sự sửa đổi văn bản đã xuất hiện trước đó không.
Qua năm lượt chạy, streaming khuếch tán trả về trung vị 9 trạng thái tinh chỉnh nhìn thấy được, dao động 7–12. Thời gian trung vị đến trạng thái hiển thị đầu tiên là 1,896 giây, và độ trễ tổng trung vị là 2,560 giây.
Bước 8: So sánh Streaming Tiêu chuẩn và Khuếch tán
Giờ khi đã hiểu cả hai luồng mã, chúng ta có thể so sánh hành vi đo được.
|
Chỉ số |
Tiêu chuẩn |
Khuếch tán |
|
Trung vị số khối/trạng thái |
6 |
9 |
|
Khoảng |
5–7 |
7–12 |
|
Trung vị đầu ra hiển thị đầu tiên |
2,903 s |
1,896 s |
|
Trung vị độ trễ tổng |
3,375 s |
2,560 s |
Khuếch tán có độ trễ trung vị thấp hơn cho prompt hỗ trợ cụ thể này, nhưng khoảng dao động chồng lấn đáng kể. Vì vậy, không nên kết luận rằng streaming khuếch tán vốn dĩ nhanh hơn.
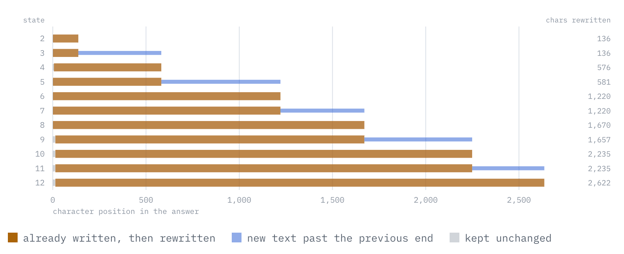
Hình: Lượt chạy 12 trạng thái, chuyển đổi theo từng bước. Thanh nâu là văn bản Mercury 3 đã viết rồi thay thế, trong khi thanh xanh là văn bản mới vượt quá phần cuối trước đó. Một dạng chỉ nối thêm sẽ không có màu nâu.
Trong các lượt của tôi, các trạng thái khuếch tán trả về đã sửa đổi văn bản hiển thị trước đó thay vì cư xử như các khối chỉ nối thêm. Ở lượt trên, không có chuyển đổi trạng thái nào trong 11 lần là thuần tuý nối thêm, và mọi lần đều khác biệt so với trạng thái trước trong vòng 14 ký tự đầu tiên.
Bước 9: Kiểm tra ngân sách hoàn thành
Tiếp theo, hãy xem hành vi của Mercury 3 với cách token suy luận tương tác với ngân sách hoàn thành. Các cuộc gọi thông thường ở trên dùng max_completion_tokens=8192, nhưng để làm rõ hành vi, ta cần giảm max_completion_tokens xuống 1600.
Giờ, chạy cùng yêu cầu một lần ở nỗ lực suy luận thấp và một lần ở cao. Dưới đây là kết quả đo được:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneỞ mức cao, toàn bộ 1.539 token hoàn thành được báo là token suy luận. Do đó, mô hình chạm giới hạn hoàn thành trước khi trả về văn bản câu trả lời hiển thị.
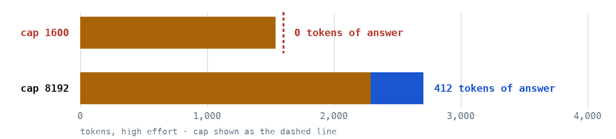
Hình: Ngân sách hoàn thành mức nỗ lực cao tại trần 1.600 và 8.192 token
Ở trần 1.600, toàn bộ ngân sách dành cho suy luận, không còn gì để phát ra. Ở 8.192, lượt chạy trung vị mức cao dùng 2.292 token cho suy luận và vẫn còn chỗ cho câu trả lời dài 412 token. Trần 8.192 nằm ngoài mép phải của thang này, đó là lý do chỉ hàng đầu trong ảnh trên có đường đứt biểu thị trần.
Tín hiệu quan trọng trong yêu cầu mức cao thất bại là response.choices[0].finish_reason, trả về length. Điều này có nghĩa yêu cầu đã chạm ngân sách token hoàn thành tối đa (max_completion_tokens). Ngân sách này bao gồm cả token suy luận và token đầu ra hiển thị. Trong lượt này, Mercury 3 báo toàn bộ 1.539 token hoàn thành là token suy luận, nên yêu cầu chạm giới hạn hoàn thành trước khi tạo ra câu trả lời hiển thị.
Lưu ý: Với demo này, max_completion_tokens=8192 là đủ cho các lượt còn lại, nhưng không nên coi đó là mức tối thiểu phổ quát.
Bước 10: So sánh Nỗ lực Suy luận Thấp và Cao
Giờ quay lại ngân sách hoàn thành 8192 thông thường và chỉ thay đổi reasoning_effort giữa thấp và cao. Chúng ta sẽ dùng trình trợ giúp run_nonstream() từ Bước 5 để thực hiện một yêu cầu với nỗ lực suy luận thấp và một với cao:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Với các kết quả được báo cáo, tôi lặp lại mỗi cấu hình năm lần thay vì dựa vào một yêu cầu duy nhất.
Các giá trị trung vị là:
|
Chỉ số |
Thấp |
Cao |
|
Độ trễ đầu-cuối |
2,936 s |
8,146 s |
|
Token hoàn thành |
1312 |
2723 |
|
Token suy luận |
828 |
2292 |
|
Xấp xỉ token hiển thị |
468 |
412 |
|
Tỷ lệ suy luận |
63% |
84% |
Mức dùng suy luận trung vị tăng từ 828 lên 2.292 token, trong khi độ trễ trung vị tăng từ 2,936 lên 8,146 giây (khoảng 2,77 lần).
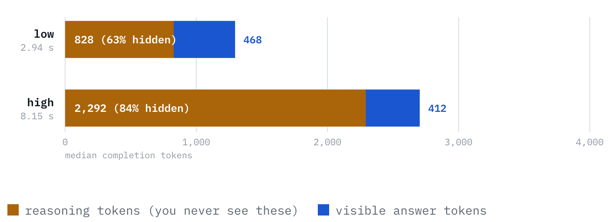
Hình: Ngân sách hoàn thành được phân bổ thế nào ở mỗi mức nỗ lực?
Độ dài câu trả lời hiển thị không thay đổi nhiều:
- Thấp: trung vị 468 token
- Cao: trung vị 412 token
và các khoảng quan sát được chồng lấn:
- Thấp: 393–494
- Cao: 356–469
Vì vậy, các lượt chạy này không ủng hộ nhận định rằng tăng nỗ lực suy luận sẽ làm câu trả lời hiển thị ngắn hơn. Các khoảng độ trễ cũng cho thấy vì sao một lượt chạy là không đủ:
- Thấp: 1,602–4,993 s
- Cao: 4,102–9,068 s
Lưu ý: Yêu cầu nhanh nhất ở mức cao thực ra nhanh hơn yêu cầu chậm nhất ở mức thấp.
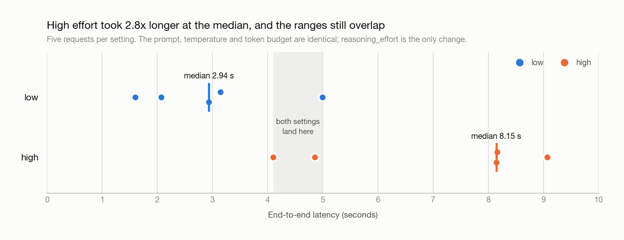
Hình: Cả mười yêu cầu mức nỗ lực suy luận được vẽ theo độ trễ
Vì vậy, reasoning_effort="high" làm tăng đáng kể mức dùng token suy luận được báo cáo và độ trễ trong thí nghiệm này, trong khi độ dài câu trả lời hiển thị nhìn chung tương tự.
Kết luận
Có ba hành vi thực tế của Mercury 3:
-
Streaming khuếch tán dùng hợp đồng đầu ra khác. Streaming tiêu chuẩn nối thêm văn bản mới, trong khi streaming khuếch tán trả về các trạng thái toàn phản hồi kế tiếp nhau cần thay thế trạng thái trước.
-
Token suy luận chia sẻ ngân sách hoàn thành. Giá trị
max_completion_tokensnhỏ có thể bị tiêu hết bởi suy luận trước khi Mercury 3 tạo ra câu trả lời hiển thị. -
Nỗ lực suy luận cao hơn đánh đổi thêm tính toán lấy độ trễ. Trong các lượt của tôi, mức cao dùng nhiều token suy luận được báo cáo hơn đáng kể và mất nhiều thời gian hơn, như kỳ vọng, trong khi độ dài câu trả lời hiển thị vẫn tương tự.
Các kết quả này đến từ số lượt chạy ít trên một tình huống hỗ trợ tổng hợp, nên nên coi là quan sát từ demo này hơn là tuyên bố hiệu năng chung về Mercury 3.

Tôi là Chuyên gia Google Developers trong lĩnh vực ML (Gen AI), Chuyên gia Kaggle 3x và Đại sứ Women Techmakers với hơn 3 năm kinh nghiệm trong ngành công nghệ. Tôi đồng sáng lập một startup công nghệ y tế vào năm 2020 và hiện đang theo học thạc sĩ khoa học máy tính tại Georgia Tech, chuyên sâu về học máy.
Câu hỏi thường gặp về Mercury 3
Sự khác biệt chính giữa streaming tiêu chuẩn và streaming khuếch tán trong Mercury 3 là gì?
Với streaming tiêu chuẩn, phản hồi đến dưới dạng các khối văn bản được nối với nhau. Với streaming khuếch tán, API phơi bày các bản sửa đổi liên tiếp của phản hồi hiện tại, vì vậy trạng thái mới nhất nên thay thế trạng thái trước đó thay vì được nối thêm.
reasoning_effort="high" có luôn tạo ra câu trả lời tốt hơn không?
Không. Nỗ lực suy luận cao hơn cho Mercury nhiều chỗ hơn để suy luận, nhưng điều đó không đảm bảo câu trả lời tốt hơn cho mọi tác vụ. Trong demo này, mức cao dùng nhiều token suy luận hơn đáng kể và mất lâu hơn, trong khi độ dài câu trả lời hiển thị tương tự. Nó cũng nhất quán hơn trong việc nêu bật một mảnh bằng chứng còn thiếu, nhưng thí nghiệm quá nhỏ để đưa ra tuyên bố chất lượng rộng hơn.
Vì sao Mercury 3 có thể không trả câu trả lời hiển thị khi max_completion_tokens quá nhỏ?
Token suy luận được tính vào cùng ngân sách token hoàn thành như câu trả lời hiển thị. Nếu mô hình tiêu thụ phần lớn hoặc toàn bộ ngân sách đó trong khi suy luận, nó có thể chạm giới hạn hoàn thành trước khi tạo đầu ra hiển thị. Khi đó, kiểm tra finish_reason và mức dùng token suy luận được báo cáo giúp giải thích điều đã xảy ra.
Streaming khuếch tán có luôn nhanh hơn streaming tiêu chuẩn không?
Không. Trong demo này, streaming khuếch tán có thời gian trung vị đến đầu ra hiển thị đầu tiên thấp hơn và độ trễ tổng trung vị thấp hơn, nhưng các khoảng dao động chồng lấn, và một prompt khác cho kết quả xếp hạng ngược lại. Khác biệt đáng tin cậy hơn là hành vi streaming, không phải đảm bảo cải thiện độ trễ.
Khi nào tôi nên dùng Mercury 3?
Mercury 3 đặc biệt phù hợp cho các ứng dụng nhạy cảm với độ trễ, nơi người dùng hưởng lợi từ phản hồi nhanh trong khi mô hình vẫn thực hiện suy luận không tầm thường. Mức nỗ lực suy luận và ngân sách hoàn thành phù hợp phụ thuộc vào tác vụ, vì vậy nên được tinh chỉnh theo cả độ trễ và chất lượng câu trả lời.


Mercury 3 là một Mô hình Ngôn ngữ Lớn dựa trên khuếch tán của Inception.ai. Khác với các LLM tự hồi quy thông thường tạo văn bản từng token một, Mercury dùng cơ chế khuếch tán để lặp lại tinh chỉnh nhiều phần của phản hồi. Mô hình này vượt trội so với GPT-6 Luna và Claude Haiku 5.5, đồng thời chạy nhanh hơn 4–8 lần ở tốc độ 1.000+ token mỗi giây trên GPU NVIDIA và hỗ trợ cửa sổ ngữ cảnh 1M token.
Trong hướng dẫn này, chúng ta sẽ xây dựng một trợ lý phân tích sự cố nhỏ nhận log ứng dụng, thông tin triển khai, số liệu GPU và vết truy hồi yêu cầu. Sau đó, chúng ta sẽ dùng cùng một tác vụ để khám phá hai đặc tính của Mercury 3:
Phát trực tuyến dựa trên khuếch tán khác gì so với streaming LLM thông thường
Điều gì thay đổi khi chúng ta tăng
reasoning_efforttừ thấp lên cao?Trong quá trình thực hiện, chúng ta cũng sẽ gặp một vấn đề quan trọng về ngân sách token khi dùng các chế độ suy luận của Mercury. Kết thúc, bạn sẽ biết cách:
Mã hoàn chỉnh trong kho lưu trữ.
Mercury 3 là gì?
Khác với các LLM tự hồi quy thông thường tạo phản hồi nghiêm ngặt từ trái sang phải, Mercury thuộc họ mô hình tinh chỉnh lặp lại nhiều vị trí token trong quá trình sinh. Cách tiếp cận của Inception phù hợp nhất cho các tác vụ nhạy cảm với độ trễ như agent, tìm kiếm, hỗ trợ khách hàng, giáo dục và các ứng dụng khác nơi số lần gọi mô hình lặp lại có thể cộng dồn nhanh chóng.
Mercury 3 kết hợp quy trình sinh dựa trên khuếch tán đó với các khả năng kỳ vọng từ một mô hình API đa dụng, bao gồm đầu vào ngữ cảnh dài, điều khiển suy luận, gọi công cụ, đầu ra có cấu trúc và endpoint tương thích OpenAI. Nó cũng cung cấp chế độ phát trực tuyến
diffusing=Truecho phép ứng dụng nhận các trạng thái tinh chỉnh toàn văn trung gian của mô hình thay vì chỉ các khối đầu ra nối thêm.Tại thời điểm viết bài, Mercury 3 hỗ trợ những điều sau:
Thuộc tính
Mercury 3
Cửa sổ ngữ cảnh
1M token
Đầu ra tối đa
131.072 token
Mức nỗ lực suy luận
instant, low, medium, high
Gọi công cụ
Hỗ trợ
Đầu ra có cấu trúc
Hỗ trợ
Streaming
Hỗ trợ
Streaming dựa trên khuếch tán
Hỗ trợ
Nhiệt độ
0,5–1,0
API
Tương thích OpenAI
Hiện Inception công bố Mercury 3 với giá ra mắt $0,10 cho mỗi triệu token đầu vào, $0,01 cho mỗi triệu token đầu vào được lưu trong bộ nhớ đệm và $0,35 cho mỗi triệu token đầu ra. Token được lưu đệm cũng giảm 90% so với giá đầu vào.
Mercury 3 lớn gấp 40 lần Mercury 1 và thông minh hơn rất nhiều, nhưng vẫn nhanh như vậy.
Hình: Chất lượng mô hình so với Kích thước mô hình (Nguồn)
Mercury 3 hoạt động như thế nào?
Hầu hết LLM tạo văn bản theo kiểu tự hồi quy từ trái sang phải, từng token một. Dưới đây là cách LLM truyền thống tạo văn bản:
Mỗi token mới phụ thuộc vào tất cả những gì đã được tạo trước đó.
Mercury thay vào đó sử dụng khuếch tán.
Inception mô tả các LLM khuếch tán của mình là các mô hình dựa trên Transformer cải thiện dần đầu ra bằng cách sửa đổi nhiều token song song. Nghiên cứu Mercury trước đây mô tả đây là quá trình sinh từ thô đến tinh thay vì dự đoán token tiếp theo nghiêm ngặt từ trái sang phải.
Một minh họa đơn giản có thể trông như sau: