

Bu yalnızca kavramsal bir örnektir, Mercury 3’ün tam içsel temsili değildir.
Inception’ın API’si bu ara durumları açığa çıkarabilir. Normal akış ile Mercury, yanıta eklenebilecek rafine metin blokları döndürür. diffusing=True ile, her parça bunun yerine model rafine ettikçe yanıtın mevcut tam sürümünü içerir.
Farkı az sonra göreceğiz.
Demo: Gerçek Zamanlı Destek Eskalasyon Asistanı Oluşturma
Demonyu oluşturmadan önce, model ayarlarını destek uygulamasının kendisinden ayıralım.
Destek vakası, Mercury 3’ü çalıştırmak için kullandığımız girdiden ibarettir. Önemli model tarafı kontrolleri, akıl yürütme bütçesi, tamamlama bütçesi ve akış modudur.
|
Ayar |
Kullanılan değer |
Neden önemli |
|
Sıcaklık |
0,75 |
Modları karşılaştırırken örneklemeyi değiştirmemek için sabit tutuldu |
|
Akıl yürütme çabası |
low, high |
Gizli akıl yürütme kullanımı ve gecikmeyi karşılaştırmamızı sağlar |
|
Tamamlama bütçesi |
8192 |
Ölçülen demo çalışmaları için yeterince büyük |
|
Standart akış |
stream=True |
Eklenebilir metin blokları döndürür |
|
Difüzyon akışı |
stream=True, diffusing=True |
Ardışık tam metin rafine etme durumları döndürür |
|
İstem |
Sabit destek vakası |
Model ayarları değişirken görevi sabit tutar |
|
Tekrarlar |
Koşul başına 5 |
Tek bir isteğe güvenmek yerine çalışmadan çalışmaya değişimi gösterir |
Bunlar bu deney için çalışan ayarlardır; Mercury 3 için genel olarak en iyi ayarlar değildir.
Adım 1: Önkoşullar
Mercury 3’e başlamak yalnızca birkaç adım sürer. Takip etmek için şunlara ihtiyacınız var:
- Bir Inception API anahtarı
- Python 3
- inceptionai paketi
case_support.jsonolarak kaydedilmiş destek vakası
Önce inception platformuna kaydolun ve API Anahtarını alın. Get Started’a tıklayın ve bilgileri doldurun:
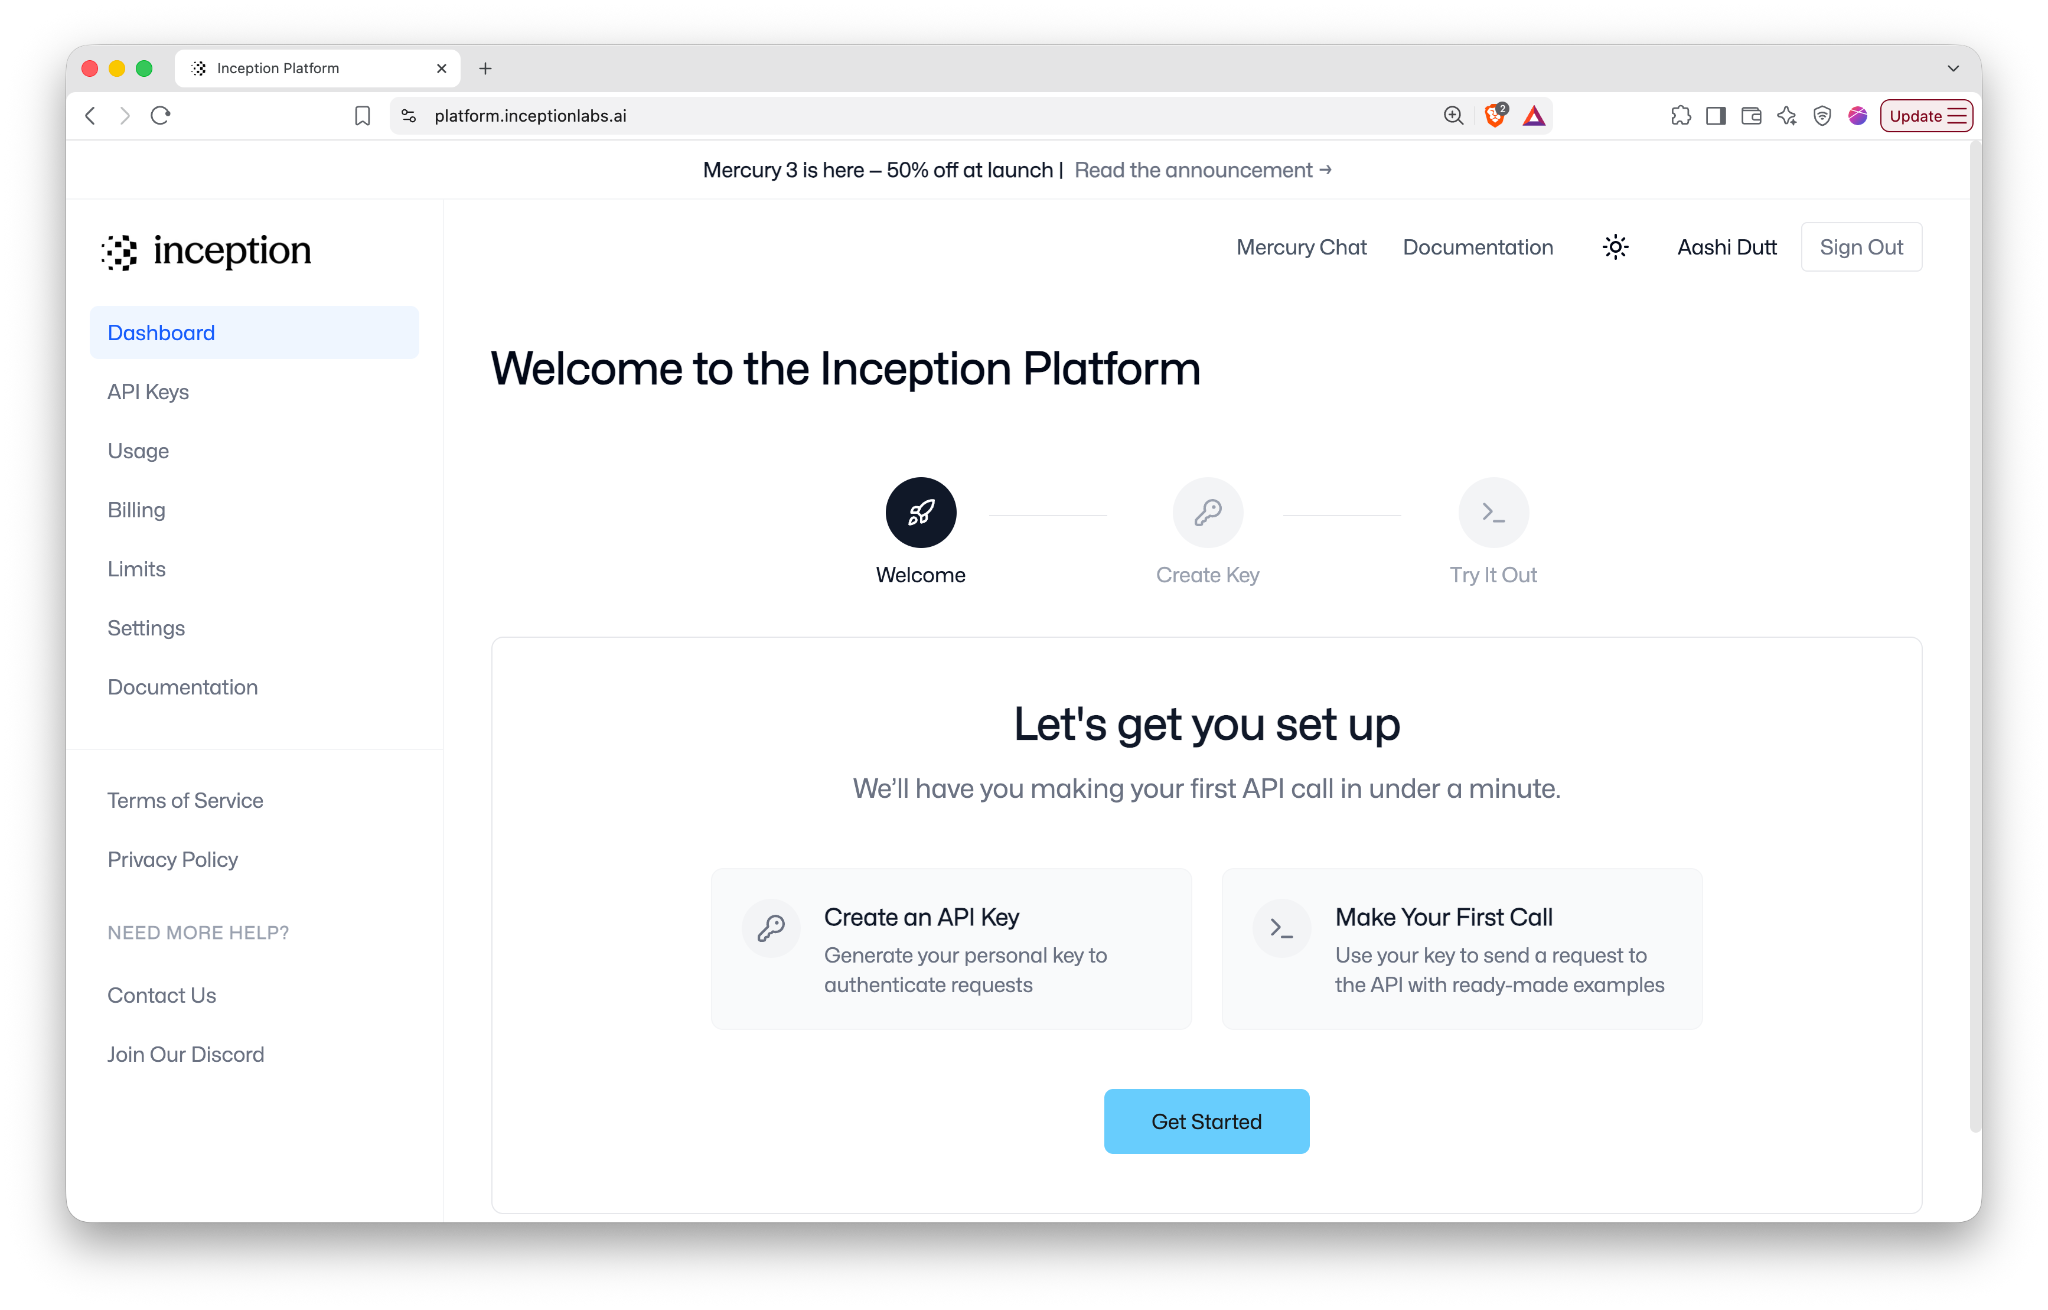
Not: Bu yazının yazıldığı sırada Inception, API’yi denemeleri için yeni hesaplara 100 milyon ücretsiz token sunmaktadır.
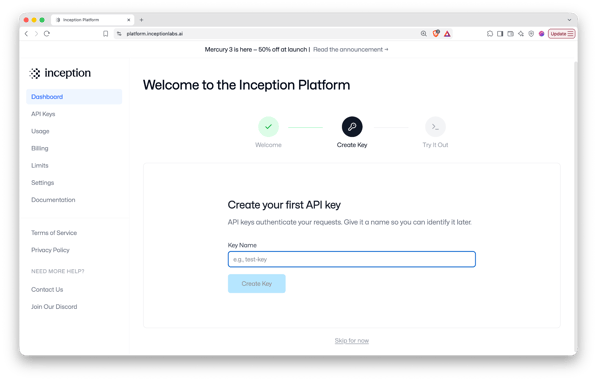
API Anahtarınızı adlandırabilir veya bu adımı atlayıp Create Key’e tıklayabilirsiniz.
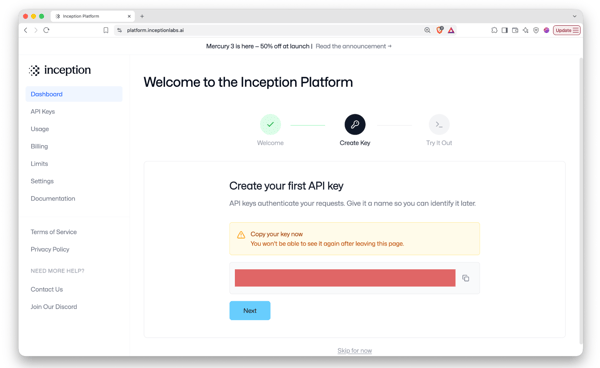
Ardından, API Anahtarını kopyalayın ve ilk API çağrınızı yapın.
Adım 2: Mercury 3’ü deneyin
Herhangi bir kod yazmadan önce Mercury 3’ü doğrudan Inception Platformu üzerinden test edebilirsiniz. API anahtarınızı oluşturduktan sonra Next’e tıklayın ve Try It Out sekmesindeki Run it now düğmesini seçin.
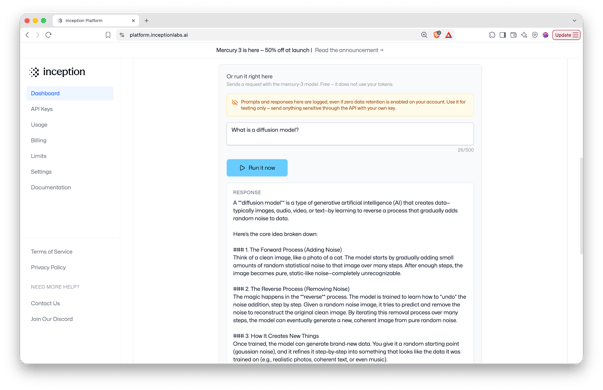
Bu, istemleri ve model ayarlarını bir uygulamaya taşımadan önce hızla test etmek için yararlıdır.
Adım 3: Ortamı hazırlayın ve bir API çağrısı yapın
Bu eğitimin geri kalanında Mercury 3’ü Python’dan çağıracağız. Önce inception SDK’sını kurun ve API anahtarını aşağıdaki gibi dışa aktarın:
!pip install -q inceptionaiArdından, demoda kullanılan paketleri içe aktarın:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass, API anahtarını ekranda göstermeden ister; os, anahtarı SDK’nın aradığı yere koyar; Path ve json, case_support.json dosyasını yükler ve isteme serileştirir; time.perf_counter() ise her yanıtın ve rafine etme durumunun ne zaman geldiğini kaydeder.
difflib, ardışık difüzyon durumlarını karşılaştırır ve clear_output(), sayfanın aşağısına yığılmak yerine oynatmanın yerinde gerçekleşmesi için hücre çıktısını değiştirir.
API anahtarı zaten ayarlı değilse, etkileşimli olarak isteyebilirsiniz:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() API anahtarını ortamdan okur. Diğer içe aktarmalar arasında, time rafine etme durumlarının geliş zamanını kaydederken, difflib ara metni karşılaştırmaya yardımcı olur ve clear_output() difüzyon sürecini yerinde yeniden oynatmamızı sağlar.
Adım 4: Model mesajlarını oluşturun
Destek vakası ayrı olarak case_support.json içinde tutulur. Vaka dosyası, müşteri mesajını, sipariş bilgilerini, ödeme kayıtlarını, yerine getirme günlüklerini, destek politikasını ve bu senaryo için kullanmak istediğimiz istemleri içerir.
Kendi dosyanızı oluşturabilir veya olduğu gibi kullanabilirsiniz:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Şimdi JSON dosyasını yükleyelim:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Mercury 3’e göndermeden önce, istem yapılandırmasını kanıtlardan ayırıyoruz:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]system_prompt, task_prompt ve packet_label anahtarları, Mercury’ye nasıl talimat verdiğimizi kontrol eder, bu yüzden vaka serileştirilmeden önce kanıtlardan çıkarılır. Artık nihai mesajları hazırlayabiliriz:
messages = build_messages(case)Burada bir getirme sistemi veya harici araç yok. Mercury’nin bu analiz için ihtiyaç duyduğu her şey doğrudan istekte sağlanıyor.
Adım 5: Mercury 3’e bir istek yapın
Akışı test etmeden önce normal, akışsız bir istek yapalım. Aşağıdaki yardımcı, Mercury API çağrısını sarar ve yanıt meta verilerini kaydeder:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Şimdi bir model çağrısı tanımlayalım:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}Başlıca model tarafı kontrolleri şunlardır:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensArtık bir temel çağrı yapabiliriz:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury, tam destek vakasını alır ve en olası açıklama, destekleyici kanıtlar, alternatif açıklamalar, belirsizlik ve önerilen sonraki adımlar da dahil olmak üzere istenen analizi döndürür.
Fonksiyon ayrıca elapsed_s ve usage alanlarını kaydeder. İlki uçtan uca istek süresini ölçerken diğeri, bildirilen akıl yürütme tokeni kullanımı dahil olmak üzere token muhasebesini içerir.
Bu eğitim için yapılan çalışmalarda Mercury, ikinci ödeme girdisini, onaylanmış ikinci bir siparişin kanıtı olmaktan ziyade, büyük olasılıkla beklemede olan bir provizyon olarak tutarlı şekilde belirledi. Ancak vaka, bu bekleyen provizyonun sonunda kaybolup kaybolmayacağını veya tahsil edilip edilmeyeceğini bilmek için kasten yeterli bilgi içermemektedir.
Adım 6: Standart akış ekleyin
Normal bir istek, Mercury bitirene kadar bekler ve tam yanıtı döndürür. Yanıtı kademeli olarak almak için stream=True etkinleştirmemiz gerekir. Standart akış fonksiyonu şöyle görünür:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Buradaki önemli davranış, standart akışta her parçanın yanıtın bir sonraki bölümünü içermesi ve bu nedenle parçaların chunks.append(content) ile biriktirilip "".join(chunks) ile nihai yanıta yeniden inşa edilebilmesidir.
Not: İlk görünür çıktıya medyan süre 2,903 saniye, medyan toplam gecikme ise 3,375 saniyeydi.
Adım 7: Difüzyon Akışına geçin
Difüzyon akışını etkinleştirmek için aşağıdaki parametreleri True yapın:
stream=True
diffusing=TrueAPI çağrısı, standart akıştan yalnızca bir ek argümanla farklıdır; yani diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}Standart akışta parçalar eklenir. Ancak difüzyon akışında, en son boş olmayan parça, yanıtın mevcut tam sürümünü temsil eder. Bu yüzden eklemek yerine daha önce gösterileni değiştiririz.
Ayrıca, döndürülen durumları, rafine etme durumu sayısını ölçmek ve sonraki durumların gerçekten daha önce görünen metni revize edip etmediğini kontrol etmek için saklarız.
Beş çalışmada, difüzyon akışı medyan 9 görünür rafine etme durumu döndürdü; aralık 7–12 idi. İlk görünür duruma medyan süre 1,896 saniye, toplam medyan gecikme 2,560 saniyeydi.
Adım 8: Standart ve Difüzyon Akışını karşılaştırın
Artık her iki kod yolunu da anladığımıza göre, ölçülen davranışı karşılaştırabiliriz.
|
Metri̇k |
Standart |
Difüzyon |
|
Medyan parça/durum |
6 |
9 |
|
Aralık |
5–7 |
7–12 |
|
İlk görünür çıktı medyanı |
2,903 s |
1,896 s |
|
Toplam gecikme medyanı |
3,375 s |
2,560 s |
Bu özel destek istemi için difüzyon daha düşük medyan gecikmeye sahipti, ancak aralıklar önemli ölçüde çakışıyor. Dolayısıyla, difüzyon akışının doğası gereği daha hızlı olduğu sonucuna varılmamalıdır.
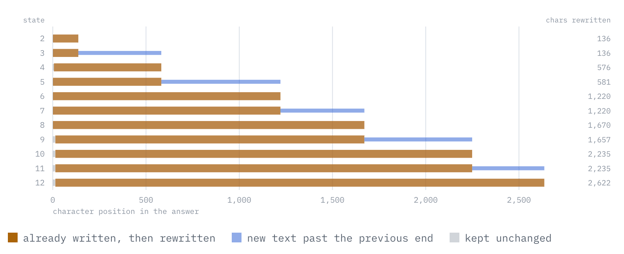
Şekil: 12 durumluk çalışma, geçişten geçişe. Kahverengi çubuk, Mercury 3’ün daha önce yazıp sonra değiştirdiği metni; mavi çubuk ise önceki sonun ötesindeki yeni metni gösterir. Salt eklemede hiç kahverengi görünmezdi.
Benim çalışmamda döndürülen difüzyon durumları, salt eklenen parçalardan ziyade daha önce görünür olan metni revize etti. Yukarıdaki çalışmada, 11 durum geçişinin hiçbiri salt ekleme değildi ve her biri, kendisinden önceki durumdan ilk 14 karakter içinde ayrıştı.
Adım 9: Tamamlama bütçesini test edin
Şimdi, akıl yürütme tokenlerinin tamamlama bütçesiyle nasıl etkileştiği bağlamında Mercury 3’ün davranışına bakalım. Yukarıdaki normal çağrılar max_completion_tokens=8192 kullanıyor; ancak davranışı daha net ortaya koymak için max_completion_tokens değerini 1600’e düşürmemiz gerekiyor.
Şimdi aynı isteği bir kez düşük, bir kez yüksek akıl yürütme çabasıyla çalıştırın. Ölçülen sonuçlar şöyle:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneYüksekte, 1.539 tamamlama tokeninin tamamı akıl yürütme tokeni olarak raporlandı. Bu nedenle model, görünür yanıt metni döndürmeden önce tamamlama sınırına ulaştı.
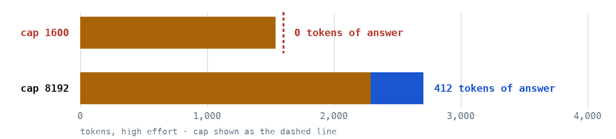
Şekil: 1.600 ve 8.192 token sınırında yüksek çaba tamamlama
1.600 sınırında tüm bütçe akıl yürütmeye gitti ve yayımlanacak hiçbir şey kalmadı. 8.192’de, medyan yüksek çaba çalışması 2.292 tokeni akıl yürütmeye harcadı ve yine de 412 tokenlik bir yanıt için alan kaldı. 8.192 sınırı bu ölçeğin sağ kenarının dışında kaldığından, yukarıdaki görselde yalnızca ilk satır kesikli sınır çizgisi gösterir.
Başarısız yüksek istekteki önemli sinyal, response.choices[0].finish_reason’dır ve length döndürmüştür. Bu, isteğin maksimum tamamlama tokeni bütçesine (max_completion_tokens) ulaştığı anlamına gelir. Bu bütçe hem akıl yürütme tokenlerini hem de görünür çıktı tokenlerini içerir. Bu çalışmada Mercury 3, 1.539 tamamlama tokeninin tamamını akıl yürütme tokeni olarak bildirdi; bu nedenle istek, görünür yanıt oluşturmadan önce tamamlama sınırına ulaştı.
Not: Bu demo için max_completion_tokens=8192 kalan çalışmalar için yeterliydi, ancak evrensel bir asgari değer olarak görülmemelidir.
Adım 10: Düşük ve Yüksek Akıl Yürütme Çabasını karşılaştırın
Şimdi normal 8192 tamamlama bütçesine geri dönün ve yalnızca reasoning_effort değerini düşük ile yüksek arasında değiştirin. Adım 5’teki run_nonstream() yardımcısını kullanarak bir isteği düşük, bir isteği yüksek akıl yürütme çabasıyla yapacağız:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Raporlanan sonuçlar için, tek bir isteğe güvenmek yerine her yapılandırmayı beş kez tekrarladım.
Medyanlar şunlardı:
|
Metri̇k |
Düşük |
Yüksek |
|
Uçtan uca gecikme |
2,936 s |
8,146 s |
|
Tamamlama tokenleri |
1312 |
2723 |
|
Akıl yürütme tokenleri |
828 |
2292 |
|
Tahm. görünür tokenler |
468 |
412 |
|
Akıl yürütme payı |
%63 |
%84 |
Medyan akıl yürütme kullanımı 828’den 2.292 tokene yükselirken, medyan gecikme 2,936’dan 8,146 saniyeye (yaklaşık 2,77x) çıktı.
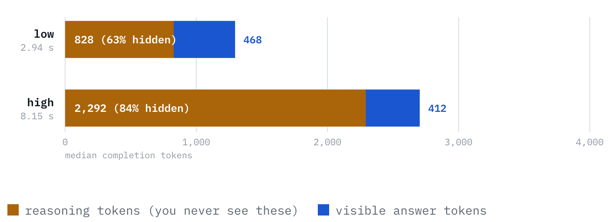
Şekil: Tamamlama bütçesi her çaba düzeyinde nereye gidiyor?
Görünür yanıt uzunluğu ise pek değişmedi:
- Düşük: 468 token medyan
- Yüksek: 412 token medyan
ve gözlenen aralıklar çakıştı:
- Düşük: 393–494
- Yüksek: 356–469
Dolayısıyla bu çalışmalar, akıl yürütme çabasını artırmanın görünür yanıtı kısalttığı iddiasını desteklemiyor. Gecikme aralıkları da neden tek bir çalışmanın yeterli olmadığını gösteriyor:
- Düşük: 1,602–4,993 s
- Yüksek: 4,102–9,068 s
Not: En hızlı yüksek istek, en yavaş düşük istekten aslında daha hızlıydı.
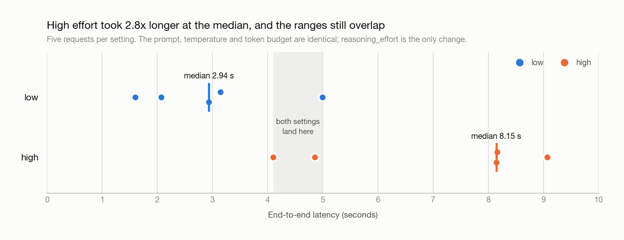
Şekil: Tüm on akıl yürütme çabası isteğinin gecikmeye göre çizimi
Dolayısıyla, bu deneyde reasoning_effort="high" bildirilen akıl yürütme tokeni kullanımını ve gecikmeyi önemli ölçüde artırdı; beklenildiği gibi. Görünür yanıt uzunluğu ise genel olarak benzer kaldı.
Son Düşünceler
Mercury 3’ün üç pratik davranışı vardır:
-
Difüzyon akışı farklı bir çıktı sözleşmesi kullanır. Standart akış yeni metni eklerken, difüzyon akışı öncekinin yerine geçmesi gereken ardışık tam yanıt durumlarını döndürür.
-
Akıl yürütme tokenleri, tamamlama bütçesini paylaşır. Küçük bir
max_completion_tokensdeğeri, Mercury 3 görünür bir yanıt üretmeden önce akıl yürütme tarafından tüketilebilir. -
Daha yüksek akıl yürütme çabası, ek hesaplamayı gecikme karşılığında değiştirir. Benim çalışmamda, yüksek mod beklenildiği gibi çok daha fazla bildirilen akıl yürütme tokeni kullandı ve daha uzun sürdü; görünür yanıt uzunluğu ise genel olarak benzer kaldı.
Bu sonuçlar, tek bir sentetik destek vakası üzerindeki az sayıda çalışmadan elde edilmiştir; bu nedenle Mercury 3 hakkında genel performans iddiaları değil, bu demodan gözlemler olarak değerlendirilmelidir.

ML (Üretken Yapay Zekâ) alanında Google Developers Uzmanıyım, Kaggle 3x Expert unvanına sahibim ve 3+ yıllık teknoloji deneyimiyle Women Techmakers Elçisiyim. 2020'de bir sağlık teknolojileri girişiminin kurucu ortağı oldum ve Georgia Tech'te makine öğrenmesi alanında uzmanlaşarak bilgisayar bilimleri yüksek lisansı yapıyorum.
Mercury 3 SSS
Mercury 3’te standart akış ile difüzyon akışı arasındaki temel fark nedir?
Standart akışta yanıt, birbirine eklenen metin parçaları halinde gelir. Difüzyon akışında ise API, mevcut yanıtın ardışık revizyonlarını açığa çıkarır; bu nedenle en son durum, eklenmek yerine bir öncekini değiştirmelidir.
reasoning_effort="high" her zaman daha iyi bir yanıt üretir mi?
Hayır. Daha yüksek akıl yürütme çabası, Mercury’ye akıl yürütme için daha fazla alan tanır; ancak bu, her görev için daha iyi bir yanıtı garanti etmez. Bu demoda, yüksek mod belirgin biçimde daha fazla akıl yürütme tokeni kullandı ve daha uzun sürdü; görünür yanıt uzunluğu ise benzer kaldı. Ayrıca eksik bir kanıt parçasını öne çıkarmada daha tutarlıydı, ancak deney daha geniş kalite iddiaları yapmak için çok küçüktü.
max_completion_tokens çok küçük olduğunda Mercury 3 neden görünür yanıt döndürmeyebilir?
Akıl yürütme tokenleri, görünür yanıtla aynı tamamlama tokeni bütçesine sayılır. Model bu bütçenin çoğunu ya da tamamını akıl yürütürken tüketirse, görünür çıktı üretmeden önce tamamlama sınırına ulaşabilir. Bu durumda finish_reason ve bildirilen akıl yürütme tokeni kullanımını kontrol etmek, ne olduğunu açıklamaya yardımcı olur.
Difüzyon akışı her zaman standart akıştan daha mı hızlıdır?
Hayır. Bu demoda, difüzyon akışının ilk görünür çıktıya medyan süresi ve medyan toplam gecikmesi daha düşüktü; ancak aralıklar çakıştı ve başka bir istem tersi sıralamayı üretti. Daha güvenilir fark, akış davranışıdır; gecikmenin garantili iyileşmesi değil.
Mercury 3’ü ne zaman kullanmalıyım?
Mercury 3, kullanıcıların hızlı yanıtlardan fayda sağladığı, modelin ise hâlâ kayda değer akıl yürütme yaptığı gecikmeye duyarlı uygulamalar için özellikle ilgi çekicidir. Doğru akıl yürütme çabası ve tamamlama bütçesi göreve bağlıdır; bu yüzden hem gecikme hem de yanıt kalitesine göre ayarlanmalıdır.



Mercury 3, Inception.ai tarafından geliştirilen difüzyon tabanlı bir Büyük Dil Modelidir. Metni birer birer token üreten geleneksel otoregresif BDM’lerin aksine, Mercury yanıtının birden fazla bölümünü yinelemeli olarak rafine etmek için difüzyonu kullanır. Model, NVIDIA GPU’larda saniyede 1.000+ token hızında 4–8 kat daha hızlı çalışırken GPT-6 Luna ve Claude Haiku 5.5’i geride bırakır ve 1M tokenlık bir bağlam penceresini destekler.
Bu eğitimde, uygulama günlüklerini, dağıtım bilgilerini, GPU metriklerini ve istek izlerini alan küçük bir olay analizi asistanı oluşturacağız. Ardından aynı görevi kullanarak Mercury 3’ün iki özelliğini inceleyeceğiz:
Difüzyon akışının normal BDM akışından nasıl farklı olduğu
reasoning_effortdeğerini düşükten yükseğe çıkardığımızda ne değişir?Bu süreçte, Mercury’nin akıl yürütme modlarını kullanırken önemli olan bir token bütçesi sorunuyla da karşılaşacağız. Sonunda şunları nasıl yapacağınızı biliyor olacaksınız:
Tam kod deposu.
Mercury 3 Nedir?
Yanıtı kesin olarak soldan sağa üreten geleneksel otoregresif BDM’lerin aksine Mercury, üretim sırasında birden çok token konumunu yinelemeli olarak rafine eden modeller ailesine aittir. Inception’ın yaklaşımı, ajanlar, arama, müşteri desteği, eğitim ve yinelemeli model çağrılarının hızla birikebileceği diğer uygulamalar gibi gecikmeye duyarlı iş yükleri için en uygunudur.
Mercury 3, bu difüzyon tabanlı üretim sürecini, uzun bağlam girişi, akıl yürütme kontrolleri, araç çağırma, yapılandırılmış çıktılar ve OpenAI uyumlu uç noktalar gibi genel amaçlı bir API modelinden beklenen yeteneklerle birleştirir. Ayrıca, uygulamaların yalnızca eklenecek çıktı blokları yerine modelin ara tam metin rafine etme durumlarını almasına olanak tanıyan
diffusing=Trueakış modunu sunar.Bu yazının yazıldığı sırada, Mercury 3 aşağıdakileri desteklemektedir:
Özellik
Mercury 3
Bağlam penceresi
1M token
Maksimum çıktı
131.072 token
Akıl yürütme çabası
instant, low, medium, high
Araç çağırma
Desteklenir
Yapılandırılmış çıktı
Desteklenir
Akış
Desteklenir
Difüzyon akışı
Desteklenir
Sıcaklık
0.5–1.0
API
OpenAI uyumlu
Inception şu anda Mercury 3’ü, milyon başına 0,10 $ giriş tokeni, milyon başına 0,01 $ önbelleğe alınmış giriş tokeni ve milyon başına 0,35 $ çıkış tokeni lansman fiyatıyla listeliyor. Önbelleğe alınan tokenler, giriş fiyatına göre %90 indirimlidir.
Mercury 3, Mercury 1’den 40 kat daha büyük ve çok daha zeki, ancak aynı derecede hızlıdır.
Şekil: Model Kalitesi vs Model Boyutu (Kaynak)
Mercury 3 Nasıl Çalışır?
Çoğu BDM, metni soldan sağa, birer token olacak şekilde otoregresif olarak üretir. Geleneksel BDM’lerin metni nasıl ürettiği şöyledir:
Her yeni token, ondan önce üretilen her şeye bağlıdır.
Mercury ise bunun yerine difüzyon kullanır.
Inception, difüzyon BDM’lerini, çıktıyı paralel olarak birden çok tokeni değiştirerek kademeli şekilde iyileştiren Transformer tabanlı modeller olarak tanımlar. Daha önceki Mercury araştırmaları, bunu, kesin olarak soldan sağa bir sonraki tokeni tahmin etmekten ziyade kaba’dan ince’ye bir üretim süreci olarak açıklar.
Basitleştirilmiş bir görselleştirme şöyle görünebilir: