

Este é apenas um exemplo conceitual, não a representação interna exata do Mercury 3.
A API da Inception pode expor esses estados intermediários. Com o streaming normal, o Mercury retorna blocos de texto refinados que podem ser anexados à resposta. Com diffusing=True, cada chunk passa a conter a versão completa atual da resposta conforme o modelo a refina.
Daqui a pouco vamos ver a diferença.
Demo: criando um assistente de escalonamento de suporte em tempo real
Antes de montar a demo, vamos separar as configurações do modelo do próprio aplicativo de suporte.
O caso de suporte é apenas o input que usamos para exercitar o Mercury 3. Os controles importantes do lado do modelo são o orçamento de raciocínio, o orçamento de conclusão e o modo de streaming.
|
Configuração |
Valor usado |
Por que importa |
|
Temperatura |
0,75 |
Mantida fixa para não mudar a amostragem ao comparar os modos |
|
Esforço de raciocínio |
low, high |
Permite comparar uso de raciocínio oculto e latência |
|
Orçamento de conclusão |
8192 |
Grande o suficiente para as execuções medidas da demo |
|
Streaming padrão |
stream=True |
Retorna blocos de texto anexáveis |
|
Streaming por difusão |
stream=True, diffusing=True |
Retorna sucessivos estados de refinamento do texto completo |
|
Prompt |
Caso de suporte fixo |
Mantém a tarefa constante enquanto alteramos as configurações do modelo |
|
Repetições |
5 por condição |
Mostra a variação entre execuções em vez de depender de um único request |
Essas são configurações de trabalho para este experimento, não os parâmetros globalmente ideais do Mercury 3.
Passo 1: pré-requisitos
O Mercury 3 exige apenas alguns passos para começar. Para acompanhar, você vai precisar de:
- Uma chave de API da Inception
- Python 3
- O pacote inceptionai
- O caso de suporte salvo como
case_support.json
Comece criando sua conta na plataforma Inception e gerando a chave de API. Clique em Get Started e preencha os dados:
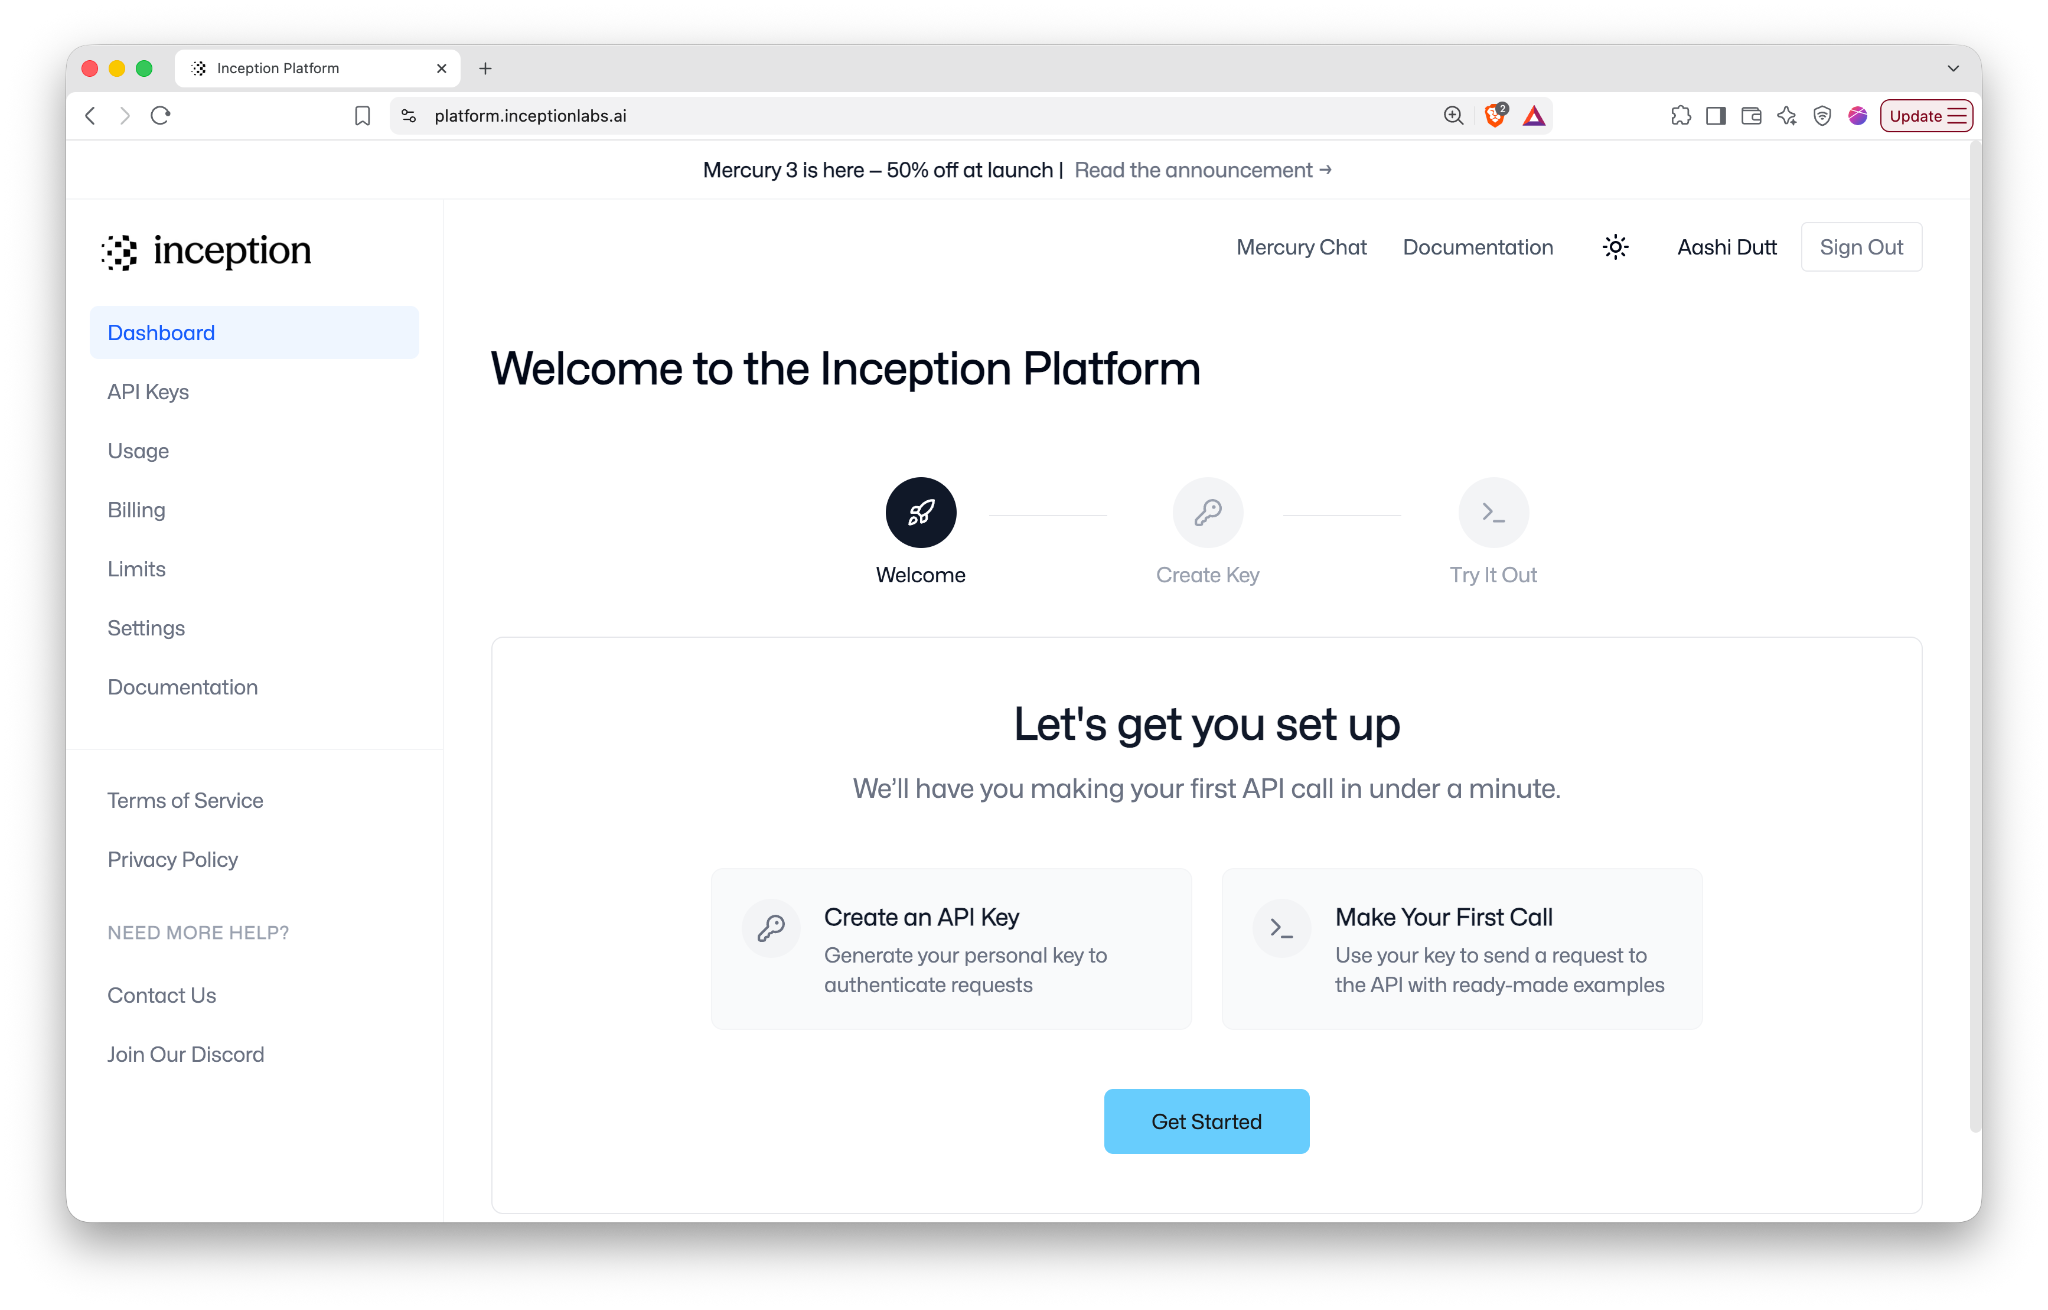
Observação: no momento em que escrevemos, a Inception oferece 100 milhões de tokens gratuitos para novas contas testarem a API.
Você pode nomear sua chave de API ou simplesmente pular essa etapa e clicar em Create Key.
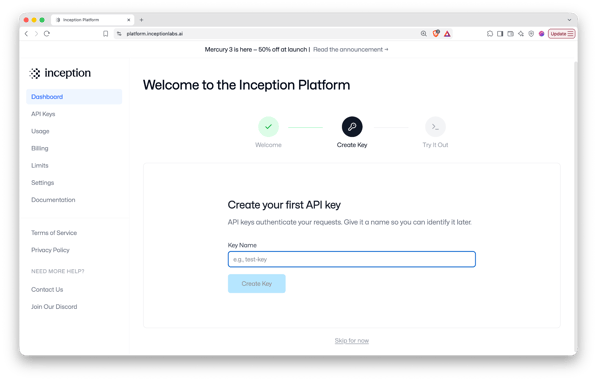
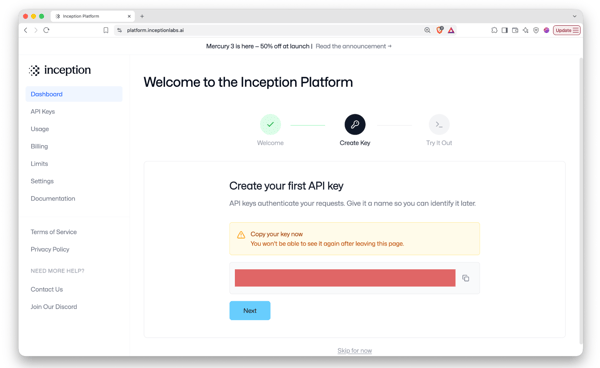
Em seguida, copie a chave de API e faça sua primeira chamada à API.
Passo 2: experimente o Mercury 3
Antes de escrever qualquer código, você pode testar o Mercury 3 diretamente pela Inception Platform. Depois de criar sua chave de API, clique em Next e selecione o botão Run it now na aba Try It Out.
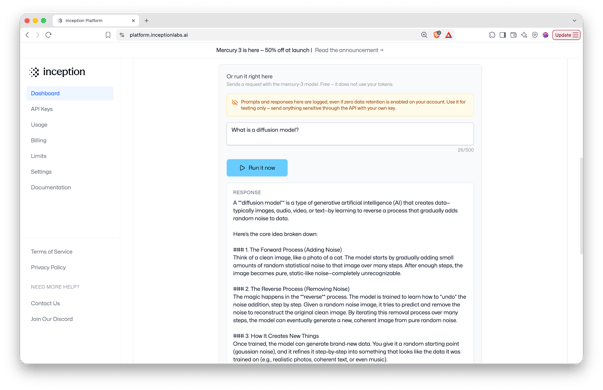
Isso é útil para testar rapidamente prompts e configurações do modelo antes de levá-los para um aplicativo.
Passo 3: prepare o ambiente e faça uma chamada à API
No restante deste tutorial, vamos chamar o Mercury 3 a partir do Python. Comece instalando o SDK da Inception e exportando a chave de API assim:
!pip install -q inceptionaiDepois, importe os pacotes usados na demo:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass solicita a chave da API sem exibi-la, os a coloca onde o SDK procura, Path e json carregam o case_support.json e o serializam no prompt, e time.perf_counter() registra quando cada resposta e estado de refinamento chegam.
difflib compara estados consecutivos de difusão e clear_output() substitui a saída da célula para que o replay aconteça no mesmo lugar, em vez de empilhar ao longo da página.
Se a chave de API ainda não estiver definida, você pode solicitá-la interativamente:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() lê a chave de API do ambiente. Enquanto isso, os outros imports, como time, registram quando os estados de refinamento chegam, difflib ajuda a comparar o texto intermediário e clear_output() permite reproduzir o processo de difusão no mesmo local.
Passo 4: monte as mensagens do modelo
O caso de suporte fica separado em case_support.json. O arquivo do caso contém a mensagem do cliente, informações do pedido, registros de pagamento, logs de fulfillment, política de suporte e os prompts que queremos usar neste cenário.
Você pode criar o seu próprio ou usar este como está:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Agora, vamos carregar o arquivo JSON:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Antes de enviar ao Mercury 3, separamos a configuração do prompt das evidências:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]As chaves system_prompt, task_prompt e packet_label controlam como instruímos o Mercury, então são removidas das evidências antes de o caso em si ser serializado. Agora podemos preparar as mensagens finais:
messages = build_messages(case)Não há sistema de busca nem ferramenta externa envolvida aqui. Tudo o que o Mercury precisa para esta análise é fornecido diretamente no request.
Passo 5: faça um request ao Mercury 3
Antes de testar o streaming, vamos fazer um request normal, sem streaming. O helper a seguir encapsula a chamada à API do Mercury e registra os metadados da resposta:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Agora vamos definir uma chamada ao modelo:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}Os controles principais do lado do modelo são:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensAgora podemos fazer uma chamada de baseline:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])O Mercury recebe o caso de suporte completo e retorna a análise solicitada, incluindo a explicação mais provável, evidências que a sustentam, explicações alternativas, incertezas e as próximas ações recomendadas.
A função também registra os campos elapsed_s e usage. O primeiro mede o tempo de ponta a ponta do request, enquanto o outro inclui a contabilidade de tokens, incluindo o uso reportado de tokens de raciocínio.
Ao longo das execuções usadas neste tutorial, o Mercury identificou de forma consistente a segunda entrada de pagamento como sendo, muito provavelmente, uma autorização pendente, e não evidência de um segundo pedido confirmado. Porém, o caso propositalmente não tem informação suficiente para saber se essa autorização pendente vai desaparecer depois ou se será capturada.
Passo 6: adicione o streaming padrão
Um request normal espera o Mercury terminar para então retornar a resposta completa. Para receber a resposta de forma incremental, precisamos ativar stream=True. A função de streaming padrão fica assim:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}O comportamento importante aqui é chunks.append(content) no streaming padrão, em que cada chunk contém o próximo trecho da resposta; assim, os chunks podem ser acumulados e reconstruídos na resposta final com "".join(chunks).
Observação: a mediana do tempo até a primeira saída visível foi de 2,903 segundos, enquanto a mediana da latência total foi de 3,375 segundos.
Passo 7: mude para diffusion streaming
Para ativar o diffusion streaming, defina os seguintes parâmetros como True:
stream=True
diffusing=TrueA chamada de API difere do streaming padrão por apenas um argumento adicional, ou seja, diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}No streaming padrão, os chunks são anexados. Já no diffusion streaming, o chunk não vazio mais recente representa a versão atual completa da resposta. Então, em vez de anexá-lo, substituímos o que foi exibido anteriormente.
Também guardamos os estados retornados para medir quantos estados de refinamento houve e verificar se estados posteriores realmente revisam texto que apareceu antes.
Em cinco execuções, o diffusion streaming retornou uma mediana de 9 estados visíveis de refinamento, variando de 7 a 12. O tempo mediano até o primeiro estado visível foi de 1,896 segundos, e a latência total mediana foi de 2,560 segundos.
Passo 8: compare o streaming padrão e o diffusion
Agora que entendemos ambos os caminhos de código, podemos comparar o comportamento medido.
|
Métrica |
Padrão |
Difusão |
|
Mediana de chunks/estados |
6 |
9 |
|
Variação |
5–7 |
7–12 |
|
Mediana do primeiro output visível |
2,903 s |
1,896 s |
|
Latência total mediana |
3,375 s |
2,560 s |
A difusão teve latência mediana menor para este prompt de suporte específico, mas os intervalos se sobrepõem bastante. Portanto, não devemos concluir que o diffusion streaming é inerentemente mais rápido.
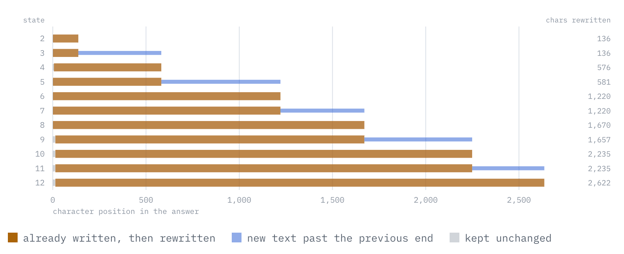
Figura: execução com 12 estados, transição por transição. A barra marrom é texto que o Mercury 3 já havia escrito e depois substituiu, enquanto a barra azul é o novo texto além do fim anterior. Um fluxo puramente por anexação não mostraria marrom algum.
Nas minhas execuções, os estados de difusão retornados revisaram texto anteriormente visível, em vez de se comportarem como chunks apenas anexáveis. Na execução acima, nenhuma das 11 transições de estado foi um append puro, e todas divergiram do estado anterior já nos primeiros 14 caracteres.
Passo 9: teste o orçamento de conclusão
Agora, vamos observar o comportamento do Mercury 3 em relação a como os tokens de raciocínio interagem com o orçamento de conclusão. As chamadas normais acima usam max_completion_tokens=8192, mas, para evidenciar melhor o comportamento, precisamos reduzir max_completion_tokens para 1600.
Agora, rode o mesmo request uma vez com esforço de raciocínio baixo e outra com alto. Aqui está o resultado medido:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneNo alto, todos os 1.539 tokens de conclusão foram reportados como tokens de raciocínio. O modelo, portanto, atingiu o limite de conclusão antes de retornar texto visível na resposta.
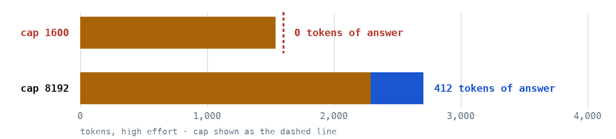
Figura: orçamento de conclusão em esforço alto com limite de 1.600 e de 8.192 tokens
Com o limite em 1.600, todo o orçamento foi para raciocínio e nada sobrou para emissão. Com 8.192, a execução mediana em esforço alto gastou 2.292 tokens raciocinando e ainda teve espaço para uma resposta de 412 tokens. O limite de 8.192 fica fora da borda direita dessa escala, por isso só a primeira linha na imagem acima mostra uma linha tracejada de limite.
O sinal importante no request malsucedido em alto é response.choices[0].finish_reason, que retornou length. Isso significa que o request atingiu seu orçamento máximo de tokens de conclusão (max_completion_tokens). Esse orçamento inclui tanto tokens de raciocínio quanto tokens de saída visível. Nessa execução, o Mercury 3 reportou todos os 1.539 tokens de conclusão como tokens de raciocínio, então o request atingiu o limite de conclusão antes de produzir uma resposta visível.
Observação: para esta demo, max_completion_tokens=8192 foi suficiente para as demais execuções, mas isso não deve ser tratado como um mínimo universal.
Passo 10: compare esforço de raciocínio baixo e alto
Agora volte ao orçamento normal de 8192 para conclusão e varie apenas o reasoning_effort entre baixo e alto. Vamos usar o helper run_nonstream() do Passo 5 para fazer um request com esforço de raciocínio baixo e outro com alto:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Para os resultados reportados, repeti cada configuração cinco vezes em vez de depender de um único request.
As medianas foram:
|
Métrica |
Baixo |
Alto |
|
Latência de ponta a ponta |
2,936 s |
8,146 s |
|
Tokens de conclusão |
1312 |
2723 |
|
Tokens de raciocínio |
828 |
2292 |
|
Tokens visíveis (aprox.) |
468 |
412 |
|
Participação do raciocínio |
63% |
84% |
O uso mediano de tokens de raciocínio subiu de 828 para 2.292, enquanto a latência mediana aumentou de 2,936 para 8,146 segundos (algo em torno de 2,77x).
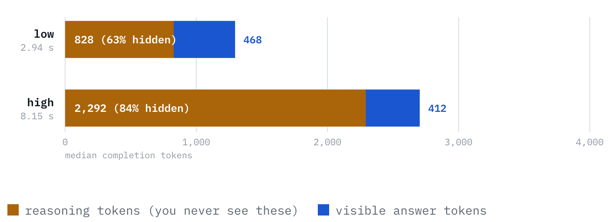
Figura: para onde vai o orçamento de conclusão em cada nível de esforço?
O tamanho da resposta visível quase não mudou:
- Baixo: mediana de 468 tokens
- Alto: mediana de 412 tokens
e as faixas observadas se sobrepõem:
- Baixo: 393–494
- Alto: 356–469
Portanto, essas execuções não sustentam a afirmação de que aumentar o esforço de raciocínio torna a resposta visível mais curta. As faixas de latência também mostram por que uma única execução não basta:
- Baixo: 1,602–4,993 s
- Alto: 4,102–9,068 s
Observação: a requisição mais rápida em alto foi, na prática, mais rápida do que a mais lenta em baixo.
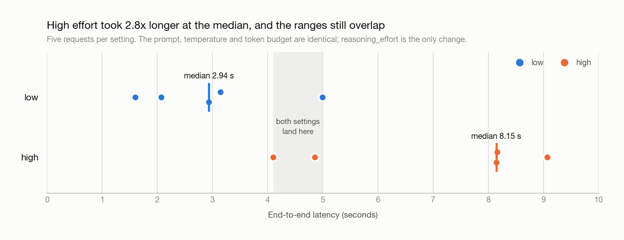
Figura: as dez requisições com esforço de raciocínio plotadas por latência
Assim, reasoning_effort="high" aumentou substancialmente o uso reportado de tokens de raciocínio e a latência neste experimento, enquanto o comprimento da resposta visível permaneceu amplamente semelhante.
Considerações finais
Há três comportamentos práticos do Mercury 3:
-
Diffusion streaming usa um contrato de saída diferente. O streaming padrão adiciona novo texto ao final, enquanto o diffusion streaming retorna estados completos sucessivos da resposta, que devem substituir o anterior.
-
Tokens de raciocínio compartilham o orçamento de conclusão. Um valor pequeno de
max_completion_tokenspode ser consumido no raciocínio antes de o Mercury 3 produzir uma resposta visível. -
Esforço de raciocínio mais alto troca mais computação por latência. Nas minhas execuções, o alto usou bem mais tokens de raciocínio reportados e levou mais tempo, como esperado, enquanto o comprimento da resposta visível ficou amplamente similar.
Esses resultados vêm de poucas execuções em um caso sintético de suporte, então devem ser tratados como observações deste demo, não como afirmações gerais de desempenho sobre o Mercury 3.

Sou Especialista Google Developers em ML (Gen AI), tricampeã no Kaggle e Embaixadora Women Techmakers, com mais de três anos de experiência na área de tecnologia. Cofundei uma startup de saúde em 2020 e atualmente faço um mestrado em ciência da computação na Georgia Tech, com foco em aprendizado de máquina.
Perguntas frequentes sobre o Mercury 3
Qual é a principal diferença entre o streaming padrão e o diffusion streaming no Mercury 3?
No streaming padrão, a resposta chega em blocos de texto que vão sendo adicionados em sequência. No diffusion streaming, a API expõe revisões sucessivas da resposta atual; por isso, o estado mais recente deve substituir o anterior, não ser anexado a ele.
reasoning_effort="high" sempre gera uma resposta melhor?
Não. Um esforço de raciocínio mais alto dá mais margem para o Mercury raciocinar, mas isso não garante uma resposta melhor em toda tarefa. Neste demo, o modo alto usou bem mais tokens de raciocínio e levou mais tempo, enquanto o tamanho da resposta visível permaneceu parecido. Ele também foi mais consistente em destacar uma evidência que faltava, mas o experimento foi pequeno demais para tirar conclusões amplas sobre qualidade.
Por que o Mercury 3 pode não retornar uma resposta visível quando o max_completion_tokens é muito baixo?
Tokens de raciocínio contam para o mesmo orçamento de tokens de conclusão que a resposta visível. Se o modelo consome a maior parte (ou todo) esse orçamento ao raciocinar, pode atingir o limite de conclusão antes de produzir saída visível. Nesses casos, verificar o finish_reason e o uso reportado de tokens de raciocínio ajuda a entender o que ocorreu.
Diffusion streaming é sempre mais rápido do que o streaming padrão?
Não. Neste demo, o diffusion streaming teve mediana menor de tempo até a primeira saída visível e menor latência total mediana, mas as faixas se sobrepuseram, e outro prompt produziu o oposto. A diferença mais confiável é o comportamento de streaming, não uma melhoria garantida de latência.
Quando devo usar o Mercury 3?
O Mercury 3 é especialmente interessante para apps sensíveis a latência, em que usuários se beneficiam de respostas rápidas enquanto o modelo ainda realiza raciocínio não trivial. O esforço de raciocínio e o orçamento de conclusão ideais dependem da tarefa, então vale ajustar considerando tanto a latência quanto a qualidade da resposta.
Mercury 3 é um Large Language Model por difusão da Inception.ai. Diferente dos LLMs autorregressivos convencionais que geram texto um token por vez, o Mercury usa difusão para refinar iterativamente várias partes da resposta. O modelo supera o GPT-6 Luna e o Claude Haiku 5.5, rodando de 4 a 8 vezes mais rápido a 1.000+ tokens por segundo em GPUs NVIDIA e com janela de contexto de 1M de tokens.
Neste tutorial, vamos construir um pequeno assistente de análise de incidentes que recebe logs de aplicação, informações de deploy, métricas de GPU e traces de requisição. Depois, vamos usar essa mesma tarefa para explorar duas propriedades do Mercury 3:
Como o streaming por difusão é diferente do streaming tradicional de LLM
O que muda quando aumentamos o
reasoning_effortde baixo para alto?No caminho, também vamos esbarrar em uma questão importante de orçamento de tokens que faz diferença ao usar os modos de raciocínio do Mercury. Ao final, você vai saber como:
Código completo no repositório.
O que é o Mercury 3?
Diferente dos LLMs autorregressivos convencionais que geram uma resposta estritamente da esquerda para a direita, o Mercury faz parte de uma família de modelos que refinam iterativamente várias posições de tokens durante a geração. A abordagem da Inception é ideal para workloads sensíveis a latência, como agentes, busca, suporte ao cliente, educação e outras aplicações em que chamadas repetidas ao modelo se acumulam rapidamente.
O Mercury 3 combina esse processo de geração por difusão com capacidades esperadas de um modelo de API de uso geral, incluindo entrada de longo contexto, controles de raciocínio, chamada de ferramentas, saídas estruturadas e endpoints compatíveis com OpenAI. Ele também oferece um modo de streaming
diffusing=Trueque permite aos aplicativos receber os estados intermediários de refinamento de texto completo do modelo, em vez de apenas blocos de saída anexados ao final.No momento da escrita, o Mercury 3 oferece suporte ao seguinte:
Propriedade
Mercury 3
Janela de contexto
1M tokens
Saída máxima
131.072 tokens
Esforço de raciocínio
instant, low, medium, high
Chamada de ferramentas
Suportado
Saída estruturada
Suportado
Streaming
Suportado
Streaming por difusão
Suportado
Temperatura
0,5–1,0
API
Compatível com OpenAI
A Inception atualmente lista o Mercury 3 com preço de lançamento de US$ 0,10 por milhão de tokens de entrada, US$ 0,01 por milhão de tokens de entrada em cache e US$ 0,35 por milhão de tokens de saída. Os tokens em cache têm 90% de desconto no preço de entrada.
O Mercury 3 é 40x maior que o Mercury 1 e muito mais inteligente, sem perder velocidade.
Figura: qualidade do modelo vs. tamanho do modelo (Fonte)
Como o Mercury 3 funciona?
A maioria dos LLMs gera texto de forma autorregressiva da esquerda para a direita, um token por vez. Veja como LLMs tradicionais geram texto:
Cada novo token depende de tudo que foi gerado antes.
O Mercury usa difusão no lugar disso.
A Inception descreve seus LLMs de difusão como modelos baseados em Transformer que aprimoram progressivamente uma saída ao modificar vários tokens em paralelo. Pesquisas anteriores sobre o Mercury descrevem isso como um processo de geração do grosso para o detalhe, em vez de uma previsão estritamente da esquerda para a direita do próximo token.
Uma ilustração simplificada poderia ser assim: