

To tylko przykład koncepcyjny, a nie dokładna wewnętrzna reprezentacja Mercury 3.
API Inception może udostępniać te stany pośrednie. Przy zwykłym streamingu Mercury zwraca bloki dopracowanego tekstu, które można dopisywać do odpowiedzi. Z diffusing=True każdy fragment zamiast tego zawiera kompletną, bieżącą wersję odpowiedzi w miarę jej dopracowywania przez model.
Za chwilę zobaczymy różnicę.
Demo: Budowa asystenta eskalacji wsparcia w czasie rzeczywistym
Zanim zbudujemy demo, oddzielmy ustawienia modelu od samej aplikacji wsparcia.
Przypadek wsparcia to tylko wejście, którego używamy do przetestowania Mercury 3. Ważne po stronie modelu są budżet rozumowania, budżet ukończenia i tryb streamingu.
|
Ustawienie |
Użyta wartość |
Dlaczego to ma znaczenie |
|
Temperatura |
0,75 |
Utrzymana stała, aby nie zmieniać próbkowania podczas porównywania trybów |
|
Nakład rozumowania |
low, high |
Pozwala porównać ukryte użycie rozumowania i opóźnienie |
|
Budżet ukończenia |
8192 |
Wystarczający dla mierzonych uruchomień demo |
|
Standardowy streaming |
stream=True |
Zwraca bloki tekstu do dopisywania |
|
Streaming dyfuzyjny |
stream=True, diffusing=True |
Zwraca kolejne pełnotekstowe stany dopracowania |
|
Prompt |
Stały przypadek wsparcia |
Utrzymuje zadanie niezmienne przy zmianie ustawień modelu |
|
Powtórzenia |
5 na warunek |
Pokazuje zmienność między uruchomieniami zamiast polegać na jednym żądaniu |
To są robocze ustawienia dla tego eksperymentu, a nie globalnie optymalne ustawienia Mercury 3.
Krok 1: Wymagania wstępne
Z Mercury 3 start zajmuje tylko kilka kroków. Aby podążać za poradnikiem, potrzebujesz:
- Klucza API Inception
- Pythona 3
- Pakietu inceptionai
- Przypadku wsparcia zapisanego jako
case_support.json
Zacznij od rejestracji na platformie Inception i uzyskaj klucz API. Kliknij Get Started i wypełnij dane:
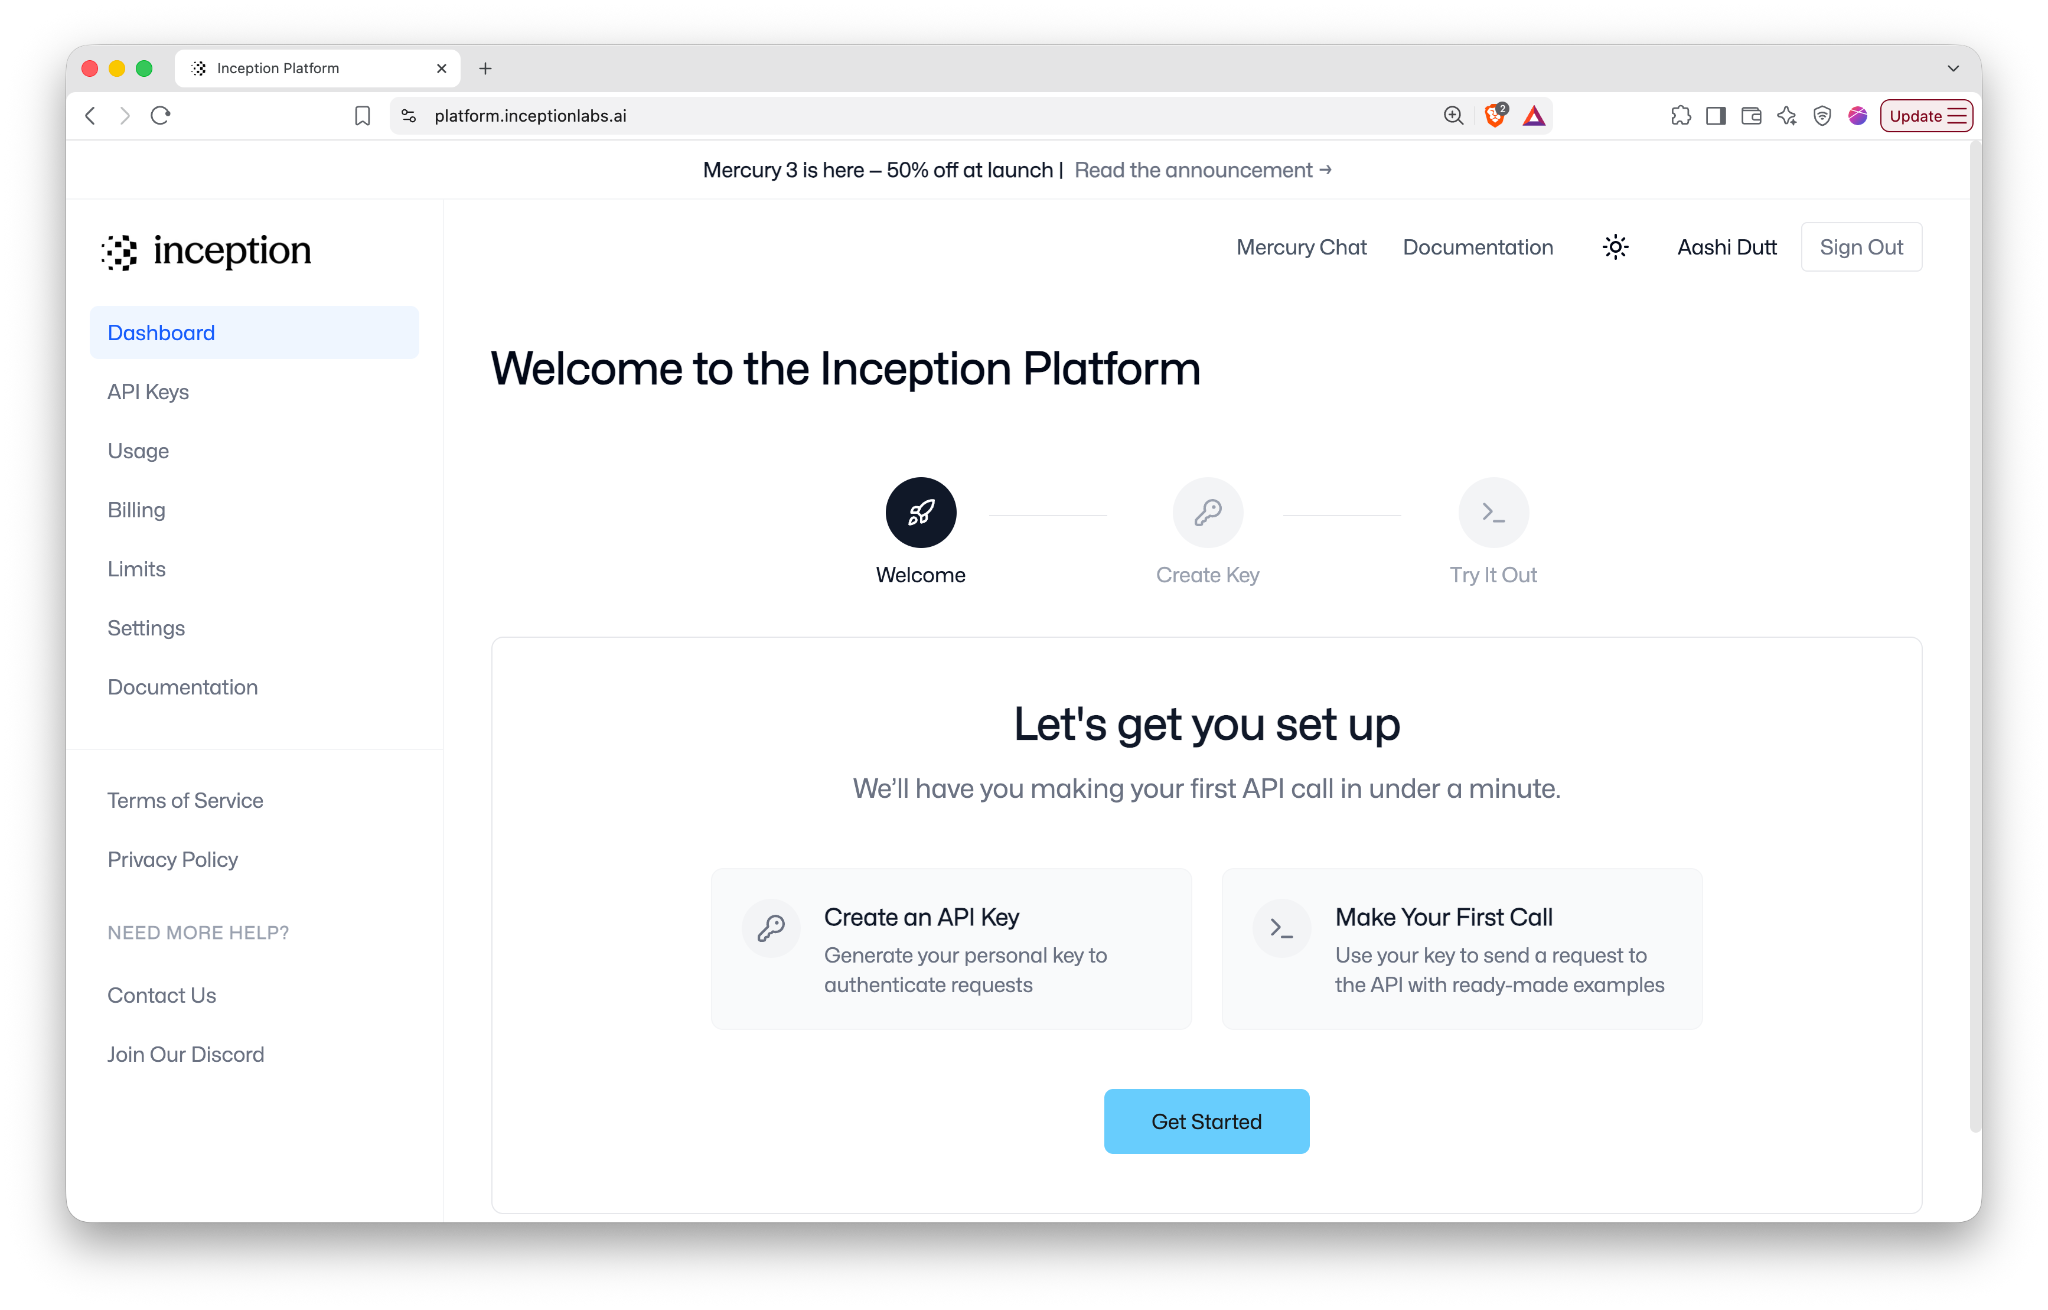
Uwaga: W chwili pisania Inception zapewnia 100 milionów darmowych tokenów nowym kontom do wypróbowania API.
Możesz nazwać swój klucz API lub po prostu pominąć ten krok i kliknąć Create Key.
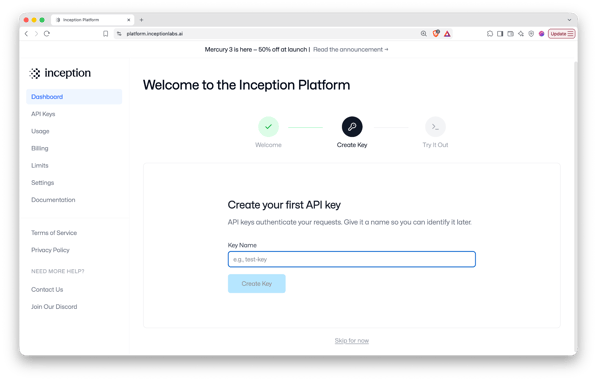
Następnie skopiuj klucz API i wykonaj pierwsze wywołanie API.
Krok 2: Wypróbuj Mercury 3
Zanim napiszesz jakikolwiek kod, możesz przetestować Mercury 3 bezpośrednio z platformy Inception. Po utworzeniu klucza API kliknij Next i wybierz przycisk Run it now na karcie Try It Out.
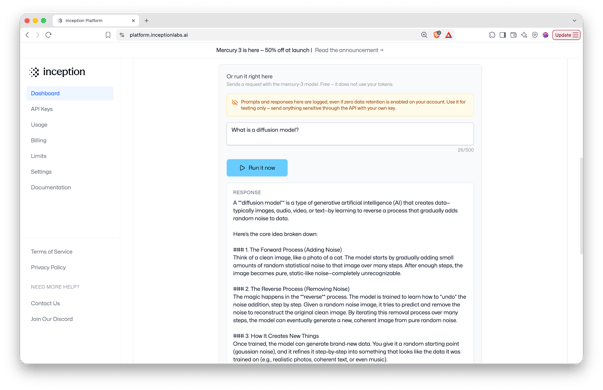
To przydatne do szybkiego testowania promptów i ustawień modelu przed przeniesieniem ich do aplikacji.
Krok 3: Przygotuj środowisko i wykonaj wywołanie API
W dalszej części samouczka będziemy wywoływać Mercury 3 z Pythona. Zacznij od zainstalowania SDK Inception i wyeksportowania klucza API w następujący sposób:
!pip install -q inceptionaiNastępnie zaimportuj pakiety używane w demie:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass pyta o klucz API bez jego wyświetlania, os umieszcza go tam, gdzie szuka go SDK, Path i json ładują case_support.json i serializują go do promptu, a time.perf_counter() zapisuje moment nadejścia każdej odpowiedzi i stanu dopracowania.
difflib porównuje kolejne stany dyfuzji, a clear_output() podmienia wynik komórki, dzięki czemu odtworzenie następuje w miejscu, a nie kaskadowo w dół strony.
Jeśli klucz API nie jest jeszcze ustawiony, możesz poprosić o niego interaktywnie:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() odczytuje klucz API ze środowiska. Pozostałe importy, jak time, zapisują moment nadejścia stanów dopracowania, difflib pomaga porównywać tekst pośredni, a clear_output() pozwala odtwarzać proces dyfuzji w miejscu.
Krok 4: Zbuduj wiadomości dla modelu
Przypadek wsparcia jest przechowywany osobno w case_support.json. Plik zawiera wiadomość klienta, informacje o zamówieniu, zapisy płatności, logi realizacji, politykę wsparcia oraz prompty, których chcemy użyć w tym scenariuszu.
Możesz przygotować własny lub użyć tego jak jest:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Teraz załadujmy plik JSON:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Zanim wyślemy go do Mercury 3, oddzielamy konfigurację promptu od materiału dowodowego:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]Klucze system_prompt, task_prompt i packet_label kontrolują sposób instruowania Mercury, więc są usuwane z materiału dowodowego przed serializacją samego przypadku. Możemy teraz przygotować finalne wiadomości:
messages = build_messages(case)Nie korzystamy tu z systemu wyszukiwania ani zewnętrznych narzędzi. Wszystko, czego Mercury potrzebuje do tej analizy, dostarczamy bezpośrednio w żądaniu.
Krok 5: Wyślij żądanie do Mercury 3
Zanim przetestujemy streaming, wykonajmy zwykłe, niestreamowane żądanie. Poniższy pomocnik opakowuje wywołanie API Mercury i zapisuje metadane odpowiedzi:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Zdefiniujmy teraz wywołanie modelu:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}Główne kontrolki po stronie modelu to:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensMożemy teraz wykonać wywołanie bazowe:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury otrzymuje kompletny przypadek wsparcia i zwraca wymaganą analizę, w tym najbardziej prawdopodobne wyjaśnienie, dowody je popierające, alternatywne wyjaśnienia, niepewności oraz rekomendowane kolejne działania.
Funkcja zapisuje też pola elapsed_s i usage. Pierwsze mierzy całkowity czas żądania, a drugie zawiera rozliczenie tokenów, w tym zgłoszone użycie tokenów rozumowania.
We wszystkich uruchomieniach użytych w tym samouczku Mercury konsekwentnie identyfikował drugi wpis płatności jako najprawdopodobniej oczekującą autoryzację, a nie dowód potwierdzonego drugiego zamówienia. Jednak w sprawie celowo brakuje wystarczających informacji, aby wiedzieć, czy ta oczekująca autoryzacja ostatecznie zniknie, czy zostanie rozliczona.
Krok 6: Dodaj standardowy streaming
Zwykłe żądanie czeka, aż Mercury skończy, zanim zwróci pełną odpowiedź. Aby otrzymywać odpowiedź stopniowo, musimy włączyć stream=True. Standardowa funkcja streamingu wygląda tak:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Kluczowe zachowanie tutaj to chunks.append(content) w standardowym streamingu, gdzie każdy fragment zawiera kolejny kawałek odpowiedzi, więc fragmenty można gromadzić i odtworzyć finalną odpowiedź przez "".join(chunks).
Uwaga: Mediana czasu do pierwszego widocznego wyjścia wyniosła 2,903 sekundy, a mediana całkowitego opóźnienia 3,375 sekundy.
Krok 7: Przełącz na streaming dyfuzyjny
Aby włączyć streaming dyfuzyjny, ustaw poniższe parametry na True:
stream=True
diffusing=TrueWywołanie API różni się od standardowego streamingu tylko jednym dodatkowym argumentem, tj. diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}W standardowym streamingu fragmenty są dopisywane. Jednak w streamingu dyfuzyjnym najnowszy niepusty fragment reprezentuje bieżącą pełną wersję odpowiedzi. Zamiast więc go dopisywać, zastępujemy to, co wcześniej wyświetlono.
Przechowujemy też zwrócone stany, aby mierzyć liczbę stanów dopracowania i sprawdzić, czy późniejsze stany faktycznie zmieniają wcześniej wyświetlony tekst.
W pięciu uruchomieniach streaming dyfuzyjny zwrócił medianę 9 widocznych stanów dopracowania, w zakresie 7–12. Mediana czasu do pierwszego widocznego stanu wyniosła 1,896 sekundy, a mediana całkowitego opóźnienia 2,560 sekundy.
Krok 8: Porównaj standardowy i dyfuzyjny streaming
Skoro rozumiemy już obie ścieżki, możemy porównać zmierzone zachowanie.
|
Metryka |
Standardowy |
Dyfuzyjny |
|
Mediana fragmentów/stanów |
6 |
9 |
|
Zakres |
5–7 |
7–12 |
|
Mediana pierwszego widocznego wyjścia |
2,903 s |
1,896 s |
|
Mediana całkowitego opóźnienia |
3,375 s |
2,560 s |
W tym konkretnym promcie wsparcia dyfuzja miała niższą medianę opóźnień, ale zakresy w dużym stopniu się pokrywały. Nie należy więc wnioskować, że streaming dyfuzyjny jest z definicji szybszy.
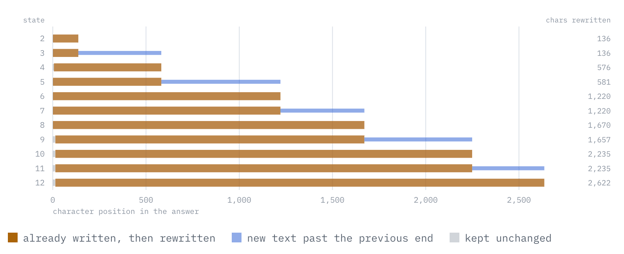
Rysunek: uruchomienie 12 stanów, przejście po przejściu. Brązowy pasek to tekst, który Mercury 3 już napisał, a następnie zastąpił, a niebieski pasek to nowy tekst poza poprzednim końcem. Czyste dopisywanie nie pokazywałoby w ogóle brązu.
W moich uruchomieniach zwrócone stany dyfuzji korygowały wcześniej widoczny tekst, zamiast zachowywać się jak fragmenty tylko do dopisywania. W powyższym uruchomieniu żadne z 11 przejść stanów nie było czystym dopisaniem, a każde odchodziło od poprzedniego stanu w ciągu pierwszych 14 znaków.
Krok 9: Przetestuj budżet ukończenia
Przyjrzyjmy się teraz zachowaniu Mercury 3 w kontekście interakcji tokenów rozumowania z budżetem ukończenia. Powyższe zwykłe wywołania używają max_completion_tokens=8192, ale aby lepiej uwidocznić zachowanie, musimy zmniejszyć max_completion_tokens do 1600.
Uruchom teraz to samo żądanie raz przy niskim, a raz przy wysokim nakładzie rozumowania. Oto zmierzony wynik:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: nonePrzy ustawieniu high wszystkie 1 539 tokenów ukończenia zostały zgłoszone jako tokeny rozumowania. Model osiągnął więc limit ukończenia, zanim zwrócił widoczny tekst odpowiedzi.
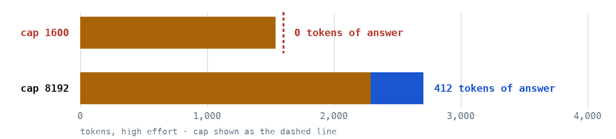
Rysunek: budżet ukończenia przy wysokim nakładzie dla limitu 1 600 i 8 192 tokenów
Przy limicie 1 600 cały budżet poszedł na rozumowanie i nic nie zostało na emisję. Przy 8 192 medianowy przebieg z wysokim nakładem zużył 2 292 tokeny na rozumowanie i nadal miał miejsce na 412‑tokenową odpowiedź. Limit 8 192 wypada poza prawą krawędź tej skali, dlatego tylko pierwszy wiersz na powyższym obrazku pokazuje przerywaną linię limitu.
Ważnym sygnałem w nieudanym żądaniu high jest response.choices[0].finish_reason, które zwróciło length. Oznacza to, że żądanie osiągnęło maksymalny budżet tokenów ukończenia (max_completion_tokens). Ten budżet obejmuje zarówno tokeny rozumowania, jak i widoczne tokeny wyjściowe. W tym uruchomieniu Mercury 3 zgłosił wszystkie 1 539 tokenów ukończenia jako tokeny rozumowania, więc żądanie osiągnęło limit ukończenia, zanim powstała widoczna odpowiedź.
Uwaga: W tym demie max_completion_tokens=8192 wystarczył na pozostałe uruchomienia, ale nie należy traktować tego jako uniwersalnego minimum.
Krok 10: Porównaj niski i wysoki nakład rozumowania
Wróć teraz do normalnego budżetu ukończenia 8192 i zmieniaj tylko reasoning_effort między low i high. Użyjemy pomocnika run_nonstream() z Kroku 5, aby wykonać jedno żądanie z niskim i drugie z wysokim nakładem:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Dla prezentowanych wyników powtórzyłam każdą konfigurację pięć razy zamiast polegać na jednym żądaniu.
Medianowe wartości były następujące:
|
Metryka |
Niski |
Wysoki |
|
Opóźnienie end‑to‑end |
2,936 s |
8,146 s |
|
Tokeny ukończenia |
1312 |
2723 |
|
Tokeny rozumowania |
828 |
2292 |
|
Przybl. widoczne tokeny |
468 |
412 |
|
Udział rozumowania |
63% |
84% |
Medianowe użycie rozumowania wzrosło z 828 do 2 292 tokenów, a medianowe opóźnienie z 2,936 do 8,146 sekundy (ok. 2,77x).
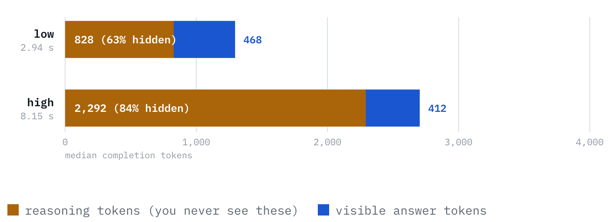
Rysunek: Na co idzie budżet ukończenia przy każdym poziomie nakładu?
Długość widocznej odpowiedzi nie zmieniła się aż tak bardzo:
- Niski: mediana 468 tokenów
- Wysoki: mediana 412 tokenów
a obserwowane zakresy się pokrywały:
- Niski: 393–494
- Wysoki: 356–469
Te uruchomienia nie potwierdzają więc tezy, że zwiększenie nakładu rozumowania skraca widoczną odpowiedź. Zakresy opóźnień też pokazują, czemu jedno uruchomienie nie wystarcza:
- Niski: 1,602–4,993 s
- Wysoki: 4,102–9,068 s
Uwaga: Najszybsze żądanie high było faktycznie szybsze niż najwolniejsze low.
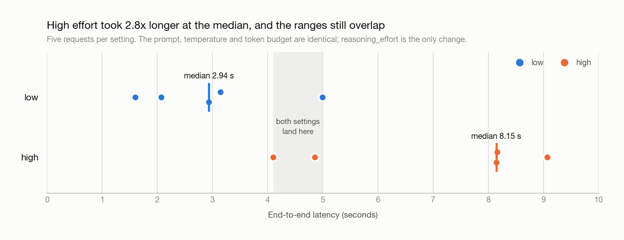
Rysunek: Wszystkie dziesięć żądań z różnym nakładem rozumowania, wykres opóźnień
Zatem reasoning_effort="high" w tym eksperymencie znacząco zwiększył zgłoszone użycie tokenów rozumowania i opóźnienie, zgodnie z oczekiwaniami, podczas gdy długość widocznej odpowiedzi pozostała ogólnie podobna.
Końcowe wnioski
Istnieją trzy praktyczne zachowania Mercury 3:
-
Streaming dyfuzyjny ma inny kontrakt wyjścia. Standardowy streaming dopisuje nowy tekst, podczas gdy streaming dyfuzyjny zwraca kolejne stany pełnej odpowiedzi, które powinny zastępować poprzedni.
-
Tokeny rozumowania współdzielą budżet ukończenia. Mała wartość
max_completion_tokensmoże zostać wyczerpana przez rozumowanie, zanim Mercury 3 wygeneruje widoczną odpowiedź. -
Wyższy nakład rozumowania zamienia dodatkowe obliczenia na opóźnienie. W moich uruchomieniach tryb high używał znacząco więcej zgłoszonych tokenów rozumowania i trwał dłużej, co było spodziewane, podczas gdy długość widocznej odpowiedzi pozostała z grubsza podobna.
Te wyniki pochodzą z niewielkiej liczby uruchomień na jednym syntetycznym przypadku wsparcia, więc należy je traktować jako obserwacje z tego dema, a nie ogólne twierdzenia o wydajności Mercury 3.
Mercury 3 — FAQ
Jaka jest główna różnica między standardowym a dyfuzyjnym streamingiem w Mercury 3?
W standardowym streamingu odpowiedź dociera w postaci fragmentów tekstu, które są do siebie dopisywane. W streamingu dyfuzyjnym API udostępnia kolejne wersje bieżącej odpowiedzi, więc najnowszy stan powinien zastąpić poprzedni, a nie zostać do niego dopisany.
Czy reasoning_effort="high" zawsze daje lepszą odpowiedź?
Nie. Wyższy nakład rozumowania daje Mercury więcej przestrzeni na rozumowanie, ale nie gwarantuje lepszej odpowiedzi dla każdego zadania. W tym demie tryb high zużywał znacznie więcej tokenów rozumowania i trwał dłużej, podczas gdy długość widocznej odpowiedzi była podobna. Był też bardziej konsekwentny w uwypuklaniu jednego brakującego elementu dowodowego, ale eksperyment był zbyt mały, by formułować szersze wnioski o jakości.
Dlaczego Mercury 3 może nie zwrócić widocznej odpowiedzi, gdy max_completion_tokens jest zbyt małe?
Tokeny rozumowania wliczają się do tego samego budżetu tokenów ukończenia co widoczna odpowiedź. Jeśli model zużyje większość lub cały ten budżet na rozumowanie, może osiągnąć limit ukończenia, zanim wygeneruje widoczne wyjście. W takim przypadku sprawdzenie finish_reason i zgłoszonego użycia tokenów rozumowania pomaga wyjaśnić, co się stało.
Czy streaming dyfuzyjny jest zawsze szybszy niż standardowy?
Nie. W tym demie streaming dyfuzyjny miał niższą medianę czasu do pierwszego widocznego wyjścia i niższą medianę całkowitego opóźnienia, ale zakresy się pokrywały, a inny prompt dał odwrotną kolejność. Bardziej wiarygodna różnica dotyczy zachowania streamingu, a nie gwarantowanej poprawy opóźnień.
Kiedy warto używać Mercury 3?
Mercury 3 jest szczególnie interesujący dla aplikacji wrażliwych na opóźnienia, w których użytkownicy zyskują na szybkich odpowiedziach, a model nadal wykonuje nietrywialne rozumowanie. Odpowiedni nakład rozumowania i budżet ukończenia zależą od zadania, więc warto je dostroić pod kątem zarówno opóźnień, jak i jakości odpowiedzi.
Mercury 3 to dyfuzyjny duży model językowy opracowany przez Inception.ai. W przeciwieństwie do konwencjonalnych autoregresyjnych LLM-ów, które generują tekst token po tokenie, Mercury wykorzystuje dyfuzję do iteracyjnego dopracowywania wielu części odpowiedzi. Model przewyższa GPT-6 Luna i Claude Haiku 5.5, działając jednocześnie 4–8x szybciej przy 1000+ tokenach na sekundę na GPU NVIDIA i obsługuje okno kontekstu 1M tokenów.
W tym samouczku zbudujemy małego asystenta do analizy incydentów, który otrzymuje logi aplikacji, informacje o wdrożeniu, metryki GPU i ślady żądań. Następnie użyjemy tego samego zadania, aby zbadać dwie właściwości Mercury 3:
Czym różni się streaming dyfuzyjny od zwykłego streamingu LLM
Co się zmienia, gdy zwiększamy
reasoning_effortz niskiego na wysoki?Po drodze natkniemy się też na ważny problem budżetu tokenów, który ma znaczenie przy korzystaniu z trybów rozumowania Mercury. Na końcu będziesz wiedzieć, jak:
Pełne repozytorium z kodem.
Czym jest Mercury 3?
W przeciwieństwie do konwencjonalnych autoregresyjnych LLM-ów, które generują odpowiedź ściśle od lewej do prawej, Mercury należy do rodziny modeli, które iteracyjnie dopracowują wiele pozycji tokenów podczas generowania. Podejście Inception najlepiej sprawdza się w zadaniach wrażliwych na opóźnienia, takich jak agenci, wyszukiwanie, obsługa klienta, edukacja i inne aplikacje, w których wielokrotne wywołania modelu szybko się kumulują.
Mercury 3 łączy proces generowania oparty na dyfuzji z możliwościami oczekiwanymi od uniwersalnego modelu API, w tym długim kontekstem wejściowym, kontrolami rozumowania, wywoływaniem narzędzi, ustrukturyzowanymi wynikami i punktami końcowymi zgodnymi z OpenAI. Udostępnia też tryb streamingu
diffusing=True, który pozwala aplikacjom otrzymywać pośrednie, pełnotekstowe stany dopracowania modelu zamiast wyłącznie bloków wyjściowych do dopisywania.W chwili pisania tego tekstu Mercury 3 obsługuje następujące funkcje:
Właściwość
Mercury 3
Okno kontekstu
1M tokenów
Maksymalna długość wyjścia
131 072 tokeny
Nakład rozumowania
instant, low, medium, high
Wywoływanie narzędzi
Obsługiwane
Ustrukturyzowane wyjście
Obsługiwane
Streaming
Obsługiwany
Streaming dyfuzyjny
Obsługiwany
Temperatura
0,5–1,0
API
Zgodne z OpenAI
Inception obecnie podaje dla Mercury 3 cenę startową 0,10 USD za milion tokenów wejściowych, 0,01 USD za milion zbuforowanych tokenów wejściowych oraz 0,35 USD za milion tokenów wyjściowych. Zbuforowane tokeny również są tańsze o 90% względem ceny wejścia.
Mercury 3 jest 40x większy niż Mercury 1 i zdecydowanie inteligentniejszy, a przy tym równie szybki.
Rysunek: Jakość modelu vs rozmiar modelu (Źródło)
Jak działa Mercury 3?
Większość LLM-ów generuje tekst autoregresyjnie od lewej do prawej, token po tokenie. Tak tradycyjne LLM-y generują tekst:
Każdy nowy token zależy od wszystkiego, co wygenerowano wcześniej.
Mercury zamiast tego wykorzystuje dyfuzję.
Inception opisuje swoje dyfuzyjne LLM-y jako modele oparte na Transformerach, które stopniowo ulepszają wynik, modyfikując równolegle wiele tokenów. Wcześniejsze badania nad Mercury opisują to jako proces generowania od ogółu do szczegółu, a nie ściśle lewo‑prawą predykcję kolejnego tokena.
Uproszczona ilustracja mogłaby wyglądać tak: