

Questo è solo un esempio concettuale, non la rappresentazione interna esatta di Mercury 3.
L’API di Inception può esporre questi stati intermedi. Con lo streaming normale, Mercury restituisce blocchi di testo raffinato che possono essere aggiunti alla risposta. Con diffusing=True, ogni chunk contiene invece la versione completa corrente della risposta man mano che il modello la affina.
Vedremo presto la differenza.
Demo: costruire un assistente in tempo reale per l’escalation del supporto
Prima di costruire la demo, separiamo le impostazioni del modello dall’applicazione di supporto in sé.
Il caso di supporto è solo l’input che usiamo per mettere alla prova Mercury 3. I controlli importanti lato modello sono il budget di ragionamento, il budget di completion e la modalità di streaming.
|
Impostazione |
Valore usato |
Perché è importante |
|
Temperatura |
0,75 |
Tenuta fissa per non cambiare il campionamento durante il confronto tra modalità |
|
Sforzo di ragionamento |
low, high |
Ci permette di confrontare uso del ragionamento nascosto e latenza |
|
Budget di completion |
8192 |
Abbastanza grande per le esecuzioni misurate nella demo |
|
Streaming standard |
stream=True |
Restituisce blocchi di testo aggiungibili |
|
Streaming a diffusione |
stream=True, diffusing=True |
Restituisce stati successivi di raffinamento del testo completo |
|
Prompt |
Caso di supporto fisso |
Mantiene costante il compito mentre cambiano le impostazioni del modello |
|
Ripetizioni |
5 per condizione |
Mostra la variazione tra esecuzioni invece di basarsi su una sola richiesta |
Queste sono impostazioni operative per questo esperimento, non impostazioni globalmente ottimali di Mercury 3.
Passo 1: Prerequisiti
Avviare Mercury 3 richiede solo pochi passaggi. Per seguire, ti servono:
- Una chiave API Inception
- Python 3
- Il pacchetto inceptionai
- Il caso di supporto salvato come
case_support.json
Inizia registrandoti alla piattaforma Inception e ottenendo la chiave API. Clicca su Get Started e compila i dati:
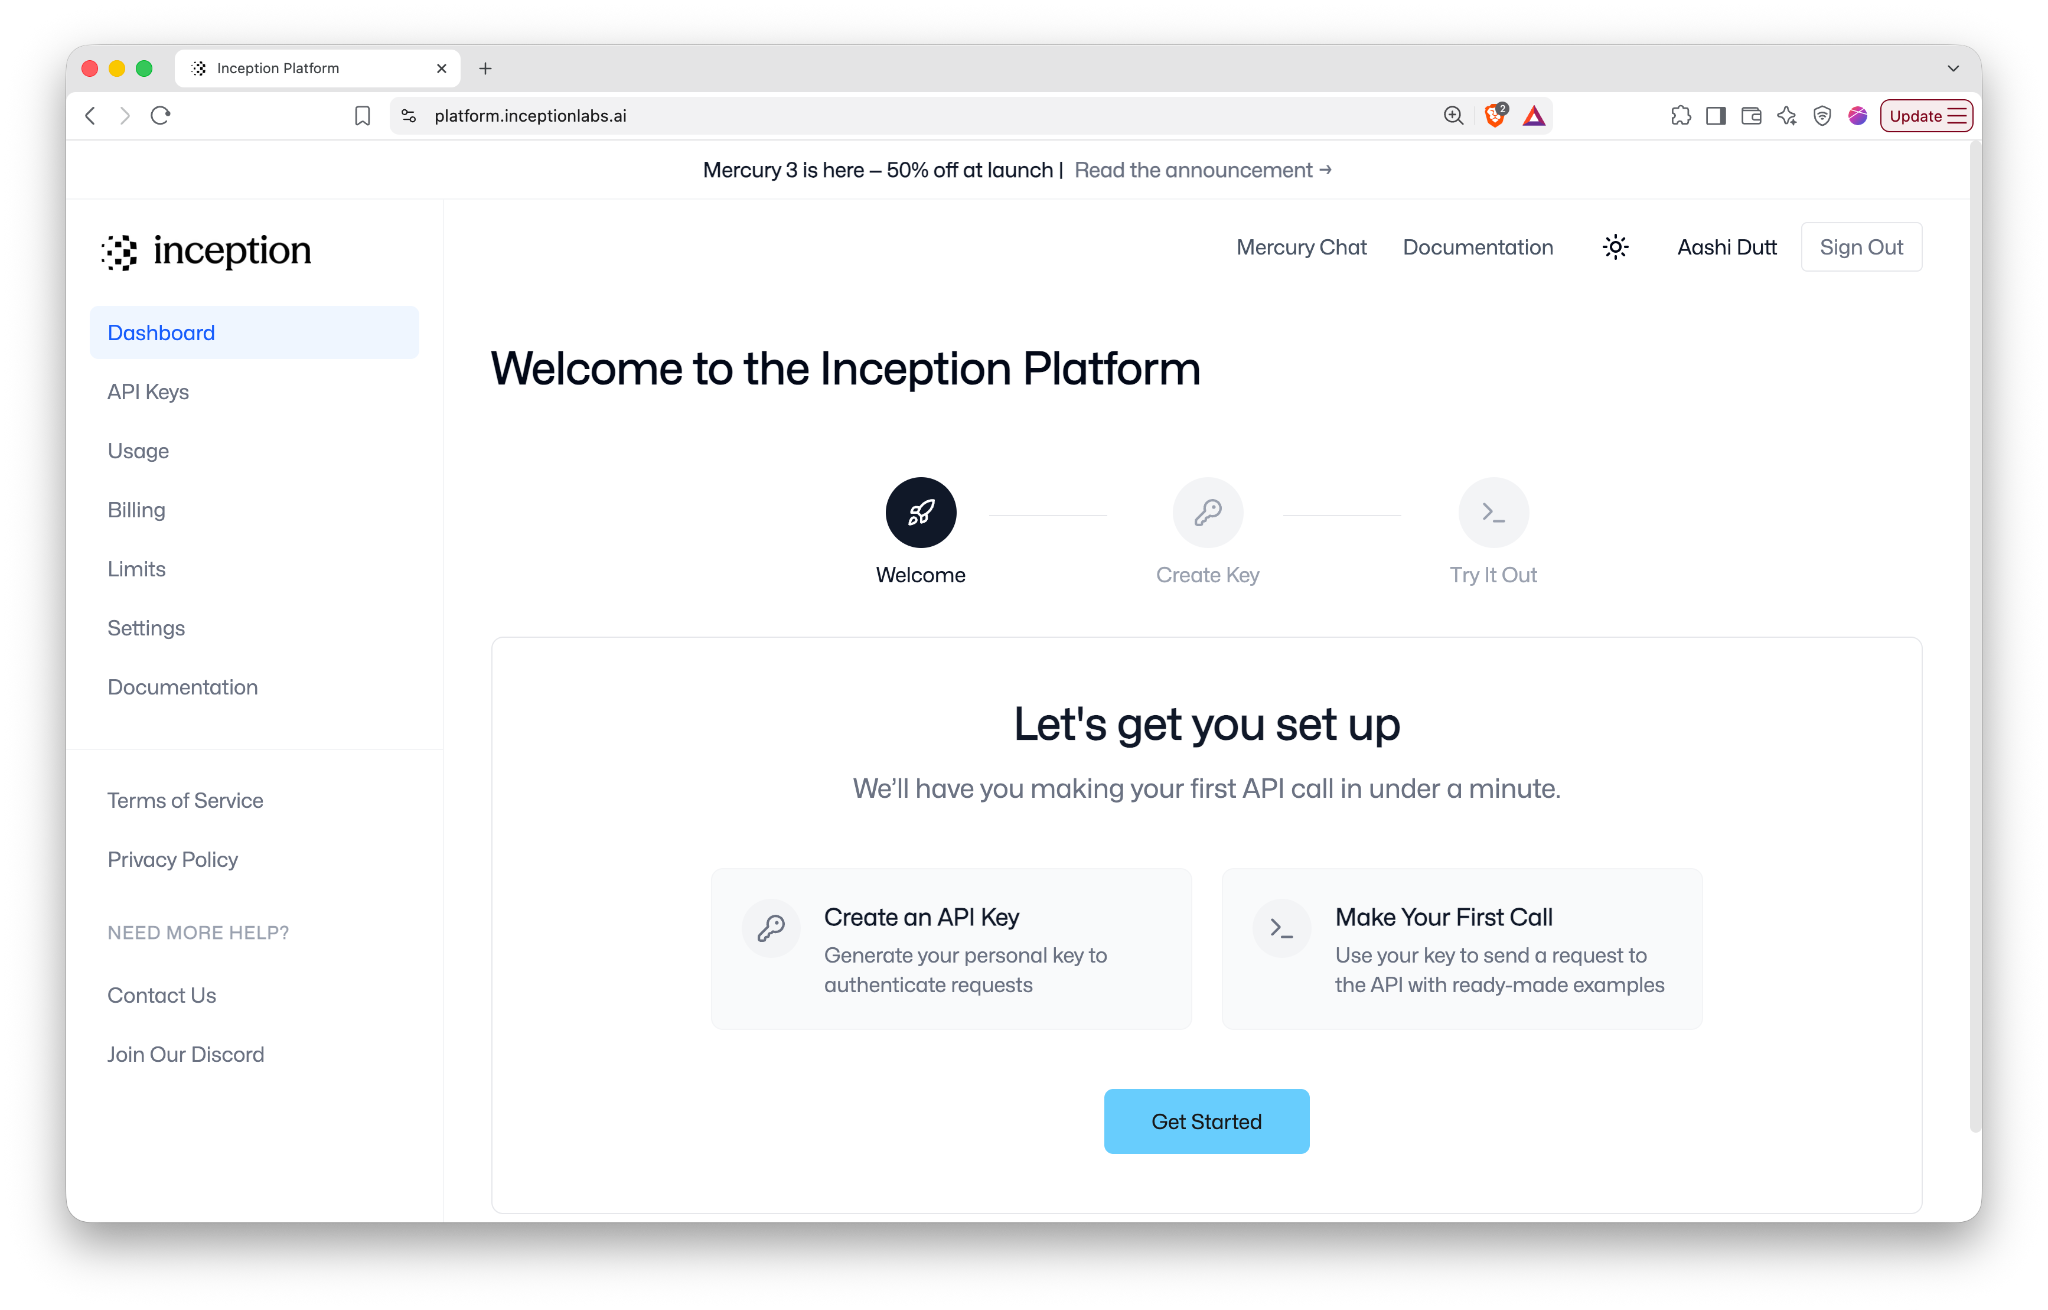
Nota: al momento della stesura, Inception fornisce 100 milioni di token gratuiti ai nuovi account per provare l’API.
Puoi dare un nome alla tua chiave API o semplicemente saltare questo passaggio e cliccare su Create Key.
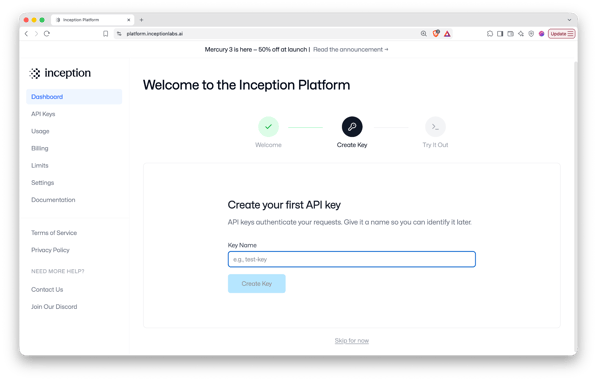
Poi copia la chiave API e fai la tua prima chiamata API.
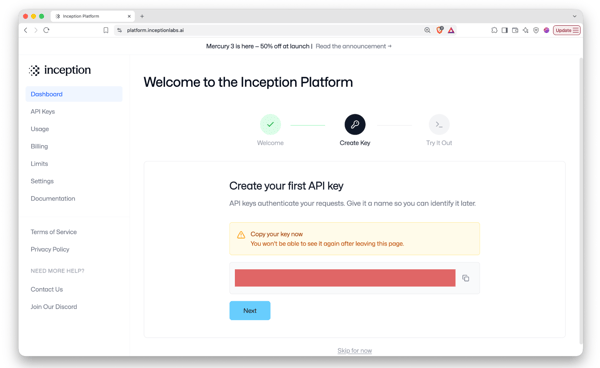
Passo 2: Prova Mercury 3
Prima di scrivere codice, puoi testare Mercury 3 direttamente dalla piattaforma Inception. Dopo aver creato la chiave API, clicca su Next e seleziona il pulsante Run it now nella scheda Try It Out.
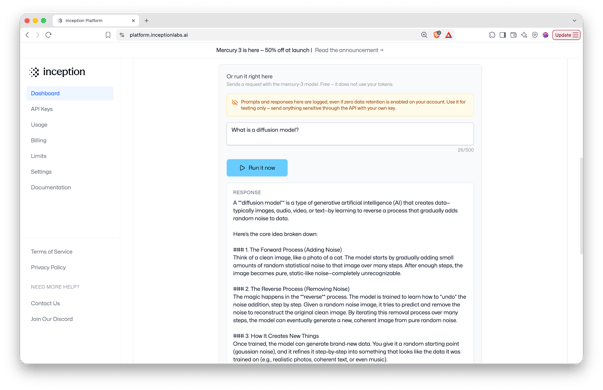
Questo è utile per testare rapidamente prompt e impostazioni del modello prima di portarli in un’applicazione.
Passo 3: Prepara l’ambiente e effettua una chiamata API
Per il resto del tutorial, chiameremo Mercury 3 da Python. Inizia installando l’SDK Inception ed esportando la chiave API come segue:
!pip install -q inceptionaiPoi importa i pacchetti usati dalla demo:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass chiede la chiave API senza visualizzarla, os la posiziona dove l’SDK la cerca, Path e json caricano case_support.json e lo serializzano nel prompt, e time.perf_counter() registra quando arriva ciascuna risposta e stato di raffinamento.
difflib confronta stati di diffusione consecutivi e clear_output() sostituisce l’output della cella così il replay avviene in loco invece di accumularsi verso il basso nella pagina.
Se la chiave API non è già impostata, puoi richiederla interattivamente:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() legge la chiave API dall’ambiente. Mentre gli altri import, come time registrano quando arrivano gli stati di raffinamento, difflib aiuta a confrontare il testo intermedio e clear_output() ci permette di riprodurre il processo di diffusione in loco.
Passo 4: Costruisci i messaggi del modello
Il caso di supporto è archiviato separatamente in case_support.json. Il file del caso contiene il messaggio del cliente, informazioni sull’ordine, registri di pagamento, log di fulfillment, policy di supporto e i prompt che vogliamo usare per questo scenario.
Puoi crearne uno tuo o usare questo così com’è:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Ora carichiamo il file JSON:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Prima di inviarlo a Mercury 3, separiamo la configurazione del prompt dalle evidenze:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]Le chiavi system_prompt, task_prompt e packet_label controllano come istruire Mercury, quindi vengono rimosse dalle evidenze prima che il caso stesso venga serializzato. Possiamo ora preparare i messaggi finali:
messages = build_messages(case)Qui non è coinvolto alcun sistema di recupero o strumento esterno. Tutto ciò di cui Mercury ha bisogno per questa analisi è fornito direttamente nella richiesta.
Passo 5: Invia una richiesta a Mercury 3
Prima di testare lo streaming, facciamo una normale richiesta non in streaming. Il seguente helper incapsula la chiamata all’API Mercury e registra i metadati della risposta:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Ora definiamo una chiamata al modello:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}I principali controlli lato modello sono:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensOra possiamo fare una chiamata di base:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury riceve il caso di supporto completo e restituisce l’analisi richiesta, inclusa la spiegazione più probabile, le evidenze a supporto, spiegazioni alternative, incertezze e azioni successive consigliate.
La funzione registra anche i campi elapsed_s e usage. Il primo misura il tempo end-to-end della richiesta, mentre l’altro include la contabilità dei token, inclusi rispettivamente i token di ragionamento riportati.
Nelle esecuzioni usate per questo tutorial, Mercury ha identificato in modo coerente la seconda voce di pagamento come molto probabilmente un’autorizzazione in sospeso piuttosto che la prova di un secondo ordine confermato. Tuttavia, il caso manca deliberatamente di informazioni sufficienti per sapere se quell’autorizzazione in sospeso scomparirà o verrà contabilizzata.
Passo 6: Aggiungi lo streaming standard
Una richiesta normale attende che Mercury finisca prima di restituire la risposta completa. Per ricevere la risposta in modo incrementale, dobbiamo abilitare stream=True. La funzione di streaming standard è la seguente:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Il comportamento importante qui è chunks.append(content) nello streaming standard, dove ogni chunk contiene il pezzo successivo della risposta, quindi i chunk possono essere accumulati e ricostruiti nella risposta finale con "".join(chunks).
Nota: il tempo mediano al primo output visibile è stato 2,903 secondi, mentre la latenza totale mediana è stata 3,375 secondi.
Passo 7: Passa allo streaming a diffusione
Per abilitare lo streaming a diffusione, imposta i seguenti parametri su True:
stream=True
diffusing=TrueLa chiamata API differisce dallo streaming standard solo per un argomento aggiuntivo, cioè diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}Con lo streaming standard, i chunk vengono aggiunti in coda. Con lo streaming a diffusione, invece, l’ultimo chunk non vuoto rappresenta la versione completa corrente della risposta. Quindi, invece di aggiungerlo, sostituiamo ciò che era stato mostrato in precedenza.
Conserviamo anche gli stati restituiti per misurare il numero di stati di raffinamento e verificare se gli stati successivi effettivamente rivedono il testo apparso in precedenza.
Su cinque esecuzioni, lo streaming a diffusione ha restituito una mediana di 9 stati di raffinamento visibili, con un intervallo di 7–12. Il tempo mediano al primo stato visibile è stato 1,896 secondi e la latenza totale mediana 2,560 secondi.
Passo 8: Confronta streaming standard e a diffusione
Ora che comprendiamo entrambi i percorsi di codice, possiamo confrontare il comportamento misurato.
|
Metrica |
Standard |
Diffusione |
|
Mediana chunk/stati |
6 |
9 |
|
Intervallo |
5–7 |
7–12 |
|
Mediana primo output visibile |
2,903 s |
1,896 s |
|
Latenza totale mediana |
3,375 s |
2,560 s |
La diffusione ha avuto una latenza mediana inferiore per questo prompt di supporto particolare, ma gli intervalli si sovrappongono in modo sostanziale. Quindi non dovremmo concludere che lo streaming a diffusione sia intrinsecamente più veloce.
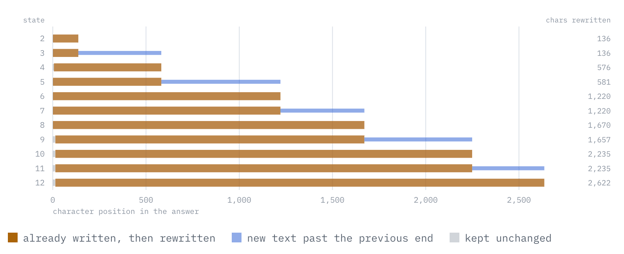
Figura: esecuzione a 12 stati, transizione per transizione. La barra marrone è testo che Mercury 3 aveva già scritto e poi sostituito, mentre la barra blu è il testo nuovo oltre il precedente finale. Un’append pura non mostrerebbe affatto marrone.
Nelle mie esecuzioni, gli stati di diffusione restituiti hanno rivisto il testo visibile in precedenza, invece di comportarsi come chunk solo in append. Nell’esecuzione sopra, nessuna delle 11 transizioni di stato è stata una pura append, e ognuna è divergita dallo stato precedente entro i primi 14 caratteri.
Passo 9: Metti alla prova il budget di completion
Vediamo ora il comportamento di Mercury 3 su come i token di ragionamento interagiscono con il budget di completion. Le chiamate normali sopra usano max_completion_tokens=8192, ma per esporre più chiaramente il comportamento dobbiamo ridurre max_completion_tokens a 1600.
Ora esegui la stessa richiesta una volta con sforzo di ragionamento basso e una volta alto. Ecco il risultato misurato:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneCon impostazione alta, tutti i 1.539 token di completion sono stati riportati come token di ragionamento. Il modello ha quindi raggiunto il limite di completion prima di restituire testo di risposta visibile.
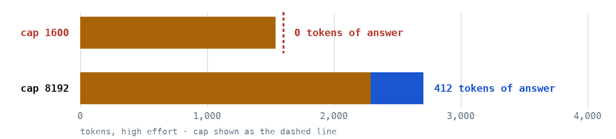
Figura: budget di completion ad alto sforzo con un cap a 1.600 e 8.192 token
Con il cap a 1.600, l’intero budget è andato al ragionamento e non è rimasto nulla da emettere. A 8.192, l’esecuzione mediana ad alto sforzo ha speso 2.292 token in ragionamento e ha avuto ancora spazio per una risposta da 412 token. Il cap a 8.192 è fuori scala a destra, motivo per cui solo la prima riga nell’immagine sopra mostra una linea tratteggiata del cap.
Il segnale importante nella richiesta alta fallita è response.choices[0].finish_reason, che ha restituito length. Ciò significa che la richiesta ha raggiunto il suo budget massimo di token di completion (max_completion_tokens). Questo budget include sia i token di ragionamento sia i token dell’output visibile. In questa esecuzione, Mercury 3 ha riportato tutti i 1.539 token di completion come token di ragionamento, quindi la richiesta ha raggiunto il limite di completion prima di produrre una risposta visibile.
Nota: per questa demo, max_completion_tokens=8192 è stato sufficiente per le restanti esecuzioni, ma non dovrebbe essere considerato un minimo universale.
Passo 10: Confronta sforzo di ragionamento basso e alto
Ora torna al normale budget di completion 8192 e varia solo reasoning_effort tra basso e alto. Useremo l’helper run_nonstream() del Passo 5 per effettuare una richiesta con sforzo di ragionamento basso e un’altra con alto:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Per i risultati riportati, ho ripetuto ogni configurazione cinque volte invece di fare affidamento su una sola richiesta.
Le mediane sono state:
|
Metrica |
Basso |
Alto |
|
Latenza end-to-end |
2,936 s |
8,146 s |
|
Token di completion |
1312 |
2723 |
|
Token di ragionamento |
828 |
2292 |
|
Token visibili ca. |
468 |
412 |
|
Quota di ragionamento |
63% |
84% |
L’uso mediano del ragionamento è aumentato da 828 a 2.292 token, mentre la latenza mediana è aumentata da 2,936 a 8,146 secondi (circa 2,77x).
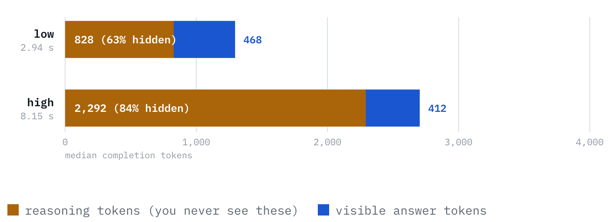
Figura: dove va il budget di completion a ciascun livello di sforzo?
La lunghezza della risposta visibile non è cambiata altrettanto:
- Basso: mediana 468 token
- Alto: mediana 412 token
e gli intervalli osservati si sovrapponevano:
- Basso: 393–494
- Alto: 356–469
Quindi, queste esecuzioni non supportano l’affermazione che aumentare lo sforzo di ragionamento renda la risposta visibile più corta. Gli intervalli di latenza mostrano anche perché un’unica esecuzione non basta:
- Basso: 1,602–4,993 s
- Alto: 4,102–9,068 s
Nota: la richiesta alta più veloce è stata in realtà più veloce della richiesta bassa più lenta.
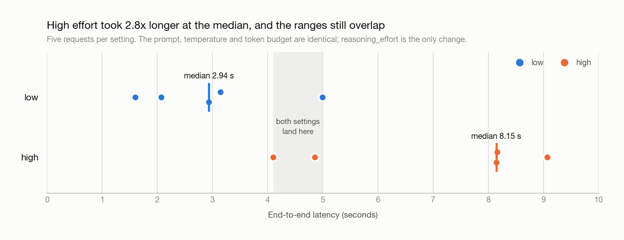
Figura: tutte le dieci richieste con sforzo di ragionamento tracciate per latenza
Quindi, reasoning_effort="high" in questo esperimento ha aumentato sostanzialmente i token di ragionamento riportati e la latenza, come previsto, mentre la lunghezza della risposta visibile è rimasta ampiamente simile.
Considerazioni finali
Ci sono tre comportamenti pratici di Mercury 3:
-
Lo streaming a diffusione usa un contratto di output diverso. Lo streaming standard aggiunge nuovo testo in coda, mentre lo streaming a diffusione restituisce stati successivi della risposta completa che dovrebbero sostituire il precedente.
-
I token di ragionamento condividono il budget di completion. Un valore piccolo di
max_completion_tokenspuò essere esaurito dal ragionamento prima che Mercury 3 produca una risposta visibile. -
Un maggiore sforzo di ragionamento scambia calcolo aggiuntivo con latenza. Nelle mie esecuzioni, l’impostazione alta ha usato molti più token di ragionamento riportati ed è risultata più lenta, come previsto, mentre la lunghezza della risposta visibile è rimasta ampiamente simile.
Questi risultati provengono da un numero ridotto di esecuzioni su un caso di supporto sintetico, quindi vanno trattati come osservazioni di questa demo piuttosto che come affermazioni generali sulle prestazioni di Mercury 3.

Sono una Google Developers Expert in ML (Gen AI), una Kaggle 3x Expert e una Women Techmakers Ambassador con oltre 3 anni di esperienza nel tech. Ho co-fondato una startup health-tech nel 2020 e sto conseguendo un master in informatica al Georgia Tech, con specializzazione in machine learning.
Mercury 3 FAQs
Qual è la principale differenza tra streaming standard e streaming a diffusione in Mercury 3?
Con lo streaming standard, la risposta arriva come chunk di testo che vengono aggiunti l’uno all’altro. Con lo streaming a diffusione, l’API espone revisioni successive della risposta corrente, quindi lo stato più recente dovrebbe sostituire il precedente invece di essere aggiunto.
reasoning_effort="high" produce sempre una risposta migliore?
No. Uno sforzo di ragionamento più alto dà a Mercury più margine per ragionare, ma non garantisce una risposta migliore per ogni task. In questa demo, l’impostazione alta ha effettivamente usato molti più token di ragionamento ed è stata più lenta, mentre la lunghezza della risposta visibile è rimasta simile. È stata anche più coerente nell’evidenziare un elemento di prova mancante, ma l’esperimento era troppo piccolo per trarre affermazioni qualitative più ampie.
Perché Mercury 3 può non restituire una risposta visibile quando max_completion_tokens è troppo piccolo?
I token di ragionamento contano sullo stesso budget di token di completion della risposta visibile. Se il modello consuma la maggior parte o tutto quel budget durante il ragionamento, può raggiungere il limite di completion prima di produrre output visibile. In tal caso, controllare finish_reason e l’uso dei token di ragionamento riportati aiuta a spiegare cosa è successo.
Lo streaming a diffusione è sempre più veloce dello streaming standard?
No. In questa demo, lo streaming a diffusione ha avuto un tempo mediano inferiore al primo output visibile e una latenza totale mediana inferiore, ma gli intervalli si sovrapponevano e un altro prompt ha prodotto l’ordinamento opposto. La differenza più affidabile è il comportamento di streaming, non un miglioramento garantito della latenza.
Quando dovrei usare Mercury 3?
Mercury 3 è particolarmente interessante per applicazioni sensibili alla latenza in cui gli utenti beneficiano di risposte rapide mentre il modello esegue comunque ragionamenti non banali. Lo sforzo di ragionamento e il budget di completion giusti dipendono dal task, quindi vanno ottimizzati sia rispetto alla latenza sia alla qualità della risposta.





Mercury 3 è un Large Language Model a diffusione di Inception.ai. A differenza degli LLM autoregressivi convenzionali che generano testo un token alla volta, Mercury usa la diffusione per raffinare iterativamente più parti della sua risposta. Il modello supera GPT-6 Luna e Claude Haiku 5.5, funzionando 4–8 volte più veloce a oltre 1.000 token al secondo su GPU NVIDIA e supporta una finestra di contesto da 1M di token.
In questo tutorial, costruiremo un piccolo assistente per l’analisi degli incidenti che riceve log applicativi, informazioni di deploy, metriche GPU e trace delle richieste. Useremo poi lo stesso compito per esplorare due proprietà di Mercury 3:
In che modo lo streaming con diffusione differisce dallo streaming LLM normale
Cosa cambia quando aumentiamo
reasoning_effortda basso ad alto?Lungo il percorso, incontreremo anche un importante problema di budget di token che conta quando si usano le modalità di ragionamento di Mercury. Alla fine, saprai come:
Repository del codice completo qui.
Che cos’è Mercury 3?
A differenza degli LLM autoregressivi tradizionali che generano una risposta rigorosamente da sinistra a destra, Mercury appartiene a una famiglia di modelli che raffinano iterativamente più posizioni di token durante la generazione. L’approccio di Inception è ideale per carichi sensibili alla latenza come agenti, ricerca, supporto clienti, education e altre applicazioni in cui chiamate ripetute al modello possono sommarsi rapidamente.
Mercury 3 combina quel processo di generazione basato sulla diffusione con funzionalità attese da un modello API generico, tra cui input a lungo contesto, controlli di ragionamento, chiamata strumenti, output strutturati ed endpoint compatibili con OpenAI. Espone anche una modalità di streaming
diffusing=Trueche consente alle applicazioni di ricevere gli stati intermedi di raffinamento del testo completo del modello invece dei soli blocchi di output in append.Al momento della stesura, Mercury 3 supporta quanto segue:
Proprietà
Mercury 3
Finestra di contesto
1M token
Output massimo
131.072 token
Sforzo di ragionamento
instant, low, medium, high
Chiamata strumenti
Supportata
Output strutturato
Supportato
Streaming
Supportato
Streaming a diffusione
Supportato
Temperatura
0,5–1,0
API
Compatibile con OpenAI
Inception attualmente indica Mercury 3 a un prezzo di lancio di $0,10 per milione di token in input, $0,01 per milione di token in input in cache e $0,35 per milione di token in output. Anche i token in cache hanno uno sconto del 90% rispetto al prezzo di input.
Mercury 3 è 40 volte più grande di Mercury 1 ed è enormemente più intelligente, ma altrettanto veloce.
Figura: Qualità del modello vs dimensione del modello (Fonte)
Come funziona Mercury 3?
La maggior parte degli LLM genera testo in modo autoregressivo da sinistra a destra, un token alla volta. Ecco come gli LLM tradizionali generano testo:
Ogni nuovo token dipende da tutto ciò che è stato generato prima.
Mercury usa invece la diffusione.
Inception descrive i suoi LLM a diffusione come modelli basati su Transformer che migliorano progressivamente un output modificando più token in parallelo. Le ricerche precedenti su Mercury descrivono questo come un processo di generazione dal grossolano al fine, piuttosto che una previsione del token successivo strettamente da sinistra a destra.
Un’illustrazione semplificata potrebbe apparire così: