

Detta är endast ett konceptuellt exempel, inte Mercury 3:s exakta interna representation.
Inceptions API kan exponera dessa intermediära tillstånd. Med normal strömning returnerar Mercury block av förfinad text som kan läggas till svaret. Med diffusing=True innehåller varje del i stället den kompletta aktuella versionen av svaret allteftersom modellen förfinar det.
Vi ser skillnaden strax.
Demo: Bygga en realtidsassistent för eskalering i support
Innan vi bygger demon separerar vi modellinställningar från själva supportapplikationen.
Supportärendet är bara indata vi använder för att testa Mercury 3. De viktiga modellsidiga kontrollerna är resoneringsbudget, slutförandebudget och strömningsläge.
|
Inställning |
Använt värde |
Varför det är viktigt |
|
Temperatur |
0,75 |
Hålls fast så att vi inte ändrar sampling när vi jämför lägen |
|
Resoneringsinsats |
low, high |
Låter oss jämföra dold resoneringsanvändning och latens |
|
Slutförandebudget |
8192 |
Tillräckligt stor för de uppmätta demokörningarna |
|
Standardströmning |
stream=True |
Returnerar textblock som kan läggas till |
|
Diffusionsströmning |
stream=True, diffusing=True |
Returnerar successiva fulltext-förfinringssteg |
|
Prompt |
Fast supportärende |
Håller uppgiften konstant medan modellinställningarna ändras |
|
Upprepningar |
5 per villkor |
Visar variation mellan körningar i stället för att förlita sig på en förfrågan |
Detta är fungerande inställningar för det här experimentet, inte globalt optimala inställningar för Mercury 3.
Steg 1: Förutsättningar
Det tar bara några steg att komma i gång med Mercury 3. För att följa med behöver du:
- En Inception-API-nyckel
- Python 3
- Paketet inceptionai
- Supportärendet sparat som
case_support.json
Börja med att registrera dig på inception-plattformen och hämta API-nyckeln. Klicka på Get Started och fyll i uppgifterna:
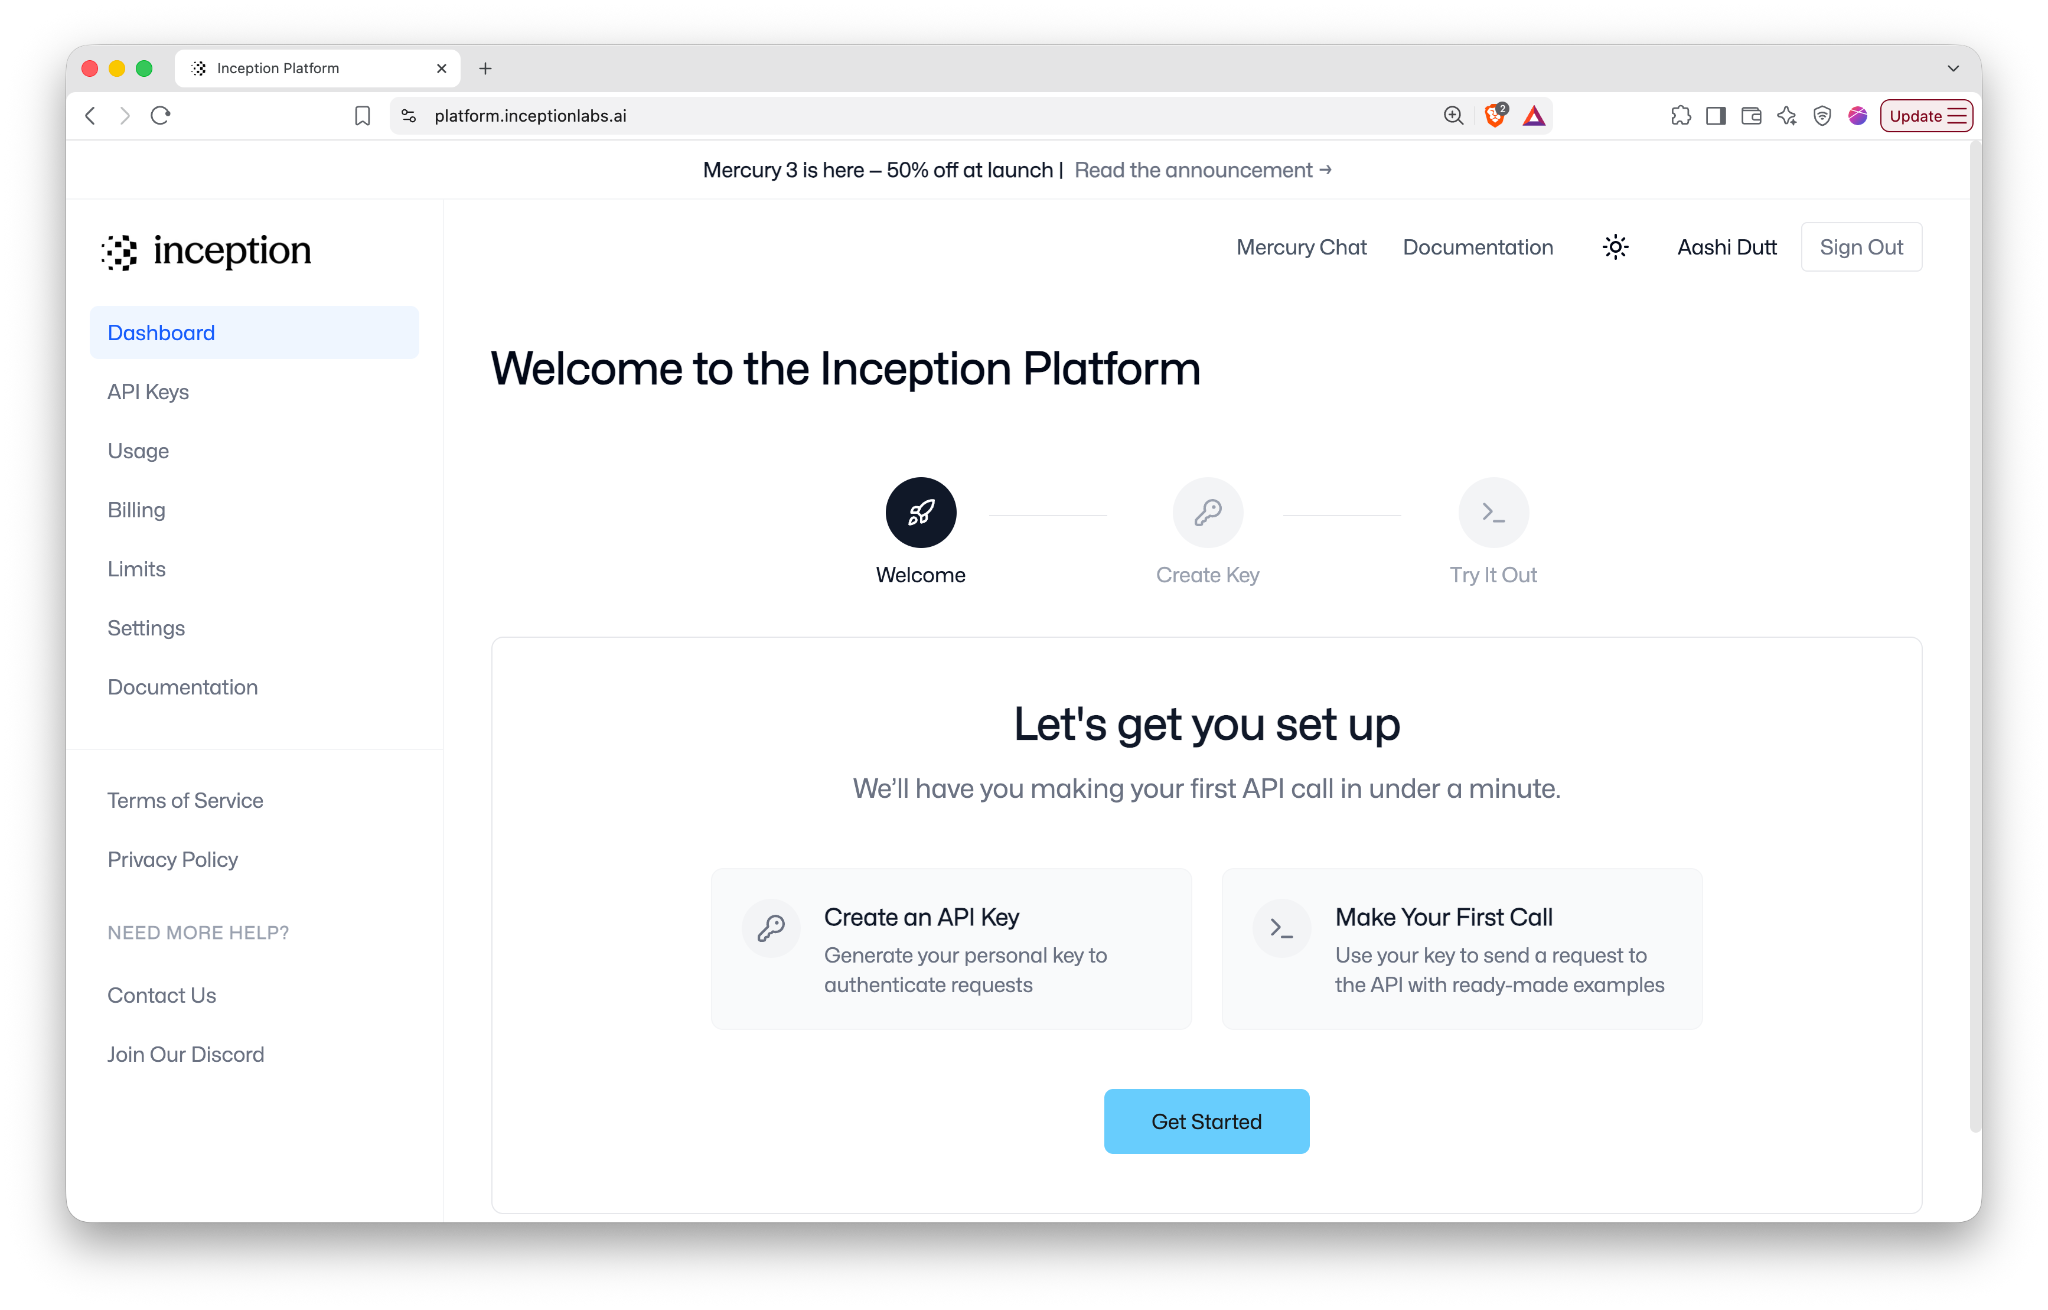
Obs: Vid skrivande stund erbjuder Inception 100 miljoner gratis tokens till nya konton för att prova API:et.
Du kan namnge din API-nyckel eller helt enkelt hoppa över detta steg och klicka på Create Key.
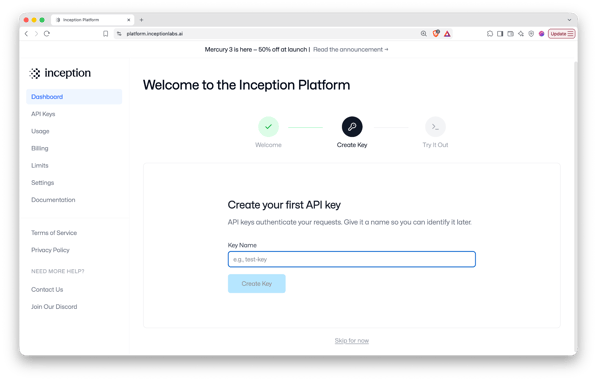
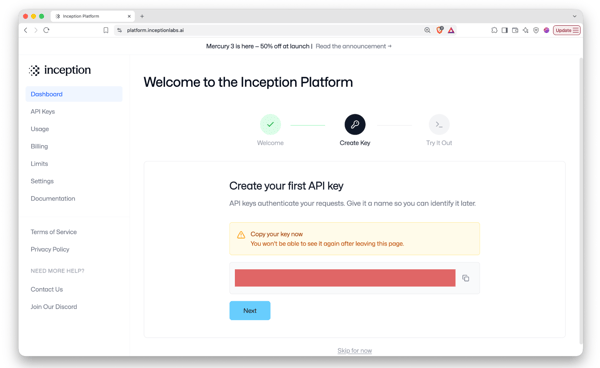
Kopiera sedan API-nyckeln och gör ditt första API-anrop.
Steg 2: Testa Mercury 3
Innan du skriver någon kod kan du testa Mercury 3 direkt från Inception-plattformen. Efter att du skapat din API-nyckel, klicka på Next och välj knappen Run it now på fliken Try It Out.
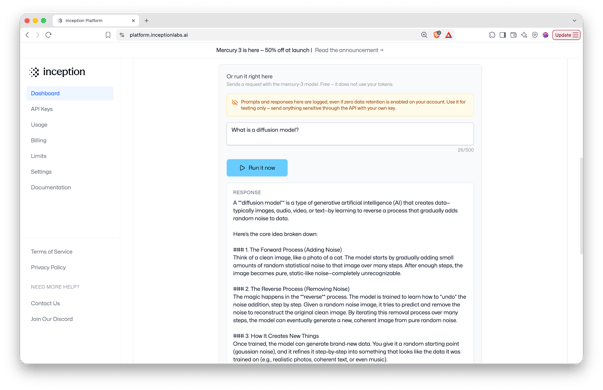
Detta är användbart för att snabbt testa promptar och modellinställningar innan de flyttas in i en applikation.
Steg 3: Förbered miljön och gör ett API-anrop
För resten av handledningen anropar vi Mercury 3 från Python. Börja med att installera inception-SDK:t och exportera API-nyckeln enligt följande:
!pip install -q inceptionaiImportera sedan paketen som används av demon:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass frågar efter API-nyckeln utan att visa den, os placerar den där SDK:t letar efter den, Path och json laddar case_support.json och serialiserar den till prompten, och time.perf_counter() registrerar när varje svar och förfinringssteg anländer.
difflib jämför på varandra följande diffusionssteg och clear_output() ersätter cellutdata så att uppspelningen sker på plats i stället för att staplas nedåt på sidan.
Om API-nyckeln inte redan är satt kan du be om den interaktivt:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() läser API-nyckeln från miljön. Medan de andra importerna, som time registrerar när förfinringssteg anländer, hjälper difflib till att jämföra intermediär text, och clear_output() låter oss spela upp diffusionsprocessen på plats.
Steg 4: Bygg modellmeddelandena
Supportärendet lagras separat i case_support.json. Ärendefilen innehåller kundmeddelandet, orderinformation, betalningsposter, fullföljandeloggar, supportpolicy och de promptar vi vill använda i detta scenario.
Du kan bygga din egen eller använda den som den är:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Låt oss nu läsa in JSON-filen:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Innan vi skickar den till Mercury 3 separerar vi promptkonfigurationen från bevisningen:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]Nycklarna system_prompt, task_prompt och packet_label styr hur vi instruerar Mercury, så de tas bort från bevisningen innan själva ärendet serialiseras. Vi kan nu förbereda de slutliga meddelandena:
messages = build_messages(case)Det finns inget hämtningssystem eller något externt verktyg inblandat här. Allt Mercury behöver för den här analysen tillhandahålls direkt i begäran.
Steg 5: Gör en begäran till Mercury 3
Innan vi testar strömning gör vi en vanlig icke-strömmande begäran. Följande hjälpfunktion kapslar in Mercury-API-anropet och registrerar svarens metadata:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Låt oss nu definiera ett modellanrop:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}De viktigaste modellsidiga kontrollerna är:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensNu kan vi göra ett baslinjeanrop:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury tar emot det kompletta supportärendet och returnerar den begärda analysen, inklusive den mest sannolika förklaringen, stödjande bevis, alternativa förklaringar, osäkerheter och rekommenderade nästa åtgärder.
Funktionen registrerar också fälten elapsed_s och usage. Det första mäter den end-to-end-tid som begäran tog, medan det andra innehåller tokenredovisning, inklusive rapporterad användning av resonerings-tokens.
I körningarna för denna handledning identifierade Mercury konsekvent den andra betalningsposten som mest sannolikt en reserverad (pending) auktorisering snarare än bevis på en bekräftad andra order. Ärendet saknar dock medvetet tillräcklig information för att veta om den reserverade auktoriseringen så småningom försvinner eller slutligen debiteras.
Steg 6: Lägg till standardströmning
En normal begäran väntar på att Mercury ska bli klar innan det fullständiga svaret returneras. För att ta emot svaret stegvis behöver vi aktivera stream=True. Standardfunktionen för strömning ser ut så här:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Det viktiga beteendet här är chunks.append(content) i standardströmning, där varje del innehåller nästa bit av svaret, så delarna kan ackumuleras och byggas ihop till det slutliga svaret med "".join(chunks).
Obs: Median tid till första synliga utdata var 2,903 sekunder, medan median total latens var 3,375 sekunder.
Steg 7: Växla till diffusionsströmning
Aktivera diffusionsströmning genom att sätta följande parametrar till True:
stream=True
diffusing=TrueAPI-anropet skiljer sig från standardströmning med endast ett extra argument, dvs. diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}Med standardströmning läggs delar till. Med diffusionsströmning representerar däremot den senaste icke-tomma delen den aktuella fullständiga versionen av svaret. Så i stället för att lägga till den ersätter vi det som tidigare visades.
Vi sparar också de returnerade tillstånden för att mäta antalet förfinringssteg och kontrollera om senare tillstånd faktiskt reviderar text som tidigare visats.
Över fem körningar returnerade diffusionsströmning en median på 9 synliga förfinringssteg, med ett intervall på 7–12. Median tid till första synliga tillstånd var 1,896 sekunder och median total latens var 2,560 sekunder.
Steg 8: Jämför standard- och diffusionsströmning
Nu när vi förstår båda kodvägarna kan vi jämföra det uppmätta beteendet.
|
Metric |
Standard |
Diffusion |
|
Median antal delar/tillstånd |
6 |
9 |
|
Intervall |
5–7 |
7–12 |
|
Median första synliga utdata |
2,903 s |
1,896 s |
|
Median total latens |
3,375 s |
2,560 s |
Diffusion hade lägre medianlatens för just den här supportprompten, men intervallen överlappar väsentligt. Vi bör därför inte dra slutsatsen att diffusionsströmning är inneboende snabbare.
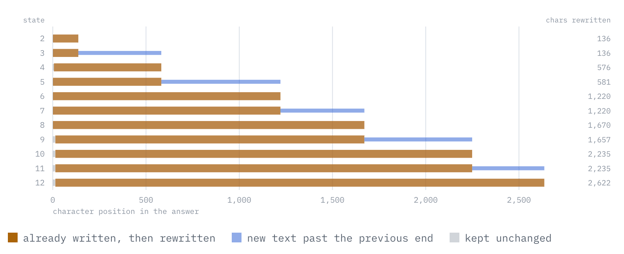
Figur: 12-tillståndskörning, övergång för övergång. Den bruna stapeln är text Mercury 3 redan hade skrivit och sedan ersatt, medan den blå stapeln är den nya texten bortom föregående slut. Ett rent tillägg skulle inte visa någon brun alls.
I mina körningar reviderade de returnerade diffusionsstegen tidigare synlig text i stället för att bete sig som enbart tilläggbara delar. I körningen ovan var ingen av de 11 tillståndsövergångarna ett rent tillägg, och var och en av dem avvek från tillståndet före inom de första 14 tecknen.
Steg 9: Testa slutförandebudgeten
Låt oss nu titta på Mercury 3:s beteende med hur resonerings-tokens samverkar med slutförandebudgeten. De normala anropen ovan använder max_completion_tokens=8192, men för att tydligare visa beteendet behöver vi sänka max_completion_tokens till 1600.
Kör nu samma begäran en gång med låg och en gång med hög resoneringsinsats. Här är det uppmätta resultatet:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneVid hög användes alla 1 539 slutförandetokens som resonerings-tokens. Modellen nådde därför slutförandegränsen innan den returnerade synlig svarstext.
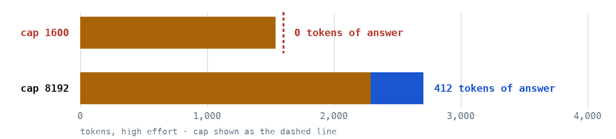
Figur: Hög insats: slutförandebudget vid tak på 1 600 och 8 192 tokens
Vid taket 1 600 gick hela budgeten till resoneringsarbete, och inget fanns kvar att emitera. Vid 8 192 använde mediankörningen med hög insats 2 292 tokens till resonemang och hade ändå utrymme för ett 412-token-svar. Taket 8 192 ligger utanför högerkanten på denna skala, vilket är varför bara den första raden i bilden ovan visar en streckad taklinje.
Den viktiga signalen i den misslyckade höga begäran är response.choices[0].finish_reason, som returnerade length. Det betyder att begäran nådde sin maximala slutförandetokenbudget (max_completion_tokens). Denna budget omfattar både resonerings-tokens och synliga utdata-tokens. I denna körning rapporterade Mercury 3 alla 1 539 slutförandetokens som resonerings-tokens, så begäran nådde slutförandegränsen innan en synlig svarstext producerades.
Obs: För denna demo räckte max_completion_tokens=8192 för de återstående körningarna, men det ska inte betraktas som ett universellt minimum.
Steg 10: Jämför låg och hög resoneringsinsats
Återgå nu till den normala slutförandebudgeten 8192 och variera endast reasoning_effort mellan låg och hög. Vi använder hjälpfunktionen run_nonstream() från steg 5 för att göra en begäran med låg resoneringsinsats och en annan med hög:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)För de rapporterade resultaten upprepade jag varje konfiguration fem gånger i stället för att förlita mig på en enda begäran.
Medianerna var:
|
Metric |
Låg |
Hög |
|
End-to-end-latens |
2,936 s |
8,146 s |
|
Slutförandetokens |
1312 |
2723 |
|
Resonerings-tokens |
828 |
2292 |
|
Approx. synliga tokens |
468 |
412 |
|
Andel resoneringsarbete |
63 % |
84 % |
Mediananvändningen för resonemang ökade från 828 till 2 292 tokens, medan medianlatensen ökade från 2,936 till 8,146 sekunder (eller cirka 2,77x).
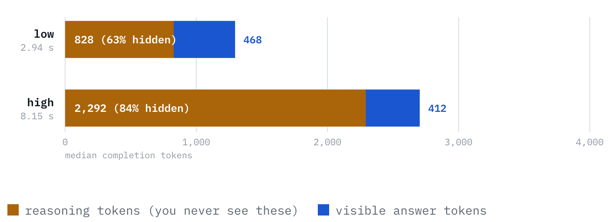
Figur: Vart tar slutförandebudgeten vägen på varje insatsnivå?
Den synliga svarslängden ändrades inte i närheten lika mycket:
- Låg: 468 token i median
- Hög: 412 token i median
och de observerade intervallen överlappade:
- Låg: 393–494
- Hög: 356–469
Så dessa körningar stöder inte påståendet att ökad resoneringsinsats gör det synliga svaret kortare. Latensintervallen visar också varför en körning inte räcker:
- Låg: 1,602–4,993 s
- Hög: 4,102–9,068 s
Obs: Den snabbaste höga begäran var faktiskt snabbare än den långsammaste låga begäran.
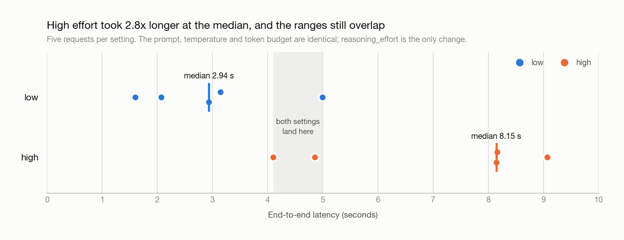
Figur: Alla tio körningar med resoneringsinsats plottade efter latens
Så reasoning_effort="high" ökade avsevärt den rapporterade användningen av resonerings-tokens och latensen i detta experiment, medan längden på det synliga svaret förblev i stort sett likartad.
Avslutande tankar
Det finns tre praktiska beteenden hos Mercury 3:
-
Diffusionsströmning använder ett annat utdata-kontrakt. Standardströmning lägger till ny text, medan diffusionsströmning returnerar successiva fullständiga versionssteg av svaret som ska ersätta det föregående.
-
Resonerings-tokens delar slutförandebudgeten. Ett litet värde för
max_completion_tokenskan förbrukas av resonemang innan Mercury 3 producerar ett synligt svar. -
Högre resoneringsinsats byter till extra beräkning till priset av latens. I mina körningar använde hög avsevärt fler rapporterade resonerings-tokens och tog längre tid, som förväntat, medan längden på det synliga svaret förblev i stort sett likartad.
Dessa resultat kommer från ett litet antal körningar på ett syntetiskt supportärende, så de bör ses som observationer från denna demo snarare än generella prestandapåståenden om Mercury 3.
Mercury 3: Vanliga frågor
Vad är den viktigaste skillnaden mellan standardströmning och diffusionsströmning i Mercury 3?
Med standardströmning anländer svaret som textdelar som läggs till varandra. Med diffusionsströmning exponerar API:et successiva revideringar av det aktuella svaret, så det senaste tillståndet ska ersätta det föregående i stället för att läggas till det.
Ger reasoning_effort="high" alltid ett bättre svar?
Nej. Högre resoneringsinsats ger Mercury mer utrymme för resonemang, men det garanterar inte ett bättre svar för varje uppgift. I den här demon använde hög avsevärt fler resonerings-tokens och tog längre tid, medan längden på det synliga svaret förblev liknande. Den var också mer konsekvent med att lyfta fram en saknad bevisbit, men experimentet var för litet för att göra bredare kvalitetsanspråk.
Varför kan Mercury 3 returnera inget synligt svar när max_completion_tokens är för litet?
Resonerings-tokens räknas mot samma slutförandetokenbudget som det synliga svaret. Om modellen förbrukar merparten eller hela den budgeten under resonemang kan den nå slutförandegränsen innan den producerar synlig utdata. I så fall hjälper det att kontrollera finish_reason och rapporterad resonerings-tokenanvändning för att förklara vad som hände.
Är diffusionsströmning alltid snabbare än standardströmning?
Nej. I denna demo hade diffusionsströmning lägre median tid till första synliga utdata och lägre median total latens, men intervallen överlappade, och en annan prompt gav motsatt ordning. Den mer tillförlitliga skillnaden är strömningsbeteendet, inte en garanterad latensförbättring.
När ska jag använda Mercury 3?
Mercury 3 är särskilt intressant för latenskänsliga applikationer där användare gynnas av snabba svar samtidigt som modellen utför icke-trivialt resonemang. Rätt resoneringsinsats och slutförandebudget beror på uppgiften, så de bör trimmas med hänsyn till både latens och svarskvalitet.
Mercury 3 är en diffusionsbaserad Large Language Model från Inception.ai. Till skillnad från konventionella autoregressiva LLM:er som genererar text en token i taget, använder Mercury diffusion för att iterativt förfina flera delar av sitt svar. Modellen överträffar GPT-6 Luna och Claude Haiku 5.5, samtidigt som den körs 4–8x snabbare i över 1 000 tokens per sekund på NVIDIA-GPU:er och stöder ett kontextfönster på 1M tokens.
I den här handledningen bygger vi en liten assistent för incidentanalys som tar emot applikationsloggar, distributionsinformation, GPU-metrik och begäransspår. Vi använder sedan samma uppgift för att utforska två egenskaper hos Mercury 3:
Hur diffusionsströmning skiljer sig från normal LLM-strömning
Vad som förändras när vi ökar
reasoning_effortfrån låg till hög?Längs vägen stöter vi också på en viktig fråga kring tokenbudget som spelar roll när du använder Mercurys resoneringslägen. I slutet kommer du att veta hur du:
Komplett kod-repo.
Vad är Mercury 3?
Till skillnad från konventionella autoregressiva LLM:er som genererar ett svar strikt från vänster till höger, tillhör Mercury en modellfamilj som iterativt förfinar flera tokenpositioner under generering. Inceptions angreppssätt passar bäst för latenskänsliga arbetslaster som agenter, sök, kundsupport, utbildning och andra applikationer där upprepade modellanrop snabbt kan bli många.
Mercury 3 kombinerar den diffusionsbaserade genereringsprocessen med funktioner man förväntar sig av en allmän API-modell, inklusive långkontextinmatning, styrning av resoneringsnivå, verktygsanrop, strukturerade utdata och OpenAI-kompatibla ändpunkter. Den exponerar också ett strömningsläge med
diffusing=Truesom låter applikationer ta emot modellens intermediära fulltext-förfinringssteg i stället för endast tilläggsbara utdata-block.Vid skrivande stund stöder Mercury 3 följande:
Egenskap
Mercury 3
Kontextfönster
1M tokens
Maximal utdata
131 072 tokens
Resoneringsinsats
instant, low, medium, high
Verktygsanrop
Stöds
Strukturerad utdata
Stöds
Strömning
Stöds
Diffusionsströmning
Stöds
Temperatur
0,5–1,0
API
OpenAI-kompatibelt
Inception listar för närvarande Mercury 3 till ett lanseringspris på $0,10 per miljon inmatade tokens, $0,01 per miljon cachade inmatade tokens och $0,35 per miljon utmatade tokens. De cachade tokens är också 90 % billigare än inmatningspriset.
Mercury 3 är 40x större än Mercury 1 och betydligt smartare, men lika snabb.
Figur: Modellkvalitet vs modellstorlek (Källa)
Hur fungerar Mercury 3?
De flesta LLM:er genererar text autoregressivt från vänster till höger, en token i taget. Så här genererar traditionella LLM:er text:
Varje ny token beror på allt som genererats före den.
Mercury använder i stället diffusion.
Inception beskriver sina diffusions-LLM:er som transformerbaserade modeller som successivt förbättrar en utdata genom att ändra flera tokens parallellt. Tidigare Mercury-forskning beskriver detta som en grov-till-fin genereringsprocess snarare än strikt vänster-till-höger nästa-token-förutsägelse.
En förenklad illustration kan se ut så här: