

Ini hanya contoh konseptual, bukan representasi internal Mercury 3 yang persis.
API Inception dapat mengekspos status perantara ini. Dengan streaming normal, Mercury mengembalikan blok teks yang telah disempurnakan yang dapat ditambahkan ke respons. Dengan diffusing=True, setiap potongan justru berisi versi lengkap jawaban saat ini seiring model menyempurnakannya.
Kita akan melihat perbedaannya sebentar lagi.
Demo: Membangun Asisten Eskalasi Dukungan Real-Time
Sebelum membangun demo, mari pisahkan pengaturan model dari aplikasi dukungan itu sendiri.
Kasus dukungan hanyalah input yang kita gunakan untuk menguji Mercury 3. Kontrol sisi model yang penting adalah anggaran penalaran, anggaran completion, dan mode streaming.
|
Pengaturan |
Nilai yang digunakan |
Mengapa penting |
|
Temperatur |
0,75 |
Ditetapkan tetap agar kita tidak mengubah sampling saat membandingkan mode |
|
Upaya penalaran |
low, high |
Memungkinkan kita membandingkan penggunaan penalaran tersembunyi dan latensi |
|
Anggaran completion |
8192 |
Cukup besar untuk run demo yang diukur |
|
Streaming standar |
stream=True |
Mengembalikan blok teks yang bisa ditambahkan |
|
Streaming difusi |
stream=True, diffusing=True |
Mengembalikan status penyempurnaan teks penuh secara berurutan |
|
Prompt |
Kasus dukungan tetap |
Menjaga tugas tetap konstan saat pengaturan model berubah |
|
Pengulangan |
5 per kondisi |
Menunjukkan variasi antar-run alih-alih mengandalkan satu permintaan |
Ini adalah pengaturan yang bekerja untuk eksperimen ini, bukan pengaturan Mercury 3 yang optimal secara global.
Langkah 1: Prasyarat
Mercury 3 hanya memerlukan beberapa langkah untuk memulai. Untuk mengikuti, Anda memerlukan:
- Kunci API Inception
- Python 3
- Paket inceptionai
- Kasus dukungan yang disimpan sebagai
case_support.json
Mulailah dengan mendaftar ke platform inception dan mendapatkan Kunci API. Klik Get Started dan isi detailnya:
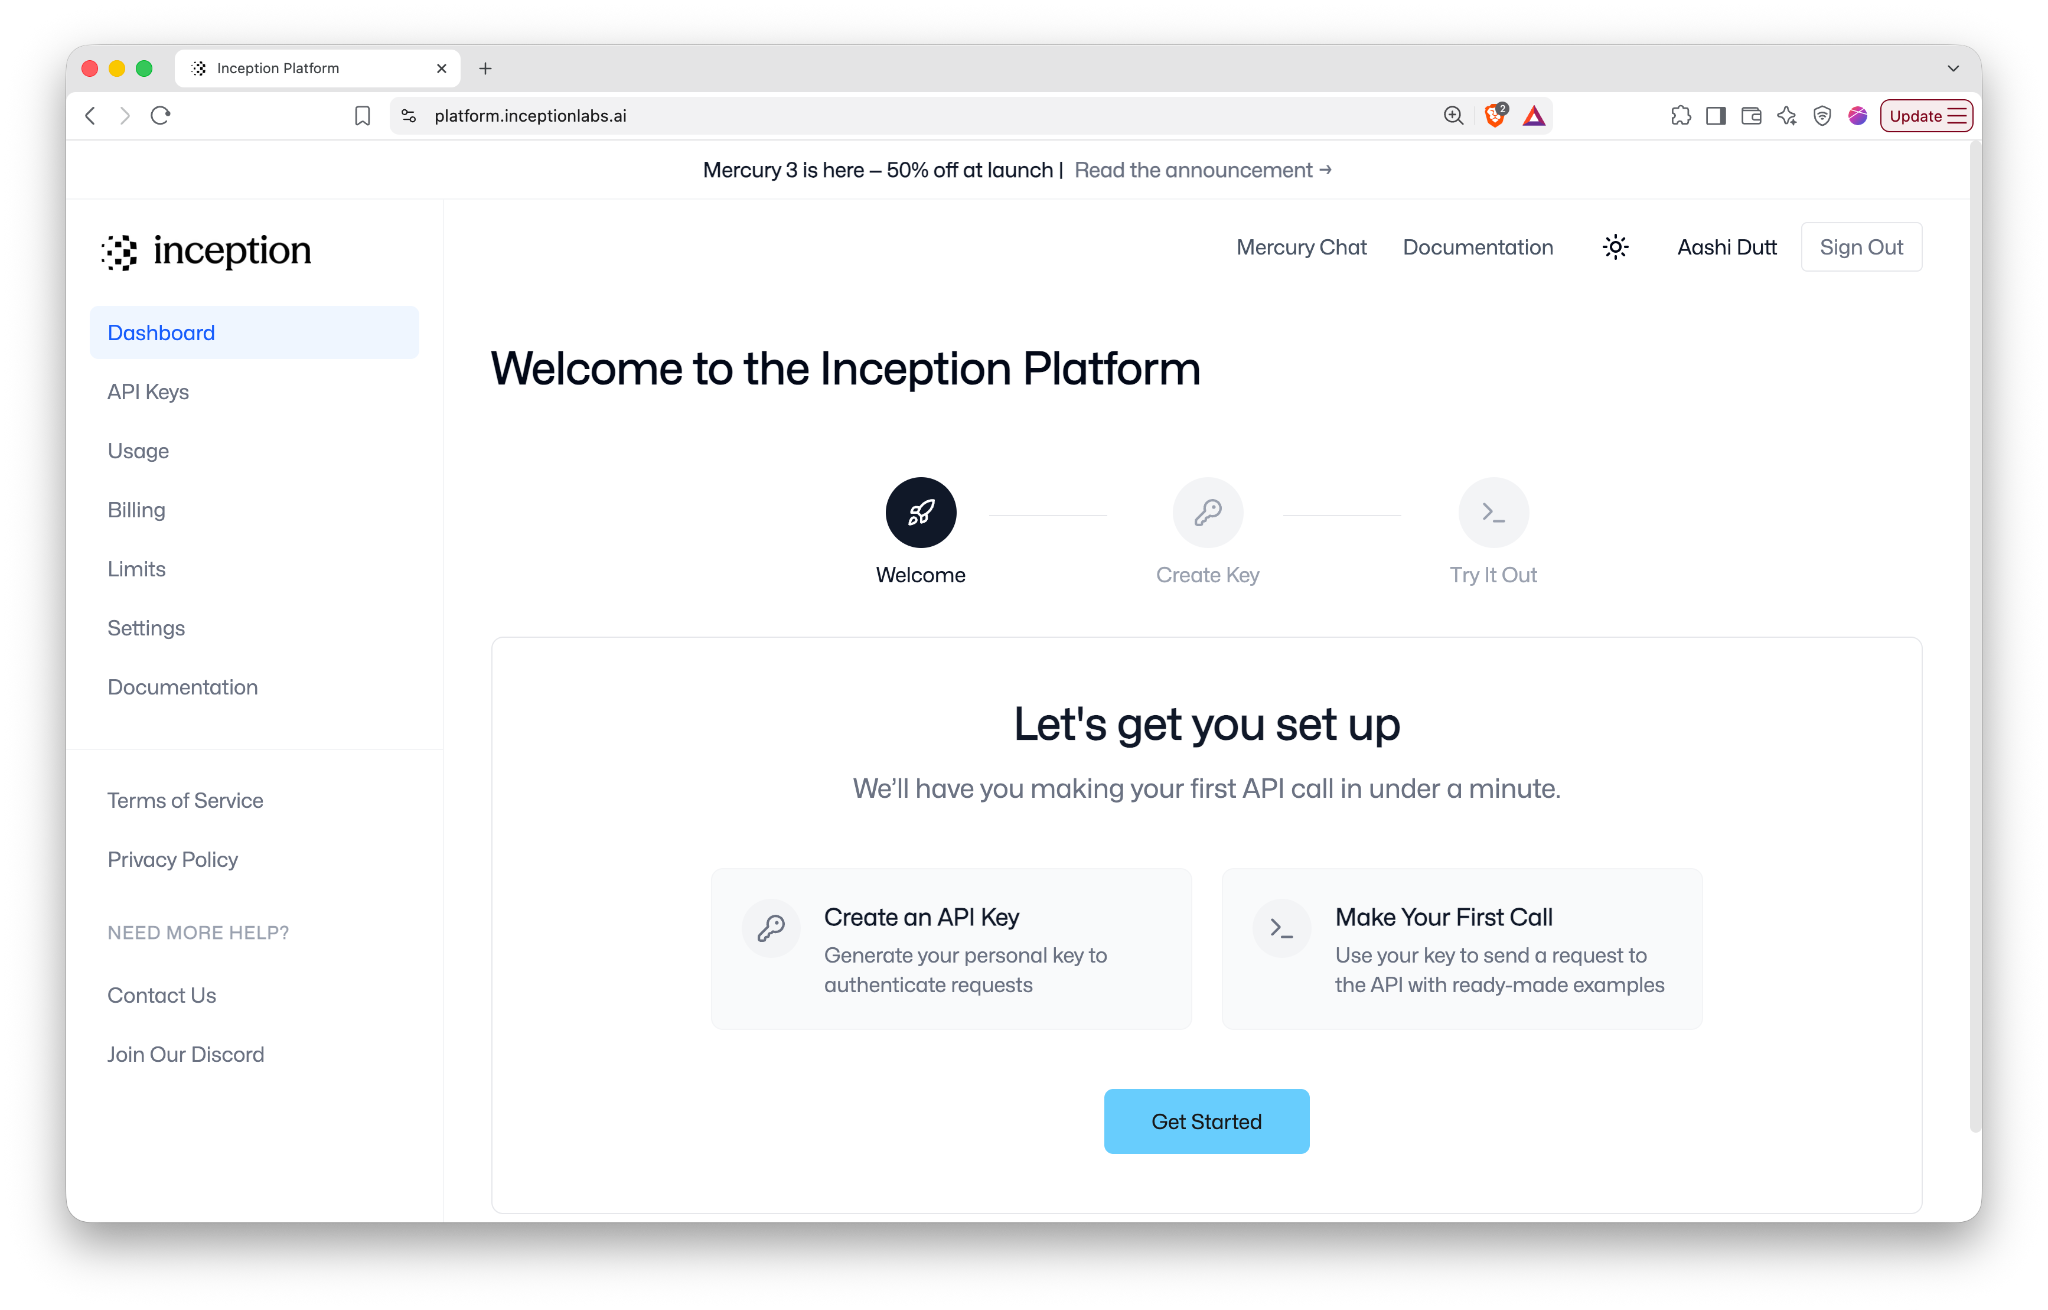
Catatan: Pada saat penulisan, Inception menyediakan 100 juta token gratis untuk akun baru guna mencoba API.
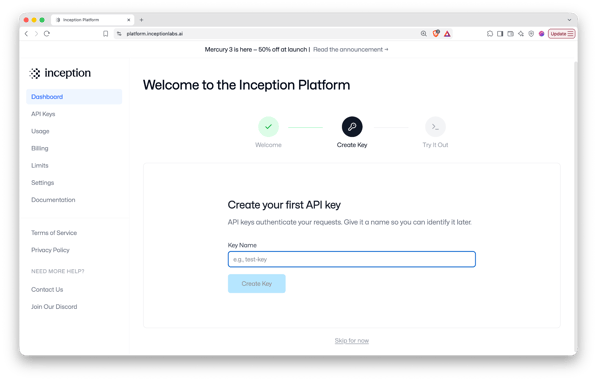
Anda dapat memberi nama Kunci API atau cukup lewati langkah ini dan klik Create Key.
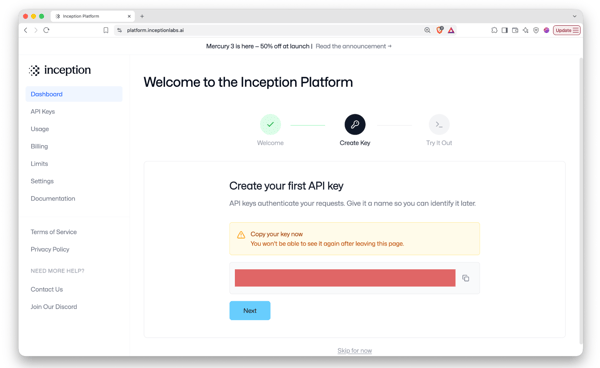
Selanjutnya, salin Kunci API dan lakukan panggilan API pertama Anda.
Langkah 2: Coba Mercury 3
Sebelum menulis kode apa pun, Anda dapat menguji Mercury 3 langsung dari Platform Inception. Setelah membuat kunci API, klik Next dan pilih tombol Run it now pada tab Try It Out.
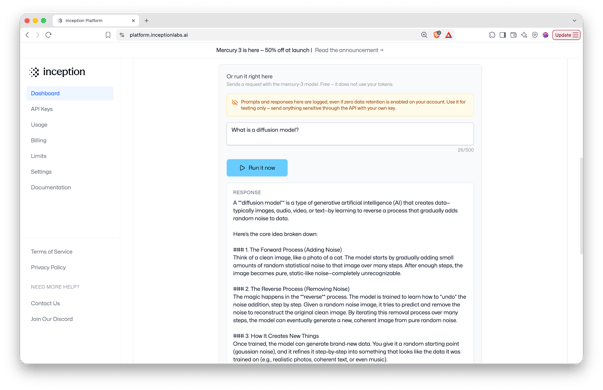
Ini berguna untuk menguji prompt dan pengaturan model dengan cepat sebelum memindahkannya ke dalam aplikasi.
Langkah 3: Siapkan lingkungan dan lakukan panggilan API
Untuk sisa tutorial ini, kita akan memanggil Mercury 3 dari Python. Mulailah dengan memasang SDK inception dan mengekspor kunci API sebagai berikut:
!pip install -q inceptionaiLalu impor paket yang digunakan oleh demo:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass meminta kunci API tanpa menampilkannya, os menempatkannya di lokasi yang dicari SDK, Path dan json memuat case_support.json dan menserialisasikannya ke dalam prompt, dan time.perf_counter() mencatat kapan setiap respons dan status penyempurnaan tiba.
difflib membandingkan status difusi berturutan dan clear_output() menggantikan keluaran sel sehingga pemutaran ulang terjadi di tempat alih-alih menumpuk ke bawah halaman.
Jika kunci API belum disetel, Anda dapat memintanya secara interaktif:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() membaca kunci API dari environment. Sementara impor lain, seperti time mencatat kapan status penyempurnaan tiba, difflib membantu membandingkan teks perantara, dan clear_output() memungkinkan kita memutar ulang proses difusi di tempat.
Langkah 4: Bangun pesan Model
Kasus dukungan disimpan terpisah di case_support.json. Berkas kasus memuat pesan pelanggan, informasi pesanan, catatan pembayaran, log pemenuhan, kebijakan dukungan, dan prompt yang ingin kita gunakan untuk skenario ini.
Anda dapat membangun sendiri atau menggunakannya apa adanya:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}Sekarang, mari muat berkas JSON:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Sebelum mengirimkannya ke Mercury 3, kita pisahkan konfigurasi prompt dari buktinya:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]Kunci system_prompt, task_prompt, dan packet_label mengontrol cara kita memberi instruksi kepada Mercury, sehingga dihapus dari bukti sebelum kasus itu sendiri diserialisasi. Kita sekarang dapat menyiapkan pesan akhir:
messages = build_messages(case)Tidak ada sistem pengambilan atau alat eksternal yang terlibat di sini. Semua yang dibutuhkan Mercury untuk analisis ini disuplai langsung dalam permintaan.
Langkah 5: Lakukan permintaan ke Mercury 3
Sebelum menguji streaming, mari buat permintaan non-streaming normal. Helper berikut membungkus panggilan API Mercury dan mencatat metadata respons:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)Sekarang mari definisikan pemanggilan model:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}Kontrol utama di sisi model adalah:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensKita sekarang dapat membuat panggilan baseline:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury menerima kasus dukungan lengkap dan mengembalikan analisis yang diminta, termasuk penjelasan paling mungkin, bukti pendukung, penjelasan alternatif, ketidakpastian, dan tindakan berikutnya yang direkomendasikan.
Fungsinya juga mencatat kolom elapsed_s dan usage. Yang pertama mengukur waktu permintaan ujung ke ujung, sedangkan yang lainnya mencakup perhitungan token, termasuk penggunaan token penalaran yang dilaporkan.
Di seluruh run yang digunakan untuk tutorial ini, Mercury secara konsisten mengidentifikasi entri pembayaran kedua sebagai otorisasi tertunda yang paling mungkin alih-alih bukti pesanan kedua yang dikonfirmasi. Namun, kasus ini sengaja tidak memiliki informasi yang cukup untuk mengetahui apakah otorisasi tertunda itu pada akhirnya akan menghilang atau terselesaikan.
Langkah 6: Tambahkan streaming standar
Permintaan normal menunggu Mercury selesai sebelum mengembalikan jawaban penuh. Untuk menerima respons secara bertahap, kita perlu mengaktifkan stream=True. Fungsi streaming standar terlihat seperti ini:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}Perilaku penting di sini adalah chunks.append(content) dalam streaming standar, di mana setiap potongan berisi bagian berikutnya dari respons, sehingga potongan dapat diakumulasikan dan direkonstruksi menjadi jawaban akhir dengan "".join(chunks).
Catatan: Median waktu hingga keluaran pertama yang terlihat adalah 2,903 detik, sedangkan median total latensi adalah 3,375 detik.
Langkah 7: Beralih ke Streaming Difusi
Untuk mengaktifkan streaming difusi, setel parameter berikut ke True:
stream=True
diffusing=TruePanggilan API berbeda dari streaming standar hanya dengan satu argumen tambahan, yaitu diffusing=True.
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}Dengan streaming standar, potongan ditambahkan. Namun, dengan streaming difusi, potongan non-kosong terbaru mewakili versi lengkap jawaban saat ini. Jadi alih-alih menambahkannya, kita menggantikan yang sebelumnya ditampilkan.
Kita juga menyimpan status yang dikembalikan untuk mengukur jumlah status penyempurnaan dan memeriksa apakah status selanjutnya benar-benar merevisi teks yang muncul sebelumnya.
Di lima run, streaming difusi mengembalikan median 9 status penyempurnaan yang terlihat, dengan rentang 7–12. Median waktu ke status pertama yang terlihat adalah 1,896 detik, dan median total latensi adalah 2,560 detik.
Langkah 8: Bandingkan Streaming Standar dan Difusi
Sekarang setelah kita memahami kedua jalur kode, kita dapat membandingkan perilaku yang diukur.
|
Metrik |
Standar |
Difusi |
|
Median chunks/states |
6 |
9 |
|
Rentang |
5–7 |
7–12 |
|
Median keluaran pertama terlihat |
2,903 dtk |
1,896 dtk |
|
Median latensi total |
3,375 dtk |
2,560 dtk |
Pada prompt dukungan khusus ini, difusi memiliki median latensi lebih rendah, tetapi rentangnya sangat tumpang tindih. Jadi, kita tidak boleh menyimpulkan bahwa streaming difusi secara inheren lebih cepat.
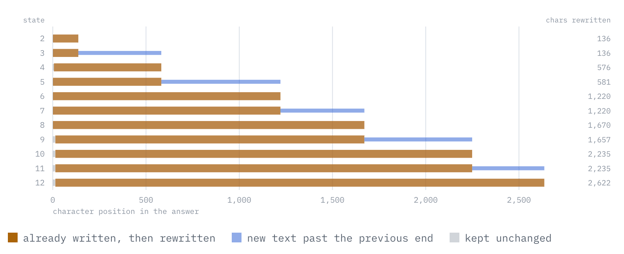
Gambar: Run 12 status, transisi demi transisi. Batang cokelat adalah teks yang sudah ditulis Mercury 3 lalu diganti, sedangkan batang biru adalah teks baru melewati akhir sebelumnya. Append murni tidak akan menampilkan batang cokelat sama sekali.
Dalam run saya, status difusi yang dikembalikan merevisi teks yang sebelumnya terlihat alih-alih berperilaku seperti potongan hanya-tambah. Pada run di atas, tidak satu pun dari 11 transisi status merupakan append murni, dan setiap transisi menyimpang dari status sebelumnya dalam 14 karakter pertama.
Langkah 9: Uji anggaran completion
Selanjutnya, mari lihat perilaku Mercury 3 terkait bagaimana token penalaran berinteraksi dengan anggaran completion. Panggilan normal di atas menggunakan max_completion_tokens=8192, tetapi untuk menonjolkan perilaku lebih jelas, kita perlu mengurangi max_completion_tokens menjadi 1600.
Sekarang, jalankan permintaan yang sama sekali pada upaya penalaran rendah dan sekali pada tinggi. Berikut hasil terukurnya:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: nonePada tingkat tinggi, seluruh 1.539 token completion dilaporkan sebagai token penalaran. Karena itu, model mencapai batas completion sebelum mengembalikan teks jawaban yang terlihat.
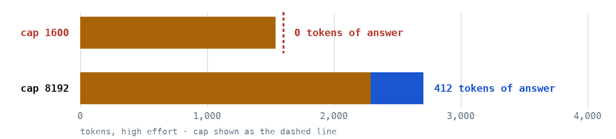
Gambar: Anggaran completion upaya tinggi pada batas 1.600 dan 8.192 token
Pada batas 1.600, seluruh anggaran digunakan untuk penalaran, dan tidak ada yang tersisa untuk dikeluarkan. Pada 8.192, median run upaya tinggi menghabiskan 2.292 token untuk penalaran dan tetap memiliki ruang untuk jawaban 412 token. Batas 8.192 berada di luar tepi kanan skala ini, yang sebabnya hanya baris pertama pada gambar di atas yang menunjukkan garis batas putus-putus.
Sinyal penting dalam permintaan gagal tingkat tinggi adalah response.choices[0].finish_reason, yang mengembalikan length. Ini berarti permintaan mencapai batas maksimum token completion (max_completion_tokens). Anggaran ini mencakup baik token penalaran maupun token keluaran yang terlihat. Pada run ini, Mercury 3 melaporkan semua 1.539 token completion sebagai token penalaran, sehingga permintaan mencapai batas completion sebelum menghasilkan jawaban yang terlihat.
Catatan: Untuk demo ini, max_completion_tokens=8192 sudah cukup untuk run berikutnya, tetapi tidak boleh dianggap sebagai minimum universal.
Langkah 10: Bandingkan Upaya Penalaran Rendah dan Tinggi
Sekarang kembali ke anggaran completion 8192 yang normal dan hanya variasikan reasoning_effort antara rendah dan tinggi. Kita akan menggunakan helper run_nonstream() dari Langkah 5 untuk membuat satu permintaan dengan upaya penalaran rendah dan satu lagi dengan tinggi:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)Untuk hasil yang dilaporkan, saya mengulangi setiap konfigurasi lima kali alih-alih mengandalkan satu permintaan.
Median yang diperoleh:
|
Metrik |
Rendah |
Tinggi |
|
Latensi ujung ke ujung |
2,936 dtk |
8,146 dtk |
|
Token completion |
1312 |
2723 |
|
Token penalaran |
828 |
2292 |
|
Perkiraan token terlihat |
468 |
412 |
|
Porsi penalaran |
63% |
84% |
Median penggunaan penalaran meningkat dari 828 menjadi 2.292 token, sementara median latensi meningkat dari 2,936 menjadi 8,146 detik (sekitar 2,77x).
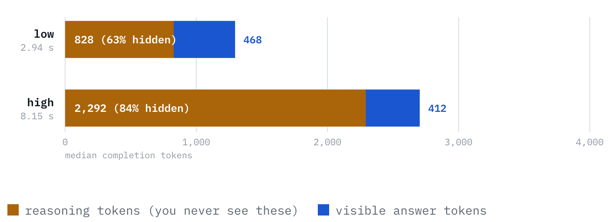
Gambar: Ke mana anggaran completion digunakan pada tiap tingkat upaya?
Panjang jawaban yang terlihat tidak banyak berubah:
- Rendah: median 468 token
- Tinggi: median 412 token
dan rentang yang diamati saling tumpang tindih:
- Rendah: 393–494
- Tinggi: 356–469
Jadi, run ini tidak mendukung klaim bahwa meningkatkan upaya penalaran membuat jawaban yang terlihat menjadi lebih pendek. Rentang latensi juga menunjukkan mengapa satu run saja tidak cukup:
- Rendah: 1,602–4,993 dtk
- Tinggi: 4,102–9,068 dtk
Catatan: Permintaan upaya tinggi tercepat ternyata lebih cepat daripada permintaan upaya rendah terlambat.
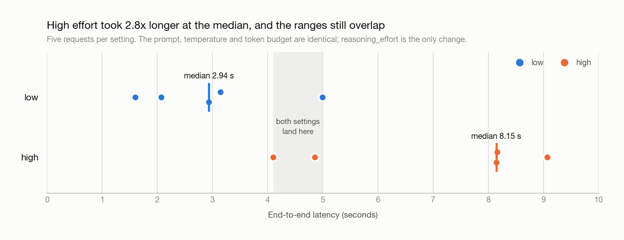
Gambar: Semua sepuluh permintaan upaya penalaran diplot menurut latensi
Jadi, reasoning_effort="high" secara substansial meningkatkan penggunaan token penalaran yang dilaporkan dan latensi dalam eksperimen ini, sementara panjang jawaban yang terlihat tetap secara umum serupa.
Pemikiran Akhir
Ada tiga perilaku praktis Mercury 3:
-
Streaming difusi menggunakan kontrak keluaran yang berbeda. Streaming standar menambahkan teks baru, sedangkan streaming difusi mengembalikan status respons penuh yang berurutan yang harus menggantikan status sebelumnya.
-
Token penalaran berbagi anggaran completion. Nilai
max_completion_tokensyang kecil dapat dihabiskan oleh penalaran sebelum Mercury 3 menghasilkan jawaban yang terlihat. -
Upaya penalaran yang lebih tinggi menukar komputasi tambahan dengan latensi. Dalam run saya, tingkat tinggi menggunakan token penalaran yang jauh lebih banyak dan memakan waktu lebih lama, sebagaimana diharapkan, sementara panjang jawaban yang terlihat tetap secara umum serupa.
Hasil ini berasal dari sejumlah kecil run pada satu kasus dukungan sintetis, jadi hasil ini harus diperlakukan sebagai observasi dari demo ini, bukan klaim kinerja umum tentang Mercury 3.

Saya adalah Google Developers Expert di ML (Gen AI), Kaggle 3x Expert, dan Women Techmakers Ambassador dengan pengalaman lebih dari 3 tahun di bidang teknologi. Saya ikut mendirikan startup health-tech pada 2020 dan sedang menempuh studi magister ilmu komputer di Georgia Tech dengan spesialisasi machine learning.
FAQ Mercury 3
Apa perbedaan utama antara streaming standar dan streaming difusi di Mercury 3?
Dengan streaming standar, respons tiba sebagai potongan teks yang ditambahkan satu sama lain. Dengan streaming difusi, API mengekspos revisi berurutan dari respons saat ini, sehingga status terbaru harus menggantikan yang sebelumnya alih-alih ditambahkan.
Apakah reasoning_effort="high" selalu menghasilkan jawaban yang lebih baik?
Tidak. Upaya penalaran yang lebih tinggi memberi Mercury ruang lebih untuk bernalar, tetapi itu tidak menjamin respons yang lebih baik untuk setiap tugas. Dalam demo ini, tingkat tinggi secara signifikan menggunakan lebih banyak token penalaran dan memakan waktu lebih lama, sementara panjang jawaban yang terlihat tetap serupa. Ini juga lebih konsisten dalam menyoroti satu bukti yang hilang, tetapi eksperimennya terlalu kecil untuk membuat klaim kualitas yang lebih luas.
Mengapa Mercury 3 bisa tidak mengembalikan jawaban yang terlihat saat max_completion_tokens terlalu kecil?
Token penalaran dihitung ke anggaran token completion yang sama dengan jawaban yang terlihat. Jika model menghabiskan sebagian besar atau seluruh anggaran tersebut saat bernalar, model dapat mencapai batas completion sebelum menghasilkan keluaran yang terlihat. Dalam kasus itu, memeriksa finish_reason dan penggunaan token penalaran yang dilaporkan membantu menjelaskan apa yang terjadi.
Apakah streaming difusi selalu lebih cepat daripada streaming standar?
Tidak. Dalam demo ini, streaming difusi memiliki median waktu ke keluaran pertama yang terlihat lebih rendah dan median latensi total lebih rendah, tetapi rentangnya tumpang tindih, dan prompt lain menghasilkan urutan sebaliknya. Perbedaan yang lebih andal adalah perilaku streaming, bukan jaminan peningkatan latensi.
Kapan saya harus menggunakan Mercury 3?
Mercury 3 sangat menarik untuk aplikasi yang sensitif terhadap latensi di mana pengguna mendapat manfaat dari respons cepat sementara model tetap melakukan penalaran yang tidak sepele. Tingkat upaya penalaran dan anggaran completion yang tepat bergantung pada tugas, sehingga harus disetel dengan mempertimbangkan baik latensi maupun kualitas jawaban.




Mercury 3 adalah Large Language Model berbasis difusi dari Inception.ai. Berbeda dengan LLM autoregresif konvensional yang menghasilkan teks satu token demi satu, Mercury menggunakan difusi untuk menyempurnakan beberapa bagian responsnya secara iteratif. Model ini melampaui GPT-6 Luna dan Claude Haiku 5.5, sekaligus berjalan 4–8x lebih cepat pada 1.000+ token per detik di GPU NVIDIA dan mendukung jendela konteks 1 juta token.
Dalam tutorial ini, kita akan membangun asisten analisis insiden kecil yang menerima log aplikasi, informasi deployment, metrik GPU, dan jejak permintaan. Lalu kita gunakan tugas yang sama untuk mengeksplorasi dua sifat Mercury 3:
Bagaimana streaming difusi berbeda dari streaming LLM normal
Apa yang berubah saat kita meningkatkan
reasoning_effortdari rendah ke tinggi?Sepanjang proses, kita juga akan menjumpai isu penting terkait anggaran token yang berpengaruh saat menggunakan mode penalaran Mercury. Pada akhirnya, Anda akan tahu cara:
Kode lengkap repository.
Apa Itu Mercury 3?
Tidak seperti LLM autoregresif konvensional yang menghasilkan respons ketat dari kiri ke kanan, Mercury termasuk keluarga model yang menyempurnakan beberapa posisi token selama generasi secara iteratif. Pendekatan Inception ini paling cocok untuk beban kerja sensitif latensi seperti agen, pencarian, dukungan pelanggan, pendidikan, dan aplikasi lain di mana pemanggilan model berulang dapat cepat terakumulasi.
Mercury 3 menggabungkan proses generasi berbasis difusi tersebut dengan kapabilitas yang diharapkan dari model API tujuan umum, termasuk input konteks panjang, kontrol penalaran, pemanggilan alat, keluaran terstruktur, dan endpoint yang kompatibel dengan OpenAI. Model ini juga menyediakan mode streaming
diffusing=Trueyang memungkinkan aplikasi menerima status penyempurnaan teks penuh perantara alih-alih hanya blok keluaran yang dapat ditambahkan saja.Pada saat penulisan, Mercury 3 mendukung hal-hal berikut:
Properti
Mercury 3
Jendela konteks
1M token
Keluaran maksimum
131.072 token
Upaya penalaran
instant, low, medium, high
Pemanggilan alat
Didukung
Keluaran terstruktur
Didukung
Streaming
Didukung
Streaming difusi
Didukung
Temperatur
0,5–1,0
API
Kompatibel dengan OpenAI
Inception saat ini mencantumkan Mercury 3 dengan harga peluncuran $0,10 per satu juta token input, $0,01 per satu juta token input yang di-cache, dan $0,35 per satu juta token output. Token yang di-cache juga mendapat diskon 90% dari harga input.
Mercury 3 berukuran 40x lebih besar dari Mercury 1 dan jauh lebih cerdas, namun tetap sama cepatnya.
Gambar: Kualitas Model vs Ukuran Model(Sumber)
Bagaimana Cara Kerja Mercury 3?
Kebanyakan LLM menghasilkan teks secara autoregresif dari kiri ke kanan, satu token demi satu. Berikut cara LLM tradisional menghasilkan teks:
Setiap token baru bergantung pada semua yang dihasilkan sebelumnya.
Mercury menggunakan difusi sebagai gantinya.
Inception mendeskripsikan LLM difusinya sebagai model berbasis Transformer yang secara progresif meningkatkan keluaran dengan memodifikasi banyak token secara paralel. Riset Mercury sebelumnya menggambarkannya sebagai proses generasi dari kasar ke halus alih-alih prediksi token berikutnya yang ketat dari kiri ke kanan.
Ilustrasi yang disederhanakan mungkin terlihat seperti ini: