

यह केवल एक वैचारिक उदाहरण है, Mercury 3 का सटीक आंतरिक प्रतिनिधित्व नहीं।
Inception का API इन इंटरमीडिएट स्टेट्स को एक्सपोज़ कर सकता है। सामान्य स्ट्रीमिंग में, Mercury परिष्कृत टेक्स्ट के ब्लॉक्स लौटाता है जिन्हें उत्तर में जोड़ा जा सकता है। diffusing=True के साथ, प्रत्येक चंक में मॉडल के परिष्करण के साथ उत्तर का वह समय का संपूर्ण वर्तमान संस्करण होता है।
हम अंतर को जल्द ही देखेंगे।
डेमो: रियल-टाइम सपोर्ट एस्केलेशन असिस्टेंट बनाना
डेमो बनाने से पहले, आइए मॉडल सेटिंग्स को स्वयं सपोर्ट एप्लिकेशन से अलग करते हैं।
सपोर्ट केस केवल वह इनपुट है जिसका हम Mercury 3 को अभ्यास कराने के लिए उपयोग करते हैं। महत्वपूर्ण मॉडल-पक्ष नियंत्रण हैं रीज़निंग बजट, कम्प्लीशन बजट और स्ट्रीमिंग मोड।
|
सेटिंग |
प्रयुक्त मान |
क्यों मायने रखता है |
|
टेम्परेचर |
0.75 |
मोड्स की तुलना करते समय सैंपलिंग न बदले इसलिए स्थिर रखा |
|
रीज़निंग प्रयास |
low, high |
हिडन रीज़निंग उपयोग और लेटेंसी की तुलना करने देता है |
|
कम्प्लीशन बजट |
8192 |
मापा गए डेमो रन के लिए पर्याप्त बड़ा |
|
स्टैंडर्ड स्ट्रीमिंग |
stream=True |
ऐपेंड किए जा सकने वाले टेक्स्ट ब्लॉक्स लौटती है |
|
डिफ्यूजन स्ट्रीमिंग |
stream=True, diffusing=True |
क्रमिक फुल-टेक्स्ट परिष्करण अवस्थाएँ लौटती है |
|
प्रॉम्प्ट |
फिक्स्ड सपोर्ट केस |
मॉडल सेटिंग बदलते समय टास्क को स्थिर रखता है |
|
दोहराव |
प्रति कंडीशन 5 |
केवल एक रिक्वेस्ट पर निर्भर होने के बजाय रन-टू-रन विविधता दिखाता है |
ये इस प्रयोग के लिए वर्किंग सेटिंग्स हैं, Mercury 3 के लिए सार्वभौमिक रूप से सर्वोत्तम सेटिंग्स नहीं।
चरण 1: आवश्यकताएँ
Mercury 3 शुरू करने के लिए कुछ ही कदम लेता है। साथ चलने के लिए, आपको चाहिए:
- एक Inception API कुंजी
- Python 3
- inceptionai पैकेज
case_support.jsonके रूप में सहेजा हुआ सपोर्ट केस
शुरुआत करें inception प्लेटफ़ॉर्म पर साइन अप करके और API कुंजी प्राप्त करके। Get Started पर क्लिक करें और विवरण भरें:
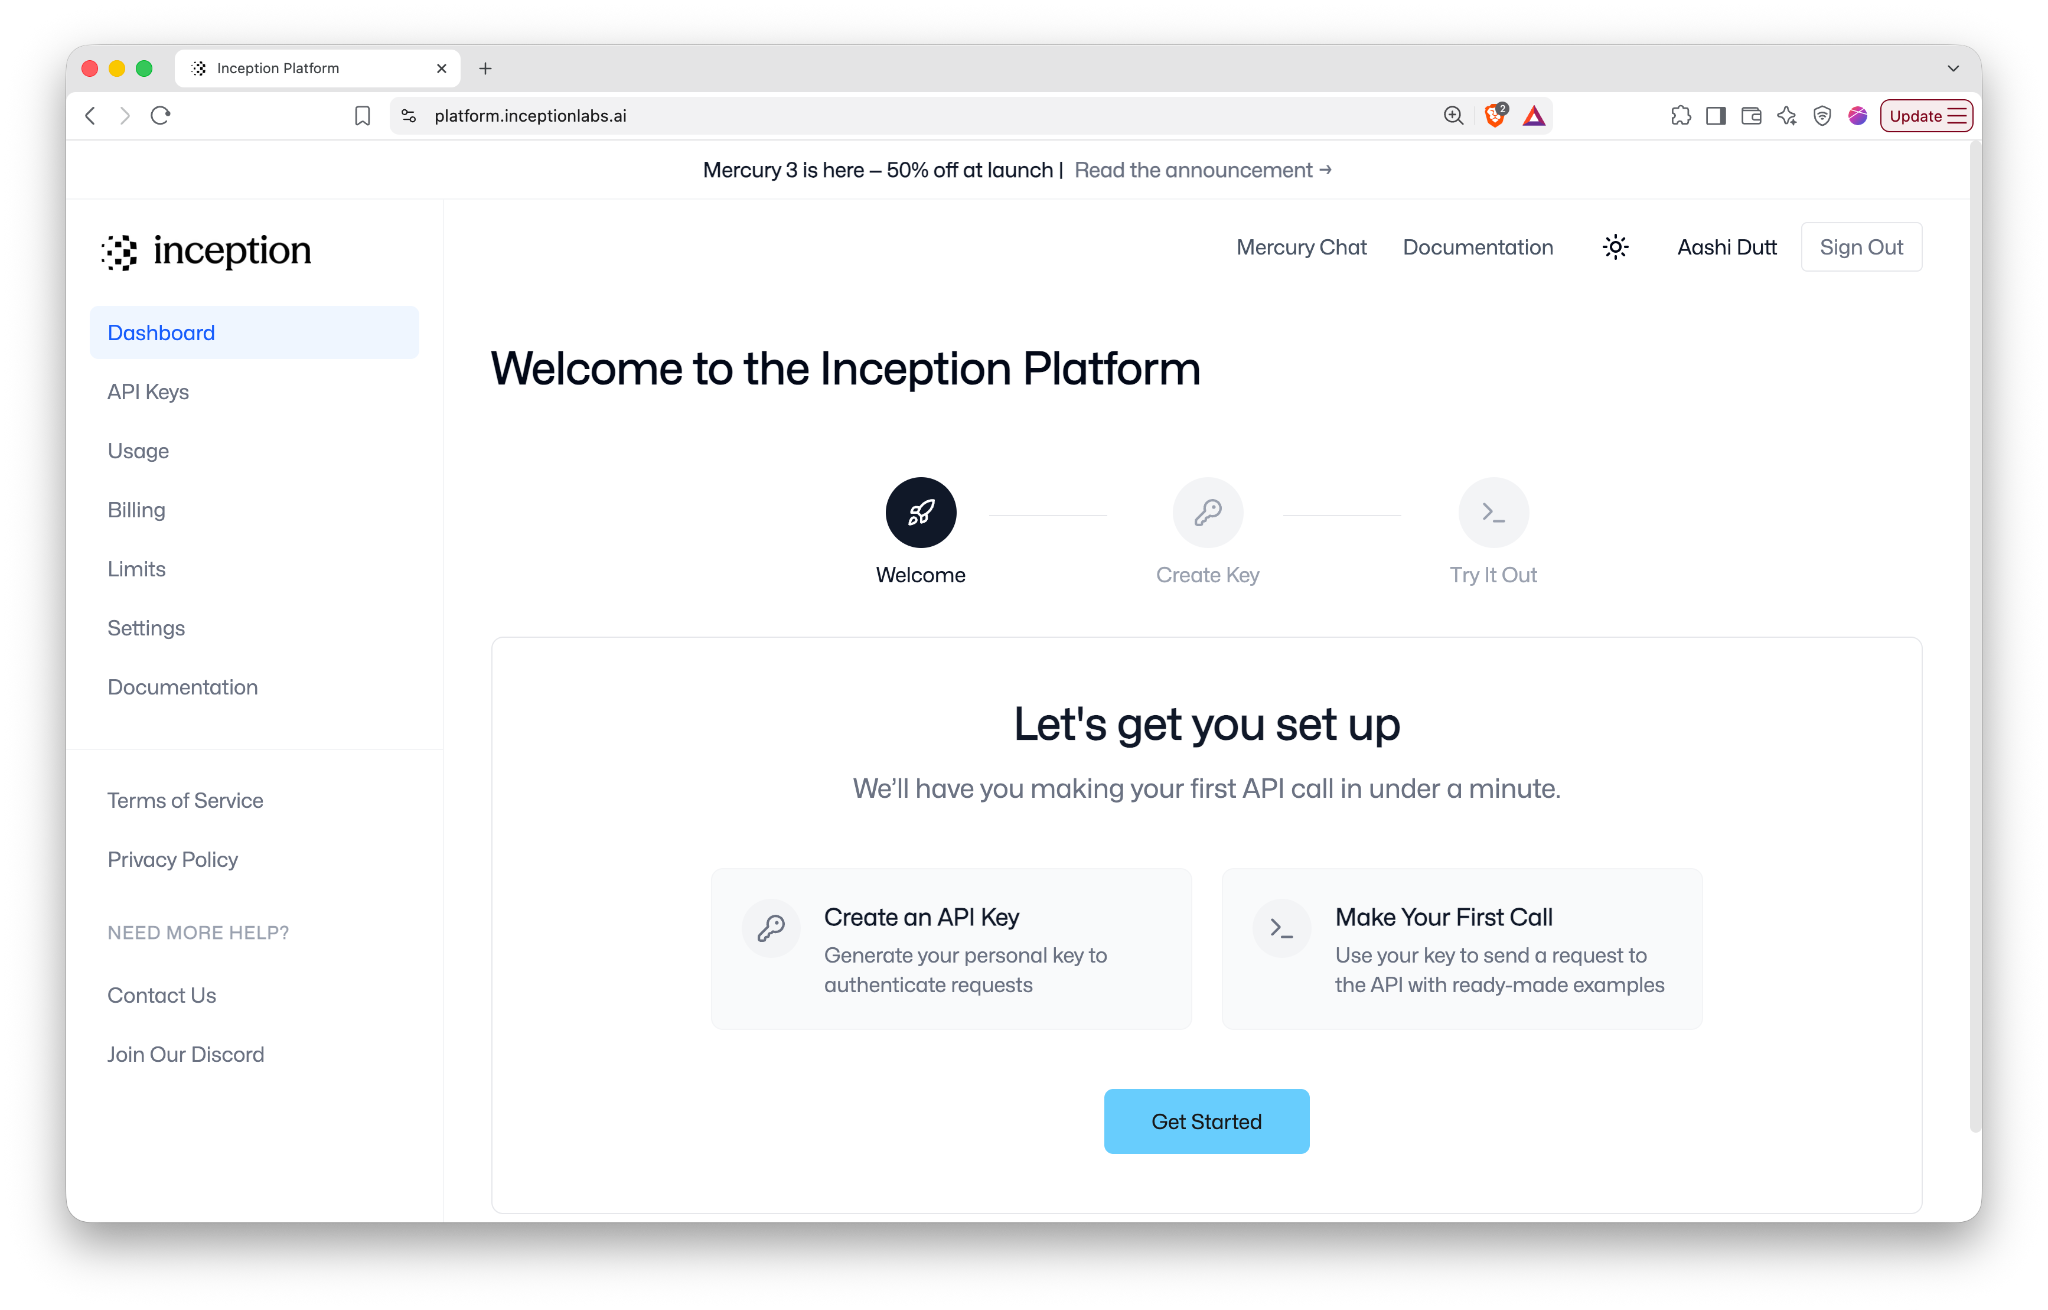
नोट: लिखते समय, Inception नए खातों को API आज़माने के लिए 100 मिलियन मुफ्त टोकन प्रदान करता है।
आप अपनी API कुंजी का नाम रख सकते हैं या बस इस चरण को छोड़कर Create Key पर क्लिक करें।
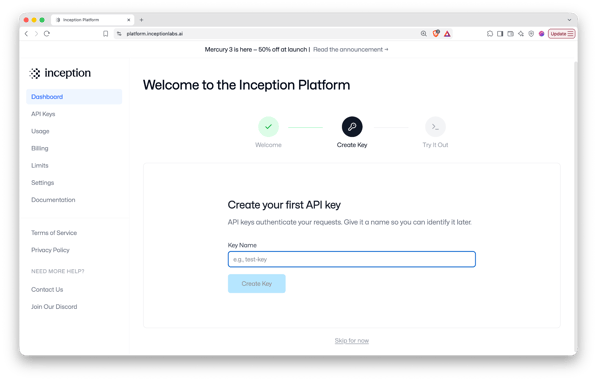
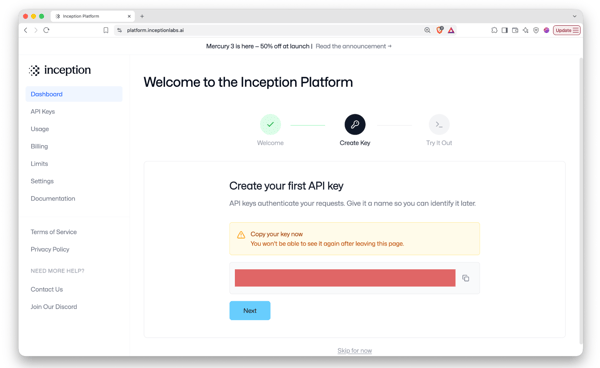
अगला, API कुंजी कॉपी करें और अपनी पहली API कॉल करें।
चरण 2: Mercury 3 आज़माएँ
कोई कोड लिखने से पहले, आप सीधे Inception प्लेटफ़ॉर्म से Mercury 3 का परीक्षण कर सकते हैं। API कुंजी बनाने के बाद, Next पर क्लिक करें और Try It Out टैब पर Run it now बटन चुनें।
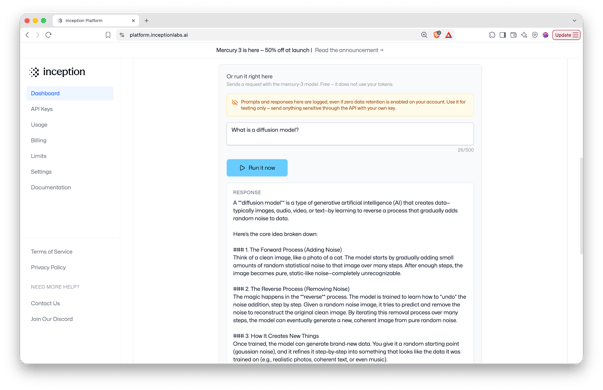
यह प्रॉम्प्ट्स और मॉडल सेटिंग्स को किसी एप्लिकेशन में ले जाने से पहले तेजी से टेस्ट करने के लिए उपयोगी है।
चरण 3: वातावरण तैयार करें और एक API कॉल करें
शेष ट्यूटोरियल के लिए, हम Python से Mercury 3 को कॉल करेंगे। शुरुआत करें Inception SDK इंस्टॉल करके और API कुंजी को इस प्रकार एक्सपोर्ट करके:
!pip install -q inceptionaiफिर डेमो द्वारा उपयोग किए गए पैकेज इम्पोर्ट करें:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass API कुंजी को इको किए बिना पूछता है, os इसे वहाँ रखता है जहाँ SDK इसे ढूंढता है, Path और json case_support.json लोड करते हैं और इसे प्रॉम्प्ट में सीरियलाइज़ करते हैं, और time.perf_counter() रिकॉर्ड करता है कि प्रत्येक प्रतिक्रिया और परिष्करण अवस्था कब आती है।
difflib क्रमिक डिफ्यूजन स्टेट्स की तुलना करता है और clear_output() सेल आउटपुट को बदल देता है ताकि रिप्ले पेज पर नीचे स्टैक होने के बजाय उसी जगह हो।
यदि API कुंजी पहले से सेट नहीं है, तो आप इसे इंटरैक्टिव रूप से पूछ सकते हैं:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() पर्यावरण से API कुंजी पढ़ता है। जबकि अन्य इम्पोर्ट्स, जैसे time परिष्करण अवस्थाएँ कब आती हैं यह रिकॉर्ड करता है, difflib इंटरमीडिएट टेक्स्ट की तुलना में मदद करता है, और clear_output() हमें डिफ्यूजन प्रक्रिया को उसी जगह रिप्ले करने देता है।
चरण 4: मॉडल संदेश बनाएं
सपोर्ट केस अलग से case_support.json में संग्रहीत है। केस फ़ाइल में ग्राहक संदेश, ऑर्डर जानकारी, भुगतान रिकॉर्ड, फुलफ़िलमेंट लॉग, सपोर्ट नीति और इस परिदृश्य के लिए उपयोग किए जाने वाले प्रॉम्प्ट्स शामिल हैं।
आप अपना खुद का बना सकते हैं या इसे ऐसे ही उपयोग कर सकते हैं:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}अब, JSON फ़ाइल लोड करें:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")इसे Mercury 3 को भेजने से पहले, हम प्रॉम्प्ट कॉन्फ़िगरेशन को साक्ष्य से अलग करते हैं:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]कुंजियाँ system_prompt, task_prompt, और packet_label नियंत्रित करती हैं कि हम Mercury को कैसे निर्देश देते हैं, इसलिए उन्हें साक्ष्य से हटा दिया जाता है, इससे पहले कि केस को स्वयं सीरियलाइज़ किया जाए। अब हम अंतिम संदेश तैयार कर सकते हैं:
messages = build_messages(case)यहाँ कोई रिट्रीवल सिस्टम या बाहरी टूल शामिल नहीं है। इस विश्लेषण के लिए Mercury को आवश्यक हर चीज सीधे रिक्वेस्ट में दी गई है।
चरण 5: Mercury 3 को रिक्वेस्ट करें
स्ट्रीमिंग का परीक्षण करने से पहले, एक सामान्य नॉन-स्ट्रीमिंग रिक्वेस्ट बनाते हैं। निम्नलिखित हेल्पर Mercury API कॉल को रैप करता है और प्रतिक्रिया मेटाडेटा रिकॉर्ड करता है:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)अब एक मॉडल कॉल परिभाषित करते हैं:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}मुख्य मॉडल-पक्ष नियंत्रण हैं:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensअब हम एक बेसलाइन कॉल कर सकते हैं:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury को पूरा सपोर्ट केस प्राप्त होता है और अनुरोधित विश्लेषण लौटाता है, जिसमें सबसे संभावित व्याख्या, सहायक साक्ष्य, वैकल्पिक व्याख्याएँ, अनिश्चितता और अनुशंसित अगले कदम शामिल हैं।
यह फ़ंक्शन elapsed_s और usage फ़ील्ड भी रिकॉर्ड करता है। पहला एंड-टू-एंड रिक्वेस्ट समय मापता है, जबकि दूसरा टोकन अकाउंटिंग, जिसमें क्रमशः रिपोर्टेड रीज़निंग-टोकन उपयोग शामिल है।
इस ट्यूटोरियल के लिए उपयोग किए गए रन में, Mercury ने लगातार दूसरी भुगतान एंट्री को एक लंबित ऑथराइज़ेशन माना, न कि किसी पुष्टि किए गए दूसरे ऑर्डर का साक्ष्य। हालांकि, केस में जानबूझकर पर्याप्त जानकारी की कमी है, जिससे यह पता नहीं चलता कि वह लंबित ऑथराइज़ेशन अंततः गायब होगा या सेटल होगा।
चरण 6: स्टैंडर्ड स्ट्रीमिंग जोड़ें
एक सामान्य रिक्वेस्ट Mercury के समाप्त होने की प्रतीक्षा करता है और फिर पूरा उत्तर देता है। उत्तर को क्रमशः प्राप्त करने के लिए, हमें stream=True सक्षम करना होगा। स्टैंडर्ड स्ट्रीमिंग फ़ंक्शन इस तरह दिखता है:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}यहाँ महत्वपूर्ण व्यवहार chunks.append(content) है स्टैंडर्ड स्ट्रीमिंग में, जहाँ प्रत्येक चंक उत्तर के अगले हिस्से को रखता है, इसलिए चंक्स को जोड़ा जा सकता है और "".join(chunks) से अंतिम उत्तर में पुनर्निर्मित किया जा सकता है।
नोट: मीडियन समय पहले दृश्य आउटपुट तक 2.903 सेकंड था, जबकि मीडियन कुल लेटेंसी 3.375 सेकंड थी।
चरण 7: डिफ्यूजन स्ट्रीमिंग पर स्विच करें
डिफ्यूजन स्ट्रीमिंग सक्षम करने के लिए, निम्न पैरामीटर्स को True पर सेट करें:
stream=True
diffusing=TrueAPI कॉल स्टैंडर्ड स्ट्रीमिंग से केवल एक अतिरिक्त आर्गुमेंट में भिन्न है, यानी diffusing=True।
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}स्टैंडर्ड स्ट्रीमिंग में, चंक्स अपेंड होते हैं। जबकि, डिफ्यूजन स्ट्रीमिंग में, नवीनतम नॉन-एम्प्टी चंक उत्तर के वर्तमान पूर्ण संस्करण का प्रतिनिधित्व करता है। इसलिए इसे जोड़ने के बजाय, हम पहले प्रदर्शित चीज़ को बदलते हैं।
हम लौटाए गए स्टेट्स को भी रखते हैं ताकि परिष्करण अवस्थाओं की संख्या मापी जा सके और यह जाँचा जा सके कि बाद की अवस्थाएँ वास्तव में पहले दिखाई दिए टेक्स्ट को संशोधित करती हैं या नहीं।
पाँच रनों में, डिफ्यूजन स्ट्रीमिंग ने 9 दृश्यमान परिष्करण अवस्थाओं का मीडियन लौटाया, रेंज 7–12 रही। पहले दृश्यमान स्टेट तक का मीडियन समय 1.896 सेकंड था, और कुल मीडियन लेटेंसी 2.560 सेकंड थी।
चरण 8: स्टैंडर्ड और डिफ्यूजन स्ट्रीमिंग की तुलना
अब जब हम दोनों कोड पाथ समझते हैं, तो हम मापे गए व्यवहार की तुलना कर सकते हैं।
|
मेट्रिक |
स्टैंडर्ड |
डिफ्यूजन |
|
मीडियन चंक्स/स्टेट्स |
6 |
9 |
|
रेंज |
5–7 |
7–12 |
|
मीडियन पहला दृश्य आउटपुट |
2.903 s |
1.896 s |
|
मीडियन कुल लेटेंसी |
3.375 s |
2.560 s |
इस विशेष सपोर्ट प्रॉम्प्ट के लिए डिफ्यूजन में मीडियन लेटेंसी कम थी, लेकिन रेंज काफी हद तक ओवरलैप होती है। इसलिए, हमें यह निष्कर्ष नहीं निकालना चाहिए कि डिफ्यूजन स्ट्रीमिंग स्वभावतः तेज़ है।
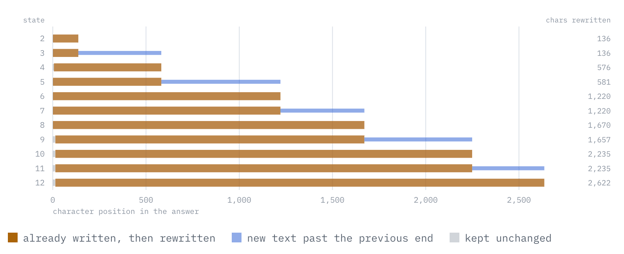
चित्र: 12-स्टेट रन, ट्रांज़िशन दर ट्रांज़िशन। भूरे रंग की पट्टी वह टेक्स्ट है जिसे Mercury 3 ने पहले लिखा था और फिर बदल दिया, जबकि नीली पट्टी पिछले अंत से आगे का नया टेक्स्ट है। एक शुद्ध अपेंड में बिल्कुल भी भूरा नहीं दिखेगा।
मेरे रनों में, लौटाए गए डिफ्यूजन स्टेट्स ने पहले से दृश्यमान टेक्स्ट को संशोधित किया, न कि अपेंड-ओनली चंक्स जैसा व्यवहार किया। ऊपर के रन में, 11 में से कोई भी स्टेट ट्रांज़िशन शुद्ध अपेंड नहीं था, और हर एक अपने पहले वाले स्टेट से पहले 14 अक्षरों के भीतर भिन्न हो गया।
चरण 9: कम्प्लीशन बजट का परीक्षण करें
अगला, देखते हैं कि Mercury 3 का व्यवहार कैसा होता है जब रीज़निंग टोकन कम्प्लीशन बजट के साथ इंटरैक्ट करते हैं। ऊपर की सामान्य कॉल्स max_completion_tokens=8192 का उपयोग करती हैं, लेकिन व्यवहार को और स्पष्ट रूप से दिखाने के लिए हमें max_completion_tokens को 1600 तक घटाना होगा।
अब, वही रिक्वेस्ट एक बार लो और एक बार हाई रीज़निंग प्रयास पर चलाएँ। यहाँ मापा गया परिणाम है:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: noneहाई पर, सभी 1,539 कम्प्लीशन टोकन रीज़निंग टोकन के रूप में रिपोर्ट हुए। इसलिए, मॉडल ने दृश्य उत्तर टेक्स्ट लौटाने से पहले कम्प्लीशन सीमा तक पहुँच बना ली।
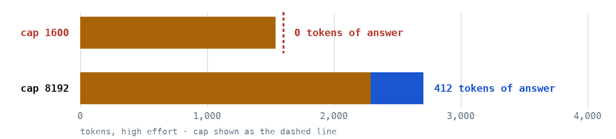
चित्र: 1,600 और 8,192 टोकन कैप पर हाई-एफ़र्ट कम्प्लीशन बजट
1,600 कैप पर, पूरा बजट रीज़निंग में चला गया और इमिट करने के लिए कुछ नहीं बचा। 8,192 पर, मीडियन हाई-एफ़र्ट रन ने 2,292 टोकन रीज़निंग में लगाए और फिर भी 412-टोकन के उत्तर के लिए जगह बची। 8,192 कैप इस स्केल के दाएँ किनारे के बाहर बैठता है, इसलिए ऊपर की छवि में केवल पहली पंक्ति एक डैश्ड कैप लाइन दिखाती है।
फेल हुई हाई रिक्वेस्ट में महत्वपूर्ण संकेत है response.choices[0].finish_reason, जिसने length लौटाया। इसका मतलब है कि रिक्वेस्ट अपने अधिकतम कम्प्लीशन-टोकन बजट (max_completion_tokens) तक पहुँच गई। यह बजट रीज़निंग टोकन्स और दृश्य आउटपुट टोकन्स दोनों को शामिल करता है। इस रन में, Mercury 3 ने सभी 1,539 कम्प्लीशन टोकन्स को रीज़निंग टोकन्स के रूप में रिपोर्ट किया, इसलिए रिक्वेस्ट ने दृश्य उत्तर बनाने से पहले कम्प्लीशन सीमा तक पहुँच बना ली।
नोट: इस डेमो के लिए, शेष रनों में max_completion_tokens=8192 पर्याप्त था, लेकिन इसे सार्वभौमिक न्यूनतम नहीं माना जाना चाहिए।
चरण 10: लो और हाई रीज़निंग प्रयास की तुलना
अब सामान्य 8192 कम्प्लीशन बजट पर लौटें और केवल reasoning_effort को लो और हाई के बीच बदलें। हम चरण 5 के run_nonstream() हेल्पर का उपयोग करेंगे—एक रिक्वेस्ट लो रीज़निंग प्रयास के साथ और दूसरी हाई के साथ:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)रिपोर्ट किए गए परिणामों के लिए, मैंने एक ही रिक्वेस्ट पर निर्भर होने के बजाय प्रत्येक कॉन्फ़िगरेशन को पाँच बार दोहराया।
मीडियन्स थे:
|
मेट्रिक |
लो |
हाई |
|
एंड-टू-एंड लेटेंसी |
2.936 s |
8.146 s |
|
कम्प्लीशन टोकन |
1312 |
2723 |
|
रीज़निंग टोकन |
828 |
2292 |
|
अनुमानित दृश्य टोकन |
468 |
412 |
|
रीज़निंग हिस्सा |
63% |
84% |
मीडियन रीज़निंग उपयोग 828 से 2,292 टोकन तक बढ़ा, जबकि मीडियन लेटेंसी 2.936 से 8.146 सेकंड (लगभग 2.77x) तक बढ़ी।
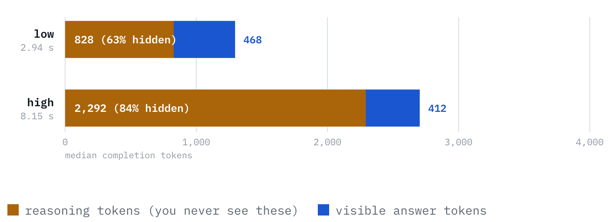
चित्र: प्रत्येक प्रयास स्तर पर कम्प्लीशन बजट कहाँ जाता है?
दृश्य उत्तर की लंबाई में उतना बदलाव नहीं आया:
- लो: 468-टोकन मीडियन
- हाई: 412-टोकन मीडियन
और देखी गई रेंज ओवरलैप हुई:
- लो: 393–494
- हाई: 356–469
तो, ये रन इस दावे का समर्थन नहीं करते कि रीज़निंग प्रयास बढ़ाने से दृश्य उत्तर छोटा हो जाता है। लेटेंसी रेंज भी दिखाती है कि एक रन पर्याप्त नहीं है:
- लो: 1.602–4.993 s
- हाई: 4.102–9.068 s
नोट: सबसे तेज़ हाई रिक्वेस्ट वास्तव में सबसे धीमी लो रिक्वेस्ट से भी तेज़ थी।
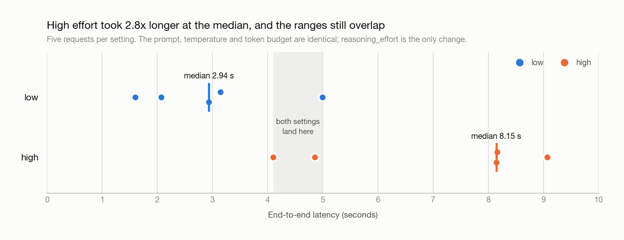
चित्र: सभी दस रीज़निंग-एफ़र्ट रिक्वेस्ट्स लेटेंसी के अनुसार प्लॉट किए गए
तो, reasoning_effort="high" ने इस प्रयोग में रिपोर्टेड रीज़निंग-टोकन उपयोग और लेटेंसी को काफी बढ़ा दिया, जबकि दृश्य उत्तर की लंबाई व्यापक रूप से समान रही।
अंतिम विचार
Mercury 3 के तीन व्यावहारिक व्यवहार हैं:
-
डिफ्यूजन स्ट्रीमिंग एक अलग आउटपुट कॉन्ट्रैक्ट का उपयोग करती है. स्टैंडर्ड स्ट्रीमिंग नया टेक्स्ट अपेंड करती है, जबकि डिफ्यूजन स्ट्रीमिंग क्रमिक पूर्ण-उत्तर स्टेट्स लौटाती है जिन्हें पिछले वाले को बदलना चाहिए।
-
रीज़निंग टोकन कम्प्लीशन बजट साझा करते हैं। एक छोटा
max_completion_tokensमान Mercury 3 द्वारा दृश्य उत्तर देने से पहले ही रीज़निंग में समाप्त हो सकता है। -
उच्च रीज़निंग प्रयास अतिरिक्त गणना को लेटेंसी के बदले में देता है। मेरे रनों में, हाई ने काफी अधिक रिपोर्टेड रीज़निंग टोकन उपयोग किए और अपेक्षित रूप से अधिक समय लिया, जबकि दृश्य उत्तर की लंबाई व्यापक रूप से समान रही।
ये परिणाम एक सिंथेटिक सपोर्ट केस पर थोड़े से रनों से आए हैं, इसलिए इन्हें इस डेमो से अवलोकन के रूप में माना जाना चाहिए, न कि Mercury 3 के बारे में सामान्य प्रदर्शन दावों के रूप में।

मैं एमएल (Gen AI) में Google Developers Expert, Kaggle 3x Expert, और Women Techmakers एंबेसडर हूँ, तथा तकनीक क्षेत्र में 3+ वर्षों का अनुभव रखती हूँ। मैंने 2020 में एक हेल्थ-टेक स्टार्टअप की सह-स्थापना की और वर्तमान में Georgia Tech से कंप्यूटर विज्ञान में मास्टर कर रही हूँ, जिसमें मेरा विशेषज्ञता क्षेत्र मशीन लर्निंग है।
Mercury 3 FAQs
Mercury 3 में स्टैंडर्ड स्ट्रीमिंग और डिफ्यूजन स्ट्रीमिंग के बीच मुख्य अंतर क्या है?
स्टैंडर्ड स्ट्रीमिंग में, प्रतिक्रिया टेक्स्ट चंक्स के रूप में आती है जो एक-दूसरे में जोड़ी जाती हैं। डिफ्यूजन स्ट्रीमिंग में, API वर्तमान उत्तर के क्रमिक संशोधन एक्सपोज़ करता है, इसलिए नवीनतम स्टेट को पिछले वाले में जोड़े जाने के बजाय उसे बदल देना चाहिए।
क्या reasoning_effort="high" हमेशा बेहतर उत्तर देता है?
नहीं। उच्च रीज़निंग प्रयास Mercury को रीज़निंग के लिए अधिक जगह देता है, लेकिन यह हर टास्क के लिए बेहतर उत्तर की गारंटी नहीं देता। इस डेमो में, हाई यूज़र ने काफी अधिक रीज़निंग टोकन उपयोग किए और अधिक समय लिया, जबकि दृश्य उत्तर की लंबाई समान रही। यह एक गायब साक्ष्य को सतह पर लाने में अधिक सुसंगत भी था, लेकिन प्रयोग व्यापक गुणवत्ता दावों के लिए बहुत छोटा था।
जब max_completion_tokens बहुत छोटा हो तो Mercury 3 दृश्य उत्तर क्यों नहीं लौटा सकता?
रीज़निंग टोकन उसी कम्प्लीशन-टोकन बजट में गिने जाते हैं जिसमें दृश्य उत्तर गिना जाता है। यदि मॉडल उस बजट का अधिकांश या सारा हिस्सा रीज़निंग में खर्च कर देता है, तो वह दृश्य आउटपुट बनाने से पहले ही कम्प्लीशन सीमा तक पहुँच सकता है। ऐसे में, finish_reason और रिपोर्टेड रीज़निंग-टोकन उपयोग की जाँच करने से समझ आता है कि क्या हुआ।
क्या डिफ्यूजन स्ट्रीमिंग हमेशा स्टैंडर्ड स्ट्रीमिंग से तेज़ होती है?
नहीं। इस डेमो में, डिफ्यूजन स्ट्रीमिंग में पहले दृश्य आउटपुट तक का मीडियन समय और कुल मीडियन लेटेंसी कम थी, लेकिन रेंज ओवरलैप हुई, और दूसरे प्रॉम्प्ट ने उल्टा क्रम दिया। अधिक विश्वसनीय अंतर स्ट्रीमिंग व्यवहार है, न कि गारंटीड लेटेंसी सुधार।
मुझे Mercury 3 कब उपयोग करना चाहिए?
Mercury 3 विशेष रूप से लैटेंसी-संवेदी एप्लिकेशंस के लिए दिलचस्प है जहाँ उपयोगकर्ताओं को तेज़ प्रतिक्रियाओं से लाभ मिलता है जबकि मॉडल अब भी गैर-तुच्छ रीज़निंग करता है। सही रीज़निंग प्रयास और कम्प्लीशन बजट टास्क पर निर्भर करते हैं, इसलिए उन्हें लेटेंसी और उत्तर गुणवत्ता दोनों के विरुद्ध ट्यून किया जाना चाहिए।
Mercury 3 Inception.ai का एक डिफ्यूजन Large Language Model है। पारंपरिक ऑटोरेग्रेसिव LLMs जो एक समय में एक-एक टोकन जनरेट करते हैं, उनसे अलग, Mercury अपने उत्तर के कई हिस्सों को क्रमिक रूप से परिष्कृत करने के लिए डिफ्यूजन का उपयोग करता है। यह मॉडल GPT-6 Luna और Claude Haiku 5.5 से बेहतर प्रदर्शन करता है, जबकि NVIDIA GPUs पर 1,000+ टोकन प्रति सेकंड की दर से 4–8x तेज़ चलता है और 1M टोकन के कॉन्टेक्स्ट विंडो को सपोर्ट करता है।
इस ट्यूटोरियल में, हम एक छोटा इन्सिडेंट-विश्लेषण असिस्टेंट बनाएंगे जो एप्लीकेशन लॉग्स, डिप्लॉयमेंट जानकारी, GPU मेट्रिक्स, और रिक्वेस्ट ट्रेसेज़ प्राप्त करता है। इसके बाद, हम इसी टास्क का उपयोग करके Mercury 3 की दो विशेषताओं का पता लगाएंगे:
डिफ्यूजन स्ट्रीमिंग सामान्य LLM स्ट्रीमिंग से कैसे भिन्न है
जब हम
reasoning_effortको कम से उच्च करते हैं तो क्या बदलता है?रास्ते में, हम एक महत्वपूर्ण टोकन-बजट मुद्दे से भी गुजरेंगे जो Mercury के रीज़निंग मोड्स का उपयोग करते समय मायने रखता है। अंत तक, आप जान जाएंगे कि कैसे:
पूरा कोड रिपॉजिटरी।
Mercury 3 क्या है?
पारंपरिक ऑटोरेग्रेसिव LLMs जो बाएँ से दाएँ क्रम से उत्तर जनरेट करते हैं, उनसे अलग Mercury उन मॉडलों के परिवार से है जो जनरेशन के दौरान कई टोकन स्थानों को क्रमिक रूप से परिष्कृत करते हैं। Inception का दृष्टिकोण एजेंट्स, सर्च, कस्टमर सपोर्ट, शिक्षा और अन्य ऐसे लैटेंसी-संवेदी वर्कलोड्स के लिए सर्वश्रेष्ठ है जहाँ बार-बार मॉडल कॉल्स जल्दी जुड़ सकते हैं।
Mercury 3 इस डिफ्यूजन-आधारित जनरेशन प्रक्रिया को एक जनरल-पर्पज़ API मॉडल से अपेक्षित क्षमताओं के साथ जोड़ता है, जिसमें लांग-कॉन्टेक्स्ट इनपुट, रीज़निंग कंट्रोल्स, टूल कॉलिंग, स्ट्रक्चर्ड आउटपुट्स और OpenAI-कम्पैटिबल एंडपॉइंट्स शामिल हैं। यह
diffusing=Trueस्ट्रीमिंग मोड भी प्रदान करता है जो एप्लिकेशंस को केवल अपेंड-ओनली आउटपुट ब्लॉक्स की जगह मॉडल के इंटरमीडिएट फुल-टेक्स्ट परिष्करण स्टेट्स प्राप्त करने देता है।लिखते समय, Mercury 3 निम्नलिखित को सपोर्ट करता है:
गुण
Mercury 3
कॉन्टेक्स्ट विंडो
1M टोकन
अधिकतम आउटपुट
131,072 टोकन
रीज़निंग प्रयास
instant, low, medium, high
टूल कॉलिंग
समर्थित
स्ट्रक्चर्ड आउटपुट
समर्थित
स्ट्रीमिंग
समर्थित
डिफ्यूजन स्ट्रीमिंग
समर्थित
टेम्परेचर
0.5–1.0
API
OpenAI-कम्पैटिबल
Inception फिलहाल Mercury 3 की लॉन्च कीमत $0.10 प्रति मिलियन इनपुट टोकन, $0.01 प्रति मिलियन कैश्ड इनपुट टोकन, और $0.35 प्रति मिलियन आउटपुट टोकन सूचीबद्ध करता है। कैश्ड टोकन भी इनपुट कीमत से 90% कम हैं।
Mercury 3, Mercury 1 से 40x बड़ा है और बहुत अधिक बुद्धिमान है, लेकिन उतना ही तेज़ है।
चित्र: मॉडल गुणवत्ता बनाम मॉडल आकार (स्रोत)
Mercury 3 कैसे काम करता है?
अधिकांश LLMs बाएँ से दाएँ, एक समय में एक टोकन, ऑटोरेग्रेसिव ढंग से टेक्स्ट जनरेट करते हैं। पारंपरिक LLMs इस तरह टेक्स्ट जनरेट करते हैं:
हर नया टोकन उससे पहले जनरेट हुई सभी चीज़ों पर निर्भर करता है।
Mercury इसके बजाय डिफ्यूजन का उपयोग करता है।
Inception अपने डिफ्यूजन LLMs को ट्रांसफॉर्मर-आधारित मॉडल के रूप में वर्णित करता है जो समानांतर में कई टोकनों को संशोधित करके आउटपुट को क्रमशः बेहतर बनाते हैं। पहले के Mercury शोध इसे कच्चे-से-सूक्ष्म (coarse-to-fine) जनरेशन प्रक्रिया के रूप में वर्णित करते हैं, न कि सख्ती से बाएँ-से-दाएँ नेक्स्ट-टोकन प्रेडिक्शन के रूप में।
एक सरलीकृत चित्रण कुछ ऐसा दिख सकता है: