

これは概念的な例に過ぎず、Mercury 3 の厳密な内部表現ではありません。
Inception の API はこれらの中間状態を公開できます。通常のストリーミングでは、Mercury は応答に追記できる洗練済みテキストのブロックを返します。diffusing=True の場合、各チャンクには、モデルが洗練を進める現在の回答の完全版が含まれます。
違いはすぐに確認できます。
デモ: リアルタイムのサポートエスカレーションアシスタントを構築する
デモを作る前に、モデル設定とサポートアプリケーション本体を分けて考えましょう。
サポートケースは、Mercury 3 を試すために使う入力にすぎません。重要なモデル側のコントロールは、推論予算、完了予算、ストリーミングモードです。
|
設定 |
使用値 |
重要な理由 |
|
温度 |
0.75 |
モード比較中にサンプリングを変えないよう固定 |
|
Reasoning effort |
low, high |
隠れた推論使用量とレイテンシを比較できる |
|
完了予算 |
8192 |
計測したデモ実行に十分な大きさ |
|
標準ストリーミング |
stream=True |
追記可能なテキストブロックを返す |
|
拡散ストリーミング |
stream=True, diffusing=True |
連続する全文リファインメント状態を返す |
|
プロンプト |
固定のサポートケース |
モデル設定を変えてもタスクを一定に保つ |
|
繰り返し回数 |
各条件で 5 回 |
単一リクエストに頼らず実行間のばらつきを示す |
これは本実験の作業用設定であり、Mercury 3 にとってのグローバル最適設定ではありません。
ステップ 1: 前提条件
Mercury 3 の開始は数ステップで済みます。以下が必要です:
- Inception の API キー
- Python 3
- inceptionai パッケージ
case_support.jsonとして保存したサポートケース
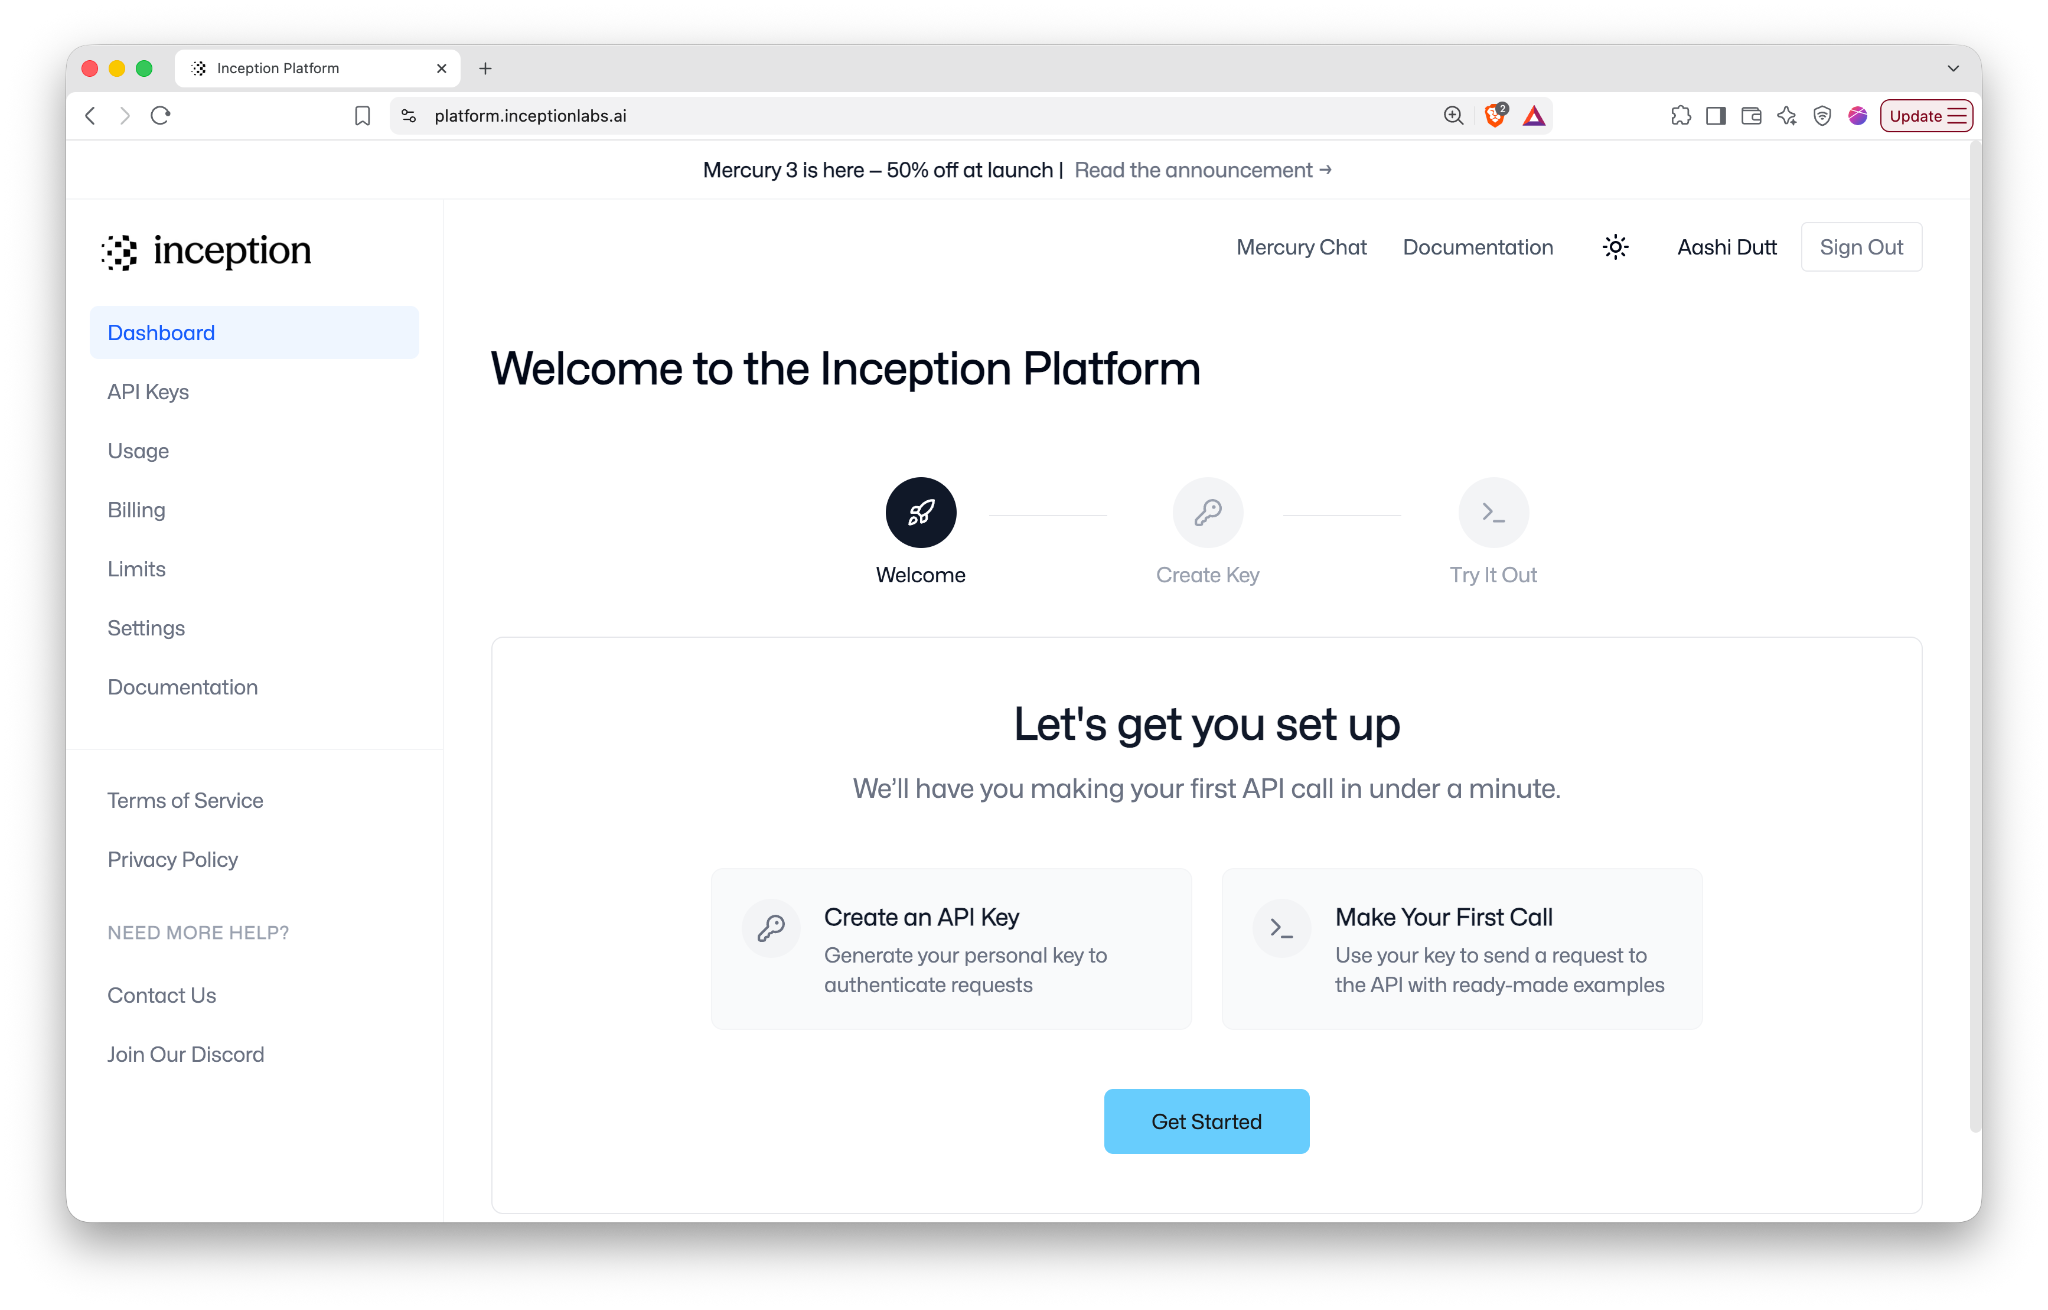
まず inception プラットフォーム にサインアップして API キーを取得します。 Get Started をクリックし、詳細を入力します。
注意: 執筆時点で、Inception は新規アカウントに対し API を試用できる 1 億トークンの無料枠 を提供しています。
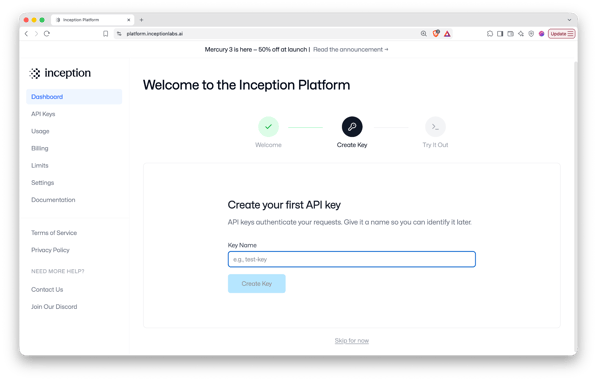
API キーに名前を付けてもよいですし、この手順をスキップして Create Key をクリックしてもかまいません。
次に API キーをコピーし、最初の API 呼び出しを行います。
ステップ 2: Mercury 3 を試す
コードを書く前に、Inception プラットフォームから直接 Mercury 3 をテストできます。API キー作成後、Next をクリックし、Try It Out タブの Run it now ボタンを選びます。
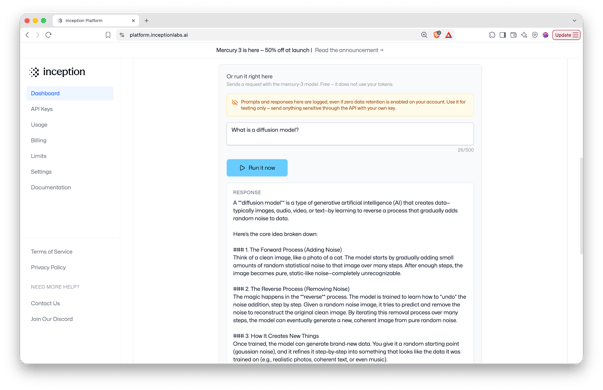
プロンプトやモデル設定をアプリケーションに移す前に素早くテストするのに便利です。
ステップ 3: 環境を準備して API を呼び出す
この先のチュートリアルでは、Python から Mercury 3 を呼び出します。まず inception SDK をインストールし、次のように API キーをエクスポートします:
!pip install -q inceptionai次にデモで使用するパッケージをインポートします:
import getpass, json, os, time, difflib
from pathlib import Path
from inceptionai import Inception
from IPython.display import clear_outputgetpass はエコーなしで API キーを尋ね、os は SDK が参照する場所に設定します。Path と json は case_support.json を読み込みプロンプトにシリアライズし、time.perf_counter() は各応答とリファインメント状態の到着時刻を記録します。
difflib は連続する拡散状態を比較し、clear_output() はセル出力を置き換えて、ページ下に積み重ねるのではなくその場でリプレイできるようにします。
API キーが未設定の場合は、対話的に取得できます:
if not os.environ.get("INCEPTION_API_KEY"):
os.environ["INCEPTION_API_KEY"] = getpass.getpass(
"Inception API key: "
)
client = Inception()
MODEL = "mercury-3"
print("ready")Inception() は環境から API キーを読み込みます。他のインポートについては、time がリファインメント状態の到着時刻を記録し、difflib が中間テキストの比較を助け、clear_output() により拡散プロセスをその場でリプレイできます。
ステップ 4: モデルのメッセージを構築する
サポートケースは case_support.json に別途保存されています。ケースファイルには、顧客メッセージ、注文情報、支払い記録、フルフィルメントログ、サポートポリシー、このシナリオで使うプロンプトが含まれています。
自作しても、そのまま使ってもかまいません:
{
"scenario": "Customer reports two charges for one order",
"system_prompt": "You are a customer-support escalation assistant.\nUse only the evidence in the supplied case file.\nSeparate what the evidence shows from what you infer.\nDo not state that a refund has been issued unless the case file says so.\nIf the evidence is insufficient to decide, say so explicitly.",
"task_prompt": "Analyze this customer-support case.\n\nReturn:\n1. The most likely explanation.\n2. Three pieces of evidence from the case file that support it.\n3. Two alternative explanations, and what is still uncertain.\n4. The next three actions for the agent, in priority order.\n\nKeep the answer concise. Write it so the customer could read it.",
"packet_label": "CASE FILE",
"customer_message": "I ordered one pair of headphones yesterday evening and my card now shows two charges of $129 each. I have one confirmation email and one tracking number. I only pressed buy once. Please refund the second charge today, I cannot afford to be out $258.",
"order": {
"order_id": "ORD-1048",
"placed_at": "2026-10-28T19:41:08Z",
"status": "shipped",
"shipped_at": "2026-10-29T08:12:00Z",
"item": "wireless headphones",
"quantity": 1,
"amount_usd": 129,
"orders_on_account_that_day": 1
},
"payment_records": [
{
"entry": 1,
"at": "2026-10-28T19:41:11Z",
"amount_usd": 129,
"status": "completed",
"authorization_code": "A7X41K",
"card_last_four": "4417"
},
{
"entry": 2,
"at": "2026-10-28T19:42:45Z",
"amount_usd": 129,
"status": "pending",
"authorization_code": "B2M09T",
"card_last_four": "4417"
}
],
"fulfillment_log": [
"19:41:12 reserved 1 unit for ORD-1048",
"19:42:47 reserved 1 unit (no order id attached)",
"19:58:30 released 1 unreserved unit back to stock",
"08:12:00 shipped 1 unit against ORD-1048, one tracking number issued"
],
"customer_history": [
{
"date": "2026-10-07",
"contact_reason": "reported two charges for one order",
"outcome": "both charges settled; agent issued a refund for one of them"
},
{
"date": "2026-06-19",
"contact_reason": "delivery address change",
"outcome": "resolved, no payment involved"
}
],
"support_policy": [
"A pending card authorization can appear on a customer statement as a second charge.",
"A pending authorization that is never captured usually disappears within 3-5 business days.",
"Escalate to the payments team if both charges settle.",
"Agents may not issue a refund against an authorization that has not settled.",
"Tell the customer what you have confirmed and what you have not."
],
"available_agent_actions": [
"explain the pending authorization to the customer",
"set a follow-up for a named number of business days",
"escalate to the payments team",
"issue a refund for a settled charge",
"request the authorization expiry date from the payment processor"
]
}では、JSON ファイルを読み込みます:
def load_incident(path: str) -> dict:
return json.loads(Path(path).read_text())
case = load_incident("case_support.json")Mercury 3 に送る前に、プロンプトの設定と証拠を分けます:
PROMPT_KEYS = (
"system_prompt",
"task_prompt",
"packet_label",
)
def build_messages(case: dict):
system = case.get("system_prompt", SYSTEM)
task = case.get("task_prompt", TASK)
label = case.get(
"packet_label",
"INCIDENT PACKET",
)
evidence = {
k: v
for k, v in case.items()
if k not in PROMPT_KEYS
}
packet = json.dumps(evidence, indent=2)
return [
{
"role": "system",
"content": system,
},
{
"role": "user",
"content": (
f"{task}\n\n"
f"{label}:\n{packet}"
),
},
]system_prompt、task_prompt、packet_label の各キーは Mercury への指示方法を制御するため、ケース本体をシリアライズする前に証拠から取り除かれます。これで最終メッセージを用意できます:
messages = build_messages(case)ここでは検索システムや外部ツールは使いません。この分析に必要なものはすべてリクエスト内で直接提供します。
ステップ 5: Mercury 3 にリクエストを送る
ストリーミングを試す前に、通常の非ストリーミングリクエストを行いましょう。次のヘルパーは Mercury の API 呼び出しを包み、応答メタデータを記録します:
def usage_dict(response) -> dict:
usage = getattr(response, "usage", None)
if usage is None:
return {}
if hasattr(usage, "model_dump"):
return usage.model_dump()
return dict(usage)ではモデル呼び出しを定義します:
def run_nonstream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
response = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
)
elapsed = time.perf_counter() - start
choice = response.choices[0]
text = choice.message.content or ""
usage = usage_dict(response)
return {
"effort": effort,
"elapsed_s": elapsed,
"finish_reason": choice.finish_reason,
"usage": usage,
"text": text,
}主なモデル側コントロールは次のとおりです:
reasoning_effort=effort
temperature=0.75
max_completion_tokens=max_tokensこれでベースラインの呼び出しができます:
result = run_nonstream(
client,
messages,
effort="low",
max_tokens=8192,
)
print(result["text"])Mercury は完全なサポートケースを受け取り、最もあり得る説明、裏付けとなる証拠、代替説明と不確実な点、推奨される次のアクションを含む要求された分析を返します。
この関数は elapsed_s と usage フィールドも記録します。前者はエンドツーエンドのリクエスト時間を測定し、後者は報告された推論トークン使用量を含むトークン計上を示します。
このチュートリアルで使用した複数回の実行において、Mercury は一貫して、2 番目の支払いエントリを確定した 2 回目の注文の証拠ではなく保留中のオーソリと特定しました。ただし、このケースは、保留中のオーソリが最終的に消えるのか決済されるのかを判断するには、あえて十分な情報が欠けるように作られています。
ステップ 6: 標準ストリーミングを追加する
通常のリクエストは、Mercury が完了してから完全な回答を返します。応答を段階的に受け取るには、stream=True を有効にします。標準ストリーミング関数は次のとおりです:
def run_standard_stream(
client,
messages,
effort: str,
max_tokens: int,
):
start = time.perf_counter()
first_output = None
finish_reason = None
chunks = []
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if content:
now = time.perf_counter()
if first_output is None:
first_output = now
chunks.append(content)
print(
content,
end="",
flush=True,
)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_chunks": len(chunks),
"finish_reason": finish_reason,
"final_text": "".join(chunks),
}ここで重要なのは標準ストリーミングにおける chunks.append(content) の挙動です。各チャンクには応答の次の部分が含まれ、"".join(chunks) でチャンクを蓄積・再構成して最終回答を得られます。
注: 目に見える最初の出力までの中央値は 2.903 秒、総レイテンシの中央値は 3.375 秒でした。
ステップ 7: 拡散ストリーミングに切り替える
拡散ストリーミングを有効にするには、次のパラメータを True に設定します:
stream=True
diffusing=TrueAPI 呼び出しは、標準ストリーミングに diffusing=True の引数を 1 つ追加するだけの違いです。
def run_diffusion_stream(
client,
messages,
effort: str,
max_tokens: int,
live: bool = True,
):
start = time.perf_counter()
first_output = None
finish_reason = None
states = []
empty_chunks = 0
stream = client.chat.completions.create(
model=MODEL,
messages=messages,
reasoning_effort=effort,
temperature=0.75,
max_completion_tokens=max_tokens,
stream=True,
diffusing=True,
)
for chunk in stream:
choices = getattr(
chunk,
"choices",
None,
) or []
if (
choices
and getattr(
choices[0],
"finish_reason",
None,
)
):
finish_reason = choices[0].finish_reason
content = extract_delta_text(chunk)
if not content:
empty_chunks += 1
continue
now = time.perf_counter()
if first_output is None:
first_output = now
states.append({
"t_s": now - start,
"text": content,
})
if live:
clear_output(wait=True)
print(content, flush=True)
end = time.perf_counter()
return {
"time_to_first_output_s": (
first_output - start
if first_output
else None
),
"total_s": end - start,
"num_refinement_states": len(states),
"finish_reason": finish_reason,
"final_text": (
states[-1]["text"]
if states
else ""
),
"states": states,
}標準ストリーミングではチャンクを追記します。しかし拡散ストリーミングでは、最新の非空チャンクが回答の現時点での完全版を表します。そのため、追記するのではなく、以前に表示した内容を置き換えます。
また、返された状態を保持して、リファインメント状態の数を測定し、後の状態が先に表示されたテキストを実際に改訂しているかどうかを確認します。
5 回の実行では、拡散ストリーミングが可視のリファインメント状態を中央値 9(範囲 7–12)返しました。最初の可視状態までの中央値は 1.896 秒、総レイテンシの中央値は 2.560 秒でした。
ステップ 8: 標準と拡散ストリーミングを比較する
両方のコードパスを理解したので、計測された挙動を比較できます。
|
指標 |
標準 |
拡散 |
|
中央値のチャンク/状態数 |
6 |
9 |
|
範囲 |
5–7 |
7–12 |
|
最初の可視出力の中央値 |
2.903 s |
1.896 s |
|
総レイテンシの中央値 |
3.375 s |
2.560 s |
この特定のサポートプロンプトでは、拡散の方がレイテンシ中央値が低くなりましたが、範囲は大きく重なっています。したがって、拡散ストリーミングが本質的に高速だと結論づけるべきではありません。
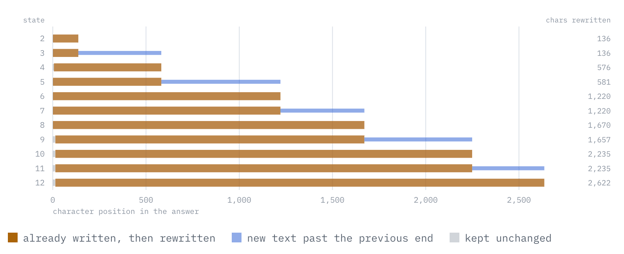
図: 12 状態の実行、遷移ごとの可視化。茶色のバーは Mercury 3 がすでに書いた後に置き換えられたテキスト、青のバーは以前の末尾より先の新しいテキストを表します。完全な追記であれば茶色は一切現れません。
私の実行では、返された拡散状態は、追記専用のチャンクのように振る舞うのではなく、以前に可視だったテキストを改訂していました。上の実行では、11 回の状態遷移のいずれも純粋な追記ではなく、すべてが前の状態から最初の 14 文字以内で乖離しました。
ステップ 9: 完了予算をテストする
次に、推論トークンが完了予算とどう相互作用するか、Mercury 3 の挙動を見ます。上の通常呼び出しでは max_completion_tokens=8192 を使用しましたが、挙動をより明確に示すため、max_completion_tokens を 1600 に下げます。
同じリクエストを、reasoning effort を low と high でそれぞれ 1 回ずつ実行します。計測結果は次のとおりです:
LOW
completion_tokens: 964
reasoning_tokens: 620
finish_reason: stop
visible answer: returned
HIGH
completion_tokens: 1539
reasoning_tokens: 1539
finish_reason: length
visible answer: nonehigh では、1,539 の完了トークンすべてが推論トークンとして報告されました。そのため、可視の回答テキストを返す前にモデルが完了上限に達しました。
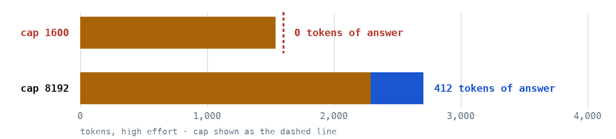
図: 高い effort の完了予算(1,600 と 8,192 トークン上限)
1,600 の上限では、予算全体が推論に使われ、出力に回す余裕がありませんでした。8,192 では、high の中央値の実行で 2,292 トークンを推論に使い、それでも 412 トークンの回答を出す余地がありました。8,192 の上限はスケールの右端外にあるため、上図で破線の上限線が表示されているのは最上段のみです。
失敗した high リクエストで重要なのは response.choices[0].finish_reason が length を返したことです。これは、リクエストが最大完了トークン予算(max_completion_tokens)に達したことを意味します。この予算には、推論トークンと可視出力トークンの両方が含まれます。この実行では、Mercury 3 は 1,539 の完了トークンをすべて推論トークンとして報告したため、可視の回答を生成する前に完了上限に達しました。
注: このデモでは、残りの実行において max_completion_tokens=8192 で十分でしたが、これを普遍的な最小値とみなすべきではありません。
ステップ 10: 低い/高い Reasoning Effort を比較する
通常の 8192 の完了予算に戻し、reasoning_effort だけを low と high で変えます。ステップ 5 の run_nonstream() ヘルパーを使い、low の推論 effort で 1 回、high で 1 回リクエストします:
results = []
for effort in ["low", "high"]:
result = run_nonstream(
client,
messages,
effort=effort,
max_tokens=8192,
)
results.append(result)
print(
effort,
result["elapsed_s"],
result["usage"],
)報告した結果では、単一のリクエストに頼らず、各構成で 5 回ずつ繰り返しました。
中央値は次のとおりです:
|
指標 |
Low |
High |
|
エンドツーエンドのレイテンシ |
2.936 s |
8.146 s |
|
完了トークン |
1312 |
2723 |
|
推論トークン |
828 |
2292 |
|
概算の可視トークン |
468 |
412 |
|
推論の比率 |
63% |
84% |
推論の使用量中央値は 828 から 2,292 トークンへ増加し、レイテンシ中央値は 2.936 秒から 8.146 秒へ(約 2.77 倍)増加しました。
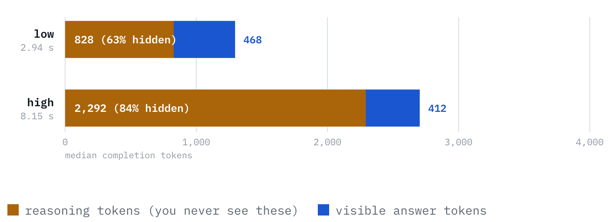
図: effort ごとに完了予算はどこへ使われるのか?
可視の回答長はそれほど大きくは変わりませんでした:
- Low: 中央値 468 トークン
- High: 中央値 412 トークン
また、観測範囲も重なっていました:
- Low: 393–494
- High: 356–469
したがって、これらの実行は、reasoning effort を上げると可視の回答が短くなるという主張を支持しません。レイテンシの範囲も、単一の実行では不十分である理由を示しています:
- Low: 1.602–4.993 s
- High: 4.102–9.068 s
注: 最速の high リクエストは、最も遅い low リクエストより実際に速かったです。
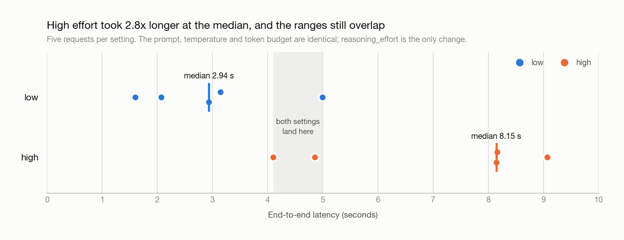
図: reasoning effort の全 10 リクエストをレイテンシでプロット
つまり、reasoning_effort="high" はこの実験で、報告された推論トークン使用量とレイテンシを大きく増加させましたが、可視の回答長は概ね同程度のままでした。
まとめ
Mercury 3 には次の 3 つの実務上の挙動があります。
-
拡散ストリーミングは異なる出力契約に基づく。標準ストリーミングは新しいテキストを追記し、拡散ストリーミングは前の状態を置き換えるべき連続する全文状態を返します。
-
推論トークンは完了予算を共有します。
max_completion_tokensが小さいと、Mercury 3 が可視の回答を出す前に推論で使い切ることがあります。 -
高い reasoning effort は、追加計算との引き換えにレイテンシを増やします。私の実行では、high は報告された推論トークンを大幅に多用し、所要時間も長くなりました(想定どおり)一方で、可視の回答長は概ね同程度でした。
これらの結果は、1 つの合成サポートケースに対する少数回の実行から得られたものであり、Mercury 3 の一般的な性能を示す主張ではなく、このデモからの観察として扱うべきです。
Mercury 3 のよくある質問
Mercury 3 における標準ストリーミングと拡散ストリーミングの主な違いは何ですか?
標準ストリーミングでは、応答が互いに追記されるテキストチャンクとして届きます。拡散ストリーミングでは、API が現在の応答の連続する改訂版を公開するため、最新の状態で前の状態を置き換える必要があり、追記はしません。
reasoning_effort="high" は常により良い回答を生みますか?
いいえ。高い reasoning effort は、Mercury により多くの推論余地を与えますが、あらゆるタスクで必ずしもより良い応答を保証するわけではありません。このデモでは、high は推論トークンを大幅に多用し、所要時間も長くなりましたが、可視の回答長は同程度でした。また、欠けている 1 つの証拠を表に出す点では一貫性が高まりましたが、実験規模が小さく、品質に関するより広い主張をするには不十分です。
max_completion_tokens が小さすぎると、なぜ Mercury 3 は可視の回答を返さないことがあるのですか?
推論トークンは可視の回答と同じ完了トークン予算に含まれます。モデルが推論でその予算の大半またはすべてを消費すると、可視出力を生成する前に完了上限に達する可能性があります。その場合、finish_reason と報告された推論トークン使用量を確認すると状況の説明に役立ちます。
拡散ストリーミングは常に標準ストリーミングより速いですか?
いいえ。このデモでは、拡散ストリーミングの方が最初の可視出力までの中央値と総レイテンシの中央値が低くなりましたが、範囲は重なっており、別のプロンプトでは逆の並びになりました。より確実な違いはストリーミングの挙動であって、レイテンシの改善が保証されるわけではありません。
いつ Mercury 3 を使うべきですか?
Mercury 3 は、ユーザーが高速な応答から恩恵を受けつつ、モデルが非自明な推論を行うレイテンシ重視のアプリケーションに特に有用です。適切な reasoning effort と完了予算はタスクに依存するため、レイテンシと回答品質の両方に対してチューニングする必要があります。
Mercury 3 は Inception.ai による拡散型の大規模言語モデルです。従来の自己回帰型 LLM がトークンを1つずつ順に生成するのと異なり、Mercury は拡散により応答の複数箇所を反復的に洗練します。モデルは GPT-6 Luna や Claude Haiku 5.5 を上回る性能を示し、NVIDIA GPU 上で毎秒 1,000+ トークンで 4〜8 倍高速に動作し、100万トークンのコンテキストウィンドウをサポートします。
このチュートリアルでは、アプリケーションログ、デプロイ情報、GPU メトリクス、リクエストトレースを受け取る小さなインシデント分析アシスタントを構築します。同じタスクを使って、Mercury 3 の次の2つの特性を確認します。
拡散ストリーミングが通常の LLM ストリーミングとどう違うか
reasoning_effortを low から high に上げると何が変わるか進める中で、Mercury の推論モードを使う際に重要となるトークン予算の問題にも遭遇します。最後までに、次のことができるようになります。
完全なコードのリポジトリ。
Mercury 3 とは?
応答を厳密に左から右へ生成する従来の自己回帰型 LLM と異なり、Mercury は生成中に複数のトークン位置を反復的に洗練するモデル群に属します。Inception の手法は、エージェント、検索、カスタマーサポート、教育など、モデル呼び出しの回数がすぐに積み上がるレイテンシ重視のワークロードに最適です。
Mercury 3 は、長文コンテキスト入力、推論コントロール、ツール呼び出し、構造化出力、OpenAI 互換エンドポイントなど、汎用 API モデルに期待される機能と拡散ベースの生成プロセスを組み合わせています。さらに、
diffusing=Trueのストリーミングモードを公開しており、追記型の出力ブロックだけでなく、モデルが洗練を進める中間の全文リファインメント状態をアプリケーションが受け取れるようにします。執筆時点で、Mercury 3 は次をサポートしています。
プロパティ
Mercury 3
コンテキストウィンドウ
100万トークン
最大出力
131,072 トークン
Reasoning effort
instant, low, medium, high
ツール呼び出し
対応
構造化出力
対応
ストリーミング
対応
拡散ストリーミング
対応
温度
0.5–1.0
API
OpenAI 互換
Inception は現在、Mercury 3 をローンチ価格として、入力 100 万トークンあたり $0.10、キャッシュ済み入力 100 万トークンあたり $0.01、出力 100 万トークンあたり $0.35 と掲載しています。キャッシュ済みトークンは入力価格から 90% オフでもあります。
Mercury 3 は Mercury 1 の 40 倍の規模で、はるかに高い知能を備えていますが、同等に高速です。
図: モデル品質とモデルサイズ(出典)
Mercury 3 はどのように動作するのか?
多くの LLM は左から右へ、トークンを1つずつ自己回帰的に生成します。従来の LLM がテキストを生成する方法は次のとおりです:
新しい各トークンは、それ以前に生成されたすべてに依存します。
Mercury は代わりに拡散を用います。
Inception は、拡散 LLM を Transformer ベースのモデルとして説明しており、複数のトークンを並行して変更することで出力を段階的に改善します。初期の Mercury の研究では、これを厳密な左から右の次トークン予測ではなく、粗から精への生成プロセスとして説明しています。
簡略化したイメージは次のようになります: