
Last chance! 50% off DataCamp Premium
Sale ends in
DeepSeek V4 is de nieuwste generatie Mixture-of-Experts (MoE)-taalmodellen van DeepSeek AI. De serie omvat twee varianten:
Meerdere architecturale verbeteringen onderscheiden V4 van zijn voorgangers:
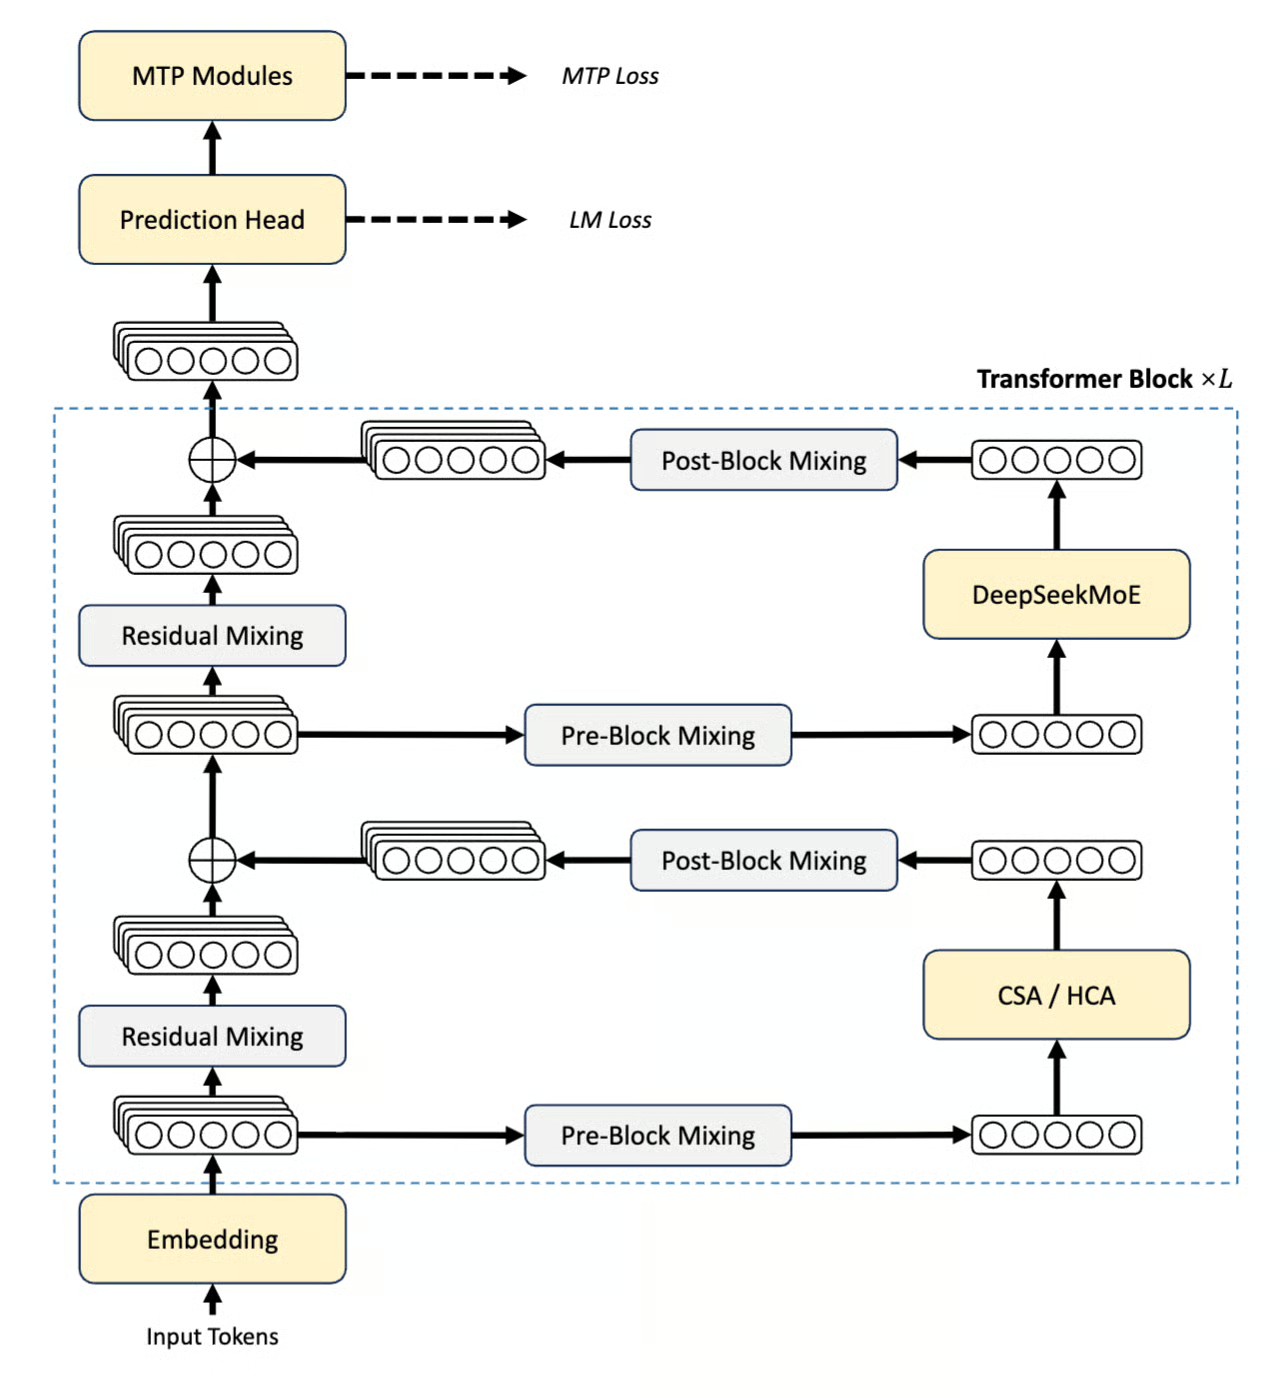
Figuur: DeepSeek V4 Series Architecture (DeepSeek Technical report)
Beide modellen ondersteunen drie verschillende inspanningsniveaus voor redeneren, Non-think, Think High en Think Max, die we in deze tutorial verkennen en vergelijken.
Het DeepSeek-team vergeleek de prestaties van het V4-model met zijn tegenhangers, en dit is wat ze vonden:
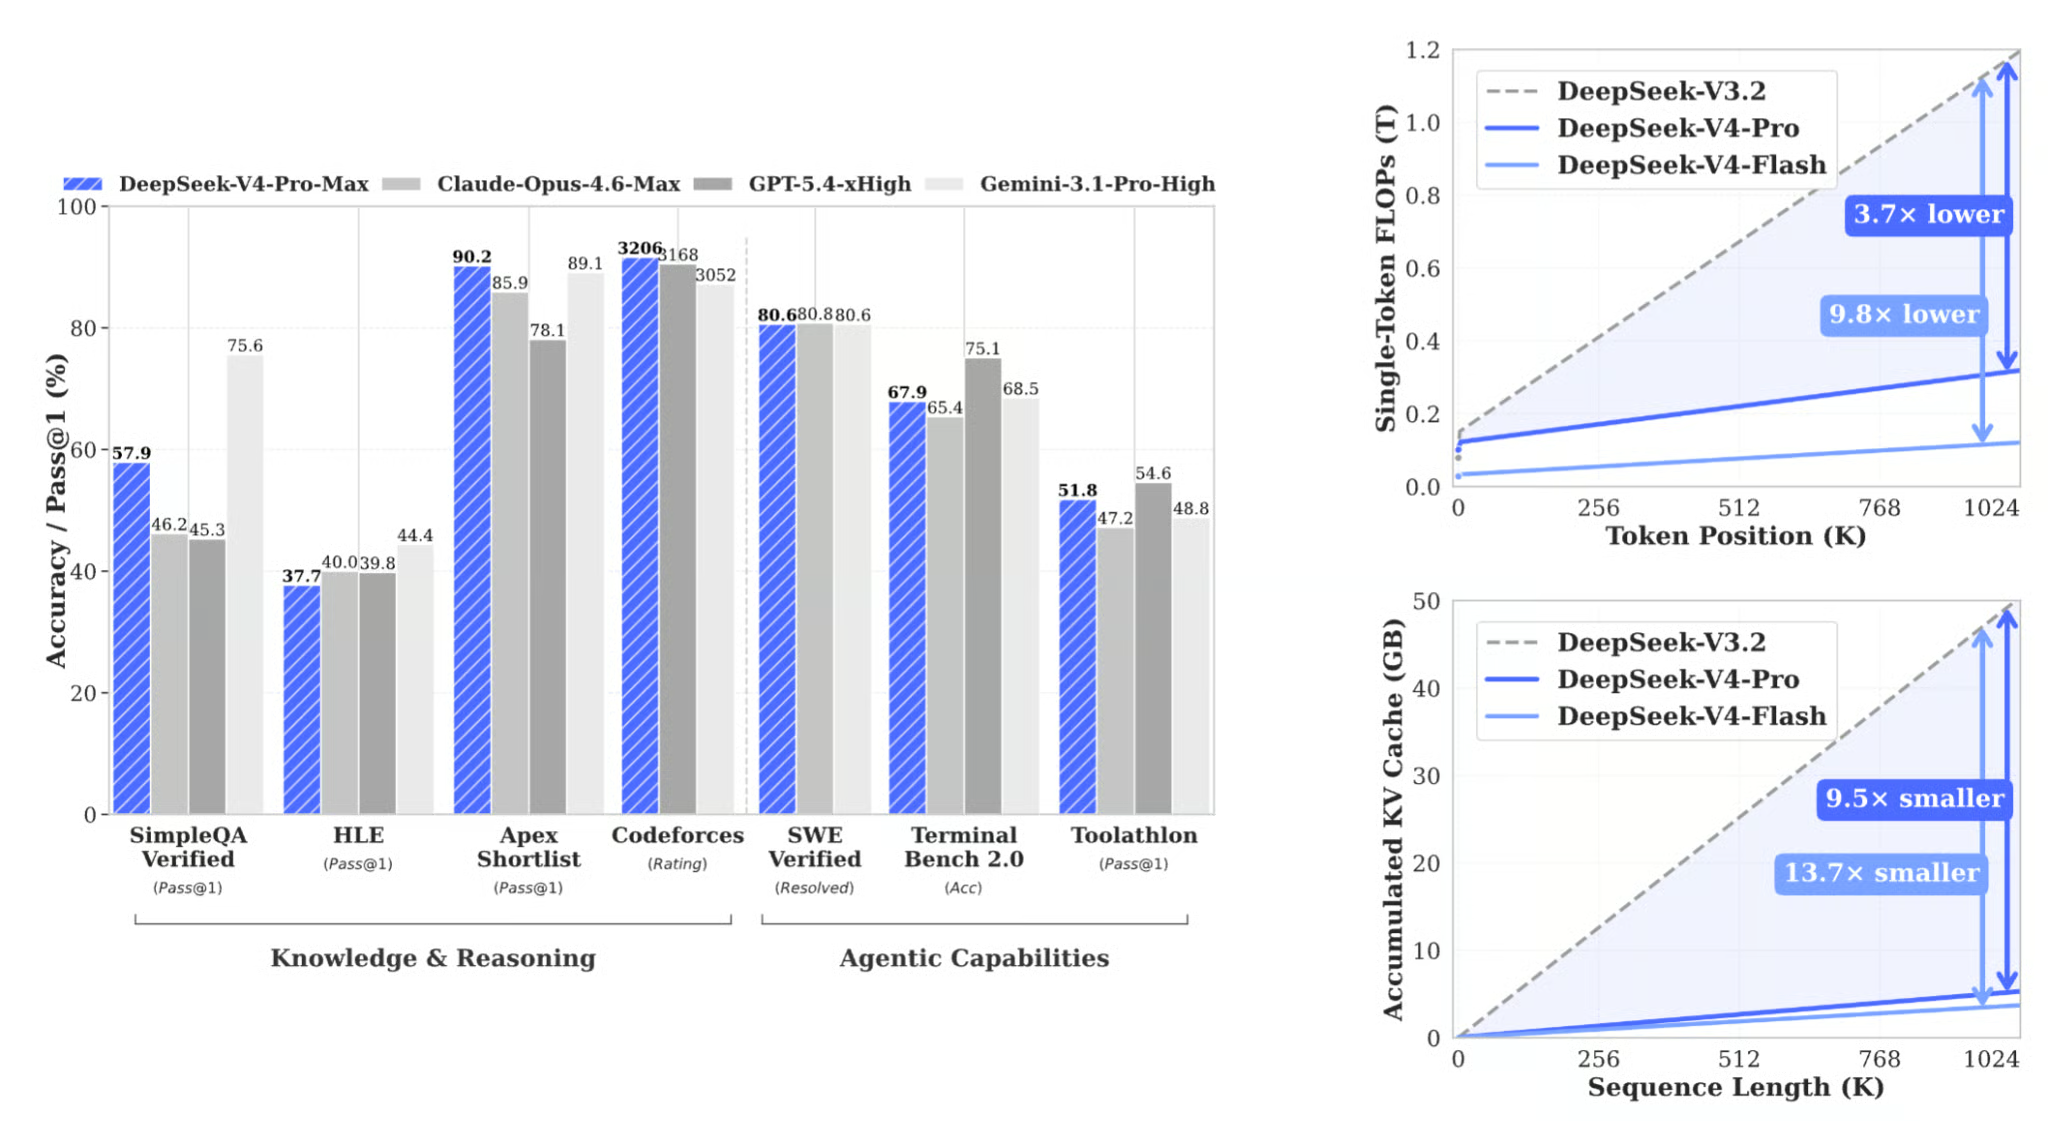
Figuur: Benchmarkprestaties van de DeepSeek V4-serie (DeepSeek Technical report)
De staafgrafiek links laat zien waar V4-Pro-Max staat ten opzichte van de toonaangevende gesloten modellen op het gebied van kennis, redeneren en agentic-taken. De twee grafieken rechts laten zien waarom de efficiëntiewinst ertoe doet, en ze zijn de meest verrassende resultaten. DeepSeek-V4-Pro-Max (de Think Max-redeneermodus) behaalt concurrerende resultaten ten opzichte van frontier closed-source modellen:
|
Benchmark |
DeepSeek-V4-Pro Max |
Claude Opus 4.6 Max |
Gemini-3.1-Pro High |
|
LiveCodeBench (Pass@1) |
93.5 |
88.8 |
91.7 |
|
Codeforces Rating |
3206 |
— |
3052 |
|
GPQA Diamond (Pass@1) |
90.1 |
91.3 |
94.3 |
|
SWE Verified (Resolved) |
80.6 |
80.8 |
80.6 |
De Codeforces-rating van 3206 plaatst V4-Pro-Max op Legendary Grandmaster-niveau, wat de coderingstaken in onze arena tot een echt interessante stresstest maakt.
Voordat we de app bouwen, is het de moeite waard om te begrijpen wat elke modus precies doet:
Non-think: Het model reageert direct, dus zonder interne chain-of-thought. Deze modus is ideaal voor taken waar snelheid belangrijker is dan diepgang, zoals formaatconversie, eenvoudige opzoekacties en samenvattingen in één zin.Think High: Het model redeneert stap voor stap voordat het een antwoord vastlegt. Deze modus is een goede balans tussen diepte en kosten voor matig complexe taken zoals debuggen, systeemontwerp en planning.Think Max: Het model drijft redeneren tot het uiterste, verkent meerdere benaderingen, verifieert zijn logica grondig en legt pas een definitief antwoord vast als het zeker is. Daarom is Think Max het best voor lastige wiskundige bewijzen, complexe refactors over meerdere bestanden of elke taak waarbij een fout, zelfverzekerd antwoord erger is dan een langzamer, geverifieerd antwoord.Het cruciale inzicht dat deze tutorial laat zien, is dat Think Max niet altijd wint. Bij triviale taken verspilt het compute voor identieke kwaliteit. Het doel van de arena is zichtbaar te maken welke modus per taaktype het echt waard is om te gebruiken, op basis van echte latency, tokenaantallen, kosten en gebruikersbeoordelingen.
Als je wilt zien hoe het model zich verhoudt tot andere state-of-the-art LLM's, lees dan onze artikelen over Claude Opus 4.7 vs DeepSeek V4 en GPT-5.5 vs DeepSeek V4.
In deze tutorial bouwen we een Streamlit-applicatie die:
Een prompt en een taakcategorie van de gebruiker accepteert
Drie parallelle API-calls uitvoert, één per redeneermodus, met Python's ThreadPoolExecutor
Denktraces parseert uit <think>...</think>-blokken in de output van het model
Latency, tokenaantallen en geschatte kosten per modus bijhoudt
Een vergelijking naast elkaar toont met metrics, een beoordelingssysteem en een winnaarsoverzicht
De volledige werkende app is één app.py-bestand, zonder externe databases of achtergrondservices nodig.
De volledige code voor deze tutorial staat in mijn GitHub-repository.
Begin met het maken van een projectmap en het installeren van de twee benodigde pakketten:
mkdir deepseek-arena && cd deepseek-arena
pip install streamlit>=1.32.0 openai>=1.12.0
De bibliotheek openai wordt hier gebruikt omdat de API van DeepSeek OpenAI-compatibel is, wat betekent dat we de OpenAI-client kunnen wijzen naar DeepSeek's base-URL zonder andere wijzigingen. Er is geen DeepSeek-specifieke SDK nodig.
Haal een API-sleutel op bij platform.deepseek.com en stel die in als omgevingsvariabele:
export DEEPSEEK_API_KEY="sk-..."Nu de omgeving klaar is, kunnen we modellen en hun modi configureren.
Voordat we logica schrijven, definiëren we de imports, modelidentifiers, configuraties voor redeneermodi en prijsconstanten. Deze dictionaries bepalen het gedrag van de hele app, zoals de modeldropdown, API-parameters die elke redeneermodus aansturen, het UI-kleurschema en de kosteninschattingen die in het vergelijkingspaneel worden getoond.
import os
import time
import concurrent.futures
from dataclasses import dataclass
from typing import Optional, Dict
import streamlit as st
from openai import OpenAI
DEEPSEEK_BASE_URL = "https://api.deepseek.com"
DEEPSEEK_API_KEY_ENV = "DEEPSEEK_API_KEY"
MODELS = {
    "DeepSeek-V4-Flash (default)": "deepseek-v4-flash",
    "DeepSeek-V4-Pro": "deepseek-v4-pro",
}
MODES: Dict[str, dict] = {
    "Non-think": {
        "icon": "",
        "color": "#10b981",
        "badge": "green",
        "desc": "Fast, direct answers — no internal reasoning",
        "thinking_type": "disabled",
        "reasoning_effort": None,
    },
    "Think High": {
        "icon": "",
        "color": "#3b82f6",
        "badge": "blue",
        "desc": "Careful step-by-step reasoning before responding",
        "thinking_type": "enabled",
        "reasoning_effort": "high",
    },
    "Think Max": {
        "icon": "",
        "color": "#ef4444",
        "badge": "red",
        "desc": "Exhaustive reasoning — push analysis to the limit",
        "thinking_type": "enabled",
        "reasoning_effort": "max",
    },
}
PRICING = {
    "deepseek-v4-flash": {
        "input_cache_hit":  0.0028,
        "input_cache_miss": 0.14,
        "output":           0.28,
    },
    "deepseek-v4-pro": {
        "input_cache_hit":  0.003625,
        "input_cache_miss": 0.435,
        "output":           0.87,
    },
}
Enkele ontwerpkeuzes zijn het toelichten waard:
Parameters voor denkmodus: Elk item in MODES bevat twee API-velden in plaats van een system prompt. Dit zijn thinking_type en reasoning_effort (”high”, "max" of None). De thinking_type wordt meegegeven via extra_body={"thinking": {"type": ...}}, en reasoning_effort is een toplevel-aanvraagparameter. Non-think zet thinking_type op "disabled" en laat reasoning_effort op None, zodat er helemaal geen thinking body wordt verstuurd.
Flash als standaardmodel: Flash activeert 13B parameters per token tegenover 49B bij Pro, waardoor drie parallelle calls goedkoop genoeg zijn om herhaaldelijk te draaien tijdens experimenten. Pro is beschikbaar via de dropdown voor wanneer je topklasse prestaties nodig hebt, maar Think Max op Pro verbruikt je quota snel; het als opt-in in plaats van standaard houden is dus een bewuste kostenrem.
Let op: De waarden in bovenstaande code weerspiegelen V4-Pro tegen zijn huidige promotiekorting. Controleer daarom altijd de actuele tarieven op api-docs.deepseek.com/quick_start/pricing voordat je kostenvergelijkingen publiceert, want zowel basistarieven als promotiekortingen veranderen vaak na de release van een nieuw model.
Het taakontwerp is het meest ondergewaardeerde onderdeel van het bouwen van een reasoning-vergelijking. Als alle taken moeilijk en open-ended zijn, wint Think Max altijd en leert de demo niets. De taakset moet het volledige moeilijkheidsspectrum beslaan, zodat elke modus ten minste één categorie heeft waarin die wint.
TASKS = {
    "Trivial / Lookup": {
        "prompt": (
            "Complete both tasks below:\n\n"
            "Task A — Convert this JSON to YAML:\n"
            '{"name": "Alice", "age": 30, "skills": ["Python", "ML", "LLMs"],\n'
            ' "address": {"city": "San Francisco", "zip": "94105"}}\n\n'
            "Task B — Summarize this paragraph in exactly one sentence:\n"
            '"Large language models have rapidly transformed natural language processing '
            "by demonstrating unprecedented capabilities across translation, summarization, "
            "reasoning, and code generation, driven by scale and alignment techniques like RLHF "
            'that bring model outputs closer to human intent."'
        ),
        "expected_winner": "Non-think",
        "tip": "Non-think should dominate here. No reasoning is required.",
    },
    "Coding / Debugging": {
        "prompt": (
            "Find every bug in the Python code below, explain each bug clearly, "
            "and provide a fully corrected version:\n\n"
            "```python\n"
            "def binary_search(arr, target):\n"
            "    left, right = 0, len(arr)\n"
            "    while left < right:\n"
            "        mid = (left + right) // 2\n"
            "        if arr[mid] == target:\n"
            "            return mid\n"
            "        elif arr[mid] < target:\n"
            "            left = mid\n"
            "        else:\n"
            "            right = mid - 1\n"
            "    return -1\n\n"
            "print(binary_search([1, 3, 5, 7, 9], 7))\n"
            "```"
        ),
        "expected_winner": "Think High",
        "tip": "Think High usually finds the bugs and explains them well.",
    },
    "System Design": {
        "prompt": (
            "Design a scalable vector search system for 100 million documents.\n\n"
            "Address each of the following:\n"
            "1. Indexing strategy and pipeline\n"
            "2. ANN algorithm selection (HNSW vs IVF-PQ vs ScaNN — justify your choice)\n"
            "3. Sharding and replication strategy\n"
            "4. p99 query latency target (< 50 ms) — how do you hit it?\n"
            "5. Real-time document update handling\n"
            "6. Top 3 failure modes and their mitigations"
        ),
        "expected_winner": "Think High",
        "tip": "Think High often gives the best quality-per-dollar design answer.",
    },
    "Planning": {
        "prompt": (
            "Create a detailed 6-month roadmap for deploying an enterprise RAG system.\n\n"
            "Include:\n"
            "- Month-by-month phases with concrete, measurable milestones\n"
            "- Top 5 risks and mitigation strategies\n"
            "- Team roles and headcount required per phase\n"
            "- Evaluation metrics for each phase (how do you know it's working?)\n"
            "- Go / no-go production checklist"
        ),
        "expected_winner": "Think High",
        "tip": "Think High should produce a more structured, complete roadmap.",
    },
    "Math (IMO-style)": {
        "prompt": (
            "Solve this problem completely and verify your answer:\n\n"
            "Find all positive integers n such that n² + 1 is divisible by n + 1.\n\n"
            "Your answer must include:\n"
            "1. A complete proof with clear logical steps\n"
            "2. Verification with at least 3 concrete numerical examples\n"
            "3. A rigorous argument for why your solution set is complete "
            "(i.e., there are no other solutions)"
        ),
        "expected_winner": "Think Max",
        "tip": "Think Max earns its cost when thorough verification matters.",
    },
}
De vijf taken mappen netjes op de drie verwachte winnaars:
|
Taak |
Verwachte winnaar |
Toelichting |
|
Trivial / Lookup |
Non-think |
Geen redeneeroverhead nodig; denktijd is pure verspilling |
|
Coding / Debugging |
Think High |
Eén zorgvuldige logische pass vindt alle bugs; Max voegt marginaal toe |
|
System Design |
Think High |
Diepte verbetert kwaliteit; uitputtendheid voegt geen nuttige architectuur toe |
|
Planning |
Think High |
Structuur wint van ruwe compute; een roadmap is geen bewijs |
|
Math (IMO-style) |
Think Max |
Verificatie is dragend; een fout bewijs is erger dan een traag correct bewijs |
Elke taak heeft ook een veld expected_winner. De app toont dit nadat resultaten binnen zijn, zodat gebruikers kunnen checken of de verwachte winnaar standhield of werd verslagen.
Met de taaktemplates gedefinieerd, hebben we nu een structuur nodig om de resultaten van elke API-call op te slaan. In plaats van ruwe responseobjecten door de app te geven, definiëren we één RunResult-dataclass die alle metrics bevat die het vergelijkingspaneel nodig heeft.
@dataclass
class RunResult:
    mode: str
    answer: str = ""
    thinking: str = ""
    latency: float = 0.0
    input_tokens: int = 0
    output_tokens: int = 0
    cost_usd: float = 0.0
    error: Optional[str] = None
    @property
    def tokens_per_second(self) -> Optional[float]:
        if self.latency > 0 and self.output_tokens > 0:
            return self.output_tokens / self.latency
        return None
    @property
    def thinking_word_count(self) -> int:
        return len(self.thinking.split()) if self.thinking else 0
Het veld thinking staat los van answer omdat de DeepSeek V4-API de chain-of-thought teruggeeft in een apart veld reasoning_content, op hetzelfde niveau als content in de responsstructuur. Ze gescheiden houden laat de UI een inklapbare reasoning trace naast het schone eindantwoord renderen, wat het modale verschil direct en tastbaar maakt, vooral bij de wiskundetaak waar de Think Max-trace tot duizenden woorden kan oplopen.
De eigenschap tokens_per_second meet generatie-throughput los van de promptlengte. Dit is nuttig om efficiëntie tussen modi te vergelijken wanneer de outputtokenaantallen aanzienlijk verschillen. Merk op dat Think Max van nature meer tokens produceert, dus ruwe latencyvergelijkingen alleen kunnen misleidend zijn zonder ook te zien hoe snel elke modus genereerde.
Voordat we de API-calllogica schrijven, definiëren we twee kleine helpers die tussen de ruwe SDK-respons en de RunResult zitten. Ze zijn makkelijk te missen maar belangrijk voor kostennauwkeurigheid.
def get_cached_prompt_tokens(usage) -> int:
    prompt_details = getattr(usage, "prompt_tokens_details", None)
    if prompt_details is None:
        return 0
    cached_tokens = getattr(prompt_details, "cached_tokens", None)
    if cached_tokens is not None:
        return cached_tokens or 0
    if isinstance(prompt_details, dict):
        return prompt_details.get("cached_tokens", 0) or 0
    return 0
def estimate_cost_usd(
    model: str,
    prompt_tokens: int,
    completion_tokens: int,
    cached_prompt_tokens: int,
) -> float:
    pricing = PRICING.get(model, PRICING["deepseek-v4-flash"])
    cached_tokens = min(cached_prompt_tokens, prompt_tokens)
    uncached_tokens = max(prompt_tokens - cached_tokens, 0)
    return (
        cached_tokens   / 1_000_000 * pricing["input_cache_hit"]
        + uncached_tokens / 1_000_000 * pricing["input_cache_miss"]
        + completion_tokens / 1_000_000 * pricing["output"]
    )
De functie get_cached_prompt_tokens() biedt geen directe veldtoegang omdat de structuur prompt_tokens_details niet gegarandeerd consistent is over SDK-versies heen. Hij checkt eerst op een getypt attribuut, valt dan terug op dict-toegang en geeft uiteindelijk nul terug in plaats van een uitzondering te gooien. Dit is belangrijk binnen een ThreadPoolExecutor, waar een stille fout in één thread tot een misleidend lage kosteninschatting voor die modus kan leiden zonder zichtbare foutmelding.
De helper estimate_cost_usd() splitst het aantal prompttokens op in cached en niet-cached delen voordat tarieven worden toegepast. Omdat DeepSeek de cache-hitprijs verlaagde tot een tiende van het misstarief, kan het verschil tussen een koude en warme prompt groot zijn. Bij herhaalde run-overs kan Non-think bijna gratis lijken vergeleken met Think Max, niet omdat het minder tokens genereerde, maar omdat zijn kortere prompt veel waarschijnlijker cache-warm is.
Dit is de architectonische kern van de arena. Alle drie de modi vuren tegelijkertijd met een ThreadPoolExecutor, zodat de totale wandkloktijd gelijk is aan de langzaamste enkele modus in plaats van de som van alle drie.
def call_mode(client: OpenAI, model: str, mode_name: str, user_prompt: str) -> RunResult:
    result = RunResult(mode=mode_name)
    mode_cfg = MODES[mode_name]
    start = time.perf_counter()
    try:
        request_kwargs = {
            "model": model,
            "messages": [{"role": "user", "content": user_prompt}],
            "max_tokens": 4096,
            "extra_body": {"thinking": {"type": mode_cfg["thinking_type"]}},
        }
        if mode_cfg["reasoning_effort"]:
            request_kwargs["reasoning_effort"] = mode_cfg["reasoning_effort"]
        response = client.chat.completions.create(**request_kwargs)
        result.latency = time.perf_counter() - start
        message = response.choices[0].message
        result.thinking = (getattr(message, "reasoning_content", None) or "").strip()
        result.answer   = (message.content or "").strip()
        usage = response.usage
        result.input_tokens  = getattr(usage, "prompt_tokens", 0) or 0
        result.output_tokens = getattr(usage, "completion_tokens", 0) or 0
        result.cost_usd = estimate_cost_usd(
            model=model,
            prompt_tokens=result.input_tokens,
            completion_tokens=result.output_tokens,
            cached_prompt_tokens=get_cached_prompt_tokens(usage),
        )
    except Exception as exc:
        result.latency = time.perf_counter() - start
        result.error = str(exc)
    return result
def run_parallel(client: OpenAI, model: str, prompt: str) -> Dict[str, RunResult]:
    results: Dict[str, RunResult] = {}
    with concurrent.futures.ThreadPoolExecutor(max_workers=3) as pool:
        futures = {
            pool.submit(call_mode, client, model, mode_name, prompt): mode_name
            for mode_name in MODES
        }
        for fut in concurrent.futures.as_completed(futures):
            results[futures[fut]] = fut.result()
    return results
Enkele ontwerpbeslissingen zijn hier het benoemen waard:
request_kwargs conditioneel opbouwen: De Non-think-modus stuurt thinking_type: "disabled" en geen reasoning_effort-sleutel. Think High en Think Max sturen thinking_type: "enabled" en hun respectieve inspanningsniveau. De guard if mode_cfg["reasoning_effort"] zorgt dat de parameter volledig wordt weggelaten voor Non-think in plaats van als None te worden verstuurd, wat een API-validatiefout kan veroorzaken.
Rechtstreeks reasoning_content lezen: De chain-of-thought-trace wordt gelezen uit message.reasoning_content met getattr() en een fallback naar een lege string. Dit is robuuster dan <think>...</think>-tags parsen uit de contentstring. Het gebruikt het officiële responsveld, handelt de case af waarin geen trace is gegenereerd (Non-think) en breekt niet als het modelwoord "think" om andere redenen in de output verschijnt.
Defensief getattr() op usage-velden: Usage-velden worden benaderd met getattr(..., 0) or 0 in plaats van directe attribuuttoegang. Dit betekent dat als het usage-object een veld mist in een oudere SDK-versie of een ongebruikelijke respons, de fallback een nul oplevert in plaats van een AttributeError die de hele run zou markeren als mislukt.
Fouthandling: Als een call faalt, slaat de RunResult-dataclass de foutstring op in plaats van te raisen. De UI checkt result.error en toont een informatieve kaart zonder de hele drie-modus-run te laten crashen.
Deze stap behandelt de presentatielaag: de paginalay-out, het CSS-designsysteem, de resultaatkolom per modus en de tabstructuur die de vergelijking ordent zonder de gebruiker bij eerste laad te overladen.
De app gebruikt st.set_page_config met layout="wide" om de driekolomsvergelijking genoeg horizontale ruimte te geven:
def main():
    st.set_page_config(
        page_title="DeepSeek V4 Think Mode Arena",
        layout="wide",
        initial_sidebar_state="expanded",
    )
    inject_css()
De functie inject_css() injecteert via st.markdown een volledig designsysteem. Het gebruikt een warme perkamentachtergrond met Space Mono voor monospacekoppen en metric-chips, en DM Sans voor lopende tekst.
def render_mode_column(result: RunResult, mode_name: str):
    cfg = MODES[mode_name]
    badge_cls = f"mode-{cfg['badge']}"
    st.markdown(
        f'<div class="mode-header {badge_cls}">{mode_name}</div>',
        unsafe_allow_html=True,
    )
    st.markdown(f'<div class="subtle-copy">{cfg["desc"]}</div>', unsafe_allow_html=True)
    if result.error:
        st.error(f"**API Error:** {result.error}")
        return
    chips = [
        ("Latency", f"{result.latency:.1f}s"),
        ("Output tokens", f"{result.output_tokens:,}"),
        ("Cost", f"${result.cost_usd:.5f}"),
    ]
    if result.tokens_per_second:
        chips.append(("Tok/s", f"{result.tokens_per_second:.0f}"))
    chip_html = "".join(
        f'<span class="metric-chip">{label} <span>{val}</span></span>'
        for label, val in chips
    )
    st.markdown(chip_html, unsafe_allow_html=True)
    if result.thinking:
        with st.expander(f" Thinking trace — {result.thinking_word_count:,} words"):
            preview = result.thinking[:5000]
            if len(result.thinking) > 5000:
                preview += "\n\n[… truncated for display …]"
            st.text(preview)
    elif mode_name != "Non-think":
        st.caption("_No thinking trace emitted_")
    st.markdown('<div class="answer-label">Final answer</div>', unsafe_allow_html=True)
    st.markdown(result.answer if result.answer else "_No answer returned._")
De thinking trace-expander is bijzonder nuttig omdat hij het modale verschil voelbaar maakt: de Think Max-trace kan bij een moeilijk wiskundeprobleem oplopen tot duizenden woorden van zelfcorrectie en verificatie, terwijl de Non-think-modus mogelijk helemaal geen trace heeft.
De hoofdlay-out gebruikt Streamlit-tabs om aandachtspunten te scheiden zonder alles op één scroll te proppen:
overview_tab, answers_tab, ratings_tab = st.tabs(
    ["Overview", "Full Responses", "Ratings"]
)
De "Overview"-tab toont het winnaarsoverzicht en de metricstabel. De "Full Responses"-tab toont de driekolomsvergelijking met denktraces, terwijl de "Ratings"-tab sliders toont voor gebruikersbeoordelingen (1–5) per modus.
Deze laatste stap bouwt de twee componenten die in de Overview-tab staan: een platte metricstabel die elke gemeten dimensie naast elkaar zet, en een winnaarsoverzicht dat de winnaar in vier afzonderlijke categorieën benoemt.
def render_metrics_table(results: Dict[str, RunResult], ratings: Dict[str, int]):
    rows = []
    for mode_name, res in results.items():
        ok = not res.error
        rows.append({
            "Mode":            mode_name,
            "Latency (s)":     f"{res.latency:.2f}" if ok else "—",
            "Input Tokens":    f"{res.input_tokens:,}" if ok else "—",
            "Output Tokens":   f"{res.output_tokens:,}" if ok else "—",
            "Tok/s":           f"{res.tokens_per_second:.0f}" if (ok and res.tokens_per_second) else "—",
            "Est. Cost (USD)": f"${res.cost_usd:.5f}" if ok else "—",
            "Thinking Words":  f"{res.thinking_word_count:,}" if ok else "—",
            "User Rating":     f"{ratings.get(mode_name)}/5" if ratings.get(mode_name) else "—",
        })
    st.table(rows)
def render_winner_summary(results: Dict[str, RunResult], ratings: Dict[str, int], expected: str):
    valid = {k: v for k, v in results.items() if not v.error}
    fastest        = min(valid, key=lambda k: valid[k].latency)
    cheapest       = min(valid, key=lambda k: valid[k].cost_usd)
    most_efficient = max(
        valid,
        key=lambda k: valid[k].output_tokens / max(valid[k].cost_usd, 1e-9),
    )
    top_rated = max(ratings, key=ratings.get) if ratings else None
Hier is een korte blik op wat deze twee functies doen:
De functie render_metrics_table() itereert over elke RunResult en bouwt een rijdictionary per modus. De acht kolommen dekken de volledige vergelijking, inclusief tijd (latency, tok/s), schaal (input- en outputtokens, denkwoorden), geld (geschatte kosten) en menselijk oordeel (gebruikersrating).
De functie render_winner_summary() filtert eerst mislukte runs weg voordat winnaars worden berekend, zodat een enkele API-fout de resultaten nooit vertekent. Vervolgens zoekt hij de winnaar in vier onafhankelijke dimensies zoals wandkloksnelheid, ruwe kosten, outputefficiëntie en gebruikersbeoordeling.
Deze vier categorieën worden bewust gescheiden gehouden in plaats van gecombineerd in één score, omdat een gewogen samengestelde score de app zou dwingen te beslissen dat latency belangrijker is dan kosten — dat is een productbeslissing, geen frameworkbeslissing.
De app toont ook de voorspelde winnaar per taak en vraagt de gebruiker te bevestigen of dit klopte:
st.markdown(
    f"> **Expected winner for this task type:** {expected} — "
    "does your result match? Rate answers to confirm.",
)De hele app staat in één app.py-bestand met twee dependencies, en starten kost twee commando's:
# Set your API key
export DEEPSEEK_API_KEY="sk-..."
# Run
streamlit run app.py
De app opent in je browser op localhost:8501. Selecteer een taaktemplate in de dropdown, bewerk desgewenst de prompt en klik op Run Arena. Een voortgangsbalk werkt bij zodra elke modus voltooit. Resultaten worden opgeslagen in st.session_state zodat je van tab kunt wisselen en antwoorden beoordelen zonder een her-run te triggeren.
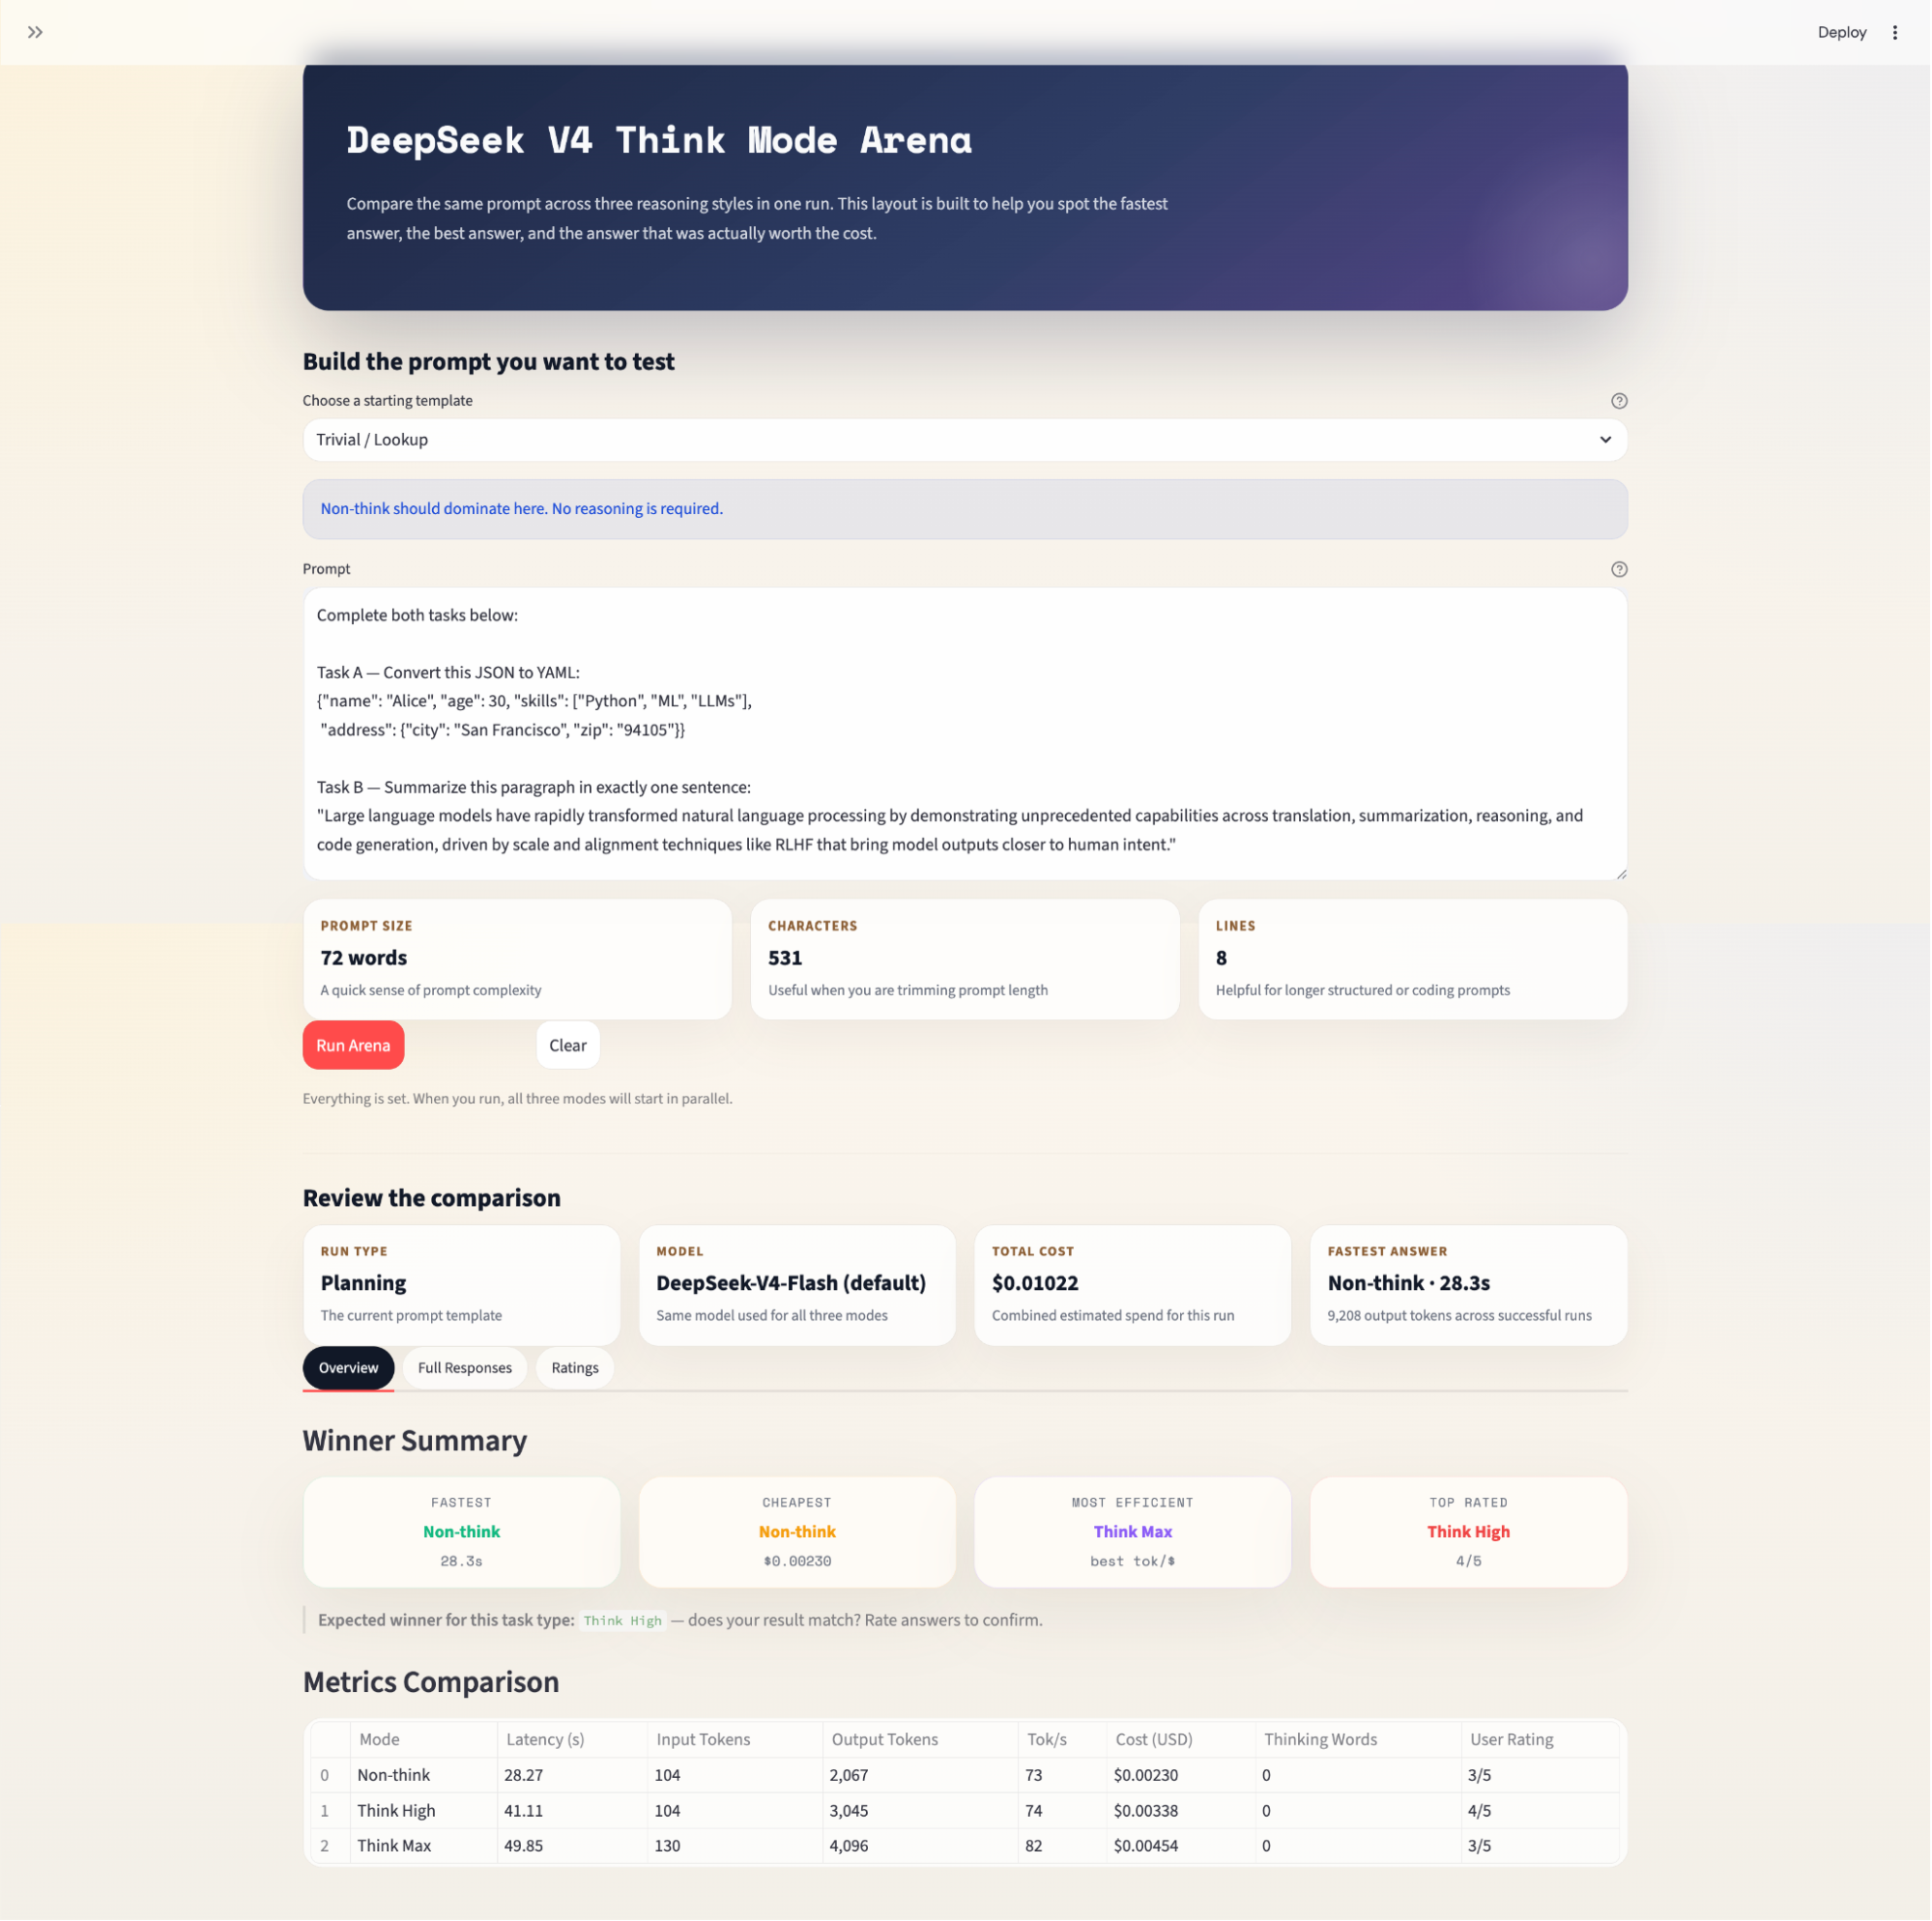
Opmerking over prijzen: DeepSeek heeft de V4 API-tarieven sinds de lancering aanzienlijk aangepast. V4-Pro is momenteel in promotiekorting, en cache-hitprijzen zijn in april 2026 verlaagd tot een tiende van het misstarief. De kosten in de app weerspiegelen deze actuele tarieven maar kunnen veranderen. Controleer altijd op api-docs.deepseek.com/quick_start/pricing voordat je enig model gebruikt.
In deze tutorial hebben we een Streamlit-app gebouwd die dezelfde prompt parallel draait over de drie redeneermodi van DeepSeek V4 en de resultaten vergelijkt op latency, kosten, tokengebruik, diepte van de denktrace en door gebruikers beoordeelde kwaliteit. De belangrijkste architecturale keuzes waren:
ThreadPoolExecutor voor echte paralleliteit, wat betekent dat de totale wandkloktijd gelijk is aan de langzaamste modus in plaats van de som van alle drie
API-parameters thinking en reasoning_effort zorgen ervoor dat de modebesturing schoon, expliciet en in lijn met DeepSeek's API is, in plaats van te vertrouwen op system prompt-sturing
Cache-bewuste kosteninschatting helpt inputtokens te splitsen in cache-hit en cache-miss, wat wezenlijk nauwkeurigere kosten oplevert, vooral bij herhaalde runs waarbij warm-cachekortingen Non-think bijna gratis kunnen laten lijken
Om dit project verder uit te breiden, kun je een LLM-as-judge-laag overwegen (met een apart model zoals Claude of GPT-4 om antwoorden automatisch te scoren), responses cachen op prompt-hash om identieke queries niet opnieuw te draaien, of een cross-model-as toevoegen die Flash Think Max tegenover Pro Think High zet — een echt interessante kostenpariteitsvraag die het V4-paper opwerpt maar niet volledig beantwoordt.
Topcursussen over AI
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min


