
{count, plural, one {Corso} other {Corsi}}
Sviluppare sistemi di AI con l'API di OpenAI
{hours} ore
23.1K
DeepSeek V4 è l’ultima generazione di modelli linguistici Mixture-of-Experts (MoE) di DeepSeek AI. La serie include due varianti:
Diverse migliorie architetturali distinguono V4 dai suoi predecessori:
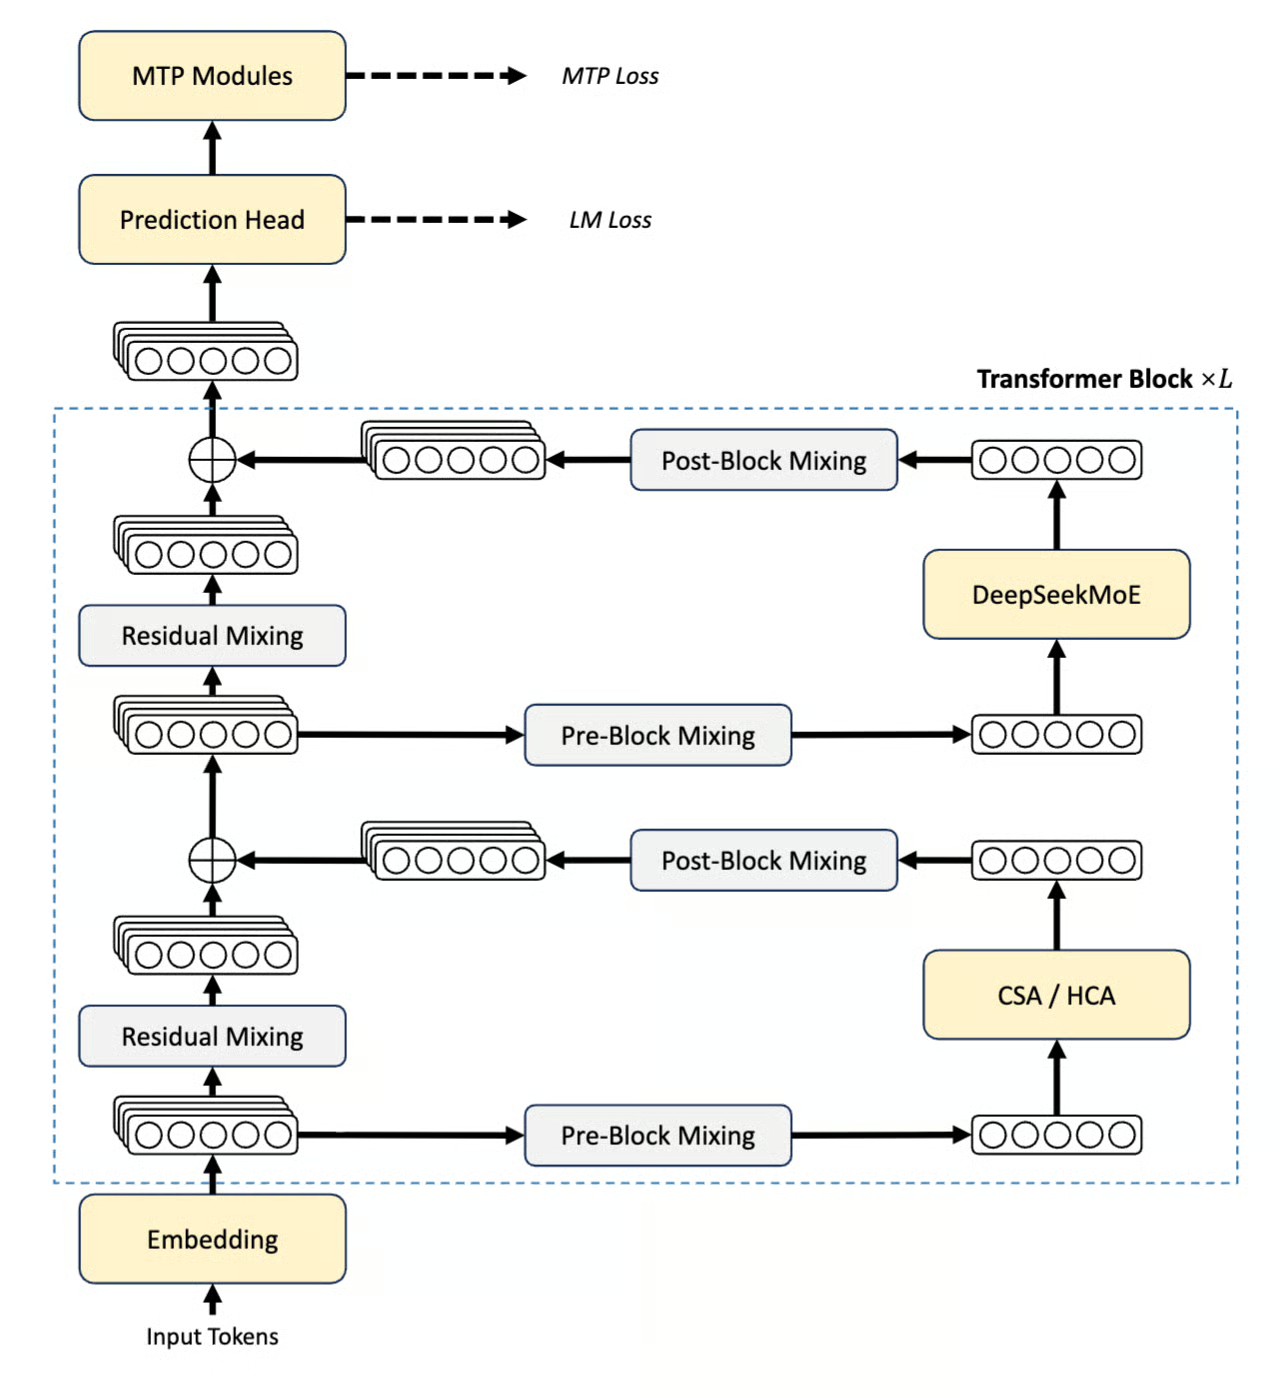
Figura: Architettura della serie DeepSeek V4 (Report tecnico DeepSeek)
Entrambi i modelli supportano tre modalità distinte di sforzo di ragionamento, Non-think, Think High e Think Max, che esploreremo e confronteremo in questo tutorial.
Il team DeepSeek ha confrontato le prestazioni del modello V4 con quelle dei suoi pari, ecco cosa ha rilevato:
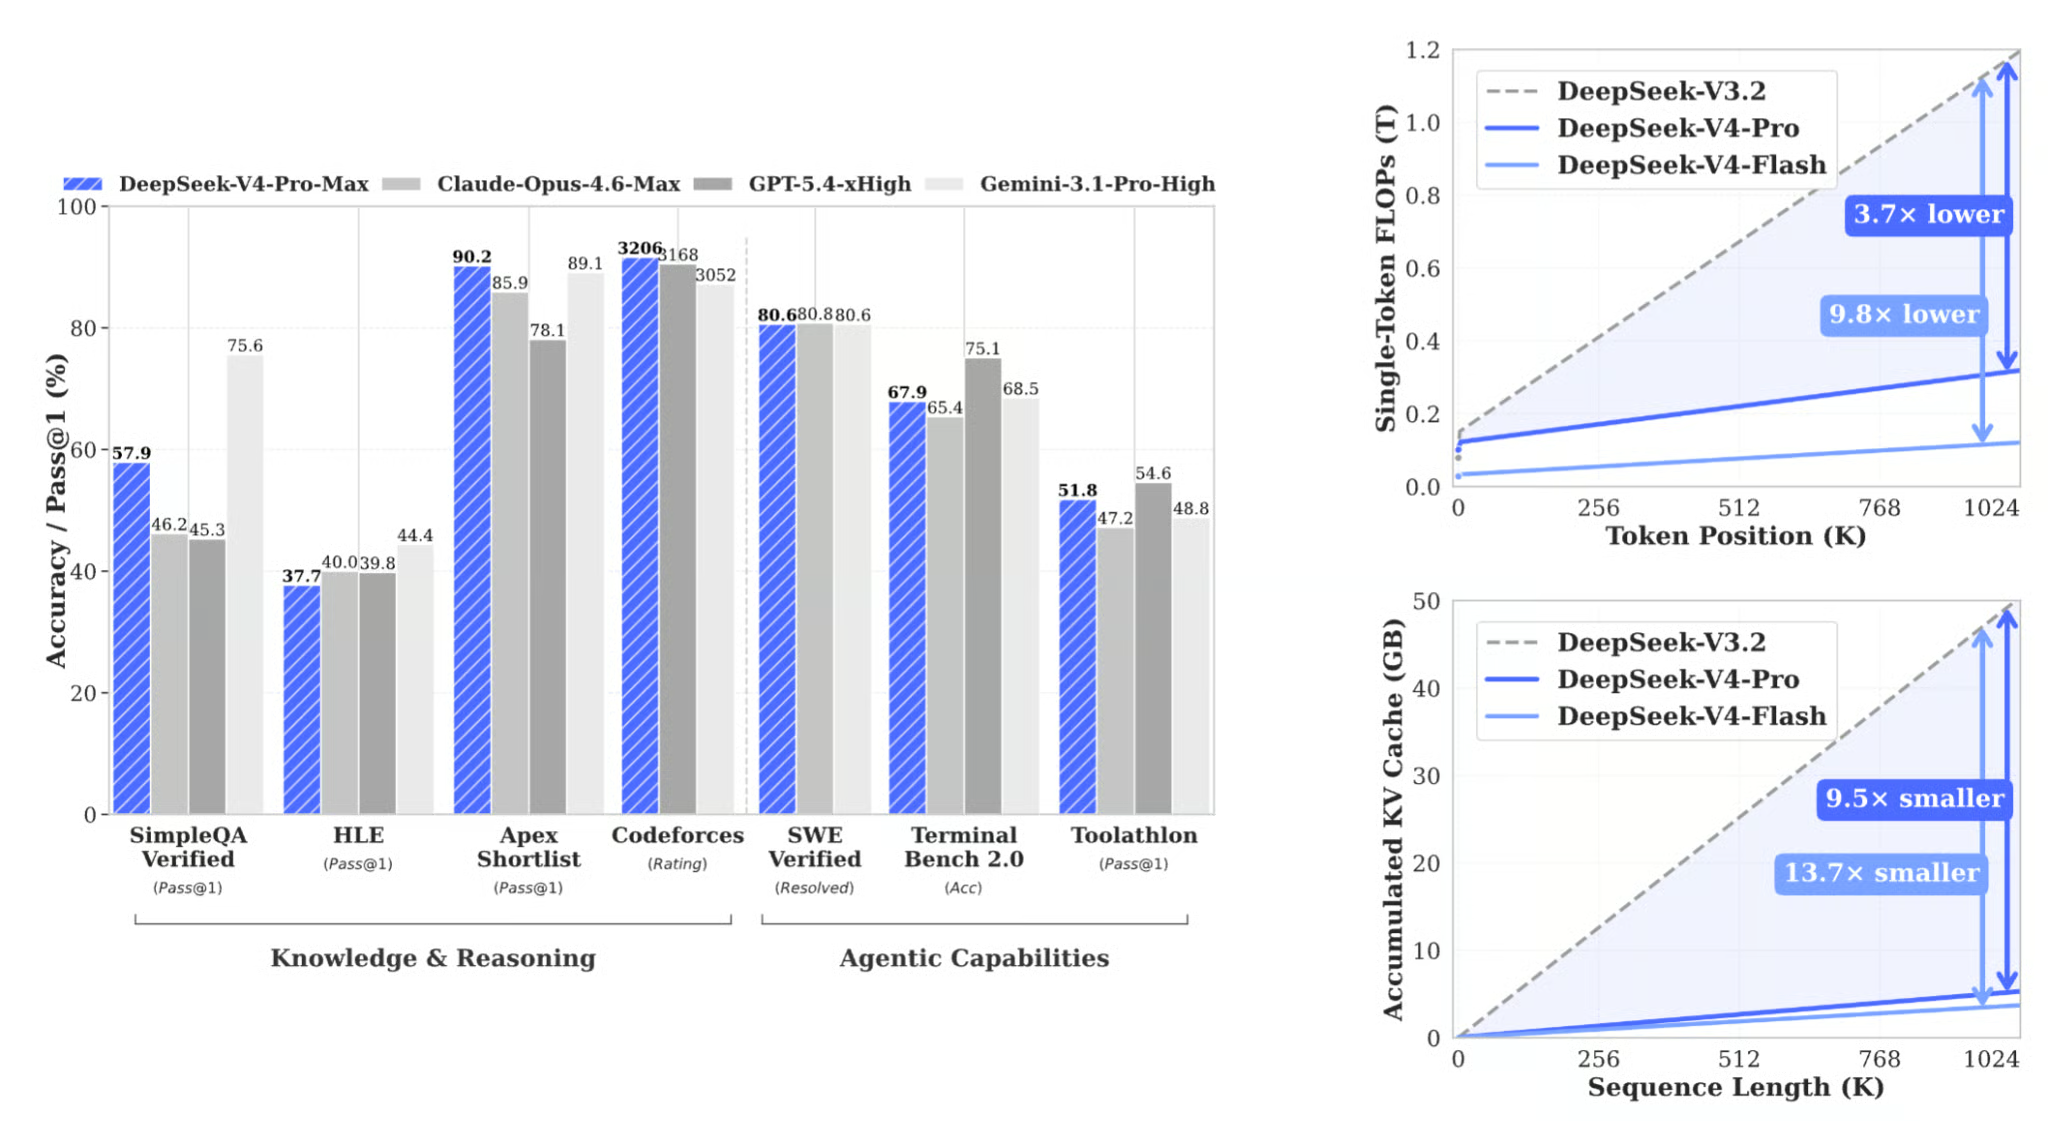
Figura: Prestazioni benchmark della serie DeepSeek V4 (Report tecnico DeepSeek)
Il grafico a barre a sinistra mostra dove si colloca V4-Pro-Max rispetto ai modelli closed-source d’avanguardia in compiti di conoscenza, ragionamento e agentici. I due grafici a destra mostrano perché i guadagni di efficienza contano, e sono i risultati più sorprendenti. DeepSeek-V4-Pro-Max (la modalità di ragionamento Think Max) ottiene risultati competitivi rispetto ai modelli closed-source di frontiera:
|
Benchmark |
DeepSeek-V4-Pro Max |
Claude Opus 4.6 Max |
Gemini-3.1-Pro High |
|
LiveCodeBench (Pass@1) |
93,5 |
88,8 |
91,7 |
|
Codeforces Rating |
3206 |
— |
3052 |
|
GPQA Diamond (Pass@1) |
90,1 |
91,3 |
94,3 |
|
SWE Verified (Resolved) |
80,6 |
80,8 |
80,6 |
Il punteggio Codeforces di 3206 colloca V4-Pro-Max al livello di Legendary Grandmaster, rendendo i task di coding nella nostra arena un test da stress davvero interessante.
Prima di costruire l’app, vale la pena capire cosa fa effettivamente ogni modalità:
Non-think: Il modello risponde direttamente, senza una catena di pensiero interna. Questa modalità è ideale quando la velocità conta più della profondità, ad esempio per conversioni di formato, ricerche semplici e riassunti in una frase.Think High: Il modello ragiona passo dopo passo prima di impegnarsi in una risposta. È un buon equilibrio tra profondità e costo per task moderatamente complessi come debugging, system design e pianificazione.Think Max: Il modello spinge il ragionamento al massimo, esplora più approcci, verifica rigorosamente la logica e si impegna a una risposta finale solo quando è certo. Quindi la modalità Think Max è la migliore per dimostrazioni matematiche difficili, refactor complessi multi-file o qualsiasi task in cui una risposta errata ma sicura è peggiore di una più lenta ma verificata.L’intuizione cruciale che questo tutorial dimostra è che Think Max non vince sempre. Su task banali, spreca compute a parità di qualità. L’obiettivo dell’arena è far emergere quale modalità valga davvero la pena usare per ciascun tipo di task, in base a latenza reale, conteggio token, costo e valutazioni degli utenti.
Se ti interessa vedere come il modello si confronta con altri LLM all’avanguardia, ti consiglio di leggere i nostri articoli su Claude Opus 4.7 vs DeepSeek V4 e GPT-5.5 vs DeepSeek V4.
In questo tutorial costruiremo un’applicazione Streamlit che:
Accetta un prompt e una categoria di task dall’utente
Esegue tre chiamate API in parallelo, una per modalità di ragionamento, usando ThreadPoolExecutor di Python
Effettua il parsing delle tracce di pensiero dai blocchi <think>...</think> nell’output del modello
Traccia latenza, conteggio token ed costo stimato per modalità
Presenta un confronto affiancato con metriche, un sistema di valutazione dell’utente e un riepilogo del vincitore
L’app completa funziona in un unico file app.py senza database esterni o servizi di background necessari.
Il codice completo di questo tutorial è disponibile nel mio repository GitHub.
Inizia creando una cartella di progetto e installando i due pacchetti richiesti:
mkdir deepseek-arena && cd deepseek-arena
pip install streamlit>=1.32.0 openai>=1.12.0
Qui usiamo la libreria openai perché l’API di DeepSeek è compatibile con OpenAI, il che significa che possiamo puntare il client OpenAI alla base URL di DeepSeek senza altre modifiche. Non serve un SDK specifico DeepSeek.
Ottieni una chiave API da platform.deepseek.com e impostala come variabile d’ambiente:
export DEEPSEEK_API_KEY="sk-..."Ora che l’ambiente è configurato, possiamo passare alla configurazione di modelli e modalità.
Prima di scrivere qualsiasi logica, definiamo gli import, gli identificatori dei modelli, le configurazioni delle modalità di ragionamento e le costanti di prezzo. Questi dizionari controllano il comportamento dell’intera app: dropdown del modello, parametri API che guidano ciascuna modalità di ragionamento, schema colori dell’UI e stime di costo mostrate nel pannello di confronto.
import os
import time
import concurrent.futures
from dataclasses import dataclass
from typing import Optional, Dict
import streamlit as st
from openai import OpenAI
DEEPSEEK_BASE_URL = "https://api.deepseek.com"
DEEPSEEK_API_KEY_ENV = "DEEPSEEK_API_KEY"
MODELS = {
    "DeepSeek-V4-Flash (default)": "deepseek-v4-flash",
    "DeepSeek-V4-Pro": "deepseek-v4-pro",
}
MODES: Dict[str, dict] = {
    "Non-think": {
        "icon": "",
        "color": "#10b981",
        "badge": "green",
        "desc": "Fast, direct answers — no internal reasoning",
        "thinking_type": "disabled",
        "reasoning_effort": None,
    },
    "Think High": {
        "icon": "",
        "color": "#3b82f6",
        "badge": "blue",
        "desc": "Careful step-by-step reasoning before responding",
        "thinking_type": "enabled",
        "reasoning_effort": "high",
    },
    "Think Max": {
        "icon": "",
        "color": "#ef4444",
        "badge": "red",
        "desc": "Exhaustive reasoning — push analysis to the limit",
        "thinking_type": "enabled",
        "reasoning_effort": "max",
    },
}
PRICING = {
    "deepseek-v4-flash": {
        "input_cache_hit":  0.0028,
        "input_cache_miss": 0.14,
        "output":           0.28,
    },
    "deepseek-v4-pro": {
        "input_cache_hit":  0.003625,
        "input_cache_miss": 0.435,
        "output":           0.87,
    },
}
Alcune scelte progettuali meritano di essere approfondite:
Parametri per la modalità di pensiero: Ogni voce in MODES porta due campi API invece di un system prompt. Includono thinking_type e reasoning_effort ("high", "max" o None). Il thinking_type viene passato tramite extra_body={"thinking": {"type": ...}}, e reasoning_effort è un parametro di richiesta di primo livello. Non-think imposta thinking_type su "disabled" e lascia reasoning_effort a None, quindi non viene inviato alcun corpo di pensiero.
Flash come modello predefinito: Flash attiva 13B parametri per token contro i 49B di Pro, il che rende abbastanza economiche da eseguire ripetutamente le chiamate parallele a tre vie durante la sperimentazione. Pro è disponibile tramite il dropdown quando ti serve performance di frontiera, ma Think Max su Pro consuma rapidamente la quota, quindi mantenerlo come opt-in e non come default è una precisa misura di controllo dei costi.
Nota: I valori usati nel codice sopra riflettono V4-Pro alle sue attuali promozioni scontate. Controlla sempre le tariffe correnti su api-docs.deepseek.com/quick_start/pricing prima di pubblicare confronti di costo, perché sia le tariffe base sia gli sconti promozionali cambiano spesso dopo il lancio di un nuovo modello.
La progettazione dei task è la parte più sottovalutata nella costruzione di un confronto di ragionamento. Se tutti i task sono difficili e aperti, Think Max vince sempre e la demo non insegna nulla. Il set di task deve coprire l’intero spettro di difficoltà affinché ogni modalità abbia almeno una categoria in cui vince.
TASKS = {
    "Trivial / Lookup": {
        "prompt": (
            "Complete both tasks below:\n\n"
            "Task A — Convert this JSON to YAML:\n"
            '{"name": "Alice", "age": 30, "skills": ["Python", "ML", "LLMs"],\n'
            ' "address": {"city": "San Francisco", "zip": "94105"}}\n\n'
            "Task B — Summarize this paragraph in exactly one sentence:\n"
            '"Large language models have rapidly transformed natural language processing '
            "by demonstrating unprecedented capabilities across translation, summarization, "
            "reasoning, and code generation, driven by scale and alignment techniques like RLHF "
            'that bring model outputs closer to human intent."'
        ),
        "expected_winner": "Non-think",
        "tip": "Non-think should dominate here. No reasoning is required.",
    },
    "Coding / Debugging": {
        "prompt": (
            "Find every bug in the Python code below, explain each bug clearly, "
            "and provide a fully corrected version:\n\n"
            "```python\n"
            "def binary_search(arr, target):\n"
            "    left, right = 0, len(arr)\n"
            "    while left < right:\n"
            "        mid = (left + right) // 2\n"
            "        if arr[mid] == target:\n"
            "            return mid\n"
            "        elif arr[mid] < target:\n"
            "            left = mid\n"
            "        else:\n"
            "            right = mid - 1\n"
            "    return -1\n\n"
            "print(binary_search([1, 3, 5, 7, 9], 7))\n"
            "```"
        ),
        "expected_winner": "Think High",
        "tip": "Think High usually finds the bugs and explains them well.",
    },
    "System Design": {
        "prompt": (
            "Design a scalable vector search system for 100 million documents.\n\n"
            "Address each of the following:\n"
            "1. Indexing strategy and pipeline\n"
            "2. ANN algorithm selection (HNSW vs IVF-PQ vs ScaNN — justify your choice)\n"
            "3. Sharding and replication strategy\n"
            "4. p99 query latency target (< 50 ms) — how do you hit it?\n"
            "5. Real-time document update handling\n"
            "6. Top 3 failure modes and their mitigations"
        ),
        "expected_winner": "Think High",
        "tip": "Think High often gives the best quality-per-dollar design answer.",
    },
    "Planning": {
        "prompt": (
            "Create a detailed 6-month roadmap for deploying an enterprise RAG system.\n\n"
            "Include:\n"
            "- Month-by-month phases with concrete, measurable milestones\n"
            "- Top 5 risks and mitigation strategies\n"
            "- Team roles and headcount required per phase\n"
            "- Evaluation metrics for each phase (how do you know it's working?)\n"
            "- Go / no-go production checklist"
        ),
        "expected_winner": "Think High",
        "tip": "Think High should produce a more structured, complete roadmap.",
    },
    "Math (IMO-style)": {
        "prompt": (
            "Solve this problem completely and verify your answer:\n\n"
            "Find all positive integers n such that n² + 1 is divisible by n + 1.\n\n"
            "Your answer must include:\n"
            "1. A complete proof with clear logical steps\n"
            "2. Verification with at least 3 concrete numerical examples\n"
            "3. A rigorous argument for why your solution set is complete "
            "(i.e., there are no other solutions)"
        ),
        "expected_winner": "Think Max",
        "tip": "Think Max earns its cost when thorough verification matters.",
    },
}
I cinque task mappano chiaramente alle tre modalità previste come vincitrici:
|
Task |
Vincitore previsto |
Motivazione |
|
Trivial / Lookup |
Non-think |
Nessun overhead di ragionamento necessario; il tempo di pensiero è puro spreco |
|
Coding / Debugging |
Think High |
Un passaggio di logica metodica trova tutti i bug; Max aggiunge valore marginale |
|
System Design |
Think High |
La profondità migliora la qualità; l’esaurimento non aggiunge architettura utile |
|
Planning |
Think High |
La struttura vince sul puro compute; una roadmap non è una dimostrazione |
|
Math (IMO-style) |
Think Max |
La verifica è portante; una dimostrazione sbagliata è peggio di una corretta ma lenta |
Ogni task include anche un campo expected_winner. L’app lo mostra dopo l’arrivo dei risultati, così gli utenti possono verificare se il vincitore previsto ha tenuto o è stato smentito.
Definiti i template dei task, ci serve ora una struttura per contenere i risultati di ciascuna chiamata API. Invece di passare in giro oggetti di risposta grezzi, definiamo un’unica dataclass RunResult che cattura tutte le metriche richieste dal pannello di confronto.
@dataclass
class RunResult:
    mode: str
    answer: str = ""
    thinking: str = ""
    latency: float = 0.0
    input_tokens: int = 0
    output_tokens: int = 0
    cost_usd: float = 0.0
    error: Optional[str] = None
    @property
    def tokens_per_second(self) -> Optional[float]:
        if self.latency > 0 and self.output_tokens > 0:
            return self.output_tokens / self.latency
        return None
    @property
    def thinking_word_count(self) -> int:
        return len(self.thinking.split()) if self.thinking else 0
Il campo thinking è separato da answer perché l’API di DeepSeek V4 restituisce la chain-of-thought in un campo dedicato reasoning_content, allo stesso livello di content nella struttura di risposta. Tenerli separati consente all’UI di rendere una traccia di ragionamento comprimibile accanto alla risposta finale pulita, rendendo la differenza di modalità immediata e tangibile, soprattutto nel task di matematica dove la traccia di Think Max può arrivare a migliaia di parole.
La proprietà tokens_per_second misura il throughput di generazione indipendentemente dalla lunghezza del prompt. È utile per confrontare l’efficienza tra modalità quando i token di output differiscono sensibilmente. Nota che Think Max produce naturalmente più token, quindi i soli confronti di latenza possono essere fuorvianti senza vedere anche la velocità di generazione di ciascuna modalità.
Prima di scrivere la logica delle chiamate API, definiamo due piccoli helper che si pongono tra la risposta grezza dell’SDK e RunResult. Sono facili da trascurare ma contano molto per l’accuratezza dei costi.
def get_cached_prompt_tokens(usage) -> int:
    prompt_details = getattr(usage, "prompt_tokens_details", None)
    if prompt_details is None:
        return 0
    cached_tokens = getattr(prompt_details, "cached_tokens", None)
    if cached_tokens is not None:
        return cached_tokens or 0
    if isinstance(prompt_details, dict):
        return prompt_details.get("cached_tokens", 0) or 0
    return 0
def estimate_cost_usd(
    model: str,
    prompt_tokens: int,
    completion_tokens: int,
    cached_prompt_tokens: int,
) -> float:
    pricing = PRICING.get(model, PRICING["deepseek-v4-flash"])
    cached_tokens = min(cached_prompt_tokens, prompt_tokens)
    uncached_tokens = max(prompt_tokens - cached_tokens, 0)
    return (
        cached_tokens   / 1_000_000 * pricing["input_cache_hit"]
        + uncached_tokens / 1_000_000 * pricing["input_cache_miss"]
        + completion_tokens / 1_000_000 * pricing["output"]
    )
La funzione get_cached_prompt_tokens() non fornisce accesso diretto al campo perché la struttura prompt_tokens_details non è garantita essere consistente tra versioni dell’SDK. Controlla prima un attributo tipizzato, poi ripiega sull’accesso come dict, quindi restituisce zero invece di sollevare un’eccezione. Ciò è importante dentro un ThreadPoolExecutor dove un errore silenzioso in un thread produrrebbe una stima di costo fuorviante per quella modalità senza mostrare alcun errore visibile.
L’helper estimate_cost_usd() separa i token del prompt in porzioni in cache e non in cache prima di applicare le tariffe. Poiché DeepSeek ha ridotto i prezzi per cache-hit a un decimo del tasso di miss, la differenza tra un prompt a freddo e uno a caldo può essere drastica. Su un task eseguito ripetutamente, Non-think può sembrare quasi gratuito rispetto a Think Max, non perché abbia generato meno token, ma perché il suo prompt più corto ha molte più probabilità di essere in cache calda.
Questo è il cuore architetturale dell’arena. Tutte e tre le modalità partono simultaneamente usando un ThreadPoolExecutor, quindi il tempo totale a muro equivale alla singola modalità più lenta, non alla somma delle tre.
def call_mode(client: OpenAI, model: str, mode_name: str, user_prompt: str) -> RunResult:
    result = RunResult(mode=mode_name)
    mode_cfg = MODES[mode_name]
    start = time.perf_counter()
    try:
        request_kwargs = {
            "model": model,
            "messages": [{"role": "user", "content": user_prompt}],
            "max_tokens": 4096,
            "extra_body": {"thinking": {"type": mode_cfg["thinking_type"]}},
        }
        if mode_cfg["reasoning_effort"]:
            request_kwargs["reasoning_effort"] = mode_cfg["reasoning_effort"]
        response = client.chat.completions.create(**request_kwargs)
        result.latency = time.perf_counter() - start
        message = response.choices[0].message
        result.thinking = (getattr(message, "reasoning_content", None) or "").strip()
        result.answer   = (message.content or "").strip()
        usage = response.usage
        result.input_tokens  = getattr(usage, "prompt_tokens", 0) or 0
        result.output_tokens = getattr(usage, "completion_tokens", 0) or 0
        result.cost_usd = estimate_cost_usd(
            model=model,
            prompt_tokens=result.input_tokens,
            completion_tokens=result.output_tokens,
            cached_prompt_tokens=get_cached_prompt_tokens(usage),
        )
    except Exception as exc:
        result.latency = time.perf_counter() - start
        result.error = str(exc)
    return result
def run_parallel(client: OpenAI, model: str, prompt: str) -> Dict[str, RunResult]:
    results: Dict[str, RunResult] = {}
    with concurrent.futures.ThreadPoolExecutor(max_workers=3) as pool:
        futures = {
            pool.submit(call_mode, client, model, mode_name, prompt): mode_name
            for mode_name in MODES
        }
        for fut in concurrent.futures.as_completed(futures):
            results[futures[fut]] = fut.result()
    return results
Qui vale la pena evidenziare alcune decisioni progettuali:
Costruire request_kwargs in modo condizionale: La modalità Non-think invia thinking_type: "disabled" e nessuna chiave reasoning_effort. Think High e Think Max inviano thinking_type: "enabled" e il rispettivo livello di sforzo. Il controllo if mode_cfg["reasoning_effort"] garantisce che il parametro sia omesso del tutto per Non-think invece di essere inviato come None, che potrebbe generare un errore di validazione API.
Lettura diretta di reasoning_content: La traccia della chain-of-thought è letta da message.reasoning_content usando getattr() con fallback a stringa vuota. È più robusto che fare parsing di tag <think>...</think> dalla stringa di contenuto. Usa il campo ufficiale di risposta, gestisce il caso in cui non sia emessa alcuna traccia (Non-think) e non si rompe se nell’output del modello compare la parola "think" per altri motivi.
getattr() difensivo sui campi di usage: I campi di utilizzo sono accessi con getattr(..., 0) or 0 invece di accesso diretto. Ciò significa che se l’oggetto usage manca di un campo in una versione SDK più vecchia o in una risposta insolita, il fallback produce zero anziché un’AttributeError che segnerebbe come fallita l’intera esecuzione.
Gestione degli errori: Se una chiamata fallisce, la dataclass RunResult salva la stringa d’errore invece di sollevare. L’UI controlla result.error e rende una scheda informativa senza far crollare l’esecuzione a tre modalità.
Questo step copre il layer di presentazione: layout della pagina, design system CSS, colonna dei risultati per modalità e struttura a tab che organizza il confronto senza sovraccaricare l’utente al primo caricamento.
L’app usa st.set_page_config con layout="wide" per dare abbastanza spazio orizzontale al confronto in tre colonne:
def main():
    st.set_page_config(
        page_title="DeepSeek V4 Think Mode Arena",
        layout="wide",
        initial_sidebar_state="expanded",
    )
    inject_css()
La funzione inject_css() inietta un design system completo via st.markdown. Usa uno sfondo pergamena caldo con Space Mono per gli header monospace e le chip delle metriche, e DM Sans per il testo del corpo.
def render_mode_column(result: RunResult, mode_name: str):
    cfg = MODES[mode_name]
    badge_cls = f"mode-{cfg['badge']}"
    st.markdown(
        f'<div class="mode-header {badge_cls}">{mode_name}</div>',
        unsafe_allow_html=True,
    )
    st.markdown(f'<div class="subtle-copy">{cfg["desc"]}</div>', unsafe_allow_html=True)
    if result.error:
        st.error(f"**API Error:** {result.error}")
        return
    chips = [
        ("Latency", f"{result.latency:.1f}s"),
        ("Output tokens", f"{result.output_tokens:,}"),
        ("Cost", f"${result.cost_usd:.5f}"),
    ]
    if result.tokens_per_second:
        chips.append(("Tok/s", f"{result.tokens_per_second:.0f}"))
    chip_html = "".join(
        f'<span class="metric-chip">{label} <span>{val}</span></span>'
        for label, val in chips
    )
    st.markdown(chip_html, unsafe_allow_html=True)
    if result.thinking:
        with st.expander(f" Thinking trace — {result.thinking_word_count:,} words"):
            preview = result.thinking[:5000]
            if len(result.thinking) > 5000:
                preview += "\n\n[… truncated for display …]"
            st.text(preview)
    elif mode_name != "Non-think":
        st.caption("_No thinking trace emitted_")
    st.markdown('<div class="answer-label">Final answer</div>', unsafe_allow_html=True)
    st.markdown(result.answer if result.answer else "_No answer returned._")
L’expander della traccia di pensiero è particolarmente utile perché rende la differenza tra modalità palpabile: la traccia di Think Max può arrivare a migliaia di parole di autocorrezioni e verifiche su un problema matematico difficile, mentre la modalità Non-think potrebbe non avere alcuna traccia.
Il layout principale usa i tab di Streamlit per separare le sezioni senza comprimere tutto in un’unica scrollata:
overview_tab, answers_tab, ratings_tab = st.tabs(
    ["Overview", "Full Responses", "Ratings"]
)
Il tab “Overview” mostra il riepilogo dei vincitori e la tabella delle metriche. Il tab “Full Responses” mostra il confronto affiancato in tre colonne con le tracce di pensiero, mentre “Ratings” mostra gli slider per le valutazioni qualitative dell’utente (1–5) per modalità.
Questo step finale costruisce i due componenti che vivono nel tab Overview: una tabella piatta di metriche che affianca ogni dimensione misurata e un riepilogo del vincitore che evidenzia il campione in quattro categorie distinte.
def render_metrics_table(results: Dict[str, RunResult], ratings: Dict[str, int]):
    rows = []
    for mode_name, res in results.items():
        ok = not res.error
        rows.append({
            "Mode":            mode_name,
            "Latency (s)":     f"{res.latency:.2f}" if ok else "—",
            "Input Tokens":    f"{res.input_tokens:,}" if ok else "—",
            "Output Tokens":   f"{res.output_tokens:,}" if ok else "—",
            "Tok/s":           f"{res.tokens_per_second:.0f}" if (ok and res.tokens_per_second) else "—",
            "Est. Cost (USD)": f"${res.cost_usd:.5f}" if ok else "—",
            "Thinking Words":  f"{res.thinking_word_count:,}" if ok else "—",
            "User Rating":     f"{ratings.get(mode_name)}/5" if ratings.get(mode_name) else "—",
        })
    st.table(rows)
def render_winner_summary(results: Dict[str, RunResult], ratings: Dict[str, int], expected: str):
    valid = {k: v for k, v in results.items() if not v.error}
    fastest        = min(valid, key=lambda k: valid[k].latency)
    cheapest       = min(valid, key=lambda k: valid[k].cost_usd)
    most_efficient = max(
        valid,
        key=lambda k: valid[k].output_tokens / max(valid[k].cost_usd, 1e-9),
    )
    top_rated = max(ratings, key=ratings.get) if ratings else None
Ecco uno sguardo rapido a cosa fanno queste due funzioni:
La funzione render_metrics_table() itera su ogni RunResult e costruisce un dizionario di riga per ciascuna modalità. Le otto colonne coprono l’intero confronto, includendo tempo (latenza, tok/s), scala (token di input e output, parole della traccia), denaro (costo stimato) e giudizio umano (valutazione utente).
La funzione render_winner_summary() filtra prima le esecuzioni fallite prima di calcolare i vincitori, così un singolo errore API non distorce i risultati. Trova poi il campione in quattro dimensioni indipendenti come velocità a muro, costo grezzo, efficienza di output e valutazione utente.
Queste quattro categorie sono intenzionalmente tenute separate invece di essere combinate in un unico punteggio perché un composito pesato richiederebbe che l’app decidesse che la latenza conta più del costo, che è una decisione di prodotto, non di framework.
L’app inoltre mostra il vincitore previsto per task, invitando l’utente a confermare se ha coinciso:
st.markdown(
    f"> **Expected winner for this task type:** {expected} — "
    "does your result match? Rate answers to confirm.",
)L’intera app vive in un singolo file app.py con due dipendenze, e avviarla richiede due comandi:
# Set your API key
export DEEPSEEK_API_KEY="sk-..."
# Run
streamlit run app.py
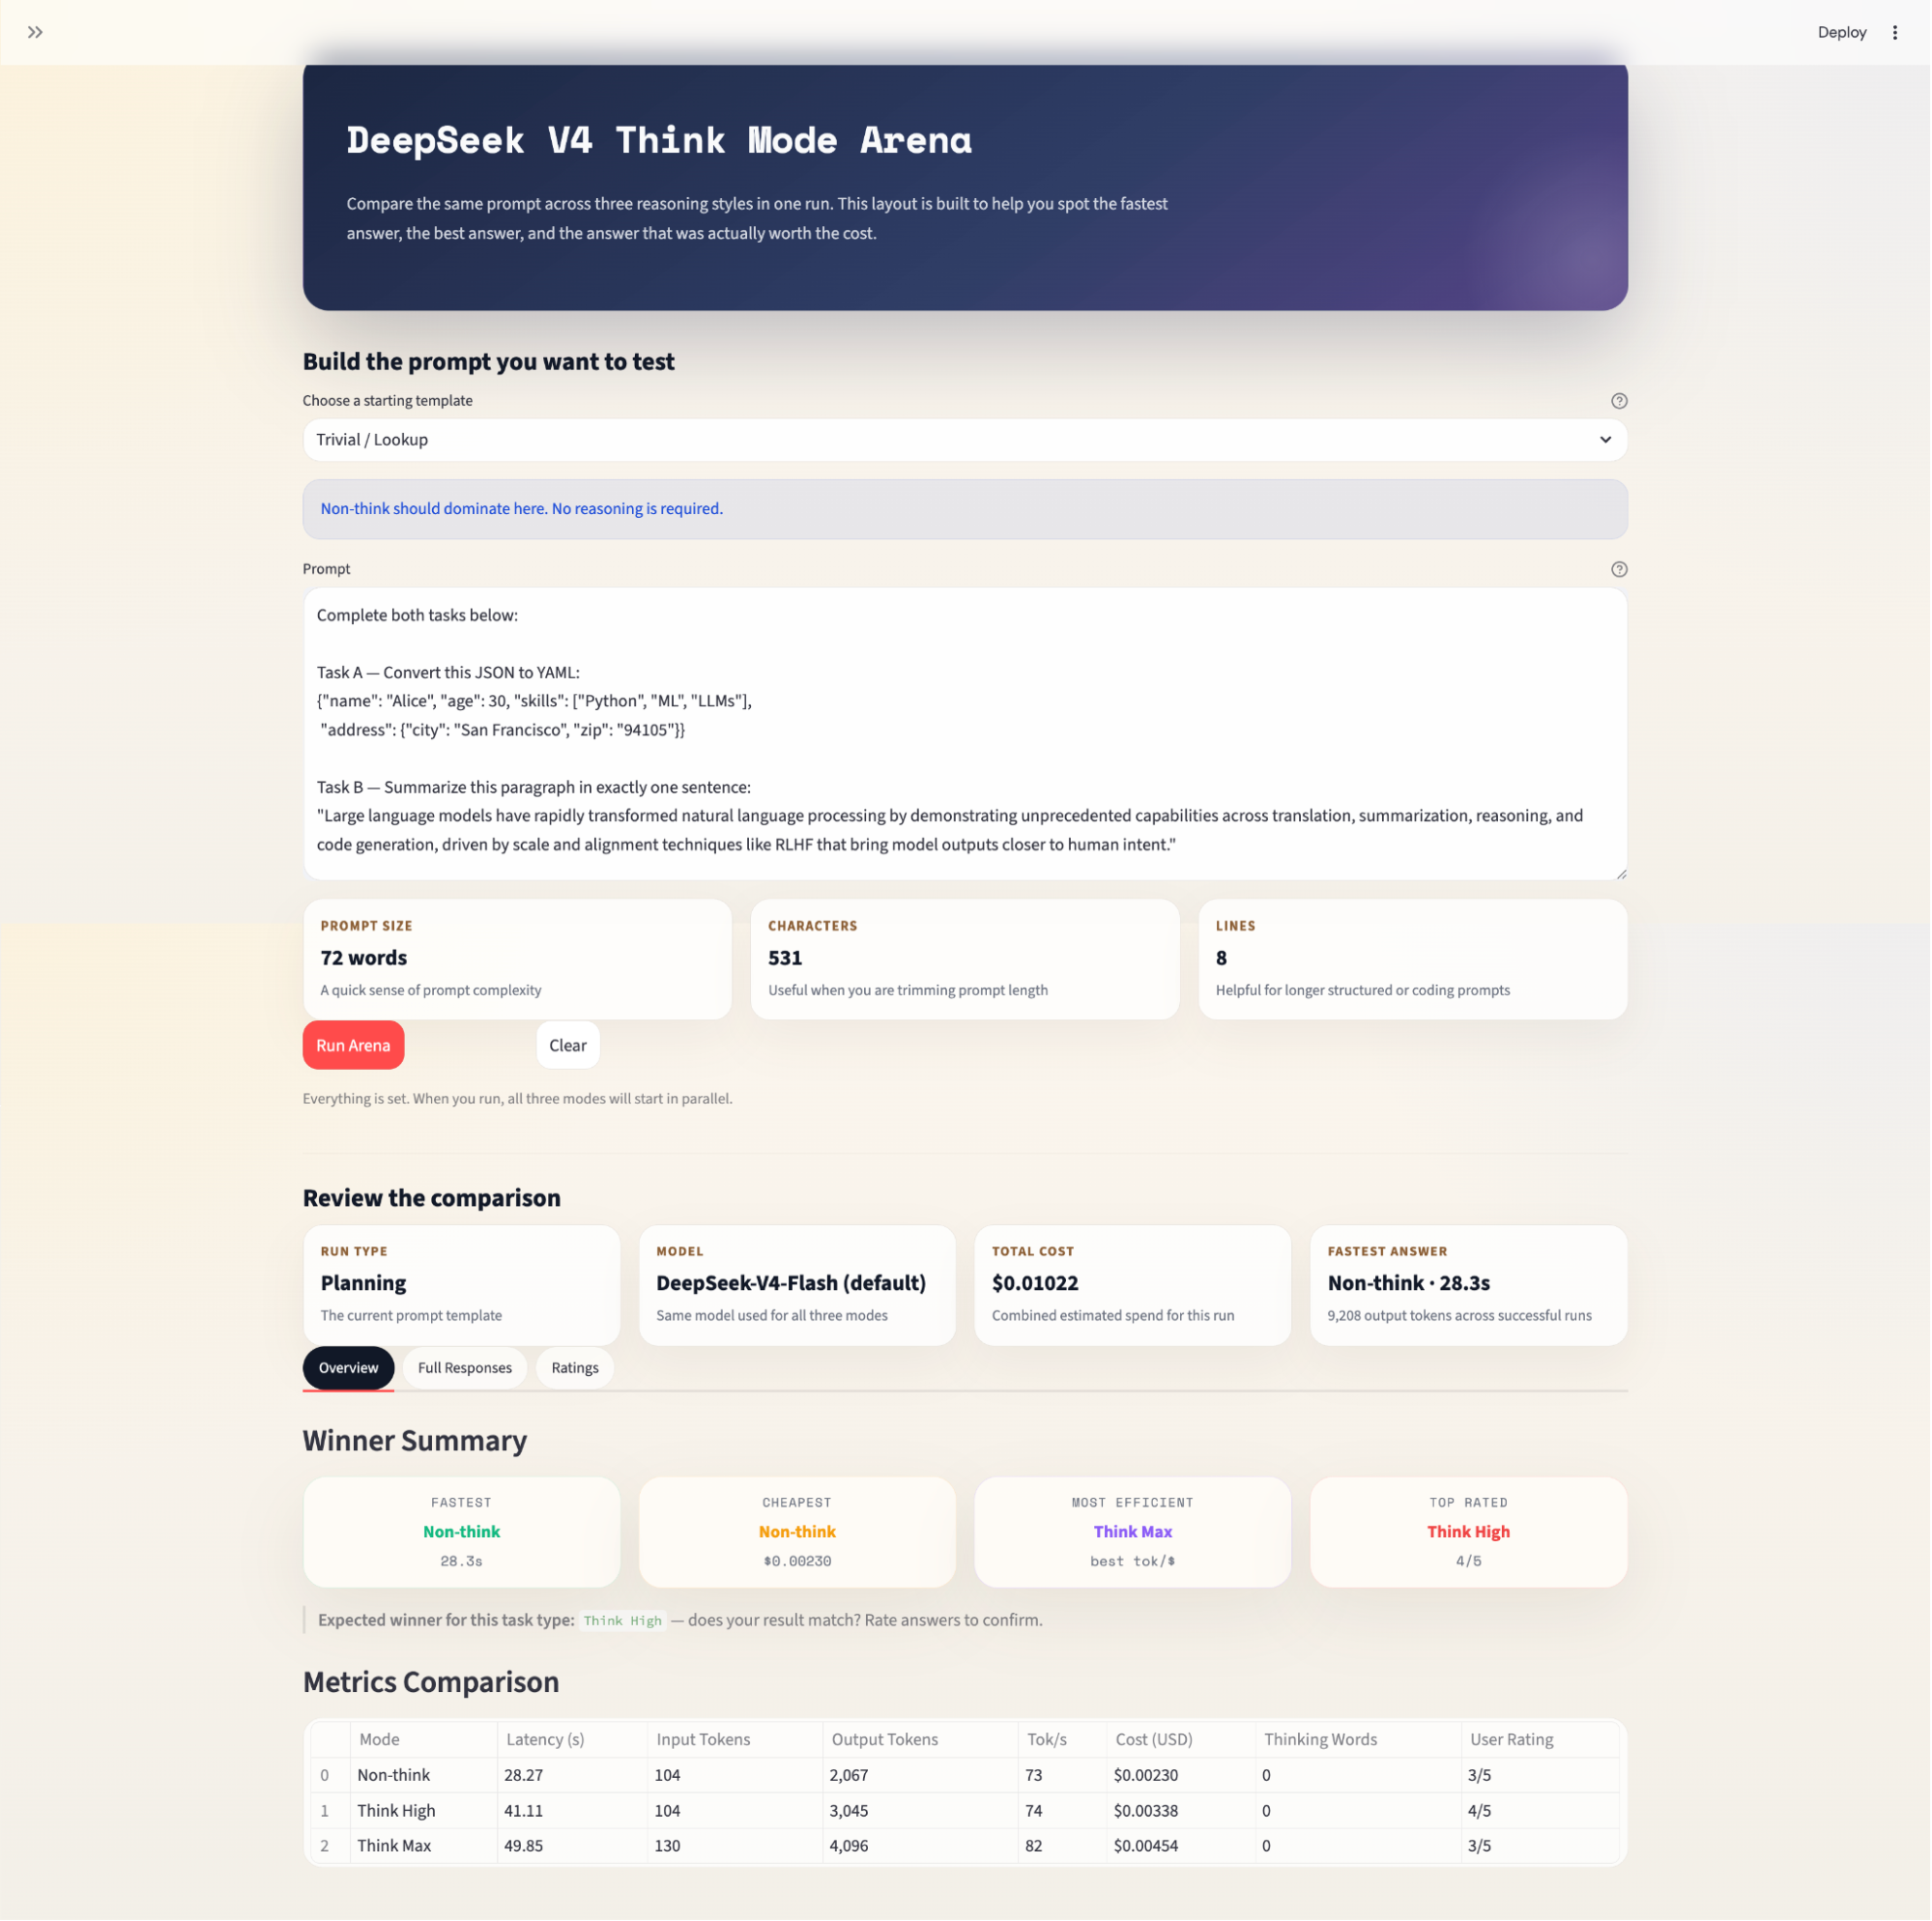
L’app si apre nel browser su localhost:8501. Seleziona un template di task dal menu a tendina, modifica facoltativamente il prompt e clicca su Run Arena. Una barra di avanzamento si aggiorna man mano che ogni modalità completa. I risultati sono memorizzati in st.session_state così puoi cambiare tab e valutare le risposte senza innescare un nuovo run.
Nota sui prezzi: DeepSeek ha modificato in modo significativo le tariffe dell’API V4 dal lancio. V4-Pro è attualmente in promozione, e i prezzi per cache-hit sono stati ridotti a un decimo del tasso di miss nell’aprile 2026. Le cifre di costo mostrate nell’app riflettono queste tariffe attuali ma possono cambiare. Verifica sempre su api-docs.deepseek.com/quick_start/pricing prima di usare qualsiasi modello.
In questo tutorial, abbiamo costruito un’app Streamlit che esegue lo stesso prompt nelle tre modalità di ragionamento di DeepSeek V4 in parallelo e confronta i risultati su latenza, costo, uso dei token, profondità della traccia di pensiero e qualità valutata dagli utenti. Le scelte architetturali chiave sono state:
ThreadPoolExecutor per un vero parallelismo, che significa che il tempo totale a muro equivale alla modalità più lenta invece che alla somma di tutte e tre
I parametri API thinking e reasoning_effort aiutano a garantire che il controllo della modalità sia pulito, esplicito e allineato all’API di DeepSeek invece di basarsi su system prompt
La stima dei costi consapevole della cache aiuta a separare i token di input in porzioni cache-hit e cache-miss, producendo cifre di costo materialmente più accurate, soprattutto su run ripetuti in cui gli sconti da cache calda possono far sembrare Non-think quasi gratuito
Per estendere ulteriormente il progetto, considera di aggiungere un layer LLM-as-judge (usando un modello separato come Claude o GPT-4 per valutare automaticamente le risposte), fare caching delle risposte sull’hash del prompt per evitare di rieseguire query identiche, o aggiungere un asse cross-model che metta a confronto Flash Think Max con Pro Think High, una domanda di reale parità di costo che il paper V4 solleva ma non risponde completamente.
Corsi AI consigliati
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



