

O que é o DeepSeek V4?
DeepSeek V4 é a nova geração de modelos de linguagem Mixture-of-Experts (MoE) da DeepSeek AI. A série inclui duas variantes:
- DeepSeek-V4-Pro: tem 1,6T de parâmetros totais (49B ativados) e suporta contexto de 1 M de tokens.
- DeepSeek-V4-Flash: a versão menor tem 284B de parâmetros totais (13B ativados), também com janela de contexto de 1M de tokens.
Várias melhorias de arquitetura distinguem o V4 de seus predecessores:
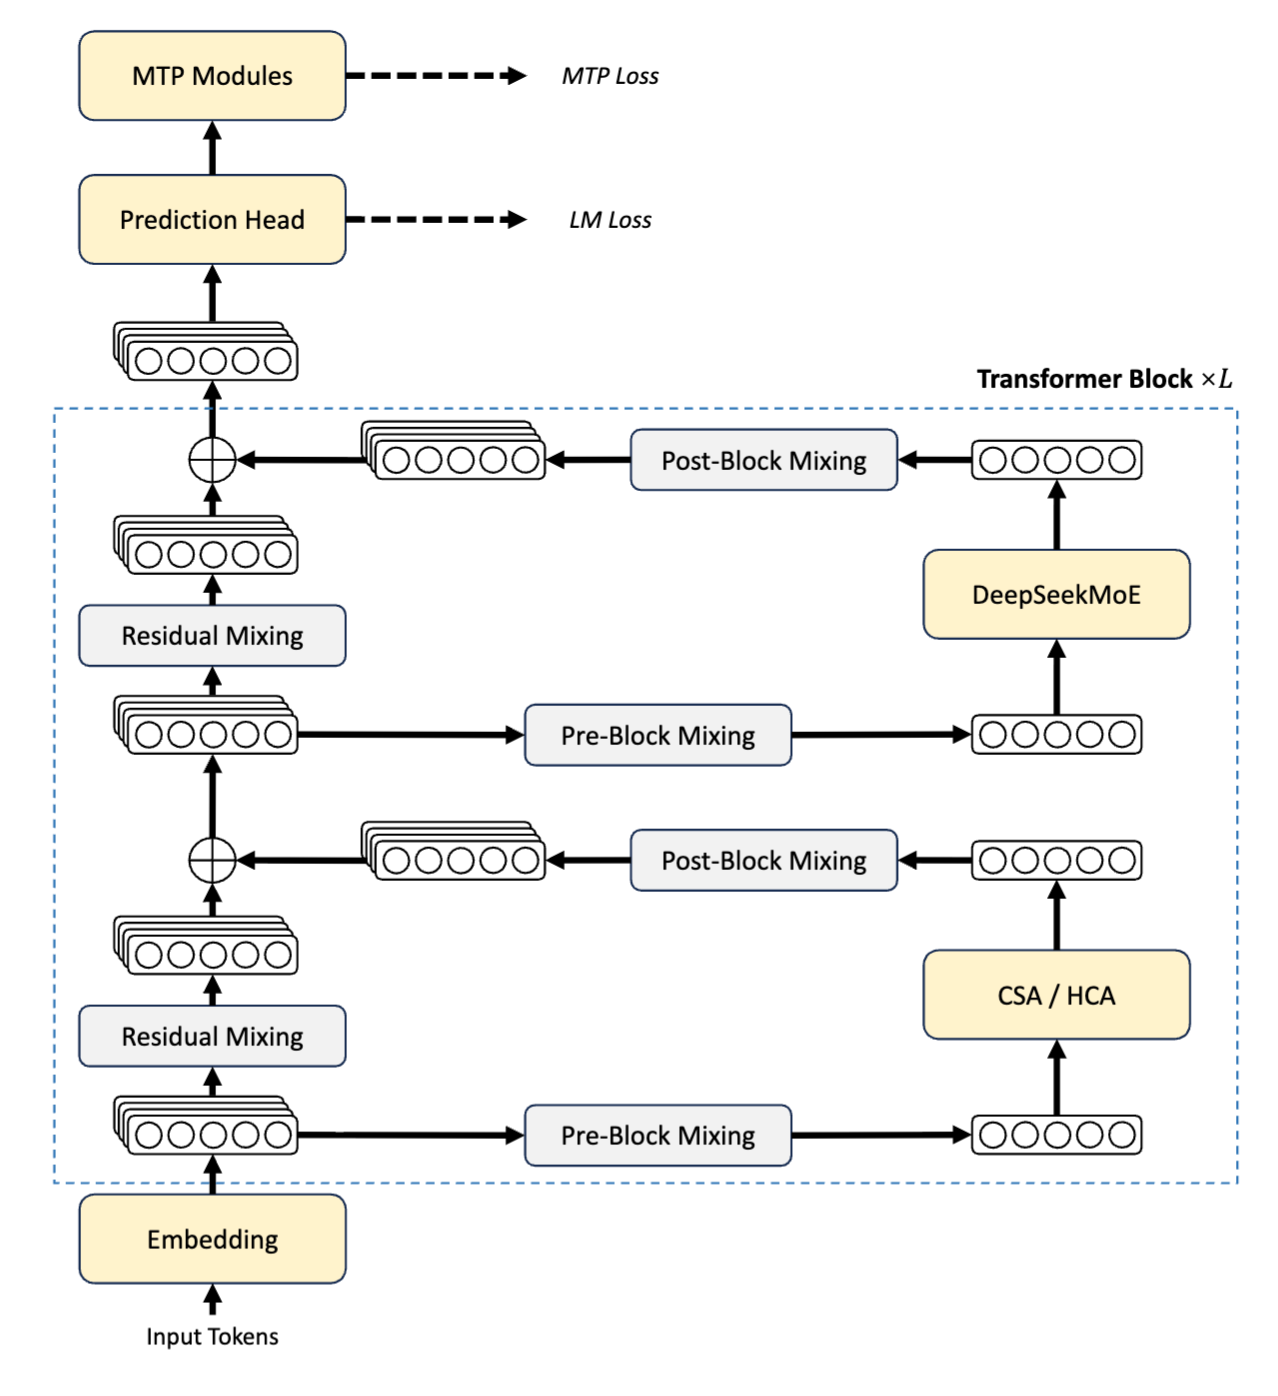
Figura: arquitetura da série DeepSeek V4 (relatório técnico da DeepSeek)
- Arquitetura de atenção híbrida (CSA / HCA): o caminho da direita (na figura acima) em cada bloco começa com Compressed Sparse Attention (CSA) e Heavily Compressed Attention (HCA). Em vez de prestar atenção a todo token em toda camada, esses mecanismos comprimem seletivamente o cálculo de atenção. Em um contexto de 1M de tokens, isso significa que o DeepSeek-V4-Pro requer apenas 27% dos FLOPs de inferência por token e 10% do cache KV em comparação com o DeepSeek-V3.2. A saída de atenção é roteada por Pre-Block e Post-Block Mixing antes de ser somada de volta ao estado oculto principal via conexão residual.
- DeepSeekMoE: após a atenção, o mesmo caminho alimenta a camada DeepSeekMoE, onde o componente Mixture-of-Experts ativa apenas um subconjunto de parâmetros por token. É isso que faz os 284B parâmetros totais do V4-Flash se comportarem como um modelo de 13B em tempo de inferência, e os 1,6T do V4-Pro se comportarem como um modelo de 49B.
- Manifold-Constrained Hyper-Connections (mHC): o caminho da esquerda (na figura acima) mostra as representações do estado oculto empilhadas passando por Residual Mixing na base e no topo de cada bloco. Essas são as camadas mHC, onde um substituto das conexões residuais padrão restringe as atualizações a um variety aprendido, melhorando a estabilidade do gradiente em pilhas profundas sem sacrificar expressividade.
- Otimizador Muon: Muon (não visível no diagrama) substitui o AdamW para a maioria dos parâmetros com uma regra de atualização inspirada em segunda ordem que entrega convergência mais rápida e curvas de loss mais estáveis nas escalas em que o V4 é treinado.
Ambos os modelos suportam três modos distintos de esforço de raciocínio, Non-think, Think High e Think Max, que vamos explorar e comparar neste tutorial.
Pontuações de benchmark do DeepSeek V4
A equipe DeepSeek comparou o desempenho do V4 com seus pares, e aqui está o que encontrou:
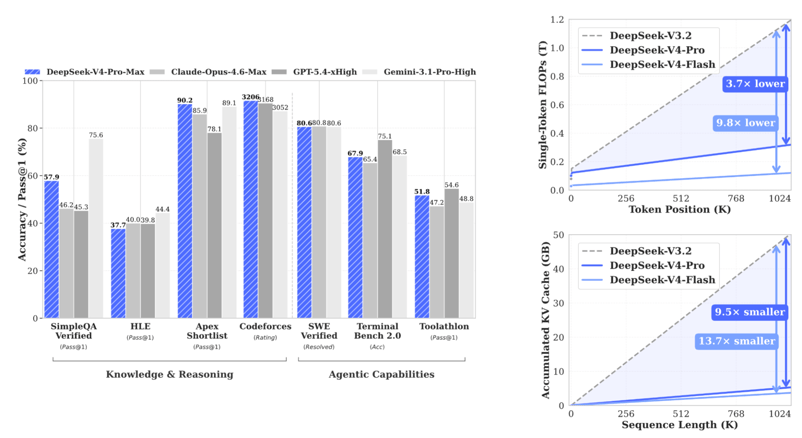
Figura: desempenho de benchmark da série DeepSeek V4 (relatório técnico da DeepSeek)
O gráfico de barras à esquerda mostra onde o V4-Pro-Max fica em relação a modelos fechados de ponta em tarefas de conhecimento, raciocínio e agentes. Os dois gráficos à direita mostram por que os ganhos de eficiência importam — e são os resultados mais surpreendentes. O DeepSeek-V4-Pro-Max (o modo de raciocínio Think Max) obtém resultados competitivos contra modelos fechados de fronteira:
|
Benchmark |
DeepSeek-V4-Pro Max |
Claude Opus 4.6 Max |
Gemini-3.1-Pro High |
|
LiveCodeBench (Pass@1) |
93,5 |
88,8 |
91,7 |
|
Codeforces Rating |
3206 |
— |
3052 |
|
GPQA Diamond (Pass@1) |
90,1 |
91,3 |
94,3 |
|
SWE Verified (Resolved) |
80,6 |
80,8 |
80,6 |
A pontuação Codeforces de 3206 coloca o V4-Pro-Max no nível Legendary Grandmaster, tornando as tarefas de código na nossa arena um teste de estresse realmente interessante.
Entendendo os três modos de raciocínio
Antes de construir o app, vale entender o que cada modo faz:
Non-think: o modelo responde diretamente, sem uma cadeia interna de pensamento. Ideal quando a velocidade importa mais que a profundidade, como conversões de formato, buscas simples e resumos em uma frase.Think High: o modelo raciocina passo a passo antes de chegar à resposta. Bom equilíbrio entre profundidade e custo para tarefas moderadamente complexas como debugging, desenho de sistemas e planejamento.Think Max: o modelo leva o raciocínio ao máximo, explora múltiplas abordagens, verifica a lógica com rigor e só entrega a resposta final quando está seguro. É o melhor para provas matemáticas difíceis, refatorações complexas com vários arquivos ou qualquer tarefa em que uma resposta errada e confiante é pior do que uma resposta correta e mais lenta.
O ponto crítico deste tutorial é que Think Max nem sempre vence. Em tarefas triviais, desperdiça computação para qualidade idêntica. A meta da arena é mostrar qual modo realmente vale a pena para cada tipo de tarefa, com base em latência real, contagem de tokens, custo e avaliações de usuários.
Se você quer ver como o modelo se compara a outros LLMs de ponta, leia nossos artigos sobre Claude Opus 4.7 vs DeepSeek V4 e GPT-5.5 vs DeepSeek V4.
Tutorial: construindo uma Think Mode Arena com o DeepSeek V4
Neste tutorial, vamos criar um app em Streamlit que:
-
Recebe um prompt e uma categoria de tarefa do usuário
-
Dispara três chamadas de API em paralelo, uma por modo de raciocínio, usando
ThreadPoolExecutordo Python -
Analisa trilhas de raciocínio dos blocos
<think>...</think>na saída do modelo -
Acompanha latência, contagem de tokens e custo estimado por modo
-
Apresenta uma comparação lado a lado com métricas, sistema de avaliação do usuário e um resumo do vencedor
O app completo funciona em um único arquivo app.py, sem bancos de dados externos nem serviços em background.
O código completo deste tutorial está no meu repositório no GitHub.
Passo 1: configuração do projeto e dependências
Comece criando a pasta do projeto e instalando os dois pacotes necessários:
mkdir deepseek-arena && cd deepseek-arena
pip install streamlit>=1.32.0 openai>=1.12.0A biblioteca openai é usada porque a API do DeepSeek é compatível com a da OpenAI, o que permite apontar o cliente da OpenAI para a base URL do DeepSeek sem outras mudanças. Não é necessário um SDK específico do DeepSeek.
Obtenha uma chave de API em platform.deepseek.com e defina-a como variável de ambiente:
export DEEPSEEK_API_KEY="sk-..."Com o ambiente pronto, vamos configurar modelos e modos.
Passo 2: configuração — modelos, modos e preços
Antes da lógica, definimos imports, identificadores de modelos, configurações dos modos de raciocínio e constantes de preços. Esses dicionários controlam o comportamento do app: dropdown de modelos, parâmetros da API que conduzem cada modo, esquema de cores da UI e estimativas de custo exibidas no painel de comparação.
import os
import time
import concurrent.futures
from dataclasses import dataclass
from typing import Optional, Dict
import streamlit as st
from openai import OpenAI
DEEPSEEK_BASE_URL = "https://api.deepseek.com"
DEEPSEEK_API_KEY_ENV = "DEEPSEEK_API_KEY"
MODELS = {
"DeepSeek-V4-Flash (default)": "deepseek-v4-flash",
"DeepSeek-V4-Pro": "deepseek-v4-pro",
}
MODES: Dict[str, dict] = {
"Non-think": {
"icon": "",
"color": "#10b981",
"badge": "green",
"desc": "Fast, direct answers — no internal reasoning",
"thinking_type": "disabled",
"reasoning_effort": None,
},
"Think High": {
"icon": "",
"color": "#3b82f6",
"badge": "blue",
"desc": "Careful step-by-step reasoning before responding",
"thinking_type": "enabled",
"reasoning_effort": "high",
},
"Think Max": {
"icon": "",
"color": "#ef4444",
"badge": "red",
"desc": "Exhaustive reasoning — push analysis to the limit",
"thinking_type": "enabled",
"reasoning_effort": "max",
},
}
PRICING = {
"deepseek-v4-flash": {
"input_cache_hit": 0.0028,
"input_cache_miss": 0.14,
"output": 0.28,
},
"deepseek-v4-pro": {
"input_cache_hit": 0.003625,
"input_cache_miss": 0.435,
"output": 0.87,
},
}Algumas escolhas de design valem o destaque:
-
Parâmetros do modo de raciocínio: cada entrada em
MODEScarrega dois campos de API em vez de um system prompt. São elesthinking_typeereasoning_effort("high","max"ouNone). Othinking_typeé passado viaextra_body={"thinking": {"type": ...}}, ereasoning_efforté um parâmetro de nível superior. Non-think definethinking_typecomo "disabled"e deixareasoning_effortcomoNone, então nenhum corpo de pensamento é enviado. -
Flash como modelo padrão: o Flash ativa 13B parâmetros por token versus 49B do Pro, o que torna as três chamadas paralelas baratas o suficiente para repetição em experimentos. O Pro está no dropdown quando você precisa de performance de ponta, mas
Think Maxno Pro consome cota rapidamente — mantê-lo como opt-in em vez de padrão é um limitador de custo deliberado.
Observação: os valores no código acima refletem o V4-Pro com o desconto promocional atual. Sempre verifique as tarifas em api-docs.deepseek.com/quick_start/pricing antes de publicar comparações de custo, pois taxas base e descontos promocionais mudam com frequência após o lançamento de um novo modelo.
Passo 3: templates de tarefas
O design das tarefas é a parte mais subestimada ao construir uma comparação de raciocínio. Se todas as tarefas forem difíceis e abertas, Think Max vence sempre — e o demo não ensina nada. O conjunto de tarefas deve cobrir toda a faixa de dificuldade para que cada modo tenha pelo menos uma categoria em que vença.
TASKS = {
"Trivial / Lookup": {
"prompt": (
"Complete both tasks below:\n\n"
"Task A — Convert this JSON to YAML:\n"
'{"name": "Alice", "age": 30, "skills": ["Python", "ML", "LLMs"],\n'
' "address": {"city": "San Francisco", "zip": "94105"}}\n\n'
"Task B — Summarize this paragraph in exactly one sentence:\n"
'"Large language models have rapidly transformed natural language processing '
"by demonstrating unprecedented capabilities across translation, summarization, "
"reasoning, and code generation, driven by scale and alignment techniques like RLHF "
'that bring model outputs closer to human intent."'
),
"expected_winner": "Non-think",
"tip": "Non-think should dominate here. No reasoning is required.",
},
"Coding / Debugging": {
"prompt": (
"Find every bug in the Python code below, explain each bug clearly, "
"and provide a fully corrected version:\n\n"
"```python\n"
"def binary_search(arr, target):\n"
" left, right = 0, len(arr)\n"
" while left < right:\n"
" mid = (left + right) // 2\n"
" if arr[mid] == target:\n"
" return mid\n"
" elif arr[mid] < target:\n"
" left = mid\n"
" else:\n"
" right = mid - 1\n"
" return -1\n\n"
"print(binary_search([1, 3, 5, 7, 9], 7))\n"
"```"
),
"expected_winner": "Think High",
"tip": "Think High usually finds the bugs and explains them well.",
},
"System Design": {
"prompt": (
"Design a scalable vector search system for 100 million documents.\n\n"
"Address each of the following:\n"
"1. Indexing strategy and pipeline\n"
"2. ANN algorithm selection (HNSW vs IVF-PQ vs ScaNN — justify your choice)\n"
"3. Sharding and replication strategy\n"
"4. p99 query latency target (< 50 ms) — how do you hit it?\n"
"5. Real-time document update handling\n"
"6. Top 3 failure modes and their mitigations"
),
"expected_winner": "Think High",
"tip": "Think High often gives the best quality-per-dollar design answer.",
},
"Planning": {
"prompt": (
"Create a detailed 6-month roadmap for deploying an enterprise RAG system.\n\n"
"Include:\n"
"- Month-by-month phases with concrete, measurable milestones\n"
"- Top 5 risks and mitigation strategies\n"
"- Team roles and headcount required per phase\n"
"- Evaluation metrics for each phase (how do you know it's working?)\n"
"- Go / no-go production checklist"
),
"expected_winner": "Think High",
"tip": "Think High should produce a more structured, complete roadmap.",
},
"Math (IMO-style)": {
"prompt": (
"Solve this problem completely and verify your answer:\n\n"
"Find all positive integers n such that n² + 1 is divisible by n + 1.\n\n"
"Your answer must include:\n"
"1. A complete proof with clear logical steps\n"
"2. Verification with at least 3 concrete numerical examples\n"
"3. A rigorous argument for why your solution set is complete "
"(i.e., there are no other solutions)"
),
"expected_winner": "Think Max",
"tip": "Think Max earns its cost when thorough verification matters.",
},
}As cinco tarefas se conectam bem aos três vencedores esperados:
|
Tarefa |
Vencedor esperado |
Raciocínio |
|
Trivial / Lookup |
Non-think |
Nenhuma sobrecarga de raciocínio é necessária; pensar aqui é desperdício |
|
Coding / Debugging |
Think High |
Uma passada metódica pega todos os bugs; Max agrega pouco valor |
|
System Design |
Think High |
Mais profundidade melhora a qualidade; exaustão não cria melhor arquitetura |
|
Planning |
Think High |
Estrutura importa mais que computação bruta; um roadmap não é uma prova |
|
Math (IMO-style) |
Think Max |
Verificação é crítica; uma prova errada é pior que uma correta mais lenta |
Cada tarefa também traz um campo expected_winner. O app exibe isso após os resultados, para você conferir se o vencedor esperado se confirmou ou foi derrotado.
Passo 4: data class
Com os templates definidos, precisamos de uma estrutura para armazenar os resultados de cada chamada de API. Em vez de passar respostas brutas pelo app, definimos uma única dataclass RunResult que captura todas as métricas necessárias para o painel de comparação.
@dataclass
class RunResult:
mode: str
answer: str = ""
thinking: str = ""
latency: float = 0.0
input_tokens: int = 0
output_tokens: int = 0
cost_usd: float = 0.0
error: Optional[str] = None
@property
def tokens_per_second(self) -> Optional[float]:
if self.latency > 0 and self.output_tokens > 0:
return self.output_tokens / self.latency
return None
@property
def thinking_word_count(self) -> int:
return len(self.thinking.split()) if self.thinking else 0O campo thinking é separado de answer porque a API do DeepSeek V4 retorna a chain-of-thought em um campo dedicado, reasoning_content, no mesmo nível de content. Mantê-los separados permite renderizar a trilha de raciocínio recolhível ao lado da resposta final, tornando a diferença entre modos imediata e tangível — especialmente em matemática, onde o Think Max pode gerar milhares de palavras.
A propriedade tokens_per_second mede throughput de geração independentemente do tamanho do prompt. Isso ajuda a comparar eficiência entre modos quando a saída varia bastante. Note que Think Max naturalmente produz mais tokens, então comparar só latência pode enganar sem ver também a velocidade de geração.
Passo 5: auxiliares de estimativa de custo
Antes da lógica de chamada à API, definimos dois helpers que ficam entre a resposta do SDK e o RunResult. São fáceis de ignorar, mas fazem diferença para a precisão de custo.
def get_cached_prompt_tokens(usage) -> int:
prompt_details = getattr(usage, "prompt_tokens_details", None)
if prompt_details is None:
return 0
cached_tokens = getattr(prompt_details, "cached_tokens", None)
if cached_tokens is not None:
return cached_tokens or 0
if isinstance(prompt_details, dict):
return prompt_details.get("cached_tokens", 0) or 0
return 0
def estimate_cost_usd(
model: str,
prompt_tokens: int,
completion_tokens: int,
cached_prompt_tokens: int,
) -> float:
pricing = PRICING.get(model, PRICING["deepseek-v4-flash"])
cached_tokens = min(cached_prompt_tokens, prompt_tokens)
uncached_tokens = max(prompt_tokens - cached_tokens, 0)
return (
cached_tokens / 1_000_000 * pricing["input_cache_hit"]
+ uncached_tokens / 1_000_000 * pricing["input_cache_miss"]
+ completion_tokens / 1_000_000 * pricing["output"]
)A função get_cached_prompt_tokens() não acessa o campo diretamente porque a estrutura prompt_tokens_details pode variar entre versões do SDK. Ela tenta um atributo tipado, cai para dict e, se nada existir, retorna zero em vez de lançar exceção. Isso importa no ThreadPoolExecutor, onde um erro silencioso em uma thread pode gerar custo subestimado para um modo sem evidência visível.
O helper estimate_cost_usd() separa os tokens de prompt em partes com cache e sem cache antes de aplicar as tarifas. Como o DeepSeek reduziu o preço de cache-hit a um décimo do miss, a diferença entre prompt frio e quente pode ser enorme. Em execuções repetidas, Non-think pode parecer quase grátis comparado ao Think Max — não por gerar menos tokens, mas porque seu prompt menor tende a estar com cache aquecido.
Passo 6: execução paralela da API
Este é o núcleo da arena. Os três modos disparam simultaneamente usando ThreadPoolExecutor, então o tempo total de execução é igual ao do modo mais lento — e não a soma dos três.
def call_mode(client: OpenAI, model: str, mode_name: str, user_prompt: str) -> RunResult:
result = RunResult(mode=mode_name)
mode_cfg = MODES[mode_name]
start = time.perf_counter()
try:
request_kwargs = {
"model": model,
"messages": [{"role": "user", "content": user_prompt}],
"max_tokens": 4096,
"extra_body": {"thinking": {"type": mode_cfg["thinking_type"]}},
}
if mode_cfg["reasoning_effort"]:
request_kwargs["reasoning_effort"] = mode_cfg["reasoning_effort"]
response = client.chat.completions.create(**request_kwargs)
result.latency = time.perf_counter() - start
message = response.choices[0].message
result.thinking = (getattr(message, "reasoning_content", None) or "").strip()
result.answer = (message.content or "").strip()
usage = response.usage
result.input_tokens = getattr(usage, "prompt_tokens", 0) or 0
result.output_tokens = getattr(usage, "completion_tokens", 0) or 0
result.cost_usd = estimate_cost_usd(
model=model,
prompt_tokens=result.input_tokens,
completion_tokens=result.output_tokens,
cached_prompt_tokens=get_cached_prompt_tokens(usage),
)
except Exception as exc:
result.latency = time.perf_counter() - start
result.error = str(exc)
return result
def run_parallel(client: OpenAI, model: str, prompt: str) -> Dict[str, RunResult]:
results: Dict[str, RunResult] = {}
with concurrent.futures.ThreadPoolExecutor(max_workers=3) as pool:
futures = {
pool.submit(call_mode, client, model, mode_name, prompt): mode_name
for mode_name in MODES
}
for fut in concurrent.futures.as_completed(futures):
results[futures[fut]] = fut.result()
return resultsAlgumas decisões de design importantes:
-
Construção condicional de
request_kwargs: o modoNon-thinkenviathinking_type: "disabled"e não enviareasoning_effort.Think HigheThink Maxenviamthinking_type: "enabled"e seu esforço correspondente. O guardif mode_cfg["reasoning_effort"]garante omitir totalmente o parâmetro emNon-think, evitando erro de validação por enviarNone. -
Leitura direta de
reasoning_content: a chain-of-thought é lida demessage.reasoning_contentviagetattr()com fallback para string vazia. É mais robusto do que analisar tags<think>...</think>no conteúdo. Usa o campo oficial, lida com casos sem trilha (Non-think) e não quebra se a palavra "think" aparecer em outro contexto. -
getattr()defensivo em usage: os campos de uso são acessados comgetattr(..., 0) or 0. Se o objeto estiver faltando um campo em SDKs antigos ou respostas incomuns, o fallback produz zero em vez deAttributeError, que invalidaria toda a execução. -
Tratamento de erros: se uma chamada falhar, a dataclass
RunResultguarda a mensagem de erro. A UI checaresult.errore renderiza um card informativo sem derrubar a execução dos três modos.
Passo 7: UI e CSS no Streamlit
Aqui está a camada de apresentação: layout da página, sistema de design em CSS, coluna de resultados por modo e a estrutura de abas que organiza a comparação sem sobrecarregar o usuário no primeiro carregamento.
O app usa st.set_page_config com layout="wide" para dar espaço horizontal suficiente à comparação em três colunas:
def main():
st.set_page_config(
page_title="DeepSeek V4 Think Mode Arena",
layout="wide",
initial_sidebar_state="expanded",
)
inject_css()A função inject_css() injeta um design system completo via st.markdown. Ela usa um fundo tipo pergaminho, Space Mono para cabeçalhos monoespaçados e chips de métricas, e DM Sans no corpo do texto.
def render_mode_column(result: RunResult, mode_name: str):
cfg = MODES[mode_name]
badge_cls = f"mode-{cfg['badge']}"
st.markdown(
f'<div class="mode-header {badge_cls}">{mode_name}</div>',
unsafe_allow_html=True,
)
st.markdown(f'<div class="subtle-copy">{cfg["desc"]}</div>', unsafe_allow_html=True)
if result.error:
st.error(f"**API Error:** {result.error}")
return
chips = [
("Latency", f"{result.latency:.1f}s"),
("Output tokens", f"{result.output_tokens:,}"),
("Cost", f"${result.cost_usd:.5f}"),
]
if result.tokens_per_second:
chips.append(("Tok/s", f"{result.tokens_per_second:.0f}"))
chip_html = "".join(
f'<span class="metric-chip">{label} <span>{val}</span></span>'
for label, val in chips
)
st.markdown(chip_html, unsafe_allow_html=True)
if result.thinking:
with st.expander(f" Thinking trace — {result.thinking_word_count:,} words"):
preview = result.thinking[:5000]
if len(result.thinking) > 5000:
preview += "\n\n[… truncated for display …]"
st.text(preview)
elif mode_name != "Non-think":
st.caption("_No thinking trace emitted_")
st.markdown('<div class="answer-label">Final answer</div>', unsafe_allow_html=True)
st.markdown(result.answer if result.answer else "_No answer returned._")O expansor da trilha de raciocínio torna a diferença entre modos muito clara: o Think Max pode trazer milhares de palavras de autocorreção e verificação em um problema difícil, enquanto Non-think pode não ter trilha alguma.
O layout principal usa abas do Streamlit para separar as seções sem apertar tudo em um único scroll:
overview_tab, answers_tab, ratings_tab = st.tabs(
["Overview", "Full Responses", "Ratings"]
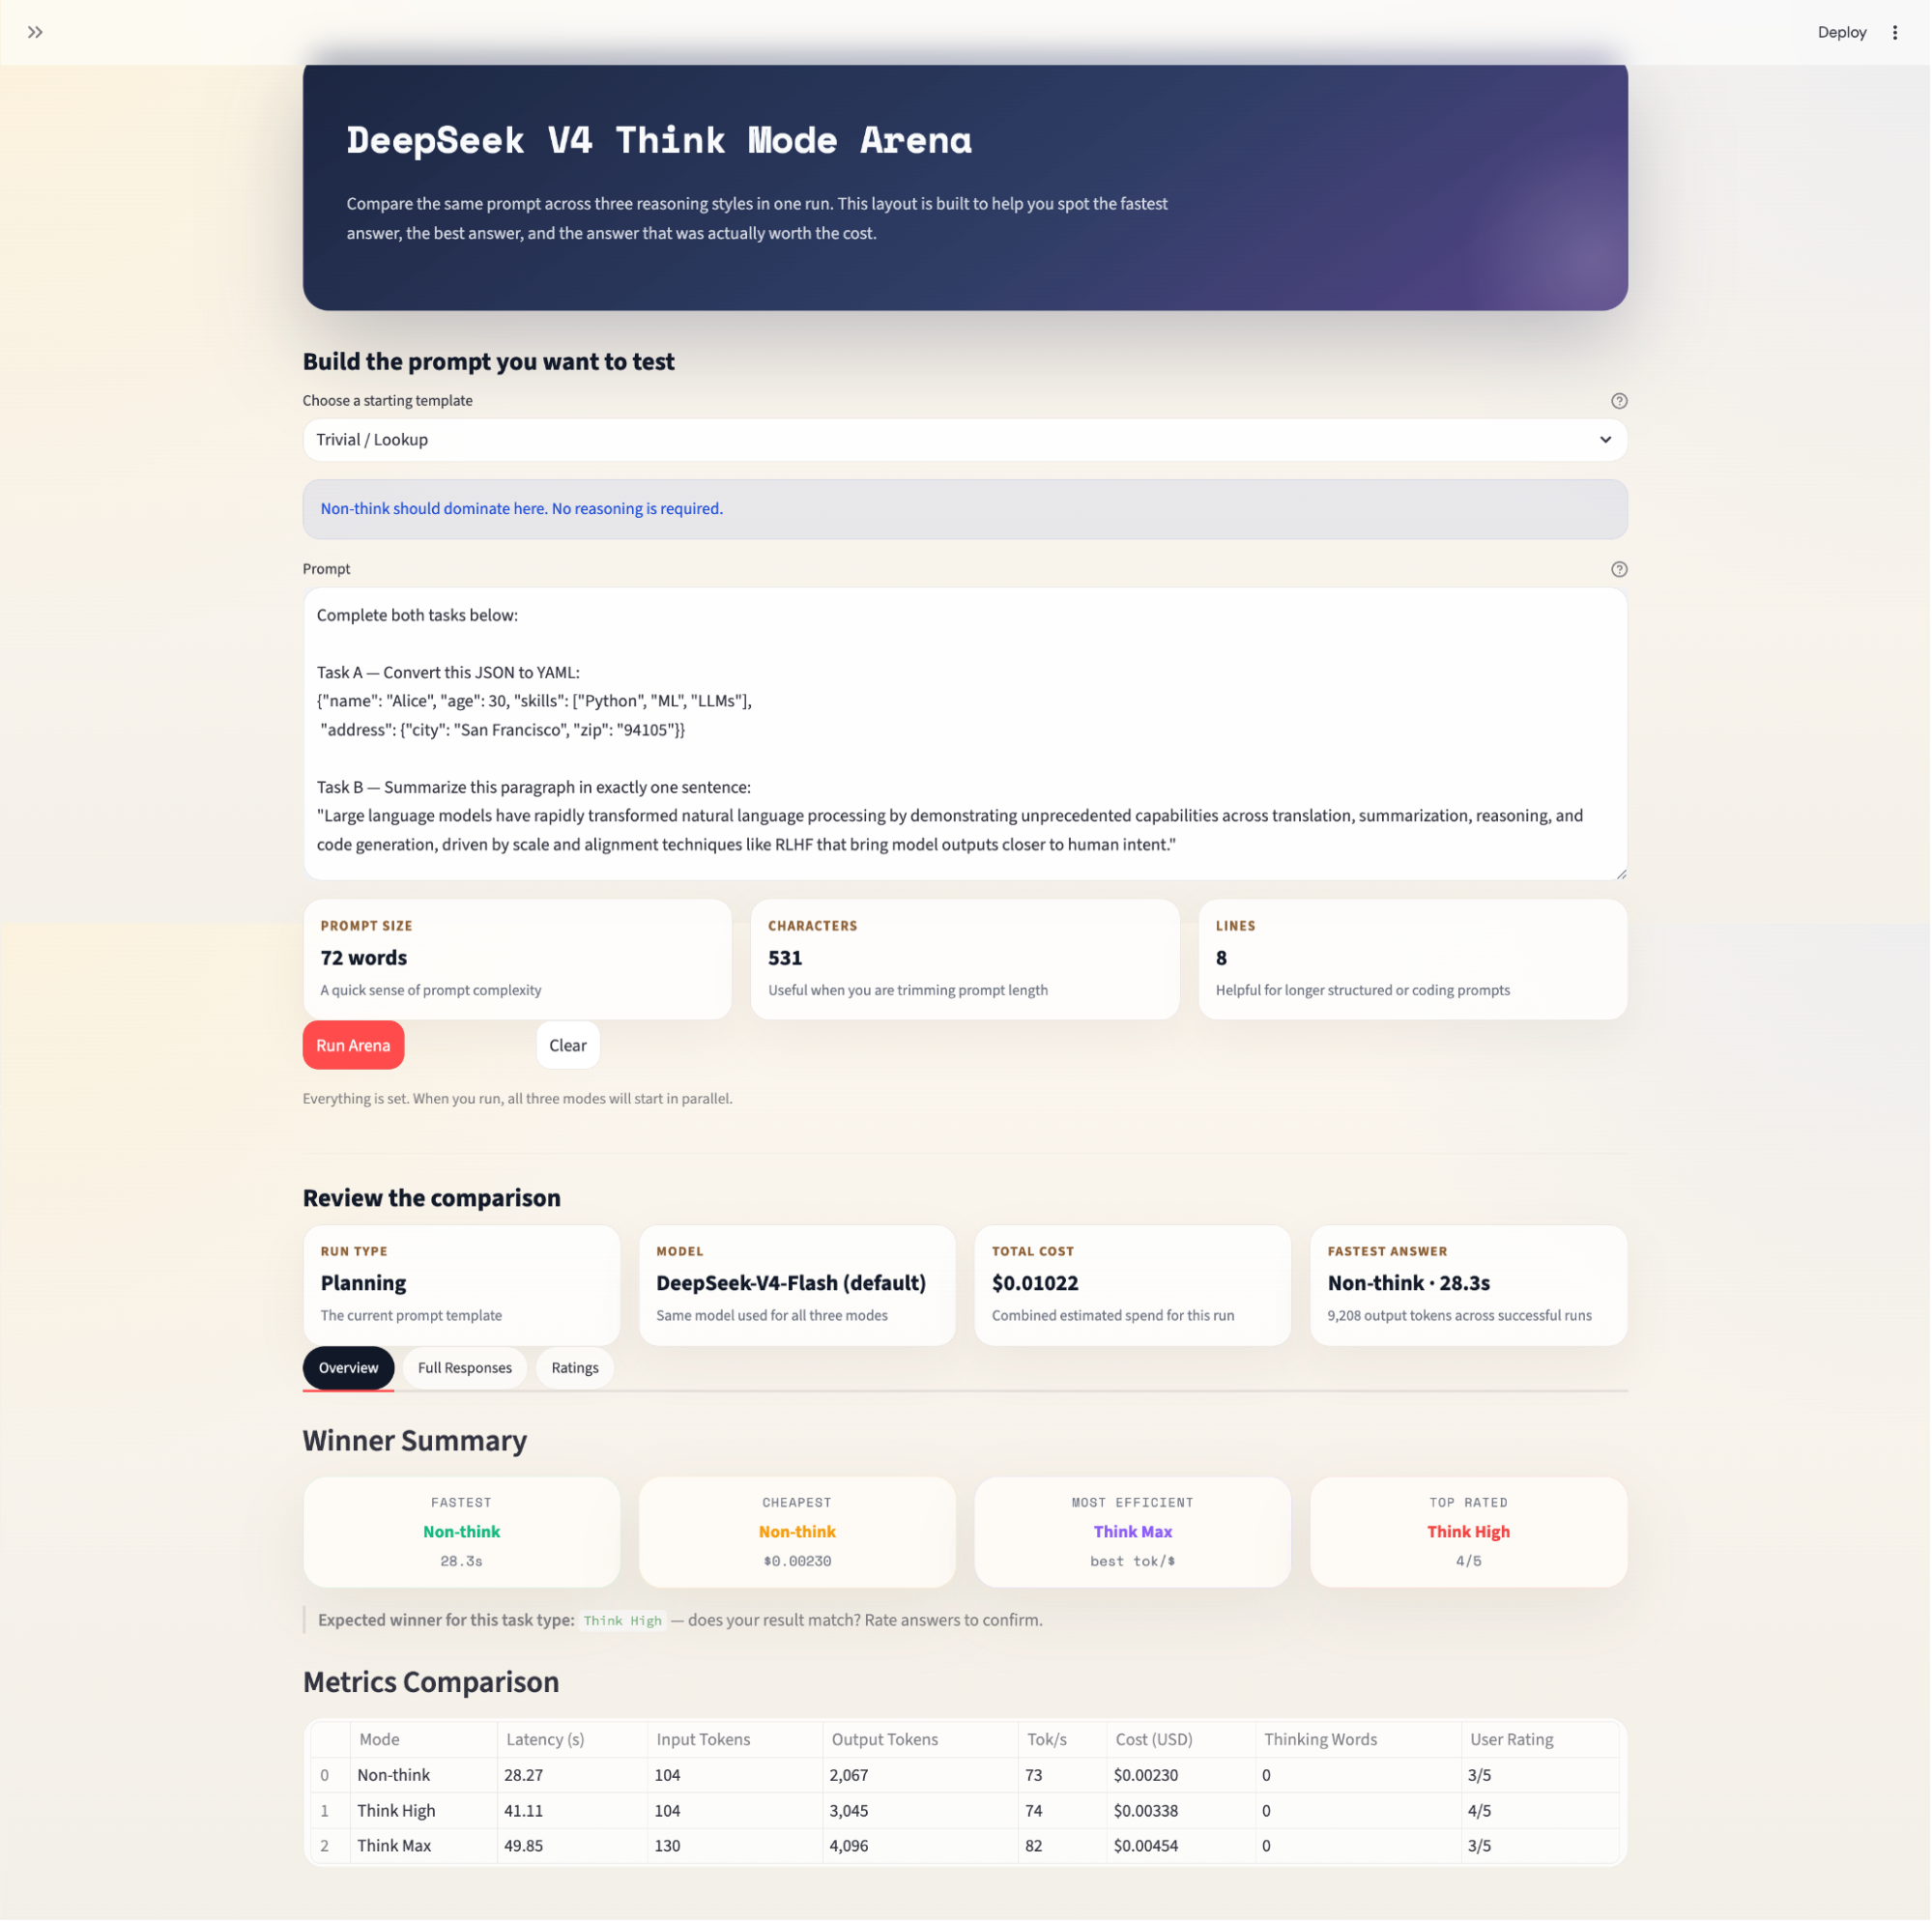
)A aba “Overview” mostra o resumo de vencedores e a tabela de métricas. “Full Responses” traz a comparação lado a lado com trilhas de raciocínio, e “Ratings” exibe sliders para avaliações de qualidade do usuário (1–5) por modo.
Passo 8: métricas e avaliações
Este passo final constrói os dois componentes da aba Overview: uma tabela plana de métricas que coloca todas as dimensões lado a lado e um resumo que destaca o vencedor em quatro categorias.
def render_metrics_table(results: Dict[str, RunResult], ratings: Dict[str, int]):
rows = []
for mode_name, res in results.items():
ok = not res.error
rows.append({
"Mode": mode_name,
"Latency (s)": f"{res.latency:.2f}" if ok else "—",
"Input Tokens": f"{res.input_tokens:,}" if ok else "—",
"Output Tokens": f"{res.output_tokens:,}" if ok else "—",
"Tok/s": f"{res.tokens_per_second:.0f}" if (ok and res.tokens_per_second) else "—",
"Est. Cost (USD)": f"${res.cost_usd:.5f}" if ok else "—",
"Thinking Words": f"{res.thinking_word_count:,}" if ok else "—",
"User Rating": f"{ratings.get(mode_name)}/5" if ratings.get(mode_name) else "—",
})
st.table(rows)
def render_winner_summary(results: Dict[str, RunResult], ratings: Dict[str, int], expected: str):
valid = {k: v for k, v in results.items() if not v.error}
fastest = min(valid, key=lambda k: valid[k].latency)
cheapest = min(valid, key=lambda k: valid[k].cost_usd)
most_efficient = max(
valid,
key=lambda k: valid[k].output_tokens / max(valid[k].cost_usd, 1e-9),
)
top_rated = max(ratings, key=ratings.get) if ratings else NoneUm rápido resumo do que fazem:
-
render_metrics_table()itera por cadaRunResulte monta uma linha por modo. As oito colunas cobrem tempo (latência, tok/s), escala (tokens de entrada e saída, palavras da trilha), dinheiro (custo estimado) e julgamento humano (nota do usuário). -
render_winner_summary()filtra execuções com erro antes de calcular vencedores, evitando que uma falha distorça o resultado. Em seguida, encontra o campeão em quatro dimensões independentes: velocidade, custo bruto, eficiência de saída e avaliação do usuário.
Mantemos as quatro categorias separadas em vez de um único score, pois um composto ponderado exigiria decidir que latência vale mais que custo — o que é decisão de produto, não do framework.
O app também mostra o vencedor previsto por tarefa, estimulando você a confirmar se bateu:
st.markdown(
f"> **Expected winner for this task type:** {expected} — "
"does your result match? Rate answers to confirm.",
)Passo 9: executando o app
Tudo vive em um único app.py com duas dependências. Para iniciar, use dois comandos:
# Set your API key
export DEEPSEEK_API_KEY="sk-..."
# Run
streamlit run app.pyO app abre no seu navegador em localhost:8501. Selecione um template de tarefa no dropdown, edite o prompt se quiser e clique em Run Arena. Uma barra de progresso avança conforme cada modo conclui. Os resultados ficam em st.session_state, permitindo alternar abas e avaliar respostas sem disparar nova execução.
Observação sobre preços: a DeepSeek ajustou significativamente as tarifas da API do V4 desde o lançamento. O V4-Pro está com desconto promocional, e os preços de cache-hit caíram para um décimo da taxa de miss em abril de 2026. As cifras de custo no app refletem as tarifas atuais, mas podem mudar. Sempre verifique em api-docs.deepseek.com/quick_start/pricing antes de usar qualquer modelo.
Conclusão
Neste tutorial, construímos um app em Streamlit que executa o mesmo prompt nos três modos de raciocínio do DeepSeek V4 em paralelo e compara resultados em latência, custo, uso de tokens, profundidade da trilha de raciocínio e qualidade avaliada por usuários. As escolhas arquiteturais-chave foram:
-
ThreadPoolExecutorpara paralelismo real — o tempo total equivale ao do modo mais lento, não à soma de todos -
Parâmetros de API
thinkingereasoning_effortpara um controle de modo limpo, explícito e alinhado com a API do DeepSeek, sem depender de system prompts -
Estimativa de custo ciente de cache para separar tokens de entrada entre acertos e perdas de cache, trazendo números bem mais fiéis — especialmente em repetições, quando descontos de cache quente podem fazer
Non-thinkparecer quase grátis
Para evoluir o projeto, considere adicionar uma camada de LLM-as-judge (usando um modelo separado como Claude ou GPT-4 para pontuar respostas automaticamente), cachear respostas por hash do prompt para evitar reexecuções idênticas, ou adicionar um eixo entre modelos que coloque o Flash Think Max contra o Pro Think High — uma questão de paridade de custo realmente interessante levantada pelo paper do V4, mas ainda sem resposta definitiva.
Perguntas frequentes sobre a Think Mode Arena da API DeepSeek V4
Por que usar OpenAI em vez de um SDK da DeepSeek?
A API da DeepSeek é compatível com a da OpenAI, o que permite apontar o cliente OpenAI para https://api.deepseek.com com uma chave de API da DeepSeek. Isso também significa que o app funciona com qualquer provedor compatível com a OpenAI que hospede o DeepSeek V4, bastando alterar a base URL e o nome do modelo.
Por que o reasoning_effort é omitido para Non-think em vez de definido como None?
O guard if mode_cfg["reasoning_effort"] em call_mode() omite totalmente o parâmetro quando ele é None, em vez de enviar reasoning_effort=None. Alguns validadores de API rejeitam parâmetros desconhecidos com valores nulos explícitos; portanto, omitir é o padrão mais seguro em endpoints recém-lançados.
Por que às vezes não aparece a trilha de raciocínio no Think High?
A trilha é lida de message.reasoning_content. Se o modelo retornar um campo vazio ou nulo em uma execução — o que pode ocorrer com prompts curtos e menos complexos, nos quais o Think High converge rápido — então result.thinking ficará como string vazia.

Sou Especialista Google Developers em ML (Gen AI), tricampeã no Kaggle e Embaixadora Women Techmakers, com mais de três anos de experiência na área de tecnologia. Cofundei uma startup de saúde em 2020 e atualmente faço um mestrado em ciência da computação na Georgia Tech, com foco em aprendizado de máquina.





Os modelos de linguagem estão ficando mais opinativos sobre como pensam. Com os três modos explícitos de raciocínio do DeepSeek V4,
Non-think,Think HigheThink Max, você agora controla a profundidade do raciocínio no nível da API — e a escolha certa depende totalmente da tarefa.Neste tutorial, vou mostrar como construir uma Think Mode Arena do DeepSeek V4 usando Streamlit. O app dispara o mesmo prompt nos três modos de raciocínio em paralelo e apresenta uma comparação lado a lado das respostas, latência, uso de tokens, custo e profundidade da trilha de raciocínio. Ao final, você terá uma ferramenta funcional que consegue:
Executar os três modos de raciocínio do DeepSeek V4 simultaneamente com chamadas de API paralelas
Analisar e exibir trilhas de raciocínio recolhíveis a partir de blocos
<think>...</think>Acompanhar latência, tokens de saída, throughput e custo estimado por modo
Destacar um vencedor em quatro dimensões: mais rápido, mais barato, mais eficiente e melhor avaliado por humanos
O código completo deste tutorial está disponível no meu repositório no GitHub.