
{count, plural, one {Kurs} other {Kurs}}
OpenAI API ile AI Sistemleri Geliştirme
{hours} sa
23.1K
DeepSeek V4, DeepSeek AI'nin en yeni nesil Mixture-of-Experts (MoE) dil modelleridir. Seri iki varyant içerir:
V4'ü seleflerinden ayıran birkaç mimari iyileştirme vardır:
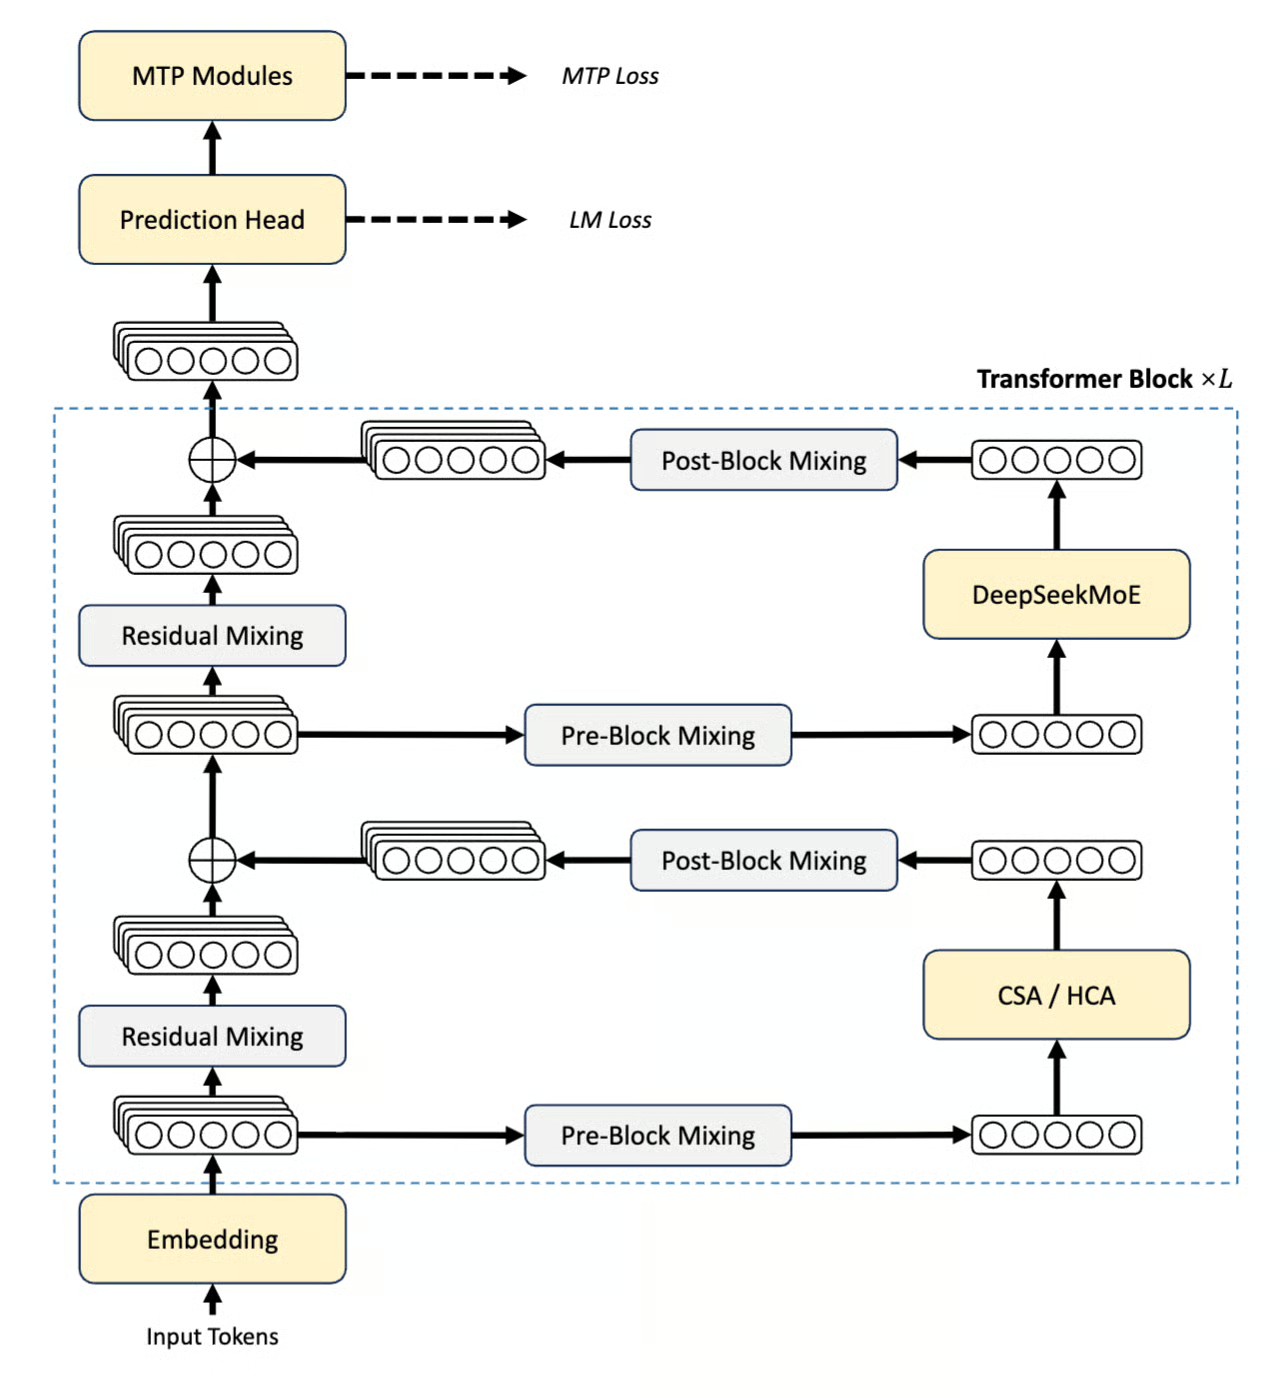
Şekil: DeepSeek V4 Seri Mimarisi (DeepSeek Teknik raporu)
Her iki model de üç farklı akıl yürütme çabası modunu destekler: Non-think, Think High ve Think Max; bu eğitimde bunları keşfedip karşılaştıracağız.
DeepSeek ekibi, V4 modelinin performansını muadilleriyle karşılaştırdı ve bulguları şöyle:
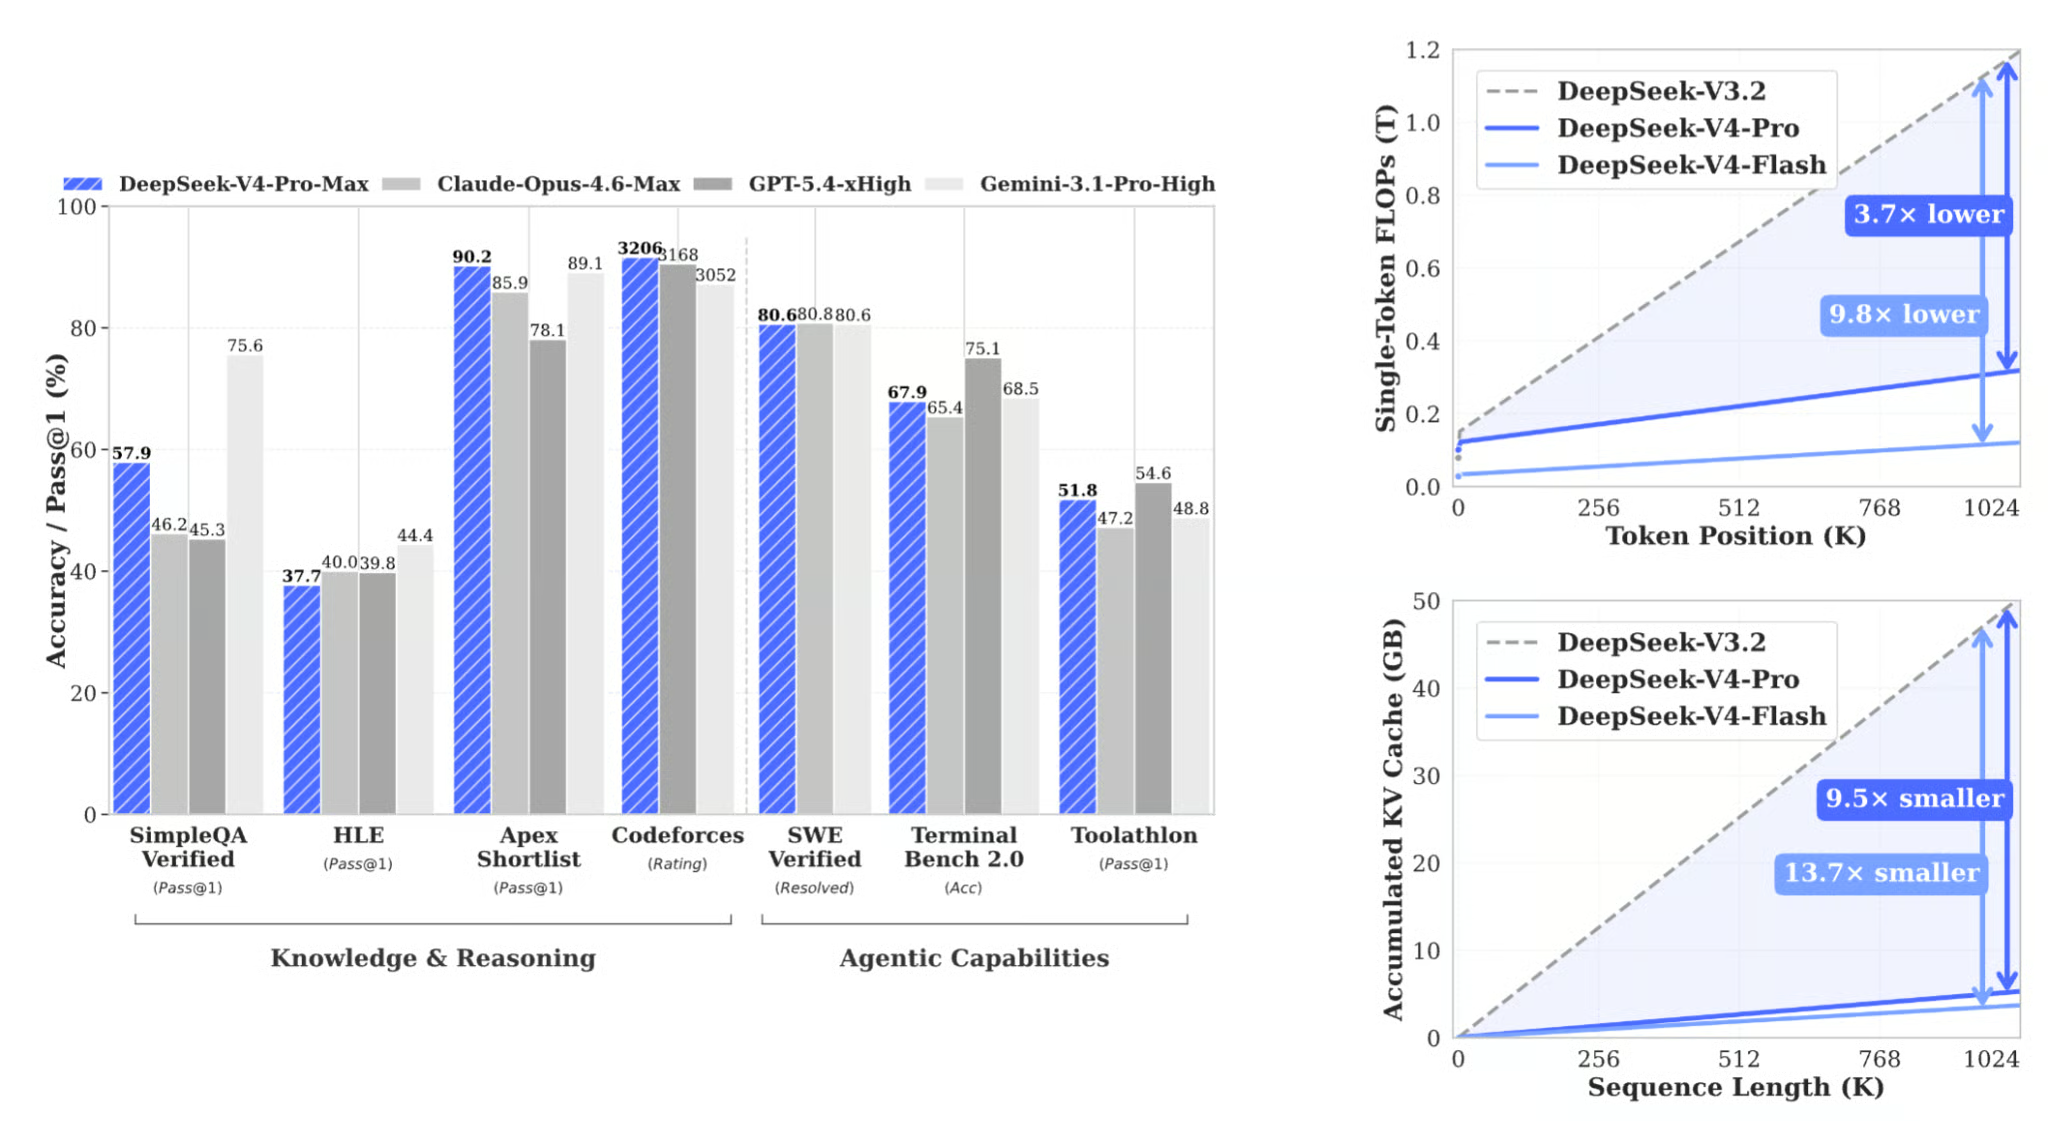
Şekil: DeepSeek V4 serisinin kıyaslama performansı (DeepSeek Teknik raporu)
Soldaki çubuk grafik, V4-Pro-Max'in bilgi, akıl yürütme ve ajans görevleri genelinde kapalı kaynak uç modellerle kıyaslandığında nereye düştüğünü gösteriyor. Sağdaki iki grafik ise verimlilik kazanımlarının neden önemli olduğunu gösteriyor ve daha şaşırtıcı sonuçlar bunlar. DeepSeek-V4-Pro-Max (Think Max akıl yürütme modu), kapalı kaynak uç modellerle rekabetçi sonuçlar elde ediyor:
|
Kıyaslama |
DeepSeek-V4-Pro Max |
Claude Opus 4.6 Max |
Gemini-3.1-Pro High |
|
LiveCodeBench (Pass@1) |
93.5 |
88.8 |
91.7 |
|
Codeforces Derecesi |
3206 |
— |
3052 |
|
GPQA Diamond (Pass@1) |
90.1 |
91.3 |
94.3 |
|
SWE Verified (Çözülen) |
80.6 |
80.8 |
80.6 |
3206'lık Codeforces derecesi, V4-Pro-Max'i Efsanevi Büyükusta seviyesine yerleştirir; bu da arenamızdaki kodlama görevlerini gerçekten ilginç bir stres testi yapar.
Uygulamayı oluşturmadan önce, her modun gerçekte ne yaptığını anlamaya değer:
Non-think: Model, dahili bir düşünce zinciri olmadan doğrudan yanıt verir. Bu mod, biçim dönüştürme, basit aramalar ve tek cümlelik özetler gibi derinlikten çok hızın önemli olduğu görevler için idealdir.Think High: Model, bir yanıta bağlanmadan önce adım adım akıl yürütür. Bu mod, hata ayıklama, sistem tasarımı ve planlama gibi orta derecede karmaşık görevler için derinlik ve maliyet arasında iyi bir dengedir.Think Max: Model, akıl yürütmeyi azami düzeye çıkarır, birden çok yaklaşımı keşfeder, mantığını titizlikle doğrular ve ancak emin olduğunda nihai yanıta bağlanır. Bu nedenle Think Max modu, zor matematik ispatları, karmaşık çok dosyalı yeniden düzenlemeler veya hatalı bir kendinden emin cevabın yavaş ama doğrulanmış olandan daha kötü olduğu herhangi bir görev için en iyisidir.Bu eğitimin gösterdiği kritik içgörü, Think Max'in her zaman kazanmadığıdır. Önemsiz görevlerde, aynı kalite için hesaplama boşa harcanır. Arenanın amacı, gerçek gecikme, token sayıları, maliyet ve kullanıcı puanlarına dayanarak her görev türü için hangi modun gerçekten kullanmaya değer olduğunu ortaya çıkarmaktır.
Modelin diğer son teknoloji LLM'lerle nasıl karşılaştırıldığını görmekle ilgileniyorsanız, Claude Opus 4.7 vs DeepSeek V4 ve GPT-5.5 vs DeepSeek V4 yazılarımızı okumanızı öneririm.
Bu eğitimde, aşağıdakileri yapan bir Streamlit uygulaması oluşturacağız:
Kullanıcıdan bir istem ve bir görev kategorisi alır
Python'un ThreadPoolExecutor'ını kullanarak her akıl yürütme modu için bir tane olmak üzere üç paralel API çağrısı başlatır
Model çıktısındaki <think>...</think> bloklarından düşünme izlerini ayrıştırır
Gecikmeyi, token sayılarını ve mod başına tahmini maliyeti izler
Ölçümler, bir kullanıcı puanlama sistemi ve bir kazanan özetiyle yan yana bir karşılaştırma sunar
Tam çalışan uygulama, harici veritabanları veya arka plan servisleri gerektirmeyen tek bir app.py dosyasıdır.
Bu eğitimin tam kodu GitHub depomda mevcuttur.
Bir proje klasörü oluşturarak ve gerekli iki paketi yükleyerek başlayın:
mkdir deepseek-arena && cd deepseek-arena
pip install streamlit>=1.32.0 openai>=1.12.0
openai kütüphanesi burada kullanılıyor çünkü DeepSeek'in API'si OpenAI ile uyumludur; bu da, OpenAI istemcisini DeepSeek'in temel URL'sine yönlendirerek başka bir değişiklik yapmadan çalışabileceğimiz anlamına gelir. DeepSeek'e özgü bir SDK gerekmez.
Bir API anahtarı alın: platform.deepseek.com ve bunu bir ortam değişkeni olarak ayarlayın:
export DEEPSEEK_API_KEY="sk-..."Artık ortam hazır olduğuna göre, modellere ve modlarına yapılandırma vermeye geçebiliriz.
Herhangi bir mantık yazmadan önce, içe aktarmaları, model tanımlayıcılarını, akıl yürütme modu yapılandırmalarını ve fiyatlandırma sabitlerini tanımlarız. Bu sözlükler, tüm uygulamanın davranışını kontrol eder; örneğin model açılır menüsü, her akıl yürütme modunu yönlendiren API parametreleri, UI renk şeması ve karşılaştırma panelinde gösterilen maliyet tahminleri.
import os
import time
import concurrent.futures
from dataclasses import dataclass
from typing import Optional, Dict
import streamlit as st
from openai import OpenAI
DEEPSEEK_BASE_URL = "https://api.deepseek.com"
DEEPSEEK_API_KEY_ENV = "DEEPSEEK_API_KEY"
MODELS = {
    "DeepSeek-V4-Flash (default)": "deepseek-v4-flash",
    "DeepSeek-V4-Pro": "deepseek-v4-pro",
}
MODES: Dict[str, dict] = {
    "Non-think": {
        "icon": "",
        "color": "#10b981",
        "badge": "green",
        "desc": "Fast, direct answers — no internal reasoning",
        "thinking_type": "disabled",
        "reasoning_effort": None,
    },
    "Think High": {
        "icon": "",
        "color": "#3b82f6",
        "badge": "blue",
        "desc": "Careful step-by-step reasoning before responding",
        "thinking_type": "enabled",
        "reasoning_effort": "high",
    },
    "Think Max": {
        "icon": "",
        "color": "#ef4444",
        "badge": "red",
        "desc": "Exhaustive reasoning — push analysis to the limit",
        "thinking_type": "enabled",
        "reasoning_effort": "max",
    },
}
PRICING = {
    "deepseek-v4-flash": {
        "input_cache_hit":  0.0028,
        "input_cache_miss": 0.14,
        "output":           0.28,
    },
    "deepseek-v4-pro": {
        "input_cache_hit":  0.003625,
        "input_cache_miss": 0.435,
        "output":           0.87,
    },
}
Buradaki bazı tasarım tercihlerini açmaya değer:
Düşünme modu için parametreler: MODES içindeki her giriş, bir sistem istemi yerine iki API alanı taşır. Bunlar thinking_type ve reasoning_effort (”high”, "max" veya None) içerir. thinking_type, extra_body={"thinking": {"type": ...}} yoluyla, reasoning_effort ise üst düzey bir istek parametresi olarak iletilir. Non-think, thinking_type'ı "disabled" olarak ayarlar ve reasoning_effort'u None bırakır; böylece hiçbir düşünme gövdesi gönderilmez.
Varsayılan model olarak Flash: Flash, Pro'nun 49B'sine karşılık token başına 13B parametre etkinleştirir; bu da üç yönlü paralel çağrıları, denemeler sırasında yeterince ucuza defalarca çalıştırılabilir kılar. Pro, sınır performansa ihtiyaç duyduğunuzda açılır menüden kullanılabilir; ancak Pro üzerinde Think Max kota tüketimini hızla artırır; bu yüzden varsayılan yerine tercihe bağlı tutulması bilinçli bir maliyet korkuluklarıdır.
Not: Yukarıdaki koddaki değerler, V4-Pro'nun mevcut promosyon indirimini yansıtır. Bu nedenle, yeni bir model sürümünden sonra hem taban ücretler hem de promosyon indirimleri sık değiştiğinden, maliyet karşılaştırmalarını yayımlamadan önce her zaman api-docs.deepseek.com/quick_start/pricing adresinden güncel oranları doğrulayın.
Görev tasarımı, bir akıl yürütme karşılaştırması oluşturmanın en az değer verilen kısmıdır. Tüm görevler zor ve ucu açık olursa Think Max her seferinde kazanır ve demo hiçbir şey öğretmez. Görev seti, her modun en az bir kategoride kazandığı şekilde tam zorluk yelpazesini kapsamalıdır.
TASKS = {
    "Trivial / Lookup": {
        "prompt": (
            "Complete both tasks below:\n\n"
            "Task A — Convert this JSON to YAML:\n"
            '{"name": "Alice", "age": 30, "skills": ["Python", "ML", "LLMs"],\n'
            ' "address": {"city": "San Francisco", "zip": "94105"}}\n\n'
            "Task B — Summarize this paragraph in exactly one sentence:\n"
            '"Large language models have rapidly transformed natural language processing '
            "by demonstrating unprecedented capabilities across translation, summarization, "
            "reasoning, and code generation, driven by scale and alignment techniques like RLHF "
            'that bring model outputs closer to human intent."'
        ),
        "expected_winner": "Non-think",
        "tip": "Non-think should dominate here. No reasoning is required.",
    },
    "Coding / Debugging": {
        "prompt": (
            "Find every bug in the Python code below, explain each bug clearly, "
            "and provide a fully corrected version:\n\n"
            "```python\n"
            "def binary_search(arr, target):\n"
            "    left, right = 0, len(arr)\n"
            "    while left < right:\n"
            "        mid = (left + right) // 2\n"
            "        if arr[mid] == target:\n"
            "            return mid\n"
            "        elif arr[mid] < target:\n"
            "            left = mid\n"
            "        else:\n"
            "            right = mid - 1\n"
            "    return -1\n\n"
            "print(binary_search([1, 3, 5, 7, 9], 7))\n"
            "```"
        ),
        "expected_winner": "Think High",
        "tip": "Think High usually finds the bugs and explains them well.",
    },
    "System Design": {
        "prompt": (
            "Design a scalable vector search system for 100 million documents.\n\n"
            "Address each of the following:\n"
            "1. Indexing strategy and pipeline\n"
            "2. ANN algorithm selection (HNSW vs IVF-PQ vs ScaNN — justify your choice)\n"
            "3. Sharding and replication strategy\n"
            "4. p99 query latency target (< 50 ms) — how do you hit it?\n"
            "5. Real-time document update handling\n"
            "6. Top 3 failure modes and their mitigations"
        ),
        "expected_winner": "Think High",
        "tip": "Think High often gives the best quality-per-dollar design answer.",
    },
    "Planning": {
        "prompt": (
            "Create a detailed 6-month roadmap for deploying an enterprise RAG system.\n\n"
            "Include:\n"
            "- Month-by-month phases with concrete, measurable milestones\n"
            "- Top 5 risks and mitigation strategies\n"
            "- Team roles and headcount required per phase\n"
            "- Evaluation metrics for each phase (how do you know it's working?)\n"
            "- Go / no-go production checklist"
        ),
        "expected_winner": "Think High",
        "tip": "Think High should produce a more structured, complete roadmap.",
    },
    "Math (IMO-style)": {
        "prompt": (
            "Solve this problem completely and verify your answer:\n\n"
            "Find all positive integers n such that n² + 1 is divisible by n + 1.\n\n"
            "Your answer must include:\n"
            "1. A complete proof with clear logical steps\n"
            "2. Verification with at least 3 concrete numerical examples\n"
            "3. A rigorous argument for why your solution set is complete "
            "(i.e., there are no other solutions)"
        ),
        "expected_winner": "Think Max",
        "tip": "Think Max earns its cost when thorough verification matters.",
    },
}
Bu beş görev, üç beklenen kazanana net şekilde eşlenir:
|
Görev |
Beklenen Kazanan |
Gerekçe |
|
Trivial / Lookup |
Non-think |
Sıfır akıl yürütme yükü gerekir; düşünme süresi tamamen israftır |
|
Coding / Debugging |
Think High |
Yöntemli tek bir geçiş tüm hataları yakalar; Max marjinal değer katar |
|
System Design |
Think High |
Derinlik kaliteyi artırır; tükenmeye varan analiz faydalı mimari eklemez |
|
Planning |
Think High |
Bir yol haritası ispat değildir; yapı ham hesaplamadan üstündür |
|
Math (IMO-style) |
Think Max |
Doğrulama yük taşır; yanlış bir ispat, yavaş ama doğru olandan daha kötüdür |
Her görev aynı zamanda bir expected_winner alanı taşır. Uygulama, sonuçlar geldikten sonra bunu gösterir; böylece kullanıcılar beklenen kazananın tutup tutmadığını ya da alt edilip edilmediğini görebilir.
Görev şablonları tanımlandıktan sonra, her API çağrısından gelen sonuçları tutacak bir yapıya ihtiyacımız var. Uygulama genelinde ham yanıt nesnelerini geçirmek yerine, karşılaştırma panelinin ihtiyaç duyduğu tüm ölçümleri yakalayan tek bir RunResult veri sınıfını tanımlarız.
@dataclass
class RunResult:
    mode: str
    answer: str = ""
    thinking: str = ""
    latency: float = 0.0
    input_tokens: int = 0
    output_tokens: int = 0
    cost_usd: float = 0.0
    error: Optional[str] = None
    @property
    def tokens_per_second(self) -> Optional[float]:
        if self.latency > 0 and self.output_tokens > 0:
            return self.output_tokens / self.latency
        return None
    @property
    def thinking_word_count(self) -> int:
        return len(self.thinking.split()) if self.thinking else 0
thinking alanı, DeepSeek V4 API'si düşünce zincirini yanıt yapısında content ile aynı düzeyde yer alan özel bir reasoning_content alanında döndürdüğü için answer'dan ayrıdır. Bunları ayrı tutmak, UI'ın, temiz nihai yanıtın yanında daraltılabilir bir akıl yürütme izini görüntülemesine olanak tanır; bu da mod farkını, özellikle Think Max izinin binlerce kelimeye ulaşabildiği matematik görevinde anında ve somut hale getirir.
tokens_per_second özelliği, istem uzunluğundan bağımsız olarak üretim throughput'unu ölçer. Çıktı token sayılarının önemli ölçüde farklı olduğu durumlarda modlar arası verimliliği karşılaştırmak için yararlıdır. Think Max'in doğal olarak daha fazla token ürettiğine dikkat edin; bu nedenle ham gecikme karşılaştırmaları, her modun ne kadar hızlı ürettiğini de görmeden yanıltıcı olabilir.
API çağrı mantığını yazmadan önce, ham SDK yanıtı ile RunResult arasında yer alan iki küçük yardımcı tanımlarız. Gözden kaçırılması kolaydır ancak maliyet doğruluğu açısından önemlidirler.
def get_cached_prompt_tokens(usage) -> int:
    prompt_details = getattr(usage, "prompt_tokens_details", None)
    if prompt_details is None:
        return 0
    cached_tokens = getattr(prompt_details, "cached_tokens", None)
    if cached_tokens is not None:
        return cached_tokens or 0
    if isinstance(prompt_details, dict):
        return prompt_details.get("cached_tokens", 0) or 0
    return 0
def estimate_cost_usd(
    model: str,
    prompt_tokens: int,
    completion_tokens: int,
    cached_prompt_tokens: int,
) -> float:
    pricing = PRICING.get(model, PRICING["deepseek-v4-flash"])
    cached_tokens = min(cached_prompt_tokens, prompt_tokens)
    uncached_tokens = max(prompt_tokens - cached_tokens, 0)
    return (
        cached_tokens   / 1_000_000 * pricing["input_cache_hit"]
        + uncached_tokens / 1_000_000 * pricing["input_cache_miss"]
        + completion_tokens / 1_000_000 * pricing["output"]
    )
get_cached_prompt_tokens() işlevi doğrudan alan erişimi sağlamaz çünkü prompt_tokens_details yapısı SDK sürümleri arasında tutarlı olmak zorunda değildir. Önce türlenmiş bir özniteliği kontrol eder, ardından sözlük erişimine geri döner ve bir istisna fırlatmak yerine sıfır döndürür. Bu, ThreadPoolExecutor içinde önemlidir; çünkü bir iş parçacığındaki sessiz bir hata, görünür bir hata olmadan o mod için yanıltıcı derecede düşük bir maliyet tahmini üretebilir.
estimate_cost_usd() yardımcı işlevi, oranları uygulamadan önce istem token sayısını önbelleğe alınmış ve alınmamış bölümlere ayırır. DeepSeek, önbellek isabeti fiyatını kaçırma oranının onda birine düşürdüğünden, soğuk ve ılık bir istem arasındaki fark çarpıcı olabilir. Tekrar edilen bir görevde, Non-think neredeyse ücretsiz görünebilir; nedeni daha az token üretmesi değil, daha kısa isteminin ezici olasılıkla önbellek-sıcak olmasıdır.
Burası arenanın mimari çekirdeği. Üç modun tümü ThreadPoolExecutor kullanılarak eşzamanlı ateşlenir; böylece toplam duvar saati süresi, üçünün toplamı yerine en yavaş tek moda eşit olur.
def call_mode(client: OpenAI, model: str, mode_name: str, user_prompt: str) -> RunResult:
    result = RunResult(mode=mode_name)
    mode_cfg = MODES[mode_name]
    start = time.perf_counter()
    try:
        request_kwargs = {
            "model": model,
            "messages": [{"role": "user", "content": user_prompt}],
            "max_tokens": 4096,
            "extra_body": {"thinking": {"type": mode_cfg["thinking_type"]}},
        }
        if mode_cfg["reasoning_effort"]:
            request_kwargs["reasoning_effort"] = mode_cfg["reasoning_effort"]
        response = client.chat.completions.create(**request_kwargs)
        result.latency = time.perf_counter() - start
        message = response.choices[0].message
        result.thinking = (getattr(message, "reasoning_content", None) or "").strip()
        result.answer   = (message.content or "").strip()
        usage = response.usage
        result.input_tokens  = getattr(usage, "prompt_tokens", 0) or 0
        result.output_tokens = getattr(usage, "completion_tokens", 0) or 0
        result.cost_usd = estimate_cost_usd(
            model=model,
            prompt_tokens=result.input_tokens,
            completion_tokens=result.output_tokens,
            cached_prompt_tokens=get_cached_prompt_tokens(usage),
        )
    except Exception as exc:
        result.latency = time.perf_counter() - start
        result.error = str(exc)
    return result
def run_parallel(client: OpenAI, model: str, prompt: str) -> Dict[str, RunResult]:
    results: Dict[str, RunResult] = {}
    with concurrent.futures.ThreadPoolExecutor(max_workers=3) as pool:
        futures = {
            pool.submit(call_mode, client, model, mode_name, prompt): mode_name
            for mode_name in MODES
        }
        for fut in concurrent.futures.as_completed(futures):
            results[futures[fut]] = fut.result()
    return results
Burada vurgulanmaya değer birkaç tasarım kararı vardır:
request_kwargs'ı koşullu kurmak: Non-think modu thinking_type: "disabled" ve reasoning_effort anahtarı olmadan gönderir. Think High ve Think Max, thinking_type: "enabled" ve kendi çaba düzeylerini gönderir. if mode_cfg["reasoning_effort"] koruması, parametrenin Non-think için None olarak gönderilmesi yerine tamamen atlanmasını sağlar; bu da bir API doğrulama hatasını tetikleyebilir.
reasoning_content'i doğrudan okumak: Düşünce zinciri izi, message.reasoning_content'ten, boş dizeye geri dönüşle getattr() kullanılarak okunur. Bu, içeriğe gömülü <think>...</think> etiketlerini ayrıştırmaktan daha sağlamdır. Resmi yanıt alanını kullanır, hiç iz yayılmadığı (Non-think) durumu ele alır ve model çıktısı başka nedenlerle "think" kelimesini içerdiğinde bozulmaz.
Kullanım alanlarında savunmacı getattr(): Kullanım alanlarına doğrudan erişmek yerine getattr(..., 0) or 0 ile erişilir. Bu, kullanım nesnesi daha eski bir SDK sürümünde veya alışılmadık bir yanıtta bir alanı kaçırırsa, tüm çalışmayı hatalı işaretleyecek bir AttributeError yerine sıfır döndürür.
Hata yönetimi: Bir çağrı başarısız olursa, RunResult veri sınıfı, yükseltmek yerine hata dizesini saklar. UI result.error'ı kontrol eder ve üç modun tamamının çalışmasını çökertmeden bilgilendirici bir kart oluşturur.
Bu adım sunum katmanını kapsar: sayfa düzeni, CSS tasarım sistemi, mod başına sonuç sütunu ve kullanıcıyı ilk yüklemede bunaltmadan karşılaştırmayı organize eden sekme yapısı.
Uygulama, üç sütunlu karşılaştırmaya yeterli yatay alan sağlamak için layout="wide" ile st.set_page_config kullanır:
def main():
    st.set_page_config(
        page_title="DeepSeek V4 Think Mode Arena",
        layout="wide",
        initial_sidebar_state="expanded",
    )
    inject_css()
inject_css() işlevi, st.markdown aracılığıyla tam bir tasarım sistemini enjekte eder. Monospace başlıklar ve metrik çipler için Space Mono, gövde metni için DM Sans kullanılan sıcak bir parşömen arka planı kullanır.
def render_mode_column(result: RunResult, mode_name: str):
    cfg = MODES[mode_name]
    badge_cls = f"mode-{cfg['badge']}"
    st.markdown(
        f'<div class="mode-header {badge_cls}">{mode_name}</div>',
        unsafe_allow_html=True,
    )
    st.markdown(f'<div class="subtle-copy">{cfg["desc"]}</div>', unsafe_allow_html=True)
    if result.error:
        st.error(f"**API Error:** {result.error}")
        return
    chips = [
        ("Latency", f"{result.latency:.1f}s"),
        ("Output tokens", f"{result.output_tokens:,}"),
        ("Cost", f"${result.cost_usd:.5f}"),
    ]
    if result.tokens_per_second:
        chips.append(("Tok/s", f"{result.tokens_per_second:.0f}"))
    chip_html = "".join(
        f'<span class="metric-chip">{label} <span>{val}</span></span>'
        for label, val in chips
    )
    st.markdown(chip_html, unsafe_allow_html=True)
    if result.thinking:
        with st.expander(f" Thinking trace — {result.thinking_word_count:,} words"):
            preview = result.thinking[:5000]
            if len(result.thinking) > 5000:
                preview += "\n\n[… truncated for display …]"
            st.text(preview)
    elif mode_name != "Non-think":
        st.caption("_No thinking trace emitted_")
    st.markdown('<div class="answer-label">Final answer</div>', unsafe_allow_html=True)
    st.markdown(result.answer if result.answer else "_No answer returned._")
Düşünme izi genişleticisi özellikle kullanışlıdır; çünkü Think Max izi, zor bir matematik probleminde binlerce kelimelik öz-düzeltme ve doğrulamaya uzanabilirken, Non-think modunun hiç izi olmayabilir; bu da mod farkını hissedilir kılar.
Ana düzen, her şeyi tek bir kaydırmaya sıkıştırmadan endişeleri ayırmak için Streamlit sekmelerini kullanır:
overview_tab, answers_tab, ratings_tab = st.tabs(
    ["Overview", "Full Responses", "Ratings"]
)
“Overview” sekmesi kazanan özetini ve ölçümler tablosunu gösterir. “Full Responses” sekmesi, düşünme izleriyle birlikte üç sütunlu yan yana karşılaştırmayı sunarken, “Ratings” sekmesi mod başına kullanıcı kalite puanları (1–5) için kaydırıcıları gösterir.
Bu son adım, Genel Bakış sekmesinde yer alan iki bileşeni oluşturur; yani tüm ölçülen boyutu yan yana koyan düz bir metrik tablosu ve dört farklı kategoride kazananı öne çıkaran bir kazanan özeti.
def render_metrics_table(results: Dict[str, RunResult], ratings: Dict[str, int]):
    rows = []
    for mode_name, res in results.items():
        ok = not res.error
        rows.append({
            "Mode":            mode_name,
            "Latency (s)":     f"{res.latency:.2f}" if ok else "—",
            "Input Tokens":    f"{res.input_tokens:,}" if ok else "—",
            "Output Tokens":   f"{res.output_tokens:,}" if ok else "—",
            "Tok/s":           f"{res.tokens_per_second:.0f}" if (ok and res.tokens_per_second) else "—",
            "Est. Cost (USD)": f"${res.cost_usd:.5f}" if ok else "—",
            "Thinking Words":  f"{res.thinking_word_count:,}" if ok else "—",
            "User Rating":     f"{ratings.get(mode_name)}/5" if ratings.get(mode_name) else "—",
        })
    st.table(rows)
def render_winner_summary(results: Dict[str, RunResult], ratings: Dict[str, int], expected: str):
    valid = {k: v for k, v in results.items() if not v.error}
    fastest        = min(valid, key=lambda k: valid[k].latency)
    cheapest       = min(valid, key=lambda k: valid[k].cost_usd)
    most_efficient = max(
        valid,
        key=lambda k: valid[k].output_tokens / max(valid[k].cost_usd, 1e-9),
    )
    top_rated = max(ratings, key=ratings.get) if ratings else None
Bu iki işlevin yaptıklarına hızlıca bakalım:
render_metrics_table() işlevi her RunResult'ı yineler ve her mod için bir satır sözlüğü oluşturur. Sekiz sütun, zaman (gecikme, tok/s), ölçek (girdi ve çıktı tokenları, düşünme kelimeleri), para (tahmini maliyet) ve insan yargısını (kullanıcı puanı) kapsar.
render_winner_summary() işlevi, kazananları hesaplamadan önce herhangi bir başarısız çalışmayı filtreler; böylece tek bir API hatası asla sonuçları çarpıtmaz. Ardından duvar saati hızı, ham maliyet, çıktı verimliliği ve kullanıcı puanı gibi dört bağımsız boyutta şampiyonu bulur.
Bu dört kategori, tek bir puanda birleştirilmek yerine kasıtlı olarak ayrı tutulur; çünkü ağırlıklı bir bileşik, gecikmenin maliyetten daha önemli olduğuna uygulamanın karar vermesini gerektirir; bu ise bir çerçeve kararı değil, bir ürün kararıdır.
Uygulama ayrıca görev başına öngörülen kazananı da yüzeye çıkarır ve kullanıcının bunun eşleşip eşleşmediğini onaylamasını ister:
st.markdown(
    f"> **Expected winner for this task type:** {expected} — "
    "does your result match? Rate answers to confirm.",
)Tüm uygulama iki bağımlılıkla tek bir app.py dosyasında yaşar ve başlatmak için iki komut yeterlidir:
# Set your API key
export DEEPSEEK_API_KEY="sk-..."
# Run
streamlit run app.py
Uygulama tarayıcınızda localhost:8501 adresinde açılır. Açılır menüden bir görev şablonu seçin, isteğe bağlı olarak istemi düzenleyin ve Run Arena'ya tıklayın. Her mod tamamlandıkça bir ilerleme çubuğu güncellenir. Sonuçlar, sekmeler arasında geçiş yapıp yanıtları yeniden çalıştırmayı tetiklemeden puanlayabilmeniz için st.session_state'te saklanır.
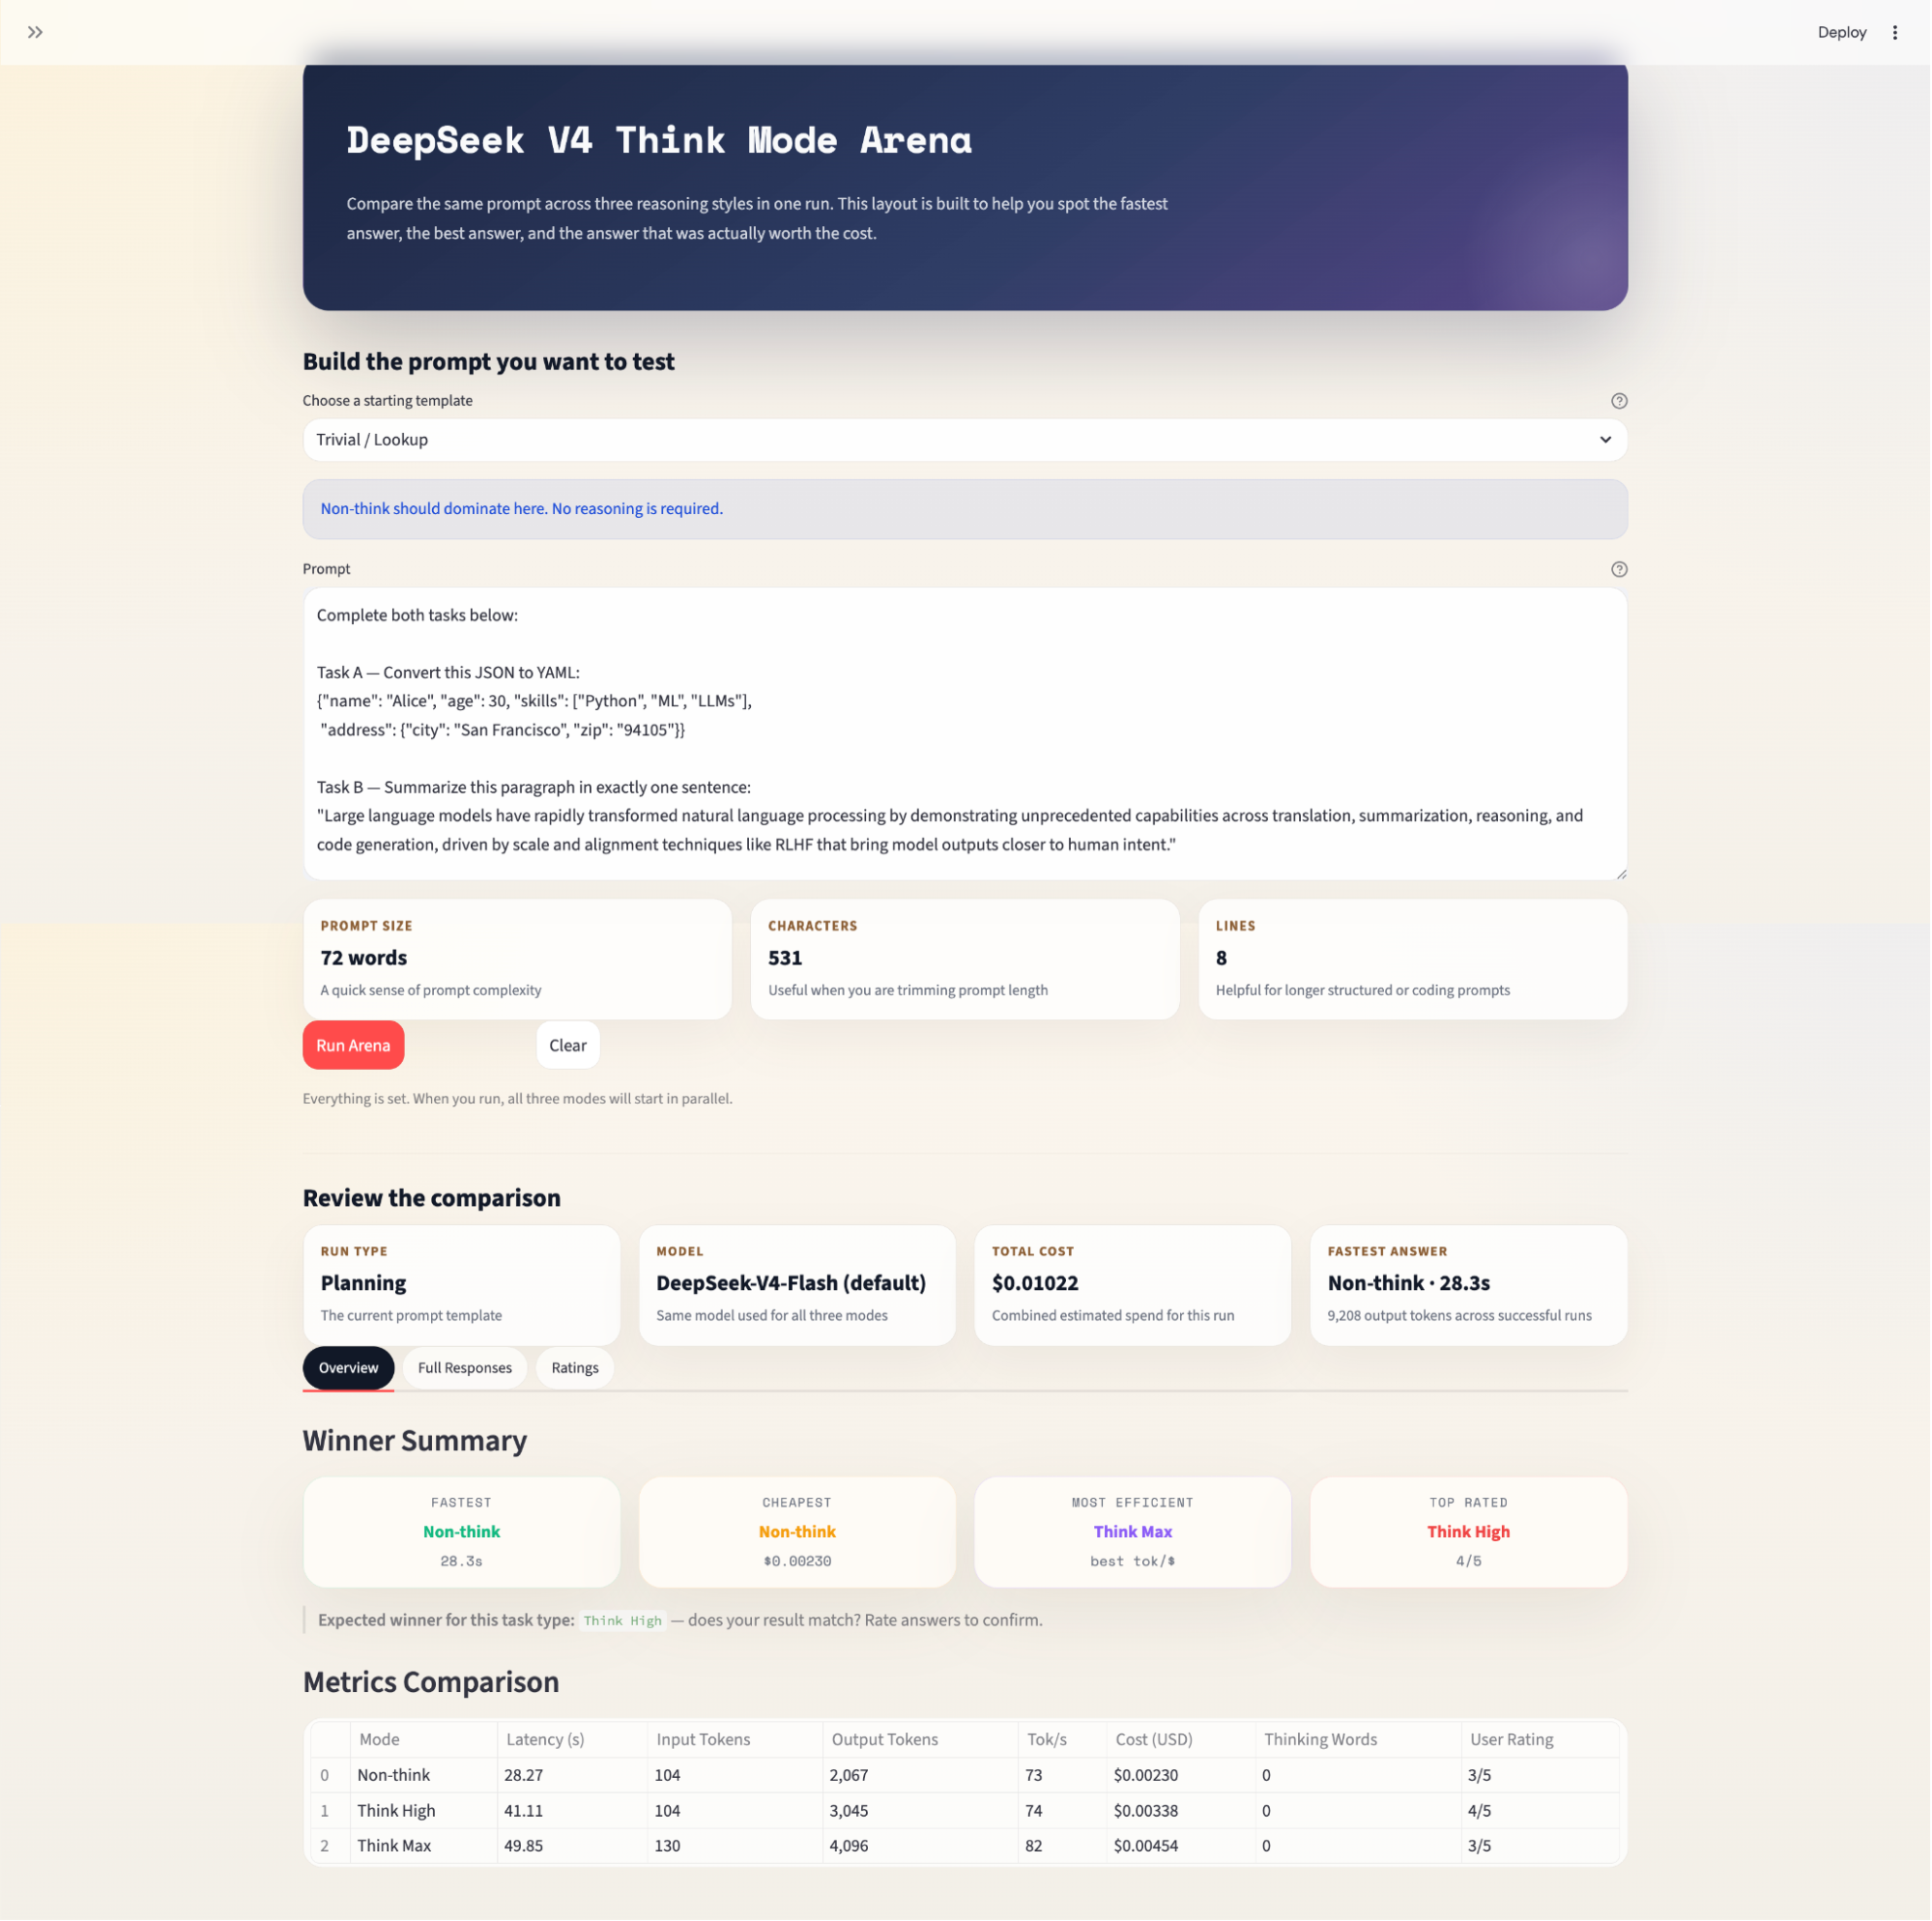
Fiyatlandırma notu: DeepSeek, lansmandan bu yana V4 API oranlarını önemli ölçüde ayarladı. V4-Pro şu anda promosyon indiriminde ve Nisan 2026'da önbellek isabeti fiyatları, kaçırma oranının onda birine düşürüldü. Uygulamada gösterilen maliyet rakamları bu güncel oranları yansıtır ancak değişebilir. Herhangi bir modeli kullanmadan önce her zaman api-docs.deepseek.com/quick_start/pricing adresinden doğrulayın.
Bu eğitimde, aynı istemi DeepSeek V4'ün üç akıl yürütme modu arasında paralel olarak çalıştıran ve sonuçları gecikme, maliyet, token kullanımı, düşünme izi derinliği ve kullanıcı puanlı kaliteye göre karşılaştıran bir Streamlit uygulaması oluşturduk. Temel mimari seçimler şunlardı:
Gerçek paralellik için ThreadPoolExecutor; bu, toplam duvar saati süresinin üçünün toplamı yerine en yavaş moda eşit olduğu anlamına gelir
thinking ve reasoning_effort API parametreleri, mod kontrolünün sistem istemi yönlendirmesine bel bağlamak yerine DeepSeek'in API'siyle uyumlu, temiz ve açık olmasına yardımcı olur
Önbellek farkındalıklı maliyet tahmini, girdi tokenlarını önbellek isabeti ve kaçırma bölümlerine ayırmada yardımcı olur; bu da özellikle önbelleğin ısındığı tekrarlı çalışmalarda, Non-think'in neredeyse ücretsiz görünmesine neden olabilecek durumlarda maddi olarak daha doğru maliyet rakamları üretir
Bu projeyi daha da genişletmek için, bir LLM-hakem katmanı eklemeyi (yanıtları otomatik olarak puanlamak için Claude veya GPT-4 gibi ayrı bir model kullanarak), aynı sorguları yeniden çalıştırmaktan kaçınmak için istem karmasında yanıtları önbelleğe almayı veya Flash Think Max'i Pro Think High'a karşı koyan ve V4 makalesinin ortaya koyduğu ancak tam olarak yanıtlamadığı gerçekten ilginç bir maliyet-paritesi sorusunu ele alan bir çapraz model ekseni eklemeyi düşünebilirsiniz.
En İyi Yapay Zekâ Kursları
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.




