
Khóa học
Phát triển hệ thống AI với OpenAI API
3 giờ
22.9K
DeepSeek V4 là thế hệ mới nhất của mô hình ngôn ngữ Mixture-of-Experts (MoE) do DeepSeek AI phát triển. Dòng này gồm hai biến thể:
Một số cải tiến kiến trúc phân biệt V4 với các phiên bản trước:
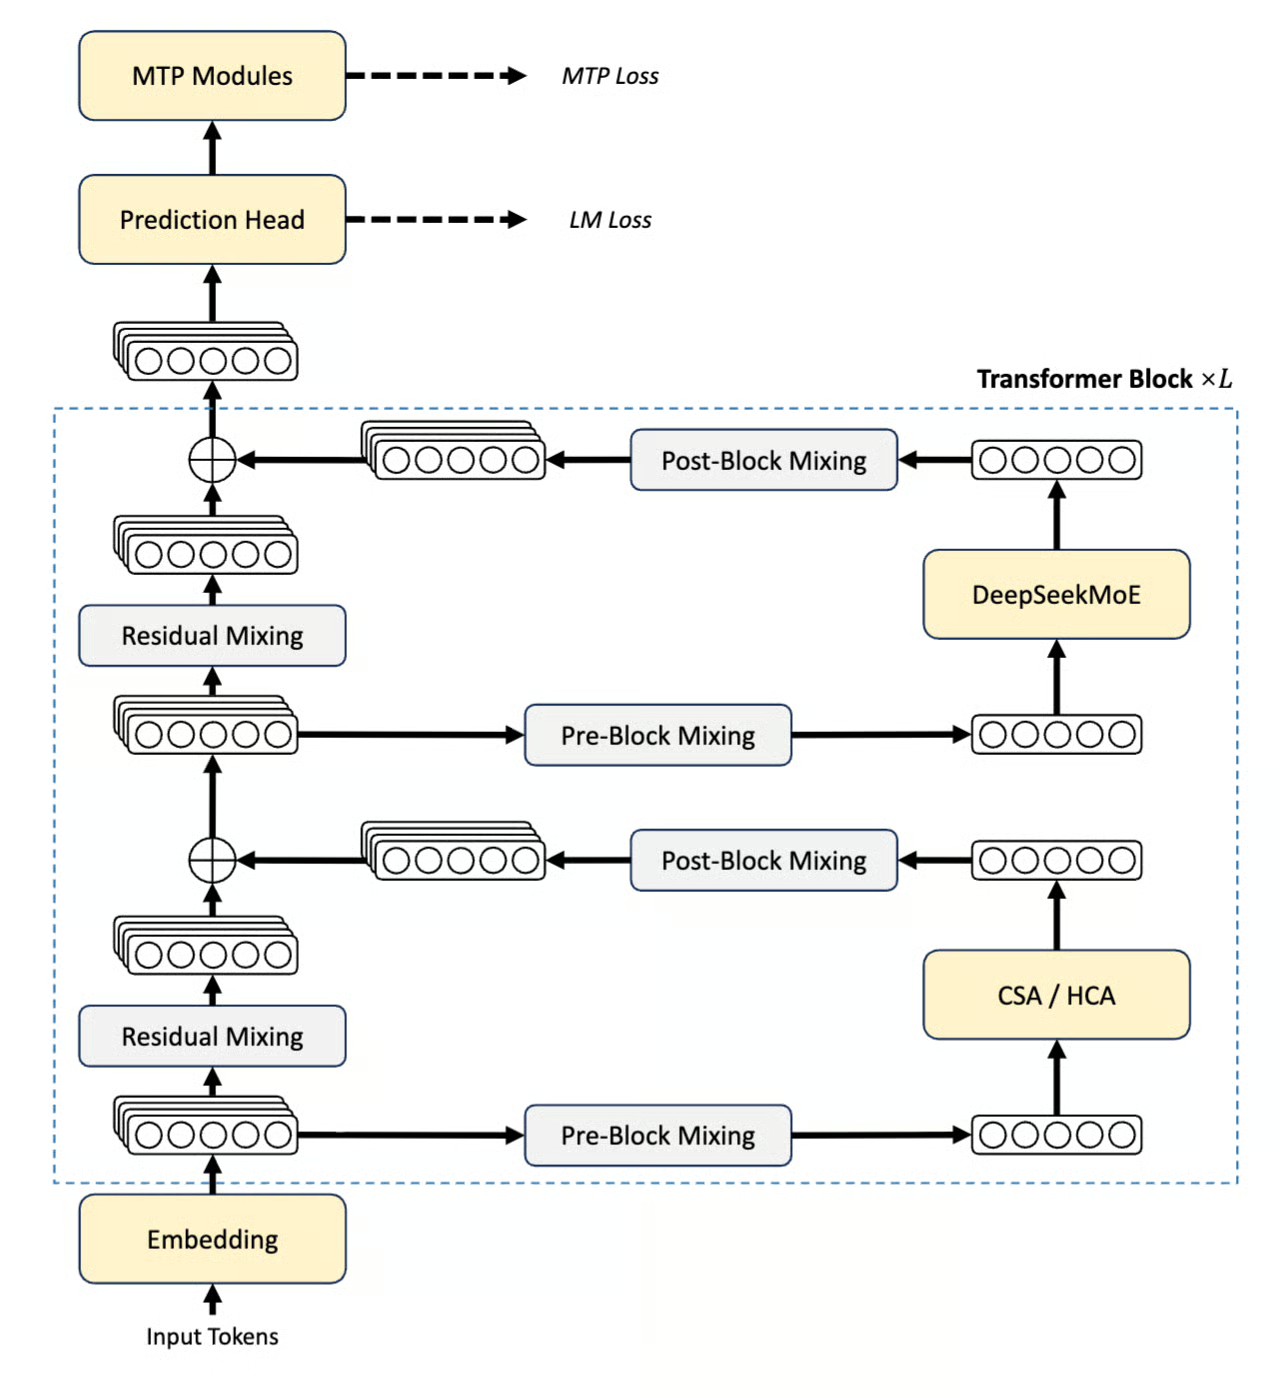
Hình: Kiến trúc dòng DeepSeek V4 (Báo cáo kỹ thuật DeepSeek)
Cả hai mô hình đều hỗ trợ ba chế độ nỗ lực suy luận riêng biệt, Non-think, Think High và Think Max, mà chúng ta sẽ khám phá và so sánh trong hướng dẫn này.
Nhóm DeepSeek đã so sánh hiệu năng của V4 với các đối thủ, và đây là những gì họ tìm thấy:
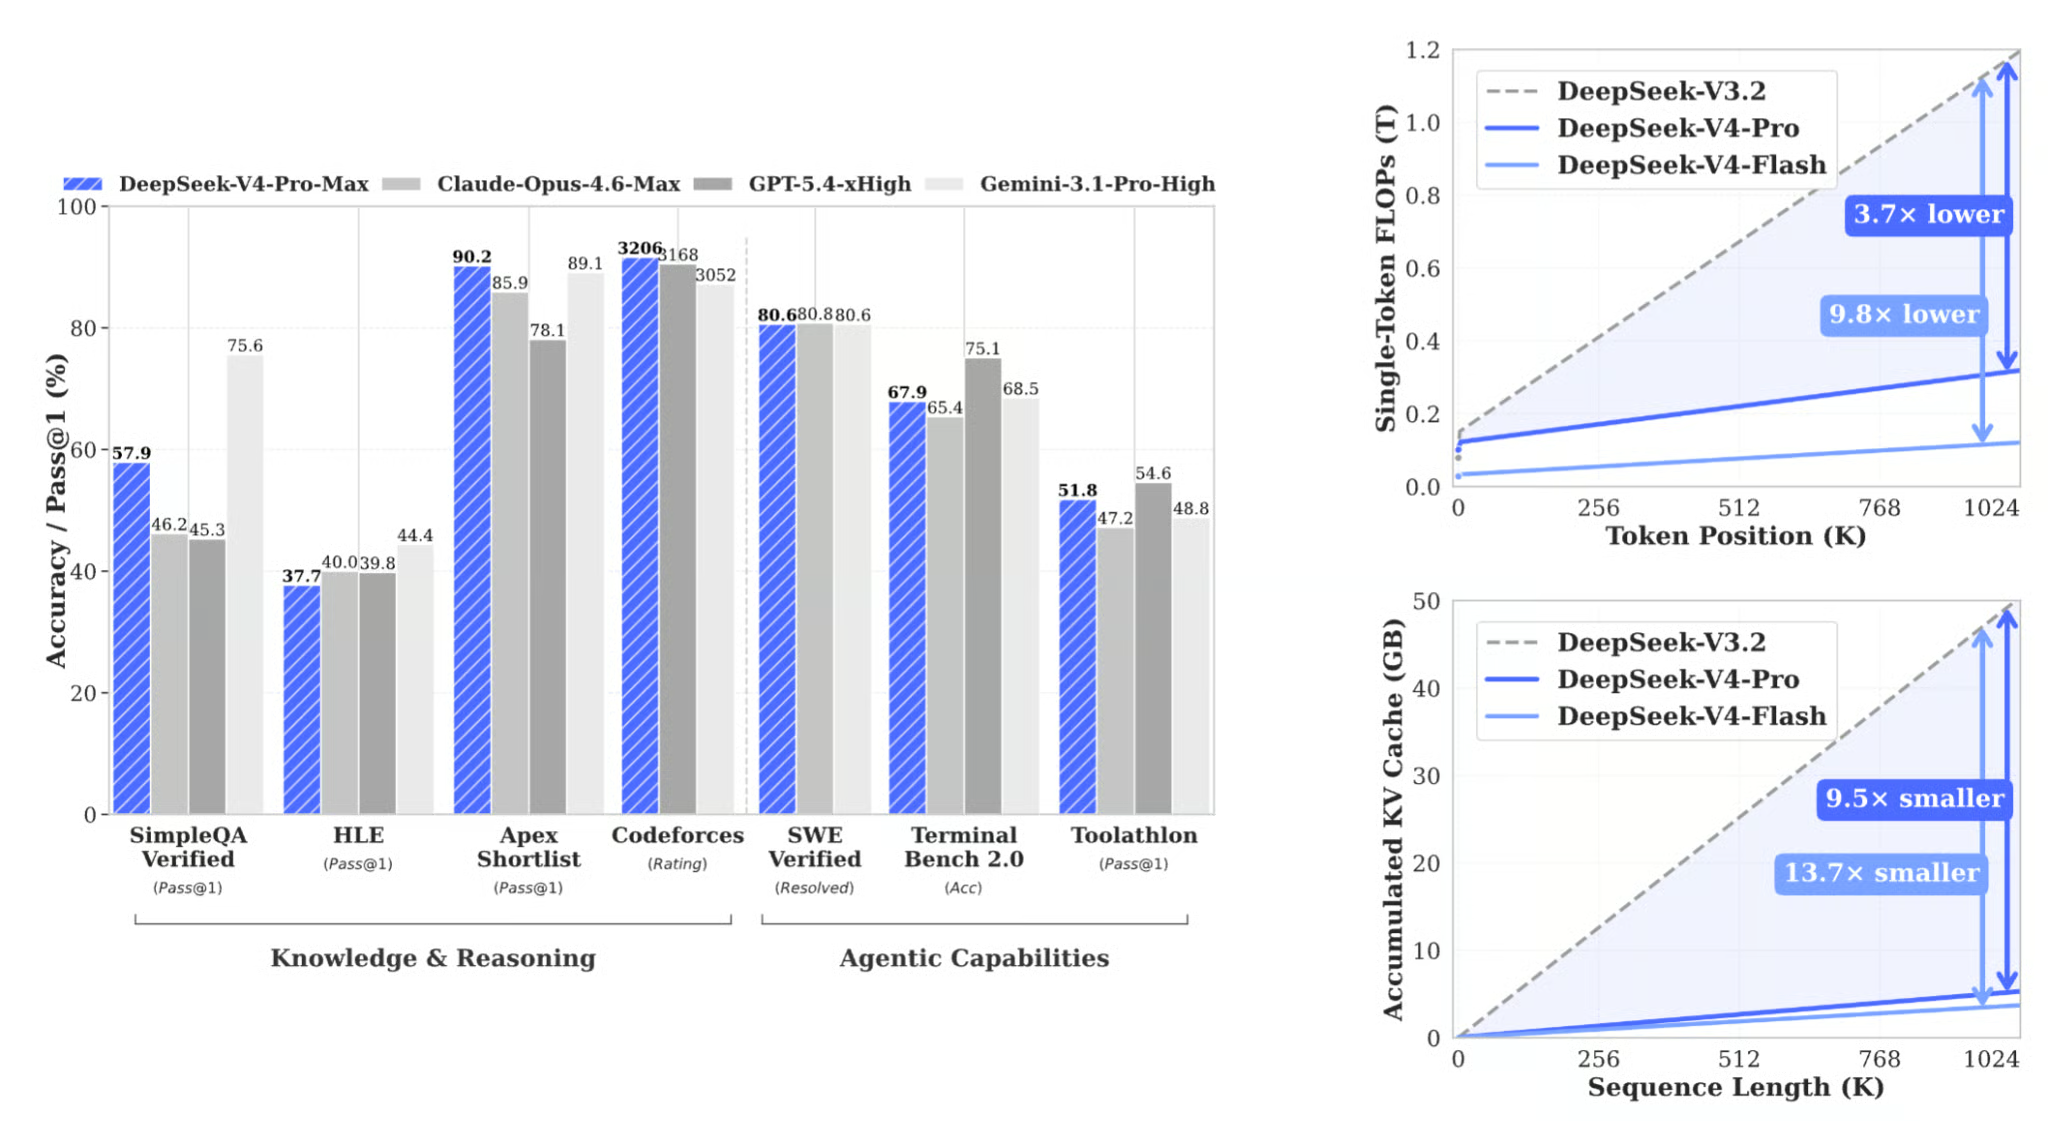
Hình: Hiệu năng benchmark của dòng DeepSeek V4 (Báo cáo kỹ thuật DeepSeek)
Biểu đồ cột bên trái cho thấy V4-Pro-Max đứng ở đâu so với các mô hình đóng nguồn tiên tiến trên các tác vụ kiến thức, suy luận và tác tử. Hai biểu đồ bên phải cho thấy vì sao các lợi ích hiệu quả lại quan trọng, và chúng là các kết quả gây bất ngờ hơn. DeepSeek-V4-Pro-Max (chế độ suy luận Think Max) đạt kết quả cạnh tranh với các mô hình đóng nguồn tiên tiến:
|
Benchmark |
DeepSeek-V4-Pro Max |
Claude Opus 4.6 Max |
Gemini-3.1-Pro High |
|
LiveCodeBench (Pass@1) |
93,5 |
88,8 |
91,7 |
|
Xếp hạng Codeforces |
3206 |
— |
3052 |
|
GPQA Diamond (Pass@1) |
90,1 |
91,3 |
94,3 |
|
SWE Verified (Resolved) |
80,6 |
80,8 |
80,6 |
Xếp hạng Codeforces 3206 đặt V4-Pro-Max ở cấp Legendary Grandmaster, khiến các tác vụ lập trình trong đấu trường của chúng ta trở thành một bài kiểm tra sức bền thực sự thú vị.
Trước khi xây dựng ứng dụng, đáng để hiểu mỗi chế độ thực sự làm gì:
Non-think: Mô hình phản hồi trực tiếp, không có chuỗi suy nghĩ nội bộ. Chế độ này lý tưởng cho các tác vụ coi trọng tốc độ hơn chiều sâu, như chuyển đổi định dạng, tra cứu đơn giản và tóm tắt một câu.Think High: Mô hình suy luận từng bước trước khi đưa ra câu trả lời. Đây là cân bằng tốt giữa chiều sâu và chi phí cho các tác vụ trung bình như gỡ lỗi, thiết kế hệ thống và lập kế hoạch.Think Max: Mô hình đẩy suy luận đến mức tối đa, khám phá nhiều cách tiếp cận, kiểm chứng logic chặt chẽ và chỉ chốt câu trả lời cuối cùng khi chắc chắn. Vì vậy, chế độ Think Max phù hợp nhất cho các bài chứng minh toán khó, tái cấu trúc nhiều tệp phức tạp, hoặc bất kỳ tác vụ nào mà câu trả lời sai nhưng tự tin còn tệ hơn một câu trả lời chậm mà đã được kiểm chứng.Điều then chốt mà hướng dẫn này chứng minh là Think Max không phải lúc nào cũng thắng. Với các tác vụ tầm thường, nó lãng phí tính toán cho chất lượng tương đương. Mục tiêu của đấu trường là làm rõ chế độ nào thực sự đáng dùng cho từng dạng tác vụ, dựa trên độ trễ thực tế, số token, chi phí và đánh giá của người dùng.
Nếu bạn muốn xem mô hình so sánh với các LLM tối tân khác, tôi khuyến nghị đọc các bài viết của chúng tôi về Claude Opus 4.7 so với DeepSeek V4 và GPT-5.5 so với DeepSeek V4.
Trong hướng dẫn này, chúng ta sẽ xây dựng một ứng dụng Streamlit có thể:
Nhận một lời nhắc và danh mục tác vụ từ người dùng
Gửi ba lời gọi API song song, mỗi lời gọi cho một chế độ suy luận, sử dụng ThreadPoolExecutor của Python
Phân tích vết suy nghĩ từ các khối <think>...</think> trong đầu ra của mô hình
Theo dõi độ trễ, số token và chi phí ước tính cho mỗi chế độ
Trình bày so sánh cạnh nhau với các chỉ số, hệ thống đánh giá người dùng và tóm tắt người thắng cuộc
Toàn bộ ứng dụng hoạt động chỉ là một tệp app.py, không cần cơ sở dữ liệu hay dịch vụ nền bên ngoài.
Mã nguồn hoàn chỉnh cho hướng dẫn này có trên kho GitHub của tôi.
Bắt đầu bằng cách tạo một thư mục dự án và cài đặt hai gói cần thiết:
mkdir deepseek-arena && cd deepseek-arena
pip install streamlit>=1.32.0 openai>=1.12.0
Thư viện openai được dùng ở đây vì API của DeepSeek tương thích với OpenAI, nghĩa là chúng ta có thể trỏ client OpenAI tới base URL của DeepSeek mà không cần thay đổi nào khác. Không cần SDK riêng của DeepSeek.
Lấy khóa API từ platform.deepseek.com và đặt nó làm biến môi trường:
export DEEPSEEK_API_KEY="sk-..."Giờ môi trường đã sẵn sàng, chúng ta có thể chuyển sang cấu hình mô hình và các chế độ.
Trước khi viết logic, chúng ta định nghĩa các import, định danh mô hình, cấu hình chế độ suy luận và hằng số giá. Các dictionary này điều khiển hành vi của toàn bộ ứng dụng, như danh sách mô hình trong dropdown, tham số API dẫn dắt mỗi chế độ suy luận, bảng màu UI và ước tính chi phí hiển thị ở bảng so sánh.
import os
import time
import concurrent.futures
from dataclasses import dataclass
from typing import Optional, Dict
import streamlit as st
from openai import OpenAI
DEEPSEEK_BASE_URL = "https://api.deepseek.com"
DEEPSEEK_API_KEY_ENV = "DEEPSEEK_API_KEY"
MODELS = {
    "DeepSeek-V4-Flash (default)": "deepseek-v4-flash",
    "DeepSeek-V4-Pro": "deepseek-v4-pro",
}
MODES: Dict[str, dict] = {
    "Non-think": {
        "icon": "",
        "color": "#10b981",
        "badge": "green",
        "desc": "Fast, direct answers — no internal reasoning",
        "thinking_type": "disabled",
        "reasoning_effort": None,
    },
    "Think High": {
        "icon": "",
        "color": "#3b82f6",
        "badge": "blue",
        "desc": "Careful step-by-step reasoning before responding",
        "thinking_type": "enabled",
        "reasoning_effort": "high",
    },
    "Think Max": {
        "icon": "",
        "color": "#ef4444",
        "badge": "red",
        "desc": "Exhaustive reasoning — push analysis to the limit",
        "thinking_type": "enabled",
        "reasoning_effort": "max",
    },
}
PRICING = {
    "deepseek-v4-flash": {
        "input_cache_hit":  0.0028,
        "input_cache_miss": 0.14,
        "output":           0.28,
    },
    "deepseek-v4-pro": {
        "input_cache_hit":  0.003625,
        "input_cache_miss": 0.435,
        "output":           0.87,
    },
}
Một vài lựa chọn thiết kế đáng để mổ xẻ thêm:
Tham số cho chế độ suy nghĩ: Mỗi mục trong MODES mang hai trường API thay vì system prompt. Chúng gồm thinking_type và reasoning_effort (“high”, "max" hoặc None). thinking_type được truyền qua extra_body={"thinking": {"type": ...}}, còn reasoning_effort là tham số cấp cao của request. Non-think đặt thinking_type thành "disabled" và để reasoning_effort là None, nên không gửi phần thân suy nghĩ.
Flash là mô hình mặc định: Flash kích hoạt 13B tham số mỗi token so với 49B của Pro, khiến ba cuộc gọi song song đủ rẻ để chạy lặp lại trong quá trình thử nghiệm. Pro có sẵn qua dropdown khi bạn cần hiệu năng hàng đầu, nhưng Think Max trên Pro sẽ tiêu tốn hạn mức nhanh, nên để nó ở chế độ tự chọn thay vì mặc định là hàng rào kiểm soát chi phí có chủ đích.
Lưu ý: Các giá trị dùng trong mã trên phản ánh V4-Pro ở mức giảm giá khuyến mãi hiện tại. Vì vậy, hãy luôn xác minh mức giá hiện hành tại api-docs.deepseek.com/quick_start/pricing trước khi công bố so sánh chi phí, vì cả mức cơ bản lẫn khuyến mãi thường thay đổi sau khi ra mắt mô hình mới.
Thiết kế tác vụ là phần ít được đánh giá cao nhất khi xây dựng so sánh suy luận. Nếu mọi tác vụ đều khó và mở, Think Max sẽ luôn thắng và bản demo chẳng dạy được gì. Bộ tác vụ phải trải rộng toàn dải độ khó để mỗi chế độ có ít nhất một danh mục mà nó thắng.
TASKS = {
    "Trivial / Lookup": {
        "prompt": (
            "Complete both tasks below:\n\n"
            "Task A — Convert this JSON to YAML:\n"
            '{"name": "Alice", "age": 30, "skills": ["Python", "ML", "LLMs"],\n'
            ' "address": {"city": "San Francisco", "zip": "94105"}}\n\n'
            "Task B — Summarize this paragraph in exactly one sentence:\n"
            '"Large language models have rapidly transformed natural language processing '
            "by demonstrating unprecedented capabilities across translation, summarization, "
            "reasoning, and code generation, driven by scale and alignment techniques like RLHF "
            'that bring model outputs closer to human intent."'
        ),
        "expected_winner": "Non-think",
        "tip": "Non-think should dominate here. No reasoning is required.",
    },
    "Coding / Debugging": {
        "prompt": (
            "Find every bug in the Python code below, explain each bug clearly, "
            "and provide a fully corrected version:\n\n"
            "```python\n"
            "def binary_search(arr, target):\n"
            "    left, right = 0, len(arr)\n"
            "    while left < right:\n"
            "        mid = (left + right) // 2\n"
            "        if arr[mid] == target:\n"
            "            return mid\n"
            "        elif arr[mid] < target:\n"
            "            left = mid\n"
            "        else:\n"
            "            right = mid - 1\n"
            "    return -1\n\n"
            "print(binary_search([1, 3, 5, 7, 9], 7))\n"
            "```"
        ),
        "expected_winner": "Think High",
        "tip": "Think High usually finds the bugs and explains them well.",
    },
    "System Design": {
        "prompt": (
            "Design a scalable vector search system for 100 million documents.\n\n"
            "Address each of the following:\n"
            "1. Indexing strategy and pipeline\n"
            "2. ANN algorithm selection (HNSW vs IVF-PQ vs ScaNN — justify your choice)\n"
            "3. Sharding and replication strategy\n"
            "4. p99 query latency target (< 50 ms) — how do you hit it?\n"
            "5. Real-time document update handling\n"
            "6. Top 3 failure modes and their mitigations"
        ),
        "expected_winner": "Think High",
        "tip": "Think High often gives the best quality-per-dollar design answer.",
    },
    "Planning": {
        "prompt": (
            "Create a detailed 6-month roadmap for deploying an enterprise RAG system.\n\n"
            "Include:\n"
            "- Month-by-month phases with concrete, measurable milestones\n"
            "- Top 5 risks and mitigation strategies\n"
            "- Team roles and headcount required per phase\n"
            "- Evaluation metrics for each phase (how do you know it's working?)\n"
            "- Go / no-go production checklist"
        ),
        "expected_winner": "Think High",
        "tip": "Think High should produce a more structured, complete roadmap.",
    },
    "Math (IMO-style)": {
        "prompt": (
            "Solve this problem completely and verify your answer:\n\n"
            "Find all positive integers n such that n² + 1 is divisible by n + 1.\n\n"
            "Your answer must include:\n"
            "1. A complete proof with clear logical steps\n"
            "2. Verification with at least 3 concrete numerical examples\n"
            "3. A rigorous argument for why your solution set is complete "
            "(i.e., there are no other solutions)"
        ),
        "expected_winner": "Think Max",
        "tip": "Think Max earns its cost when thorough verification matters.",
    },
}
Năm tác vụ này ánh xạ rõ ràng tới ba người thắng dự kiến:
|
Tác vụ |
Người thắng dự kiến |
Lý do |
|
Trivial / Lookup |
Non-think |
Không cần chi phí suy luận; thời gian suy nghĩ là lãng phí thuần túy |
|
Coding / Debugging |
Think High |
Một lượt lập luận có phương pháp bắt hết lỗi; Max chỉ thêm giá trị biên |
|
System Design |
Think High |
Chiều sâu cải thiện chất lượng; khai thác kiệt sức không thêm kiến trúc hữu ích |
|
Planning |
Think High |
Cấu trúc thắng thế so với tính toán thô; lộ trình không phải là chứng minh |
|
Math (IMO-style) |
Think Max |
Kiểm chứng là điểm chịu tải; một chứng minh sai còn tệ hơn một chứng minh đúng nhưng chậm |
Mỗi tác vụ cũng mang trường expected_winner. Ứng dụng hiển thị điều này sau khi có kết quả để người dùng kiểm tra liệu người thắng dự kiến có giữ vững hay bị đánh bại.
Với các mẫu tác vụ đã định nghĩa, chúng ta cần một cấu trúc để giữ kết quả từ mỗi lời gọi API. Thay vì truyền các đối tượng phản hồi thô khắp ứng dụng, ta định nghĩa một dataclass RunResult duy nhất để ghi nhận mọi chỉ số mà bảng so sánh cần.
@dataclass
class RunResult:
    mode: str
    answer: str = ""
    thinking: str = ""
    latency: float = 0.0
    input_tokens: int = 0
    output_tokens: int = 0
    cost_usd: float = 0.0
    error: Optional[str] = None
    @property
    def tokens_per_second(self) -> Optional[float]:
        if self.latency > 0 and self.output_tokens > 0:
            return self.output_tokens / self.latency
        return None
    @property
    def thinking_word_count(self) -> int:
        return len(self.thinking.split()) if self.thinking else 0
Trường thinking tách biệt với answer vì API DeepSeek V4 trả về chuỗi suy nghĩ trong trường reasoning_content riêng, ngang cấp với content trong cấu trúc phản hồi. Giữ chúng riêng giúp UI hiển thị vết suy luận có thể thu gọn bên cạnh câu trả lời cuối cùng gọn gàng, khiến khác biệt giữa các chế độ trở nên trực quan, đặc biệt ở bài toán toán học nơi vết Think Max có thể dài tới hàng nghìn từ.
Thuộc tính tokens_per_second đo thông lượng sinh đầu ra độc lập với độ dài prompt. Điều này hữu ích để so sánh hiệu quả giữa các chế độ khi số token đầu ra khác nhau đáng kể. Lưu ý Think Max tự nhiên sinh nhiều token hơn, nên so sánh thuần độ trễ có thể gây hiểu lầm nếu không xem thêm tốc độ sinh của từng chế độ.
Trước khi viết logic gọi API, chúng ta định nghĩa hai hàm trợ giúp nhỏ nằm giữa phản hồi SDK thô và RunResult. Chúng dễ bị bỏ qua nhưng rất quan trọng cho độ chính xác chi phí.
def get_cached_prompt_tokens(usage) -> int:
    prompt_details = getattr(usage, "prompt_tokens_details", None)
    if prompt_details is None:
        return 0
    cached_tokens = getattr(prompt_details, "cached_tokens", None)
    if cached_tokens is not None:
        return cached_tokens or 0
    if isinstance(prompt_details, dict):
        return prompt_details.get("cached_tokens", 0) or 0
    return 0
def estimate_cost_usd(
    model: str,
    prompt_tokens: int,
    completion_tokens: int,
    cached_prompt_tokens: int,
) -> float:
    pricing = PRICING.get(model, PRICING["deepseek-v4-flash"])
    cached_tokens = min(cached_prompt_tokens, prompt_tokens)
    uncached_tokens = max(prompt_tokens - cached_tokens, 0)
    return (
        cached_tokens   / 1_000_000 * pricing["input_cache_hit"]
        + uncached_tokens / 1_000_000 * pricing["input_cache_miss"]
        + completion_tokens / 1_000_000 * pricing["output"]
    )
Hàm get_cached_prompt_tokens() không truy cập trường trực tiếp vì cấu trúc prompt_tokens_details không đảm bảo nhất quán giữa các phiên bản SDK. Nó kiểm tra thuộc tính kiểu trước, sau đó rơi về truy cập dict, rồi trả về 0 thay vì ném ngoại lệ. Điều này quan trọng trong ThreadPoolExecutor nơi một lỗi im lặng ở một luồng có thể tạo ước tính chi phí sai thấp cho chế độ đó mà không hiện lỗi rõ ràng.
Hàm trợ giúp estimate_cost_usd() tách số token prompt thành phần được cache và không được cache trước khi áp mức giá. Vì DeepSeek đã giảm giá cache-hit xuống một phần mười so với cache-miss, khác biệt giữa prompt nguội và ấm có thể rất lớn. Trên một tác vụ chạy lặp lại, Non-think có thể xem như gần như miễn phí so với Think Max, không phải vì nó sinh ít token hơn, mà vì prompt ngắn hơn gần như chắc chắn ở trạng thái cache ấm.
Đây là lõi kiến trúc của đấu trường. Cả ba chế độ được gọi đồng thời bằng ThreadPoolExecutor, vì thế tổng thời gian thực bằng thời gian của chế độ chậm nhất thay vì tổng của cả ba.
def call_mode(client: OpenAI, model: str, mode_name: str, user_prompt: str) -> RunResult:
    result = RunResult(mode=mode_name)
    mode_cfg = MODES[mode_name]
    start = time.perf_counter()
    try:
        request_kwargs = {
            "model": model,
            "messages": [{"role": "user", "content": user_prompt}],
            "max_tokens": 4096,
            "extra_body": {"thinking": {"type": mode_cfg["thinking_type"]}},
        }
        if mode_cfg["reasoning_effort"]:
            request_kwargs["reasoning_effort"] = mode_cfg["reasoning_effort"]
        response = client.chat.completions.create(**request_kwargs)
        result.latency = time.perf_counter() - start
        message = response.choices[0].message
        result.thinking = (getattr(message, "reasoning_content", None) or "").strip()
        result.answer   = (message.content or "").strip()
        usage = response.usage
        result.input_tokens  = getattr(usage, "prompt_tokens", 0) or 0
        result.output_tokens = getattr(usage, "completion_tokens", 0) or 0
        result.cost_usd = estimate_cost_usd(
            model=model,
            prompt_tokens=result.input_tokens,
            completion_tokens=result.output_tokens,
            cached_prompt_tokens=get_cached_prompt_tokens(usage),
        )
    except Exception as exc:
        result.latency = time.perf_counter() - start
        result.error = str(exc)
    return result
def run_parallel(client: OpenAI, model: str, prompt: str) -> Dict[str, RunResult]:
    results: Dict[str, RunResult] = {}
    with concurrent.futures.ThreadPoolExecutor(max_workers=3) as pool:
        futures = {
            pool.submit(call_mode, client, model, mode_name, prompt): mode_name
            for mode_name in MODES
        }
        for fut in concurrent.futures.as_completed(futures):
            results[futures[fut]] = fut.result()
    return results
Một số quyết định thiết kế nổi bật ở đây:
Xây dựng request_kwargs có điều kiện: Chế độ Non-think gửi thinking_type: "disabled" và không có khóa reasoning_effort. Think High và Think Max gửi thinking_type: "enabled" và mức nỗ lực tương ứng. Điều kiện mode_cfg["reasoning_effort"] đảm bảo tham số này bị lược bỏ hoàn toàn cho Non-think thay vì gửi None, vốn có thể gây lỗi xác thực API.
Đọc trực tiếp reasoning_content: Chuỗi suy nghĩ được đọc từ message.reasoning_content bằng getattr() với mặc định là chuỗi rỗng. Cách này vững chắc hơn so với việc phân tích thẻ <think>...</think> từ chuỗi nội dung. Nó dùng trường phản hồi chính thức, xử lý trường hợp không có vết (Non-think), và không hỏng nếu đầu ra của mô hình tình cờ chứa từ "think" vì lý do khác.
getattr() phòng thủ trên các trường usage: Các trường usage được truy cập bằng getattr(..., 0) or 0 thay vì truy cập trực tiếp. Nghĩa là nếu đối tượng usage thiếu trường trong phiên bản SDK cũ hoặc phản hồi bất thường, giá trị dự phòng sẽ là 0 thay vì AttributeError khiến cả lượt chạy thất bại.
Xử lý lỗi: Nếu một cuộc gọi thất bại, dataclass RunResult lưu chuỗi lỗi thay vì ném lỗi. UI kiểm tra result.error và hiển thị thẻ thông tin mà không làm sập toàn bộ lượt chạy ba chế độ.
Bước này bao phủ lớp trình bày: bố cục trang, hệ thống thiết kế CSS, cột kết quả cho mỗi chế độ và cấu trúc tab để tổ chức so sánh mà không gây choáng ngợp khi tải lần đầu.
Ứng dụng dùng st.set_page_config với layout="wide" để có đủ không gian ngang cho so sánh ba cột:
def main():
    st.set_page_config(
        page_title="DeepSeek V4 Think Mode Arena",
        layout="wide",
        initial_sidebar_state="expanded",
    )
    inject_css()
Hàm inject_css() chèn một hệ thống thiết kế đầy đủ qua st.markdown. Ứng dụng dùng nền giấy da ấm với Space Mono cho tiêu đề monospace và chip chỉ số, và DM Sans cho phần văn bản nội dung.
def render_mode_column(result: RunResult, mode_name: str):
    cfg = MODES[mode_name]
    badge_cls = f"mode-{cfg['badge']}"
    st.markdown(
        f'<div class="mode-header {badge_cls}">{mode_name}</div>',
        unsafe_allow_html=True,
    )
    st.markdown(f'<div class="subtle-copy">{cfg["desc"]}</div>', unsafe_allow_html=True)
    if result.error:
        st.error(f"**API Error:** {result.error}")
        return
    chips = [
        ("Latency", f"{result.latency:.1f}s"),
        ("Output tokens", f"{result.output_tokens:,}"),
        ("Cost", f"${result.cost_usd:.5f}"),
    ]
    if result.tokens_per_second:
        chips.append(("Tok/s", f"{result.tokens_per_second:.0f}"))
    chip_html = "".join(
        f'<span class="metric-chip">{label} <span>{val}</span></span>'
        for label, val in chips
    )
    st.markdown(chip_html, unsafe_allow_html=True)
    if result.thinking:
        with st.expander(f" Thinking trace — {result.thinking_word_count:,} words"):
            preview = result.thinking[:5000]
            if len(result.thinking) > 5000:
                preview += "\n\n[… truncated for display …]"
            st.text(preview)
    elif mode_name != "Non-think":
        st.caption("_No thinking trace emitted_")
    st.markdown('<div class="answer-label">Final answer</div>', unsafe_allow_html=True)
    st.markdown(result.answer if result.answer else "_No answer returned._")
Trình mở rộng vết suy nghĩ đặc biệt hữu ích vì nó làm cho khác biệt giữa các chế độ trở nên sống động: vết Think Max có thể dài hàng nghìn từ tự sửa và kiểm chứng ở một bài toán khó, trong khi Non-think có thể không có vết nào.
Bố cục chính dùng các tab của Streamlit để tách mối quan tâm mà không dồn mọi thứ vào một cuộn trang:
overview_tab, answers_tab, ratings_tab = st.tabs(
    ["Overview", "Full Responses", "Ratings"]
)
Tab “Overview” hiển thị tóm tắt người thắng và bảng chỉ số. Tab “Full Responses” hiển thị so sánh ba cột cạnh nhau với vết suy nghĩ, trong khi tab “Ratings” hiển thị các thanh trượt để người dùng chấm điểm chất lượng (1–5) theo chế độ.
Bước cuối xây dựng hai thành phần nằm trong tab Overview, tức bảng chỉ số phẳng đặt mọi chiều đo cạnh nhau, và tóm tắt người thắng nêu người chiến thắng trong bốn hạng mục riêng biệt.
def render_metrics_table(results: Dict[str, RunResult], ratings: Dict[str, int]):
    rows = []
    for mode_name, res in results.items():
        ok = not res.error
        rows.append({
            "Mode":            mode_name,
            "Latency (s)":     f"{res.latency:.2f}" if ok else "—",
            "Input Tokens":    f"{res.input_tokens:,}" if ok else "—",
            "Output Tokens":   f"{res.output_tokens:,}" if ok else "—",
            "Tok/s":           f"{res.tokens_per_second:.0f}" if (ok and res.tokens_per_second) else "—",
            "Est. Cost (USD)": f"${res.cost_usd:.5f}" if ok else "—",
            "Thinking Words":  f"{res.thinking_word_count:,}" if ok else "—",
            "User Rating":     f"{ratings.get(mode_name)}/5" if ratings.get(mode_name) else "—",
        })
    st.table(rows)
def render_winner_summary(results: Dict[str, RunResult], ratings: Dict[str, int], expected: str):
    valid = {k: v for k, v in results.items() if not v.error}
    fastest        = min(valid, key=lambda k: valid[k].latency)
    cheapest       = min(valid, key=lambda k: valid[k].cost_usd)
    most_efficient = max(
        valid,
        key=lambda k: valid[k].output_tokens / max(valid[k].cost_usd, 1e-9),
    )
    top_rated = max(ratings, key=ratings.get) if ratings else None
Dưới đây là cái nhìn nhanh về hai hàm này:
Hàm render_metrics_table() lặp qua mỗi RunResult và tạo một dictionary hàng cho từng chế độ. Tám cột bao quát so sánh đầy đủ, gồm thời gian (độ trễ, tok/s), quy mô (token đầu vào và đầu ra, số từ suy nghĩ), tiền bạc (chi phí ước tính) và đánh giá con người (điểm người dùng).
Hàm render_winner_summary() trước hết lọc bỏ mọi lượt thất bại trước khi tính người thắng, vì thế một lỗi API đơn lẻ không làm lệch kết quả. Sau đó, nó tìm người dẫn đầu ở bốn chiều độc lập như tốc độ thời gian thực, chi phí thô, hiệu quả đầu ra và điểm đánh giá người dùng.
Bốn hạng mục này được cố ý giữ tách biệt thay vì gộp thành một điểm số, bởi một điểm tổng hợp có trọng số sẽ buộc ứng dụng quyết định rằng độ trễ quan trọng hơn chi phí, điều vốn là quyết định sản phẩm, không phải quyết định của khung.
Ứng dụng cũng hiển thị người thắng dự đoán cho mỗi tác vụ, nhắc người dùng xác nhận liệu có khớp hay không:
st.markdown(
    f"> **Expected winner for this task type:** {expected} — "
    "does your result match? Rate answers to confirm.",
)Toàn bộ ứng dụng nằm trong một tệp app.py với hai phụ thuộc, và khởi động chỉ cần hai lệnh:
# Set your API key
export DEEPSEEK_API_KEY="sk-..."
# Run
streamlit run app.py
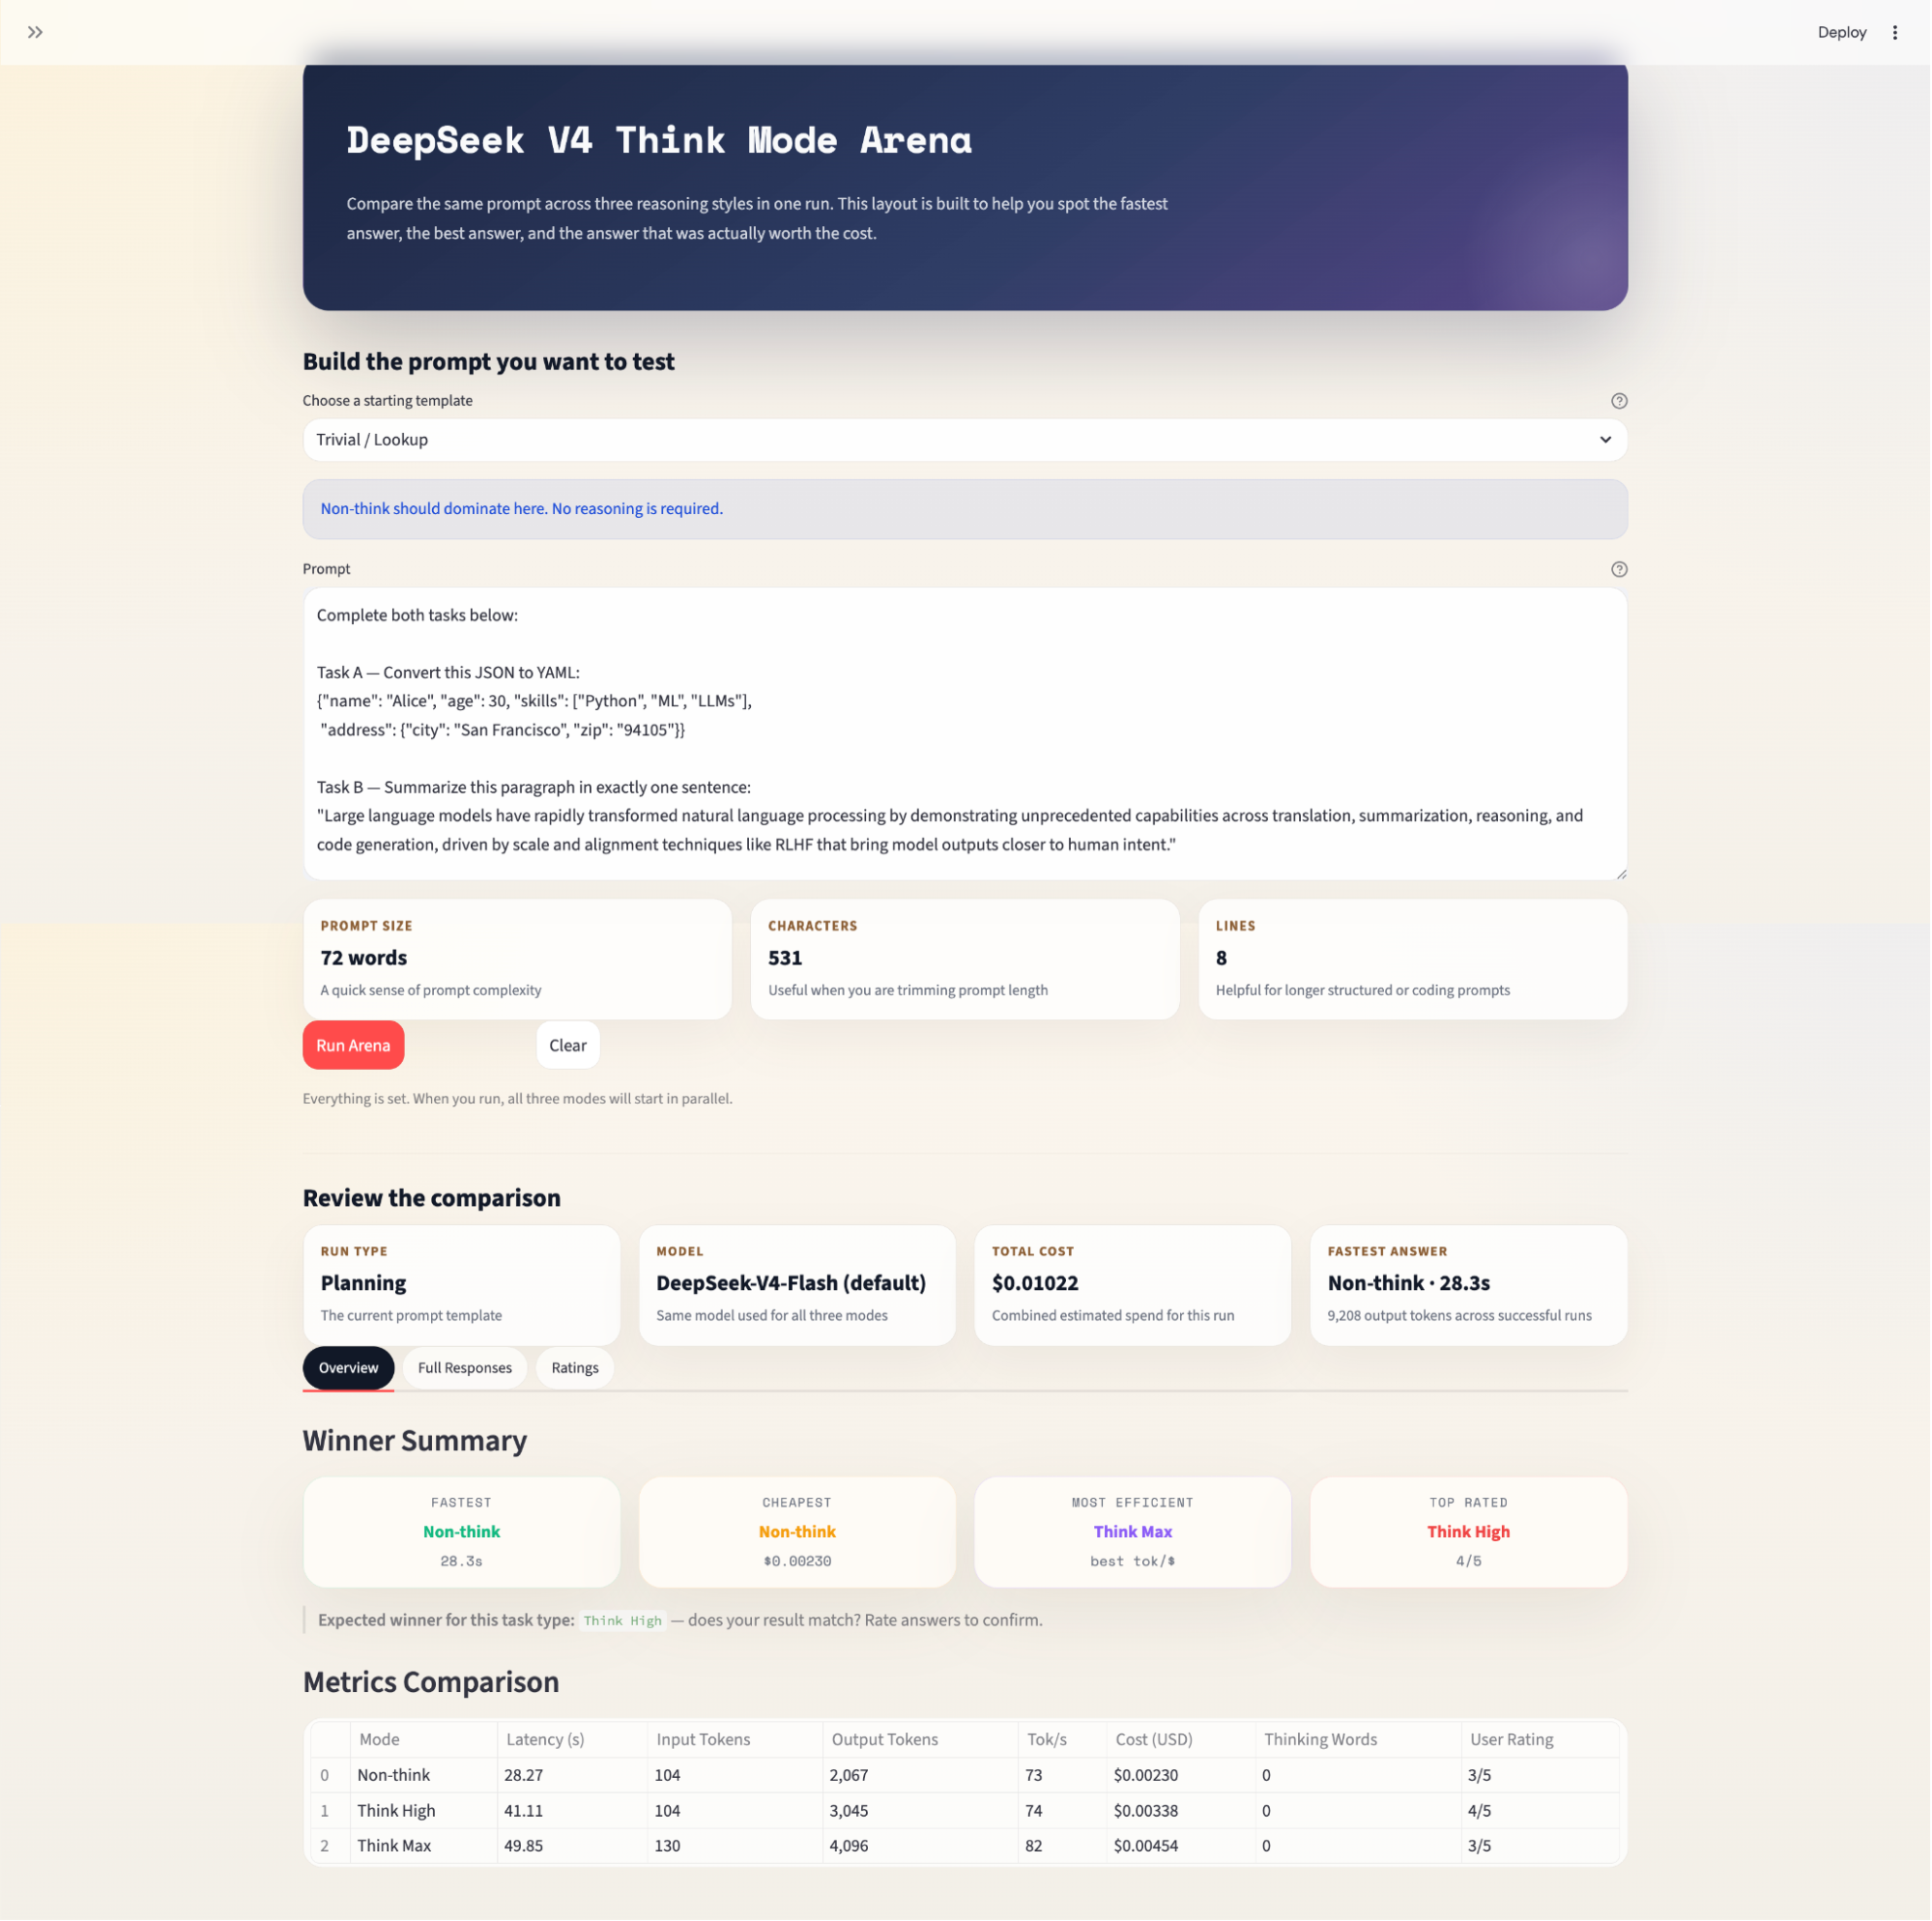
Ứng dụng mở trong trình duyệt tại localhost:8501. Chọn một mẫu tác vụ từ dropdown, tùy ý chỉnh sửa prompt, rồi nhấp Run Arena. Thanh tiến trình sẽ cập nhật khi mỗi chế độ hoàn tất. Kết quả được lưu trong st.session_state để bạn có thể chuyển tab và chấm điểm mà không kích hoạt chạy lại.
Lưu ý về giá: DeepSeek đã điều chỉnh mức giá API V4 đáng kể kể từ khi ra mắt. V4-Pro hiện đang có giảm giá khuyến mãi, và giá cache-hit đã được giảm xuống một phần mười so với cache-miss vào tháng 4/2026. Các con số chi phí hiển thị trong ứng dụng phản ánh mức hiện tại nhưng có thể thay đổi. Luôn xác minh tại api-docs.deepseek.com/quick_start/pricing trước khi sử dụng bất kỳ mô hình nào.
Trong hướng dẫn này, chúng ta đã xây dựng một ứng dụng Streamlit chạy cùng một prompt trên ba chế độ suy luận của DeepSeek V4 song song và so sánh kết quả theo độ trễ, chi phí, số token, độ sâu vết suy nghĩ và chất lượng do người dùng đánh giá. Những lựa chọn kiến trúc chủ chốt gồm:
ThreadPoolExecutor để đạt tính song song thực sự, đồng nghĩa tổng thời gian thực bằng thời gian của chế độ chậm nhất thay vì tổng của cả ba
Các tham số API thinking và reasoning_effort giúp đảm bảo điều khiển chế độ rõ ràng, tường minh và phù hợp với API của DeepSeek thay vì dựa vào điều hướng bằng system prompt
Ước tính chi phí có xét cache giúp tách token đầu vào thành phần cache-hit và cache-miss, tạo ra con số chi phí chính xác hơn đáng kể, đặc biệt ở các lượt chạy lặp khi ưu đãi cache ấm có thể khiến Non-think gần như miễn phí
Để mở rộng dự án, hãy cân nhắc thêm lớp LLM-as-judge (dùng một mô hình riêng như Claude hoặc GPT-4 để chấm điểm tự động), lưu đệm phản hồi theo băm của prompt để tránh chạy lại truy vấn giống hệt, hoặc thêm trục so sánh giữa mô hình như đối đầu Flash Think Max với Pro Think High, một câu hỏi cân bằng chi phí thực sự thú vị được nêu trong bài V4 nhưng chưa trả lời trọn vẹn.
Các khóa học AI hàng đầu
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
