Corso
Lavorare con l'API di OpenAI
3 ore
184.5K
Il modello più avanzato di OpenAI, Generative Pre-trained Transformer 4 (GPT-4), lanciato a marzo 2023, rappresenta un balzo in avanti nell’intelligenza artificiale, introducendo un nuovo punto di riferimento per le capacità dell’IA. Disponibile tramite ChatGPT Plus, l’API di OpenAI e Microsoft Copilot, GPT-4 si distingue per le sue abilità multimodali, in particolare con GPT-4V, che gli consente di elaborare immagini insieme al testo, aprendo la strada ad applicazioni innovative in vari settori.
Al cuore dei progressi di GPT-4 c’è il framework basato su transformer, pre-addestrato in modo estensivo su un’ampia gamma di dati da internet e da fonti con licenza, e ottimizzato con una combinazione di feedback umano e apprendimento per rinforzo guidato dall’IA. Questo approccio mira a migliorare l’allineamento del modello agli standard etici umani e alla conformità alle policy.
Sebbene GPT-4 rappresenti un miglioramento rispetto al suo predecessore, GPT-3, ne eredita alcune limitazioni, evidenziando le sfide complesse dei Large Language Model e della Generative AI. Alcune di queste sfide possono essere affrontate tramite un processo chiamato fine-tuning, che è proprio l’argomento di questo tutorial. Gli obiettivi di questo tutorial sono:
Va però notato che il fine-tuning di GPT-4 è attualmente in accesso sperimentale, e gli sviluppatori idonei possono richiederlo tramite la UI di fine-tuning. Detto questo, le tecniche di fine-tuning trattate sono applicabili a tutti i modelli GPT.
Il fine-tuning è un processo avanzato che affina modelli pre-addestrati (come GPT-4) per compiti o domini specifici, sfruttando l’ampia conoscenza di base acquisita dal modello durante l’addestramento iniziale su dataset eterogenei. Comporta l’adeguamento dei parametri del modello in base a dati specifici del compito, migliorandone le prestazioni e consentendogli di gestire applicazioni particolari con maggiore precisione ed efficienza.
Un esempio illustrativo dell’impatto del fine-tuning è il miglioramento delle risposte del modello a domande specialistiche. Per esempio, un modello pre-addestrato potrebbe offrire una spiegazione di base sul perché il cielo è blu. Con il fine-tuning, questa risposta può essere arricchita con un contesto scientifico dettagliato, rendendola più adatta ad applicazioni specializzate come piattaforme educative.
I metodi di fine-tuning spaziano dall’instruction fine-tuning, in cui i modelli vengono addestrati con esempi specifici che mostrano le risposte desiderate, al parameter-efficient fine-tuning (PEFT), che aggiorna solo un sottoinsieme dei parametri del modello per risparmiare risorse computazionali e prevenire il catastrophic forgetting.
Al contrario, la Retrieval Augmented Generation (RAG) rappresenta un approccio diverso. RAG combina elementi di modelli basati sul recupero e generativi per migliorare la qualità dei contenuti generati integrando informazioni recuperate da fonti esterne durante il processo di generazione.
Mentre il fine-tuning si concentra sull’ottimizzazione di modelli preesistenti per compiti specifici, RAG integra conoscenze esterne per arricchire il processo di generazione dei contenuti.
La scelta tra fine-tuning e RAG dipende dai requisiti specifici dell’applicazione, tra cui la necessità di informazioni aggiornate, le risorse computazionali disponibili e il livello di specializzazione richiesto. Il fine-tuning offre un modo diretto per sfruttare l’ampia base di conoscenza dei modelli pre-addestrati per compiti specifici, mentre RAG fornisce un approccio dinamico per garantire la rilevanza e l’accuratezza delle informazioni usate dal modello.
Il fine-tuning dei modelli di generazione del testo di OpenAI è un metodo potente per adattarli a esigenze specifiche, ma richiede tempo e risorse considerevoli. Prima di passare al fine-tuning, è consigliabile cercare di massimizzare le prestazioni del modello tramite prompt engineering, prompt chaining (suddividere compiti complessi in prompt più semplici e sequenziali) e uso di funzioni. Questo approccio è raccomandato per diversi motivi:
Il fine-tuning può essere particolarmente utile nei seguenti scenari:
Data la natura proprietaria dei modelli di OpenAI, per eseguire il fine-tuning di qualsiasi modello OpenAI devi utilizzare un’API di fine-tuning di OpenAI. Questo processo implica il caricamento dei tuoi dati sui server di OpenAI per addestrare il modello.
Al momento, solo i seguenti modelli sono supportati per il fine-tuning via API.
Il fine-tuning di GPT-4 è in accesso sperimentale e gli sviluppatori idonei possono richiedere l’accesso tramite la UI di fine-tuning. Indipendentemente dal modello usato, il processo di fine-tuning e il codice in questo tutorial non cambiano.
Questo è il passaggio più importante. La qualità di un modello sottoposto a fine-tuning dipende direttamente dai dati che creerai per eseguire il fine-tuning. Per l’API di OpenAI, i dati devono essere in formato jsonl.
Il formato JSONL è un formato di testo in cui ogni riga è un oggetto JSON separato, adatto all’elaborazione di grandi dataset riga per riga. È particolarmente utile per gestire dati facilmente suddivisibili in record individuali senza perdere struttura.
Esempio:
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
{"prompt": "<prompt text>", "completion": "<ideal generated text>"}
Per questo tutorial, ho creato dati di esempio con soli cinque esempi. I dati consistono in domande su vari argomenti di machine learning e risposte nello stile di Shakespeare.
Dati di esempio che ho creato per questo tutorial:
{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "What is machine learning?"}, {"role": "assistant", "content": "'Tis but the art of teaching machines to think, to learn from data most fine, and decisions to link."}]}

{"messages": [{"role": "system", "content": "You are teaching assistant for Machine Learning. You should help to user to answer on his question."}, {"role": "user", "content": "How doth neural networks work?"}, {"role": "assistant", "content": "They're like the brains of yon digital beast, with layers many, and nodes that cease."}]}Il primo passo per creare un job di fine-tuning tramite l’API di OpenAI è caricare il file. Per usare questa API, devi avere installata in Python la libreria openai.
!pip install openaiOra accedi al tuo account su platform.openai.com e genera un token API:
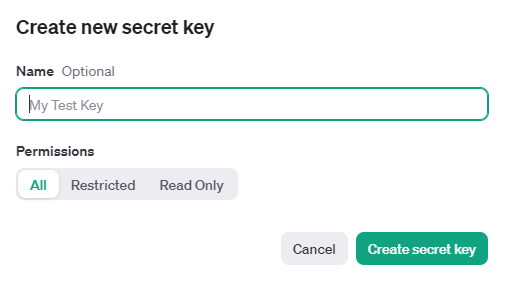
Puoi quindi impostare il token come variabile d’ambiente usando la libreria os.
import os


# Set the OPENAI_API_KEY environment variable
os.environ['OPENAI_API_KEY'] = '...'Il tuo file di training deve essere in formato jsonl. Una volta caricato il file, l’elaborazione potrebbe richiedere un po’ di tempo. La dimensione massima per gli upload è di 1 GB. Per caricare un file sul server OpenAI:
from openai import OpenAI
client = OpenAI()


client.files.create(
  file=open("train.jsonl", "rb"),
  purpose="fine-tune"
)
Output:
FileObject(id='file-rIua39sJX1O64gzxTYfpvJx7', bytes=11165, created_at=1709499930, filename='train.jsonl', object='file', purpose='fine-tune', status='processed', status_details=None)Dopo esserti assicurato che il file sia stato caricato correttamente, il passo successivo è creare un job di fine-tuning. training_file è l’ID del file restituito quando il file di training è stato caricato sull’API di OpenAI. Per avviare un job di fine-tuning:
from openai import OpenAI
client = OpenAI()


client.fine_tuning.jobs.create(
  training_file="file-rIua39sJX1O64gzxTYfpvJx7",
  model="gpt-3.5-turbo" #change to gpt-4-0613 if you have access
)
Per configurare impostazioni aggiuntive di fine-tuning, come il validation_file o gli iperparametri, consulta la documentazione dell’API sul fine-tuning.
I job di fine-tuning richiedono tempi variabili per essere completati, da pochi minuti a diverse ore, a seconda del modello e della dimensione del dataset. Per esempio, con appena 50 esempi nel nostro dataset train.jsonl e usando il modello gpt-3.5-turbo, il job è terminato in soli 7 minuti.
Al termine del job, viene inviata anche un’email di conferma.
Oltre ad avviare un job di fine-tuning, puoi visualizzare l’elenco dei job correnti, controllare lo stato di un job specifico o annullarne uno.
from openai import OpenAI
client = OpenAI()


# List 10 fine-tuning jobs
client.fine_tuning.jobs.list(limit=10)


# Retrieve the state of a fine-tune
client.fine_tuning.jobs.retrieve("...")


# Cancel a job
client.fine_tuning.jobs.cancel("...")


# List up to 10 events from a fine-tuning job
client.fine_tuning.jobs.list_events(fine_tuning_job_id="...", limit=10)


# Delete a fine-tuned model (must be an owner of the org the model was created in)
client.models.delete("ft:gpt-3.5-turbo:xxx:xxx")\OpenAI fornisce metriche chiave di training come training loss, token accuracy per il training, test loss e test token accuracy. Queste metriche aiutano a verificare che l’addestramento stia procedendo come previsto, con la perdita che diminuisce e l’accuratezza sui token che migliora. Puoi visualizzare queste metriche utili in un oggetto evento durante un job di fine-tuning attivo.
{
    "object": "fine_tuning.job.event",
    "id": "ftjob-Na7BnF5y91wwGJ4EgxtzVyDD",
    "created_at": 1693582679,
    "level": "info",
    "message": "Step 100/100: training loss=0.00",
    "data": {
        "step": 100,
        "train_loss": 1.805623287509661e-5,
        "train_mean_token_accuracy": 1.0
    },
    "type": "metrics"
}
Puoi visualizzare queste informazioni anche nella UI.
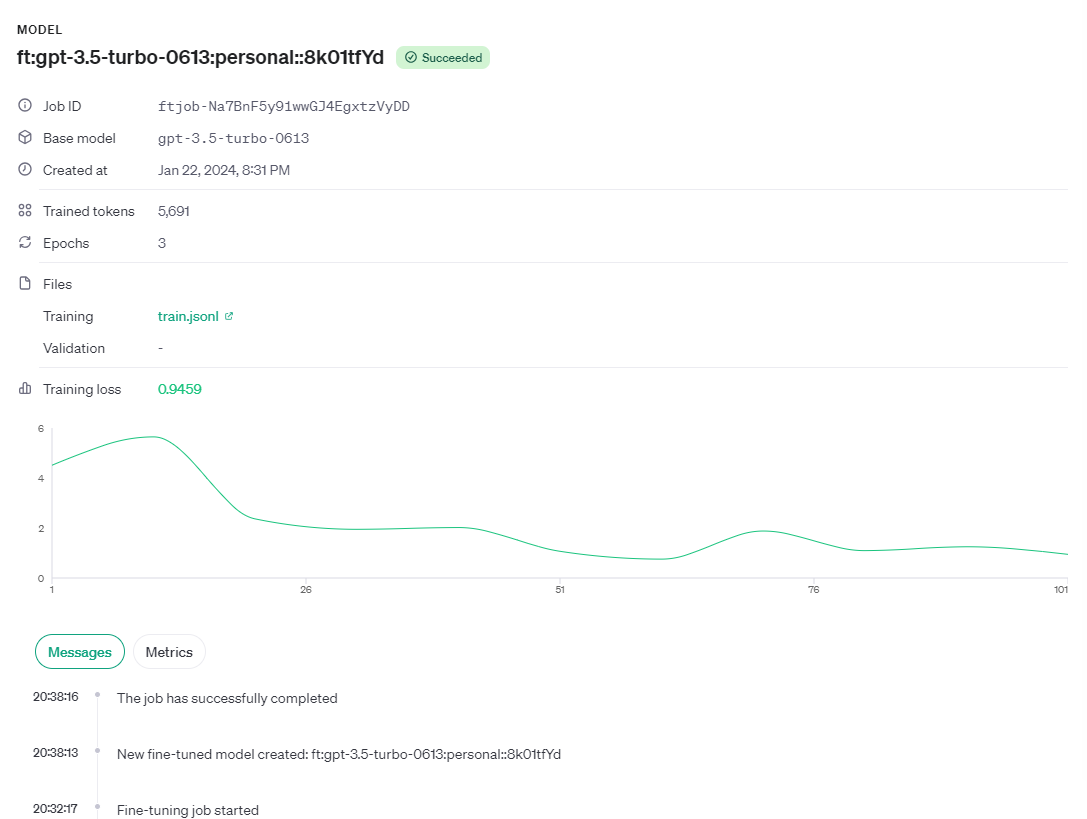
Al completamento del job, i dettagli includeranno il campo fine_tuned_model, che mostra il nome del modello. Puoi effettuare una chiamata API a questo modello e ottenere una risposta dal modello appena ottimizzato.
from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="ft:gpt-3.5-turbo-0613:personal::8k01tfYd",
  messages=[
    {"role": "system", "content": "You are a teaching assistant for Machine Learning. You should help to user to answer on his question."},
    {"role": "user", "content": "What is a loss function?"}
  ]
)
print(completion.choices[0].message)
Output:
ChatCompletionMessage(content="To measure how far we falter, it guides our way, our hope's defaulter.", role='assistant', function_call=None, tool_calls=None)Questo tutorial ti ha guidato nel processo di fine-tuning del modello GPT di OpenAI, un passo avanzato per sfruttare le vaste capacità degli LLM in applicazioni di dominio specializzato. Il fine-tuning consente di affinare le risposte del modello linguistico, rendendolo più abile nel gestire compiti, stili o domini specifici con maggiore precisione ed efficienza.
Questo tutorial utilizza l’API Python di OpenAI per il fine-tuning di un modello. Se preferisci imparare a fare la stessa cosa tramite una UI senza scrivere nemmeno una riga di codice, dai un’occhiata al tutorial How to Fine Tune GPT 3.5 su Datacamp.
Poiché GPT non è un modello open source, il processo di fine-tuning è piuttosto semplice e si riduce a effettuare una chiamata API. La situazione è molto diversa quando si tratta di fare fine-tuning di modelli open source come llama-2, Mistral, Stable Diffusion, ecc. Se ti interessa imparare come eseguire il fine-tuning di vari modelli open source, puoi consultare questi blog su DataCamp:
Per ulteriori risorse per principianti sul fine-tuning degli LLM, consulta Guida introduttiva al fine-tuning degli LLM su Datacamp.
Inizia oggi il tuo percorso nell’IA!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



