
Cursus
Werken met Hugging Face
2 uur
39K
In het snel evoluerende veld van artificial intelligence (AI) en machine learning (ML) is beeldclassificatie een basistaak die een breed scala aan toepassingen aandrijft, van gezichtsherkenningssystemen tot medische beelddiagnostiek.
Onder de vele tools en libraries die beschikbaar zijn voor data scientists en AI-practitioners is Hugging Face een grote speler, vooral voor wie werkt met natural language processing (NLP) en, in toenemende mate, met computervisie-taken zoals beeldclassificatie.
Dit artikel behandelt de essentials van het gebruik van Hugging Face voor beeldclassificatie, inclusief de basis van beeldclassificatie, het voorbereiden van je data, het trainen van je model, het uitrollen van je model naar de Hugging Face Hub en tot slot interactie met het uitgerolde model via de API en de Hugging Face-interface.
Of je nu een beginner bent of een ervaren practitioner, deze gids biedt waardevolle inzichten om Hugging Face in te zetten voor je beeldclassificatiewerk.
Deze sectie geeft inzicht in de basis van beeldclassificatie en de voordelen van het gebruik van Hugging Face.
Beeldclassificatie verwijst naar het indelen van afbeeldingen in een van meerdere vooraf gedefinieerde klassen.
Deze taak wordt uitgevoerd met algoritmen die de visuele inhoud van een afbeelding analyseren en de categorie voorspellen op basis van patronen die zijn geleerd uit de trainingsdataset. Deep learning-modellen, met name convolutional neural networks (CNN’s), zijn de standaardaanpak voor deze taak vanwege hun vermogen om relevante patronen in beelddata vast te leggen.
Wil je meer leren over CNN’s? Ons artikel An Introduction to Convolutional Neural Networks (CNNs) biedt een complete gids om CNN’s te begrijpen, hun impact op beeldanalyse en enkele belangrijke strategieën om overfitting tegen te gaan voor robuuste CNN’s versus deep learning-toepassingen.
Bovendien doorloopt het artikel Classification in Machine Learning: An Introduction stap voor stap wat classificatie in machine learning is, hoe het wordt gebruikt en enkele voorbeelden van classificatie-algoritmen.
Hugging Face biedt een uitgebreid ecosysteem voor machine learning, met gebruiksvriendelijke interfaces, een enorme repository met voorgetrainde modellen en uitgebreide documentatie.
Vergeleken met andere platforms biedt Hugging Face verschillende voordelen voor beeldclassificatie:
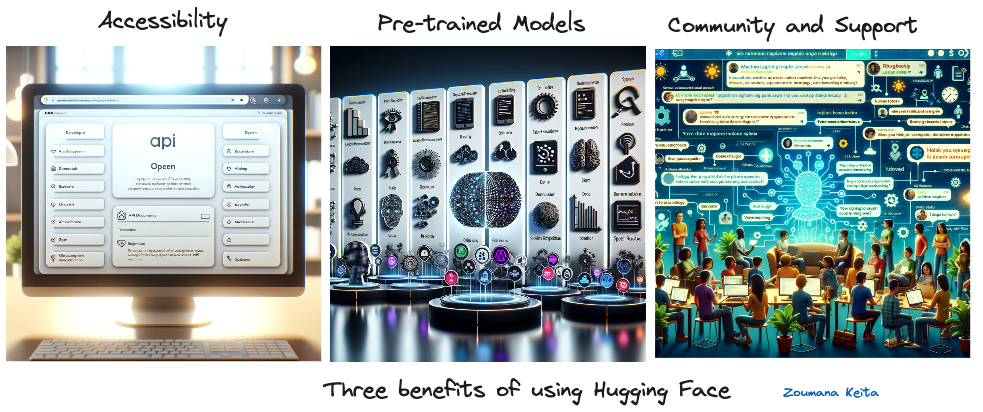
Drie voordelen van het gebruik van Hugging Face (Afbeelding gegenereerd met GPT-4)
Daarnaast maakt Hugging Face het uitrollen van modellen mogelijk op grote cloudplatforms zoals AWS, Azure en Google Cloud Platform, met meerdere inferentietypen.
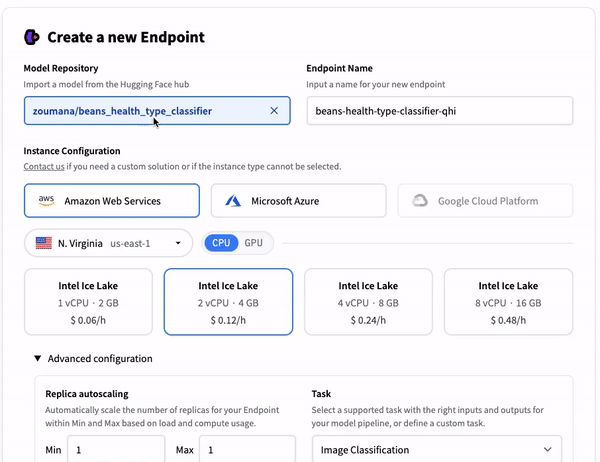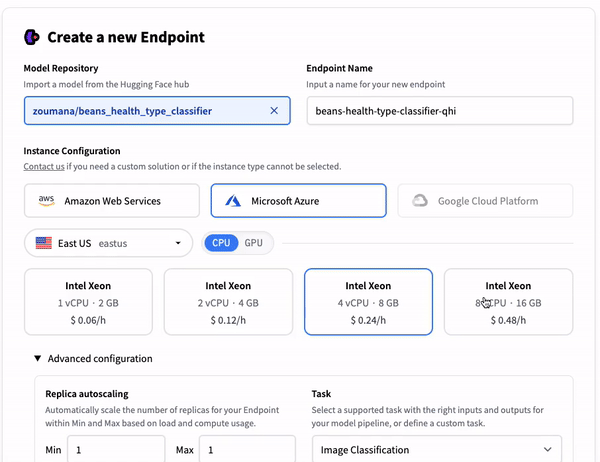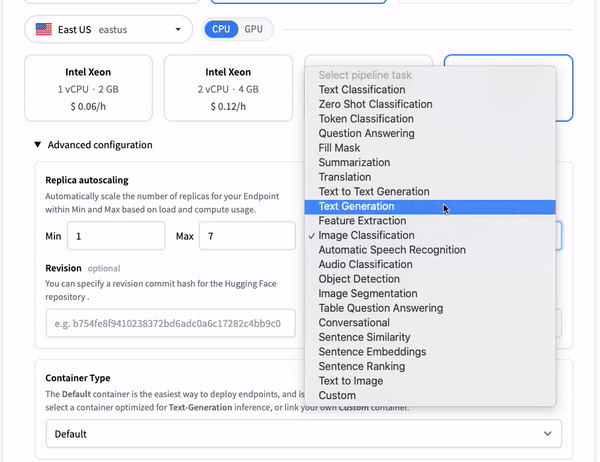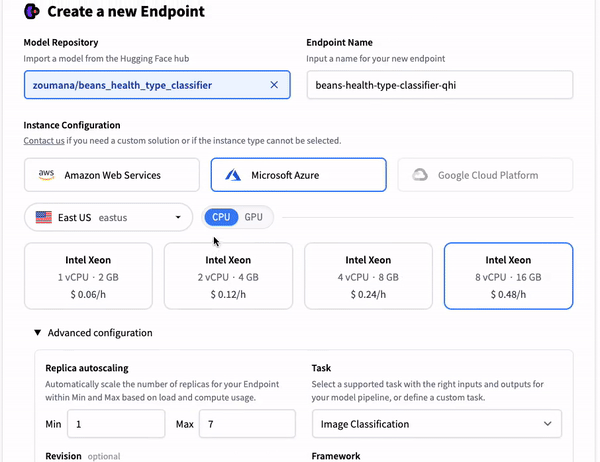
Opties voor modeluitrol op cloudplatforms
De hoofdtaak in dit artikel is beeldclassificatie, en we gebruiken de beans-dataset van Hugging Face als voorbeeld. Nadat we de dataset hebben geladen, voeren we enkele visualisaties uit voordat we duiken in de preprocessing voor modeltraining.
De notebook met de code is beschikbaar om mee te volgen in Google Colab.
De code in dit artikel is sterk geïnspireerd op de officiële website van Hugging Face.
In dit artikel worden meerdere libraries gebruikt, elk met een specifieke rol. Sommige libraries vereisen installatie. Die libraries installeer je met de Python-package manager "pip" als volgt:
%%bash
pip -q install datasets
pip -q install transformers=='4.29.0'
pip -q install tensorflow=='2.15' # At least this tensorflow version is required to use the "evaluate module"
pip -q install evaluate
pip -q install --upgrade accelerate
Het is belangrijk om de kernel te herstarten na het installeren van de libraries. Na een geslaagde installatie kun je de benodigde libraries importeren met de from- en import-statements:
import torch
import torchvision
import numpy as np
import evaluate
from datasets import load_dataset
from huggingface_hub import notebook_login
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from transformers import DefaultDataCollator
from transformers import AutoImageProcessor
from torchvision.transforms import RandomResizedCrop, Compose, Normalize, ToTensor
from transformers import AutoModelForImageClassification, TrainingArguments, Trainer
import matplotlib.pyplot as pltData laden uit Hugging Face is eenvoudig met de functie load_dataset.
beans_train = load_dataset("beans", split="train")beans is de naam van de dataset die wordt gebruikt.train komt overeen met de subset van de volledige data die wordt gebruikt.Zodra de data is geladen, kunnen we de kenmerken controleren door simpelweg de naam van de bovenstaande variabele te printen.
print(beans_train)Dit toont het onderstaande resultaat:
Dataset({
    features: ['image_file_path', 'image', 'labels'],
    num_rows: 1034
})
Er zijn in totaal 1034 afbeeldingen, en elke afbeelding heeft drie velden:
image_path: het pad naar de daadwerkelijke afbeelding.image: een PIL-object van de bonenafbeelding.labels: het label van de afbeelding, dat een van de volgende drie typen kan zijn:De volgende helperfunctie maakt het makkelijker om een specifiek aantal willekeurig gekozen afbeeldingen te visualiseren en het juiste type afbeelding te tonen samen met de bestaande labels (0, 1 en 2)
labels_names = {
   0: "angular_leaf_spot",
   1: "bean_rust",
   2: "healthy",
}

def display_random_images(dataset, num_images=4):

   num_rows = 2
   num_cols = np.ceil(num_images / num_rows).astype(int)

   plt.figure(figsize=(num_cols * 3, num_rows * 3))
   indices = np.random.choice(range(len(dataset)), size=num_images, replace=False)

   for i, idx in enumerate(indices, 1):
       idx = int(idx)
       image = dataset[idx]['image']
       label = dataset[idx]['labels']
       label_name = labels_names.get(label, "Unknown")

       plt.subplot(num_rows, num_cols, i)
       plt.imshow(image)
       plt.title(f"{label_name} ({label})")
       plt.axis('off')

   plt.tight_layout()
   plt.show()
Kort gezegd selecteert deze functie, display_random_images, een willekeurige subset afbeeldingen uit een gegeven dataset en toont ze in een raster, waarbij elke afbeelding gelabeld is volgens de classificatie (bijv. "angular_leaf_spot", "bean_rust", "healthy").
De functie rangschikt de afbeeldingen dynamisch in twee rijen en berekent het benodigde aantal kolommen op basis van het totaal aantal te tonen afbeeldingen, waarbij duplicatie wordt voorkomen en elke afbeelding vergezeld gaat van de bijbehorende labelnaam en numeriek label.
We kunnen vervolgens zes willekeurige afbeeldingen tonen met de functie als volgt:
display_random_images(beans_train, num_images=6)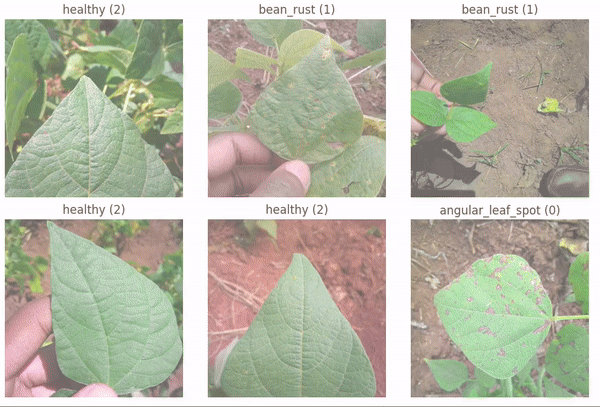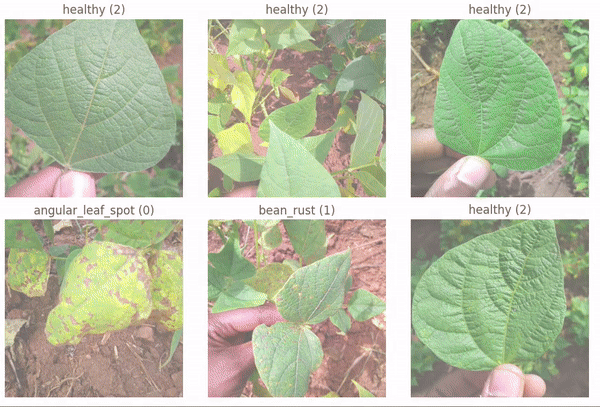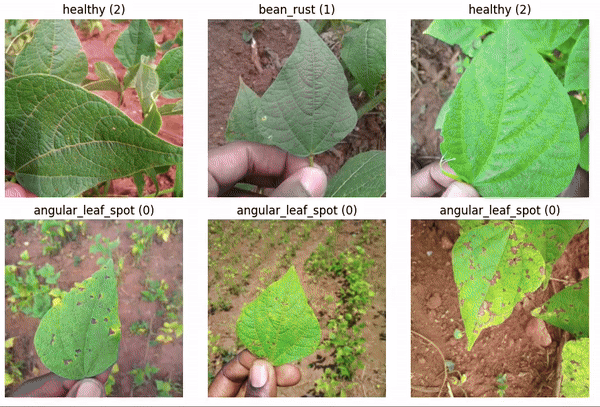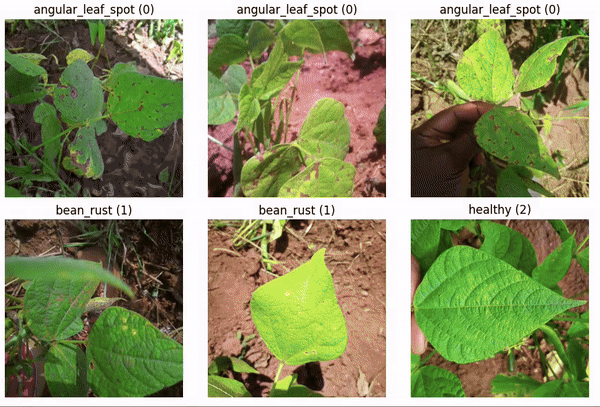
Zes willekeurige afbeeldingen uit de dataset
Voor het trainen van het model is het belangrijk om relevante preprocessing uit te voeren om de data geschikt te maken voor het model.
Allereerst wordt de originele dataset gesplitst in trainings- en validatiedata, respectievelijk 80% en 20%, en dit gebeurt met de functie train_test_split.
beans_train = beans_train.train_test_split(test_size=0.2)Vervolgens maken we twee dictionaries: label2id en id2label. Dit is cruciaal voor de conversie tussen menselijk leesbare labelnamen en machine-leesbare numerieke identifiers.
Dit proces vergemakkelijkt zowel het trainingsproces als de interpretatie van de voorspellingen van het uiteindelijke model.
labels = beans_train["train"].features["labels"].names
label2id, id2label = dict(), dict()

for i, label in enumerate(labels):
   label2id[label] = str(i)
   id2label[str(i)] = label
Hieronder staat het resultaat van de variabele id2label:
print(id2label){'0': 'angular_leaf_spot', '1': 'bean_rust', '2': 'healthy'}Ons classificatiemodel maakt gebruik van de voorgetrainde Vision Transformer (ViT) van Hugging Face.
Dit model werd geïntroduceerd in de paper An Image is Worth 16x16 words: Transformers for Image Recognition at Scale en markeert de eerste succesvolle toepassing van de transformer-architectuur op beeldherkenning, getraind op de ImageNet-dataset.
De volgende code laat alle stappen zien om het voorgetrainde model te laden, de data te preprocessed om aan de vereisten van het model te voldoen, en de tussenstappen om te zorgen dat de beelden correct worden verwerkt en klaar zijn om aan het voorgetrainde model gevoerd te worden voor fine-tuning en evaluatie.
checkpoint = "google/vit-base-patch16-224-in21k"
image_processor = AutoImageProcessor.from_pretrained(checkpoint)

normalize = Normalize(mean=image_processor.image_mean,
                  	std=image_processor.image_std)

size = (
	image_processor.size["shortest_edge"]
	if "shortest_edge" in image_processor.size
	else (image_processor.size["height"], image_processor.size["width"])
)

_transforms = Compose([RandomResizedCrop(size), ToTensor(), normalize])

def transforms(examples):

	examples["pixel_values"] = [_transforms(img.convert("RGB")) for img in examples["image"]]
	del examples["image"]
	return examples

beans_transformed = beans_train.with_transform(transforms)

data_collator = DefaultDataCollator()
Laten we bekijken wat er in de bovenstaande code gebeurt:
google/vit-base-patch16-224-in21k._transforms) wordt samengesteld, waaronder willekeurig croppen, conversie naar tensor en normalisatie.beans_train wordt getransformeerd met de transforms-functie, zodat hij klaar is voor modeltraining.Na deze setups gebruiken we als evaluatiemetric de accuracy, geïmplementeerd met de volgende helperfunctie.
accuracy = evaluate.load("accuracy")
def compute_metrics(eval_pred):
   predictions, labels = eval_pred
   predictions = np.argmax(predictions, axis=1)

   return accuracy.compute(predictions=predictions,
references=labels)Voor het trainingsproces van het model definiëren we het daadwerkelijke model door het voorgetrainde model te gebruiken met de functie .from_pretrained als volgt
model = AutoModelForImageClassification.from_pretrained(
   checkpoint,
   num_labels=len(labels),
   id2label=id2label,
   label2id=label2id,
)De volgende stap is het instellen van het model door de trainingsomgeving te configureren en te initialiseren.
De setup omvat het specificeren van de benodigde hyperparameters met betrekking tot training, evaluatie en optimalisatie.
Maar daarvoor moeten we inloggen op ons Hugging Face-account met onze accountgegevens, die je als volgt kunt ophalen:
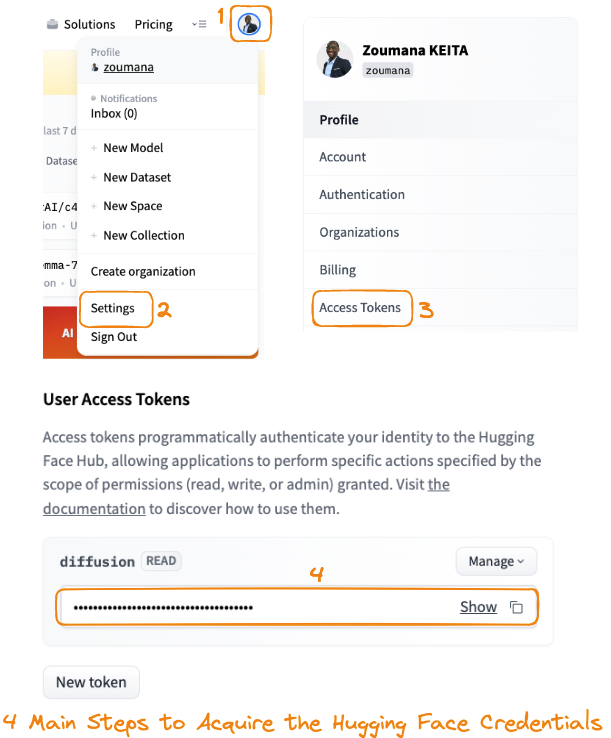
Belangrijkste stappen om Hugging Face-gegevens te verkrijgen
Door in te loggen op ons Hugging Face-account kunnen we onze getrainde modellen uploaden en delen met de community. Vervolgens starten we het authenticatieproces met de functie notebook_login.
notebook_login()Wanneer je hierom wordt gevraagd, voer je de connectietoken in, zoals in stap 4 hierboven is gekopieerd.
Na een geslaagde login zou het volgende bericht moeten verschijnen:
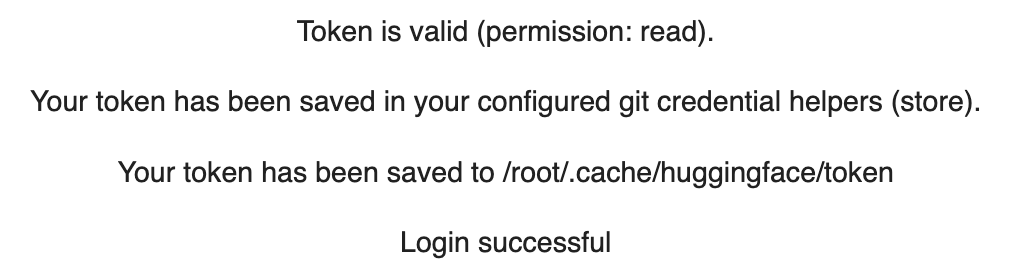
De configuratie- en initialisatiecode staat hieronder:
training_args = TrainingArguments(
	output_dir="./beans_health_type_classifier",
	remove_unused_columns=False,
	evaluation_strategy="epoch",
	save_strategy="epoch",
	learning_rate=5e-5,
	per_device_train_batch_size=16,
	gradient_accumulation_steps=4,
	per_device_eval_batch_size=16,
	num_train_epochs=3,
	warmup_ratio=0.1,
	logging_steps=10,
	load_best_model_at_end=True,
	metric_for_best_model="accuracy"
)

trainer = Trainer(
	model=model,
	args=training_args,
	data_collator=data_collator,
	train_dataset=beans_transformed["train"],
	eval_dataset=beans_transformed["test"],
	tokenizer=image_processor,
	compute_metrics=compute_metrics,
)
TrainingArguments worden geconfigureerd met specifieke parameters zoals de outputmap, evaluatie- en opslagstrategie per epoch, learning rate, batchgrootte, stappen voor gradiëntaccumulatie en andere instellingen om het trainingsproces en de modelprestaties te optimaliseren.Trainer-object wordt geïnitialiseerd met het eerder gedefinieerde model, de trainingsargumenten, een data collator voor batching, train- en evaluatiedatasets, een tokenizer (of in dit geval image processor) voor datapreprocessing en een functie om metrics voor evaluatie te berekenen.Nu volgt de trainingsfase, die wordt uitgevoerd met de functie .train.
trainer.train()Deze specifieke training leverde de volgende metrics op:
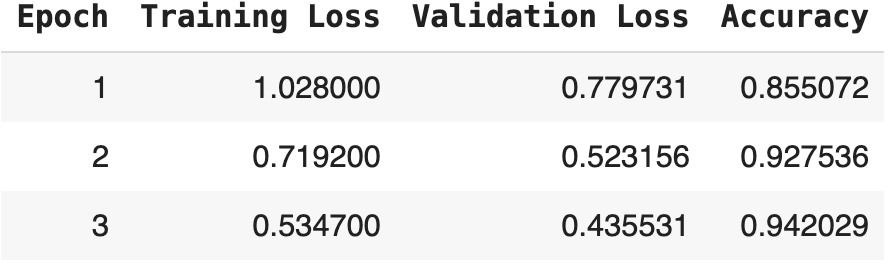
Resultaat modeltraining voor drie epochs
We zien dat de tabel de voortgang van de modeltraining over drie epochs op je beans-dataset toont, met drie kernmetrics: training loss, validation loss en accuracy.
Bij de eerste authenticatie op het Hugging Face-portaal was de verbindingsmodus alleen read. We hebben echter write-credentials nodig om ons model naar de Hugging Face Hub te kunnen pushen.
Daarna moeten we opnieuw inloggen met de functie notebook_login met de nieuw aangemaakte credentials.
notebook_login()Het pushen van het model gebeurt met de functie push_to_hub als volgt:
trainer.model.push_to_hub("zoumana/beans_health_type_classifier")Dit pusht het model naar de Hub, waar we de belangrijkste eigenschappen van het model kunnen bekijken.
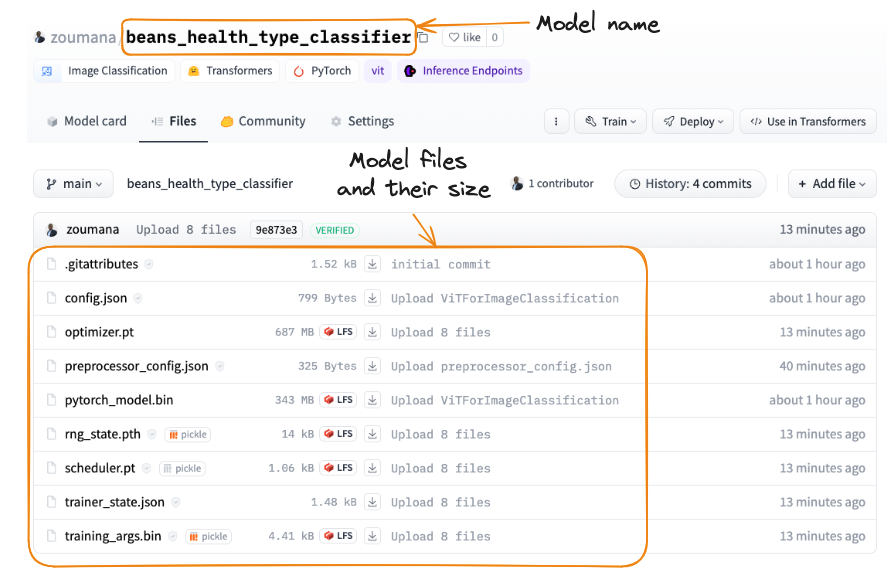
Model gepusht naar Hugging Face
Zodra het model gedeeld is, kan het worden geïntegreerd in applicaties via REST API, of gebruikers kunnen het rechtstreeks integreren vanuit het Hugging Face-portaal. Ontwikkelaars en onderzoekers kunnen het model ook gebruiken door het te laden met de Transformers-library.
In deze sectie behandelen we de drie belangrijkste manieren om het model te gebruiken.
Op het portaal kunnen gebruikers direct een afbeelding uploaden en de voorspellingen van het model ophalen, zoals geïllustreerd in de volgende animatie.
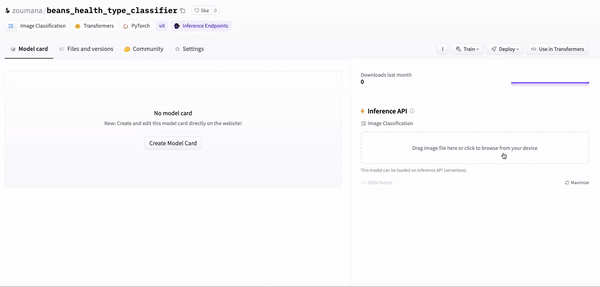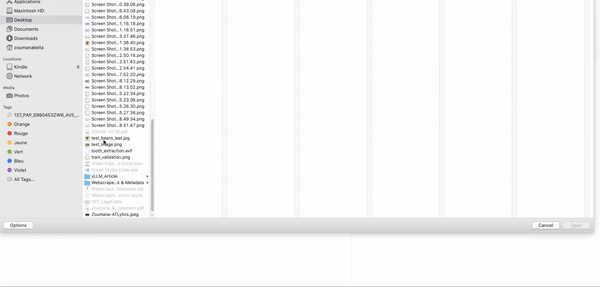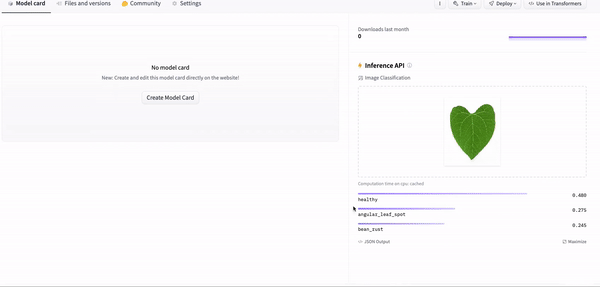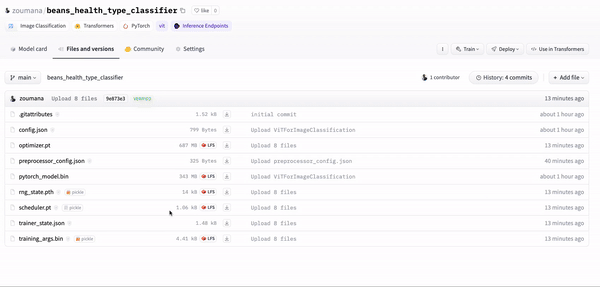
Het model gebruiken via het Hugging Face-portaal
Door het pictogram “Use in Transformers” te selecteren, wordt de code om het model te gebruiken automatisch verstrekt, zoals hieronder:
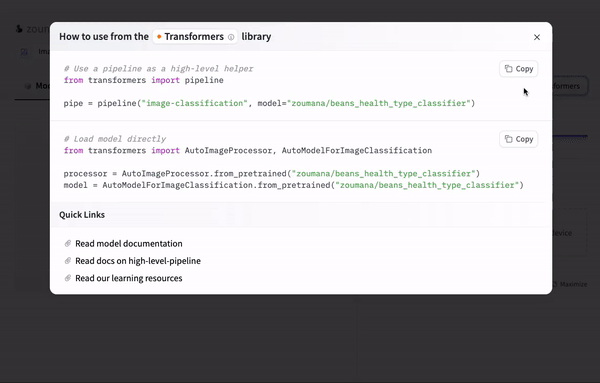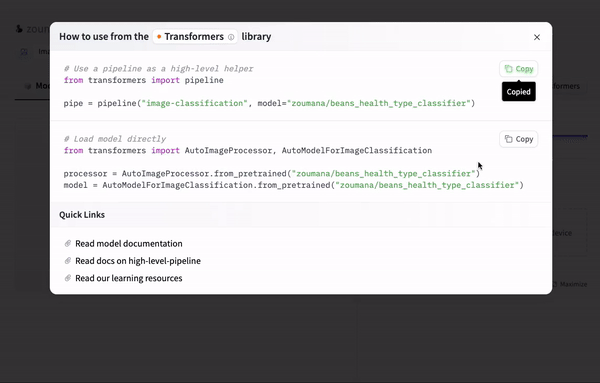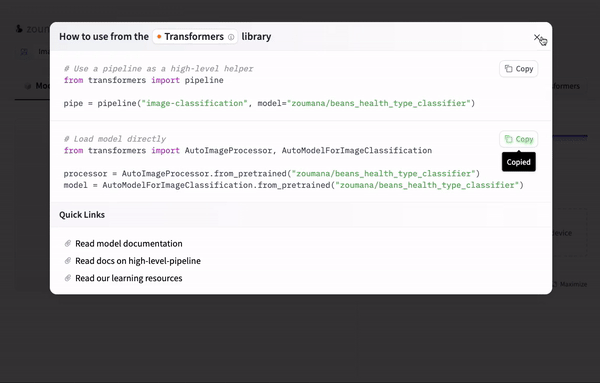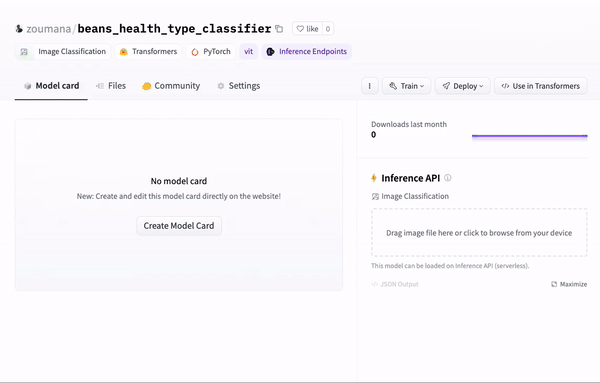
Het model gebruiken met Transformers
Tot slot kunnen we het model gebruiken als een REST API via de connection string die automatisch vanuit het portaal wordt verstrekt na het klikken op het pictogram “Deploy > Inference API (serverless)”.
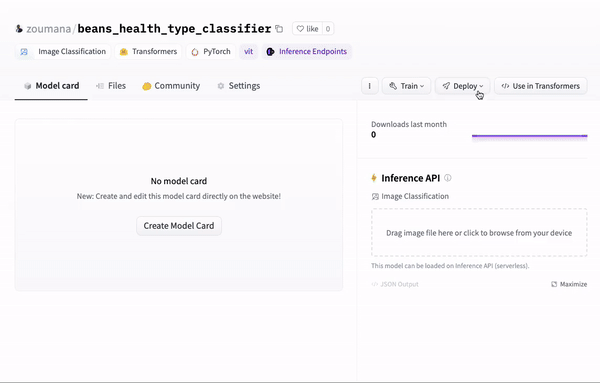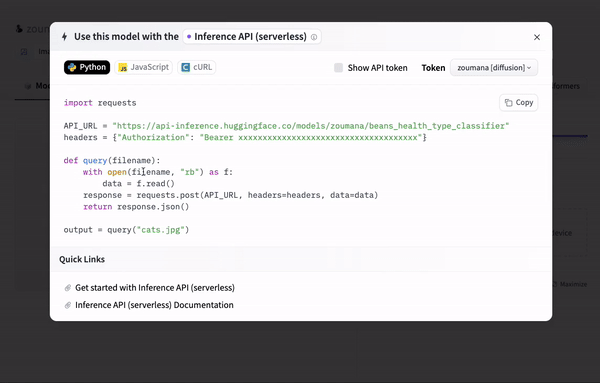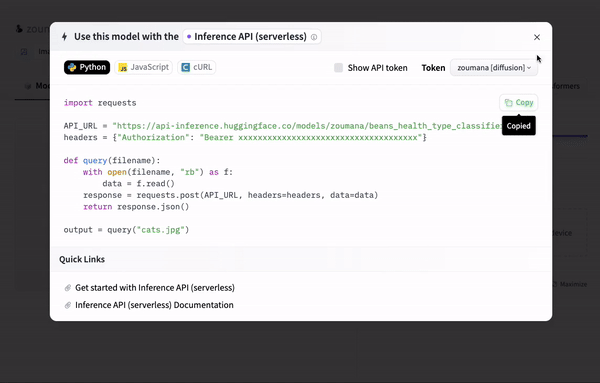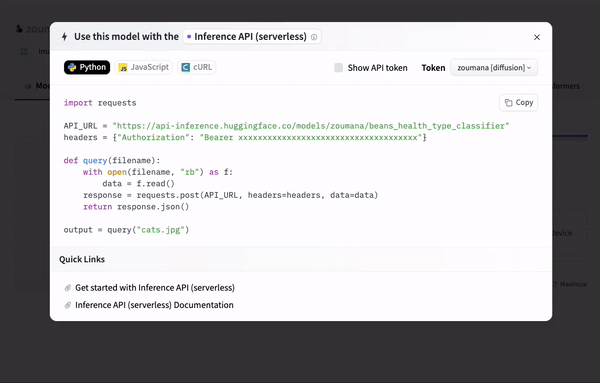
Een API-endpoint gebruiken
De codefragmenten in de vorige animatie zijn hetzelfde als hieronder en kunnen worden gebruikt om voorspellingen te doen voor een gegeven afbeelding.
De gebruikte afbeelding is dezelfde als in de illustratie via het Hugging Face-portaal.
Zorg dat je de “xxx” vervangt door de daadwerkelijke waarden.
import requests

API_URL = "https://api-inference.huggingface.co/models/zoumana/beans_health_type_classifier"
headers = {"Authorization": "Bearer xxxxxxxxxxxxxxxxx"}

def query(filename):
   with open(filename, "rb") as f:
       data = f.read()
   response = requests.post(API_URL, headers=headers, data=data)
   return response.json()
Vervolgens halen we de respons van het model op met de eerdere query-functie.
output = query("./inference_images/test_beans_leaf.jpg")Het eindresultaat is een JSON-respons, zoals hieronder te zien. We zien dat het voorspelde label degene is met de hoogste waarschijnlijkheidsscore; in dit geval is dat healthy, exact dezelfde voorspelling als via het Hugging Face-portaal.
print(output)[
{'label': 'healthy', 'score': 0.4799719452857971},
{'label': 'angular_leaf_spot', 'score': 0.27489492297172546},
{'label': 'bean_rust', 'score': 0.2451331913471222}
]Dit artikel gaf een complete gids voor het uitvoeren van beeldclassificatietaken met Hugging Face.
We begonnen met de basis van beeldclassificatie en bespraken waarom Hugging Face een geweldig hulpmiddel is voor deze klus, dankzij de uitgebreide collectie modellen en de ondersteunende community.
Daarna hebben we behandeld hoe je trainingsafbeeldingen gereed maakt voor classificatie, inclusief hoe je zorgt dat de trainingsdata voldoet aan de fine-tuningvereisten.
Vervolgens doken we in het fine-tunen van een model met Hugging Face en het kiezen van het juiste voorgetrainde model. Ook bespraken we hoe je het getrainde model integreert in real-world applicaties met drie hoofdstrategieën.
Er valt altijd meer te leren en te ontdekken in AI, en elke stap die je zet opent nieuwe mogelijkheden. Voor iedereen die meer wil leren over AI en machine learning, vooral over het classificeren van afbeeldingen en meer, zijn dit mooie bronnen om te bekijken:
Deze gids is bedoeld om iedereen te helpen om eigen projecten te starten met Hugging Face voor beeldclassificatie, of je nu beginner, gevorderd of vergevorderd bent.
Begin vandaag nog met je AI-reis!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

