
कोर्स
Hugging Face के साथ काम करना
2 घंटा
39.2K
कृत्रिम बुद्धिमत्ता (AI) और मशीन लर्निंग (ML) के तेजी से विकसित होते क्षेत्र में, इमेज क्लासिफिकेशन एक बुनियादी कार्य के रूप में उभरता है, जो चेहरे की पहचान प्रणालियों से लेकर चिकित्सा इमेज डायग्नोस्टिक्स तक, अनेक अनुप्रयोगों को शक्ति देता है।
डेटा वैज्ञानिकों और AI प्रैक्टिशनर्स के लिए उपलब्ध अनेक टूल्स और लाइब्रेरीज़ में, Hugging Face एक प्रमुख खिलाड़ी रहा है—विशेषकर प्राकृतिक भाषा संसाधन (NLP) के लिए, और अब बढ़ते हुए इमेज क्लासिफिकेशन जैसे कंप्यूटर विज़न कार्यों के लिए भी।
यह लेख Hugging Face का उपयोग करके इमेज क्लासिफिकेशन के मूल तत्वों को कवर करेगा—इमेज क्लासिफिकेशन की बुनियादी समझ, अपने डेटा की तैयारी, अपने मॉडल का प्रशिक्षण, अपने मॉडल को Hugging Face हब पर डिप्लॉय करना, और अंततः API और Hugging Face इंटरफ़ेस के माध्यम से डिप्लॉय किए गए मॉडल के साथ इंटरैक्ट करना।
चाहे आप एक शुरुआती हों या अनुभवी प्रैक्टिशनर, यह गाइड आपकी इमेज क्लासिफिकेशन आवश्यकताओं के लिए Hugging Face का लाभ उठाने में उपयोगी अंतर्दृष्टि प्रदान करेगा।
यह सेक्शन इमेज क्लासिफिकेशन की बुनियाद और Hugging Face का उपयोग करने के फ़ायदों पर प्रकाश डालता है।
इमेज क्लासिफिकेशन का अर्थ है छवियों को पूर्वनिर्धारित कई श्रेणियों में से किसी एक में वर्गीकृत करना।
यह कार्य उन एल्गोरिद्मों से किया जाता है जो किसी छवि की दृश्य सामग्री का विश्लेषण करते हैं और प्रशिक्षण डेटा सेट से सीखे गए पैटर्न के आधार पर उसकी श्रेणी का अनुमान लगाते हैं। डीप लर्निंग मॉडल, विशेष रूप से कॉन्वोल्यूशनल न्यूरल नेटवर्क (CNNs), छवि डेटा में प्रासंगिक पैटर्न को पकड़ने की क्षमता के कारण, इस कार्य के लिए मानक दृष्टिकोण बन गए हैं।
CNNs के बारे में और जानने के लिए, हमारा लेख An Introduction to Convolutional Neural Networks (CNNs) CNNs को समझने, छवि विश्लेषण पर उनके प्रभाव, और डीप लर्निंग अनुप्रयोगों के लिए मजबूत CNNs हेतु ओवरफिटिंग से निपटने की कुछ प्रमुख रणनीतियों का एक संपूर्ण मार्गदर्शक प्रदान करता है।
इसके अलावा, Classification in Machine Learning: An Introduction लेख मशीन लर्निंग में क्लासिफिकेशन के बारे में चरण-दर-चरण प्रक्रिया से गुजरता है—यह क्या है, कैसे उपयोग होता है, और क्लासिफिकेशन एल्गोरिद्म के कुछ उदाहरण।
Hugging Face मशीन लर्निंग के लिए एक व्यापक इकोसिस्टम प्रदान करता है—आसान-से-उपयोग इंटरफ़ेस, पूर्व-प्रशिक्षित मॉडलों का विशाल भंडार, और विस्तृत दस्तावेज़ीकरण के साथ।
अन्य प्लेटफ़ॉर्म्स की तुलना में, इमेज क्लासिफिकेशन के लिए Hugging Face कई लाभ देता है:
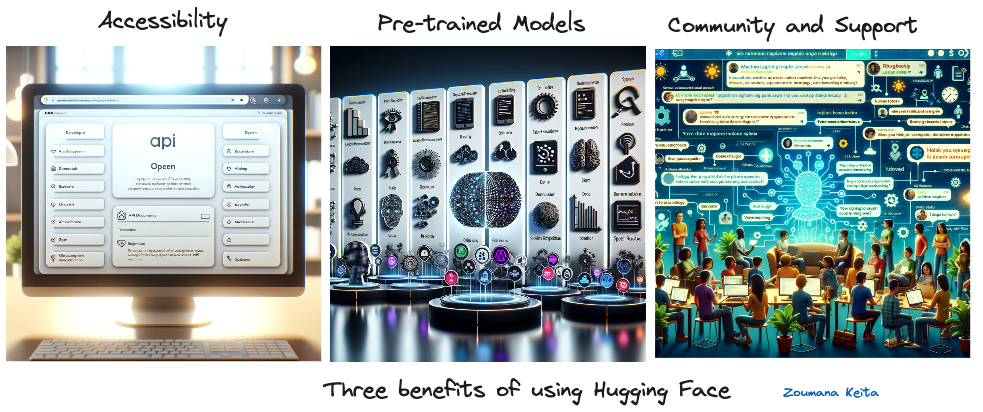
Hugging Face के उपयोग के तीन लाभ (छवि GPT-4 का उपयोग करके जनरेट की गई)
इसके अतिरिक्त, Hugging Face AWS, Azure, और Google Cloud Platform जैसे प्रमुख क्लाउड प्लेटफ़ॉर्म्स पर, और अनेक इन्फ़रेंस प्रकारों के साथ, मॉडल डिप्लॉयमेंट को आसान बनाता है।
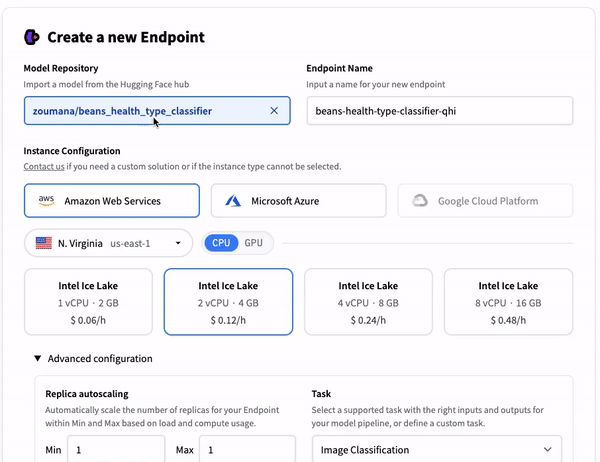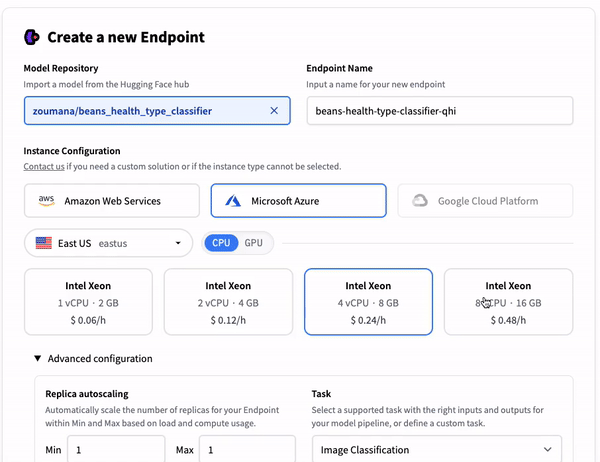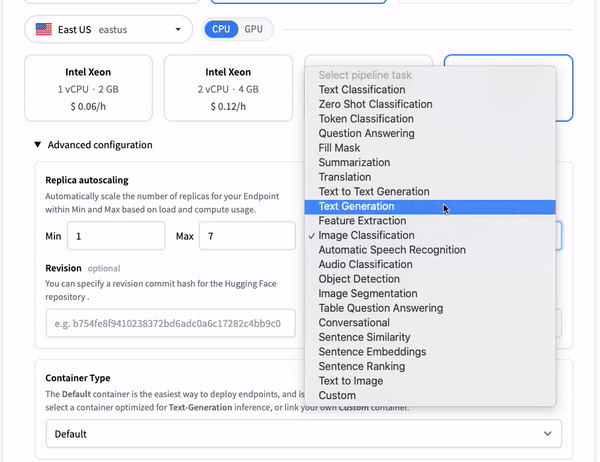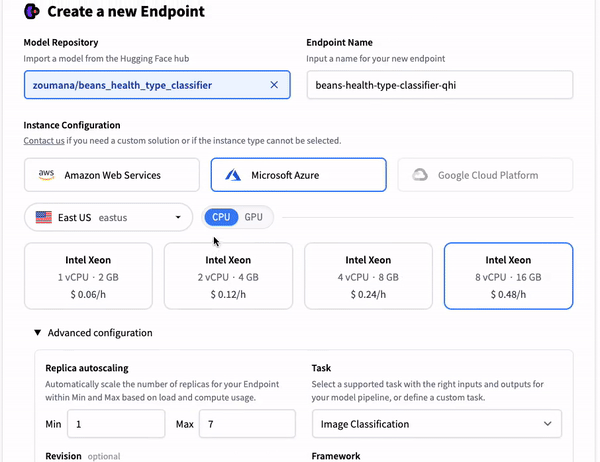
क्लाउड प्लेटफ़ॉर्म्स पर मॉडल डिप्लॉयमेंट विकल्प
इस लेख में कवर किया गया मुख्य कार्य इमेज क्लासिफिकेशन है, और हम अपने उदाहरण के लिए Hugging Face से beans डेटा सेट का उपयोग करेंगे। डेटासेट लोड करने के बाद, हम प्रीप्रोसेसिंग में जाने से पहले कुछ विज़ुअलाइज़ेशन करेंगे।
कोड वाला नोटबुक Google Colab में साथ-साथ फ़ॉलो करने के लिए उपलब्ध है।
इस लेख के कोड्स Hugging Face की आधिकारिक वेबसाइट से काफ़ी प्रेरित हैं।
इस लेख के दायरे में कई लाइब्रेरीज़ का उपयोग किया गया है, और हर एक की विशिष्ट भूमिका है। कुछ लाइब्रेरीज़ इंस्टॉलेशन मांगती हैं। वे लाइब्रेरीज़ Python पैकेज मैनेजर “pip” से इस प्रकार इंस्टॉल की जाती हैं:
%%bash
pip -q install datasets
pip -q install transformers=='4.29.0'
pip -q install tensorflow=='2.15' # At least this tensorflow version is required to use the "evaluate module"
pip -q install evaluate
pip -q install --upgrade accelerate
लाइब्रेरीज़ इंस्टॉल करने के बाद कर्नेल को रीस्टार्ट करना महत्वपूर्ण है। सफल इंस्टॉलेशन के बाद, आवश्यक लाइब्रेरीज़ को from और import स्टेटमेंट्स से इम्पोर्ट किया जा सकता है:
import torch
import torchvision
import numpy as np
import evaluate
from datasets import load_dataset
from huggingface_hub import notebook_login
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from transformers import DefaultDataCollator
from transformers import AutoImageProcessor
from torchvision.transforms import RandomResizedCrop, Compose, Normalize, ToTensor
from transformers import AutoModelForImageClassification, TrainingArguments, Trainer
import matplotlib.pyplot as pltHugging Face से डेटा लोड करना load_dataset फ़ंक्शन का उपयोग करके सीधा-सादा है।
beans_train = load_dataset("beans", split="train")beans उपयोग में लिए जा रहे डेटासेट का नाम है।train पूरे डेटा के उस सबसेट के अनुरूप है जिसका उपयोग किया जा रहा है।एक बार डेटा लोड हो जाने के बाद, हम ऊपर दिए वेरिएबल का नाम प्रिंट करके इसकी विशेषताओं की जाँच कर सकते हैं।
print(beans_train)यह नीचे दिया परिणाम दिखाता है:
Dataset({
    features: ['image_file_path', 'image', 'labels'],
    num_rows: 1034
})
कुल 1034 छवियाँ हैं, और हर छवि के तीन फ़ील्ड हैं:
image_path: वास्तविक छवि का पथ।image: बीन्स छवि का एक PIL ऑब्जेक्ट।labels: छवि का लेबल, जो निम्न तीन प्रकारों में से एक हो सकता है:निम्न हेल्पर फ़ंक्शन यादृच्छिक रूप से चुनी गई एक निश्चित संख्या की छवियों को देखना आसान बनाता है और मौजूदा लेबल्स (0, 1, और 2) के साथ सही इमेज टाइप आवंटित करता है
labels_names = {
   0: "angular_leaf_spot",
   1: "bean_rust",
   2: "healthy",
}

def display_random_images(dataset, num_images=4):

   num_rows = 2
   num_cols = np.ceil(num_images / num_rows).astype(int)

   plt.figure(figsize=(num_cols * 3, num_rows * 3))
   indices = np.random.choice(range(len(dataset)), size=num_images, replace=False)

   for i, idx in enumerate(indices, 1):
       idx = int(idx)
       image = dataset[idx]['image']
       label = dataset[idx]['labels']
       label_name = labels_names.get(label, "Unknown")

       plt.subplot(num_rows, num_cols, i)
       plt.imshow(image)
       plt.title(f"{label_name} ({label})")
       plt.axis('off')

   plt.tight_layout()
   plt.show()
संक्षेप में, यह फ़ंक्शन display_random_images दिए गए डेटासेट से छवियों का एक रैंडम सबसेट चुनता है और उन्हें ग्रिड में दिखाता है, जहाँ हर छवि को उसकी श्रेणी के अनुसार लेबल किया जाता है (जैसे "angular_leaf_spot", "bean_rust", "healthy")।
यह छवियों को गतिशील रूप से दो पंक्तियों में व्यवस्थित करता है और प्रदर्शित की जाने वाली कुल छवियों की संख्या के आधार पर आवश्यक कॉलम की गणना करता है, यह सुनिश्चित करते हुए कि कोई छवि दोहराई न जाए और हर छवि के साथ उसका संबंधित लेबल नाम और संख्यात्मक लेबल हो।
इसके बाद हम निम्न प्रकार से फ़ंक्शन का उपयोग कर छह यादृच्छिक छवियाँ दिखा सकते हैं:
display_random_images(beans_train, num_images=6)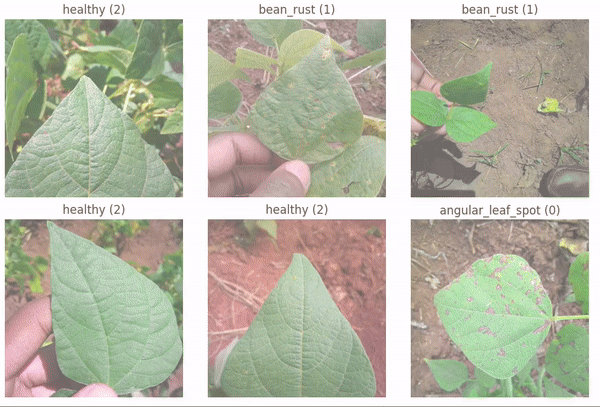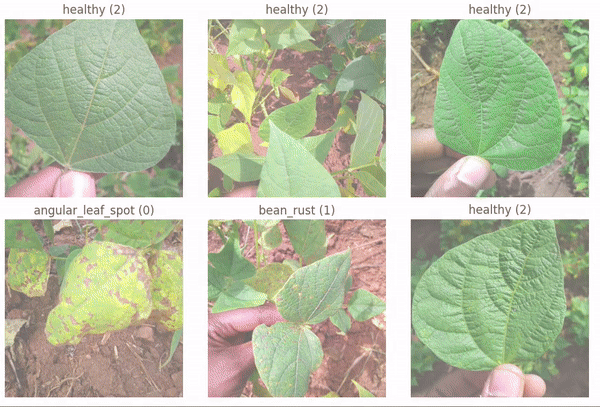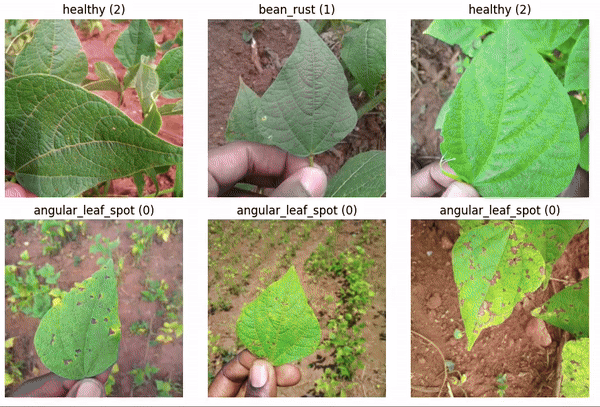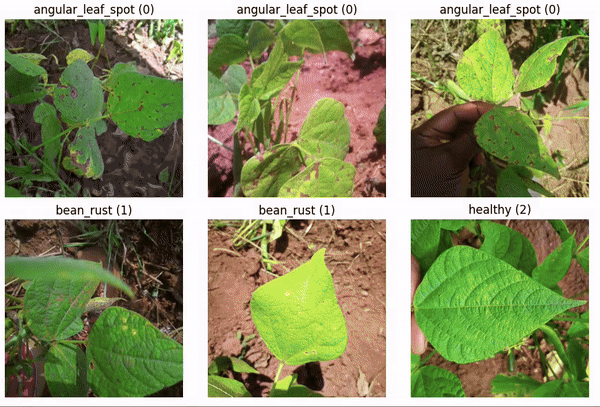
डेटासेट से छह यादृच्छिक छवियाँ
मॉडल ट्रेन करने से पहले, डेटा को मॉडल के लिए उपयुक्त बनाने हेतु प्रासंगिक प्रीप्रोसेसिंग करना महत्वपूर्ण है।
पहले, मूल डेटासेट को 80% और 20% क्रमशः प्रशिक्षण और वैलिडेशन डेटा में विभाजित किया जाता है, और यह train_test_split फ़ंक्शन का उपयोग करके हासिल किया जाता है।
beans_train = beans_train.train_test_split(test_size=0.2)अगला, दो शब्दकोश बनाए जाते हैं: label2id और id2label। यह मानव-पठनीय लेबल नामों और मशीन-समझने योग्य संख्यात्मक पहचानकर्ताओं के बीच रूपांतरण के लिए अत्यावश्यक है।
यह प्रक्रिया प्रशिक्षण प्रक्रिया और अंतिम मॉडल की भविष्यवाणियों की व्याख्या—दोनों को सुगम बनाती है।
labels = beans_train["train"].features["labels"].names
label2id, id2label = dict(), dict()

for i, label in enumerate(labels):
   label2id[label] = str(i)
   id2label[str(i)] = label
नीचे id2label वेरिएबल का परिणाम है:
print(id2label){'0': 'angular_leaf_spot', '1': 'bean_rust', '2': 'healthy'}हमारा क्लासिफिकेशन मॉडल Hugging Face के प्री-ट्रेंड मॉडल Vision Transformer (ViT) का लाभ उठाता है।
यह मॉडल पेपर An Image is Worth 16x16 words: Transformers for Image Recognition at Scale में प्रस्तुत किया गया था और यह इमेज रिकग्निशन में ट्रांसफ़ॉर्मर आर्किटेक्चर के पहले सफल अनुप्रयोग का संकेत देता है, जिसे ImageNet डेटासेट पर प्रशिक्षित किया गया है।
निम्न कोड प्री-ट्रेंड मॉडल को लोड करने, डेटा को मॉडल की आवश्यकताओं के अनुरूप प्रीप्रोसेस करने, और यह सुनिश्चित करने के मध्यवर्ती चरणों को समझाता है कि छवियाँ सही ढंग से प्रोसेस हों और फाइन-ट्यूनिंग और मूल्यांकन के लिए प्री-ट्रेंड मॉडल में भेजे जाने के लिए तैयार हों।
checkpoint = "google/vit-base-patch16-224-in21k"
image_processor = AutoImageProcessor.from_pretrained(checkpoint)

normalize = Normalize(mean=image_processor.image_mean,
                  	std=image_processor.image_std)

size = (
	image_processor.size["shortest_edge"]
	if "shortest_edge" in image_processor.size
	else (image_processor.size["height"], image_processor.size["width"])
)

_transforms = Compose([RandomResizedCrop(size), ToTensor(), normalize])

def transforms(examples):

	examples["pixel_values"] = [_transforms(img.convert("RGB")) for img in examples["image"]]
	del examples["image"]
	return examples

beans_transformed = beans_train.with_transform(transforms)

data_collator = DefaultDataCollator()
आइए समझते हैं कि ऊपर दिए गए कोड में क्या हो रहा है:
google/vit-base-patch16-224-in21k से प्री-ट्रेंड इमेज प्रोसेसिंग मॉडल चेकपॉइंट लोड करते हैं।_transforms) की एक श्रृंखला तैयार की जाती है, जिसमें रैंडम क्रॉपिंग, टेन्सर कन्वर्ज़न, और नॉर्मलाइज़ेशन शामिल हैं।beans_train डेटासेट को transforms फ़ंक्शन के साथ ट्रांसफ़ॉर्म किया जाता है, ताकि वह मॉडल प्रशिक्षण के लिए तैयार हो जाए।इन सेटअप्स के बाद, मॉडल के प्रदर्शन का मूल्यांकन करने के लिए accuracy मेट्रिक का उपयोग किया जाता है, जिसे निम्न हेल्पर फ़ंक्शन से लागू किया गया है।
accuracy = evaluate.load("accuracy")
def compute_metrics(eval_pred):
   predictions, labels = eval_pred
   predictions = np.argmax(predictions, axis=1)

   return accuracy.compute(predictions=predictions,
references=labels)मॉडल प्रशिक्षण प्रक्रिया से पहले, वास्तविक मॉडल को .from_pretrained फ़ंक्शन का लाभ उठाकर प्री-ट्रेंड मॉडल से परिभाषित किया जाता है:
model = AutoModelForImageClassification.from_pretrained(
   checkpoint,
   num_labels=len(labels),
   id2label=id2label,
   label2id=label2id,
)अगला चरण प्रशिक्षण वातावरण को कॉन्फ़िगर और इनिशियलाइज़ करके मॉडल सेट करना है।
इस सेटअप में मॉडल प्रशिक्षण, मूल्यांकन और ऑप्टिमाइज़ेशन से संबंधित आवश्यक हाइपरपैरामीटर्स निर्दिष्ट करना शामिल है।
लेकिन उससे पहले, हमें अपने Hugging Face अकाउंट में अपनी अकाउंट क्रेडेंशियल्स का उपयोग करके लॉगिन करना होगा, जिन्हें निम्न प्रकार से प्राप्त किया जा सकता है:
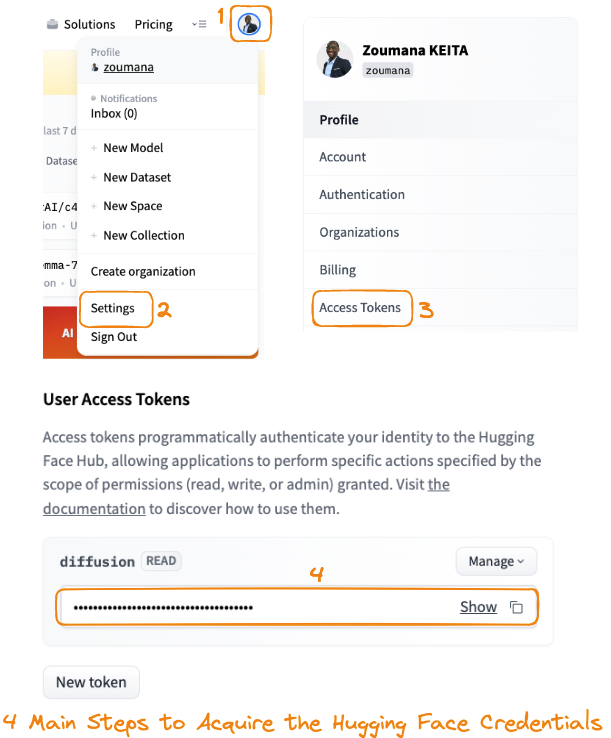
Hugging Face क्रेडेंशियल्स प्राप्त करने के मुख्य चरण
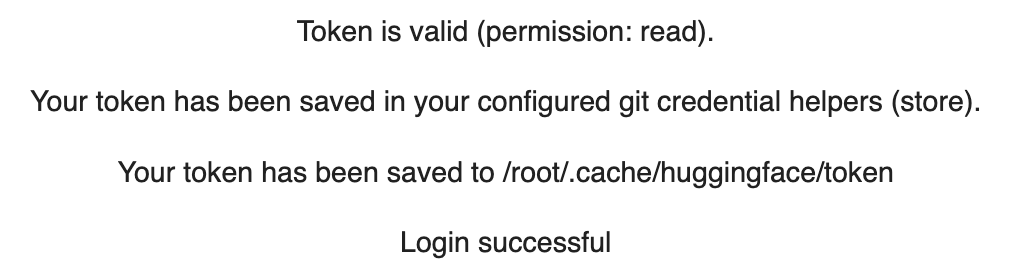
अपने Hugging Face अकाउंट में लॉगिन करके हम अपने प्रशिक्षित मॉडल्स को समुदाय के साथ अपलोड और साझा कर सकते हैं। अगला, प्रमाणीकरण प्रक्रिया notebook_login फ़ंक्शन द्वारा ट्रिगर की जाती है।
notebook_login()प्रॉम्प्ट आने पर, ऊपर दिए गाइड के चरण 4 में कॉपी किया गया कनेक्शन टोकन प्रदान करें।
सफल लॉगिन के बाद, निम्न संदेश प्रदर्शित होना चाहिए:
कॉनफ़िगरेशन और इनिशियलाइज़ेशन का कोड नीचे दिया गया है:
training_args = TrainingArguments(
	output_dir="./beans_health_type_classifier",
	remove_unused_columns=False,
	evaluation_strategy="epoch",
	save_strategy="epoch",
	learning_rate=5e-5,
	per_device_train_batch_size=16,
	gradient_accumulation_steps=4,
	per_device_eval_batch_size=16,
	num_train_epochs=3,
	warmup_ratio=0.1,
	logging_steps=10,
	load_best_model_at_end=True,
	metric_for_best_model="accuracy"
)

trainer = Trainer(
	model=model,
	args=training_args,
	data_collator=data_collator,
	train_dataset=beans_transformed["train"],
	eval_dataset=beans_transformed["test"],
	tokenizer=image_processor,
	compute_metrics=compute_metrics,
)
TrainingArguments को विशिष्ट पैरामीटर्स के साथ कॉन्फ़िगर किया गया है, जैसे आउटपुट डायरेक्ट्री, प्रति epoch मूल्यांकन और सेविंग रणनीति, लर्निंग रेट, बैच साइज़, ग्रेडिएंट एक्यूम्युलेशन स्टेप्स, और प्रशिक्षण प्रक्रिया व मॉडल प्रदर्शन को अनुकूलित करने के लिए अन्य सेटिंग्स।Trainer ऑब्जेक्ट पहले से परिभाषित मॉडल, प्रशिक्षण आर्ग्युमेंट्स, बैचिंग के लिए डेटा कोलेटर, ट्रेन और मूल्यांकन डेटासेट्स, डेटा प्रीप्रोसेसिंग के लिए टोकनाइज़र (या इस मामले में इमेज प्रोसेसर), और मूल्यांकन के लिए मेट्रिक्स कंप्यूट करने वाले फ़ंक्शन के साथ इनिशियलाइज़ किया जाता है।अब आता है प्रशिक्षण चरण, जो .train फ़ंक्शन से किया जाता है।
trainer.train()इस विशेष प्रशिक्षण से निम्न मेट्रिक्स प्राप्त हुए:
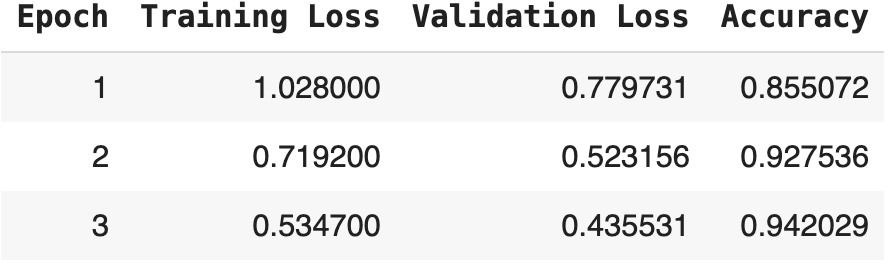
तीन epochs के लिए मॉडल प्रशिक्षण परिणाम
हम देख सकते हैं कि तालिका आपके beans डेटासेट पर तीन epochs के दौरान मॉडल प्रशिक्षण की प्रगति दिखाती है, और तीन प्रमुख मेट्रिक्स प्रदर्शित करती है: प्रशिक्षण लॉस, वैलिडेशन लॉस, और एक्यूरेसी।
Hugging Face पोर्टल पर पहली बार प्रमाणीकरण करते समय, कनेक्शन मोड केवल Read था। हालाँकि, हमें अपना मॉडल Hugging Face हब पर पुश करने के लिए write क्रेडेंशियल की आवश्यकता है।
इसके बाद, हमें नए बनाए गए क्रेडेंशियल्स का उपयोग करके notebook_login फ़ंक्शन से दोबारा लॉगिन करना होगा।
notebook_login()मॉडल को पुश करना push_to_hub फ़ंक्शन से इस प्रकार किया जाता है:
trainer.model.push_to_hub("zoumana/beans_health_type_classifier")यह मॉडल को हब पर पुश कर देगा, और हम वास्तविक मॉडल के मुख्य गुण देख सकते हैं।
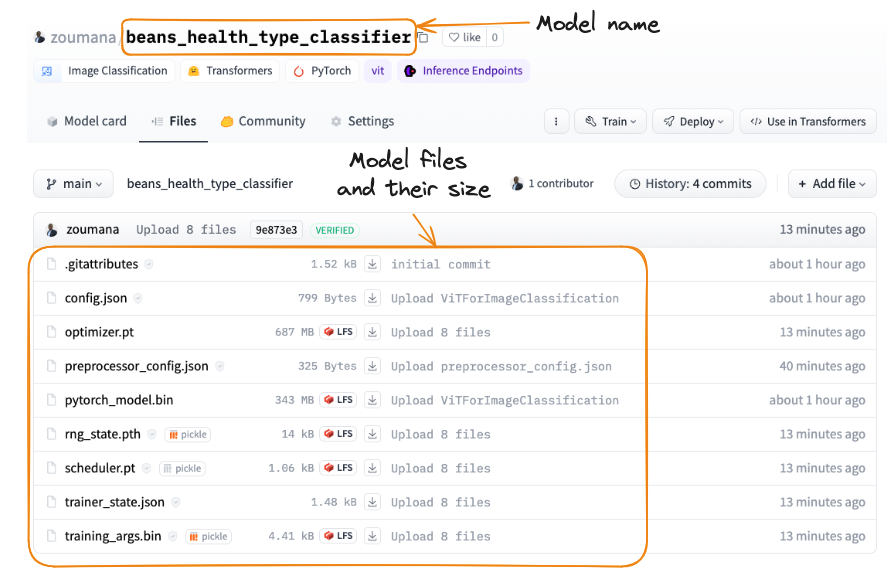
Hugging Face पर मॉडल पुश किया गया
मॉडल साझा हो जाने के बाद, इसे REST API का उपयोग करके एप्लिकेशनों में इंटीग्रेट किया जा सकता है, या उपयोगकर्ता सीधे Hugging Face पोर्टल से भी इंटीग्रेट कर सकते हैं। डेवलपर्स और शोधकर्ता Transformers लाइब्रेरी का उपयोग करके मॉडल को लोड कर भी सकते हैं।
इस सेक्शन में, हम मॉडल का उपयोग करने के तीन मुख्य तरीकों को कवर करते हैं।
पोर्टल पर, उपयोगकर्ता सीधे एक छवि अपलोड कर सकते हैं और नीचे दी एनीमेशन में दिखाए अनुसार मॉडल की भविष्यवाणियाँ प्राप्त कर सकते हैं।
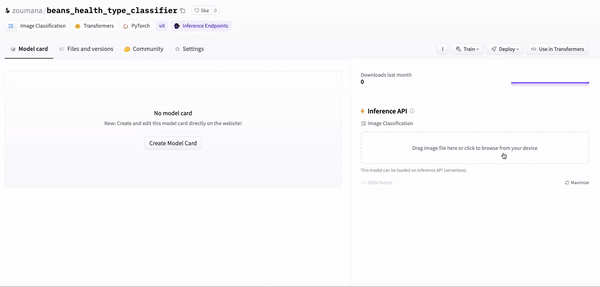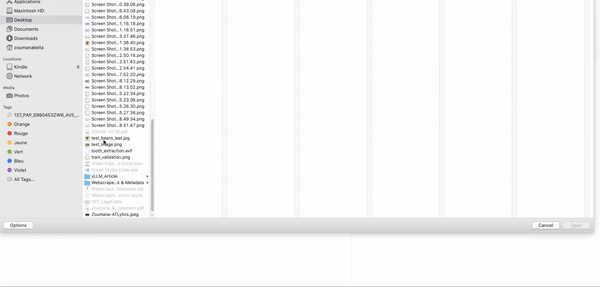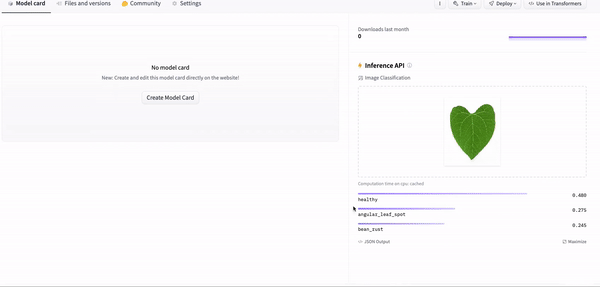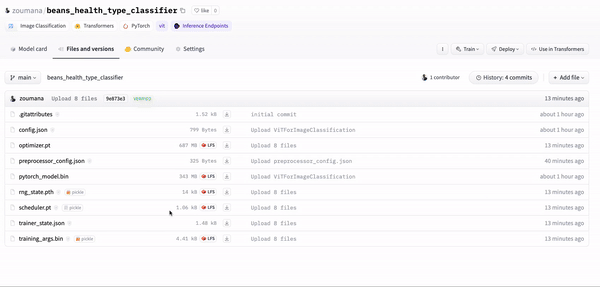
Hugging Face पोर्टल से मॉडल का उपयोग
“Use in Transformers” आइकन चुनने पर, मॉडल उपयोग करने का कोड अपने-आप निम्न प्रकार से प्रदान किया जाता है:
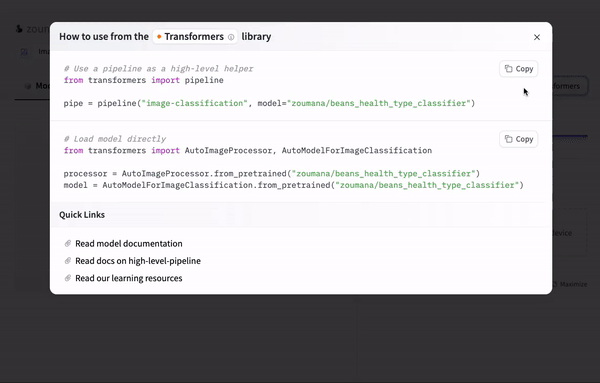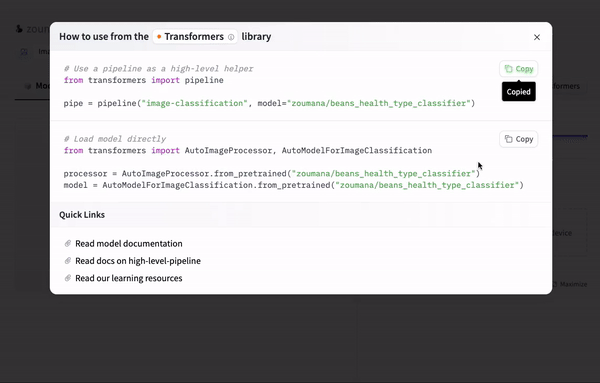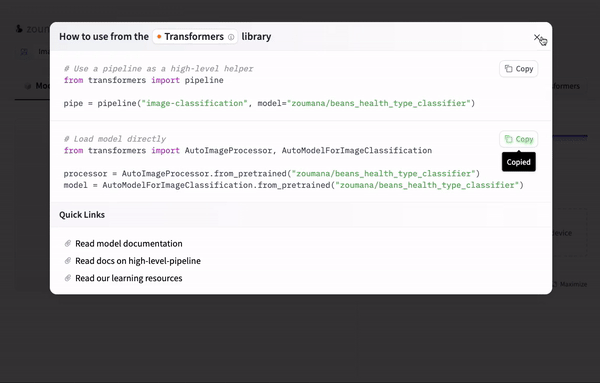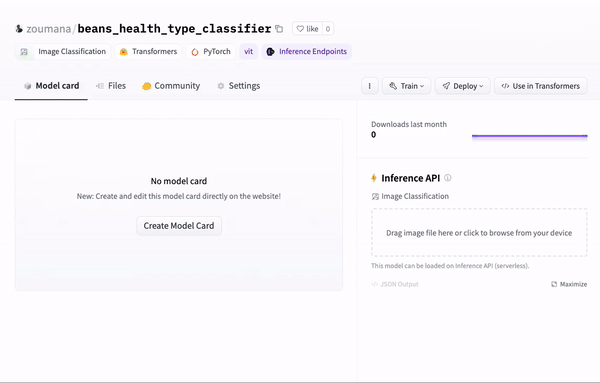
Transformers के साथ मॉडल का उपयोग
अंततः, हम पोर्टल पर “Deploy > Inference API (serverless)” आइकन पर क्लिक करने के बाद स्वचालित रूप से प्रदान किए गए कनेक्शन स्ट्रिंग का उपयोग करके मॉडल को REST API के रूप में उपयोग कर सकते हैं।
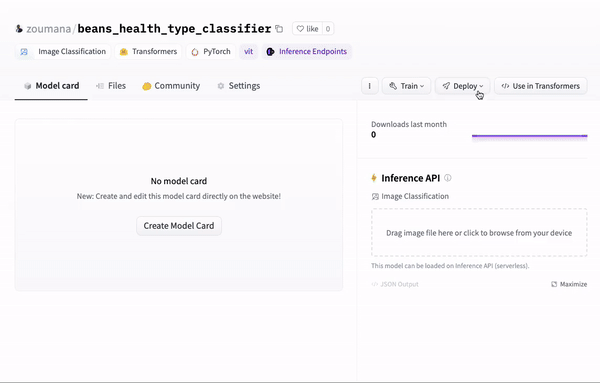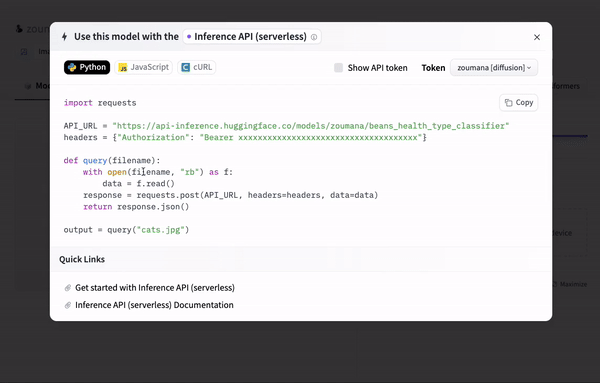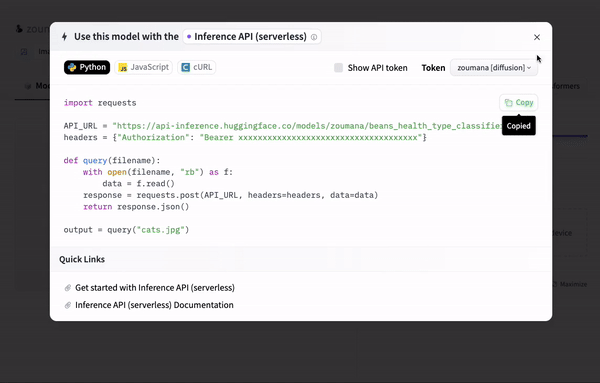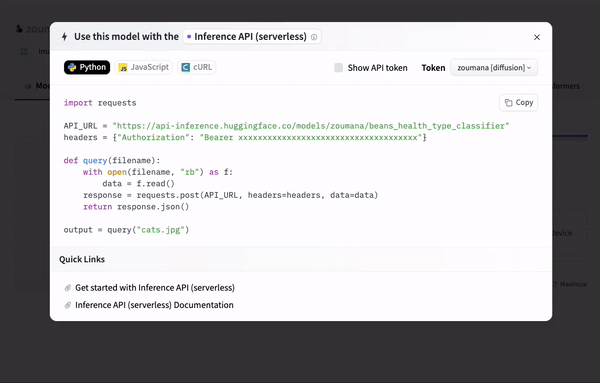
API एंडपॉइंट का उपयोग
पिछली एनीमेशन में दिया कोड स्निपेट नीचे जैसा ही है और किसी दी गई छवि पर प्रेडिक्शन करने के लिए उपयोग किया जा सकता है।
प्रयुक्त छवि वही है जो Hugging Face पोर्टल के डेमो के दौरान दी गई थी।
“xxx” को वास्तविक मानों से बदलना सुनिश्चित करें।
import requests

API_URL = "https://api-inference.huggingface.co/models/zoumana/beans_health_type_classifier"
headers = {"Authorization": "Bearer xxxxxxxxxxxxxxxxx"}

def query(filename):
   with open(filename, "rb") as f:
       data = f.read()
   response = requests.post(API_URL, headers=headers, data=data)
   return response.json()
इसके बाद, हम पिछले query फ़ंक्शन का उपयोग करके मॉडल की प्रतिक्रिया प्राप्त करते हैं।
output = query("./inference_images/test_beans_leaf.jpg")अंतिम परिणाम नीचे दिखाया गया एक JSON रिस्पॉन्स है। हम देख सकते हैं कि भविष्यवाणी किया गया लेबल वह है जिसकी संभावना स्कोर सबसे अधिक है—और इस मामले में, यह healthy लेबल है, जो Hugging Face पोर्टल की ठीक वही भविष्यवाणी है।
print(output)[
{'label': 'healthy', 'score': 0.4799719452857971},
{'label': 'angular_leaf_spot', 'score': 0.27489492297172546},
{'label': 'bean_rust', 'score': 0.2451331913471222}
]इस लेख ने Hugging Face का उपयोग करके इमेज क्लासिफिकेशन कार्यों को करने पर एक संपूर्ण गाइड प्रदान किया।
हमने इमेज क्लासिफिकेशन की बुनियाद से शुरुआत की और यह चर्चा की कि क्यों Hugging Face इस काम के लिए बेहतरीन टूल है—इसके व्यापक मॉडल संग्रह और सहयोगी समुदाय के कारण।
फिर, हमने क्लासिफिकेशन के लिए प्रशिक्षण छवियों को तैयार करने को कवर किया, जिसमें यह सुनिश्चित करना शामिल था कि प्रशिक्षण डेटा फाइन-ट्यूनिंग आवश्यकताओं को पूरा करे।
आगे, हमने Hugging Face के साथ किसी उपयुक्त प्री-ट्रेंड मॉडल का चयन कर, मॉडल को फाइन-ट्यून करने की प्रक्रिया में गहराई से देखा। हमने प्रशिक्षित मॉडल को वास्तविक दुनिया के अनुप्रयोगों में तीन प्रमुख इंटीग्रेशन रणनीतियों के माध्यम से कैसे शामिल करें, इस पर भी चर्चा की।
There's always more to learn and explore in AI, and each step you take opens up new possibilities. So, for anyone wanting to learn more about AI and machine learning, especially about classifying images and more, here are some great resources to check out:
यह गाइड किसी भी व्यक्ति को—चाहे वे शुरुआती हों, मध्यवर्ती या उन्नत प्रैक्टिशनर—Hugging Face का उपयोग करके इमेज क्लासिफिकेशन के लिए अपने स्वयं के प्रोजेक्ट शुरू करने में मदद करने के लिए बनाया गया है।
Start Your AI Journey Today!
कोर्स
कोर्स
लर्निंग पाथ