
Kurs
Hugging Face ile Çalışmak
2 sa
39.3K
Yapay zekâ (AI) ve makine öğrenimi (ML) hızla gelişirken, görüntü sınıflandırma; yüz tanıma sistemlerinden tıbbi görüntü analizine kadar geniş bir uygulama yelpazesini besleyen temel bir görev olarak öne çıkıyor.
Veri bilimciler ve AI uygulayıcıları için mevcut çok sayıdaki araç ve kütüphane arasında, Hugging Face özellikle doğal dil işleme (NLP) üzerinde çalışanlar ve giderek artan biçimde görüntü sınıflandırma gibi bilgisayarlı görü görevleri için önemli bir oyuncu konumunda.
Bu makalede, Hugging Face'i görüntü sınıflandırma için kullanmanın temellerini; görüntü sınıflandırmanın temellerini anlamayı, verinizi hazırlamayı, modelinizi eğitmeyi, modeli Hugging Face hub'ına dağıtmayı ve son olarak dağıtılmış modelle API ve Hugging Face arayüzü üzerinden etkileşimi kapsayacak şekilde ele alacağız.
İster yeni başlıyor olun ister deneyimli bir uygulayıcı olun, bu rehber görüntü sınıflandırma ihtiyaçlarınız için Hugging Face'ten nasıl yararlanabileceğinize dair değerli içgörüler sunacak.
Bu bölüm, görüntü sınıflandırmanın temelleri ve Hugging Face kullanmanın faydalarına dair bir bakış sunar.
Görüntü sınıflandırma, görüntülerin önceden tanımlanmış sınıflardan birine atanmasını ifade eder.
Bu görev, bir görüntünün görsel içeriğini analiz eden ve eğitim veri setinden öğrendiği örüntülere dayanarak kategorisini tahmin eden algoritmalarla gerçekleştirilir. Özellikle evrişimli sinir ağları (CNN'ler) olmak üzere derin öğrenme modelleri, görüntü verilerindeki ilgili örüntüleri yakalama becerileri nedeniyle bu görev için standart yaklaşım haline gelmiştir.
CNN'ler hakkında daha fazla bilgi edinmek için, Evrişimli Sinir Ağlarına (CNN'ler) Giriş başlıklı makalemiz; CNN'leri, görüntü analizine etkilerini ve güçlü CNN'ler ile derin öğrenme uygulamaları için aşırı uyumu önlemeye yönelik bazı temel stratejileri ayrıntılı biçimde açıklar.
Ayrıca, Makine Öğreniminde Sınıflandırma: Bir Giriş makalesi; sınıflandırmanın ne olduğunu, nasıl kullanıldığını ve bazı sınıflandırma algoritmalarına örnekleri adım adım ele alır.
Hugging Face, kullanımı kolay arayüzleri, geniş bir önceden eğitilmiş model deposu ve kapsamlı dokümantasyonuyla makine öğrenimi için geniş bir ekosistem sunar.
Diğer platformlarla karşılaştırıldığında Hugging Face, görüntü sınıflandırma için birçok avantaj sağlar:
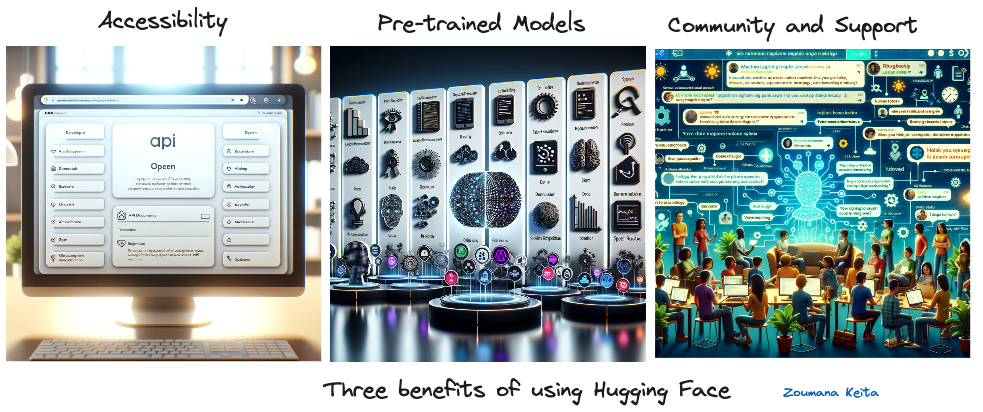
Hugging Face kullanmanın üç faydası (Görsel GPT-4 ile oluşturuldu)
Ek olarak, Hugging Face modellerin AWS, Azure ve Google Cloud Platform gibi büyük bulut platformlarına, birden çok çıkarım türüyle dağıtılmasını kolaylaştırır.
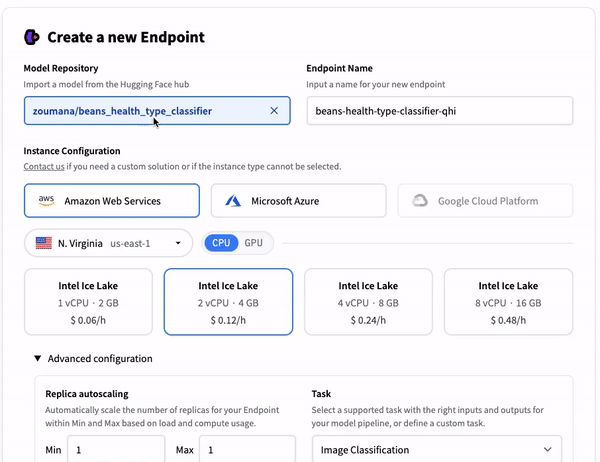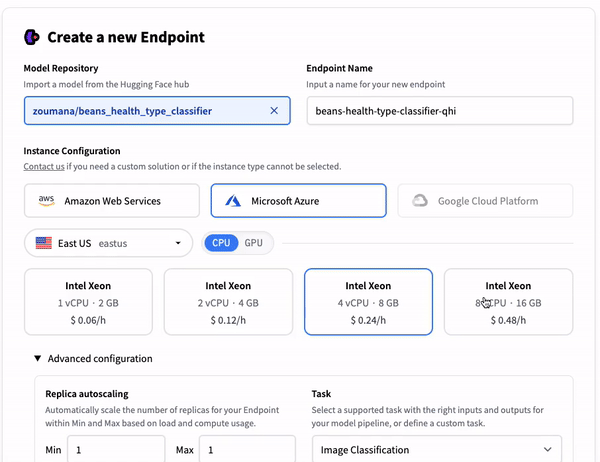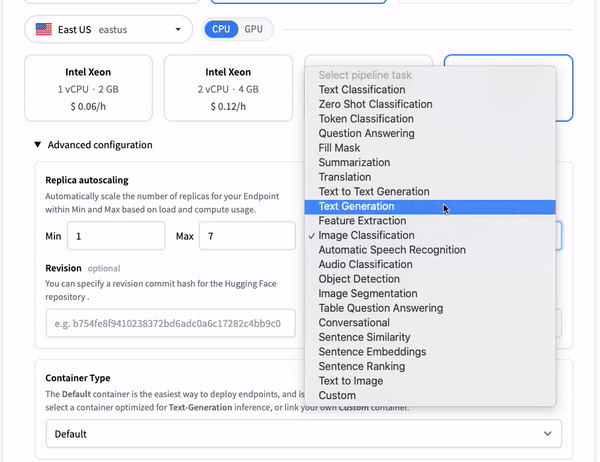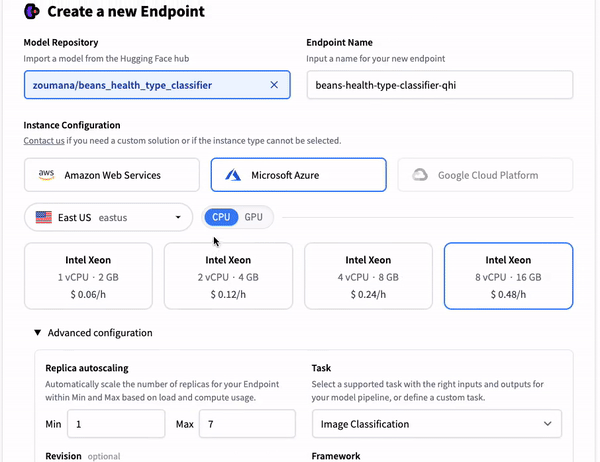
Bulut platformlarında model dağıtım seçenekleri
Bu makalede ele alınan ana görev görüntü sınıflandırmadır ve örneğimiz için Hugging Face'teki beans veri setini kullanacağız. Veri kümesini yükledikten sonra, model eğitimine yönelik ön işlemeden önce bazı görselleştirmeler yapacağız.
Kodu içeren not defteri, Google Colab üzerinde adım adım takip etmek için kullanılabilir.
Bu makaledeki kodlar, Hugging Face'in resmi web sitesinden büyük ölçüde esinlenmiştir.
Bu makale kapsamında birden fazla kütüphane kullanılır ve her birinin belirli bir rolü vardır. Bazı kütüphanelerin kurulması gerekir. Bu kütüphaneler, Python paket yöneticisi “pip” ile aşağıdaki gibi kurulur:
%%bash
pip -q install datasets
pip -q install transformers=='4.29.0'
pip -q install tensorflow=='2.15' # At least this tensorflow version is required to use the "evaluate module"
pip -q install evaluate
pip -q install --upgrade accelerate
Kütüphaneler kurulduktan sonra çekirdeği yeniden başlatmak önemlidir. Başarılı bir kurulumdan sonra, gerekli kütüphaneler from ve import deyimleriyle içe aktarılabilir:
import torch
import torchvision
import numpy as np
import evaluate
from datasets import load_dataset
from huggingface_hub import notebook_login
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from transformers import DefaultDataCollator
from transformers import AutoImageProcessor
from torchvision.transforms import RandomResizedCrop, Compose, Normalize, ToTensor
from transformers import AutoModelForImageClassification, TrainingArguments, Trainer
import matplotlib.pyplot as pltHugging Face'ten veri yüklemek, load_dataset fonksiyonunu kullanarak oldukça kolaydır.
beans_train = load_dataset("beans", split="train")beans, kullanılan veri setinin adıdır.train, tüm verilerin kullanılan alt kümesine karşılık gelir.Veri yüklendikten sonra, yukarıdaki değişkenin adını yazdırarak özelliklerini kontrol edebiliriz.
print(beans_train)Bu, aşağıdaki sonucu gösterir:
Dataset({
    features: ['image_file_path', 'image', 'labels'],
    num_rows: 1034
})
Toplamda 1034 görüntü vardır ve her görüntünün üç alanı bulunur:
image_path: gerçek görüntünün yolu.image: fasulye görüntüsünün bir PIL nesnesi.labels: görüntünün etiketi; aşağıdaki üç türden biri olabilir:Aşağıdaki yardımcı fonksiyon, rastgele seçilen belirli sayıda görüntüyü görselleştirmeyi ve mevcut etiketlerle (0, 1 ve 2) birlikte doğru görüntü türünü atamayı kolaylaştırır
labels_names = {
   0: "angular_leaf_spot",
   1: "bean_rust",
   2: "healthy",
}

def display_random_images(dataset, num_images=4):

   num_rows = 2
   num_cols = np.ceil(num_images / num_rows).astype(int)

   plt.figure(figsize=(num_cols * 3, num_rows * 3))
   indices = np.random.choice(range(len(dataset)), size=num_images, replace=False)

   for i, idx in enumerate(indices, 1):
       idx = int(idx)
       image = dataset[idx]['image']
       label = dataset[idx]['labels']
       label_name = labels_names.get(label, "Unknown")

       plt.subplot(num_rows, num_cols, i)
       plt.imshow(image)
       plt.title(f"{label_name} ({label})")
       plt.axis('off')

   plt.tight_layout()
   plt.show()
Kısacası, bu display_random_images fonksiyonu, verilen bir veri kümesinden rastgele bir görüntü alt kümesi seçer ve her görüntüyü sınıflandırmasına göre (ör. "angular_leaf_spot", "bean_rust", "healthy") etiketleyerek bir ızgarada gösterir.
Görüntüleri dinamik olarak iki satıra yerleştirir ve gösterilecek toplam görüntü sayısına göre gerekli sütun sayısını hesaplar; böylece yinelenen görüntü olmaz ve her biri karşılık gelen etiket adı ve sayısal etiketiyle birlikte sunulur.
Ardından, fonksiyonu aşağıdaki gibi kullanarak altı rastgele görüntü görüntüleyebiliriz:
display_random_images(beans_train, num_images=6)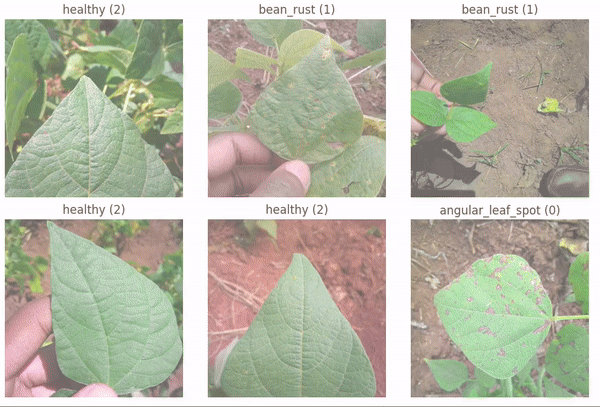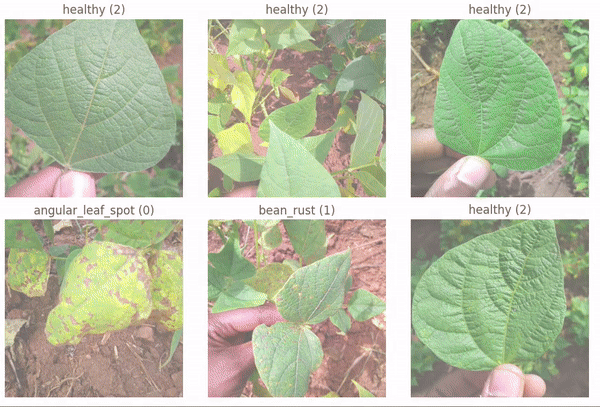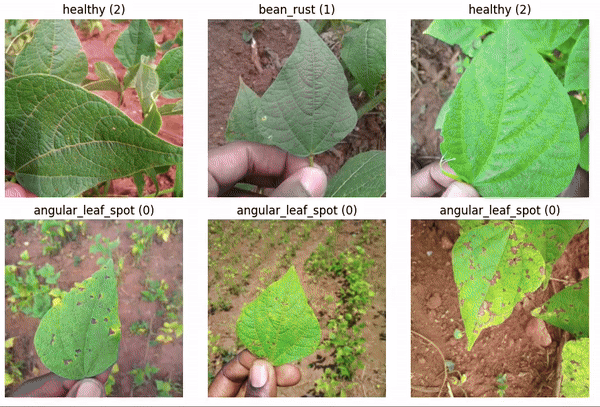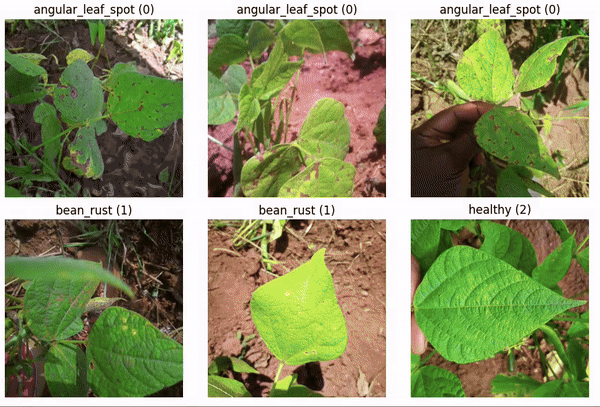
Veri setinden altı rastgele görüntü
Modeli eğitmeden önce, veriyi model için uygun hale getirecek ilgili ön işlemleri yapmak önemlidir.
İlk olarak, orijinal veri seti sırasıyla %80 eğitim ve %20 doğrulama olacak şekilde bölünür; bu da train_test_split fonksiyonu kullanılarak gerçekleştirilir.
beans_train = beans_train.train_test_split(test_size=0.2)Sonraki adımda iki sözlük oluşturulur: label2id ve id2label. Bu, insan tarafından okunabilir etiket adları ile makinenin anlayabileceği sayısal tanımlayıcılar arasında dönüşüm yapmak için kritik önemdedir.
Bu süreç, hem eğitim sürecini hem de nihai modelin tahminlerinin yorumlanmasını kolaylaştırır.
labels = beans_train["train"].features["labels"].names
label2id, id2label = dict(), dict()

for i, label in enumerate(labels):
   label2id[label] = str(i)
   id2label[str(i)] = label
Aşağıda id2label değişkeninin sonucu yer almaktadır:
print(id2label){'0': 'angular_leaf_spot', '1': 'bean_rust', '2': 'healthy'}Sınıflandırma modelimiz, Hugging Face'ten önceden eğitilmiş görsel dönüştürücü (ViT) modelinden yararlanır.
Bu model, An Image is Worth 16x16 words: Transformers for Image Recognition at Scale çalışmasında tanıtılmış olup, ImageNet veri seti üzerinde eğitilen dönüştürücü mimarisinin görüntü tanımaya ilk başarılı uygulanmasını temsil eder.
Aşağıdaki kod, önceden eğitilmiş modeli yüklemek, veriyi modelin gereksinimlerini karşılayacak şekilde ön işlemek ve görüntülerin doğru biçimde işlenip ince ayar ve değerlendirme için modele beslenmeye hazır olmasını sağlamak üzere ara adımları açıklar.
checkpoint = "google/vit-base-patch16-224-in21k"
image_processor = AutoImageProcessor.from_pretrained(checkpoint)

normalize = Normalize(mean=image_processor.image_mean,
                  	std=image_processor.image_std)

size = (
	image_processor.size["shortest_edge"]
	if "shortest_edge" in image_processor.size
	else (image_processor.size["height"], image_processor.size["width"])
)

_transforms = Compose([RandomResizedCrop(size), ToTensor(), normalize])

def transforms(examples):

	examples["pixel_values"] = [_transforms(img.convert("RGB")) for img in examples["image"]]
	del examples["image"]
	return examples

beans_transformed = beans_train.with_transform(transforms)

data_collator = DefaultDataCollator()
Yukarıdaki kodda neler olduğuna bakalım:
google/vit-base-patch16-224-in21k kontrol noktasından önceden eğitilmiş görüntü işleme modeli yüklenir._transforms) birleştirilir.beans_train veri seti, eğitim için hazırlanması amacıyla bu dönüşüm fonksiyonu ile dönüştürülür.Bu kurulumların ardından, model performansını değerlendirmek için kullanılan değerlendirme metriği doğruluktur (accuracy) ve aşağıdaki yardımcı fonksiyonla uygulanır.
accuracy = evaluate.load("accuracy")
def compute_metrics(eval_pred):
   predictions, labels = eval_pred
   predictions = np.argmax(predictions, axis=1)

   return accuracy.compute(predictions=predictions,
references=labels)Model eğitim sürecinden önce, önceden eğitilmiş modelden yararlanarak gerçek model, .from_pretrained fonksiyonu ile aşağıdaki gibi tanımlanır
model = AutoModelForImageClassification.from_pretrained(
   checkpoint,
   num_labels=len(labels),
   id2label=id2label,
   label2id=label2id,
)Bir sonraki adım, eğitim ortamını yapılandırıp başlatarak modeli kurmaktır.
Kurulum; model eğitimi, değerlendirme ve optimizasyona ilişkin gerekli hiperparametrelerin belirlenmesini içerir.
Ancak bundan önce, hesap kimlik bilgilerimizi kullanarak Hugging Face hesabımıza giriş yapmamız gerekir; bunlar aşağıdaki şekilde edinilebilir:
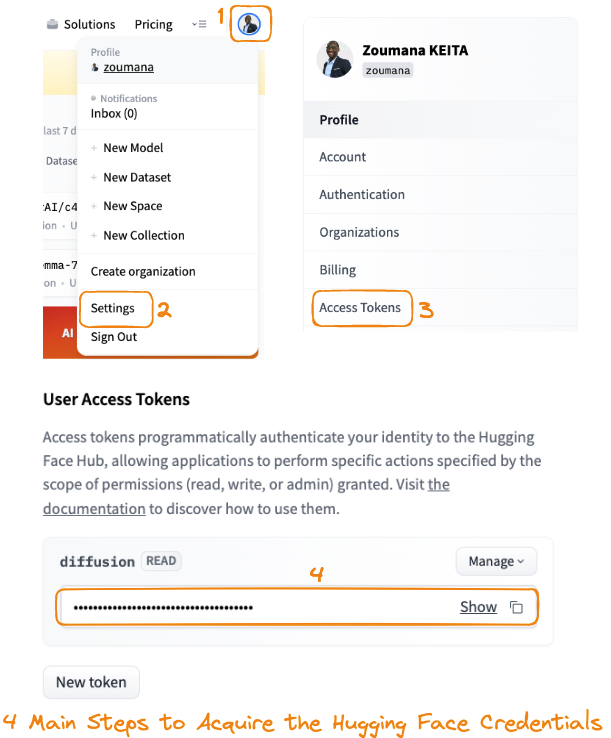
Hugging Face kimlik bilgilerini edinmenin ana adımları
Hugging Face hesabımıza giriş yaparak, eğitilmiş modellerimizi toplulukla yükleyebilir ve paylaşabiliriz. Sonraki adımda, kimlik doğrulama süreci notebook_login fonksiyonu kullanılarak başlatılır.
notebook_login()İstendiğinde, yukarıdaki rehberin 4. adımında kopyalanan bağlantı belirtecini girin.
Başarılı bir oturum açma sonrasında aşağıdaki mesaj görüntülenmelidir:
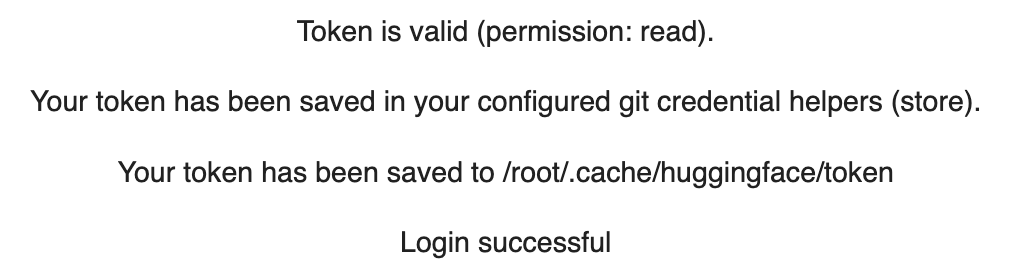
Yapılandırma ve başlatma kodu aşağıda verilmiştir:
training_args = TrainingArguments(
	output_dir="./beans_health_type_classifier",
	remove_unused_columns=False,
	evaluation_strategy="epoch",
	save_strategy="epoch",
	learning_rate=5e-5,
	per_device_train_batch_size=16,
	gradient_accumulation_steps=4,
	per_device_eval_batch_size=16,
	num_train_epochs=3,
	warmup_ratio=0.1,
	logging_steps=10,
	load_best_model_at_end=True,
	metric_for_best_model="accuracy"
)

trainer = Trainer(
	model=model,
	args=training_args,
	data_collator=data_collator,
	train_dataset=beans_transformed["train"],
	eval_dataset=beans_transformed["test"],
	tokenizer=image_processor,
	compute_metrics=compute_metrics,
)TrainingArguments, çıktı dizini; dönem başına değerlendirme ve kaydetme stratejisi; öğrenme oranı; yığın boyutu; gradyan biriktirme adımları ve eğitim sürecini ve model performansını optimize etmeye yönelik diğer ayarlar gibi belirli parametrelerle yapılandırılır.Trainer nesnesi başlatılır.Şimdi .train fonksiyonu ile gerçekleştirilen eğitim aşamasına geçiyoruz.
trainer.train()Bu özel eğitim süreci aşağıdaki metriklere yol açtı:
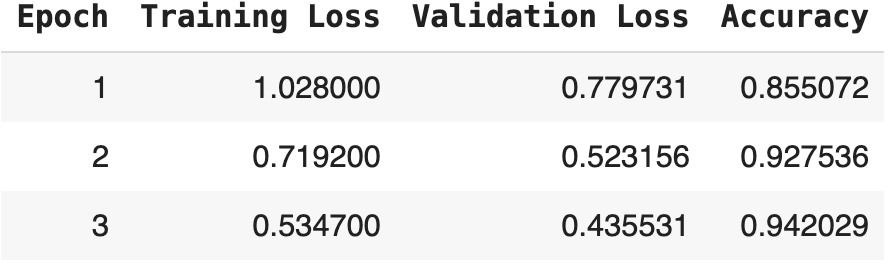
Üç dönemlik model eğitimi sonucu
Tablonun, fasulye veri kümeniz üzerinde üç dönem boyunca model eğitimindeki ilerlemeyi; üç ana metriği vurgulayarak gösterdiğini görüyoruz: eğitim kaybı, doğrulama kaybı ve doğruluk.
Hugging Face portalına ilk kez kimlik doğrulaması yaparken bağlantı modu yalnızca Read idi. Ancak modelimizi Hugging Face hub'ına gönderebilmek için write yetkisine sahip kimlik bilgisine ihtiyacımız var.
Bunun ardından, yeni oluşturulan kimlik bilgilerini kullanarak notebook_login fonksiyonuyla tekrar giriş yapmamız gerekir.
notebook_login()Modeli gönderme işlemi, push_to_hub fonksiyonu aşağıdaki gibi kullanılarak gerçekleştirilir:
trainer.model.push_to_hub("zoumana/beans_health_type_classifier")Bu işlem modeli hub'a gönderecek ve mevcut modelin temel özelliklerini görebileceğiz.
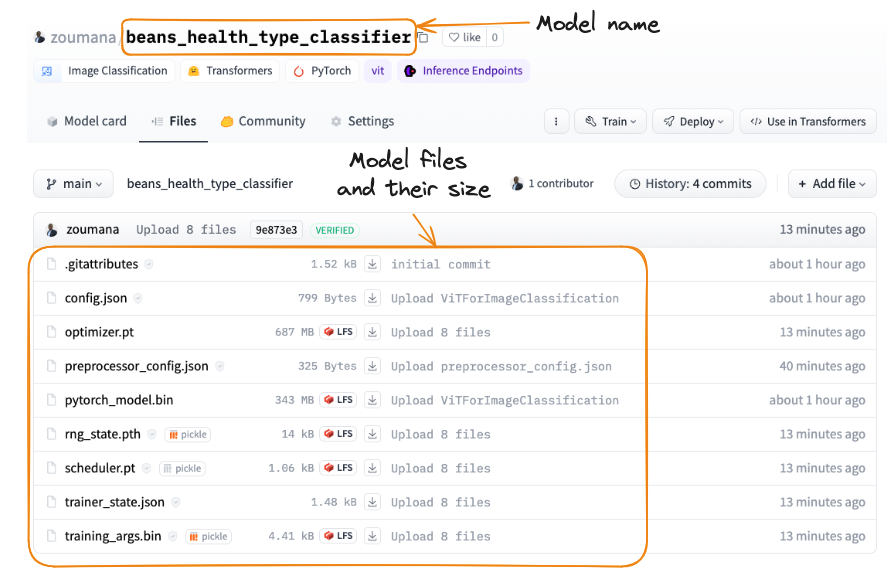
Model Hugging Face'e gönderildi
Model paylaşıldıktan sonra, REST API kullanılarak uygulamalara entegre edilebilir veya kullanıcılar onu doğrudan Hugging Face portalı üzerinden kullanabilir. Geliştiriciler ve araştırmacılar ayrıca modeli Transformers kütüphanesiyle yükleyerek de kullanabilir.
Bu bölümde, modeli kullanmanın üç ana yolunu ele alıyoruz.
Portal üzerinde kullanıcılar doğrudan bir görüntü yükleyerek, aşağıdaki animasyonda gösterildiği gibi modelin tahminlerini alabilir.
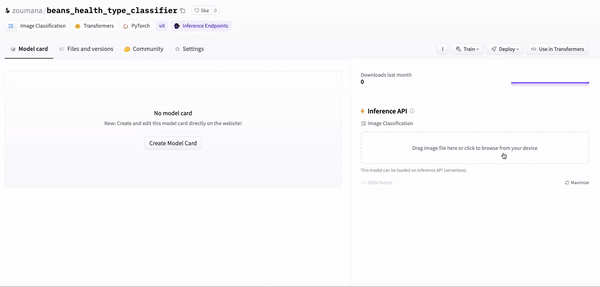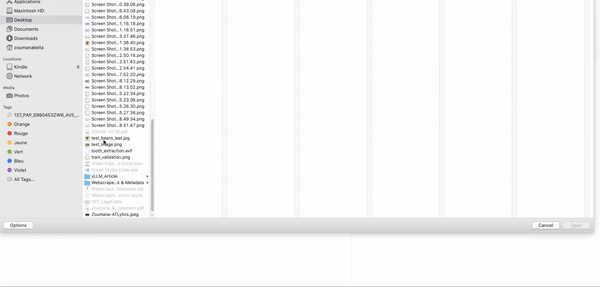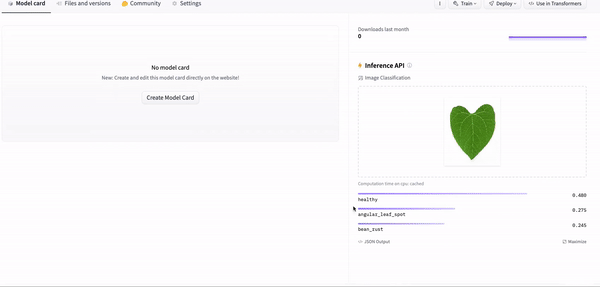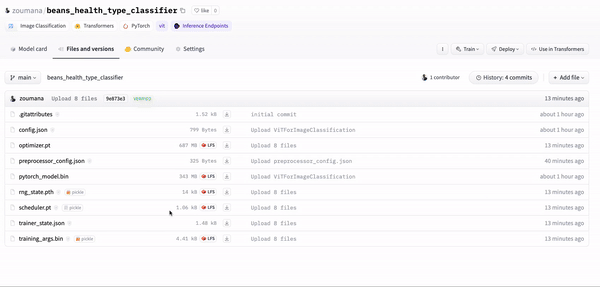
Modeli Hugging Face portalından kullanma
“Use in Transformers” simgesi seçildiğinde, modeli kullanmaya yönelik kod aşağıdaki gibi otomatik olarak sağlanır:
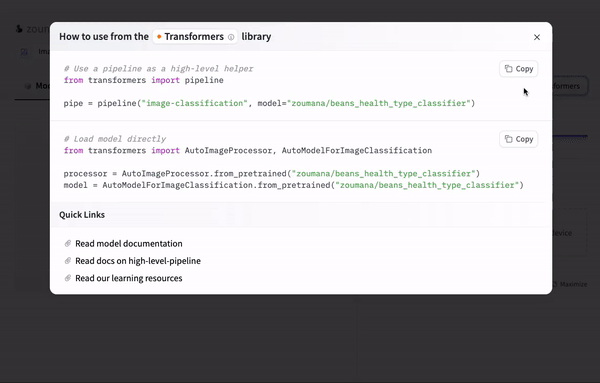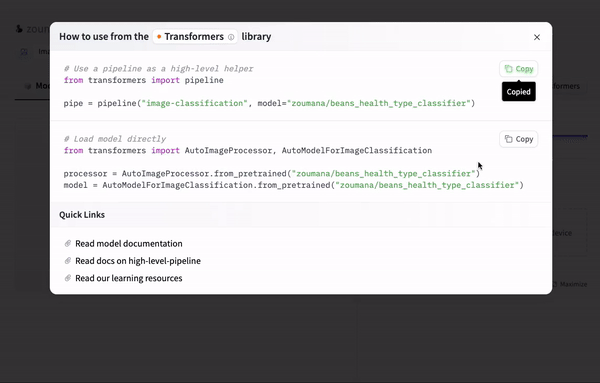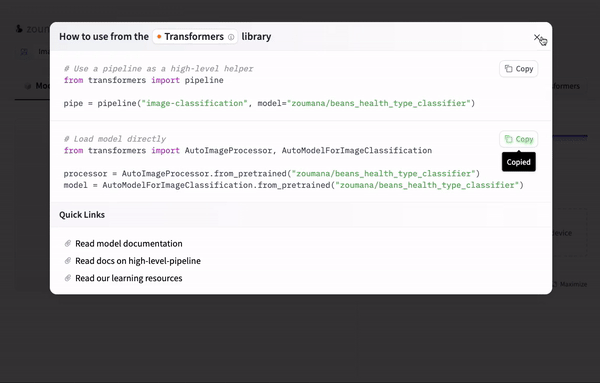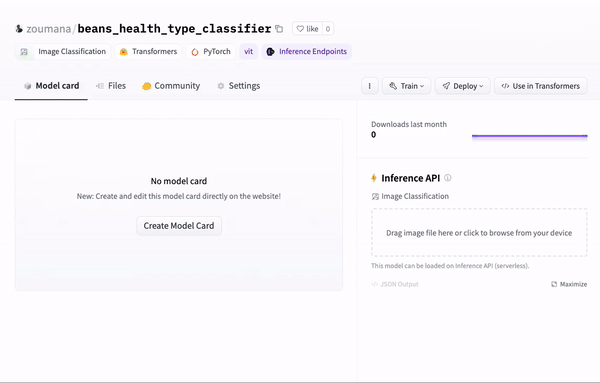
Modeli Transformers ile kullanma
Son olarak, “Deploy > Inference API (serverless)” simgesine tıkladıktan sonra portaldan otomatik olarak sağlanan bağlantı dizesini kullanarak modeli bir REST API olarak kullanabiliriz.
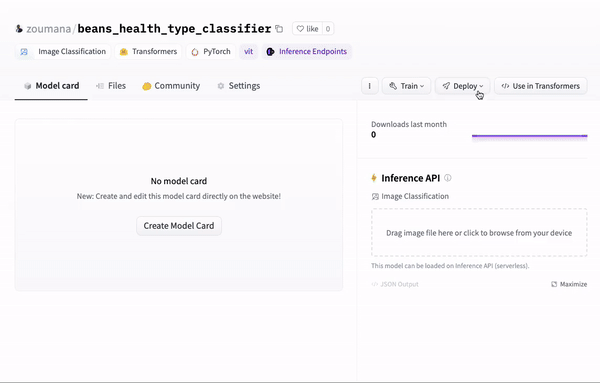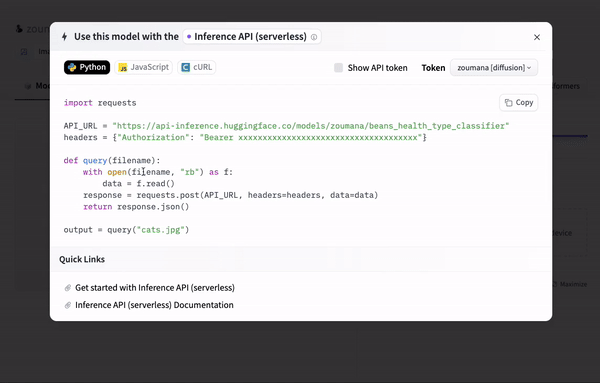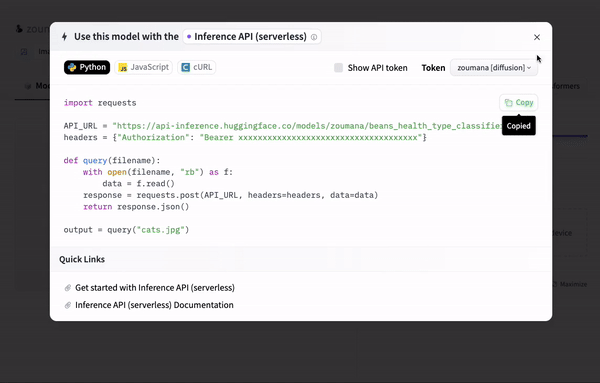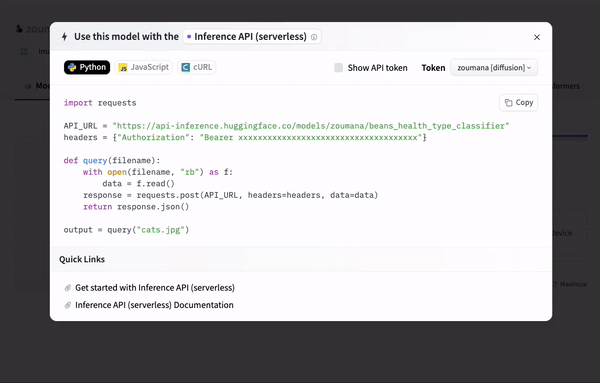
Bir API uç noktası kullanma
Önceki animasyonda verilen kod parçacığı aşağıdakiyle aynıdır ve belirli bir görüntü üzerinde tahmin yapmak için kullanılabilir.
Kullanılan görüntü, Hugging Face portalındaki örnekte kullanılanın aynısıdır.
“xxx” ifadelerini gerçek değerlerle değiştirdiğinizden emin olun.
import requests

API_URL = "https://api-inference.huggingface.co/models/zoumana/beans_health_type_classifier"
headers = {"Authorization": "Bearer xxxxxxxxxxxxxxxxx"}

def query(filename):
   with open(filename, "rb") as f:
       data = f.read()
   response = requests.post(API_URL, headers=headers, data=data)
   return response.json()
Ardından, önceki query fonksiyonunu kullanarak modelin yanıtını alırız.
output = query("./inference_images/test_beans_leaf.jpg")Nihai sonuç aşağıda gösterildiği gibi bir JSON yanıtıdır. En yüksek olasılık skoruna sahip etiketin tahmin edildiğini görüyoruz; bu durumda healthy etiketi olup Hugging Face portalındaki tahminle birebir aynıdır.
print(output)[
{'label': 'healthy', 'score': 0.4799719452857971},
{'label': 'angular_leaf_spot', 'score': 0.27489492297172546},
{'label': 'bean_rust', 'score': 0.2451331913471222}
]Bu makale, Hugging Face kullanarak görüntü sınıflandırma görevlerinin nasıl gerçekleştirileceğine dair eksiksiz bir rehber sundu.
Görüntü sınıflandırmanın temelleriyle başladık ve geniş model koleksiyonu ile destekleyici topluluğu sayesinde Hugging Face'in bu iş için neden harika bir araç olduğundan bahsettik.
Ardından, eğitim görüntülerini sınıflandırmaya hazır hale getirmeyi; eğitim verisinin ince ayar gereksinimlerini karşıladığından nasıl emin olunacağını kapsadık.
Ayrıca, doğru önceden eğitilmiş modeli seçerek Hugging Face ile bir modelin nasıl ince ayarının yapılacağını inceledik. Eğitilen modelin üç ana entegrasyon stratejisiyle gerçek dünya uygulamalarına nasıl entegre edileceğini de tartıştık.
AI alanında her zaman öğrenilecek ve keşfedilecek daha çok şey var ve attığınız her adım yeni olasılıkların kapısını aralar. Bu nedenle, özellikle görüntü sınıflandırma ve ötesi konusunda AI ve makine öğrenimi hakkında daha fazla bilgi edinmek isteyen herkes için göz atılabilecek bazı harika kaynaklar şunlardır:
Bu rehber, ister başlangıç düzeyinde, ister orta veya ileri düzey uygulayıcılar olsun, herkesin Hugging Face kullanarak görüntü sınıflandırma projelerine başlamasına yardımcı olmayı amaçlar.
Yapay Zekâ Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



