
Kurs
Arbeiten mit Hugging Face
2 Std.
38.2K
In der rasant wachsenden Welt der Künstlichen Intelligenz (KI) und des maschinellen Lernens (ML) ist die Bildklassifikation eine zentrale Aufgabe. Sie treibt Anwendungen von Gesichtserkennung bis hin zu medizinischer Bilddiagnostik an.
Unter den vielen Tools und Bibliotheken für Data Scientists und KI-Profis ist Hugging Face eine feste Größe – besonders in der Sprachverarbeitung (NLP) und zunehmend auch bei Computer-Vision-Aufgaben wie der Bildklassifikation.
Dieser Artikel zeigt dir die Essentials der Bildklassifikation mit Hugging Face: von den Grundlagen über die Datenaufbereitung und das Training bis hin zum Deployment deines Modells im Hugging Face Hub – inklusive Zugriff über API und die Hugging Face Oberfläche.
Egal ob Einsteiger oder erfahrene Praktikerin: Dieser Guide gibt dir wertvolle Einblicke, wie du Hugging Face für deine Bildklassifikationsprojekte optimal nutzt.
In diesem Abschnitt lernst du die Grundlagen der Bildklassifikation und die Vorteile von Hugging Face kennen.
Bildklassifikation bedeutet, Bilder einer von mehreren vordefinierten Klassen zuzuordnen.
Dazu analysieren Algorithmen den visuellen Inhalt eines Bildes und sagen anhand von Mustern aus den Trainingsdaten die passende Kategorie voraus. Tiefe neuronale Netze, insbesondere Convolutional Neural Networks (CNNs), sind hier Standard, weil sie relevante Strukturen in Bilddaten sehr gut erfassen.
Mehr über CNNs erfährst du im Artikel An Introduction to Convolutional Neural Networks (CNNs) – inklusive Grundlagen, Wirkung auf die Bildanalyse und Strategien gegen Overfitting für robuste Deep-Learning-Anwendungen.
Außerdem führt der Artikel Classification in Machine Learning: An Introduction Schritt für Schritt durch das Thema Klassifikation im maschinellen Lernen – was sie ist, wie sie eingesetzt wird und Beispiele für gängige Algorithmen.
Hugging Face bietet ein umfassendes ML-Ökosystem mit leicht bedienbaren Schnittstellen, einem riesigen Fundus an vortrainierten Modellen und sehr guter Dokumentation.
Im Vergleich zu anderen Plattformen hat Hugging Face mehrere Vorteile für Bildklassifikation:
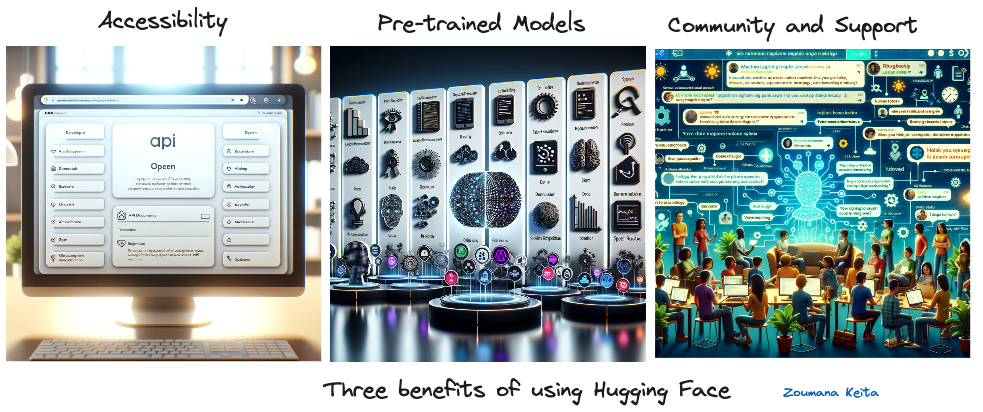
Drei Vorteile von Hugging Face (Bild generiert mit GPT-4)
Zusätzlich erleichtert Hugging Face das Deployment auf großen Cloud-Plattformen wie AWS, Azure und Google Cloud Platform – inklusive verschiedener Inferenz-Optionen.
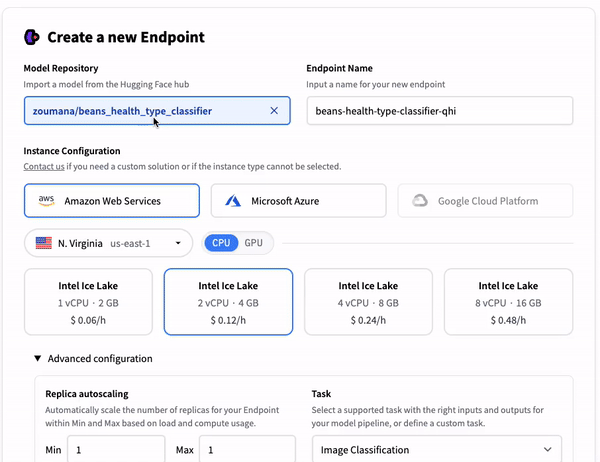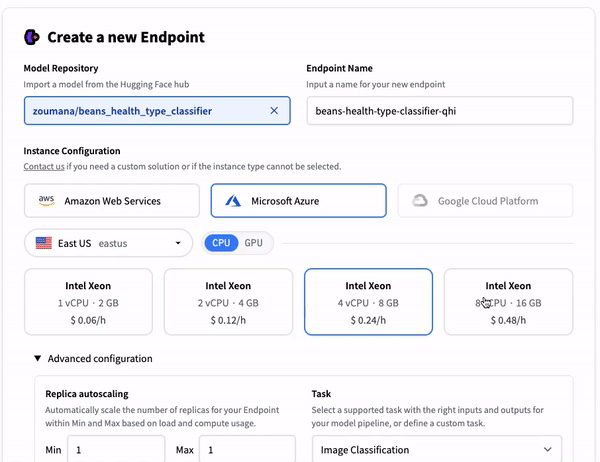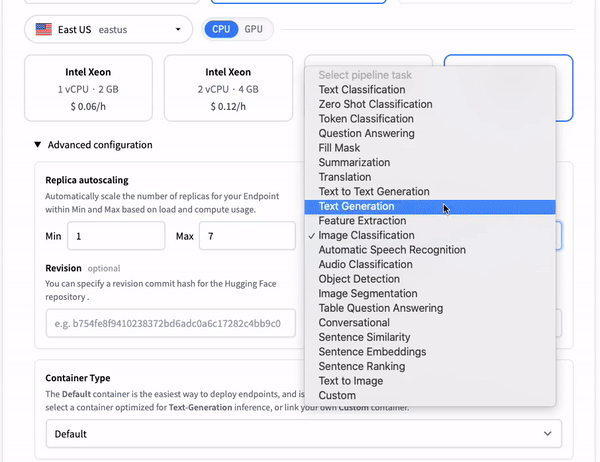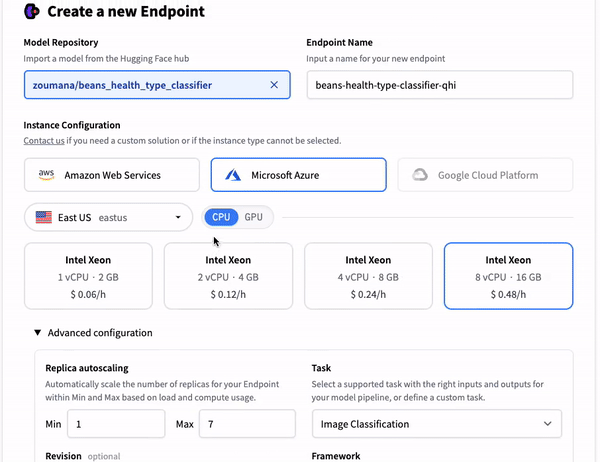
Bereitstellungsoptionen auf Cloud-Plattformen
Die Hauptaufgabe in diesem Artikel ist die Bildklassifikation. Für das Beispiel nutzen wir den Beans-Datensatz von Hugging Face. Nach dem Laden visualisieren wir einige Beispiele und steigen dann in die Vorverarbeitung für das Training ein.
Das Notebook mit dem Code findest du zum Mitmachen in Google Colab.
Die Codes in diesem Artikel sind stark an die offizielle Hugging Face Website angelehnt.
Wir verwenden mehrere Bibliotheken mit jeweils eigener Aufgabe. Einige müssen installiert werden. Die Installation erfolgt mit dem Python-Paketmanager „pip“ wie folgt:
%%bash
pip -q install datasets
pip -q install transformers=='4.29.0'
pip -q install tensorflow=='2.15' # At least this tensorflow version is required to use the "evaluate module"
pip -q install evaluate
pip -q install --upgrade accelerate
Nach der Installation solltest du den Kernel neu starten. Danach können die benötigten Bibliotheken per from und import eingebunden werden:
import torch
import torchvision
import numpy as np
import evaluate
from datasets import load_dataset
from huggingface_hub import notebook_login
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from transformers import DefaultDataCollator
from transformers import AutoImageProcessor
from torchvision.transforms import RandomResizedCrop, Compose, Normalize, ToTensor
from transformers import AutoModelForImageClassification, TrainingArguments, Trainer
import matplotlib.pyplot as pltDas Laden der Daten von Hugging Face ist mit der Funktion load_dataset ganz unkompliziert.
beans_train = load_dataset("beans", split="train")beans ist der Name des verwendeten Datensatzes.train entspricht dem verwendeten Teil des gesamten Datensatzes.Sobald die Daten geladen sind, können wir uns ihre Eigenschaften ansehen, indem wir einfach den Variablennamen ausgeben.
print(beans_train)Das ergibt die folgende Ausgabe:
Dataset({
    features: ['image_file_path', 'image', 'labels'],
    num_rows: 1034
})
Insgesamt gibt es 1034 Bilder, und jedes Bild hat drei Felder:
image_path: Der Pfad zur Bilddatei.image: Ein PIL-Objekt des Bohnenblatts.labels: Das Label des Bildes, eines der folgenden drei:Die folgende Helper-Funktion visualisiert eine bestimmte Anzahl zufällig gewählter Bilder und weist den richtigen Typ zusammen mit den vorhandenen Labels (0, 1, 2) zu.
labels_names = {
   0: "angular_leaf_spot",
   1: "bean_rust",
   2: "healthy",
}

def display_random_images(dataset, num_images=4):

   num_rows = 2
   num_cols = np.ceil(num_images / num_rows).astype(int)

   plt.figure(figsize=(num_cols * 3, num_rows * 3))
   indices = np.random.choice(range(len(dataset)), size=num_images, replace=False)

   for i, idx in enumerate(indices, 1):
       idx = int(idx)
       image = dataset[idx]['image']
       label = dataset[idx]['labels']
       label_name = labels_names.get(label, "Unknown")

       plt.subplot(num_rows, num_cols, i)
       plt.imshow(image)
       plt.title(f"{label_name} ({label})")
       plt.axis('off')

   plt.tight_layout()
   plt.show()
Kurz gesagt: display_random_images wählt eine zufällige Teilmenge von Bildern aus einem Datensatz und zeigt sie als Grid an – jeweils mit Klassenname (z. B. "angular_leaf_spot", "bean_rust", "healthy") und numerischem Label.
Die Funktion ordnet die Bilder dynamisch in zwei Zeilen an und berechnet die nötige Spaltenanzahl, vermeidet Duplikate und ergänzt jeden Eintrag um Namen und numerisches Label.
Sechs Zufallsbilder lassen sich so anzeigen:
display_random_images(beans_train, num_images=6)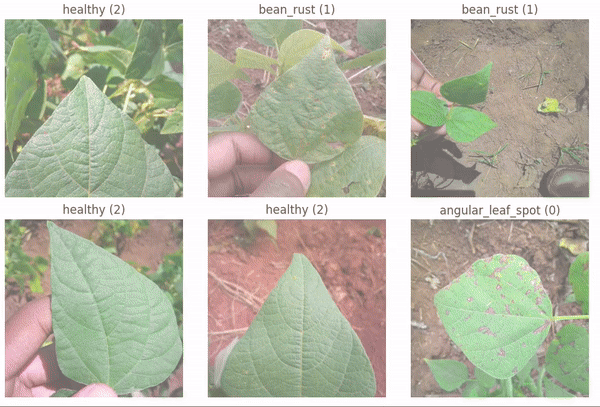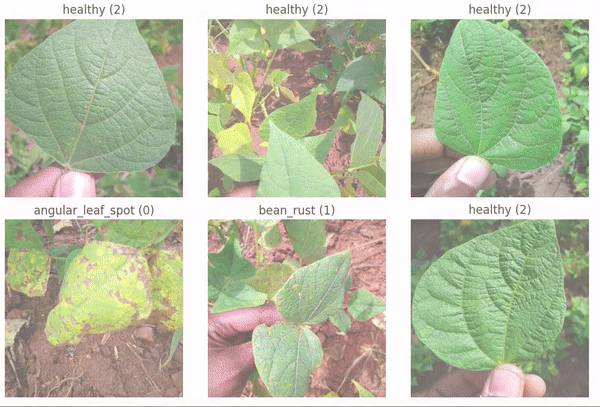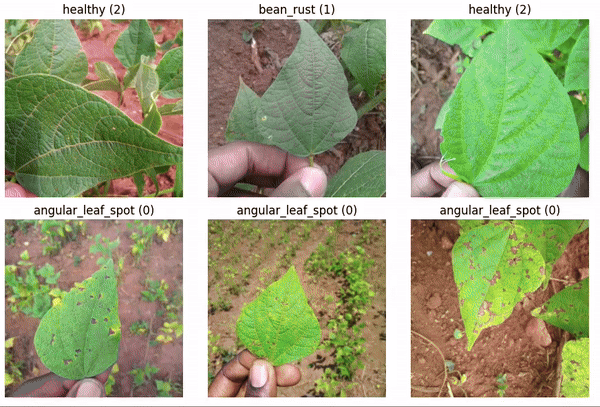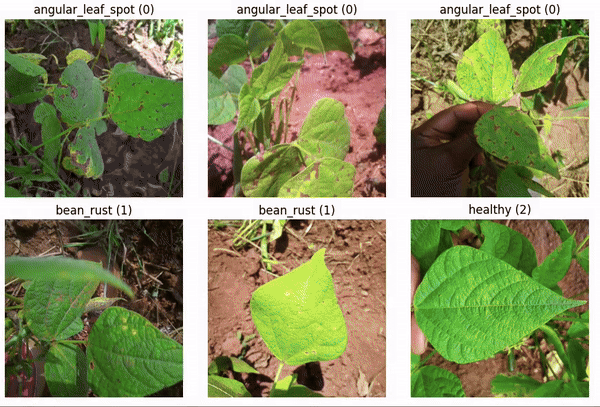
Sechs zufällige Bilder aus dem Datensatz
Bevor wir trainieren, bereiten wir die Daten so auf, dass sie optimal zum Modell passen.
Zunächst teilen wir den ursprünglichen Datensatz in Trainings- (80%) und Validierungsdaten (20%) – mit train_test_split.
beans_train = beans_train.train_test_split(test_size=0.2)Als Nächstes erzeugen wir zwei Dictionaries: label2id und id2label. Damit wandeln wir zwischen sprechenden Labelnamen und numerischen IDs.
Das vereinfacht sowohl das Training als auch die Interpretation der Vorhersagen des finalen Modells.
labels = beans_train["train"].features["labels"].names
label2id, id2label = dict(), dict()

for i, label in enumerate(labels):
   label2id[label] = str(i)
   id2label[str(i)] = label
So sieht die Variable id2label aus:
print(id2label){'0': 'angular_leaf_spot', '1': 'bean_rust', '2': 'healthy'}Für die Klassifikation nutzen wir den vortrainierten Vision Transformer (ViT) von Hugging Face.
Das Modell wurde im Paper An Image is Worth 16x16 words: Transformers for Image Recognition at Scale vorgestellt – die erste erfolgreiche Anwendung der Transformer-Architektur auf Bildklassifikation, trainiert auf ImageNet.
Der folgende Code lädt das vortrainierte Modell, bereitet die Daten passend auf und stellt sicher, dass die Bilder korrekt transformiert werden – bereit für Feintuning und Evaluation.
checkpoint = "google/vit-base-patch16-224-in21k"
image_processor = AutoImageProcessor.from_pretrained(checkpoint)

normalize = Normalize(mean=image_processor.image_mean,
                  	std=image_processor.image_std)

size = (
	image_processor.size["shortest_edge"]
	if "shortest_edge" in image_processor.size
	else (image_processor.size["height"], image_processor.size["width"])
)

_transforms = Compose([RandomResizedCrop(size), ToTensor(), normalize])

def transforms(examples):

	examples["pixel_values"] = [_transforms(img.convert("RGB")) for img in examples["image"]]
	del examples["image"]
	return examples

beans_transformed = beans_train.with_transform(transforms)

data_collator = DefaultDataCollator()
Was passiert hier genau?
google/vit-base-patch16-224-in21k._transforms): zufälliger Zuschnitt, Tensorkonvertierung und Normalisierung.beans_train wird damit transformiert und für das Training vorbereitet.Als Evaluationsmetrik verwenden wir die Accuracy. Diese Helper-Funktion berechnet sie:
accuracy = evaluate.load("accuracy")
def compute_metrics(eval_pred):
   predictions, labels = eval_pred
   predictions = np.argmax(predictions, axis=1)

   return accuracy.compute(predictions=predictions,
references=labels)Bevor das Training startet, definieren wir das eigentliche Modell als Feintuning eines vortrainierten Modells mit .from_pretrained:
model = AutoModelForImageClassification.from_pretrained(
   checkpoint,
   num_labels=len(labels),
   id2label=id2label,
   label2id=label2id,
)Als Nächstes konfigurieren und initialisieren wir die Trainingsumgebung.
Dazu gehören die wichtigsten Hyperparameter für Training, Evaluation und Optimierung.
Vorher melden wir uns mit unseren Hugging Face Zugangsdaten an, die du so abrufen kannst:
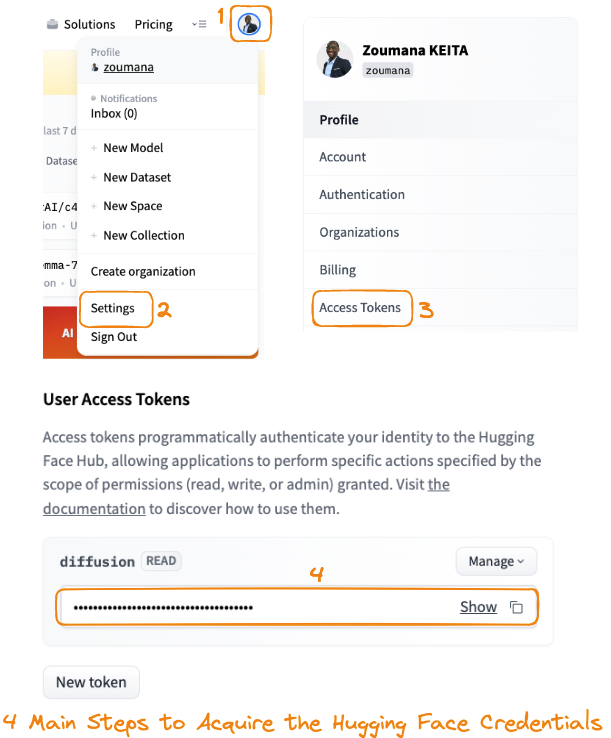
Hauptschritte zum Abrufen der Hugging Face Zugangsdaten
Mit dem Login kannst du dein trainiertes Modell in die Community hochladen und teilen. Die Authentifizierung startest du mit notebook_login.
notebook_login()Wenn du dazu aufgefordert wirst, gib den Verbindungstoken ein, den du in Schritt 4 kopiert hast.
Nach erfolgreichem Login erscheint diese Meldung:
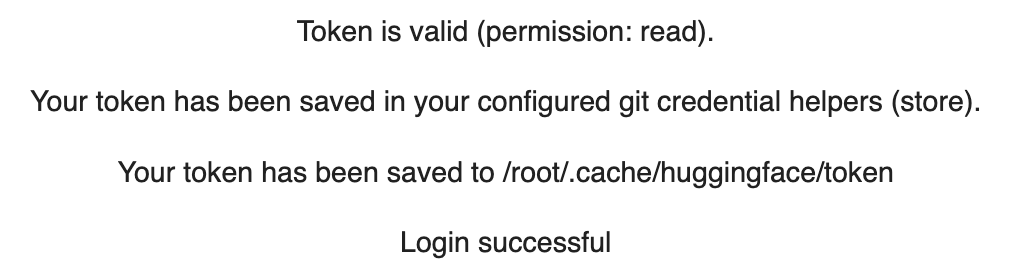
Die Konfiguration und Initialisierung sieht so aus:
training_args = TrainingArguments(
	output_dir="./beans_health_type_classifier",
	remove_unused_columns=False,
	evaluation_strategy="epoch",
	save_strategy="epoch",
	learning_rate=5e-5,
	per_device_train_batch_size=16,
	gradient_accumulation_steps=4,
	per_device_eval_batch_size=16,
	num_train_epochs=3,
	warmup_ratio=0.1,
	logging_steps=10,
	load_best_model_at_end=True,
	metric_for_best_model="accuracy"
)

trainer = Trainer(
	model=model,
	args=training_args,
	data_collator=data_collator,
	train_dataset=beans_transformed["train"],
	eval_dataset=beans_transformed["test"],
	tokenizer=image_processor,
	compute_metrics=compute_metrics,
)
TrainingArguments sind mit Parametern wie Ausgabeverzeichnis, Evaluations- und Speicherstrategie pro Epoche, Lernrate, Batchgröße, Gradientenakkumulation u. a. konfiguriert – für effizientes Training und gute Performance.Trainer-Objekt bündelt Modell, Trainingsargumente, Data Collator, Trainings- und Evaluationsdaten, den Tokenizer (hier: Image Processor) und die Metrikfunktion.Jetzt startet die Trainingsphase mit .train.
trainer.train()Dieses Training ergab folgende Kennzahlen:
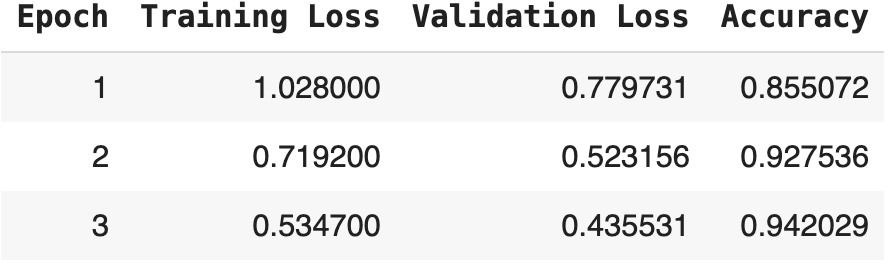
Trainingsergebnis für drei Epochen
Die Tabelle zeigt den Verlauf über drei Epochen mit drei Kernmetriken: Trainingsverlust, Validierungsverlust und Accuracy.
Beim ersten Login im Hugging Face Portal war die Berechtigung Read only. Für das Pushen ins Hub benötigen wir Write-Rechte.
Danach melden wir uns erneut mit notebook_login an – diesmal mit den neuen Berechtigungen.
notebook_login()Das Pushen erfolgt mit push_to_hub so:
trainer.model.push_to_hub("zoumana/beans_health_type_classifier")Damit landet das Modell im Hub, wo du die wichtigsten Eigenschaften siehst.
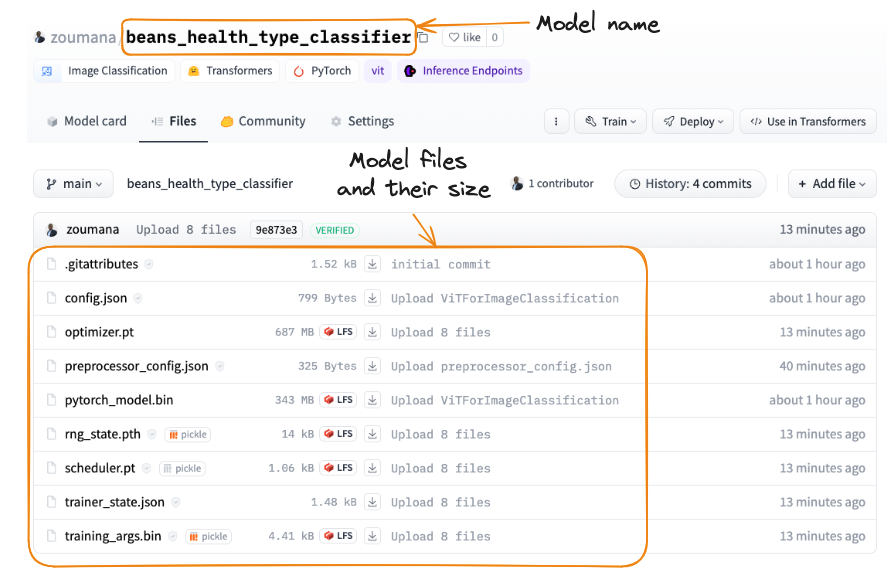
Modell im Hugging Face Hub
Sobald das Modell geteilt ist, kannst du es per REST API in Apps integrieren oder direkt über das Hugging Face Portal nutzen. Entwickler:innen und Forschende können es außerdem mit der Transformers-Bibliothek laden.
Hier sind die drei wichtigsten Nutzungswege.
Im Portal kannst du direkt ein Bild hochladen und dir die Vorhersage anzeigen lassen – wie in der Animation gezeigt.
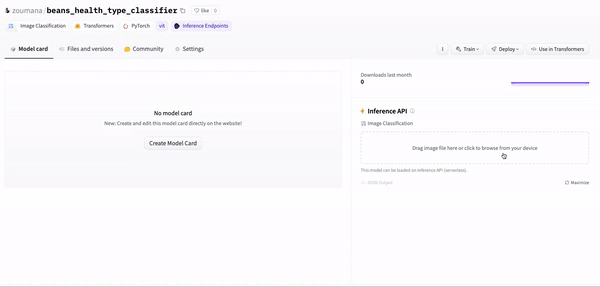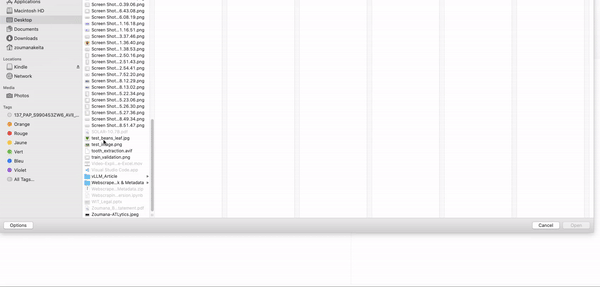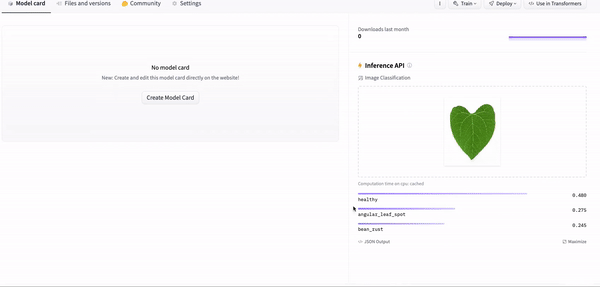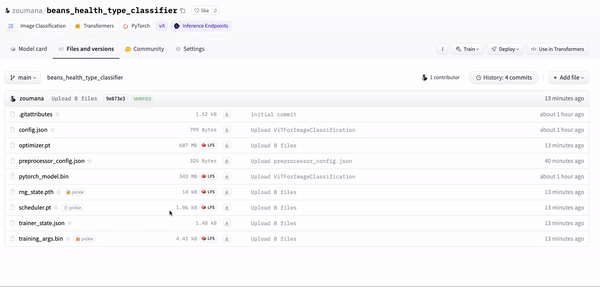
Nutzung über das Hugging Face Portal
Über das Icon „Use in Transformers“ erhältst du automatisch den passenden Beispielcode:
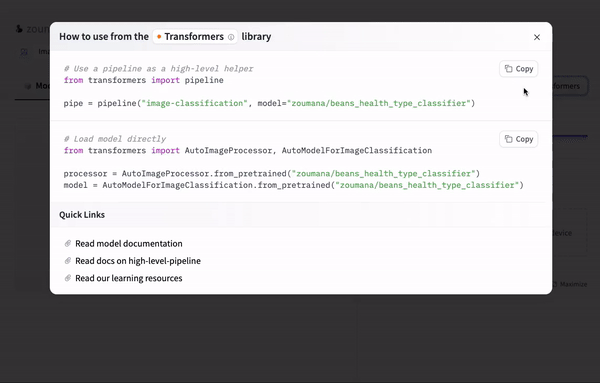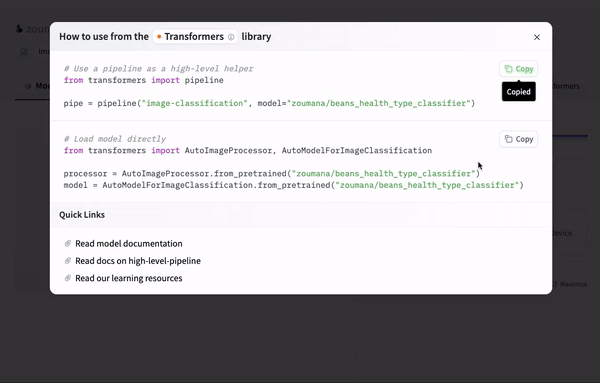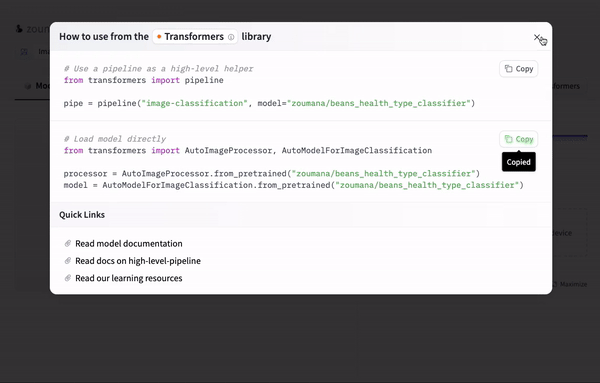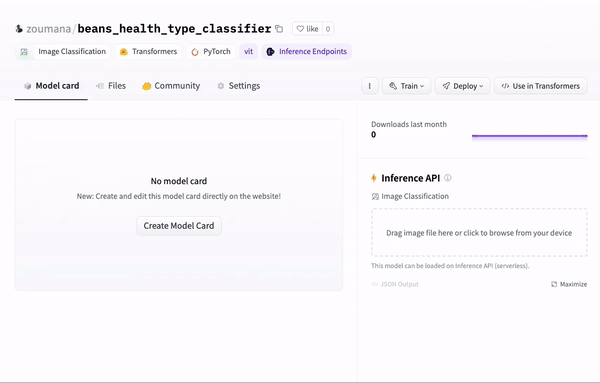
Verwendung mit Transformers
Schließlich kannst du das Modell als REST API nutzen. Den Verbindungsstring bekommst du automatisch im Portal unter „Deploy > Inference API (serverless)“.
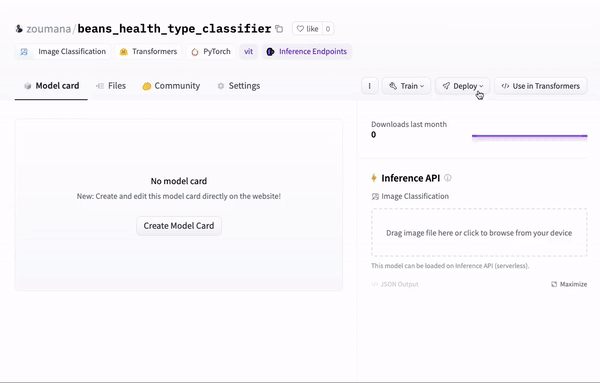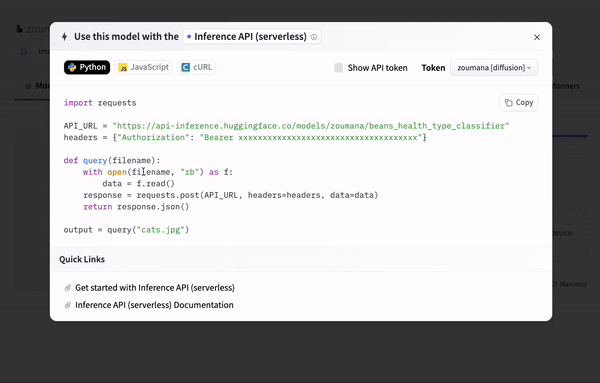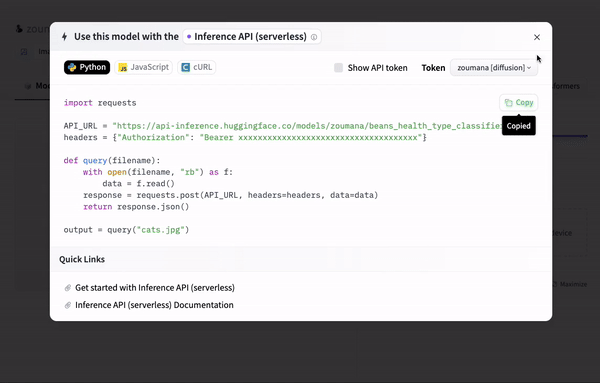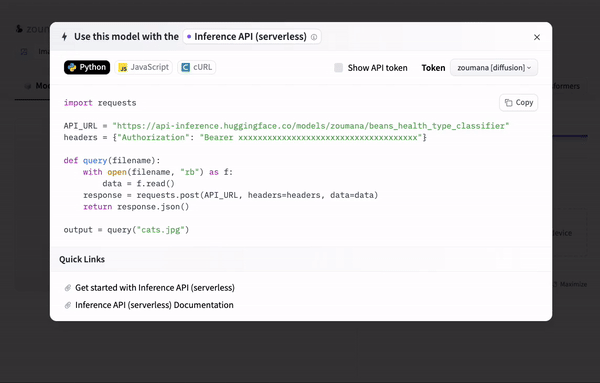
Nutzung eines API-Endpunkts
Der im Clip gezeigte Codeschnipsel ist unten noch einmal aufgeführt. Damit kannst du für ein Bild Vorhersagen anfragen.
Das verwendete Bild ist dasselbe wie im Portal-Beispiel.
Ersetze „xxx“ durch die echten Werte.
import requests

API_URL = "https://api-inference.huggingface.co/models/zoumana/beans_health_type_classifier"
headers = {"Authorization": "Bearer xxxxxxxxxxxxxxxxx"}

def query(filename):
   with open(filename, "rb") as f:
       data = f.read()
   response = requests.post(API_URL, headers=headers, data=data)
   return response.json()
Jetzt holen wir die Antwort des Modells mit der Funktion query.
output = query("./inference_images/test_beans_leaf.jpg")Das Ergebnis ist eine JSON-Antwort wie unten. Das Label mit der höchsten Wahrscheinlichkeit ist die Vorhersage – hier healthy, identisch mit der Ausgabe im Hugging Face Portal.
print(output)[
{'label': 'healthy', 'score': 0.4799719452857971},
{'label': 'angular_leaf_spot', 'score': 0.27489492297172546},
{'label': 'bean_rust', 'score': 0.2451331913471222}
]Dieser Artikel war ein kompletter Leitfaden zur Bildklassifikation mit Hugging Face.
Wir haben mit den Grundlagen begonnen und gezeigt, warum Hugging Face sich durch seine große Modellsammlung und die starke Community besonders eignet.
Dann haben wir erläutert, wie du Trainingsbilder vorbereitest und sicherstellst, dass die Daten die Anforderungen fürs Feintuning erfüllen.
Anschließend sind wir ins Feintuning mit dem passenden vortrainierten Modell eingestiegen und haben drei Wege zur Integration in reale Anwendungen gezeigt.
In KI gibt es immer mehr zu entdecken – jeder Schritt eröffnet neue Möglichkeiten. Wenn du tiefer einsteigen willst, besonders in Bildklassifikation und mehr, empfehlen wir:
Dieser Guide hilft dir, eigene Projekte zur Bildklassifikation mit Hugging Face zu starten – egal ob du Einsteiger, fortgeschritten oder Profi bist.
Starte heute deine KI-Reise!
Kurs
Kurs
Lernpfad