
{count, plural, one {Corso} other {Corsi}}
Lavorare con Hugging Face
{hours} ore
39.4K
Nel campo in rapida evoluzione dell'intelligenza artificiale (AI) e del machine learning (ML), la classificazione di immagini spicca come un compito fondamentale che alimenta un'ampia gamma di applicazioni, dai sistemi di riconoscimento facciale alla diagnostica per immagini mediche.
Tra i tanti strumenti e librerie a disposizione di data scientist e professionisti dell'AI, Hugging Face è un protagonista di primo piano, in particolare per chi lavora con l'elaborazione del linguaggio naturale (NLP) e, sempre più spesso, con compiti di computer vision come la classificazione di immagini.
Questo articolo copre gli elementi essenziali per usare Hugging Face nella classificazione di immagini, compresi i fondamenti della classificazione, la preparazione dei dati, l'addestramento del modello, la distribuzione del modello sull'hub di Hugging Face e, infine, l'interazione con il modello distribuito tramite API e interfaccia di Hugging Face.
Che tu sia alle prime armi o un professionista esperto, questa guida ti darà spunti utili per sfruttare Hugging Face nelle tue attività di classificazione di immagini.
Questa sezione offre una panoramica dei fondamenti della classificazione di immagini e dei vantaggi di usare Hugging Face.
La classificazione di immagini consiste nell'assegnare le immagini a una delle classi predefinite.
Questo compito viene eseguito con algoritmi che analizzano il contenuto visivo di un'immagine e ne prevedono la categoria in base ai pattern appresi dal set di dati di addestramento. I modelli di deep learning, in particolare le reti neurali convoluzionali (CNN), sono diventati l'approccio standard grazie alla loro capacità di catturare pattern rilevanti nei dati di immagine.
Per saperne di più sulle CNN, il nostro articolo Introduzione alle Convolutional Neural Networks (CNN) offre una guida completa per capire le CNN, il loro impatto sull'analisi delle immagini e alcune strategie chiave per contrastare l'overfitting e rendere le CNN più robuste nelle applicazioni di deep learning.
Inoltre, l'articolo Classification in Machine Learning: An Introduction illustra passo passo cos'è la classificazione nel machine learning, come viene usata e alcuni esempi di algoritmi di classificazione.
Hugging Face offre un ecosistema esteso per il machine learning, con interfacce intuitive, un vasto repository di modelli pre-addestrati e una documentazione completa.
Rispetto ad altre piattaforme, Hugging Face offre diversi vantaggi per la classificazione di immagini:
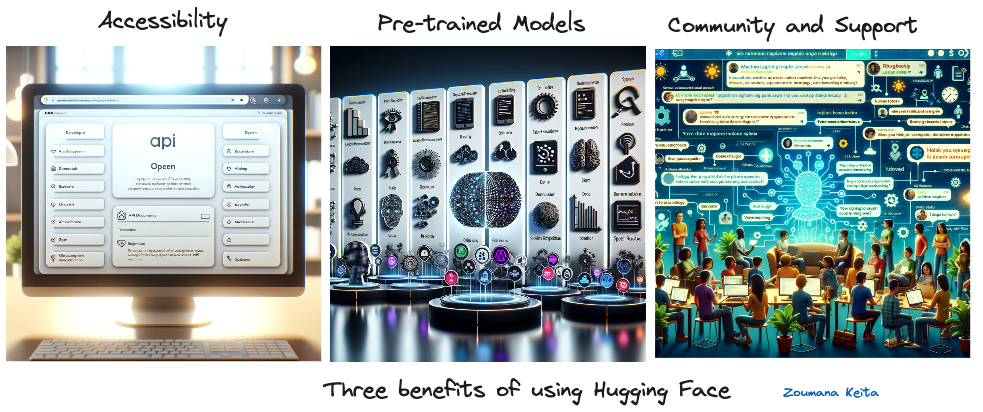
Tre vantaggi dell'uso di Hugging Face (Immagine generata con GPT-4)
Inoltre, Hugging Face facilita la distribuzione dei modelli sulle principali piattaforme cloud come AWS, Azure e Google Cloud Platform, oltre a supportare diversi tipi di inferenza.
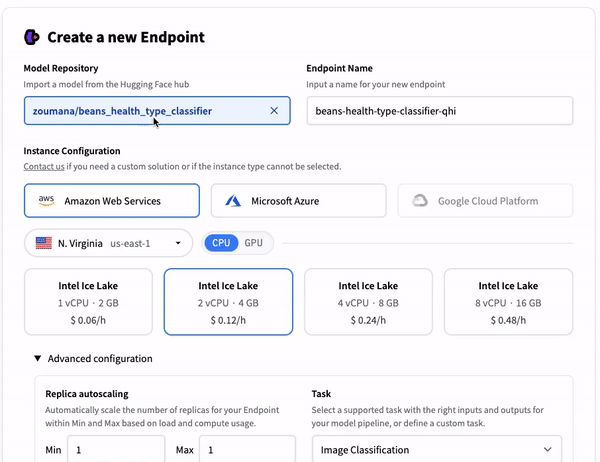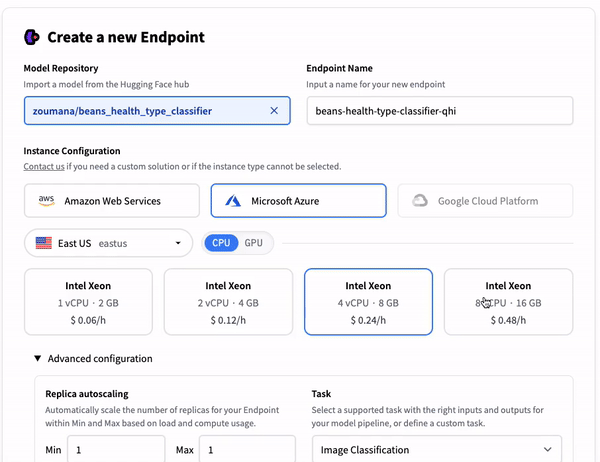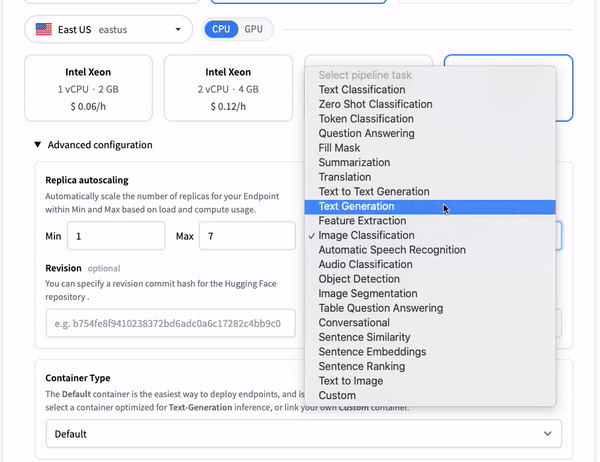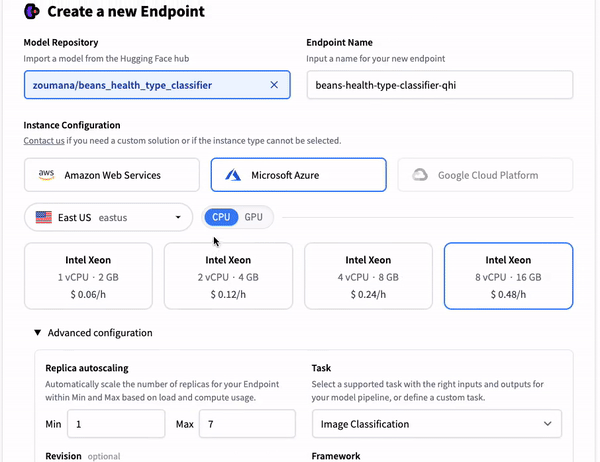
Opzioni di distribuzione dei modelli sulle piattaforme Cloud
Il compito principale trattato in questo articolo è la classificazione di immagini e useremo il set di dati sui fagioli di Hugging Face come esempio. Dopo aver caricato il dataset, eseguiremo alcune visualizzazioni prima di passare al pre-processing per l'addestramento del modello.
Il notebook con il codice è disponibile per seguire passo passo su Google Colab.
I codici di questo articolo sono fortemente ispirati al sito ufficiale di Hugging Face.
In questo articolo vengono usate più librerie, ognuna con un ruolo specifico. Alcune richiedono l'installazione. Queste librerie si installano con il gestore pacchetti di Python "pip" come segue:
%%bash
pip -q install datasets
pip -q install transformers=='4.29.0'
pip -q install tensorflow=='2.15' # At least this tensorflow version is required to use the "evaluate module"
pip -q install evaluate
pip -q install --upgrade accelerate
È importante riavviare il kernel dopo l'installazione delle librerie. Dopo un'installazione riuscita, le librerie necessarie possono essere importate con le istruzioni from e import:
import torch
import torchvision
import numpy as np
import evaluate
from datasets import load_dataset
from huggingface_hub import notebook_login
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from transformers import DefaultDataCollator
from transformers import AutoImageProcessor
from torchvision.transforms import RandomResizedCrop, Compose, Normalize, ToTensor
from transformers import AutoModelForImageClassification, TrainingArguments, Trainer
import matplotlib.pyplot as pltCaricare i dati da Hugging Face è semplice usando la funzione load_dataset .
beans_train = load_dataset("beans", split="train")beans è il nome del dataset utilizzato.train corrisponde alla porzione di dati usata.Una volta caricati i dati, possiamo verificarne le caratteristiche semplicemente stampando il nome della variabile qui sopra.
print(beans_train)Questo mostra il risultato seguente:
Dataset({
    features: ['image_file_path', 'image', 'labels'],
    num_rows: 1034
})
In totale ci sono 1034 immagini e ogni immagine ha tre campi:
image_path: il percorso dell'immagine effettiva.image: un oggetto PIL dell'immagine del fagiolo.labels: l'etichetta dell'immagine, che può essere uno dei seguenti tre tipi:La funzione di supporto seguente semplifica la visualizzazione di un numero specifico di immagini scelte casualmente e assegna il tipo di immagine corretto insieme alle etichette esistenti (0, 1 e 2)
labels_names = {
   0: "angular_leaf_spot",
   1: "bean_rust",
   2: "healthy",
}

def display_random_images(dataset, num_images=4):

   num_rows = 2
   num_cols = np.ceil(num_images / num_rows).astype(int)

   plt.figure(figsize=(num_cols * 3, num_rows * 3))
   indices = np.random.choice(range(len(dataset)), size=num_images, replace=False)

   for i, idx in enumerate(indices, 1):
       idx = int(idx)
       image = dataset[idx]['image']
       label = dataset[idx]['labels']
       label_name = labels_names.get(label, "Unknown")

       plt.subplot(num_rows, num_cols, i)
       plt.imshow(image)
       plt.title(f"{label_name} ({label})")
       plt.axis('off')

   plt.tight_layout()
   plt.show()
In poche parole, questa funzione, display_random_images, seleziona un sottoinsieme casuale di immagini da un dataset e le mostra in una griglia, con ogni immagine etichettata in base alla sua classe (ad es. "angular_leaf_spot", "bean_rust", "healthy").
Dispone dinamicamente le immagini su due righe e calcola il numero di colonne necessario in base al totale di immagini da mostrare, evitando duplicazioni e affiancando a ciascuna il relativo nome e numero di etichetta.
Possiamo quindi visualizzare sei immagini casuali usando la funzione come segue:
display_random_images(beans_train, num_images=6)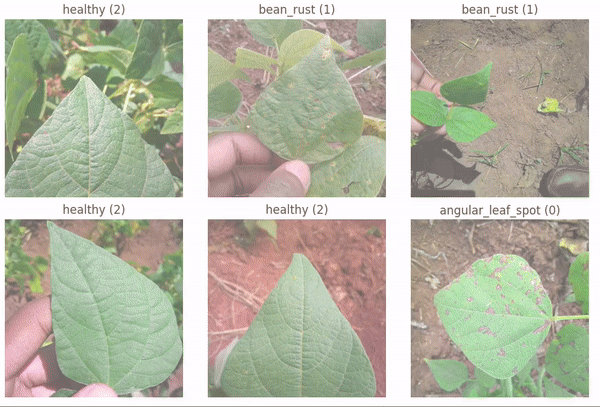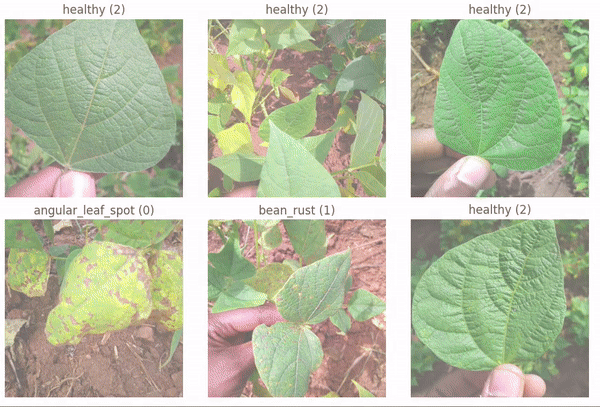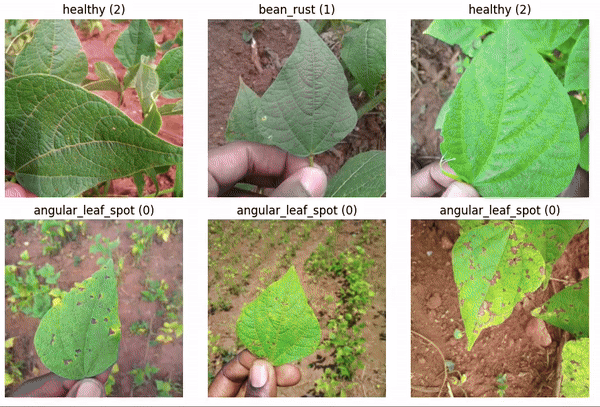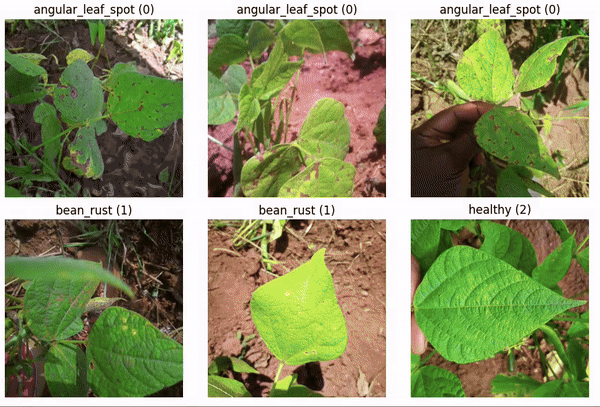
Sei immagini casuali dal dataset
Prima di addestrare il modello, è importante eseguire un pre-processing adeguato per rendere i dati adatti al modello.
Per prima cosa, il dataset originale viene suddiviso in dati di addestramento e validazione, rispettivamente 80% e 20%, utilizzando la funzione train_test_split .
beans_train = beans_train.train_test_split(test_size=0.2)Successivamente, vengono creati due dizionari: label2id e id2label. Questo è fondamentale per convertire tra nomi di etichette leggibili dalle persone e identificatori numerici comprensibili dalla macchina.
Questo processo facilita sia l'addestramento sia l'interpretazione delle previsioni finali del modello.
labels = beans_train["train"].features["labels"].names
label2id, id2label = dict(), dict()

for i, label in enumerate(labels):
   label2id[label] = str(i)
   id2label[str(i)] = label
Di seguito è riportato il risultato della variabile id2label:
print(id2label){'0': 'angular_leaf_spot', '1': 'bean_rust', '2': 'healthy'}Il nostro classificatore sfrutta il modello pre-addestrato Vision Transformer (ViT) di Hugging Face.
Questo modello è stato introdotto nell'articolo An Image is Worth 16x16 words: Transformers for Image Recognition at Scale ed è la prima applicazione di successo dell'architettura transformer al riconoscimento di immagini, addestrata sul dataset ImageNet.
Il codice seguente spiega tutti i passaggi per caricare il modello pre-addestrato, pre-processare i dati per soddisfare i requisiti del modello e le fasi intermedie per assicurare che le immagini siano correttamente elaborate e pronte per essere fornite al modello per il fine-tuning e la valutazione.
checkpoint = "google/vit-base-patch16-224-in21k"
image_processor = AutoImageProcessor.from_pretrained(checkpoint)

normalize = Normalize(mean=image_processor.image_mean,
                  	std=image_processor.image_std)

size = (
	image_processor.size["shortest_edge"]
	if "shortest_edge" in image_processor.size
	else (image_processor.size["height"], image_processor.size["width"])
)

_transforms = Compose([RandomResizedCrop(size), ToTensor(), normalize])

def transforms(examples):

	examples["pixel_values"] = [_transforms(img.convert("RGB")) for img in examples["image"]]
	del examples["image"]
	return examples

beans_transformed = beans_train.with_transform(transforms)

data_collator = DefaultDataCollator()
Vediamo cosa succede nel codice qui sopra:
google/vit-base-patch16-224-in21k._transforms) che includono crop casuale, conversione a tensore e normalizzazione.beans_train viene trasformato con la funzione di trasformazione, preparandolo all'addestramento del modello.Dopo queste impostazioni, la metrica di valutazione usata per misurare le prestazioni del modello è l'accuracy, implementata con la seguente funzione di supporto.
accuracy = evaluate.load("accuracy")
def compute_metrics(eval_pred):
   predictions, labels = eval_pred
   predictions = np.argmax(predictions, axis=1)

   return accuracy.compute(predictions=predictions,
references=labels)Prima del processo di training, si definisce il modello vero e proprio sfruttando il pre-addestrato con la funzione .from_pretrained come segue
model = AutoModelForImageClassification.from_pretrained(
   checkpoint,
   num_labels=len(labels),
   id2label=id2label,
   label2id=label2id,
)Il passo successivo è configurare e inizializzare l'ambiente di training del modello.
La configurazione include la definizione degli iperparametri necessari relativi a training, valutazione e ottimizzazione.
Ma prima dobbiamo accedere al nostro account Hugging Face usando le credenziali dell'account, che si possono ottenere come segue:
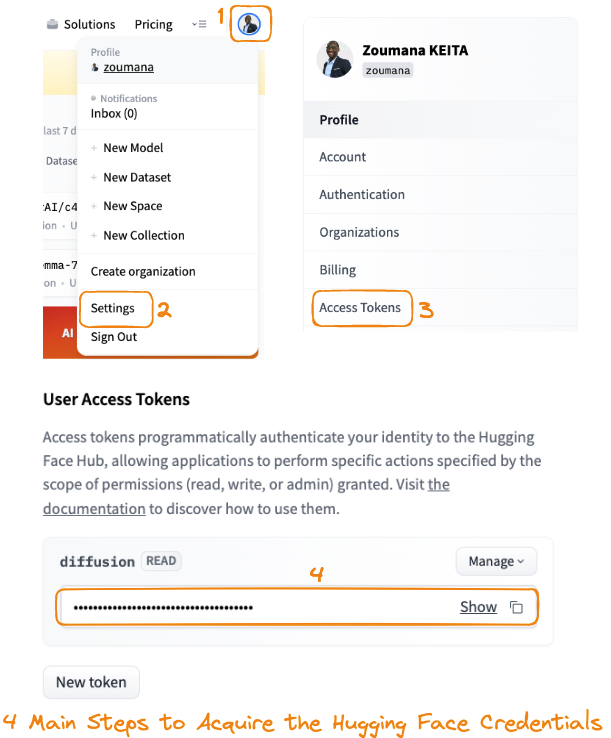
Passaggi principali per ottenere le credenziali Hugging Face
Accedendo al nostro account Hugging Face, possiamo caricare e condividere con la community i modelli addestrati. Successivamente, si avvia il processo di autenticazione usando la funzione notebook_login.
notebook_login()Quando richiesto, fornisci il token di connessione, copiato al passaggio 4 della guida sopra.
Dopo un login riuscito, dovrebbe essere visualizzato il seguente messaggio:
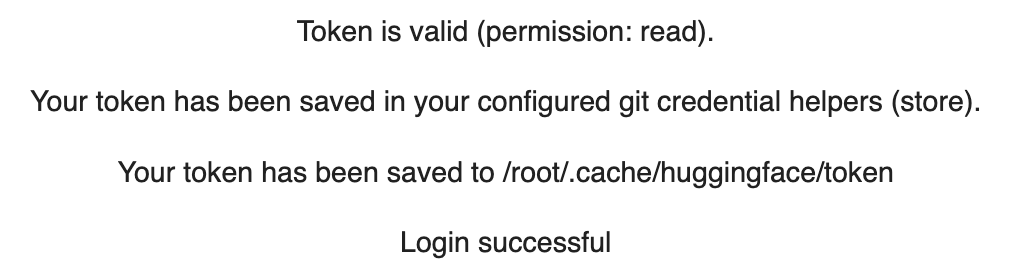
Il codice di configurazione e inizializzazione è riportato di seguito:
training_args = TrainingArguments(
	output_dir="./beans_health_type_classifier",
	remove_unused_columns=False,
	evaluation_strategy="epoch",
	save_strategy="epoch",
	learning_rate=5e-5,
	per_device_train_batch_size=16,
	gradient_accumulation_steps=4,
	per_device_eval_batch_size=16,
	num_train_epochs=3,
	warmup_ratio=0.1,
	logging_steps=10,
	load_best_model_at_end=True,
	metric_for_best_model="accuracy"
)

trainer = Trainer(
	model=model,
	args=training_args,
	data_collator=data_collator,
	train_dataset=beans_transformed["train"],
	eval_dataset=beans_transformed["test"],
	tokenizer=image_processor,
	compute_metrics=compute_metrics,
)
TrainingArguments sono configurati con parametri specifici come la directory di output, la strategia di valutazione e salvataggio per epoca, il learning rate, le dimensioni dei batch, i passi di accumulo dei gradienti e altre impostazioni pensate per ottimizzare training e prestazioni del modello.Trainer viene inizializzato con il modello definito, gli argomenti di training, il data collator per il batching, i dataset di training e valutazione, un tokenizer (in questo caso l'image processor) per il pre-processing e una funzione per calcolare le metriche di valutazione.Arriva ora la fase di training, che si esegue con la funzione .train.
trainer.train()Questo specifico training ha prodotto le seguenti metriche:
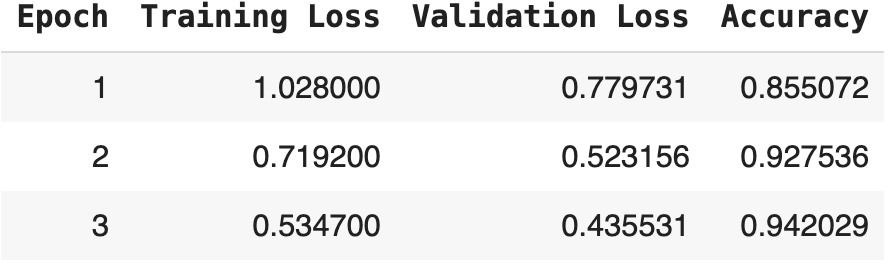
Risultato del training del modello per tre epoche
Si vede che la tabella mostra l'andamento dell'addestramento su tre epoche sul tuo dataset di fagioli, con tre metriche chiave: training loss, validation loss e accuracy.
Alla prima autenticazione sul portale Hugging Face, la modalità di connessione era solo Read. Tuttavia, servono credenziali di scrittura per poter inviare il nostro modello all'hub di Hugging Face.
Dopodiché, dobbiamo accedere di nuovo usando la funzione notebook_login con le nuove credenziali create.
notebook_login()L'invio del modello si esegue con la funzione push_to_hub come segue:
trainer.model.push_to_hub("zoumana/beans_health_type_classifier")Questo caricherà il modello sull'hub e potremo vederne le proprietà principali.
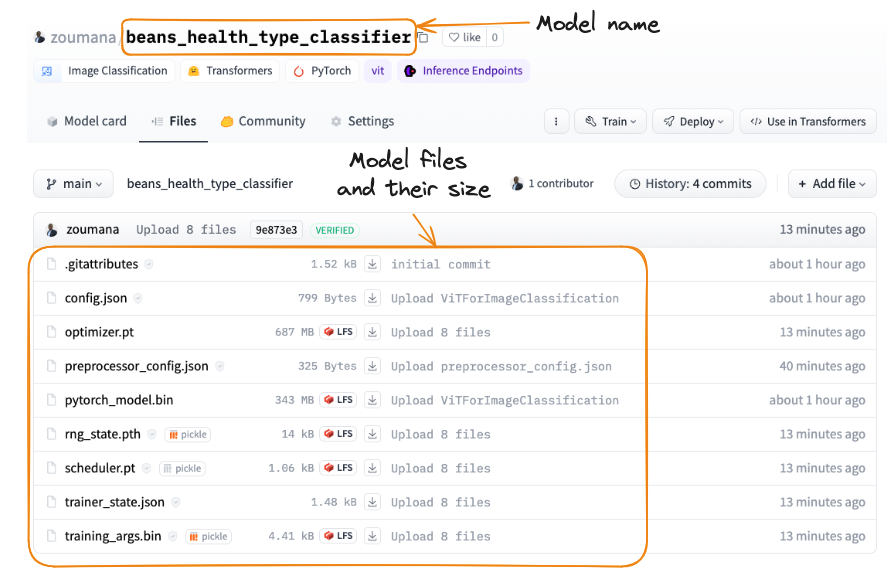
Modello caricato su Hugging Face
Una volta condiviso, il modello può essere integrato nelle applicazioni tramite REST API, oppure gli utenti possono integrarlo direttamente dal portale Hugging Face. Sviluppatori e ricercatori possono anche usarlo caricandolo con la libreria Transformers.
In questa sezione, vediamo tre modi principali per usare il modello.
Sul portale, gli utenti possono caricare direttamente un'immagine e ottenere le previsioni del modello, come illustrato nell'animazione seguente.
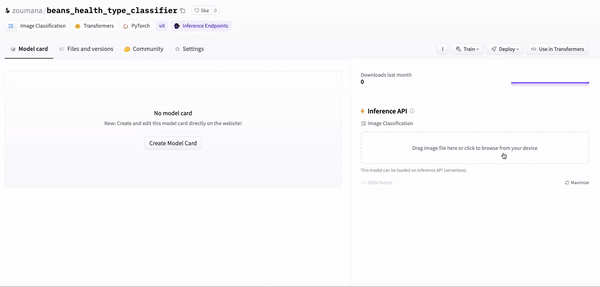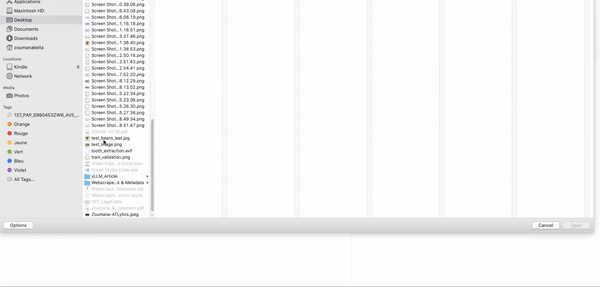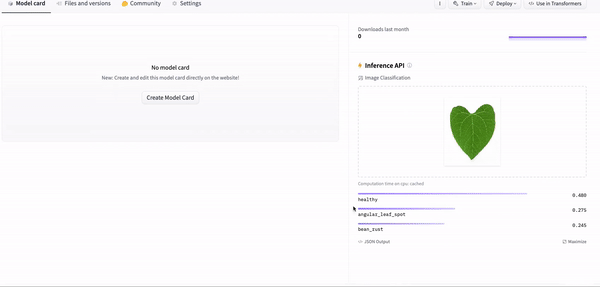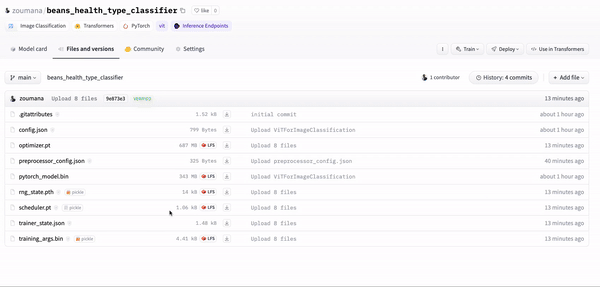
Uso del modello dal portale Hugging Face
Selezionando l'icona "Use in Transformers", viene fornito automaticamente il codice per usare il modello come segue:
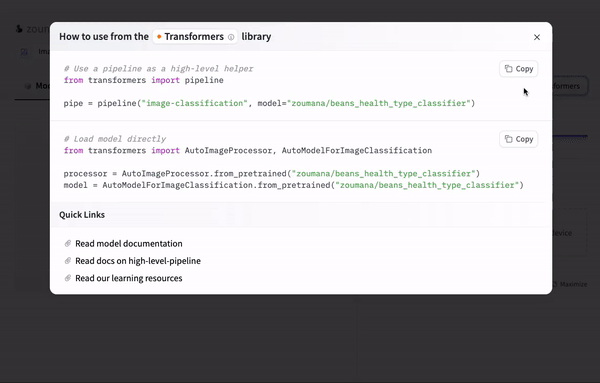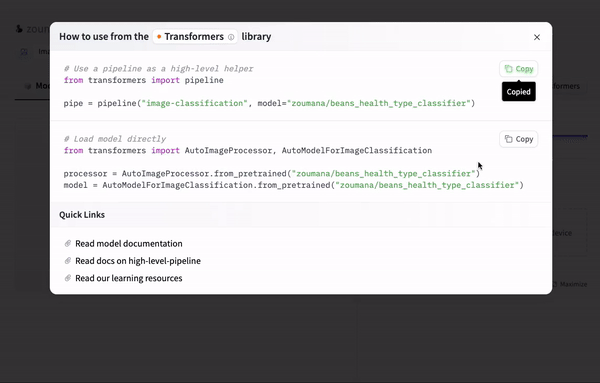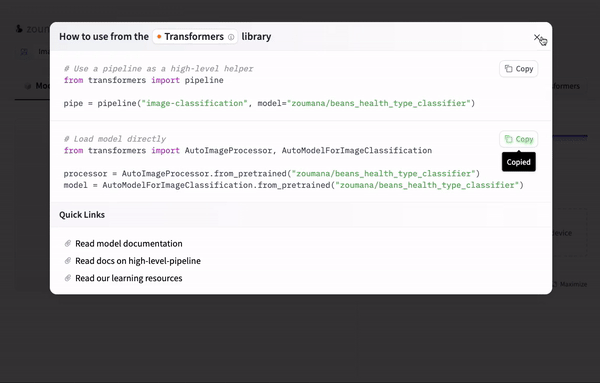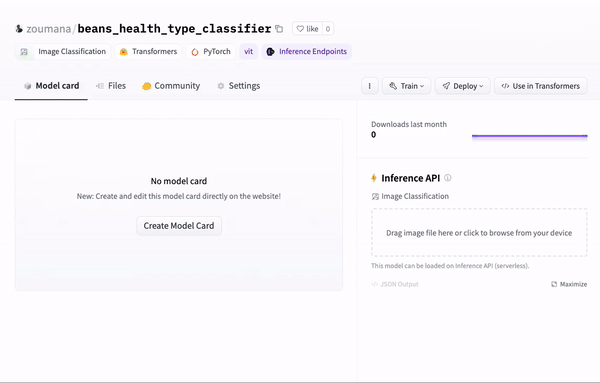
Uso del modello con Transformers
Infine, possiamo usare il modello come REST API utilizzando la stringa di connessione fornita automaticamente dal portale dopo aver cliccato l'icona "Deploy > Inference API (serverless)".
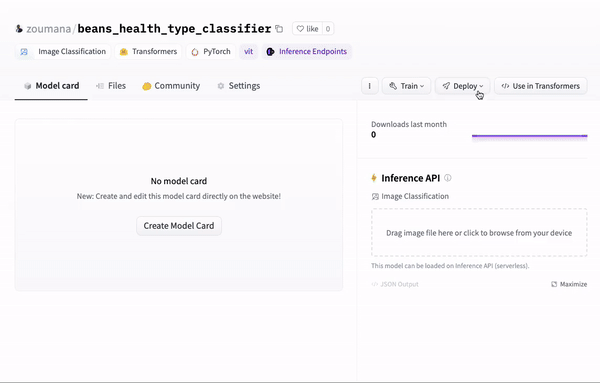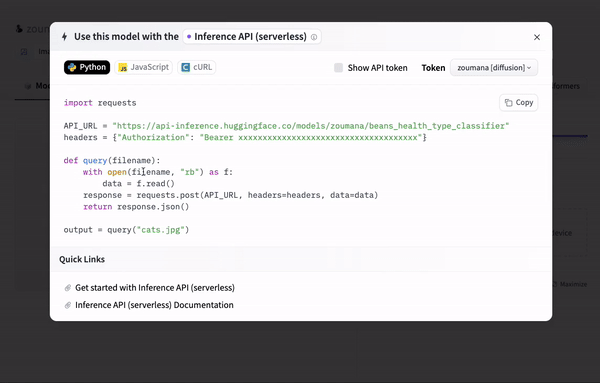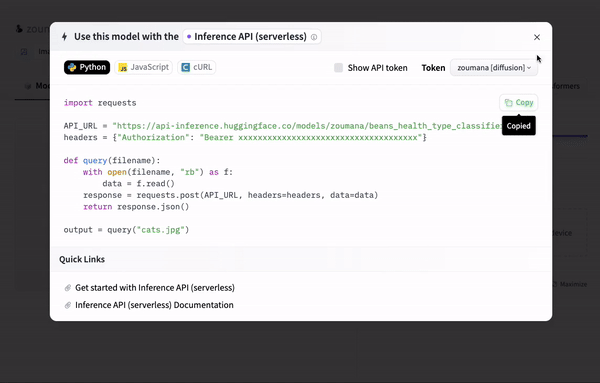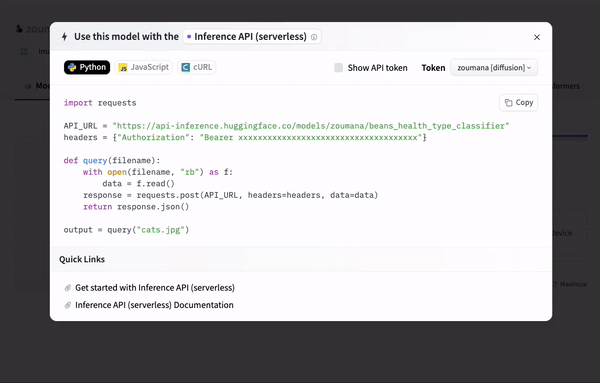
Uso di un endpoint API
Lo snippet di codice mostrato nell'animazione precedente è lo stesso riportato sotto e può essere usato per fare previsioni su una data immagine.
L'immagine utilizzata è la stessa mostrata nell'illustrazione dal portale Hugging Face.
Assicurati di sostituire le "xxx" con i valori effettivi.
import requests

API_URL = "https://api-inference.huggingface.co/models/zoumana/beans_health_type_classifier"
headers = {"Authorization": "Bearer xxxxxxxxxxxxxxxxx"}

def query(filename):
   with open(filename, "rb") as f:
       data = f.read()
   response = requests.post(API_URL, headers=headers, data=data)
   return response.json()
Poi otteniamo la risposta del modello usando la precedente funzione query.
output = query("./inference_images/test_beans_leaf.jpg")Il risultato finale è una risposta JSON, come mostrato sotto. Si vede che l'etichetta prevista è quella con la probabilità più alta e, in questo caso, è healthy, esattamente la stessa previsione dal portale Hugging Face.
print(output)[
{'label': 'healthy', 'score': 0.4799719452857971},
{'label': 'angular_leaf_spot', 'score': 0.27489492297172546},
{'label': 'bean_rust', 'score': 0.2451331913471222}
]Questo articolo ha fornito una guida completa su come svolgere compiti di classificazione di immagini con Hugging Face.
Siamo partiti dalle basi della classificazione di immagini e abbiamo spiegato perché Hugging Face è un ottimo strumento per questo lavoro, grazie alla sua vasta collezione di modelli e alla community di supporto.
Abbiamo poi visto come preparare le immagini per il training, incluso come assicurarsi che i dati soddisfino i requisiti per il fine-tuning.
Inoltre, abbiamo approfondito come eseguire il fine-tuning di un modello con Hugging Face, scegliendo il giusto modello pre-addestrato. Abbiamo anche discusso come integrare il modello addestrato in applicazioni reali usando tre principali strategie di integrazione.
Nel mondo dell'AI c'è sempre altro da imparare ed esplorare, e ogni passo apre nuove possibilità. Quindi, per chi vuole approfondire AI e machine learning, in particolare la classificazione di immagini e oltre, ecco alcune ottime risorse da consultare:
Questa guida è pensata per aiutare chiunque a iniziare i propri progetti con Hugging Face per la classificazione di immagini, che sia principiante, intermedio o avanzato.
Inizia oggi il tuo percorso nell'AI!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



