Curso
Trabalhando com Hugging Face
2 h
38.2K
No campo em rápida evolução da inteligência artificial (IA) e do aprendizado de máquina (ML), a classificação de imagens se destaca como uma tarefa fundamental que impulsiona uma ampla variedade de aplicações, de sistemas de reconhecimento facial a diagnósticos por imagem na área médica.
Entre as diversas ferramentas e bibliotecas disponíveis para cientistas de dados e profissionais de IA, o Hugging Face vem ganhando protagonismo, especialmente para quem trabalha com processamento de linguagem natural (NLP) e, cada vez mais, com tarefas de visão computacional como a classificação de imagens.
Este artigo cobre o essencial de como usar o Hugging Face para classificação de imagens, incluindo os conceitos básicos, como preparar seus dados, treinar o modelo, fazer a implantação no Hub do Hugging Face e, por fim, como interagir com o modelo implantado pela API e pela interface do Hugging Face.
Seja você iniciante ou já experiente, este guia traz insights valiosos para aproveitar o Hugging Face nas suas necessidades de classificação de imagens.
Nesta seção, você encontra os conceitos básicos de classificação de imagens e os benefícios de usar o Hugging Face.
Classificação de imagens é o processo de categorizar imagens em uma entre várias classes predefinidas.
Essa tarefa é realizada por algoritmos que analisam o conteúdo visual de uma imagem e predizem sua categoria com base em padrões aprendidos no conjunto de treinamento. Modelos de deep learning, em especial as redes neurais convolucionais (CNNs), tornaram-se o padrão para essa tarefa pela capacidade de capturar padrões relevantes em dados de imagem.
Para saber mais sobre CNNs, nosso artigo An Introduction to Convolutional Neural Networks (CNNs) traz um guia completo para entender CNNs, seu impacto na análise de imagens e estratégias-chave para combater overfitting e obter CNNs robustas em aplicações de deep learning.
Além disso, o artigo Classification in Machine Learning: An Introduction apresenta passo a passo o que é classificação em machine learning, como é usada e exemplos de algoritmos de classificação.
O Hugging Face oferece um ecossistema completo para machine learning, com interfaces fáceis de usar, um vasto repositório de modelos pré-treinados e documentação abrangente.
Em comparação com outras plataformas, o Hugging Face traz várias vantagens para classificação de imagens:
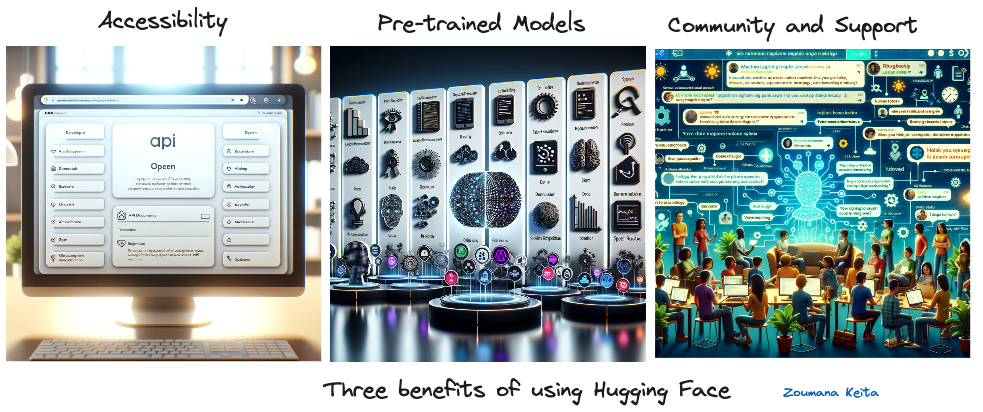
Três benefícios de usar o Hugging Face (imagem gerada com GPT-4)
Além disso, o Hugging Face facilita a implantação de modelos nos principais provedores de nuvem como AWS, Azure e Google Cloud Platform, com múltiplos tipos de inferência.
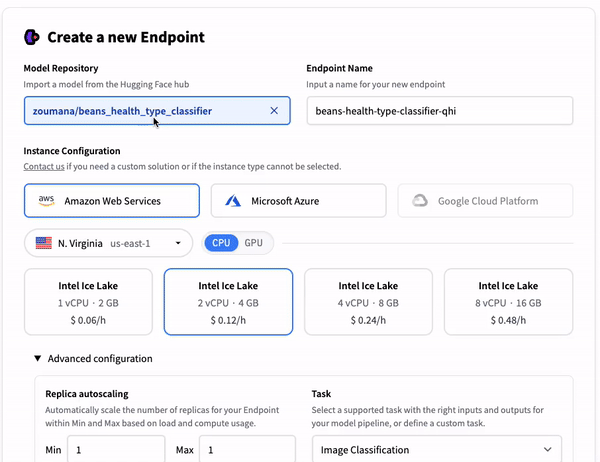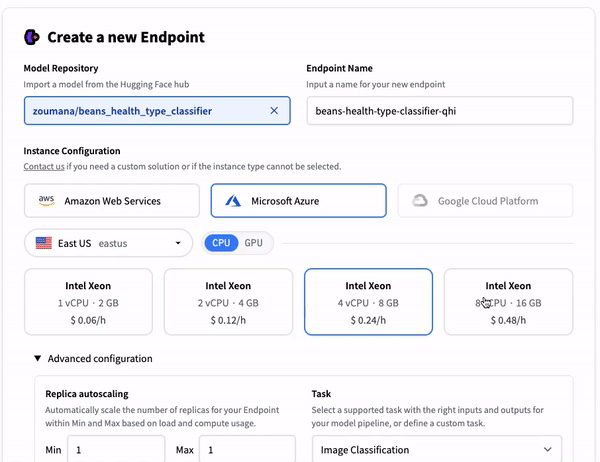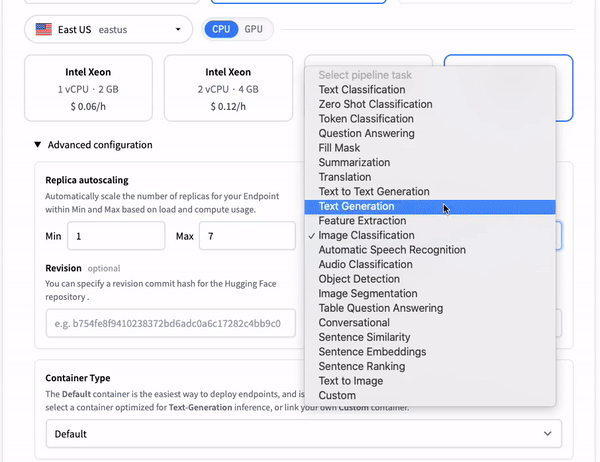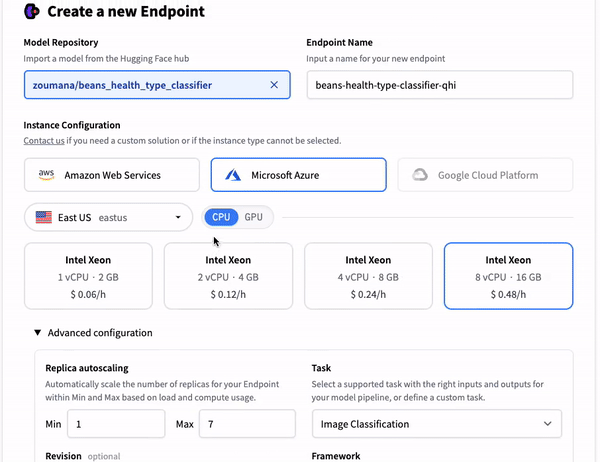
Opções de implantação de modelos em plataformas de nuvem
A tarefa principal abordada neste artigo é a classificação de imagens, e vamos usar o conjunto de dados de beans do Hugging Face no nosso exemplo. Depois de carregar o dataset, faremos algumas visualizações antes de entrar no pré-processamento para o treinamento do modelo.
O notebook com o código está disponível para acompanhamento no Google Colab.
Os códigos deste artigo se inspiram fortemente no site oficial do Hugging Face.
Diversas bibliotecas são usadas ao longo deste artigo, cada uma com um papel específico. Algumas precisam ser instaladas. Essas bibliotecas são instaladas com o gerenciador de pacotes do Python, o “pip”, assim:
%%bash
pip -q install datasets
pip -q install transformers=='4.29.0'
pip -q install tensorflow=='2.15' # At least this tensorflow version is required to use the "evaluate module"
pip -q install evaluate
pip -q install --upgrade accelerate
É importante reiniciar o kernel após instalar as bibliotecas. Com a instalação concluída, você pode importar as bibliotecas necessárias com as instruções from e import:
import torch
import torchvision
import numpy as np
import evaluate
from datasets import load_dataset
from huggingface_hub import notebook_login
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from transformers import DefaultDataCollator
from transformers import AutoImageProcessor
from torchvision.transforms import RandomResizedCrop, Compose, Normalize, ToTensor
from transformers import AutoModelForImageClassification, TrainingArguments, Trainer
import matplotlib.pyplot as pltCarregar os dados do Hugging Face é simples usando a função load_dataset.
beans_train = load_dataset("beans", split="train")beans é o nome do dataset usado.train corresponde ao subconjunto do conjunto completo de dados.Depois que os dados são carregados, podemos verificar suas características apenas imprimindo o nome da variável acima.
print(beans_train)Isso retorna o seguinte resultado:
Dataset({
    features: ['image_file_path', 'image', 'labels'],
    num_rows: 1034
})
Há um total de 1034 imagens, e cada imagem possui três campos:
image_path: o caminho para a imagem.image: um objeto PIL da imagem do feijão.labels: o rótulo da imagem, que pode ser um dos três tipos a seguir:A função auxiliar abaixo facilita a visualização de um número específico de imagens escolhidas aleatoriamente e exibe o tipo correto de imagem junto com os rótulos existentes (0, 1 e 2)
labels_names = {
   0: "angular_leaf_spot",
   1: "bean_rust",
   2: "healthy",
}

def display_random_images(dataset, num_images=4):

   num_rows = 2
   num_cols = np.ceil(num_images / num_rows).astype(int)

   plt.figure(figsize=(num_cols * 3, num_rows * 3))
   indices = np.random.choice(range(len(dataset)), size=num_images, replace=False)

   for i, idx in enumerate(indices, 1):
       idx = int(idx)
       image = dataset[idx]['image']
       label = dataset[idx]['labels']
       label_name = labels_names.get(label, "Unknown")

       plt.subplot(num_rows, num_cols, i)
       plt.imshow(image)
       plt.title(f"{label_name} ({label})")
       plt.axis('off')

   plt.tight_layout()
   plt.show()
Em resumo, essa função, display_random_images, seleciona um subconjunto aleatório de imagens de um dataset e as exibe em uma grade, com cada imagem rotulada conforme sua classe (por exemplo, "angular_leaf_spot", "bean_rust", "healthy").
Ela organiza dinamicamente as imagens em duas linhas e calcula o número necessário de colunas com base no total de imagens a exibir, garantindo que não haja duplicação e que cada uma traga o nome e o índice numérico do rótulo correspondente.
Podemos então exibir seis imagens aleatórias usando a função assim:
display_random_images(beans_train, num_images=6)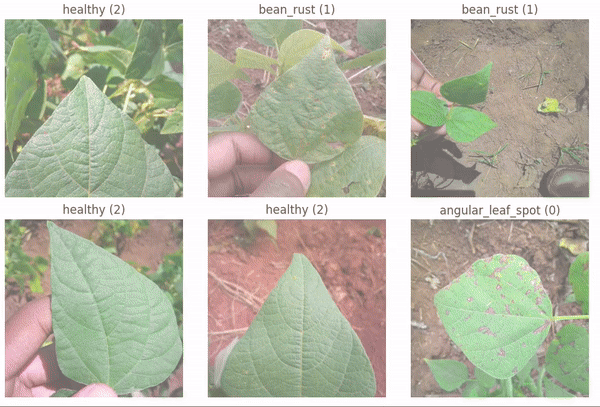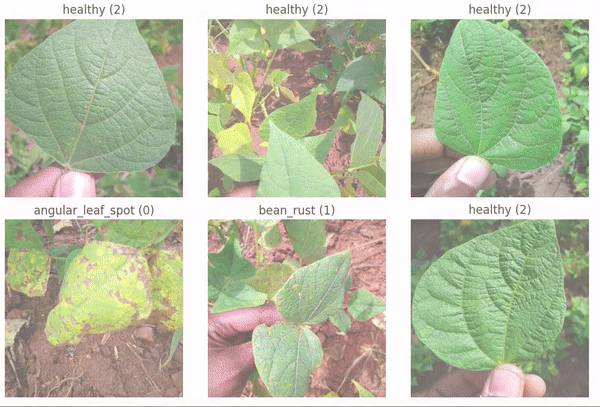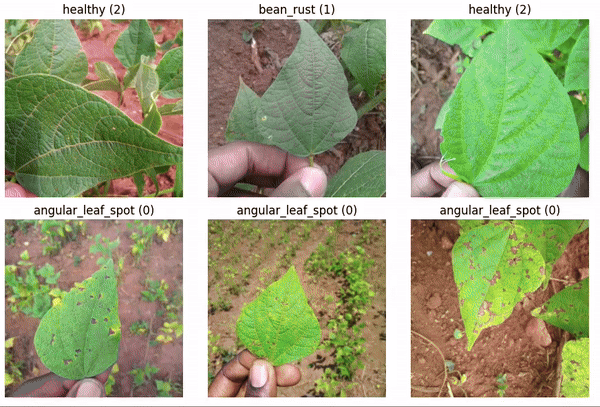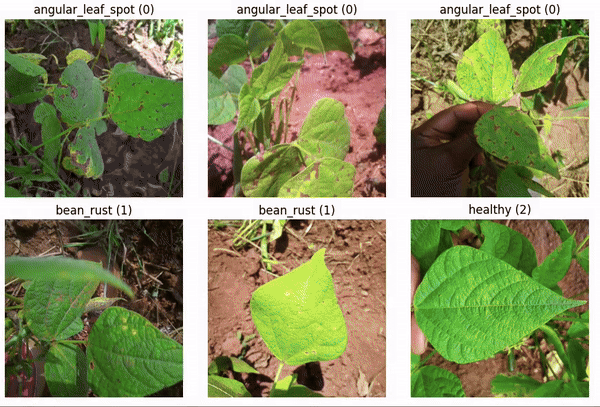
Seis imagens aleatórias do dataset
Antes de treinar o modelo, é importante realizar um pré-processamento adequado para tornar os dados compatíveis com o modelo.
Primeiro, o dataset original é dividido em dados de treino e validação, respectivamente 80% e 20%, usando a função train_test_split.
beans_train = beans_train.train_test_split(test_size=0.2)Em seguida, criamos dois dicionários: label2id e id2label. Isso é fundamental para converter entre nomes de rótulos legíveis por humanos e identificadores numéricos compreendidos pela máquina.
Esse processo facilita tanto o treinamento quanto a interpretação das previsões do modelo final.
labels = beans_train["train"].features["labels"].names
label2id, id2label = dict(), dict()

for i, label in enumerate(labels):
   label2id[label] = str(i)
   id2label[str(i)] = label
Abaixo está o resultado da variável id2label:
print(id2label){'0': 'angular_leaf_spot', '1': 'bean_rust', '2': 'healthy'}Nosso classificador aproveita o modelo pré-treinado Vision Transformer (ViT) do Hugging Face.
Esse modelo foi apresentado no artigo An Image is Worth 16x16 words: Transformers for Image Recognition at Scale e marca a primeira aplicação bem-sucedida da arquitetura transformer em reconhecimento de imagens, treinado no dataset ImageNet.
O código a seguir mostra todas as etapas para carregar o modelo pré-treinado, pré-processar os dados para atender aos requisitos do modelo e os passos intermediários para garantir que as imagens sejam processadas corretamente e estejam prontas para fine-tuning e avaliação.
checkpoint = "google/vit-base-patch16-224-in21k"
image_processor = AutoImageProcessor.from_pretrained(checkpoint)

normalize = Normalize(mean=image_processor.image_mean,
                  	std=image_processor.image_std)

size = (
	image_processor.size["shortest_edge"]
	if "shortest_edge" in image_processor.size
	else (image_processor.size["height"], image_processor.size["width"])
)

_transforms = Compose([RandomResizedCrop(size), ToTensor(), normalize])

def transforms(examples):

	examples["pixel_values"] = [_transforms(img.convert("RGB")) for img in examples["image"]]
	del examples["image"]
	return examples

beans_transformed = beans_train.with_transform(transforms)

data_collator = DefaultDataCollator()
Vamos entender o que acontece no código acima:
google/vit-base-patch16-224-in21k._transforms) incluindo recorte redimensionado aleatório, conversão para tensor e normalização.beans_train é transformado com a função transforms, preparando-o para o treinamento do modelo.Após essas etapas, a métrica de avaliação usada para medir o desempenho do modelo é a acurácia, implementada com a função auxiliar abaixo.
accuracy = evaluate.load("accuracy")
def compute_metrics(eval_pred):
   predictions, labels = eval_pred
   predictions = np.argmax(predictions, axis=1)

   return accuracy.compute(predictions=predictions,
references=labels)Antes do processo de treinamento, definimos o modelo aproveitando o pré-treinado com a função .from_pretrained assim:
model = AutoModelForImageClassification.from_pretrained(
   checkpoint,
   num_labels=len(labels),
   id2label=id2label,
   label2id=label2id,
)O próximo passo é configurar o modelo definindo e inicializando o ambiente de treinamento.
A configuração inclui especificar os hiperparâmetros necessários relacionados ao treinamento, avaliação e otimização.
Mas, antes disso, precisamos fazer login na nossa conta do Hugging Face usando nossas credenciais, que podem ser obtidas assim:
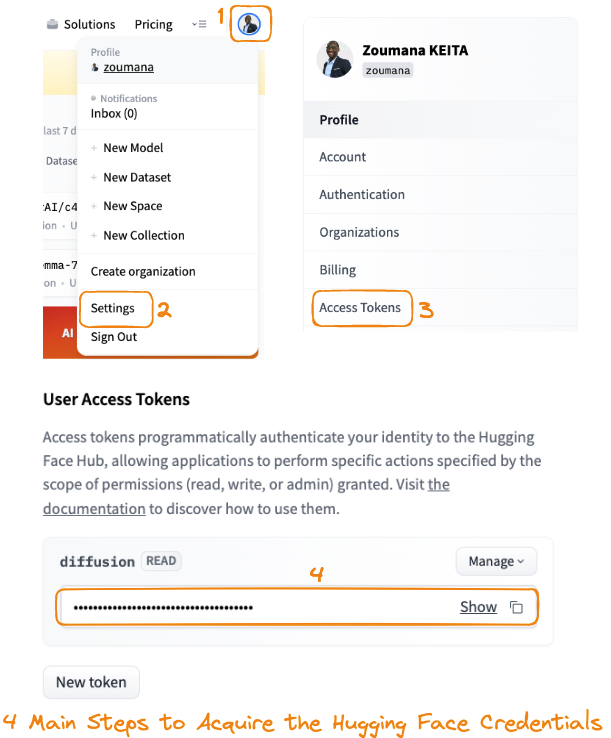
Etapas principais para obter as credenciais do Hugging Face
Ao fazer login na conta do Hugging Face, você pode enviar e compartilhar seus modelos treinados com a comunidade. Em seguida, a autenticação é iniciada com a função notebook_login.
notebook_login()Quando solicitado, forneça o token de conexão copiado na etapa 4 do guia acima.
Depois do login bem-sucedido, a mensagem a seguir deve ser exibida:
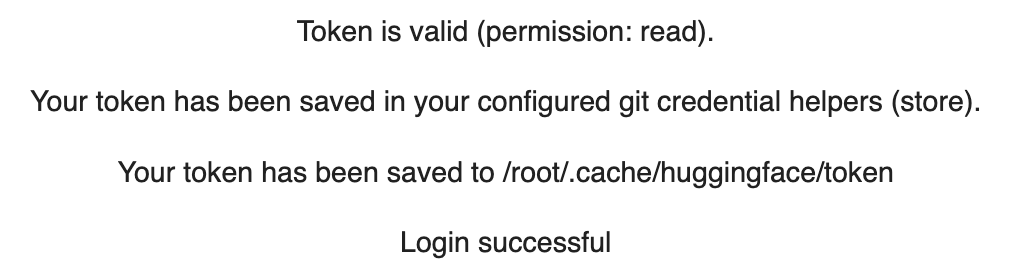
O código de configuração e inicialização está abaixo:
training_args = TrainingArguments(
	output_dir="./beans_health_type_classifier",
	remove_unused_columns=False,
	evaluation_strategy="epoch",
	save_strategy="epoch",
	learning_rate=5e-5,
	per_device_train_batch_size=16,
	gradient_accumulation_steps=4,
	per_device_eval_batch_size=16,
	num_train_epochs=3,
	warmup_ratio=0.1,
	logging_steps=10,
	load_best_model_at_end=True,
	metric_for_best_model="accuracy"
)

trainer = Trainer(
	model=model,
	args=training_args,
	data_collator=data_collator,
	train_dataset=beans_transformed["train"],
	eval_dataset=beans_transformed["test"],
	tokenizer=image_processor,
	compute_metrics=compute_metrics,
)
TrainingArguments são configurados com parâmetros como diretório de saída, estratégia de avaliação e salvamento por época, taxa de aprendizado, tamanho de batch, etapas de acumulação de gradiente e outras definições para otimizar o treinamento e o desempenho do modelo.Trainer é inicializado com o modelo definido, argumentos de treinamento, data collator para batching, datasets de treino e avaliação, um tokenizer (ou processador de imagens neste caso) para pré-processamento e uma função para calcular métricas de avaliação.Agora vem a fase de treinamento, realizada com a função .train.
trainer.train()Este treinamento específico gerou as seguintes métricas:
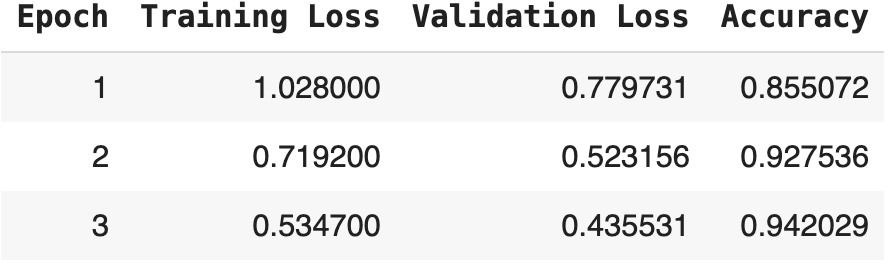
Resultado do treinamento do modelo por três épocas
A tabela mostra a evolução do treinamento ao longo de três épocas no dataset de beans, com três métricas principais: perda de treino, perda de validação e acurácia.
Ao autenticar no portal do Hugging Face pela primeira vez, o modo de conexão foi apenas read. No entanto, precisamos de credenciais de write para enviar nosso modelo ao Hub do Hugging Face.
Depois disso, é preciso fazer login novamente com a função notebook_login usando as novas credenciais.
notebook_login()O envio do modelo é feito com a função push_to_hub da seguinte forma:
trainer.model.push_to_hub("zoumana/beans_health_type_classifier")Isso vai enviar o modelo para o Hub, onde podemos ver as principais propriedades do modelo publicado.
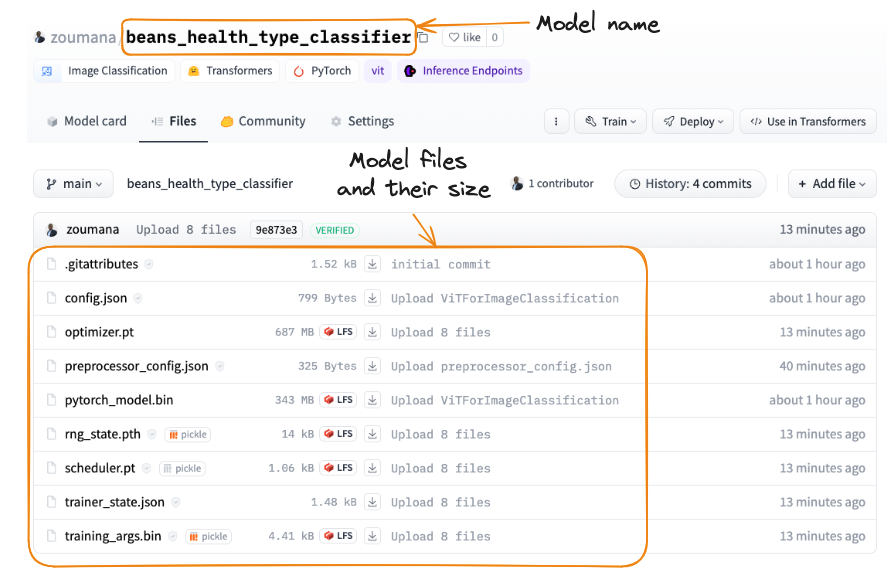
Modelo publicado no Hugging Face
Depois de compartilhado, o modelo pode ser integrado em aplicações via REST API, ou os usuários podem utilizá-lo diretamente pelo portal do Hugging Face. Desenvolvedores e pesquisadores também podem carregar o modelo usando a biblioteca Transformers.
Nesta seção, cobrimos as três principais formas de usar o modelo.
No portal, usuários podem enviar uma imagem e obter as previsões do modelo, como mostrado na animação a seguir.
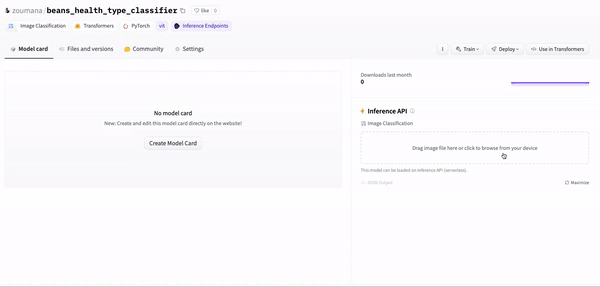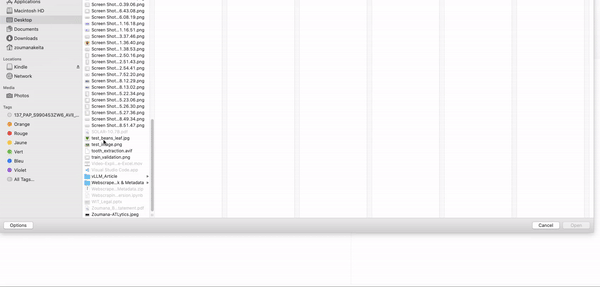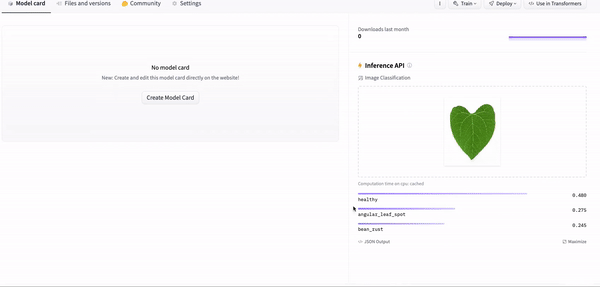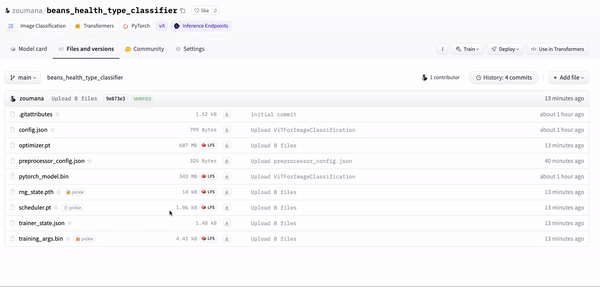
Usando o modelo pelo portal do Hugging Face
Ao selecionar o ícone “Use in Transformers”, o código para usar o modelo é fornecido automaticamente, como abaixo:
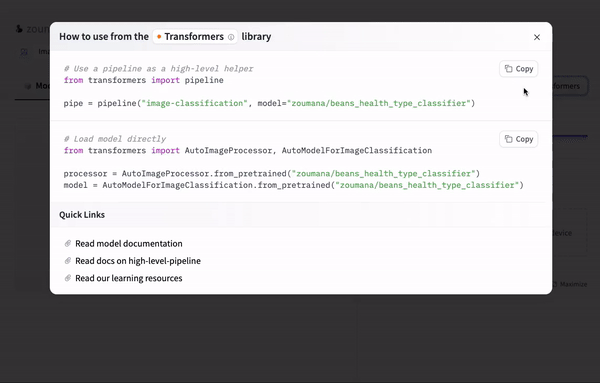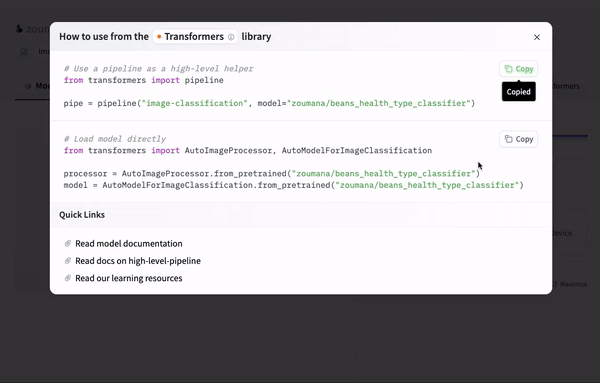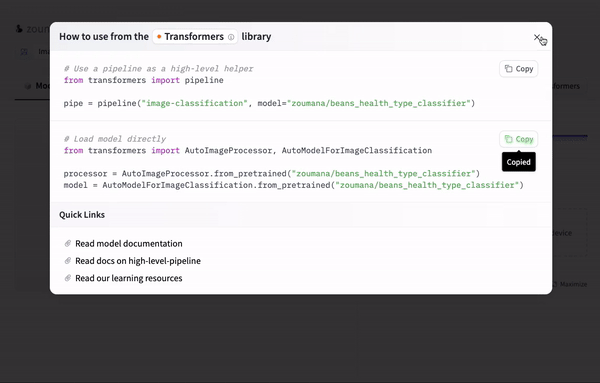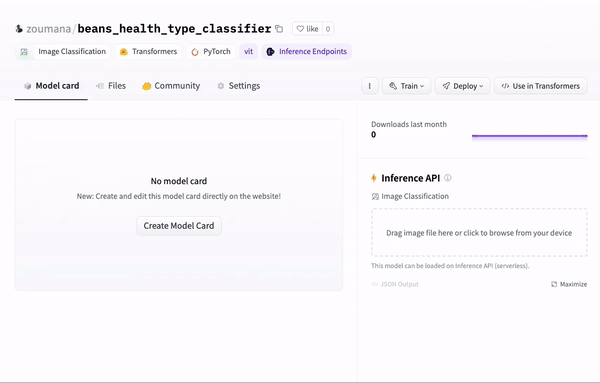
Usando o modelo com Transformers
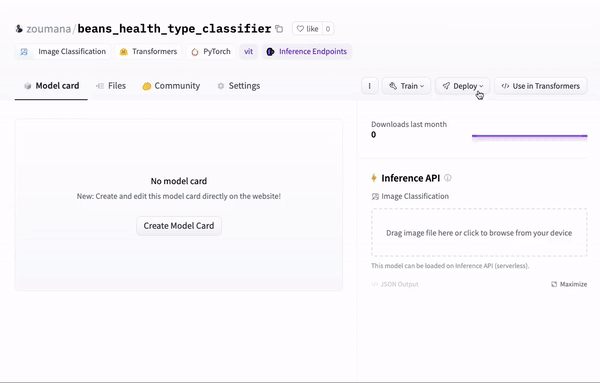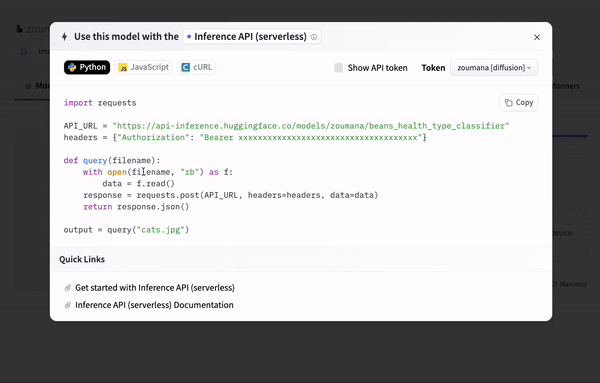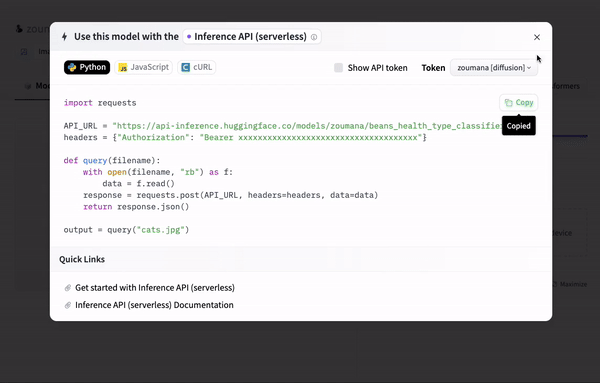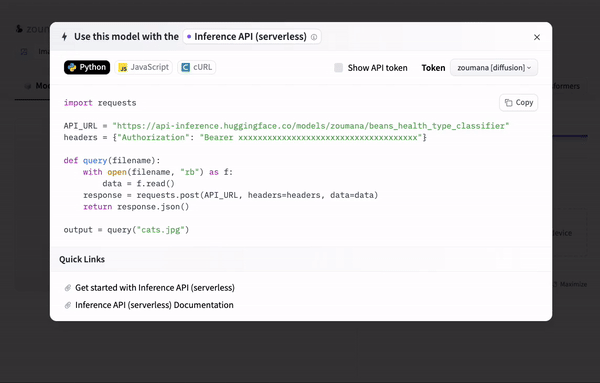
Por fim, podemos usar o modelo como uma REST API usando a string de conexão fornecida automaticamente no portal após clicar no ícone “Deploy > Inference API (serverless)”.
Usando um endpoint de API
O snippet apresentado na animação anterior é o mesmo abaixo e pode ser usado para fazer previsões sobre uma imagem.
A imagem usada é a mesma mostrada na ilustração pelo portal do Hugging Face.
Lembre-se de substituir os “xxx” pelos valores reais.
import requests

API_URL = "https://api-inference.huggingface.co/models/zoumana/beans_health_type_classifier"
headers = {"Authorization": "Bearer xxxxxxxxxxxxxxxxx"}

def query(filename):
   with open(filename, "rb") as f:
       data = f.read()
   response = requests.post(API_URL, headers=headers, data=data)
   return response.json()
Em seguida, obtemos a resposta do modelo usando a função query anterior.
output = query("./inference_images/test_beans_leaf.jpg")O resultado final é uma resposta JSON, como mostrado abaixo. Vemos que o rótulo previsto é aquele com maior probabilidade e, neste caso, é healthy, exatamente o mesmo resultado obtido no portal do Hugging Face.
print(output)[
{'label': 'healthy', 'score': 0.4799719452857971},
{'label': 'angular_leaf_spot', 'score': 0.27489492297172546},
{'label': 'bean_rust', 'score': 0.2451331913471222}
]Este artigo trouxe um guia completo de como realizar tarefas de classificação de imagens com o Hugging Face.
Começamos pelos fundamentos de classificação de imagens e por que o Hugging Face é uma ótima ferramenta para isso, graças à sua ampla coleção de modelos e à comunidade engajada.
Depois, cobrimos como preparar as imagens de treino para classificação, garantindo que os dados atendam aos requisitos de fine-tuning.
Além disso, vimos como ajustar um modelo com o Hugging Face, escolhendo o pré-treinado adequado. Também discutimos como integrar o modelo treinado em aplicações reais usando três estratégias principais de integração.
Sempre há mais para explorar em IA, e cada passo abre novas possibilidades. Para quem quer aprender mais sobre IA e machine learning, especialmente sobre classificação de imagens e além, aqui vão alguns ótimos recursos:
Este guia foi feito para ajudar qualquer pessoa a iniciar seus próprios projetos usando o Hugging Face para classificação de imagens, seja iniciante, intermediária ou avançada.
Comece sua jornada em IA hoje mesmo!
Curso
Curso
Programa
blog
Abid Ali Awan
8 min
blog
Abid Ali Awan
15 min
Tutorial
Zoumana Keita
14 min
Tutorial
Amberle McKee
15 min
Tutorial
Zoumana Keita
14 min
Tutorial
Moez Ali
12 min