
Khóa học
Làm việc với Hugging Face
2 giờ
40K
Trong lĩnh vực trí tuệ nhân tạo (AI) và học máy (ML) đang phát triển nhanh chóng, phân loại ảnh nổi bật như một nhiệm vụ nền tảng hỗ trợ nhiều ứng dụng, từ hệ thống nhận diện khuôn mặt đến chẩn đoán ảnh y khoa.
Giữa rất nhiều công cụ và thư viện dành cho nhà khoa học dữ liệu và người làm AI, Hugging Face là một tên tuổi lớn, đặc biệt với những ai làm việc với xử lý ngôn ngữ tự nhiên (NLP) và ngày càng nhiều hơn với các tác vụ thị giác máy tính như phân loại ảnh.
Bài viết này sẽ bao quát những điều cốt lõi khi dùng Hugging Face cho phân loại ảnh, gồm: hiểu các khái niệm cơ bản, chuẩn bị dữ liệu, huấn luyện mô hình, triển khai mô hình lên Hugging Face Hub, và cuối cùng là tương tác với mô hình đã triển khai qua API và giao diện Hugging Face.
Dù bạn là người mới bắt đầu hay đã có kinh nghiệm, hướng dẫn này sẽ mang đến những góc nhìn hữu ích để tận dụng Hugging Face cho nhu cầu phân loại ảnh của bạn.
Phần này cung cấp cái nhìn tổng quan về các khái niệm cơ bản của phân loại ảnh và lợi ích khi sử dụng Hugging Face.
Phân loại ảnh là việc xếp các hình ảnh vào một trong số các lớp được xác định trước.
Nhiệm vụ này được thực hiện bằng các thuật toán phân tích nội dung thị giác của ảnh và dự đoán danh mục dựa trên các mẫu được học từ tập dữ liệu huấn luyện. Các mô hình học sâu, đặc biệt là mạng nơ-ron tích chập (CNN), đã trở thành phương pháp tiêu chuẩn cho nhiệm vụ này nhờ khả năng nắm bắt các mẫu liên quan trong dữ liệu ảnh.
Để tìm hiểu thêm về CNN, bài viết Giới thiệu về Mạng Nơ-ron Tích chập (CNN) của chúng tôi cung cấp hướng dẫn đầy đủ để hiểu CNN, tác động của chúng đối với phân tích ảnh, và một số chiến lược then chốt để chống quá khớp nhằm xây dựng CNN vững chắc cho các ứng dụng học sâu.
Ngoài ra, bài viết Phân loại trong Học máy: Giới thiệu trình bày quy trình từng bước để tìm hiểu về phân loại trong học máy, xem xét khái niệm, cách sử dụng và một số ví dụ về thuật toán phân loại.
Hugging Face cung cấp một hệ sinh thái rộng lớn cho học máy, với giao diện dễ dùng, lưu trữ kho mô hình tiền huấn luyện phong phú và tài liệu toàn diện.
So với các nền tảng khác, Hugging Face mang lại nhiều lợi thế cho phân loại ảnh:
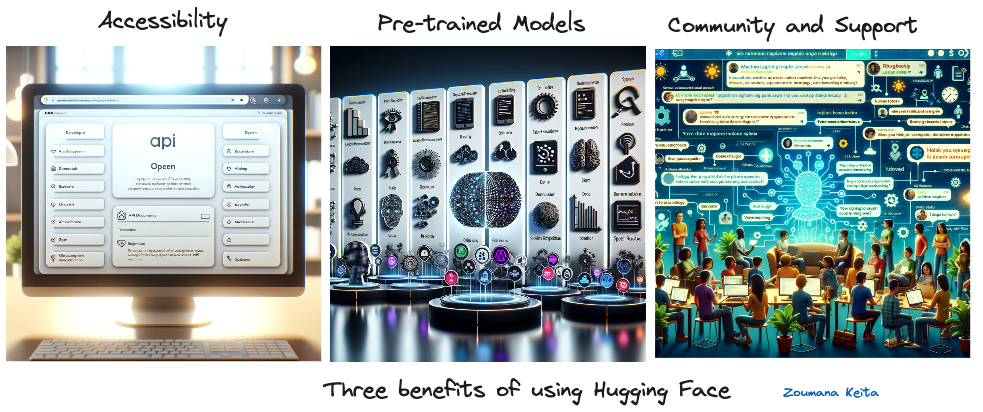
Ba lợi ích khi dùng Hugging Face (Hình tạo bằng GPT-4)
Ngoài ra, Hugging Face còn hỗ trợ triển khai mô hình trên các nền tảng đám mây lớn như AWS, Azure và Google Cloud Platform, kèm nhiều kiểu suy luận.
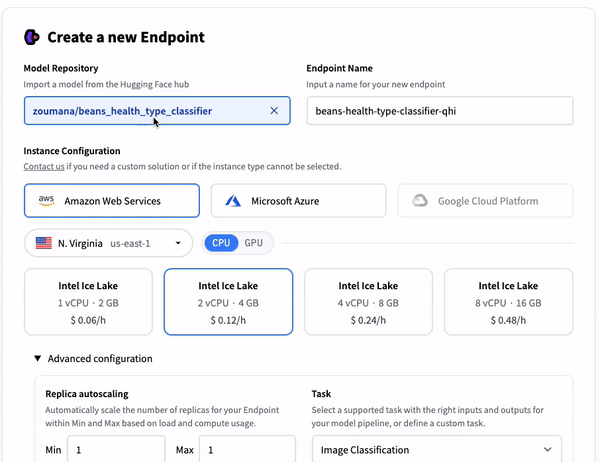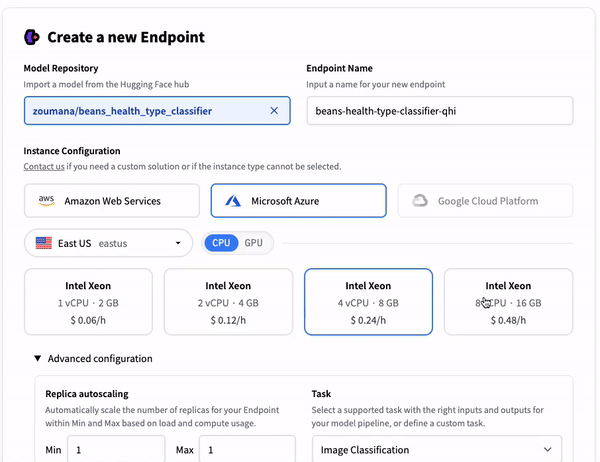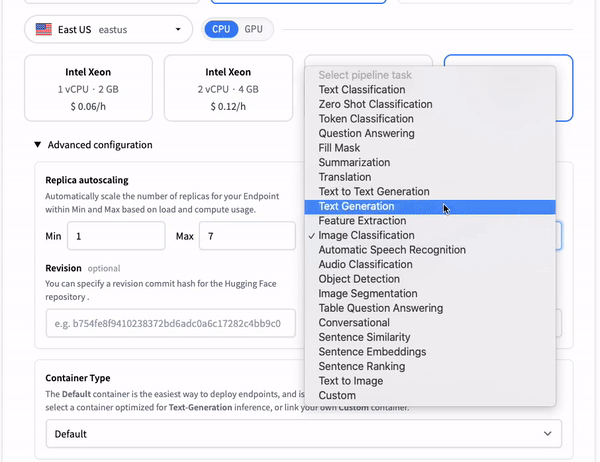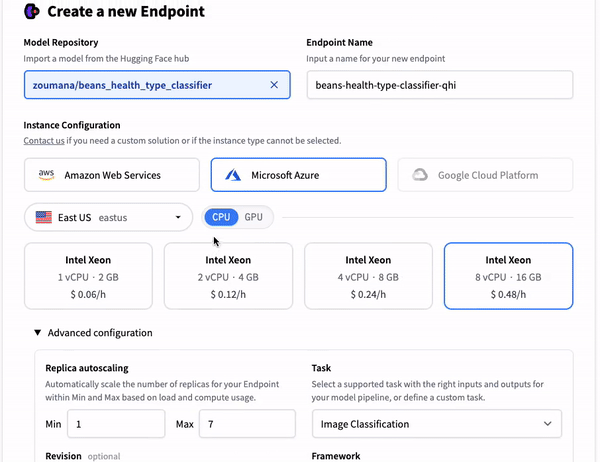
Tùy chọn triển khai mô hình trên các nền tảng đám mây
Nhiệm vụ chính trong bài là phân loại ảnh, và chúng tôi sẽ dùng bộ dữ liệu beans từ Hugging Face cho ví dụ. Sau khi tải dữ liệu, chúng ta sẽ trực quan hóa trước khi đi vào tiền xử lý để huấn luyện mô hình.
Notebook chứa mã nguồn sẵn sàng để bạn theo dõi trên Google Colab.
Mã trong bài viết này được truyền cảm hứng mạnh mẽ từ trang chính thức của Hugging Face.
Nhiều thư viện được sử dụng xuyên suốt bài viết, mỗi thư viện có vai trò riêng. Một số thư viện cần cài đặt. Các thư viện này được cài bằng trình quản lý gói Python “pip” như sau:
%%bash
pip -q install datasets
pip -q install transformers=='4.29.0'
pip -q install tensorflow=='2.15' # At least this tensorflow version is required to use the "evaluate module"
pip -q install evaluate
pip -q install --upgrade accelerate
Điều quan trọng là khởi động lại kernel sau khi cài đặt thư viện. Sau khi cài thành công, có thể import các thư viện cần thiết bằng các câu lệnh from và import:
import torch
import torchvision
import numpy as np
import evaluate
from datasets import load_dataset
from huggingface_hub import notebook_login
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from transformers import DefaultDataCollator
from transformers import AutoImageProcessor
from torchvision.transforms import RandomResizedCrop, Compose, Normalize, ToTensor
from transformers import AutoModelForImageClassification, TrainingArguments, Trainer
import matplotlib.pyplot as pltTải dữ liệu từ Hugging Face rất đơn giản với hàm load_dataset .
beans_train = load_dataset("beans", split="train")beans là tên bộ dữ liệu được sử dụng.train tương ứng với phân tập dữ liệu toàn bộ đang dùng.Khi dữ liệu đã được tải, chúng ta có thể kiểm tra đặc tính của nó bằng cách in đơn giản tên biến ở trên.
print(beans_train)Màn hình sẽ hiển thị kết quả dưới đây:
Dataset({
    features: ['image_file_path', 'image', 'labels'],
    num_rows: 1034
})
Tổng cộng có 1034 ảnh, và mỗi ảnh có ba trường:
image_path: đường dẫn tới ảnh thực tế.image: một đối tượng PIL của ảnh lá đậu.labels: nhãn của ảnh, là một trong ba loại sau:Hàm trợ giúp sau giúp việc trực quan hóa một số lượng ảnh được chọn ngẫu nhiên trở nên dễ dàng hơn và gán đúng loại ảnh cùng với các nhãn hiện có (0, 1 và 2)
labels_names = {
   0: "angular_leaf_spot",
   1: "bean_rust",
   2: "healthy",
}

def display_random_images(dataset, num_images=4):

   num_rows = 2
   num_cols = np.ceil(num_images / num_rows).astype(int)

   plt.figure(figsize=(num_cols * 3, num_rows * 3))
   indices = np.random.choice(range(len(dataset)), size=num_images, replace=False)

   for i, idx in enumerate(indices, 1):
       idx = int(idx)
       image = dataset[idx]['image']
       label = dataset[idx]['labels']
       label_name = labels_names.get(label, "Unknown")

       plt.subplot(num_rows, num_cols, i)
       plt.imshow(image)
       plt.title(f"{label_name} ({label})")
       plt.axis('off')

   plt.tight_layout()
   plt.show()
Tóm lại, hàm display_random_images chọn một tập con ảnh ngẫu nhiên từ một tập dữ liệu cho trước và hiển thị chúng theo dạng lưới, mỗi ảnh được gắn nhãn theo phân loại (ví dụ: "angular_leaf_spot", "bean_rust", "healthy").
Hàm này sắp xếp ảnh thành hai hàng và tính số cột cần thiết dựa trên tổng số ảnh cần hiển thị, đảm bảo không trùng ảnh và mỗi ảnh đều có tên nhãn kèm nhãn số tương ứng.
Sau đó, chúng ta có thể hiển thị sáu ảnh ngẫu nhiên bằng hàm như sau:
display_random_images(beans_train, num_images=6)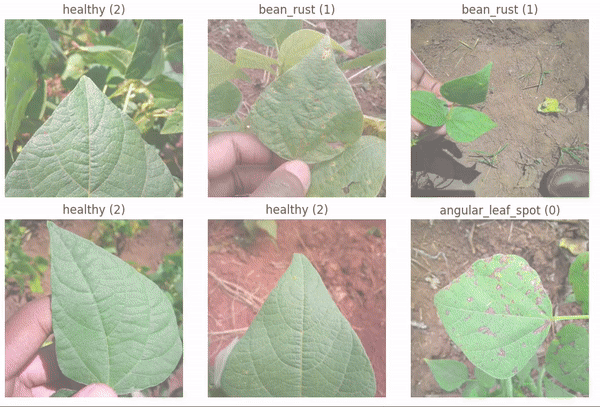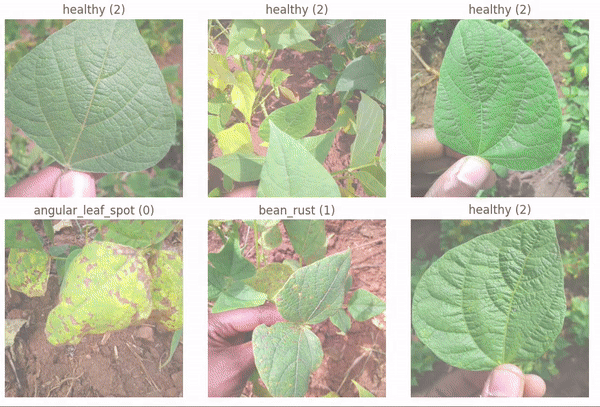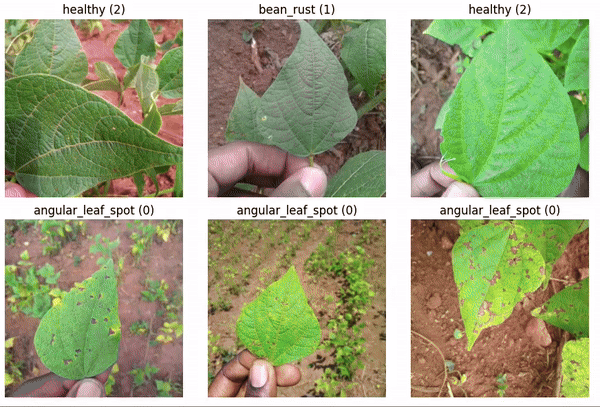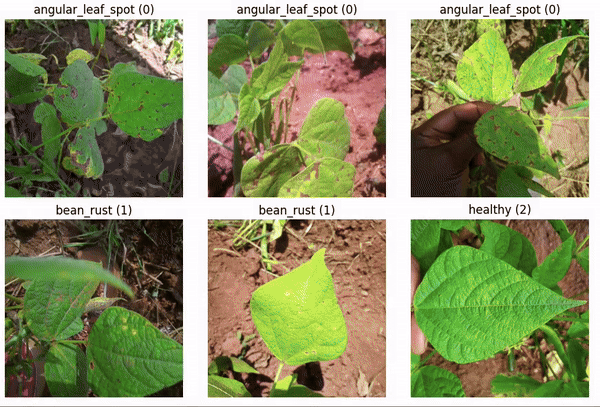
Sáu ảnh ngẫu nhiên từ bộ dữ liệu
Trước khi huấn luyện mô hình, cần thực hiện tiền xử lý phù hợp để dữ liệu sẵn sàng cho mô hình.
Đầu tiên, bộ dữ liệu gốc được tách thành dữ liệu huấn luyện và kiểm định lần lượt 80% và 20%, thực hiện bằng hàm train_test_split .
beans_train = beans_train.train_test_split(test_size=0.2)Tiếp theo, tạo hai từ điển: label2id và id2label. Đây là bước quan trọng để chuyển đổi giữa tên nhãn dễ đọc với con người và định danh số mà máy hiểu được.
Quy trình này hỗ trợ cả quá trình huấn luyện và việc diễn giải dự đoán cuối cùng của mô hình.
labels = beans_train["train"].features["labels"].names
label2id, id2label = dict(), dict()

for i, label in enumerate(labels):
   label2id[label] = str(i)
   id2label[str(i)] = label
Dưới đây là kết quả của biến id2label:
print(id2label){'0': 'angular_leaf_spot', '1': 'bean_rust', '2': 'healthy'}Mô hình phân loại của chúng ta tận dụng Vision Transformer (ViT) tiền huấn luyện từ Hugging Face.
Mô hình này được giới thiệu trong bài báo An Image is Worth 16x16 words: Transformers for Image Recognition at Scale, đánh dấu lần đầu tiên ứng dụng thành công kiến trúc transformer vào nhận dạng ảnh, được huấn luyện trên bộ ImageNet.
Đoạn mã sau giải thích các bước để tải mô hình tiền huấn luyện, tiền xử lý dữ liệu theo yêu cầu của mô hình, và các bước trung gian để đảm bảo ảnh được xử lý đúng cách, sẵn sàng đưa vào mô hình tiền huấn luyện để tinh chỉnh và đánh giá.
checkpoint = "google/vit-base-patch16-224-in21k"
image_processor = AutoImageProcessor.from_pretrained(checkpoint)

normalize = Normalize(mean=image_processor.image_mean,
                  	std=image_processor.image_std)

size = (
	image_processor.size["shortest_edge"]
	if "shortest_edge" in image_processor.size
	else (image_processor.size["height"], image_processor.size["width"])
)

_transforms = Compose([RandomResizedCrop(size), ToTensor(), normalize])

def transforms(examples):

	examples["pixel_values"] = [_transforms(img.convert("RGB")) for img in examples["image"]]
	del examples["image"]
	return examples

beans_transformed = beans_train.with_transform(transforms)

data_collator = DefaultDataCollator()
Hãy cùng hiểu điều gì đang diễn ra trong đoạn mã trên:
google/vit-base-patch16-224-in21k._transforms) được hợp thành, bao gồm cắt ngẫu nhiên, chuyển sang tensor và chuẩn hóa.beans_train được biến đổi bằng hàm transforms, chuẩn bị cho huấn luyện mô hình.Sau các bước thiết lập này, thước đo đánh giá hiệu năng mô hình được sử dụng là độ chính xác (accuracy), được hiện thực bằng hàm trợ giúp sau.
accuracy = evaluate.load("accuracy")
def compute_metrics(eval_pred):
   predictions, labels = eval_pred
   predictions = np.argmax(predictions, axis=1)

   return accuracy.compute(predictions=predictions,
references=labels)Trước quá trình huấn luyện, mô hình thực tế được định nghĩa bằng cách tận dụng mô hình tiền huấn luyện với hàm .from_pretrained như sau
model = AutoModelForImageClassification.from_pretrained(
   checkpoint,
   num_labels=len(labels),
   id2label=id2label,
   label2id=label2id,
)Bước tiếp theo là thiết lập mô hình bằng cách cấu hình và khởi tạo môi trường huấn luyện.
Thiết lập bao gồm chỉ định các siêu tham số cần thiết liên quan đến huấn luyện, đánh giá và tối ưu.
Nhưng trước đó, chúng ta cần đăng nhập vào tài khoản Hugging Face bằng thông tin xác thực, có thể lấy như sau:
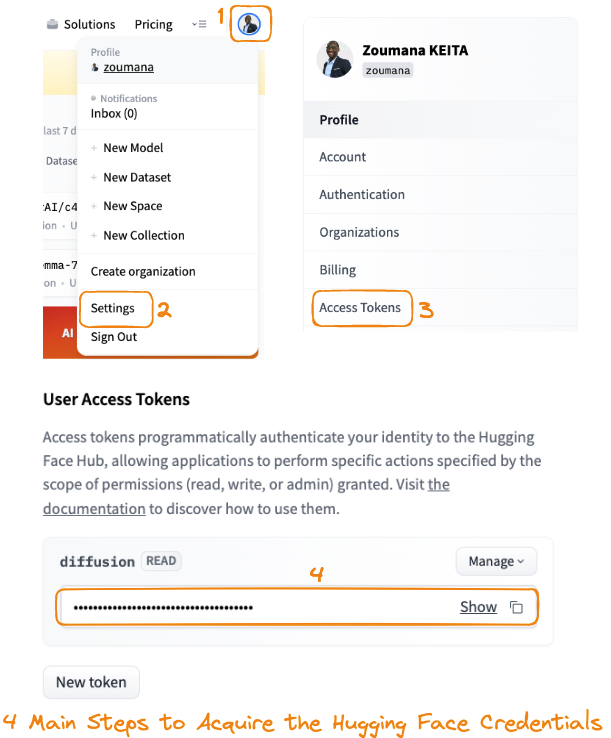
Các bước chính để lấy thông tin xác thực Hugging Face
Bằng cách đăng nhập vào tài khoản Hugging Face, chúng ta có thể tải lên và chia sẻ các mô hình đã huấn luyện với cộng đồng. Tiếp theo, kích hoạt quy trình xác thực bằng hàm notebook_login.
notebook_login()Khi được nhắc, hãy cung cấp token kết nối, như đã sao chép ở bước 4 trong hướng dẫn trên.
Sau khi đăng nhập thành công, thông báo sau sẽ được hiển thị:
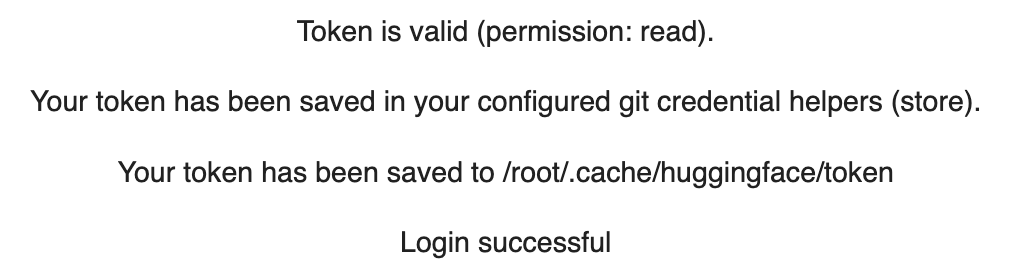
Mã cấu hình và khởi tạo được cung cấp dưới đây:
training_args = TrainingArguments(
	output_dir="./beans_health_type_classifier",
	remove_unused_columns=False,
	evaluation_strategy="epoch",
	save_strategy="epoch",
	learning_rate=5e-5,
	per_device_train_batch_size=16,
	gradient_accumulation_steps=4,
	per_device_eval_batch_size=16,
	num_train_epochs=3,
	warmup_ratio=0.1,
	logging_steps=10,
	load_best_model_at_end=True,
	metric_for_best_model="accuracy"
)

trainer = Trainer(
	model=model,
	args=training_args,
	data_collator=data_collator,
	train_dataset=beans_transformed["train"],
	eval_dataset=beans_transformed["test"],
	tokenizer=image_processor,
	compute_metrics=compute_metrics,
)
TrainingArguments được cấu hình với các tham số cụ thể như thư mục đầu ra, chiến lược đánh giá và lưu theo từng epoch, tốc độ học, kích thước batch, số bước tích lũy gradient và các thiết lập khác nhằm tối ưu quá trình huấn luyện và hiệu năng mô hình.Trainer được khởi tạo với mô hình đã định nghĩa, các tham số huấn luyện, data collator để tạo batch, tập huấn luyện và kiểm định, một tokenizer (hoặc bộ xử lý ảnh trong trường hợp này) để tiền xử lý dữ liệu, và hàm tính chỉ số đánh giá.Giờ đến giai đoạn huấn luyện, được thực hiện bằng hàm .train.
trainer.train()Quá trình huấn luyện cụ thể này cho ra các chỉ số sau:
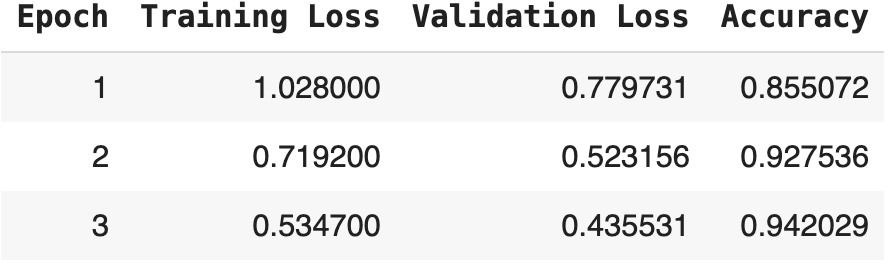
Kết quả huấn luyện mô hình trong ba epoch
Bảng hiển thị tiến trình huấn luyện qua ba epoch trên bộ dữ liệu beans, thể hiện ba chỉ số chính: mất mát huấn luyện, mất mát kiểm định và độ chính xác.
Khi xác thực vào cổng Hugging Face lần đầu, chế độ kết nối là chỉ đọc. Tuy nhiên, chúng ta cần thông tin xác thực ghi để có thể đẩy mô hình lên Hugging Face Hub.
Sau đó, cần đăng nhập lại bằng hàm notebook_login với thông tin xác thực vừa tạo.
notebook_login()Việc đẩy mô hình được thực hiện bằng hàm push_to_hub như sau:
trainer.model.push_to_hub("zoumana/beans_health_type_classifier")Lệnh này sẽ đẩy mô hình lên hub, và chúng ta có thể xem các thuộc tính chính của mô hình.
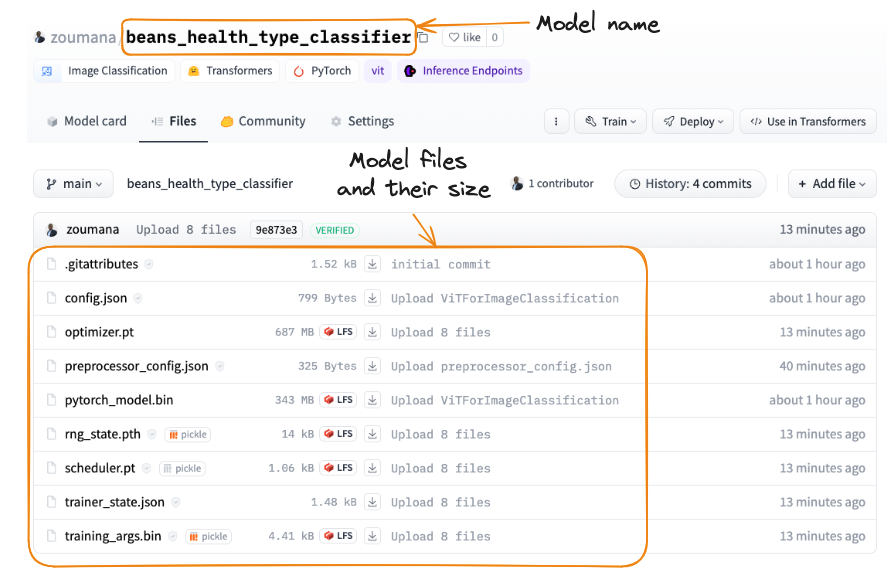
Mô hình đã được đẩy lên Hugging Face
Khi mô hình đã được chia sẻ, có thể tích hợp vào ứng dụng qua REST API, hoặc người dùng có thể tích hợp trực tiếp từ cổng Hugging Face. Nhà phát triển và nhà nghiên cứu cũng có thể dùng mô hình bằng cách tải qua thư viện Transformers.
Phần này trình bày ba cách chính để sử dụng mô hình.
Trên cổng, người dùng có thể tải trực tiếp một ảnh lên và nhận dự đoán từ mô hình như minh họa trong ảnh động sau.
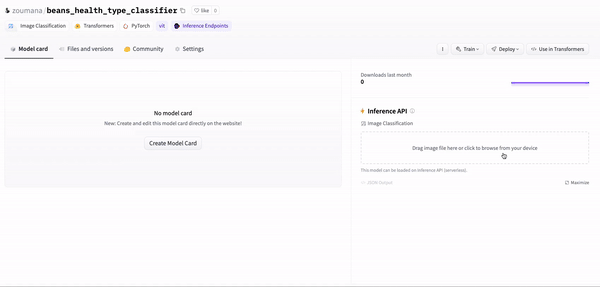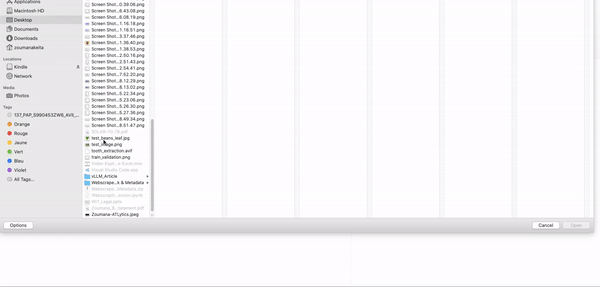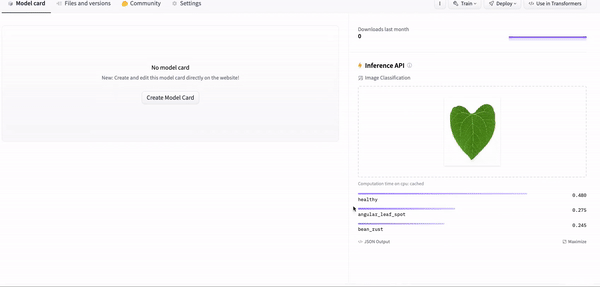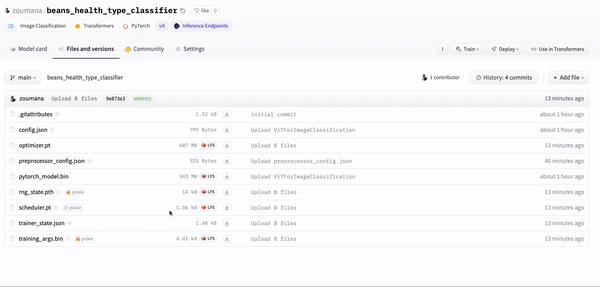
Sử dụng mô hình từ cổng Hugging Face
Bằng cách chọn biểu tượng “Use in Transformers”, mã sử dụng mô hình sẽ được cung cấp tự động như sau:
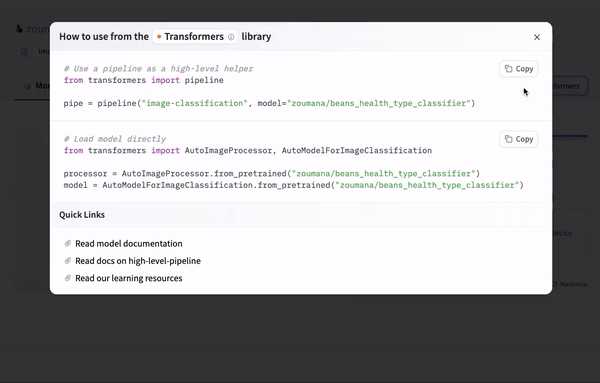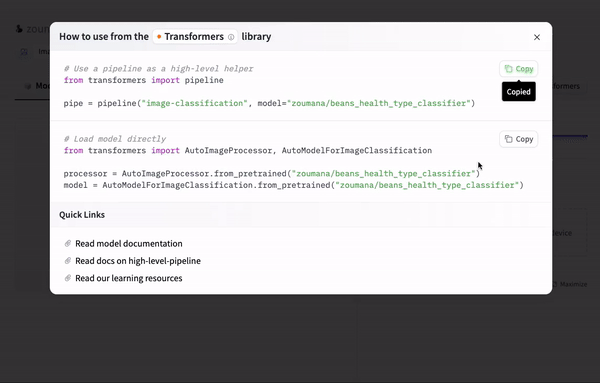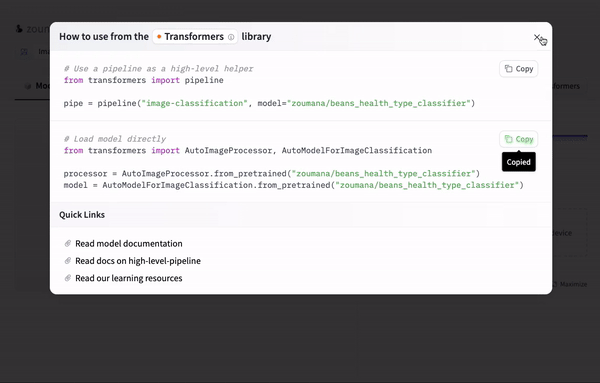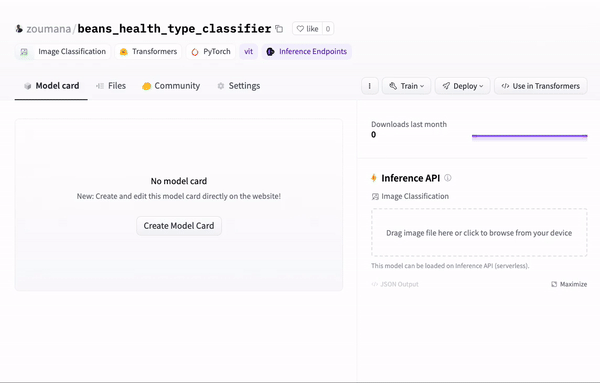
Sử dụng mô hình với Transformers
Cuối cùng, chúng ta có thể dùng mô hình như một REST API bằng chuỗi kết nối được cung cấp tự động từ cổng sau khi nhấp vào biểu tượng “Deploy > Inference API (serverless)”.
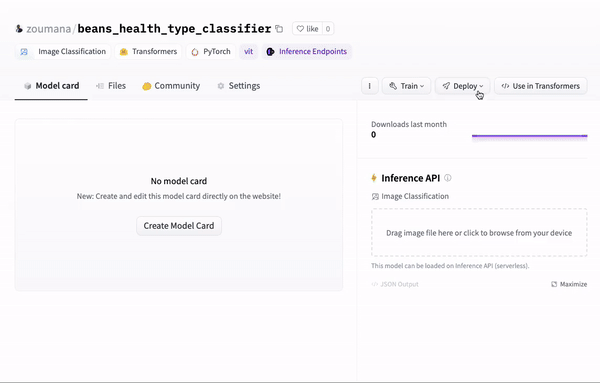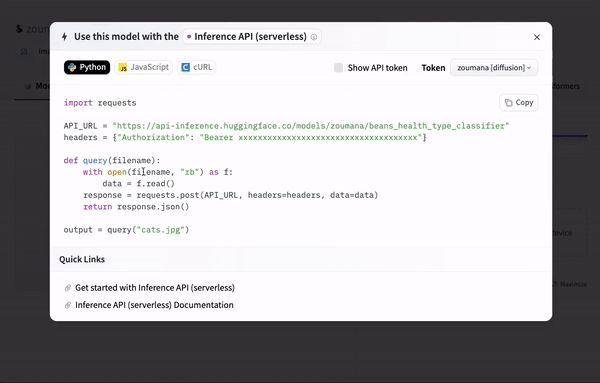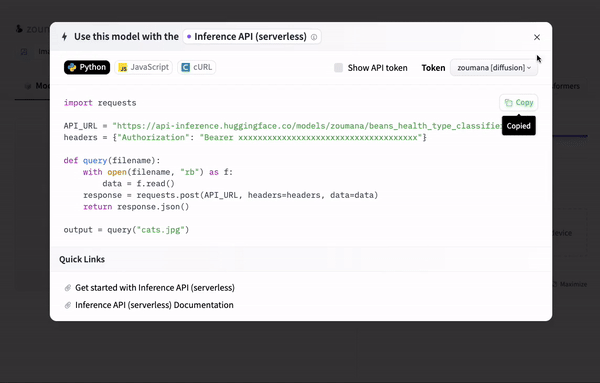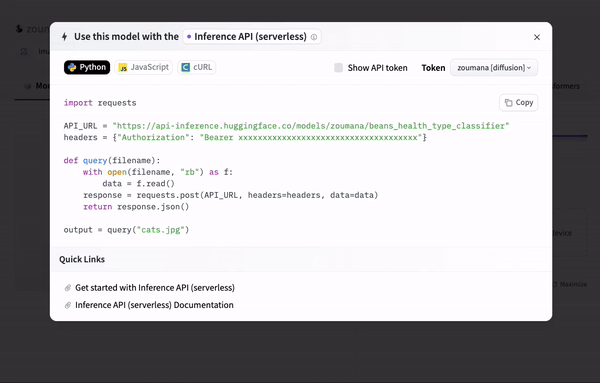
Sử dụng endpoint API
Đoạn mã trong ảnh động trước giống với mã dưới đây và có thể dùng để dự đoán trên một ảnh cho trước.
Ảnh được dùng chính là ảnh đã sử dụng trong minh họa trên cổng Hugging Face.
Hãy đảm bảo thay “xxx” bằng giá trị thực tế.
import requests

API_URL = "https://api-inference.huggingface.co/models/zoumana/beans_health_type_classifier"
headers = {"Authorization": "Bearer xxxxxxxxxxxxxxxxx"}

def query(filename):
   with open(filename, "rb") as f:
       data = f.read()
   response = requests.post(API_URL, headers=headers, data=data)
   return response.json()
Tiếp theo, chúng ta lấy phản hồi của mô hình bằng hàm query ở trên.
output = query("./inference_images/test_beans_leaf.jpg")Kết quả cuối cùng là phản hồi JSON như dưới đây. Có thể thấy nhãn được dự đoán là nhãn có điểm xác suất cao nhất, trong trường hợp này là nhãn healthy, trùng khớp với dự đoán từ cổng Hugging Face.
print(output)[
{'label': 'healthy', 'score': 0.4799719452857971},
{'label': 'angular_leaf_spot', 'score': 0.27489492297172546},
{'label': 'bean_rust', 'score': 0.2451331913471222}
]Bài viết này cung cấp hướng dẫn đầy đủ về cách thực hiện các tác vụ phân loại ảnh bằng Hugging Face.
Chúng ta bắt đầu với những điều cơ bản của phân loại ảnh và lý do vì sao Hugging Face là công cụ tuyệt vời cho công việc này, nhờ bộ sưu tập mô hình phong phú và cộng đồng hỗ trợ nhiệt tình.
Sau đó, chúng ta đề cập cách chuẩn bị ảnh huấn luyện cho phân loại, bao gồm đảm bảo dữ liệu huấn luyện đáp ứng yêu cầu tinh chỉnh.
Tiếp nữa, chúng ta đi sâu vào cách tinh chỉnh mô hình với Hugging Face, lựa chọn mô hình tiền huấn luyện phù hợp. Chúng ta cũng thảo luận cách tích hợp mô hình đã huấn luyện vào ứng dụng thực tế với ba chiến lược tích hợp chính.
Luôn còn nhiều điều để học và khám phá trong AI, và mỗi bước bạn đi mở ra những khả năng mới. Vì vậy, với bất kỳ ai muốn học thêm về AI và học máy, đặc biệt là về phân loại ảnh và hơn thế nữa, đây là một số tài nguyên hữu ích:
Hướng dẫn này nhằm giúp bất kỳ ai bắt đầu dự án riêng với Hugging Face cho phân loại ảnh, dù là người mới, trung cấp hay nâng cao.
Bắt đầu hành trình AI của bạn ngay hôm nay!
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
