Cours
Concevoir des systèmes agentiques avec LangChain
3 h
14.8K
Vous pouvez accéder au code complet de cette démo ici.
Nemotron 3 Super est le modèle de raisonnement ouvert de NVIDIA pour des workflows agentiques et à long contexte. Il s’appuie sur une architecture hybride Mamba-Transformer avec Latent MoE, totalisant 120 milliards de paramètres (dont 12 milliards actifs), intègre la prédiction multi-jetons (MTP) et est conçu pour des tâches exigeantes en raisonnement comme le code, l’usage d’outils et l’analyse long-contexte.
NVIDIA le positionne spécifiquement pour des applications multi-agents complexes et le raisonnement à l’échelle d’une base de code entière.
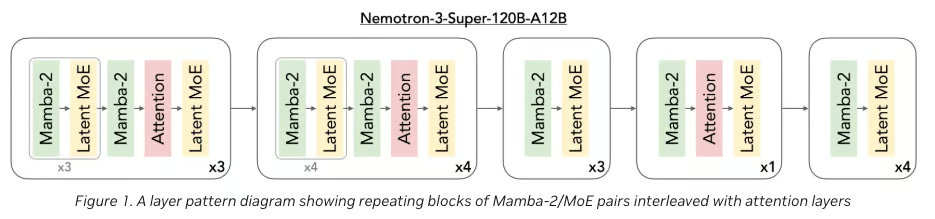
Figure 1 : architecture de Nemotron 3 Super (NVIDIA Blog)
Quelques idées clés derrière Nemotron 3 Super :
Pour ce tutoriel, nous utiliserons l’endpoint gratuit hébergé par OpenRouter, car les variantes complètes et quantifiées du modèle exigent en général au moins un GPU H100 pour une inférence praticable. L’endpoint hébergé prend actuellement en charge une fenêtre de contexte de 262 k jetons (au lieu du 1 M complet), ce qui reste suffisant pour analyser des dépôts de taille moyenne dans cette démo.
La famille Nemotron 3 a été présentée comme une famille de modèles ouverts pour des systèmes d’IA agentiques, avec différentes tailles selon les besoins de déploiement et de raisonnement : gammes Nemotron Nano, Super et Ultra.
Concrètement, on peut voir la famille ainsi :
Nemotron 3 Super est donc le bon choix ici, car nous voulons un modèle capable de raisonner sur l’ensemble d’un dépôt, et pas seulement de résoudre des sous-tâches de code isolées.
Dans cette section, nous allons construire un analyseur de repo avec Nemotron 3 Super encapsulé dans une interface Gradio. Voici, à haut niveau, ce que fait l’application finale :
Construisons-le pas à pas.
Avant de créer l’analyseur, nous avons besoin d’un environnement minimal capable de gérer trois responsabilités clés : l’affichage de l’UI, le traitement du dépôt et l’interaction avec le modèle. Comme Nemotron ne tourne pas en local, l’installation reste légère et ciblée.
Installez tout en exécutant :
!pip -q install gradio openai tiktoken gitpython orjson pandasDans ce projet, nous utiliserons :
openai pour interagir avec l’API d’OpenRouter (endpoint Nemotron)gradio pour construire l’UI interactivetiktoken pour estimer l’usage de jetons avant l’envoi des promptsorjson pour un parsing JSON rapide des sorties du modèlepandas pour afficher les résultats structurés sous forme de tableauxgitpython pour cloner et manipuler des dépôtsContrairement aux setups LLM locaux (qui nécessitent CUDA, vLLM ou quantization), cette approche évite toute dépendance GPU et reste adaptée à Colab.
Ici, nous configurons Nemotron 3 Super via OpenRouter et définissons quelques constantes pour piloter le traitement des dépôts. Comme le modèle ne tourne pas en local, ce client devient l’interface centrale pour envoyer de grands prompts packagés et recevoir des sorties d’analyse structurées.
OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")
MODEL = "nvidia/nemotron-3-super-120b-a12b:free"
WORKDIR = "/content/repo_ui"
if not OPENROUTER_API_KEY:
    raise ValueError("Set OPENROUTER_API_KEY in environment before running.")
client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=OPENROUTER_API_KEY,
)
enc = tiktoken.get_encoding("cl100k_base")
À ce stade, l’application communique avec Nemotron 3 Super via OpenRouter à l’aide du client Python openai configuré avec un base_url personnalisé et une clé d’API dans OPENROUTER_API_KEY.
Le modèle sélectionné pointe vers l’endpoint hébergé d’OpenRouter, ce qui permet d’exécuter un très grand modèle sans infrastructure GPU locale.
Pour gérer la taille de contexte, nous initialisons un tokenizer (tiktoken avec cl100k_base) afin d’estimer combien de jetons consommera le dépôt empaqueté avant de l’envoyer au modèle, car la fenêtre de contexte est finie.
Deux considérations pratiques :
Nous avons besoin de deux garde‑fous : le filtrage des fichiers et l’ancrage du prompt.
Le premier évite de gaspiller du contexte sur des artefacts non pertinents (builds, notebooks, images, binaires).
Le second garantit qu’une fois le dépôt packagé, le modèle reste ancré dans le code réel au lieu de dériver vers des conseils génériques.
Ensemble, ces règles rendent l’analyse plus efficace.
BASE_IGNORE_DIRS = {
    ".git", ".github", "__pycache__", "node_modules", ".venv", "venv",
    "dist", "build", ".mypy_cache", ".pytest_cache", ".idea", ".vscode"
}
IGNORE_SUFFIXES = {
    ".png", ".jpg", ".jpeg", ".gif", ".webp", ".pdf", ".zip", ".gz",
    ".tar", ".mp4", ".mov", ".onnx", ".pt", ".bin", ".parquet", ".feather",
    ".ico", ".svg", ".lock"
}
MAX_FILE_BYTES = 250_000
SYSTEM_PROMPT = """You are a codebase analysis model.
You are given the complete repository contents in one prompt.
Rules:
1. Use only the provided repository content.
2. Do not invent files, modules, libraries, or dependencies.
3. Every substantial claim must cite one or more file paths.
4. Clearly separate direct observations from engineering inferences or recommendations.
5. For modernization or improvement suggestions, explicitly distinguish:
   - repo-grounded findings
   - general engineering recommendations
6. Return valid JSON only.
7. If uncertain, say so explicitly.
8. For anything involving security, dead code, dependency replacement, or testing gaps,
   present findings as likely candidates unless directly proven by repository content.
"""
Les trois variables de filtrage suivantes contrôlent le prétraitement du dépôt :
BASE_IGNORE_DIRS : exclut des répertoires inutiles à l’analyse (ex. .git, node_modules, dossiers de build, caches d’éditeur).IGNORE_SUFFIXES : filtre des types de fichiers généralement peu utiles au raisonnement (images, archives, vidéos, checkpoints de modèles, etc.).MAX_FILE_BYTES : saute les fichiers trop volumineux pour rester dans un budget de contexte praticable.Le SYSTEM_PROMPT est tout aussi important que les filtres.
Comme le modèle voit le dépôt comme un long prompt, nous devons donner des garde‑fous clairs pour éviter d’inventer des modules, mal lire des abstractions ou proposer des recommandations trop génériques.
Ces instructions obligent le modèle à rester ancré dans le dépôt fourni, à citer des chemins de fichiers pour les affirmations importantes et à distinguer preuves directes et jugement général.
Maintenant que nous avons le filtrage et le prompt système, définissons un ensemble de tâches à l’échelle du dépôt, chacune avec un schéma JSON structuré.
Deux avantages majeurs : le modèle sait exactement quel type de sortie produire, et l’app peut parser et afficher de manière fiable les résultats dans des tableaux adaptés à chaque tâche.
TASK_DEFS: Dict[str, Dict[str, Any]] = {
    "Architecture Overview": {
        "description": "Explain the architecture, major modules, likely entrypoints, dependencies, and architectural issues.",
        "schema": {
            "repo_overview": {
                "summary": "",
                "primary_languages": [],
                "likely_entrypoints": []
            },
            "modules": [
                {
                    "name": "",
                    "responsibility": "",
                    "key_files": [],
                    "evidence_paths": []
                }
            ],
            "dependencies": [
                {
                    "from_module": "",
                    "to_module": "",
                    "relationship": "",
                    "evidence_paths": []
                }
            ],
            "issues": [
                {
                    "type": "",
                    "description": "",
                    "severity": "low|medium|high",
                    "evidence_paths": []
                }
            ],
            "unknowns_and_uncertainties": []
        },
    },
    ...
}
TASK_DEFS sert de registre central à tous les modes d’analyse pris en charge par l’app.
Chaque tâche contient une description en langage naturel qui guide le modèle, et un schéma strict qui définit le JSON attendu.
C’est ce qui permet au même dépôt empaqueté de supporter des raisonnements variés : cartographie d’architecture, détection de duplications, onboarding, identification des lacunes de tests, etc.
Par exemple, Architecture Overview demande au modèle d’identifier :
D’autres tâches dans le code complet couvrent :
Code Duplication, qui cible les logiques répétées et les refactorings associés,Improvement Opportunities, qui met en évidence des gains de maintenabilité et de modularité,Testing Gaps, qui souligne les zones sous‑testées,Onboarding Guide, qui explique comment un nouvel·le ingénieur·e doit aborder la base de code,Library Modernization, qui remonte les bibliothèques obsolètes ou redondantes,Code Quality Hotspots, qui pointe les zones fragiles ou sujettes aux bugs,Security ou Config Hygiene, qui signalent des valeurs par défaut risquées ou des problèmes opérationnels.FULL_REVIEW_TASKS = [
"Architecture Overview",
"Improvement Opportunities",
"Code Quality Hotspots",
"Testing Gaps",
"Refactor Roadmap",
]
TASK_CHOICES = [
"Architecture Overview",
"Code Duplication",
"Improvement Opportunities",
"Refactor Roadmap",
"Testing Gaps",
"Onboarding Guide",
"Library Modernization",
"Code Quality Hotspots",
"Security / Config Hygiene",
"Full Review",
]
def safe_str(value: Any) -> str:
if value is None:
return ""
if isinstance(value, str):
return value.strip()
return str(value).strip()La liste FULL_REVIEW_TASKS définit un examen multi‑étapes groupé.
Au lieu d’exécuter toutes les tâches, elle en lance un sous‑ensemble pertinent pour une vue d’ensemble d’ingénierie. TASK_CHOICES alimente directement la liste déroulante dans Gradio pour choisir une tâche unique ou la revue groupée.
Enfin, safe_str() corrige un écueil de stabilité fréquent pendant le dev :
'NoneType' object has no attribute 'strip'Cela arrive lorsque :
None,En normalisant ces valeurs via safe_str(), l’app gagne en robustesse.
Avant d’envoyer quoi que ce soit au modèle, nous devons transformer un dépôt GitHub en un prompt structuré unique.
Cette étape couvre toute l’ingestion : clonage, filtrage des fichiers non pertinents, extraction du texte exploitable et packaging dans un format consommable en une seule fois par le modèle.
Contrairement aux pipelines RAG classiques, nous ne découpons pas et n’embarquons pas : nous compressons tout le dépôt en une seule entrée long‑contexte, d’où l’importance d’être sélectif et structuré pour la performance et la qualité.
def clone_repo(repo_url: str, branch: str = "main") -> str:
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    if not repo_url:
        raise ValueError("Repository URL is empty.")
    if os.path.exists(WORKDIR):
        shutil.rmtree(WORKDIR)
    cmd = ["git", "clone", "--depth", "1"]
    if branch:
        cmd += ["--branch", branch]
    cmd += [repo_url, WORKDIR]
    subprocess.run(cmd, check=True, capture_output=True, text=True)
    return WORKDIR
def is_probably_text(path: Path) -> bool:
    try:
        with open(path, "rb") as f:
            chunk = f.read(2048)
        if b"\x00" in chunk:
            return False
        chunk.decode("utf-8")
        return True
    except Exception:
        return False
def iter_repo_files(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    for path in root.rglob("*"):
        if not path.is_file():
            continue
        rel = path.relative_to(root)
        parts = set(rel.parts)
        rel_str = str(rel).lower()
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        if path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        try:
            if path.stat().st_size > MAX_FILE_BYTES:
                continue
        except Exception:
            continue
        if not is_probably_text(path):
            continue
        yield path
def repo_tree_string(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool) -> str:
    root = Path(root)
    lines: List[str] = []
    for path in sorted(root.rglob("*")):
        rel = path.relative_to(root)
        rel_str = str(rel).lower()
        parts = set(rel.parts)
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if path.is_file() and path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        lines.append(f"{rel}/" if path.is_dir() else str(rel))
    return "\n".join(lines)
def pack_repo(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    tree = repo_tree_string(root, exclude_tests, exclude_docs, exclude_notebooks)
    files: List[Tuple[str, int, str]] = []
    total_tokens = len(enc.encode(tree))
    for path in iter_repo_files(root, exclude_tests, exclude_docs, exclude_notebooks):
        rel = path.relative_to(root)
        try:
            content = path.read_text(encoding="utf-8", errors="ignore")
        except Exception:
            continue
        block = f"\n=== FILE START: {rel} ===\n{content}\n=== FILE END: {rel} ===\n"
        tok = len(enc.encode(block))
        files.append((str(rel), tok, block))
        total_tokens += tok
    return tree, files, total_tokens
def build_repo_context(tree: str, files: List[Tuple[str, int, str]]) -> str:
    joined_files = "".join(block for _, _, block in files)
    return f"""=== REPO TREE START ===
{tree}
=== REPO TREE END ===
=== REPOSITORY FILES START ===
{joined_files}
=== REPOSITORY FILES END ===
"""
Cette étape définit le pipeline complet d’ingestion et d’emballage, avec pour chaque fonction un rôle précis :
clone_repo() : clone un dépôt GitHub dans un répertoire de travail temporaire en mode shallow (--depth 1) pour éviter l’historique complet. Les entrées URL/branche sont normalisées via safe_str(). La sortie est le chemin local (WORKDIR).iter_repo_files() : couche de filtrage principale. Parcourt le repo et ne renvoie que les fichiers à fort signal. Exclut systèmes, types non pris en charge, fichiers trop gros, et optionnellement tests, docs et notebooks. is_probably_text() : vérification légère en lisant un petit bloc et en testant l’absence d’octets nuls et le décodage UTF‑8. Seuls les fichiers qui passent sont inclus.repo_tree_string() : construit une représentation textuelle de la structure du dépôt (en appliquant les mêmes filtres) pour donner au modèle une vue d’ensemble avant le contenu des fichiers.pack_repo() : cœur du packaging. Lit chaque fichier filtré, l’encadre avec === FILE START ===/=== FILE END ===, estime les jetons via tiktoken et cumule le total. build_repo_context() : assemble tout dans un prompt structuré unique : l’arborescence d’abord, puis les fichiers. Le modèle comprend la structure avant de lire l’implémentation.Résultat : un dépôt GitHub brut transformé en une entrée long‑contexte structurée.
Le dépôt étant filtré et packagé en une seule entrée, nous devons indiquer au modèle quel type d’analyse produire et sous quel format.
Plutôt que d’envoyer une instruction générique, nous générons un prompt spécifique à la tâche, incluant son nom, sa description et le schéma JSON exact attendu en réponse.
def build_task_prompt(task_name: str, repo_context: str) -> str:
    task_name = safe_str(task_name)
    if not task_name:
        raise ValueError("Task name is empty.")
    if task_name not in TASK_DEFS:
        raise ValueError(f"Unknown task: {task_name}")
    task_def = TASK_DEFS[task_name]
    return f"""Analyze this full repository.
Task Name:
{task_name}
Task Description:
{task_def["description"]}
Return JSON matching this schema exactly:
{json.dumps(task_def["schema"], indent=2)}
{repo_context}
"""
def try_parse_json(text: str) -> Dict[str, Any]:
    text = safe_str(text)
    if not text:
        raise ValueError("Model returned empty text.")
    try:
        return orjson.loads(text)
    except Exception:
        start = text.find("{")
        end = text.rfind("}")
        if start != -1 and end != -1 and end > start:
            return orjson.loads(text[start:end+1])
        raise ValueError("Could not parse model output as JSON.")
Ce snippet définit deux fonctions qui font le lien entre dépôt packagé et sortie d’analyse spécifique.
build_task_prompt() : crée le prompt final envoyé au modèle. Normalise le nom de tâche avec safe_str(), vérifie son existence dans TASK_DEFS, puis insère description, schéma JSON et contexte du dépôt.try_parse_json() : gère la sortie du modèle après inférence. Les modèles long‑contexte encapsulent parfois le JSON avec du texte parasite. La fonction tente d’abord un parsing direct (orjson.loads()), puis extrait la portion JSON entre la première { et la dernière } si nécessaire. Un prompting strict combiné à un parsing tolérant rend l’app bien plus stable.À l’étape suivante, nous relierons cette logique au call modèle pour produire des analyses structurées.
Nous exécutons maintenant l’analyse en envoyant le prompt à Nemotron 3 Super via OpenRouter.
Plutôt que de découper ou de récupérer des parties du repo, nous envoyons l’ensemble du code filtré en une seule requête et laissons le modèle raisonner globalement entre fichiers, modules et dépendances.
def call_model(prompt: str, max_tokens: int = 5000) -> str:
    prompt = safe_str(prompt)
    if not prompt:
        raise ValueError("Prompt is empty.")
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
        ],
        temperature=0.2,
        max_tokens=max_tokens,
        extra_headers={
            "HTTP-Referer": "https://colab.research.google.com",
            "X-Title": "Whole Repo Analysis Demo"
        }
    )
    if not getattr(resp, "choices", None):
        raise ValueError("Model response has no choices.")
    message = getattr(resp.choices[0], "message", None)
    if message is None:
        raise ValueError("Model response has no message.")
    content = getattr(message, "content", None)
    content = safe_str(content)
    if not content:
        raise ValueError("Model returned empty content.")
    return content
La fonction call_model() exécute l’appel au modèle et extrait la réponse :
temperature à 0,2 pour des sorties plus déterministes, max_tokens pour borner la taille de réponse.Nous pouvons maintenant passer à l’inférence et comprendre l’exécution via le modèle hébergé OpenRouter.
Il nous faut quelques petites fonctions pour faciliter l’UI et la gestion des sorties.
def to_df(items, columns=None):
    if items is None:
        return pd.DataFrame(columns=columns or [])
    if isinstance(items, dict):
        return pd.DataFrame([items])
    if not items:
        return pd.DataFrame(columns=columns or [])
    return pd.DataFrame(items)
def get_tasks_to_run(task: str) -> List[str]:
    task = safe_str(task)
    if not task:
        raise ValueError("Task is empty.")
    return FULL_REVIEW_TASKS if task == "Full Review" else [task]
def visible_for_task(task: str) -> Dict[str, bool]:
    task = safe_str(task)
    if task == "Full Review":
        return {
            "modules": True,
            "deps": True,
            "issues": True,
            "dups": False,
            "refactor": False,
            "improvements": True,
            "roadmap": True,
            "testing": True,
            "onboarding": False,
            "libs": False,
            "hotspots": True,
            "security": False,
        }
    return {
        "modules": task == "Architecture Overview",
        "deps": task == "Architecture Overview",
        "issues": task == "Architecture Overview",
        "dups": task == "Code Duplication",
        "refactor": task == "Code Duplication",
        "improvements": task == "Improvement Opportunities",
        "roadmap": task == "Refactor Roadmap",
        "testing": task == "Testing Gaps",
        "onboarding": task == "Onboarding Guide",
        "libs": task == "Library Modernization",
        "hotspots": task == "Code Quality Hotspots",
        "security": task == "Security / Config Hygiene",
    }
def render_markdown_summary(repo_url: str, total_tokens: int, files, results: Dict[str, Dict[str, Any]]) -> str:
    repo_url = safe_str(repo_url)
    lines = [
        "# Whole-Repo Analysis Report",
        f"**Repository:** {repo_url}",
        f"**Files included:** {len(files)}",
        f"**Estimated input tokens:** {total_tokens}",
        "",
    ]
    if "Architecture Overview" in results:
        overview = results["Architecture Overview"].get("repo_overview", {})
        lines += [
            "## Architecture",
            overview.get("summary", "No summary returned."),
            "",
            f"**Primary languages:** {', '.join(overview.get('primary_languages', [])) or 'N/A'}",
            f"**Likely entrypoints:** {', '.join(overview.get('likely_entrypoints', [])) or 'N/A'}",
            "",
        ]
    if "Improvement Opportunities" in results:
        lines += [
            "## Improvement Opportunities",
            f"- Identified: {len(results['Improvement Opportunities'].get('improvement_opportunities', []))}",
            "",
        ]
    if "Code Quality Hotspots" in results:
        lines += [
            "## Code Quality Hotspots",
            f"- Identified: {len(results['Code Quality Hotspots'].get('quality_hotspots', []))}",
            "",
        ]
    if "Testing Gaps" in results:
        lines += [
            "## Testing Gaps",
            f"- Identified: {len(results['Testing Gaps'].get('testing_gaps', []))}",
            "",
        ]
    if "Code Duplication" in results:
        dup = results["Code Duplication"]
        lines += [
            "## Duplication & Refactor Summary",
            f"- Duplication candidates: {len(dup.get('duplication_candidates', []))}",
            f"- Design smells: {len(dup.get('design_smells', []))}",
            f"- High risk files: {len(dup.get('high_risk_files', []))}",
            f"- Refactor recommendations: {len(dup.get('refactor_recommendations', []))}",
            "",
        ]
    if "Library Modernization" in results:
        lines += [
            "## Library Modernization",
            f"- Recommendations: {len(results['Library Modernization'].get('library_recommendations', []))}",
            "",
        ]
    if "Security / Config Hygiene" in results:
        lines += [
            "## Security / Config Hygiene",
            f"- Findings: {len(results['Security / Config Hygiene'].get('security_and_config_findings', []))}",
            "",
        ]
    if "Refactor Roadmap" in results:
        lines += [
            "## Refactor Roadmap",
            f"- Planned items: {len(results['Refactor Roadmap'].get('refactor_roadmap', []))}",
            "",
        ]
    if "Onboarding Guide" in results:
        onboarding = results["Onboarding Guide"].get("onboarding_guide", {})
        lines += [
            "## Onboarding Guide",
            onboarding.get("summary", "No summary returned."),
            "",
            f"**Recommended reading order:** {', '.join(onboarding.get('recommended_reading_order', [])) or 'N/A'}",
            f"**Entrypoints:** {', '.join(onboarding.get('entrypoints', [])) or 'N/A'}",
            "",
        ]
    return "\n".join(lines)
def hidden_update():
    return gr.update(value=pd.DataFrame(), visible=False)
def visible_update(df):
    return gr.update(value=df, visible=True)
def empty_outputs(stats, status_message):
    return (
        status_message,
        "",
        *all_hidden(),
        "{}",
        json.dumps(stats, indent=2),
    )
Ces utilitaires gèrent l’essentiel de la présentation de l’app.
to_df() : convertit les sorties du modèle en DataFrame pandas pour un rendu propre dans Gradio. get_tasks_to_run() : décide d’exécuter une tâche unique ou la Full Review groupée.visible_for_task() : contrôle quelles tables afficher selon la tâche (inutile, par exemple, d’afficher la duplication pour un Onboarding Guide).render_markdown_summary() : génère un résumé lisible avec métadonnées du dépôt, nombre de jetons et points saillants par tâche.hidden_update() et visible_update() : petits helpers Gradio pour l’état des composants (vider/masquer vs remplir/afficher).empty_outputs() : gère les sorties en cas d’arrêt anticipé ou d’erreur tout en alimentant correctement l’UI.Ces helpers ne changent pas la logique du modèle mais rendent l’application exploitable.
Cette fonction orchestre l’ensemble du workflow : validation des entrées, préparation du repo, exécution des tâches et renvoi des sorties structurées dans Gradio.
def analyze_repo(repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks):
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    task = safe_str(task)
    try:
        if not repo_url:
            stats = {"repo_url": "", "branch": branch}
            return empty_outputs(stats, "Error: Repository URL is empty.")
        if not task:
            stats = {"repo_url": repo_url, "branch": branch}
            return empty_outputs(stats, "Error: Task is empty.")
        repo_path = clone_repo(repo_url, branch)
        tree, files, total_tokens = pack_repo(repo_path, exclude_tests, exclude_docs, exclude_notebooks)
        stats = {
            "repo_url": repo_url,
            "branch": branch,
            "files_included": len(files),
            "estimated_input_tokens": total_tokens,
            "token_budget": token_budget,
            "fits_budget": total_tokens <= token_budget,
            "sample_files": [f[0] for f in files[:30]],
            "tasks_requested": get_tasks_to_run(task),
        }
        if total_tokens > token_budget:
            msg = (
                f"Repo too large for current budget.\n\n"
                f"Estimated tokens: {total_tokens}\n"
                f"Budget: {token_budget}\n\n"
                f"Try excluding tests/docs/notebooks or use a smaller repo."
            )
            return empty_outputs(stats, msg)
        repo_context = build_repo_context(tree, files)
        tasks_to_run = get_tasks_to_run(task)
        results: Dict[str, Dict[str, Any]] = {}
        for task_name in tasks_to_run:
            prompt = build_task_prompt(task_name, repo_context)
            raw_text = call_model(prompt)
            results[task_name] = try_parse_json(raw_text)
        report_md = render_markdown_summary(repo_url, total_tokens, files, results)
        vis = visible_for_task(task)
        arch_json = results.get("Architecture Overview", {})
        dup_json = results.get("Code Duplication", {})
        imp_json = results.get("Improvement Opportunities", {})
        roadmap_json = results.get("Refactor Roadmap", {})
        testing_json = results.get("Testing Gaps", {})
        onboarding_json = results.get("Onboarding Guide", {})
        lib_json = results.get("Library Modernization", {})
        hotspot_json = results.get("Code Quality Hotspots", {})
        security_json = results.get("Security / Config Hygiene", {})
        modules_df = to_df(arch_json.get("modules", []), ["name", "responsibility", "key_files", "evidence_paths"])
        deps_df = to_df(arch_json.get("dependencies", []), ["from_module", "to_module", "relationship", "evidence_paths"])
        issues_df = to_df(arch_json.get("issues", []), ["type", "description", "severity", "evidence_paths"])
        dups_df = to_df(dup_json.get("duplication_candidates", []), ["summary", "files_involved", "why_it_looks_duplicate", "confidence"])
        refactor_df = to_df(dup_json.get("refactor_recommendations", []), ["title", "description", "target_files", "expected_benefit"])
        improvements_df = to_df(imp_json.get("improvement_opportunities", []), ["title", "description", "why_it_matters", "affected_files", "suggested_change", "expected_impact", "effort", "evidence_paths"])
        roadmap_df = to_df(roadmap_json.get("refactor_roadmap", []), ["priority", "title", "description", "target_files", "impact", "effort", "why_now"])
        testing_df = to_df(testing_json.get("testing_gaps", []), ["module_or_file", "why_it_needs_tests", "likely_missing_cases", "recommended_test_type", "evidence_paths"])
        onboarding_df = to_df(onboarding_json.get("onboarding_guide", {}), ["summary", "recommended_reading_order", "entrypoints", "important_directories", "debugging_start_points", "common_confusion_points"])
        libs_df = to_df(lib_json.get("library_recommendations", []), ["current_library_or_pattern", "where_used", "suggested_alternative", "why_better", "migration_difficulty", "confidence", "evidence_paths", "recommendation_type"])
        hotspots_df = to_df(hotspot_json.get("quality_hotspots", []), ["file_or_module", "risk_level", "why_it_is_a_hotspot", "evidence_paths", "recommended_cleanup"])
        security_df = to_df(security_json.get("security_and_config_findings", []), ["title", "severity", "description", "affected_files", "evidence_paths", "recommended_fix", "confidence"])
        status = (
            f"Done.\n\n"
            f"Files included: {len(files)}\n"
            f"Estimated input tokens: {total_tokens}\n"
            f"Tasks run: {', '.join(tasks_to_run)}"
        )
        return (
            status,
            report_md,
            visible_update(modules_df) if vis["modules"] else hidden_update(),
            visible_update(deps_df) if vis["deps"] else hidden_update(),
            visible_update(issues_df) if vis["issues"] else hidden_update(),
            visible_update(dups_df) if vis["dups"] else hidden_update(),
            visible_update(refactor_df) if vis["refactor"] else hidden_update(),
            visible_update(improvements_df) if vis["improvements"] else hidden_update(),
            visible_update(roadmap_df) if vis["roadmap"] else hidden_update(),
            visible_update(testing_df) if vis["testing"] else hidden_update(),
            visible_update(onboarding_df) if vis["onboarding"] else hidden_update(),
            visible_update(libs_df) if vis["libs"] else hidden_update(),
            visible_update(hotspots_df) if vis["hotspots"] else hidden_update(),
            visible_update(security_df) if vis["security"] else hidden_update(),
            json.dumps(results, indent=2),
            json.dumps(stats, indent=2),
        )
    except subprocess.CalledProcessError as e:
        stats = {"repo_url": repo_url, "branch": branch}
        stderr = safe_str(getattr(e, "stderr", "")) or safe_str(e)
        return empty_outputs(stats, f"Git clone failed:\n{stderr}")
    except Exception as e:
        stats = {"repo_url": repo_url, "branch": branch}
        return empty_outputs(stats, f"Error: {safe_str(e)}")
Cette fonction orchestre le pipeline, du repo brut à la sortie structurée.
to_df() et mapping aux composants, avec visibilité pilotée par visible_for_task().empty_outputs() pour garder l’UI stable.Enfin, encapsulons le tout dans une interface Gradio simple.
with gr.Blocks(title="Nemotron Repo Analyzer") as demo:
    gr.Markdown("# Nemotron Repo Analyzer")
    # gr.Markdown("Analyze a public GitHub repository without RAG using a single packed prompt.")
    with gr.Tab("Analyze"):
        with gr.Row():
            repo_url = gr.Textbox(
                label="GitHub Repo URL",
                value="https://github.com/AashiDutt/Nemotron-3-Nano.git"
            )
            branch = gr.Textbox(label="Branch", value="main")
        with gr.Row():
            task = gr.Dropdown(
                choices=TASK_CHOICES,
                value="Full Review",
                label="Task"
            )
            token_budget = gr.Slider(
                minimum=40000,
                maximum=180000,
                step=5000,
                value=120000,
                label="Token Budget"
            )
        with gr.Row():
            exclude_tests = gr.Checkbox(value=False, label="Exclude tests")
            exclude_docs = gr.Checkbox(value=False, label="Exclude docs / markdown")
            exclude_notebooks = gr.Checkbox(value=True, label="Exclude notebooks")
        analyze_btn = gr.Button("Analyze Repo", variant="primary")
        status = gr.Textbox(label="Status", lines=7)
    with gr.Tab("Report"):
        report_md = gr.Markdown()
        modules_df = gr.Dataframe(label="Modules", visible=False)
        deps_df = gr.Dataframe(label="Dependencies", visible=False)
        issues_df = gr.Dataframe(label="Architecture Issues", visible=False)
        dups_df = gr.Dataframe(label="Duplication Candidates", visible=False)
        refactor_df = gr.Dataframe(label="Refactor Recommendations", visible=False)
        improvements_df = gr.Dataframe(label="Improvement Opportunities", visible=False)
        roadmap_df = gr.Dataframe(label="Refactor Roadmap", visible=False)
        testing_df = gr.Dataframe(label="Testing Gaps", visible=False)
        onboarding_df = gr.Dataframe(label="Onboarding Guide", visible=False)
        libs_df = gr.Dataframe(label="Library Modernization", visible=False)
        hotspots_df = gr.Dataframe(label="Code Quality Hotspots", visible=False)
        security_df = gr.Dataframe(label="Security / Config Hygiene", visible=False)
    with gr.Tab("Raw JSON"):
        all_results_json_box = gr.Code(label="All Task Results JSON", language="json")
        stats_box = gr.Code(label="Run Stats", language="json")
    analyze_btn.click(
        analyze_repo,
        inputs=[repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks],
        outputs=[
            status,
            report_md,
            modules_df,
            deps_df,
            issues_df,
            dups_df,
            refactor_df,
            improvements_df,
            roadmap_df,
            testing_df,
            onboarding_df,
            libs_df,
            hotspots_df,
            security_df,
            all_results_json_box,
            stats_box,
        ]
    )
demo.launch(debug=True, share=True)
Le conteneur gr.Blocks() définit la mise en page, tandis que le Markdown de tête fixe le titre et le contexte. L’interface est organisée en trois onglets.
Cela relie directement les entrées utilisateur à analyze_repo() et mappe ses sorties aux composants UI. L’ordre des sorties est crucial : chaque valeur renvoie à un élément précis.
Enfin, l’app est lancée avec :
demo.launch(debug=True, share=True)Le flag debug=True facilite le débogage, et share=True crée un lien public pour partager l’app sans déploiement.
Dans ce tutoriel, j’ai montré comment créer un analyseur de base de code avec NVIDIA Nemotron 3 Super, OpenRouter et Gradio.
Plutôt que de s’appuyer sur le découpage, les embeddings et le retrieval, l’app clone un dépôt GitHub public, filtre et packe la base de code dans un seul prompt, puis demande au modèle de raisonner sur l’ensemble du dépôt d’un bloc.
Cette approche « contexte global » est utile pour les tâches nécessitant une vision d’ensemble : explication d’architecture, onboarding, analyse des lacunes de tests, opportunités d’amélioration et feuille de route de refactor.
Vous pouvez prolonger le projet de plusieurs façons :
Top DataCamp Courses
Cours
Cours
Cours
blog
Kurtis Pykes
15 min
blog
Kurtis Pykes
9 min
blog
Nathaniel Taylor-Leach
8 min
Tutoriel
Tutoriel
Josef Waples
8 min
Tutoriel
Stephen Gruppetta
12 min