Curso
Projetando Sistemas Agentes com LangChain
3 h
14.8K
Você pode acessar o código completo deste demo aqui.
Nemotron 3 Super é o modelo aberto de raciocínio da NVIDIA para fluxos agentic e de contexto longo. Ele usa uma arquitetura híbrida Mamba-Transformer com Latent MoE, com 120B parâmetros totais e 12B ativos, inclui predição multi-token (MTP) e é projetado para tarefas pesadas de raciocínio como codificação, uso de ferramentas e análise de contexto longo.
A NVIDIA o posiciona especificamente para aplicações complexas de múltiplos agentes e raciocínio sobre bases de código inteiras.
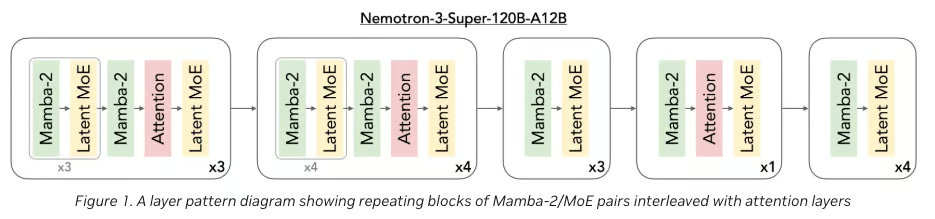
Figura 1: arquitetura do Nemotron 3 Super (NVIDIA Blog)
Algumas ideias centrais por trás do Nemotron 3 Super incluem:
Para este tutorial, usaremos o endpoint gratuito hospedado no OpenRouter, já que as variantes completa e quantizada do modelo normalmente exigem ao menos uma GPU H100 para inferência prática. O endpoint hospedado atualmente suporta uma janela de contexto de 262K tokens (em vez de 1M), o que ainda é suficiente para analisar repositórios de porte médio neste demo.
A família Nemotron 3 foi apresentada como uma linha aberta de modelos para sistemas de IA agentic, com tamanhos diferentes voltados a necessidades distintas de deployment e raciocínio: camadas Nemotron Nano, Super e Ultra.
Na prática, você pode pensar na família assim:
Assim, o Nemotron 3 Super é a escolha certa aqui porque queremos um modelo que consiga raciocinar sobre o repositório inteiro de uma vez, e não apenas resolver subtarefas isoladas de código.
Nesta seção, vamos construir um analisador de repositório usando o Nemotron 3 Super com uma interface em Gradio. Em alto nível, o app final faz o seguinte:
Vamos construir passo a passo.
Antes de criar o analisador, precisamos de um ambiente mínimo que dê conta de três responsabilidades centrais: renderização da UI, processamento do repositório e interação com o modelo. Como não vamos rodar o Nemotron localmente, o setup fica leve e focado.
Instale tudo executando:
!pip -q install gradio openai tiktoken gitpython orjson pandasNeste projeto, vamos usar:
openai para interagir com a API do OpenRouter (endpoint do Nemotron)gradio para construir a UI interativatiktoken para estimar o uso de tokens antes de enviar os promptsorjson para parsing rápido de JSON nas respostas do modelopandas para exibir resultados estruturados em tabelasgitpython para clonar e trabalhar com repositóriosDiferente de setups locais de LLM (que exigem CUDA, vLLM ou quantização), esta abordagem evita dependências de GPU e mantém o ambiente amigável ao Colab.
Neste passo, configuramos o Nemotron 3 Super via OpenRouter e definimos algumas constantes que controlam como os repositórios são processados. Como não estamos executando o modelo localmente, este cliente vira a interface central para enviar prompts grandes e empacotados e receber saídas estruturadas de análise.
OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")
MODEL = "nvidia/nemotron-3-super-120b-a12b:free"
WORKDIR = "/content/repo_ui"
if not OPENROUTER_API_KEY:
    raise ValueError("Set OPENROUTER_API_KEY in environment before running.")
client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=OPENROUTER_API_KEY,
)
enc = tiktoken.get_encoding("cl100k_base")
Neste estágio, o app se comunica com o Nemotron 3 Super via OpenRouter usando o cliente Python openai configurado com um base_url customizado e uma API key armazenada em OPENROUTER_API_KEY.
O modelo selecionado aponta para o endpoint hospedado do OpenRouter, permitindo rodar um modelo muito grande sem precisar de infraestrutura de GPU local.
Para gerenciar o tamanho do contexto, inicializamos um tokenizador (tiktoken com cl100k_base) para estimar quantos tokens o repositório empacotado vai consumir antes de enviá-lo ao modelo, já que a janela de contexto é finita.
Algumas considerações práticas:
Agora precisamos de duas salvaguardas: filtragem de arquivos e ancoragem do prompt.
A primeira evita desperdiçar contexto com artefatos irrelevantes como outputs de build, notebooks, imagens ou arquivos binários.
A segunda garante que, uma vez empacotado, o modelo permaneça ancorado no código real em vez de derivar para conselhos genéricos de engenharia de software.
Juntas, essas regras tornam a análise mais eficiente.
BASE_IGNORE_DIRS = {
    ".git", ".github", "__pycache__", "node_modules", ".venv", "venv",
    "dist", "build", ".mypy_cache", ".pytest_cache", ".idea", ".vscode"
}
IGNORE_SUFFIXES = {
    ".png", ".jpg", ".jpeg", ".gif", ".webp", ".pdf", ".zip", ".gz",
    ".tar", ".mp4", ".mov", ".onnx", ".pt", ".bin", ".parquet", ".feather",
    ".ico", ".svg", ".lock"
}
MAX_FILE_BYTES = 250_000
SYSTEM_PROMPT = """You are a codebase analysis model.
You are given the complete repository contents in one prompt.
Rules:
1. Use only the provided repository content.
2. Do not invent files, modules, libraries, or dependencies.
3. Every substantial claim must cite one or more file paths.
4. Clearly separate direct observations from engineering inferences or recommendations.
5. For modernization or improvement suggestions, explicitly distinguish:
   - repo-grounded findings
   - general engineering recommendations
6. Return valid JSON only.
7. If uncertain, say so explicitly.
8. For anything involving security, dead code, dependency replacement, or testing gaps,
   present findings as likely candidates unless directly proven by repository content.
"""
As três variáveis de filtragem a seguir controlam o pré-processamento do repositório:
BASE_IGNORE_DIRS exclui diretórios irrelevantes à análise de código ou barulhentos demais, como .git, node_modules, pastas de build e caches específicos de editor. IGNORE_SUFFIXES filtra tipos de arquivo que geralmente não ajudam no raciocínio sobre o repositório, incluindo imagens, arquivos compactados, vídeos, checkpoints de modelo e outros artefatos. MAX_FILE_BYTES adiciona uma verificação extra, ignorando arquivos grandes demais e ajudando a manter o repositório empacotado dentro de um orçamento de contexto prático.O SYSTEM_PROMPT é tão importante quanto os filtros.
Como o modelo vê o repositório como um único prompt longo, precisamos fornecer limites comportamentais claros para evitar invenção de módulos, leituras equivocadas de abstrações ou recomendações genéricas demais.
Essas instruções forçam o modelo a ficar ancorado no repositório fornecido, citar caminhos de arquivo para afirmações importantes e separar evidências diretas de julgamentos gerais.
Com a filtragem de arquivos e o prompt do sistema prontos, o próximo passo é definir um conjunto de tarefas para todo o repositório, cada uma com um esquema JSON estruturado.
Isso traz dois benefícios: o modelo sabe exatamente que tipo de saída produzir e o app consegue fazer parsing e renderizar resultados de forma confiável em tabelas específicas por tarefa.
TASK_DEFS: Dict[str, Dict[str, Any]] = {
    "Architecture Overview": {
        "description": "Explain the architecture, major modules, likely entrypoints, dependencies, and architectural issues.",
        "schema": {
            "repo_overview": {
                "summary": "",
                "primary_languages": [],
                "likely_entrypoints": []
            },
            "modules": [
                {
                    "name": "",
                    "responsibility": "",
                    "key_files": [],
                    "evidence_paths": []
                }
            ],
            "dependencies": [
                {
                    "from_module": "",
                    "to_module": "",
                    "relationship": "",
                    "evidence_paths": []
                }
            ],
            "issues": [
                {
                    "type": "",
                    "description": "",
                    "severity": "low|medium|high",
                    "evidence_paths": []
                }
            ],
            "unknowns_and_uncertainties": []
        },
    },
    ...
}
O dicionário TASK_DEFS funciona como o registro central de todos os modos de análise suportados pelo app.
Cada tarefa contém uma descrição em linguagem natural que diz ao modelo o que fazer e um esquema rígido que define o JSON esperado como saída.
É isso que permite que o mesmo repositório empacotado suporte formas bem diferentes de raciocínio, como mapeamento de arquitetura, análise de duplicação, orientação de onboarding ou detecção de lacunas de testes.
Por exemplo, Architecture Overview pede ao modelo para identificar:
Outras tarefas no código completo incluem:
Code Duplication, focada em lógica repetida e oportunidades de refatoração relacionadas,Improvement Opportunities, que identifica ganhos de manutenibilidade e modularidade,Testing Gaps destaca áreas pouco testadas,Onboarding Guide explica como um engenheiro novo deve abordar a base de código,Library Modernization expõe bibliotecas desatualizadas ou sobrepostas,Code Quality Hotspots aponta áreas frágeis ou propensas a bugs,Security ou Config Hygiene sinaliza padrões arriscados ou problemas operacionais.FULL_REVIEW_TASKS = [
"Architecture Overview",
"Improvement Opportunities",
"Code Quality Hotspots",
"Testing Gaps",
"Refactor Roadmap",
]
TASK_CHOICES = [
"Architecture Overview",
"Code Duplication",
"Improvement Opportunities",
"Refactor Roadmap",
"Testing Gaps",
"Onboarding Guide",
"Library Modernization",
"Code Quality Hotspots",
"Security / Config Hygiene",
"Full Review",
]
def safe_str(value: Any) -> str:
if value is None:
return ""
if isinstance(value, str):
return value.strip()
return str(value).strip()A lista FULL_REVIEW_TASKS define uma revisão multietapas agrupada.
Em vez de executar todas as tarefas possíveis, ela roda um subconjunto curado que oferece uma visão ampla de engenharia do repositório. TASK_CHOICES é usado diretamente no dropdown do Gradio para o usuário escolher uma única tarefa ou a revisão completa.
A última parte, safe_str(), resolve um problema de estabilidade surpreendentemente comum. Durante o desenvolvimento, um modo de falha recorrente era:
'NoneType' object has no attribute 'strip'Isso acontece quando:
None,Ao normalizar esses valores com a função safe_str(), deixamos o app muito mais robusto.
Antes de enviar qualquer coisa ao modelo, precisamos transformar um repositório GitHub em um único prompt estruturado.
Esta etapa cobre todo o pipeline de ingestão: clonar o repo, filtrar arquivos irrelevantes, extrair apenas texto útil e empacotar tudo em um formato que o modelo consiga consumir de uma vez.
Diferente de pipelines de RAG, não vamos fazer chunking nem embeddings. Vamos comprimir o repositório inteiro em uma única entrada de contexto longo, então ser seletivo e estruturado aqui é crucial para desempenho e qualidade.
def clone_repo(repo_url: str, branch: str = "main") -> str:
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    if not repo_url:
        raise ValueError("Repository URL is empty.")
    if os.path.exists(WORKDIR):
        shutil.rmtree(WORKDIR)
    cmd = ["git", "clone", "--depth", "1"]
    if branch:
        cmd += ["--branch", branch]
    cmd += [repo_url, WORKDIR]
    subprocess.run(cmd, check=True, capture_output=True, text=True)
    return WORKDIR
def is_probably_text(path: Path) -> bool:
    try:
        with open(path, "rb") as f:
            chunk = f.read(2048)
        if b"\x00" in chunk:
            return False
        chunk.decode("utf-8")
        return True
    except Exception:
        return False
def iter_repo_files(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    for path in root.rglob("*"):
        if not path.is_file():
            continue
        rel = path.relative_to(root)
        parts = set(rel.parts)
        rel_str = str(rel).lower()
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        if path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        try:
            if path.stat().st_size > MAX_FILE_BYTES:
                continue
        except Exception:
            continue
        if not is_probably_text(path):
            continue
        yield path
def repo_tree_string(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool) -> str:
    root = Path(root)
    lines: List[str] = []
    for path in sorted(root.rglob("*")):
        rel = path.relative_to(root)
        rel_str = str(rel).lower()
        parts = set(rel.parts)
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if path.is_file() and path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        lines.append(f"{rel}/" if path.is_dir() else str(rel))
    return "\n".join(lines)
def pack_repo(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    tree = repo_tree_string(root, exclude_tests, exclude_docs, exclude_notebooks)
    files: List[Tuple[str, int, str]] = []
    total_tokens = len(enc.encode(tree))
    for path in iter_repo_files(root, exclude_tests, exclude_docs, exclude_notebooks):
        rel = path.relative_to(root)
        try:
            content = path.read_text(encoding="utf-8", errors="ignore")
        except Exception:
            continue
        block = f"\n=== FILE START: {rel} ===\n{content}\n=== FILE END: {rel} ===\n"
        tok = len(enc.encode(block))
        files.append((str(rel), tok, block))
        total_tokens += tok
    return tree, files, total_tokens
def build_repo_context(tree: str, files: List[Tuple[str, int, str]]) -> str:
    joined_files = "".join(block for _, _, block in files)
    return f"""=== REPO TREE START ===
{tree}
=== REPO TREE END ===
=== REPOSITORY FILES START ===
{joined_files}
=== REPOSITORY FILES END ===
"""
Esta etapa define todo o pipeline de ingestão e empacotamento, e cada função tem uma responsabilidade específica:
função clone_repo(): Clona um repositório GitHub para um diretório temporário usando clone raso (--depth 1) para evitar baixar o histórico completo. Entradas como URL do repo e branch são normalizadas com safe_str() para prevenir erros de runtime. A saída é um caminho local (WORKDIR) usado pelo restante do pipeline.função iter_repo_files(): Camada principal de filtragem. Vasculha recursivamente o repositório e retorna apenas arquivos de alto sinal. Exclui diretórios de sistema, tipos de arquivo não suportados, arquivos grandes e, opcionalmente, testes, documentação e notebooks. função is_probably_text(): Verificação leve usada na filtragem. Lê um pequeno trecho de cada arquivo e verifica ausência de bytes nulos (indicando conteúdo binário) e decodificação UTF-8 bem-sucedida. Só arquivos aprovados seguem para o conjunto final.função repo_tree_string(): Constrói uma representação em string da estrutura do repositório. Cria uma árvore de diretórios (aplicando as mesmas regras) com listas de pastas e arquivos, usada no prompt para o modelo entender o layout antes do conteúdo dos arquivos.função pack_repo(): Função central de empacotamento. Itera sobre os arquivos filtrados, lê o conteúdo e envolve cada arquivo com marcadores explícitos como === FILE START === e === FILE END ===. Também estima o uso de tokens com tiktoken e acumula o total. função build_repo_context(): Combina tudo em um único prompt estruturado. Primeiro a árvore do repo, seguida do conteúdo dos arquivos. O modelo entende a estrutura e depois lê os detalhes de implementação.O efeito final é transformar um repositório GitHub bruto em uma única entrada estruturada de contexto longo.
Com o repositório filtrado e empacotado em uma única entrada, o próximo passo é dizer ao modelo qual análise executar e como formatar o resultado.
Em vez de enviar a mesma instrução genérica para todos os casos, geramos um prompt específico por tarefa que inclui o nome escolhido, sua descrição e o esquema JSON exato esperado na resposta.
def build_task_prompt(task_name: str, repo_context: str) -> str:
    task_name = safe_str(task_name)
    if not task_name:
        raise ValueError("Task name is empty.")
    if task_name not in TASK_DEFS:
        raise ValueError(f"Unknown task: {task_name}")
    task_def = TASK_DEFS[task_name]
    return f"""Analyze this full repository.
Task Name:
{task_name}
Task Description:
{task_def["description"]}
Return JSON matching this schema exactly:
{json.dumps(task_def["schema"], indent=2)}
{repo_context}
"""
def try_parse_json(text: str) -> Dict[str, Any]:
    text = safe_str(text)
    if not text:
        raise ValueError("Model returned empty text.")
    try:
        return orjson.loads(text)
    except Exception:
        start = text.find("{")
        end = text.rfind("}")
        if start != -1 and end != -1 and end > start:
            return orjson.loads(text[start:end+1])
        raise ValueError("Could not parse model output as JSON.")
O snippet acima define duas funções que fazem a ponte entre o repositório empacotado e a saída de análise específica por tarefa.
função build_task_prompt() : cria o prompt final enviado ao modelo. Primeiro normaliza o nome da tarefa com safe_str(). Em seguida valida se a tarefa existe em TASK_DEFS, prevenindo nomes inválidos. Então busca a descrição e o esquema JSON da tarefa e incorpora ambos ao prompt, junto com o contexto completo do repositório.função try_parse_json(): lida com a saída do modelo após a inferência. Na prática, modelos de contexto longo às vezes envolvem o JSON com texto extra ou artefatos. Para maior robustez, a função tenta primeiro fazer parsing direto com orjson.loads() e, se falhar, tenta extrair o bloco JSON entre chaves. Combinando prompting rigoroso e parsing tolerante, o app fica mais estável.No próximo passo, vamos conectar essa lógica de prompting à chamada do modelo e começar a gerar resultados estruturados de análise.
Aqui rodamos a análise enviando o prompt ao Nemotron 3 Super via OpenRouter.
Em vez de dividir ou recuperar partes do repo, enviamos todo o código filtrado em uma única requisição e deixamos o modelo raciocinar globalmente entre arquivos, módulos e dependências.
def call_model(prompt: str, max_tokens: int = 5000) -> str:
    prompt = safe_str(prompt)
    if not prompt:
        raise ValueError("Prompt is empty.")
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
        ],
        temperature=0.2,
        max_tokens=max_tokens,
        extra_headers={
            "HTTP-Referer": "https://colab.research.google.com",
            "X-Title": "Whole Repo Analysis Demo"
        }
    )
    if not getattr(resp, "choices", None):
        raise ValueError("Model response has no choices.")
    message = getattr(resp.choices[0], "message", None)
    if message is None:
        raise ValueError("Model response has no message.")
    content = getattr(message, "content", None)
    content = safe_str(content)
    if not content:
        raise ValueError("Model returned empty content.")
    return content
A função call_model() executa a chamada ao modelo e extrai a resposta. O pipeline completo:
0.2 mantém os outputs mais determinísticos e max_tokens limita o tamanho da resposta.Agora podemos avançar para a parte de inferência via modelo hospedado no OpenRouter.
Precisamos de algumas funções auxiliares que facilitem a UI e o tratamento das saídas.
def to_df(items, columns=None):
    if items is None:
        return pd.DataFrame(columns=columns or [])
    if isinstance(items, dict):
        return pd.DataFrame([items])
    if not items:
        return pd.DataFrame(columns=columns or [])
    return pd.DataFrame(items)
def get_tasks_to_run(task: str) -> List[str]:
    task = safe_str(task)
    if not task:
        raise ValueError("Task is empty.")
    return FULL_REVIEW_TASKS if task == "Full Review" else [task]
def visible_for_task(task: str) -> Dict[str, bool]:
    task = safe_str(task)
    if task == "Full Review":
        return {
            "modules": True,
            "deps": True,
            "issues": True,
            "dups": False,
            "refactor": False,
            "improvements": True,
            "roadmap": True,
            "testing": True,
            "onboarding": False,
            "libs": False,
            "hotspots": True,
            "security": False,
        }
    return {
        "modules": task == "Architecture Overview",
        "deps": task == "Architecture Overview",
        "issues": task == "Architecture Overview",
        "dups": task == "Code Duplication",
        "refactor": task == "Code Duplication",
        "improvements": task == "Improvement Opportunities",
        "roadmap": task == "Refactor Roadmap",
        "testing": task == "Testing Gaps",
        "onboarding": task == "Onboarding Guide",
        "libs": task == "Library Modernization",
        "hotspots": task == "Code Quality Hotspots",
        "security": task == "Security / Config Hygiene",
    }
def render_markdown_summary(repo_url: str, total_tokens: int, files, results: Dict[str, Dict[str, Any]]) -> str:
    repo_url = safe_str(repo_url)
    lines = [
        "# Whole-Repo Analysis Report",
        f"**Repository:** {repo_url}",
        f"**Files included:** {len(files)}",
        f"**Estimated input tokens:** {total_tokens}",
        "",
    ]
    if "Architecture Overview" in results:
        overview = results["Architecture Overview"].get("repo_overview", {})
        lines += [
            "## Architecture",
            overview.get("summary", "No summary returned."),
            "",
            f"**Primary languages:** {', '.join(overview.get('primary_languages', [])) or 'N/A'}",
            f"**Likely entrypoints:** {', '.join(overview.get('likely_entrypoints', [])) or 'N/A'}",
            "",
        ]
    if "Improvement Opportunities" in results:
        lines += [
            "## Improvement Opportunities",
            f"- Identified: {len(results['Improvement Opportunities'].get('improvement_opportunities', []))}",
            "",
        ]
    if "Code Quality Hotspots" in results:
        lines += [
            "## Code Quality Hotspots",
            f"- Identified: {len(results['Code Quality Hotspots'].get('quality_hotspots', []))}",
            "",
        ]
    if "Testing Gaps" in results:
        lines += [
            "## Testing Gaps",
            f"- Identified: {len(results['Testing Gaps'].get('testing_gaps', []))}",
            "",
        ]
    if "Code Duplication" in results:
        dup = results["Code Duplication"]
        lines += [
            "## Duplication & Refactor Summary",
            f"- Duplication candidates: {len(dup.get('duplication_candidates', []))}",
            f"- Design smells: {len(dup.get('design_smells', []))}",
            f"- High risk files: {len(dup.get('high_risk_files', []))}",
            f"- Refactor recommendations: {len(dup.get('refactor_recommendations', []))}",
            "",
        ]
    if "Library Modernization" in results:
        lines += [
            "## Library Modernization",
            f"- Recommendations: {len(results['Library Modernization'].get('library_recommendations', []))}",
            "",
        ]
    if "Security / Config Hygiene" in results:
        lines += [
            "## Security / Config Hygiene",
            f"- Findings: {len(results['Security / Config Hygiene'].get('security_and_config_findings', []))}",
            "",
        ]
    if "Refactor Roadmap" in results:
        lines += [
            "## Refactor Roadmap",
            f"- Planned items: {len(results['Refactor Roadmap'].get('refactor_roadmap', []))}",
            "",
        ]
    if "Onboarding Guide" in results:
        onboarding = results["Onboarding Guide"].get("onboarding_guide", {})
        lines += [
            "## Onboarding Guide",
            onboarding.get("summary", "No summary returned."),
            "",
            f"**Recommended reading order:** {', '.join(onboarding.get('recommended_reading_order', [])) or 'N/A'}",
            f"**Entrypoints:** {', '.join(onboarding.get('entrypoints', [])) or 'N/A'}",
            "",
        ]
    return "\n".join(lines)
def hidden_update():
    return gr.update(value=pd.DataFrame(), visible=False)
def visible_update(df):
    return gr.update(value=df, visible=True)
def empty_outputs(stats, status_message):
    return (
        status_message,
        "",
        *all_hidden(),
        "{}",
        json.dumps(stats, indent=2),
    )
Este passo define um conjunto pequeno de helpers que, juntos, cuidam de grande parte da apresentação do app.
função to_df(): converte saídas do modelo em DataFrame do pandas para exibição limpa em tabelas do Gradio. função get_tasks_to_run(): decide se o app deve rodar uma tarefa única ou a Full Review agrupada. Se a tarefa selecionada for "Full Review", ela se expande na lista predefinida; caso contrário, retorna a tarefa única.função visible_for_task(): controla quais tabelas devem aparecer na UI. Por exemplo, se o usuário escolher Onboarding Guide, não faz sentido exibir duplicação ou segurança. função render_markdown_summary(): em vez de despejar JSON cru, gera um resumo legível com metadados do repositório, contagem de tokens e destaques por tarefa.funções hidden_update() e visible_update(): helpers do Gradio para controlar estado de componentes. hidden_update() limpa e esconde uma tabela; visible_update() preenche e mostra. O padrão é importante pois o Gradio espera um retorno para cada componente de saída.função empty_outputs(): lida com saídas vazias e erros. Se o repo for grande demais, a tarefa inválida ou algo falhar, o app ainda retorna valores válidos para cada componente da UI. Juntas, essas funções não mudam a lógica central do modelo, mas tornam o app utilizável.
Esta função orquestra o fluxo completo. Ela valida entradas, prepara o repositório, executa uma ou mais tarefas de análise e retorna saídas estruturadas para a UI do Gradio.
def analyze_repo(repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks):
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    task = safe_str(task)
    try:
        if not repo_url:
            stats = {"repo_url": "", "branch": branch}
            return empty_outputs(stats, "Error: Repository URL is empty.")
        if not task:
            stats = {"repo_url": repo_url, "branch": branch}
            return empty_outputs(stats, "Error: Task is empty.")
        repo_path = clone_repo(repo_url, branch)
        tree, files, total_tokens = pack_repo(repo_path, exclude_tests, exclude_docs, exclude_notebooks)
        stats = {
            "repo_url": repo_url,
            "branch": branch,
            "files_included": len(files),
            "estimated_input_tokens": total_tokens,
            "token_budget": token_budget,
            "fits_budget": total_tokens <= token_budget,
            "sample_files": [f[0] for f in files[:30]],
            "tasks_requested": get_tasks_to_run(task),
        }
        if total_tokens > token_budget:
            msg = (
                f"Repo too large for current budget.\n\n"
                f"Estimated tokens: {total_tokens}\n"
                f"Budget: {token_budget}\n\n"
                f"Try excluding tests/docs/notebooks or use a smaller repo."
            )
            return empty_outputs(stats, msg)
        repo_context = build_repo_context(tree, files)
        tasks_to_run = get_tasks_to_run(task)
        results: Dict[str, Dict[str, Any]] = {}
        for task_name in tasks_to_run:
            prompt = build_task_prompt(task_name, repo_context)
            raw_text = call_model(prompt)
            results[task_name] = try_parse_json(raw_text)
        report_md = render_markdown_summary(repo_url, total_tokens, files, results)
        vis = visible_for_task(task)
        arch_json = results.get("Architecture Overview", {})
        dup_json = results.get("Code Duplication", {})
        imp_json = results.get("Improvement Opportunities", {})
        roadmap_json = results.get("Refactor Roadmap", {})
        testing_json = results.get("Testing Gaps", {})
        onboarding_json = results.get("Onboarding Guide", {})
        lib_json = results.get("Library Modernization", {})
        hotspot_json = results.get("Code Quality Hotspots", {})
        security_json = results.get("Security / Config Hygiene", {})
        modules_df = to_df(arch_json.get("modules", []), ["name", "responsibility", "key_files", "evidence_paths"])
        deps_df = to_df(arch_json.get("dependencies", []), ["from_module", "to_module", "relationship", "evidence_paths"])
        issues_df = to_df(arch_json.get("issues", []), ["type", "description", "severity", "evidence_paths"])
        dups_df = to_df(dup_json.get("duplication_candidates", []), ["summary", "files_involved", "why_it_looks_duplicate", "confidence"])
        refactor_df = to_df(dup_json.get("refactor_recommendations", []), ["title", "description", "target_files", "expected_benefit"])
        improvements_df = to_df(imp_json.get("improvement_opportunities", []), ["title", "description", "why_it_matters", "affected_files", "suggested_change", "expected_impact", "effort", "evidence_paths"])
        roadmap_df = to_df(roadmap_json.get("refactor_roadmap", []), ["priority", "title", "description", "target_files", "impact", "effort", "why_now"])
        testing_df = to_df(testing_json.get("testing_gaps", []), ["module_or_file", "why_it_needs_tests", "likely_missing_cases", "recommended_test_type", "evidence_paths"])
        onboarding_df = to_df(onboarding_json.get("onboarding_guide", {}), ["summary", "recommended_reading_order", "entrypoints", "important_directories", "debugging_start_points", "common_confusion_points"])
        libs_df = to_df(lib_json.get("library_recommendations", []), ["current_library_or_pattern", "where_used", "suggested_alternative", "why_better", "migration_difficulty", "confidence", "evidence_paths", "recommendation_type"])
        hotspots_df = to_df(hotspot_json.get("quality_hotspots", []), ["file_or_module", "risk_level", "why_it_is_a_hotspot", "evidence_paths", "recommended_cleanup"])
        security_df = to_df(security_json.get("security_and_config_findings", []), ["title", "severity", "description", "affected_files", "evidence_paths", "recommended_fix", "confidence"])
        status = (
            f"Done.\n\n"
            f"Files included: {len(files)}\n"
            f"Estimated input tokens: {total_tokens}\n"
            f"Tasks run: {', '.join(tasks_to_run)}"
        )
        return (
            status,
            report_md,
            visible_update(modules_df) if vis["modules"] else hidden_update(),
            visible_update(deps_df) if vis["deps"] else hidden_update(),
            visible_update(issues_df) if vis["issues"] else hidden_update(),
            visible_update(dups_df) if vis["dups"] else hidden_update(),
            visible_update(refactor_df) if vis["refactor"] else hidden_update(),
            visible_update(improvements_df) if vis["improvements"] else hidden_update(),
            visible_update(roadmap_df) if vis["roadmap"] else hidden_update(),
            visible_update(testing_df) if vis["testing"] else hidden_update(),
            visible_update(onboarding_df) if vis["onboarding"] else hidden_update(),
            visible_update(libs_df) if vis["libs"] else hidden_update(),
            visible_update(hotspots_df) if vis["hotspots"] else hidden_update(),
            visible_update(security_df) if vis["security"] else hidden_update(),
            json.dumps(results, indent=2),
            json.dumps(stats, indent=2),
        )
    except subprocess.CalledProcessError as e:
        stats = {"repo_url": repo_url, "branch": branch}
        stderr = safe_str(getattr(e, "stderr", "")) or safe_str(e)
        return empty_outputs(stats, f"Git clone failed:\n{stderr}")
    except Exception as e:
        stats = {"repo_url": repo_url, "branch": branch}
        return empty_outputs(stats, f"Error: {safe_str(e)}")
Essa função orquestra todo o pipeline, do repo bruto à saída estruturada.
results.to_df() e mapeia para componentes da interface, com visibilidade controlada por visible_for_task().empty_outputs() para manter a UI estável.Por fim, vamos empacotar tudo em uma interface simples no Gradio.
with gr.Blocks(title="Nemotron Repo Analyzer") as demo:
    gr.Markdown("# Nemotron Repo Analyzer")
    # gr.Markdown("Analyze a public GitHub repository without RAG using a single packed prompt.")
    with gr.Tab("Analyze"):
        with gr.Row():
            repo_url = gr.Textbox(
                label="GitHub Repo URL",
                value="https://github.com/AashiDutt/Nemotron-3-Nano.git"
            )
            branch = gr.Textbox(label="Branch", value="main")
        with gr.Row():
            task = gr.Dropdown(
                choices=TASK_CHOICES,
                value="Full Review",
                label="Task"
            )
            token_budget = gr.Slider(
                minimum=40000,
                maximum=180000,
                step=5000,
                value=120000,
                label="Token Budget"
            )
        with gr.Row():
            exclude_tests = gr.Checkbox(value=False, label="Exclude tests")
            exclude_docs = gr.Checkbox(value=False, label="Exclude docs / markdown")
            exclude_notebooks = gr.Checkbox(value=True, label="Exclude notebooks")
        analyze_btn = gr.Button("Analyze Repo", variant="primary")
        status = gr.Textbox(label="Status", lines=7)
    with gr.Tab("Report"):
        report_md = gr.Markdown()
        modules_df = gr.Dataframe(label="Modules", visible=False)
        deps_df = gr.Dataframe(label="Dependencies", visible=False)
        issues_df = gr.Dataframe(label="Architecture Issues", visible=False)
        dups_df = gr.Dataframe(label="Duplication Candidates", visible=False)
        refactor_df = gr.Dataframe(label="Refactor Recommendations", visible=False)
        improvements_df = gr.Dataframe(label="Improvement Opportunities", visible=False)
        roadmap_df = gr.Dataframe(label="Refactor Roadmap", visible=False)
        testing_df = gr.Dataframe(label="Testing Gaps", visible=False)
        onboarding_df = gr.Dataframe(label="Onboarding Guide", visible=False)
        libs_df = gr.Dataframe(label="Library Modernization", visible=False)
        hotspots_df = gr.Dataframe(label="Code Quality Hotspots", visible=False)
        security_df = gr.Dataframe(label="Security / Config Hygiene", visible=False)
    with gr.Tab("Raw JSON"):
        all_results_json_box = gr.Code(label="All Task Results JSON", language="json")
        stats_box = gr.Code(label="Run Stats", language="json")
    analyze_btn.click(
        analyze_repo,
        inputs=[repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks],
        outputs=[
            status,
            report_md,
            modules_df,
            deps_df,
            issues_df,
            dups_df,
            refactor_df,
            improvements_df,
            roadmap_df,
            testing_df,
            onboarding_df,
            libs_df,
            hotspots_df,
            security_df,
            all_results_json_box,
            stats_box,
        ]
    )
demo.launch(debug=True, share=True)
O container gr.Blocks() define o layout geral do app, enquanto o Markdown inicial define título e contexto. A interface é dividida em três abas para organizar o fluxo.
Isso conecta as entradas do usuário diretamente à função analyze_repo() e mapeia suas saídas de volta aos componentes da UI. A ordem dos outputs é crítica, já que cada valor retorna para um elemento específico.
Por fim, o app é iniciado com:
demo.launch(debug=True, share=True)A flag debug=True ajuda a expor erros de runtime durante o desenvolvimento, enquanto share=True cria um link público para compartilhar o app sem deploy.
Neste tutorial, mostrei como construir um analisador de base de código usando NVIDIA Nemotron 3 Super, OpenRouter e Gradio.
Em vez de depender de chunking, embeddings e recuperação, o app clona um repositório público do GitHub, filtra e empacota a base de código em um único prompt e pede ao modelo para raciocinar sobre o repositório inteiro de uma vez.
Essa abordagem de contexto total é útil para tarefas que exigem visão global da base, como explicação de arquitetura, onboarding, análise de lacunas de testes, oportunidades de melhoria e planejamento de refatoração.
A partir daqui, você pode evoluir o projeto de várias formas:
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Ryan Ong
12 min
Tutorial
Zoumana Keita
14 min
Tutorial
Moez Ali
12 min
Tutorial
Moez Ali
13 min