Curso
Diseño de sistemas agénticos con LangChain
3 h
14.8K
Puedes acceder al código completo de esta demo aquí.
Nemotron 3 Super es el modelo abierto de razonamiento de NVIDIA para flujos agentivos y de contexto largo. Emplea una arquitectura híbrida Mamba-Transformer con Latent MoE con 120B parámetros totales y 12B activos, incluye predicción multi-token (MTP) y está diseñado para tareas de alto razonamiento como programación, uso de herramientas y análisis de contexto largo.
NVIDIA lo posiciona específicamente para aplicaciones multiagente complejas y razonamiento sobre bases de código completas.
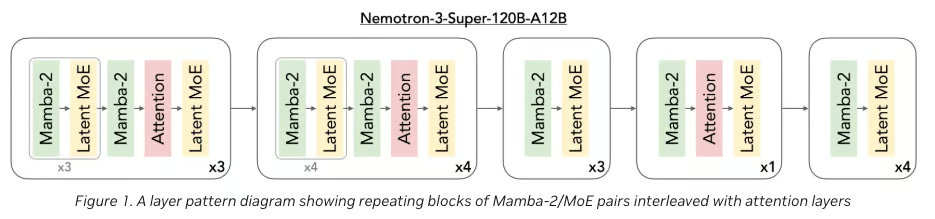
Figura 1: arquitectura de Nemotron 3 Super (NVIDIA Blog)
Algunas ideas clave detrás de Nemotron 3 Super incluyen:
Para este tutorial, usaremos el endpoint gratuito alojado de OpenRouter, ya que tanto la variante completa como la cuantizada del modelo suelen requerir al menos una GPU H100 para una inferencia práctica. El endpoint alojado actualmente admite una ventana de contexto de 262K tokens (en lugar del millón completo), que sigue siendo suficiente para analizar repositorios medianos en esta demo.
La familia Nemotron 3 de NVIDIA se presentó como una gama abierta para sistemas de IA agentiva, con distintos tamaños según necesidades de despliegue y razonamiento: niveles Nano, Super y Ultra.
En la práctica, puedes entender la familia así:
Así que Nemotron 3 Super es la elección adecuada aquí porque queremos un modelo que pueda razonar sobre un repositorio completo a la vez, no solo resolver subtareas aisladas de código.
En esta sección, construiremos un analizador de repos usando Nemotron 3 Super envuelto en una interfaz de Gradio. A grandes rasgos, esto es lo que hace la app final:
Vamos a construirlo paso a paso.
Antes de crear el analizador, necesitamos un entorno mínimo que cubra tres responsabilidades clave: renderizar la UI, procesar el repositorio e interactuar con el modelo. Como no ejecutamos Nemotron en local, la configuración se mantiene ligera y enfocada.
Instala todo ejecutando:
!pip -q install gradio openai tiktoken gitpython orjson pandasEn este proyecto usaremos:
openai para interactuar con la API de OpenRouter (endpoint de Nemotron)gradio para construir la UI interactivatiktoken para estimar el uso de tokens antes de enviar promptsorjson para parseo rápido de JSON desde las salidas del modelopandas para mostrar resultados estructurados como tablasgitpython para clonar y trabajar con repositoriosA diferencia de los montajes locales de LLM (que requieren CUDA, vLLM o cuantización), este enfoque evita por completo dependencias de GPU y mantiene el entorno compatible con Colab.
En este paso configuramos Nemotron 3 Super vía OpenRouter y definimos algunas constantes clave que controlan cómo se procesan los repositorios. Como no ejecutamos el modelo en local, este cliente es la interfaz central para enviar prompts grandes empaquetados y recibir salidas de análisis estructuradas.
OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")
MODEL = "nvidia/nemotron-3-super-120b-a12b:free"
WORKDIR = "/content/repo_ui"
if not OPENROUTER_API_KEY:
    raise ValueError("Set OPENROUTER_API_KEY in environment before running.")
client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=OPENROUTER_API_KEY,
)
enc = tiktoken.get_encoding("cl100k_base")
A esta altura, la aplicación se comunica con Nemotron 3 Super a través de OpenRouter usando el cliente de Python openai configurado con un base_url personalizado y una API key almacenada en OPENROUTER_API_KEY.
El modelo seleccionado apunta al endpoint alojado de OpenRouter, lo que nos permite ejecutar un modelo muy grande sin necesitar infraestructura GPU local.
Para gestionar el tamaño de contexto, inicializamos un tokenizador (tiktoken con cl100k_base) y así estimar cuántos tokens consumirá el repositorio empaquetado antes de enviarlo al modelo. Esto es importante porque el modelo tiene una ventana de contexto finita.
Un par de consideraciones prácticas:
Ahora necesitamos dos salvaguardas: filtrado de archivos y anclaje del prompt.
La primera evita desperdiciar contexto en artefactos irrelevantes como builds, notebooks, imágenes o binarios.
La segunda garantiza que, una vez empaquetado el repositorio, el modelo se mantenga anclado al código real en lugar de derivar hacia consejos genéricos de software.
Juntas, estas reglas hacen el análisis más eficiente.
BASE_IGNORE_DIRS = {
    ".git", ".github", "__pycache__", "node_modules", ".venv", "venv",
    "dist", "build", ".mypy_cache", ".pytest_cache", ".idea", ".vscode"
}
IGNORE_SUFFIXES = {
    ".png", ".jpg", ".jpeg", ".gif", ".webp", ".pdf", ".zip", ".gz",
    ".tar", ".mp4", ".mov", ".onnx", ".pt", ".bin", ".parquet", ".feather",
    ".ico", ".svg", ".lock"
}
MAX_FILE_BYTES = 250_000
SYSTEM_PROMPT = """You are a codebase analysis model.
You are given the complete repository contents in one prompt.
Rules:
1. Use only the provided repository content.
2. Do not invent files, modules, libraries, or dependencies.
3. Every substantial claim must cite one or more file paths.
4. Clearly separate direct observations from engineering inferences or recommendations.
5. For modernization or improvement suggestions, explicitly distinguish:
   - repo-grounded findings
   - general engineering recommendations
6. Return valid JSON only.
7. If uncertain, say so explicitly.
8. For anything involving security, dead code, dependency replacement, or testing gaps,
   present findings as likely candidates unless directly proven by repository content.
"""
Las tres variables de filtrado siguientes controlan el preprocesado del repositorio:
BASE_IGNORE_DIRS excluye directorios irrelevantes para el análisis o demasiado ruidosos, como .git, node_modules, carpetas de build y cachés de editores. IGNORE_SUFFIXES filtra tipos de archivo que generalmente no ayudan al razonamiento del repo, como imágenes, archivos comprimidos, vídeos, checkpoints de modelos y otros artefactos. MAX_FILE_BYTES añade un control más saltándose archivos demasiado grandes, lo que ayuda a mantener el repositorio empaquetado dentro de un presupuesto de contexto práctico.El SYSTEM_PROMPT es tan importante como los filtros.
Como el modelo ve el repo como un único prompt largo, debemos fijar pautas claras de comportamiento para evitar inventar módulos, malinterpretar abstracciones o dar recomendaciones demasiado genéricas.
Estas instrucciones fuerzan explícitamente al modelo a mantenerse anclado en el repo proporcionado, citar rutas de archivos para afirmaciones importantes y separar evidencia directa de juicios generales.
Con el filtrado de archivos y el prompt del sistema listos, el siguiente paso es definir un conjunto de tareas a nivel de repositorio, cada una con un esquema JSON estructurado.
Esto aporta dos ventajas: el modelo sabe exactamente qué tipo de salida producir y la app puede parsearla y mostrarla de forma fiable en tablas específicas por tarea.
TASK_DEFS: Dict[str, Dict[str, Any]] = {
    "Architecture Overview": {
        "description": "Explain the architecture, major modules, likely entrypoints, dependencies, and architectural issues.",
        "schema": {
            "repo_overview": {
                "summary": "",
                "primary_languages": [],
                "likely_entrypoints": []
            },
            "modules": [
                {
                    "name": "",
                    "responsibility": "",
                    "key_files": [],
                    "evidence_paths": []
                }
            ],
            "dependencies": [
                {
                    "from_module": "",
                    "to_module": "",
                    "relationship": "",
                    "evidence_paths": []
                }
            ],
            "issues": [
                {
                    "type": "",
                    "description": "",
                    "severity": "low|medium|high",
                    "evidence_paths": []
                }
            ],
            "unknowns_and_uncertainties": []
        },
    },
    ...
}
El diccionario TASK_DEFS actúa como registro central de todos los modos de análisis que soporta la app.
Cada tarea incluye una descripción en lenguaje natural que indica al modelo qué hacer, y un esquema estricto que define el JSON esperado.
Esto permite que el mismo repositorio empaquetado soporte formas de razonamiento muy distintas, como mapeo de arquitectura, análisis de duplicidad, guía de onboarding o detección de carencias de pruebas.
Por ejemplo, Architecture Overview pide al modelo identificar:
Otras tareas en el código completo incluyen:
Code Duplication, centrada en lógica repetida y oportunidades de refactor relacionadas,Improvement Opportunities, que identifica mejoras de mantenibilidad y modularidad,Testing Gaps destaca áreas con pocas pruebas,Onboarding Guide explica cómo debería abordar la base de código una persona que se incorpora,Library Modernization saca a la luz librerías obsoletas o solapadas,Code Quality Hotspots señala zonas frágiles o propensas a errores,Security o Config Hygiene alertan sobre valores por defecto arriesgados o problemas operativos.FULL_REVIEW_TASKS = [
"Architecture Overview",
"Improvement Opportunities",
"Code Quality Hotspots",
"Testing Gaps",
"Refactor Roadmap",
]
TASK_CHOICES = [
"Architecture Overview",
"Code Duplication",
"Improvement Opportunities",
"Refactor Roadmap",
"Testing Gaps",
"Onboarding Guide",
"Library Modernization",
"Code Quality Hotspots",
"Security / Config Hygiene",
"Full Review",
]
def safe_str(value: Any) -> str:
if value is None:
return ""
if isinstance(value, str):
return value.strip()
return str(value).strip()La lista FULL_REVIEW_TASKS define una revisión multietapa agrupada.
En lugar de ejecutar todas las tareas posibles, lanza un subconjunto curado que ofrece una visión de ingeniería amplia del repo. TASK_CHOICES se usa directamente en el desplegable de Gradio para que el usuario elija una sola tarea o la revisión agrupada.
La última parte, safe_str(), resuelve un problema de estabilidad más importante de lo que parece. Durante el desarrollo, un error común era:
'NoneType' object has no attribute 'strip'Esto puede ocurrir cuando:
None,Al normalizar todos esos valores con safe_str(), la app es mucho más robusta.
Antes de enviar nada al modelo, tenemos que convertir un repositorio de GitHub en un único prompt estructurado.
Este paso gestiona toda la ingesta: clonar el repo, filtrar archivos irrelevantes, extraer solo texto utilizable y empaquetarlo todo en un formato que el modelo pueda consumir de una vez.
A diferencia de los pipelines RAG tradicionales, aquí no troceamos ni creamos embeddings. En su lugar, comprimimos todo el repositorio en una sola entrada de contexto largo, así que ser selectivos y estructurados es clave para el rendimiento y la calidad.
def clone_repo(repo_url: str, branch: str = "main") -> str:
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    if not repo_url:
        raise ValueError("Repository URL is empty.")
    if os.path.exists(WORKDIR):
        shutil.rmtree(WORKDIR)
    cmd = ["git", "clone", "--depth", "1"]
    if branch:
        cmd += ["--branch", branch]
    cmd += [repo_url, WORKDIR]
    subprocess.run(cmd, check=True, capture_output=True, text=True)
    return WORKDIR
def is_probably_text(path: Path) -> bool:
    try:
        with open(path, "rb") as f:
            chunk = f.read(2048)
        if b"\x00" in chunk:
            return False
        chunk.decode("utf-8")
        return True
    except Exception:
        return False
def iter_repo_files(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    for path in root.rglob("*"):
        if not path.is_file():
            continue
        rel = path.relative_to(root)
        parts = set(rel.parts)
        rel_str = str(rel).lower()
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        if path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        try:
            if path.stat().st_size > MAX_FILE_BYTES:
                continue
        except Exception:
            continue
        if not is_probably_text(path):
            continue
        yield path
def repo_tree_string(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool) -> str:
    root = Path(root)
    lines: List[str] = []
    for path in sorted(root.rglob("*")):
        rel = path.relative_to(root)
        rel_str = str(rel).lower()
        parts = set(rel.parts)
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if path.is_file() and path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        lines.append(f"{rel}/" if path.is_dir() else str(rel))
    return "\n".join(lines)
def pack_repo(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    tree = repo_tree_string(root, exclude_tests, exclude_docs, exclude_notebooks)
    files: List[Tuple[str, int, str]] = []
    total_tokens = len(enc.encode(tree))
    for path in iter_repo_files(root, exclude_tests, exclude_docs, exclude_notebooks):
        rel = path.relative_to(root)
        try:
            content = path.read_text(encoding="utf-8", errors="ignore")
        except Exception:
            continue
        block = f"\n=== FILE START: {rel} ===\n{content}\n=== FILE END: {rel} ===\n"
        tok = len(enc.encode(block))
        files.append((str(rel), tok, block))
        total_tokens += tok
    return tree, files, total_tokens
def build_repo_context(tree: str, files: List[Tuple[str, int, str]]) -> str:
    joined_files = "".join(block for _, _, block in files)
    return f"""=== REPO TREE START ===
{tree}
=== REPO TREE END ===
=== REPOSITORY FILES START ===
{joined_files}
=== REPOSITORY FILES END ===
"""
Este paso define toda la canalización de ingesta y empaquetado del repositorio, pero cada función tiene su cometido:
clone_repo(): clona un repo de GitHub en un directorio de trabajo temporal con un clon superficial (--depth 1) para evitar traer el historial completo. Las entradas como URL y rama se normalizan con safe_str() para prevenir errores en tiempo de ejecución. Devuelve una ruta local (WORKDIR) sobre la que operará el resto del pipeline.iter_repo_files(): actúa como capa principal de filtrado. Recorre recursivamente el repo y solo devuelve archivos de alto valor. Excluye directorios del sistema, tipos no soportados, archivos grandes y, opcionalmente, tests, documentación y notebooks. is_probably_text(): comprobación ligera usada durante el filtrado. Lee un pequeño bloque de cada archivo y verifica ausencia de bytes nulos (indicativos de binarios) y decodificación UTF-8 correcta. Solo los que pasan se consideran texto válido.repo_tree_string(): construye una representación en texto de la estructura del repo (aplicando las mismas reglas) con una lista de directorios y archivos, para que el modelo entienda el layout antes de leer contenidos.pack_repo(): función central de empaquetado. Itera los archivos filtrados, lee su contenido y envuelve cada archivo con marcadores explícitos como === FILE START === y === FILE END ===. También estima tokens con tiktoken y acumula el total. build_repo_context(): combina todo en un único prompt estructurado. Coloca primero el árbol del repo y después los contenidos. El modelo entiende la estructura y luego lee la implementación.El efecto neto es un repositorio crudo de GitHub transformado en una entrada única y estructurada de contexto largo.
Con el repositorio filtrado y empaquetado, el siguiente paso es indicar al modelo qué análisis realizar y cómo dar formato al resultado.
En lugar de enviar la misma instrucción genérica para todos los casos, generamos un prompt específico por tarea, que incluye su nombre, descripción y el esquema JSON exacto esperado en la respuesta.
def build_task_prompt(task_name: str, repo_context: str) -> str:
    task_name = safe_str(task_name)
    if not task_name:
        raise ValueError("Task name is empty.")
    if task_name not in TASK_DEFS:
        raise ValueError(f"Unknown task: {task_name}")
    task_def = TASK_DEFS[task_name]
    return f"""Analyze this full repository.
Task Name:
{task_name}
Task Description:
{task_def["description"]}
Return JSON matching this schema exactly:
{json.dumps(task_def["schema"], indent=2)}
{repo_context}
"""
def try_parse_json(text: str) -> Dict[str, Any]:
    text = safe_str(text)
    if not text:
        raise ValueError("Model returned empty text.")
    try:
        return orjson.loads(text)
    except Exception:
        start = text.find("{")
        end = text.rfind("}")
        if start != -1 and end != -1 and end > start:
            return orjson.loads(text[start:end+1])
        raise ValueError("Could not parse model output as JSON.")
El fragmento anterior define dos funciones estrechamente relacionadas que hacen de puente entre el repo empaquetado y la salida de análisis específica por tarea.
build_task_prompt(): crea el prompt final que se envía al modelo. Primero normaliza el nombre de la tarea con safe_str() para que una entrada vacía no rompa el pipeline. Después valida que la tarea existe en TASK_DEFS, evitando nombres no soportados o mal escritos. Una vez validada, recupera su descripción y esquema JSON, e incrusta ambos en el prompt final junto al contexto completo del repo.try_parse_json(): gestiona la salida del modelo tras la inferencia. En la práctica, los modelos de contexto largo a veces envuelven el JSON con texto extra o artefactos de formato. Para robustecer la app, primero intenta el parseo directo con orjson.loads(). Al combinar prompting estricto con parseo tolerante, la app es más estable.En el siguiente paso conectaremos esta lógica de prompting con la llamada al modelo y empezaremos a generar resultados estructurados.
Ahora ejecutamos el análisis enviando el prompt a Nemotron 3 Super a través de OpenRouter.
En lugar de trocear o recuperar partes del repo, enviamos todo el código filtrado en una sola petición y dejamos que el modelo razone de forma global entre archivos, módulos y dependencias.
def call_model(prompt: str, max_tokens: int = 5000) -> str:
    prompt = safe_str(prompt)
    if not prompt:
        raise ValueError("Prompt is empty.")
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
        ],
        temperature=0.2,
        max_tokens=max_tokens,
        extra_headers={
            "HTTP-Referer": "https://colab.research.google.com",
            "X-Title": "Whole Repo Analysis Demo"
        }
    )
    if not getattr(resp, "choices", None):
        raise ValueError("Model response has no choices.")
    message = getattr(resp.choices[0], "message", None)
    if message is None:
        raise ValueError("Model response has no message.")
    content = getattr(message, "content", None)
    content = safe_str(content)
    if not content:
        raise ValueError("Model returned empty content.")
    return content
La función call_model() ejecuta la llamada al modelo y extrae la respuesta. El flujo completo es:
temperature=0.2 busca salidas más deterministas y max_tokens limita el tamaño de la respuesta.Por último, pasamos a la parte de inferencia con el modelo y cómo ejecutar el análisis mediante el modelo alojado en OpenRouter.
Necesitamos ahora algunas funciones pequeñas que faciliten la UI y el manejo de salidas.
def to_df(items, columns=None):
    if items is None:
        return pd.DataFrame(columns=columns or [])
    if isinstance(items, dict):
        return pd.DataFrame([items])
    if not items:
        return pd.DataFrame(columns=columns or [])
    return pd.DataFrame(items)
def get_tasks_to_run(task: str) -> List[str]:
    task = safe_str(task)
    if not task:
        raise ValueError("Task is empty.")
    return FULL_REVIEW_TASKS if task == "Full Review" else [task]
def visible_for_task(task: str) -> Dict[str, bool]:
    task = safe_str(task)
    if task == "Full Review":
        return {
            "modules": True,
            "deps": True,
            "issues": True,
            "dups": False,
            "refactor": False,
            "improvements": True,
            "roadmap": True,
            "testing": True,
            "onboarding": False,
            "libs": False,
            "hotspots": True,
            "security": False,
        }
    return {
        "modules": task == "Architecture Overview",
        "deps": task == "Architecture Overview",
        "issues": task == "Architecture Overview",
        "dups": task == "Code Duplication",
        "refactor": task == "Code Duplication",
        "improvements": task == "Improvement Opportunities",
        "roadmap": task == "Refactor Roadmap",
        "testing": task == "Testing Gaps",
        "onboarding": task == "Onboarding Guide",
        "libs": task == "Library Modernization",
        "hotspots": task == "Code Quality Hotspots",
        "security": task == "Security / Config Hygiene",
    }
def render_markdown_summary(repo_url: str, total_tokens: int, files, results: Dict[str, Dict[str, Any]]) -> str:
    repo_url = safe_str(repo_url)
    lines = [
        "# Whole-Repo Analysis Report",
        f"**Repository:** {repo_url}",
        f"**Files included:** {len(files)}",
        f"**Estimated input tokens:** {total_tokens}",
        "",
    ]
    if "Architecture Overview" in results:
        overview = results["Architecture Overview"].get("repo_overview", {})
        lines += [
            "## Architecture",
            overview.get("summary", "No summary returned."),
            "",
            f"**Primary languages:** {', '.join(overview.get('primary_languages', [])) or 'N/A'}",
            f"**Likely entrypoints:** {', '.join(overview.get('likely_entrypoints', [])) or 'N/A'}",
            "",
        ]
    if "Improvement Opportunities" in results:
        lines += [
            "## Improvement Opportunities",
            f"- Identified: {len(results['Improvement Opportunities'].get('improvement_opportunities', []))}",
            "",
        ]
    if "Code Quality Hotspots" in results:
        lines += [
            "## Code Quality Hotspots",
            f"- Identified: {len(results['Code Quality Hotspots'].get('quality_hotspots', []))}",
            "",
        ]
    if "Testing Gaps" in results:
        lines += [
            "## Testing Gaps",
            f"- Identified: {len(results['Testing Gaps'].get('testing_gaps', []))}",
            "",
        ]
    if "Code Duplication" in results:
        dup = results["Code Duplication"]
        lines += [
            "## Duplication & Refactor Summary",
            f"- Duplication candidates: {len(dup.get('duplication_candidates', []))}",
            f"- Design smells: {len(dup.get('design_smells', []))}",
            f"- High risk files: {len(dup.get('high_risk_files', []))}",
            f"- Refactor recommendations: {len(dup.get('refactor_recommendations', []))}",
            "",
        ]
    if "Library Modernization" in results:
        lines += [
            "## Library Modernization",
            f"- Recommendations: {len(results['Library Modernization'].get('library_recommendations', []))}",
            "",
        ]
    if "Security / Config Hygiene" in results:
        lines += [
            "## Security / Config Hygiene",
            f"- Findings: {len(results['Security / Config Hygiene'].get('security_and_config_findings', []))}",
            "",
        ]
    if "Refactor Roadmap" in results:
        lines += [
            "## Refactor Roadmap",
            f"- Planned items: {len(results['Refactor Roadmap'].get('refactor_roadmap', []))}",
            "",
        ]
    if "Onboarding Guide" in results:
        onboarding = results["Onboarding Guide"].get("onboarding_guide", {})
        lines += [
            "## Onboarding Guide",
            onboarding.get("summary", "No summary returned."),
            "",
            f"**Recommended reading order:** {', '.join(onboarding.get('recommended_reading_order', [])) or 'N/A'}",
            f"**Entrypoints:** {', '.join(onboarding.get('entrypoints', [])) or 'N/A'}",
            "",
        ]
    return "\n".join(lines)
def hidden_update():
    return gr.update(value=pd.DataFrame(), visible=False)
def visible_update(df):
    return gr.update(value=df, visible=True)
def empty_outputs(stats, status_message):
    return (
        status_message,
        "",
        *all_hidden(),
        "{}",
        json.dumps(stats, indent=2),
    )
Este paso define un pequeño conjunto de funciones auxiliares que, juntas, manejan gran parte de la presentación de la app.
to_df(): convierte salidas del modelo en un DataFrame de pandas para mostrarlas como tablas en Gradio. get_tasks_to_run(): decide si la app debe ejecutar una sola tarea o la agrupada Full Review. Si la tarea seleccionada es "Full Review", la expande en la lista predefinida; si no, devuelve la tarea individual. visible_for_task(): controla qué tablas del informe deben mostrarse en la UI. Por ejemplo, si eliges Onboarding Guide, no tiene sentido mostrar duplicidad o seguridad. render_markdown_summary(): en lugar de volcar JSON en crudo, genera un resumen legible con metadatos del repo, recuento de tokens y destacados por tarea.hidden_update() y visible_update(): pequeñas utilidades de Gradio para controlar el estado de componentes. La primera limpia y oculta una tabla; la segunda la rellena y la hace visible. Este patrón es importante porque Gradio espera un valor de retorno para cada componente de salida.empty_outputs(): gestiona salidas tempranas y estados de error. Si el repo es demasiado grande, la tarea no es válida o algo falla, la app sigue devolviendo salidas válidas para cada componente de la UI. En conjunto, estas funciones no cambian la lógica del modelo, pero hacen que la aplicación sea utilizable.
Esta función orquesta el flujo completo. Valida entradas, prepara el repositorio, ejecuta una o varias tareas de análisis y devuelve salidas estructuradas a la UI de Gradio.
def analyze_repo(repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks):
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    task = safe_str(task)
    try:
        if not repo_url:
            stats = {"repo_url": "", "branch": branch}
            return empty_outputs(stats, "Error: Repository URL is empty.")
        if not task:
            stats = {"repo_url": repo_url, "branch": branch}
            return empty_outputs(stats, "Error: Task is empty.")
        repo_path = clone_repo(repo_url, branch)
        tree, files, total_tokens = pack_repo(repo_path, exclude_tests, exclude_docs, exclude_notebooks)
        stats = {
            "repo_url": repo_url,
            "branch": branch,
            "files_included": len(files),
            "estimated_input_tokens": total_tokens,
            "token_budget": token_budget,
            "fits_budget": total_tokens <= token_budget,
            "sample_files": [f[0] for f in files[:30]],
            "tasks_requested": get_tasks_to_run(task),
        }
        if total_tokens > token_budget:
            msg = (
                f"Repo too large for current budget.\n\n"
                f"Estimated tokens: {total_tokens}\n"
                f"Budget: {token_budget}\n\n"
                f"Try excluding tests/docs/notebooks or use a smaller repo."
            )
            return empty_outputs(stats, msg)
        repo_context = build_repo_context(tree, files)
        tasks_to_run = get_tasks_to_run(task)
        results: Dict[str, Dict[str, Any]] = {}
        for task_name in tasks_to_run:
            prompt = build_task_prompt(task_name, repo_context)
            raw_text = call_model(prompt)
            results[task_name] = try_parse_json(raw_text)
        report_md = render_markdown_summary(repo_url, total_tokens, files, results)
        vis = visible_for_task(task)
        arch_json = results.get("Architecture Overview", {})
        dup_json = results.get("Code Duplication", {})
        imp_json = results.get("Improvement Opportunities", {})
        roadmap_json = results.get("Refactor Roadmap", {})
        testing_json = results.get("Testing Gaps", {})
        onboarding_json = results.get("Onboarding Guide", {})
        lib_json = results.get("Library Modernization", {})
        hotspot_json = results.get("Code Quality Hotspots", {})
        security_json = results.get("Security / Config Hygiene", {})
        modules_df = to_df(arch_json.get("modules", []), ["name", "responsibility", "key_files", "evidence_paths"])
        deps_df = to_df(arch_json.get("dependencies", []), ["from_module", "to_module", "relationship", "evidence_paths"])
        issues_df = to_df(arch_json.get("issues", []), ["type", "description", "severity", "evidence_paths"])
        dups_df = to_df(dup_json.get("duplication_candidates", []), ["summary", "files_involved", "why_it_looks_duplicate", "confidence"])
        refactor_df = to_df(dup_json.get("refactor_recommendations", []), ["title", "description", "target_files", "expected_benefit"])
        improvements_df = to_df(imp_json.get("improvement_opportunities", []), ["title", "description", "why_it_matters", "affected_files", "suggested_change", "expected_impact", "effort", "evidence_paths"])
        roadmap_df = to_df(roadmap_json.get("refactor_roadmap", []), ["priority", "title", "description", "target_files", "impact", "effort", "why_now"])
        testing_df = to_df(testing_json.get("testing_gaps", []), ["module_or_file", "why_it_needs_tests", "likely_missing_cases", "recommended_test_type", "evidence_paths"])
        onboarding_df = to_df(onboarding_json.get("onboarding_guide", {}), ["summary", "recommended_reading_order", "entrypoints", "important_directories", "debugging_start_points", "common_confusion_points"])
        libs_df = to_df(lib_json.get("library_recommendations", []), ["current_library_or_pattern", "where_used", "suggested_alternative", "why_better", "migration_difficulty", "confidence", "evidence_paths", "recommendation_type"])
        hotspots_df = to_df(hotspot_json.get("quality_hotspots", []), ["file_or_module", "risk_level", "why_it_is_a_hotspot", "evidence_paths", "recommended_cleanup"])
        security_df = to_df(security_json.get("security_and_config_findings", []), ["title", "severity", "description", "affected_files", "evidence_paths", "recommended_fix", "confidence"])
        status = (
            f"Done.\n\n"
            f"Files included: {len(files)}\n"
            f"Estimated input tokens: {total_tokens}\n"
            f"Tasks run: {', '.join(tasks_to_run)}"
        )
        return (
            status,
            report_md,
            visible_update(modules_df) if vis["modules"] else hidden_update(),
            visible_update(deps_df) if vis["deps"] else hidden_update(),
            visible_update(issues_df) if vis["issues"] else hidden_update(),
            visible_update(dups_df) if vis["dups"] else hidden_update(),
            visible_update(refactor_df) if vis["refactor"] else hidden_update(),
            visible_update(improvements_df) if vis["improvements"] else hidden_update(),
            visible_update(roadmap_df) if vis["roadmap"] else hidden_update(),
            visible_update(testing_df) if vis["testing"] else hidden_update(),
            visible_update(onboarding_df) if vis["onboarding"] else hidden_update(),
            visible_update(libs_df) if vis["libs"] else hidden_update(),
            visible_update(hotspots_df) if vis["hotspots"] else hidden_update(),
            visible_update(security_df) if vis["security"] else hidden_update(),
            json.dumps(results, indent=2),
            json.dumps(stats, indent=2),
        )
    except subprocess.CalledProcessError as e:
        stats = {"repo_url": repo_url, "branch": branch}
        stderr = safe_str(getattr(e, "stderr", "")) or safe_str(e)
        return empty_outputs(stats, f"Git clone failed:\n{stderr}")
    except Exception as e:
        stats = {"repo_url": repo_url, "branch": branch}
        return empty_outputs(stats, f"Error: {safe_str(e)}")
Esta función orquesta todo el pipeline, del repo crudo a la salida estructurada.
results.to_df() y las mapea a componentes de la UI. La visibilidad se controla con visible_for_task(), mostrando solo lo relevante.empty_outputs() para mantener estable la UI.Por último, envolvemos todo en una interfaz sencilla de Gradio.
with gr.Blocks(title="Nemotron Repo Analyzer") as demo:
    gr.Markdown("# Nemotron Repo Analyzer")
    # gr.Markdown("Analyze a public GitHub repository without RAG using a single packed prompt.")
    with gr.Tab("Analyze"):
        with gr.Row():
            repo_url = gr.Textbox(
                label="GitHub Repo URL",
                value="https://github.com/AashiDutt/Nemotron-3-Nano.git"
            )
            branch = gr.Textbox(label="Branch", value="main")
        with gr.Row():
            task = gr.Dropdown(
                choices=TASK_CHOICES,
                value="Full Review",
                label="Task"
            )
            token_budget = gr.Slider(
                minimum=40000,
                maximum=180000,
                step=5000,
                value=120000,
                label="Token Budget"
            )
        with gr.Row():
            exclude_tests = gr.Checkbox(value=False, label="Exclude tests")
            exclude_docs = gr.Checkbox(value=False, label="Exclude docs / markdown")
            exclude_notebooks = gr.Checkbox(value=True, label="Exclude notebooks")
        analyze_btn = gr.Button("Analyze Repo", variant="primary")
        status = gr.Textbox(label="Status", lines=7)
    with gr.Tab("Report"):
        report_md = gr.Markdown()
        modules_df = gr.Dataframe(label="Modules", visible=False)
        deps_df = gr.Dataframe(label="Dependencies", visible=False)
        issues_df = gr.Dataframe(label="Architecture Issues", visible=False)
        dups_df = gr.Dataframe(label="Duplication Candidates", visible=False)
        refactor_df = gr.Dataframe(label="Refactor Recommendations", visible=False)
        improvements_df = gr.Dataframe(label="Improvement Opportunities", visible=False)
        roadmap_df = gr.Dataframe(label="Refactor Roadmap", visible=False)
        testing_df = gr.Dataframe(label="Testing Gaps", visible=False)
        onboarding_df = gr.Dataframe(label="Onboarding Guide", visible=False)
        libs_df = gr.Dataframe(label="Library Modernization", visible=False)
        hotspots_df = gr.Dataframe(label="Code Quality Hotspots", visible=False)
        security_df = gr.Dataframe(label="Security / Config Hygiene", visible=False)
    with gr.Tab("Raw JSON"):
        all_results_json_box = gr.Code(label="All Task Results JSON", language="json")
        stats_box = gr.Code(label="Run Stats", language="json")
    analyze_btn.click(
        analyze_repo,
        inputs=[repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks],
        outputs=[
            status,
            report_md,
            modules_df,
            deps_df,
            issues_df,
            dups_df,
            refactor_df,
            improvements_df,
            roadmap_df,
            testing_df,
            onboarding_df,
            libs_df,
            hotspots_df,
            security_df,
            all_results_json_box,
            stats_box,
        ]
    )
demo.launch(debug=True, share=True)
El contenedor gr.Blocks() define el layout general, mientras que el Markdown superior fija el título y el contexto. La interfaz se divide en tres pestañas para mantener el flujo ordenado.
Esto conecta las entradas del usuario directamente con analyze_repo() y mapea sus salidas a los componentes de la UI. El orden de las salidas es crítico, ya que cada valor se enruta a un elemento específico.
Finalmente, la app se lanza con:
demo.launch(debug=True, share=True)La bandera debug=True ayuda a aflorar errores en desarrollo, mientras que share=True crea un enlace público para compartir la app sin desplegarla.
En este tutorial te he mostrado cómo construir un analizador de bases de código de repos usando NVIDIA Nemotron 3 Super, OpenRouter y Gradio.
En lugar de depender de troceado, embeddings y recuperación, la app clona un repositorio público de GitHub, filtra y empaqueta la base de código en un único prompt y pide al modelo que razone sobre todo el repositorio a la vez.
Este enfoque de contexto completo es útil para tareas que requieren una vista global del código, como explicación de arquitectura, onboarding, análisis de carencias de tests, oportunidades de mejora y planificación de refactor.
A partir de aquí, podrías ampliar el proyecto de varias formas:
Top DataCamp Courses
Curso
Curso
Curso
Tutorial
Ryan Ong
12 min
Tutorial
Zoumana Keita
15 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
12 min
Tutorial
Abid Ali Awan
9 min