Kurs
LangChain ile Aracı Sistemler Tasarlama
3 sa
14.8K
Bu demonun tüm koduna buradan erişebilirsiniz.
Nemotron 3 Super, aracısal ve uzun bağlamlı iş akışları için NVIDIA’nın açık mantık yürütme modelidir. Hibrit bir Mamba-Transformer Gizil MoE mimarisini kullanır; toplam 120B parametre ve 12B etkin parametreye sahiptir, çoklu token tahmini (MTP) içerir ve kodlama, araç kullanımı ve uzun bağlam analizi gibi yoğun mantık gerektiren görevler için tasarlanmıştır.
NVIDIA, modeli özellikle karmaşık çoklu ajan uygulamaları ve tüm kod tabanı üzerinde mantık yürütme için konumlandırıyor.
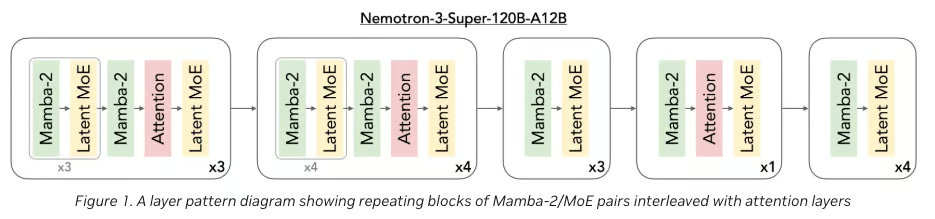
Şekil 1: Nemotron 3 Super Mimarisi (NVIDIA Blogu)
Nemotron 3 Super’ın arkasındaki bazı temel fikirler şunlardır:
Bu eğitim için, modelin tam ve quantize edilmiş varyantları genellikle pratik çıkarım için en az bir H100 GPU gerektirdiğinden, OpenRouter’ın barındırılan ücretsiz uç noktasını kullanacağız. Barındırılan uç nokta şu anda (tam 1M yerine) 262K token bağlam penceresini destekliyor; bu da bu demoda orta ölçekli depoları analiz etmek için yeterli.
NVIDIA’nın Nemotron 3 ailesi; aracısal yapay zekâ sistemleri için farklı dağıtım ve akıl yürütme ihtiyaçlarına yönelik farklı boyutlarda, Nemotron Nano, Super ve Ultra katmanları olarak adlandırılmış açık bir model ailesi olarak tanıtıldı.
Pratik düzeyde aileyi şöyle düşünebilirsiniz:
Dolayısıyla, burada Nemotron 3 Super doğru seçim; çünkü amacımız yalnızca yalıtılmış kod alt görevlerini çözmek değil, tüm depoda bir defada akıl yürütebilen bir model kullanmak.
Bu bölümde, Gradio arayüzüne sarılmış Nemotron 3 Super kullanarak bir depo analiz aracı oluşturacağız. Yüksek düzeyde, nihai uygulama şunları yapar:
Haydi adım adım oluşturalım.
Depo analiz aracını oluşturmadan önce, üç temel sorumluluğu (UI oluşturma, depo işleme ve model etkileşimi) yerine getirebilecek minimal bir ortama ihtiyacımız var. Nemotron’ı yerelde çalıştırmadığımız için kurulum hafif ve odaklı kalıyor.
Her şeyi şu komutla yükleyin:
!pip -q install gradio openai tiktoken gitpython orjson pandasBu projede şunları kullanacağız:
openai OpenRouter’ın API’siyle (Nemotron uç noktası) etkileşim kurmak içingradio etkileşimli UI oluşturmak içintiktoken prompt göndermeden önce token kullanımını tahmin etmek içinorjson model çıktılarından hızlı JSON ayrıştırma içinpandas yapılandırılmış sonuçları tablolar olarak işlemek içingitpython depoları klonlamak ve onlarla çalışmak içinYerel LLM kurulumlarının (CUDA, vLLM veya quantization gerektiren) aksine, bu yaklaşım GPU bağımlılıklarını tamamen ortadan kaldırır ve ortamı Colab-dostu tutar.
Bu adımda, OpenRouter üzerinden Nemotron 3 Super’ı kuruyor ve depoların nasıl işleneceğini kontrol eden birkaç temel sabiti tanımlıyoruz. Modeli yerelde çalıştırmadığımız için, bu istemci büyük, paketlenmiş prompt’ları göndermek ve yapılandırılmış analiz çıktıları almak için merkezi arayüz hâline gelir.
OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")
MODEL = "nvidia/nemotron-3-super-120b-a12b:free"
WORKDIR = "/content/repo_ui"
if not OPENROUTER_API_KEY:
    raise ValueError("Set OPENROUTER_API_KEY in environment before running.")
client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=OPENROUTER_API_KEY,
)
enc = tiktoken.get_encoding("cl100k_base")
Bu aşamada uygulama, openai Python istemcisini özel base_url ve OPENROUTER_API_KEY’de saklanan bir API anahtarıyla yapılandırarak OpenRouter üzerinden Nemotron 3 Super ile iletişim kurar.
Seçilen model, yerel GPU altyapısına ihtiyaç duymadan çok büyük bir modeli çalıştırmamıza imkân veren OpenRouter’ın barındırılan uç noktasını işaret eder.
Bağlam boyutunu yönetmek için, modeli göndermeden önce paketlenmiş deponun kaç token tüketeceğini tahmin edebilmemiz amacıyla bir tokenizer (cl100k_base ile tiktoken) başlatıyoruz. Bunun nedeni modelin sonlu bir bağlam penceresine sahip olmasıdır.
Burada birkaç pratik husus:
Şimdi iki korumaya ihtiyacımız var; yani dosya filtreleme ve prompt temellendirme.
İlki, derleme çıktıları, not defterleri, görseller veya ikili dosyalar gibi alakasız eserler için bağlamı boşa harcamamızı engeller.
İkincisi, depo paketlendikten sonra modelin genel yazılım tavsiyelerine kaymak yerine gerçek koda bağlı kalmasını sağlar.
Birlikte, bu kurallar depo analizini daha verimli hâle getirir.
BASE_IGNORE_DIRS = {
    ".git", ".github", "__pycache__", "node_modules", ".venv", "venv",
    "dist", "build", ".mypy_cache", ".pytest_cache", ".idea", ".vscode"
}
IGNORE_SUFFIXES = {
    ".png", ".jpg", ".jpeg", ".gif", ".webp", ".pdf", ".zip", ".gz",
    ".tar", ".mp4", ".mov", ".onnx", ".pt", ".bin", ".parquet", ".feather",
    ".ico", ".svg", ".lock"
}
MAX_FILE_BYTES = 250_000
SYSTEM_PROMPT = """You are a codebase analysis model.
You are given the complete repository contents in one prompt.
Rules:
1. Use only the provided repository content.
2. Do not invent files, modules, libraries, or dependencies.
3. Every substantial claim must cite one or more file paths.
4. Clearly separate direct observations from engineering inferences or recommendations.
5. For modernization or improvement suggestions, explicitly distinguish:
   - repo-grounded findings
   - general engineering recommendations
6. Return valid JSON only.
7. If uncertain, say so explicitly.
8. For anything involving security, dead code, dependency replacement, or testing gaps,
   present findings as likely candidates unless directly proven by repository content.
"""
Aşağıdaki üç filtreleme değişkeni, depo ön işlemeyi kontrol eder:
BASE_IGNORE_DIRS, .git, node_modules, derleme klasörleri ve editöre özgü önbellekler gibi kod analizi için alakasız veya fazla gürültülü dizinleri hariç tutar. IGNORE_SUFFIXES, görseller, arşivler, videolar, model kontrol noktaları ve diğer eserler dâhil olmak üzere genelde depo mantık yürütmesi için yararlı olmayan dosya türlerini filtreler. MAX_FILE_BYTES, çok büyük dosyaları atlayarak bir güvenlik kontrolü daha sağlar; bu da paketlenmiş deponun pratik bir bağlam bütçesinde kalmasına yardımcı olur.SYSTEM_PROMPT dosya filtreleri kadar önemlidir.
Model depo içeriğini tek bir uzun prompt olarak gördüğünden, modüller uydurma, soyutlamaları yanlış okuma veya aşırı genel önerilerde bulunmayı önlemek için net davranış kısıtları sağlamamız gerekir.
Bu talimatlar, modeli verilen depoda temelli kalmaya, önemli iddialar için dosya yollarını alıntılamaya ve doğrudan kanıtları genel yargılardan ayırmaya açıkça zorlar.
Dosya filtreleme ve bir sistem prompt’u hazırladığımıza göre, sonraki adım yapılandırılmış bir JSON şemasıyla eşleştirilmiş bir dizi depo genel görevi tanımlamaktır.
Bunun iki büyük faydası var: Model ne tür bir çıktı üreteceğini tam olarak bilir ve uygulama sonuçları görev özelindeki tablolarda güvenilir biçimde ayrıştırıp işler.
TASK_DEFS: Dict[str, Dict[str, Any]] = {
    "Architecture Overview": {
        "description": "Explain the architecture, major modules, likely entrypoints, dependencies, and architectural issues.",
        "schema": {
            "repo_overview": {
                "summary": "",
                "primary_languages": [],
                "likely_entrypoints": []
            },
            "modules": [
                {
                    "name": "",
                    "responsibility": "",
                    "key_files": [],
                    "evidence_paths": []
                }
            ],
            "dependencies": [
                {
                    "from_module": "",
                    "to_module": "",
                    "relationship": "",
                    "evidence_paths": []
                }
            ],
            "issues": [
                {
                    "type": "",
                    "description": "",
                    "severity": "low|medium|high",
                    "evidence_paths": []
                }
            ],
            "unknowns_and_uncertainties": []
        },
    },
    ...
}
TASK_DEFS sözlüğü, uygulamanın desteklediği tüm analiz modları için merkezi kayıt görevi görür.
Her görev, modele ne yapacağını söyleyen doğal dilde bir açıklama ve beklenen JSON çıktısını tanımlayan katı bir şema içerir.
Bu, aynı paketlenmiş deponun mimari haritalama, çoğaltma analizi, işe alıştırma rehberi veya test boşluğu tespiti gibi çok farklı akıl yürütme biçimlerini desteklemesini sağlar.
Örneğin, Architecture Overview modelden şunları belirlemesini ister:
Tam koddaki diğer görevler şunlara genişler:
Code Duplication tekrarlanan mantık ve ilgili yeniden düzenleme fırsatlarına odaklanır,Improvement Opportunities bakım yapılabilirlik ve modülerlik kazanımlarını belirler,Testing Gaps yetersiz test edilen alanları vurgular,Onboarding Guide yeni bir mühendisin kod tabanına nasıl yaklaşması gerektiğini açıklar,Library Modernization güncelliğini yitirmiş veya çakışan kütüphaneleri ortaya çıkarır,Code Quality Hotspots kırılgan veya hata eğilimli alanları işaret eder,Security veya Config Hygiene riskli varsayılanları veya operasyonel sorunları bayraklar.FULL_REVIEW_TASKS = [
"Architecture Overview",
"Improvement Opportunities",
"Code Quality Hotspots",
"Testing Gaps",
"Refactor Roadmap",
]
TASK_CHOICES = [
"Architecture Overview",
"Code Duplication",
"Improvement Opportunities",
"Refactor Roadmap",
"Testing Gaps",
"Onboarding Guide",
"Library Modernization",
"Code Quality Hotspots",
"Security / Config Hygiene",
"Full Review",
]
def safe_str(value: Any) -> str:
if value is None:
return ""
if isinstance(value, str):
return value.strip()
return str(value).strip()FULL_REVIEW_TASKS listesi paket hâlinde çok adımlı bir incelemeyi tanımlar.
Tüm olası görevleri çalıştırmak yerine, deponun geniş bir mühendislik görünümünü sağlayan, özenle seçilmiş bir alt kümeyi çalıştırır. Ardından TASK_CHOICES, kullanıcı tek bir görevi ya da paket incelemeyi seçebilsin diye doğrudan Gradio açılır listesinde kullanılır.
Son kısım olan safe_str() şaşırtıcı derecede önemli bir kararlılık sorununu çözer. Geliştirme sırasında yaygın bir arıza modu şuydu:
'NoneType' object has no attribute 'strip'Bu şu durumlarda meydana gelebilir:
None döndürdüğünde,Tüm bu değerleri safe_str() işlevinden geçirerek normalleştirerek uygulamayı çok daha sağlam hâle getiriyoruz.
Modele herhangi bir şey gönderebilmeden önce, bir GitHub deposunu tek bir yapılandırılmış prompt’a dönüştürmemiz gerekir.
Bu adım, depoyu klonlama, alakasız dosyaları filtreleme, yalnızca kullanılabilir metni çıkarma ve her şeyi modelin tek seferde tüketebileceği bir formata paketleme dâhil olmak üzere tam alma hattını yönetir.
Geleneksel RAG hatlarının aksine, parçalama veya gömme yapmıyoruz. Bunun yerine tüm depoyu tek bir uzun bağlamlı girdiye sıkıştırıyoruz; dolayısıyla burada seçici ve yapılandırılmış olmak hem performans hem de kalite için kritik.
def clone_repo(repo_url: str, branch: str = "main") -> str:
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    if not repo_url:
        raise ValueError("Repository URL is empty.")
    if os.path.exists(WORKDIR):
        shutil.rmtree(WORKDIR)
    cmd = ["git", "clone", "--depth", "1"]
    if branch:
        cmd += ["--branch", branch]
    cmd += [repo_url, WORKDIR]
    subprocess.run(cmd, check=True, capture_output=True, text=True)
    return WORKDIR
def is_probably_text(path: Path) -> bool:
    try:
        with open(path, "rb") as f:
            chunk = f.read(2048)
        if b"\x00" in chunk:
            return False
        chunk.decode("utf-8")
        return True
    except Exception:
        return False
def iter_repo_files(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    for path in root.rglob("*"):
        if not path.is_file():
            continue
        rel = path.relative_to(root)
        parts = set(rel.parts)
        rel_str = str(rel).lower()
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        if path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        try:
            if path.stat().st_size > MAX_FILE_BYTES:
                continue
        except Exception:
            continue
        if not is_probably_text(path):
            continue
        yield path
def repo_tree_string(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool) -> str:
    root = Path(root)
    lines: List[str] = []
    for path in sorted(root.rglob("*")):
        rel = path.relative_to(root)
        rel_str = str(rel).lower()
        parts = set(rel.parts)
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if path.is_file() and path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        lines.append(f"{rel}/" if path.is_dir() else str(rel))
    return "\n".join(lines)
def pack_repo(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    tree = repo_tree_string(root, exclude_tests, exclude_docs, exclude_notebooks)
    files: List[Tuple[str, int, str]] = []
    total_tokens = len(enc.encode(tree))
    for path in iter_repo_files(root, exclude_tests, exclude_docs, exclude_notebooks):
        rel = path.relative_to(root)
        try:
            content = path.read_text(encoding="utf-8", errors="ignore")
        except Exception:
            continue
        block = f"\n=== FILE START: {rel} ===\n{content}\n=== FILE END: {rel} ===\n"
        tok = len(enc.encode(block))
        files.append((str(rel), tok, block))
        total_tokens += tok
    return tree, files, total_tokens
def build_repo_context(tree: str, files: List[Tuple[str, int, str]]) -> str:
    joined_files = "".join(block for _, _, block in files)
    return f"""=== REPO TREE START ===
{tree}
=== REPO TREE END ===
=== REPOSITORY FILES START ===
{joined_files}
=== REPOSITORY FILES END ===
"""
Bu adım, tam depo alma ve paketleme hattını tanımlar; ancak her işlevin belirli bir sorumluluğu vardır:
clone_repo() işlevi: Bu işlev, tam geçmişi çekmekten kaçınmak için sığ klon (--depth 1) kullanarak bir GitHub deposunu geçici bir çalışma dizinine klonlar. Depo URL’si ve dal gibi girdiler, çalışma zamanı hatalarını önlemek için safe_str() ile normalize edilir. Çıktı, hattın geri kalanının üzerinde çalıştığı yerel bir yoldur (WORKDIR).iter_repo_files() işlevi: Bu işlev ana filtreleme katmanı olarak çalışır. Depoyu özyinelemeli olarak tarar ve yalnızca yüksek sinyalli dosyaları getirir. Sistem dizinlerini, desteklenmeyen dosya türlerini, aşırı büyük dosyaları hariç tutar ve isteğe bağlı olarak testleri, dokümantasyonu ve not defterlerini filtreler. is_probably_text() işlevi: Bu, filtreleme sırasında kullanılan hafif bir güvenlik kontrolüdür. Her dosyadan küçük bir parça okur ve (genellikle ikili içeriği gösteren) null baytların yokluğunu ve başarılı UTF-8 kod çözmeyi doğrular. Yalnızca bu kontrolden geçen dosyalar geçerli metin olarak değerlendirilir ve nihai veri setine dâhil edilir.repo_tree_string() işlevi: Bu işlev, depo yapısının bir dize gösterimini oluşturur. Aynı filtreleme kurallarını uygulayarak bir dizin ağacı oluşturur ve dosya içeriklerini okumadan önce modelin kod tabanının düzenini üst düzeyde anlaması için prompt’ta kullanılan dizinler ve dosyaların bir listesini üretir.pack_repo() işlevi: Bu, çekirdek paketleme işlevidir. Tüm filtrelenmiş dosyalar üzerinde yineleme yapar, içeriklerini okur ve her dosyayı === FILE START === ve === FILE END === gibi açık işaretleyiciler içine sarar. Ayrıca tiktoken kullanarak token kullanımını tahmin eder ve toplam token sayısını toplar. build_repo_context() işlevi: Bu işlev her şeyi tek bir yapılandırılmış prompt’ta birleştirir. Önce depo ağacını, ardından tüm dosya içeriklerini yerleştirir. Model önce yapıyı anlar, ardından gerçek uygulama ayrıntılarını okur.Net etki, ham bir GitHub deposunun tek bir, yapılandırılmış uzun bağlamlı girdiye dönüştürülmesidir.
Depo filtrelenip tek bir uzun bağlamlı girdi hâline paketlendikten sonra, bir sonraki adım modelin ne tür bir analiz yapacağını ve sonucu nasıl biçimlendireceğini belirtmektir.
Her kullanım durumu için aynı genel talimatı göndermek yerine, seçilen görev adını, açıklamasını ve yanıtta beklenen JSON şemasını içeren görev özelinde bir prompt üretiyoruz.
def build_task_prompt(task_name: str, repo_context: str) -> str:
    task_name = safe_str(task_name)
    if not task_name:
        raise ValueError("Task name is empty.")
    if task_name not in TASK_DEFS:
        raise ValueError(f"Unknown task: {task_name}")
    task_def = TASK_DEFS[task_name]
    return f"""Analyze this full repository.
Task Name:
{task_name}
Task Description:
{task_def["description"]}
Return JSON matching this schema exactly:
{json.dumps(task_def["schema"], indent=2)}
{repo_context}
"""
def try_parse_json(text: str) -> Dict[str, Any]:
    text = safe_str(text)
    if not text:
        raise ValueError("Model returned empty text.")
    try:
        return orjson.loads(text)
    except Exception:
        start = text.find("{")
        end = text.rfind("}")
        if start != -1 and end != -1 and end > start:
            return orjson.loads(text[start:end+1])
        raise ValueError("Could not parse model output as JSON.")
Yukarıdaki kod parçası, paketlenmiş depo ile görev özelindeki analiz çıktısı arasında köprü görevi gören iki yakından ilişkili işlevi tanımlar.
build_task_prompt() işlevi: Bu işlev, modele gönderilen nihai prompt’u oluşturur. Önce boş girdi hattı bozmasın diye görev adını safe_str() ile normalize eder. Ardından TASK_DEFS içinde görevin varlığını doğrular; bu da uygulamanın desteklenmeyen veya yanlış yazılmış görev adlarını göndermesini önler. Görev doğrulandıktan sonra, işlev o görevin açıklamasını ve JSON şemasını alır ve her ikisini de tam paketli depo bağlamıyla birlikte nihai prompt’a gömer.try_parse_json() işlevi: Bu işlev, çıkarımdan sonra modelin çıktısını işler. Pratikte, uzun bağlamlı modeller zaman zaman JSON’u fazladan metin, biçimlendirme artıkları veya kısmi açıklayıcı içerikle sarabilir. Uygulamayı daha sağlam kılmak için try_parse_json() ilk olarak orjson.loads() ile doğrudan ayrıştırmayı dener. Sıkı prompt’lama ile hoşgörülü ayrıştırmayı birleştirerek uygulama daha istikrarlı kalır.Bir sonraki adımda, bu prompt’lama mantığını model çağrısına bağlayacak ve yapılandırılmış depo analiz sonuçları üretmeye başlayacağız.
Bu aşamada, prompt’u OpenRouter üzerinden Nemotron 3 Super’a göndererek analizi çalıştırıyoruz.
Depoyu parçalara bölmek veya kısımlarını geri getirmek yerine, filtrelenmiş tüm kod tabanını tek bir istekte gönderiyor ve modelin dosyalar, modüller ve bağımlılıklar arasında küresel olarak mantık yürütmesine izin veriyoruz.
def call_model(prompt: str, max_tokens: int = 5000) -> str:
    prompt = safe_str(prompt)
    if not prompt:
        raise ValueError("Prompt is empty.")
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
        ],
        temperature=0.2,
        max_tokens=max_tokens,
        extra_headers={
            "HTTP-Referer": "https://colab.research.google.com",
            "X-Title": "Whole Repo Analysis Demo"
        }
    )
    if not getattr(resp, "choices", None):
        raise ValueError("Model response has no choices.")
    message = getattr(resp.choices[0], "message", None)
    if message is None:
        raise ValueError("Model response has no message.")
    content = getattr(message, "content", None)
    content = safe_str(content)
    if not content:
        raise ValueError("Model returned empty content.")
    return content
call_model() işlevi, gerçek model çağrısını yürütmek ve yanıtı çıkarmaktan sorumludur. İşte tam hat:
0.2 olarak ayarlanmıştır; bu da çıktıları tutarlı kılar ve max_tokens parametresi yanıt boyutunu sınırlar; böylece model yapılandırılmış çıktıya odaklanır.Son olarak, model çıkarımı kısmına geçebilir ve analizi OpenRouter’ın barındırdığı model üzerinden nasıl çalıştırdığımızı anlayabiliriz.
Sırada, UI ve çıktı işlemeyi kolaylaştıracak birkaç küçük yardımcı işlev var.
def to_df(items, columns=None):
    if items is None:
        return pd.DataFrame(columns=columns or [])
    if isinstance(items, dict):
        return pd.DataFrame([items])
    if not items:
        return pd.DataFrame(columns=columns or [])
    return pd.DataFrame(items)
def get_tasks_to_run(task: str) -> List[str]:
    task = safe_str(task)
    if not task:
        raise ValueError("Task is empty.")
    return FULL_REVIEW_TASKS if task == "Full Review" else [task]
def visible_for_task(task: str) -> Dict[str, bool]:
    task = safe_str(task)
    if task == "Full Review":
        return {
            "modules": True,
            "deps": True,
            "issues": True,
            "dups": False,
            "refactor": False,
            "improvements": True,
            "roadmap": True,
            "testing": True,
            "onboarding": False,
            "libs": False,
            "hotspots": True,
            "security": False,
        }
    return {
        "modules": task == "Architecture Overview",
        "deps": task == "Architecture Overview",
        "issues": task == "Architecture Overview",
        "dups": task == "Code Duplication",
        "refactor": task == "Code Duplication",
        "improvements": task == "Improvement Opportunities",
        "roadmap": task == "Refactor Roadmap",
        "testing": task == "Testing Gaps",
        "onboarding": task == "Onboarding Guide",
        "libs": task == "Library Modernization",
        "hotspots": task == "Code Quality Hotspots",
        "security": task == "Security / Config Hygiene",
    }
def render_markdown_summary(repo_url: str, total_tokens: int, files, results: Dict[str, Dict[str, Any]]) -> str:
    repo_url = safe_str(repo_url)
    lines = [
        "# Whole-Repo Analysis Report",
        f"**Repository:** {repo_url}",
        f"**Files included:** {len(files)}",
        f"**Estimated input tokens:** {total_tokens}",
        "",
    ]
    if "Architecture Overview" in results:
        overview = results["Architecture Overview"].get("repo_overview", {})
        lines += [
            "## Architecture",
            overview.get("summary", "No summary returned."),
            "",
            f"**Primary languages:** {', '.join(overview.get('primary_languages', [])) or 'N/A'}",
            f"**Likely entrypoints:** {', '.join(overview.get('likely_entrypoints', [])) or 'N/A'}",
            "",
        ]
    if "Improvement Opportunities" in results:
        lines += [
            "## Improvement Opportunities",
            f"- Identified: {len(results['Improvement Opportunities'].get('improvement_opportunities', []))}",
            "",
        ]
    if "Code Quality Hotspots" in results:
        lines += [
            "## Code Quality Hotspots",
            f"- Identified: {len(results['Code Quality Hotspots'].get('quality_hotspots', []))}",
            "",
        ]
    if "Testing Gaps" in results:
        lines += [
            "## Testing Gaps",
            f"- Identified: {len(results['Testing Gaps'].get('testing_gaps', []))}",
            "",
        ]
    if "Code Duplication" in results:
        dup = results["Code Duplication"]
        lines += [
            "## Duplication & Refactor Summary",
            f"- Duplication candidates: {len(dup.get('duplication_candidates', []))}",
            f"- Design smells: {len(dup.get('design_smells', []))}",
            f"- High risk files: {len(dup.get('high_risk_files', []))}",
            f"- Refactor recommendations: {len(dup.get('refactor_recommendations', []))}",
            "",
        ]
    if "Library Modernization" in results:
        lines += [
            "## Library Modernization",
            f"- Recommendations: {len(results['Library Modernization'].get('library_recommendations', []))}",
            "",
        ]
    if "Security / Config Hygiene" in results:
        lines += [
            "## Security / Config Hygiene",
            f"- Findings: {len(results['Security / Config Hygiene'].get('security_and_config_findings', []))}",
            "",
        ]
    if "Refactor Roadmap" in results:
        lines += [
            "## Refactor Roadmap",
            f"- Planned items: {len(results['Refactor Roadmap'].get('refactor_roadmap', []))}",
            "",
        ]
    if "Onboarding Guide" in results:
        onboarding = results["Onboarding Guide"].get("onboarding_guide", {})
        lines += [
            "## Onboarding Guide",
            onboarding.get("summary", "No summary returned."),
            "",
            f"**Recommended reading order:** {', '.join(onboarding.get('recommended_reading_order', [])) or 'N/A'}",
            f"**Entrypoints:** {', '.join(onboarding.get('entrypoints', [])) or 'N/A'}",
            "",
        ]
    return "\n".join(lines)
def hidden_update():
    return gr.update(value=pd.DataFrame(), visible=False)
def visible_update(df):
    return gr.update(value=df, visible=True)
def empty_outputs(stats, status_message):
    return (
        status_message,
        "",
        *all_hidden(),
        "{}",
        json.dumps(stats, indent=2),
    )
Bu adım, küçük bir yardımcı işlev kümesini tanımlar; ancak birlikte uygulamanın sunum mantığının çoğunu ele alırlar.
to_df() işlevi: Bu işlev, model çıktılarıı pandas DataFrame’e dönüştürür; böylece Gradio tablolarında temizce işlenebilirler. get_tasks_to_run() işlevi: Uygulamanın tek bir görevi mi yoksa paket Full Review’ü mü çalıştıracağını belirler. Seçilen görev "Full Review" ise, önceden tanımlanmış inceleme görevleri listesine genişler. Aksi hâlde, seçilen görevi içeren tek öğelik bir liste döndürür. visible_for_task() işlevi: Hangi rapor tablolarının UI’da gösterileceğini kontrol eder. Örneğin, kullanıcı Onboarding Guide’ı seçerse, çoğaltma veya güvenlik tablolarını göstermek fayda sağlamaz. render_markdown_summary() işlevi: Ham JSON’u doğrudan dökmek yerine, bu işlev depo meta verileri, token sayımı ve görev özelindeki öne çıkanlarla okunabilir bir özet üretir.hidden_update() ve visible_update() işlevleri: Bunlar, bileşen durumunu kontrol etmek için kullanılan küçük Gradio yardımcılarıdır. hidden_update() bir tabloyu temizler ve gizler; visible_update() ise bir tabloyu verilerle doldurur ve görünür kılar. Bu kalıp önemlidir; çünkü Gradio, her çıktı bileşeni için bir dönüş değeri bekler ve açık sıfırlamalar olmadan sorun yaşanabilir.empty_outputs() işlevi: Bu işlev, erken çıkışları ve hata durumlarını ele alır. Depo çok büyükse, görev geçersizse veya başka bir şey başarısız olursa, uygulama yine de her UI bileşeni için geçerli çıktılar döndürmelidir. Birlikte, bu yardımcı işlevler çekirdek model mantığını değiştirmez; fakat kullanılabilir bir uygulama ortaya çıkarırlar.
Bu işlev, tam iş akışını düzenler. Girdileri doğrular, depoyu hazırlar, bir veya birden fazla analiz görevini çalıştırır ve yapılandırılmış çıktıları Gradio UI’ına döndürür.
def analyze_repo(repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks):
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    task = safe_str(task)
    try:
        if not repo_url:
            stats = {"repo_url": "", "branch": branch}
            return empty_outputs(stats, "Error: Repository URL is empty.")
        if not task:
            stats = {"repo_url": repo_url, "branch": branch}
            return empty_outputs(stats, "Error: Task is empty.")
        repo_path = clone_repo(repo_url, branch)
        tree, files, total_tokens = pack_repo(repo_path, exclude_tests, exclude_docs, exclude_notebooks)
        stats = {
            "repo_url": repo_url,
            "branch": branch,
            "files_included": len(files),
            "estimated_input_tokens": total_tokens,
            "token_budget": token_budget,
            "fits_budget": total_tokens <= token_budget,
            "sample_files": [f[0] for f in files[:30]],
            "tasks_requested": get_tasks_to_run(task),
        }
        if total_tokens > token_budget:
            msg = (
                f"Repo too large for current budget.\n\n"
                f"Estimated tokens: {total_tokens}\n"
                f"Budget: {token_budget}\n\n"
                f"Try excluding tests/docs/notebooks or use a smaller repo."
            )
            return empty_outputs(stats, msg)
        repo_context = build_repo_context(tree, files)
        tasks_to_run = get_tasks_to_run(task)
        results: Dict[str, Dict[str, Any]] = {}
        for task_name in tasks_to_run:
            prompt = build_task_prompt(task_name, repo_context)
            raw_text = call_model(prompt)
            results[task_name] = try_parse_json(raw_text)
        report_md = render_markdown_summary(repo_url, total_tokens, files, results)
        vis = visible_for_task(task)
        arch_json = results.get("Architecture Overview", {})
        dup_json = results.get("Code Duplication", {})
        imp_json = results.get("Improvement Opportunities", {})
        roadmap_json = results.get("Refactor Roadmap", {})
        testing_json = results.get("Testing Gaps", {})
        onboarding_json = results.get("Onboarding Guide", {})
        lib_json = results.get("Library Modernization", {})
        hotspot_json = results.get("Code Quality Hotspots", {})
        security_json = results.get("Security / Config Hygiene", {})
        modules_df = to_df(arch_json.get("modules", []), ["name", "responsibility", "key_files", "evidence_paths"])
        deps_df = to_df(arch_json.get("dependencies", []), ["from_module", "to_module", "relationship", "evidence_paths"])
        issues_df = to_df(arch_json.get("issues", []), ["type", "description", "severity", "evidence_paths"])
        dups_df = to_df(dup_json.get("duplication_candidates", []), ["summary", "files_involved", "why_it_looks_duplicate", "confidence"])
        refactor_df = to_df(dup_json.get("refactor_recommendations", []), ["title", "description", "target_files", "expected_benefit"])
        improvements_df = to_df(imp_json.get("improvement_opportunities", []), ["title", "description", "why_it_matters", "affected_files", "suggested_change", "expected_impact", "effort", "evidence_paths"])
        roadmap_df = to_df(roadmap_json.get("refactor_roadmap", []), ["priority", "title", "description", "target_files", "impact", "effort", "why_now"])
        testing_df = to_df(testing_json.get("testing_gaps", []), ["module_or_file", "why_it_needs_tests", "likely_missing_cases", "recommended_test_type", "evidence_paths"])
        onboarding_df = to_df(onboarding_json.get("onboarding_guide", {}), ["summary", "recommended_reading_order", "entrypoints", "important_directories", "debugging_start_points", "common_confusion_points"])
        libs_df = to_df(lib_json.get("library_recommendations", []), ["current_library_or_pattern", "where_used", "suggested_alternative", "why_better", "migration_difficulty", "confidence", "evidence_paths", "recommendation_type"])
        hotspots_df = to_df(hotspot_json.get("quality_hotspots", []), ["file_or_module", "risk_level", "why_it_is_a_hotspot", "evidence_paths", "recommended_cleanup"])
        security_df = to_df(security_json.get("security_and_config_findings", []), ["title", "severity", "description", "affected_files", "evidence_paths", "recommended_fix", "confidence"])
        status = (
            f"Done.\n\n"
            f"Files included: {len(files)}\n"
            f"Estimated input tokens: {total_tokens}\n"
            f"Tasks run: {', '.join(tasks_to_run)}"
        )
        return (
            status,
            report_md,
            visible_update(modules_df) if vis["modules"] else hidden_update(),
            visible_update(deps_df) if vis["deps"] else hidden_update(),
            visible_update(issues_df) if vis["issues"] else hidden_update(),
            visible_update(dups_df) if vis["dups"] else hidden_update(),
            visible_update(refactor_df) if vis["refactor"] else hidden_update(),
            visible_update(improvements_df) if vis["improvements"] else hidden_update(),
            visible_update(roadmap_df) if vis["roadmap"] else hidden_update(),
            visible_update(testing_df) if vis["testing"] else hidden_update(),
            visible_update(onboarding_df) if vis["onboarding"] else hidden_update(),
            visible_update(libs_df) if vis["libs"] else hidden_update(),
            visible_update(hotspots_df) if vis["hotspots"] else hidden_update(),
            visible_update(security_df) if vis["security"] else hidden_update(),
            json.dumps(results, indent=2),
            json.dumps(stats, indent=2),
        )
    except subprocess.CalledProcessError as e:
        stats = {"repo_url": repo_url, "branch": branch}
        stderr = safe_str(getattr(e, "stderr", "")) or safe_str(e)
        return empty_outputs(stats, f"Git clone failed:\n{stderr}")
    except Exception as e:
        stats = {"repo_url": repo_url, "branch": branch}
        return empty_outputs(stats, f"Error: {safe_str(e)}")
Bu işlev, ham depodan yapılandırılmış çıktıya kadar tüm hattı düzenler.
results sözlüğünde depolanır.to_df() kullanılarak DataFrame’lere dönüştürülür ve UI bileşenlerine eşlenir. Görünürlük, seçilen göreve göre yalnızca ilgili tabloların gösterilmesini sağlayan visible_for_task() ile kontrol edilir.empty_outputs() ile güvenle ele alınır.Son olarak, her şeyi basit bir Gradio arayüzü içinde sarıyoruz.
with gr.Blocks(title="Nemotron Repo Analyzer") as demo:
    gr.Markdown("# Nemotron Repo Analyzer")
    # gr.Markdown("Analyze a public GitHub repository without RAG using a single packed prompt.")
    with gr.Tab("Analyze"):
        with gr.Row():
            repo_url = gr.Textbox(
                label="GitHub Repo URL",
                value="https://github.com/AashiDutt/Nemotron-3-Nano.git"
            )
            branch = gr.Textbox(label="Branch", value="main")
        with gr.Row():
            task = gr.Dropdown(
                choices=TASK_CHOICES,
                value="Full Review",
                label="Task"
            )
            token_budget = gr.Slider(
                minimum=40000,
                maximum=180000,
                step=5000,
                value=120000,
                label="Token Budget"
            )
        with gr.Row():
            exclude_tests = gr.Checkbox(value=False, label="Exclude tests")
            exclude_docs = gr.Checkbox(value=False, label="Exclude docs / markdown")
            exclude_notebooks = gr.Checkbox(value=True, label="Exclude notebooks")
        analyze_btn = gr.Button("Analyze Repo", variant="primary")
        status = gr.Textbox(label="Status", lines=7)
    with gr.Tab("Report"):
        report_md = gr.Markdown()
        modules_df = gr.Dataframe(label="Modules", visible=False)
        deps_df = gr.Dataframe(label="Dependencies", visible=False)
        issues_df = gr.Dataframe(label="Architecture Issues", visible=False)
        dups_df = gr.Dataframe(label="Duplication Candidates", visible=False)
        refactor_df = gr.Dataframe(label="Refactor Recommendations", visible=False)
        improvements_df = gr.Dataframe(label="Improvement Opportunities", visible=False)
        roadmap_df = gr.Dataframe(label="Refactor Roadmap", visible=False)
        testing_df = gr.Dataframe(label="Testing Gaps", visible=False)
        onboarding_df = gr.Dataframe(label="Onboarding Guide", visible=False)
        libs_df = gr.Dataframe(label="Library Modernization", visible=False)
        hotspots_df = gr.Dataframe(label="Code Quality Hotspots", visible=False)
        security_df = gr.Dataframe(label="Security / Config Hygiene", visible=False)
    with gr.Tab("Raw JSON"):
        all_results_json_box = gr.Code(label="All Task Results JSON", language="json")
        stats_box = gr.Code(label="Run Stats", language="json")
    analyze_btn.click(
        analyze_repo,
        inputs=[repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks],
        outputs=[
            status,
            report_md,
            modules_df,
            deps_df,
            issues_df,
            dups_df,
            refactor_df,
            improvements_df,
            roadmap_df,
            testing_df,
            onboarding_df,
            libs_df,
            hotspots_df,
            security_df,
            all_results_json_box,
            stats_box,
        ]
    )
demo.launch(debug=True, share=True)
gr.Blocks() kapsayıcısı, uygulamanın genel yerleşimini tanımlar; üst düzey Markdown ise başlığı ve bağlamı ayarlar. Arayüz, iş akışını düzenli tutmak için üç sekmeye bölünmüştür.
Bu, kullanıcı girdilerini doğrudan analyze_repo() işlevine bağlar ve çıktıları UI bileşenlerine geri eşler. Çıktıların sıralaması burada kritiktir; çünkü döndürülen her değer belirli bir UI öğesine yönlendirilir.
Son olarak uygulama şu komutla başlatılır:
demo.launch(debug=True, share=True)debug=True bayrağı geliştirme sırasında çalışma zamanı hatalarının yüzeye çıkmasına yardımcı olurken, share=True genel bir bağlantı oluşturur ve uygulamayı dağıtım olmadan paylaşmayı kolaylaştırır.
Bu eğitimde, NVIDIA Nemotron 3 Super, OpenRouter ve Gradio kullanarak bir depo kod tabanı analiz aracı nasıl oluşturacağımı gösterdim.
Parçalama, gömme ve geri getirmeye güvenmek yerine, uygulama herkese açık bir GitHub deposunu klonlar; kod tabanını filtreleyip tek bir prompt’a paketler ve modelden tüm depo üzerinde bir kerede mantık yürütmesini ister.
Bu tüm bağlam yaklaşımı, mimari açıklama, işe alıştırma rehberi, test boşluğu analizi, iyileştirme fırsatları ve yeniden düzenleme planlaması gibi kod tabanının küresel bir görünümünü gerektiren görevler için faydalıdır.
Buradan projeyi birkaç yolla genişletebilirsiniz:
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme