
Cursus
Inleiding tot statistiek in Python
4 uur
199.2K
Als je onze tutorial over covariantie al hebt bekeken, weet je dat die draait om hoe twee variabelen samen veranderen. Correlatie gaat een stap verder door de maatstaf te standaardiseren, zodat je relaties kunt vergelijken tussen verschillende datasets.
In deze gids leer je wat correlatie is (we focussen specifiek op de meest gangbare, de Pearson-correlatie), hoe die verschilt van covariantie en hoe je die kunt berekenen en interpreteren met Python en R. Tot slot behandelen we ook verschillende soorten correlaties voor verschillende scenario’s.
Wil je je statistiekvaardigheden verder versterken, mis dan onze skill track Statistics Fundamentals in Python of de cursus Introduction to Statistics in R niet.
Correlatie meet de sterkte en richting van een lineaire relatie tussen twee kwantitatieve variabelen. Het helpt je te begrijpen hoe veranderingen in de ene variabele samenhangen met veranderingen in een andere.
Een positieve correlatie betekent dat wanneer de ene variabele toeneemt, de andere ook de neiging heeft toe te nemen. Een negatieve correlatie betekent dat wanneer de ene variabele toeneemt, de andere de neiging heeft af te nemen.
Laat me de belangrijkste ideeën opsommen:
Zoals gezegd meet de Pearson-correlatiecoëfficiënt de lineaire relatie tussen twee continue variabelen. Wat ik nog niet heb genoemd: hij gaat uit van normaal verdeelde data (strikt genomen: de variabelen zijn gezamenlijk normaal verdeeld, oftewel bivariate normaliteit – er zit wat nuance in), en is gevoelig voor uitschieters. De Pearson-correlatiecoëfficiënt wordt aangeduid met r.
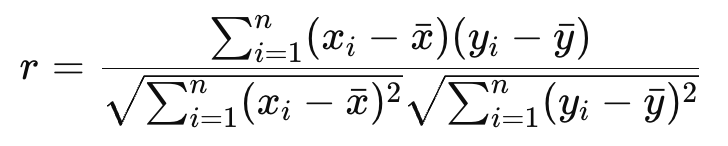
waar xi en yi datapunten zijn, en x en y hun respectieve gemiddelden.
Laten we bekijken hoe je dit berekent in Python en R.
Je kunt de Pearson-correlatiecoëfficiënt in Python berekenen met de functie pearsonr() uit de module scipy.stats:
import numpy as np
from scipy.stats import pearsonr

# Temperature data in Celsius and corresponding Fahrenheit
temperature_celsius = np.array([0, 10, 20, 30, 40])
temperature_fahrenheit = np.array([32, 50, 68, 86, 104])  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient, p_value = pearsonr(temperature_celsius, temperature_fahrenheit)
print("Pearson correlation coefficient:", correlation_coefficient)
Pearson correlation coefficient: 1.0
p-value: 0.0De output laat een perfecte positieve lineaire relatie zien tussen x_values en y_values (omdat we y simpelweg hebben gedefinieerd als 2x).
In R kun je de functie cor() gebruiken:
temperature_celsius <- c(0, 10, 20, 30, 40)
temperature_fahrenheit <- c(32, 50, 68, 86, 104)  # Converted from Celsius

# Calculate Pearson correlation coefficient
correlation_coefficient <- cor(temperature_celsius, temperature_fahrenheit, method = "pearson")
print(correlation_coefficient)
[1] 1Ook deze output geeft, net als eerder, een perfecte positieve lineaire relatie aan.
Een correlatiematrix toont de correlatiecoëfficiënten tussen meerdere paren variabelen in een dataset. Het is handig om relaties in multivariate data te verkennen.
Het is gebruikelijk om variabelen in matrixvorm weer te geven, zoals een pandas DataFrame, en de correlatiematrix direct te berekenen:
import pandas as pd

# Create a DataFrame with two perfectly correlated variables and one that isn't
data = pd.DataFrame({
    'temperature_celsius': [0, 10, 20, 30, 40],
    'temperature_fahrenheit': [32, 50, 68, 86, 104],  # Perfect linear transformation
    'ice_cream_sales': [100, 150, 200, 220, 230]      # Roughly increasing, not perfectly
})

# Calculate the Pearson correlation matrix
correlation_matrix = data.corr(method='pearson')
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.000000 1.000000 0.993858
temperature_fahrenheit 1.000000 1.000000 0.993858
ice_cream_sales 0.993858 0.993858 1.000000Deze output laat het volgende zien:
Een perfecte positieve correlatie tussen temperature_celsius en temperature_fahrenheit (zoals verwacht, net als eerder).
Een sterke maar niet perfecte correlatie tussen ice_cream_sales en zowel temperature_celsius als temperature_fahrenheit.
In R kun je hetzelfde bereiken met de functie cor() die we eerder gebruikten, toegepast op een data frame of matrix:
# Create a data frame with two perfectly correlated variables and one unrelated
data <- data.frame(
  temperature_celsius = c(0, 10, 20, 30, 40),
  temperature_fahrenheit = c(32, 50, 68, 86, 104),  # Perfect conversion from Celsius
  ice_cream_sales = c(100, 150, 200, 220, 230)      # Generally increases, but not perfectly
)

# Calculate the correlation matrix
correlation_matrix <- cor(data, method = "pearson")
print(correlation_matrix)
temperature_celsius temperature_fahrenheit ice_cream_sales
temperature_celsius 1.00 1.00 0.99
temperature_fahrenheit 1.00 1.00 0.99
ice_cream_sales 0.99 0.99 1.00Deze R-output weerspiegelt het Python-voorbeeld, met:
Perfecte positieve correlatie tussen temperature_celsius en temperature_fahrenheit.
Sterke negatieve correlatie tussen ice_cream_sales en temperature_celsius of temperature_fahrenheit.
Dit soort matrixweergave is vooral handig om potentiële multicollineariteit in regressie te identificeren of om variabelen te kiezen voor dimensionaliteitsreductietechnieken zoals PCA.
We zien dat correlatie lineaire verbanden vastlegt. Laten we het nu duidelijk onderscheiden van begrippen die erop lijken.
Zowel correlatie als covariantie meten hoe twee variabelen samen veranderen, maar ze verschillen in twee dingen: schaal en interpreteerbaarheid.
Covariantie geeft de richting van een lineaire relatie aan, maar niet op een gestandaardiseerde manier de sterkte ervan. De waarde hangt af van de eenheden van de variabelen, wat vergelijken tussen datasets lastig maakt.
Correlatie standaardiseert de covariantie door te delen door de standaarddeviaties van de variabelen, wat een eenheidsloze waarde tussen -1 en 1 oplevert.
R-kwadraat (R²), of de determinatiecoëfficiënt, wordt ook weleens verward met correlatie. Ik zie dit vooral wanneer analisten modelprestaties proberen te interpreteren.
Correlatie (Pearsons r) meet de sterkte en richting van een lineaire relatie tussen twee variabelen.
R-kwadraat vertegenwoordigt het aandeel verklaarde variantie in de ene variabele dat voorspelbaar is op basis van een andere variabele in een lineair regressiemodel. In eenvoudige lineaire regressie is het het kwadraat van Pearsons r.
Verwar correlatie niet met causaliteit! Dit is een veelgemaakte fout.
Correlatie laat alleen zien dat twee variabelen samen bewegen. Het verklaart niet waarom. Het is dus beschrijvend, niet verklarend. Correlatie kan het gevolg zijn van toeval, confounders of omgekeerde causaliteit.
Causaliteit impliceert dat een verandering in de ene variabele direct veroorzaakt dat een andere variabele verandert. Bewaar gesprekken over causaliteit voor gecontroleerde experimenten of voor causale-inferentietechnieken.
Het is belangrijk om je bewust te zijn van veelgemaakte fouten door analisten:
In dit artikel hebben we de Pearson-correlatiecoëfficiënt behandeld, omdat deze direct voortbouwt op het concept van covariantie en in de praktijk het meest wordt gebruikt. Maar laten we nu naar andere soorten kijken.
Spearman rangcorrelatie beoordeelt de sterkte en richting van een monotone relatie met gerangschikte waarden. Het is niet-parametrisch en werkt goed voor ordinale data of niet-lineaire maar consistente trends.
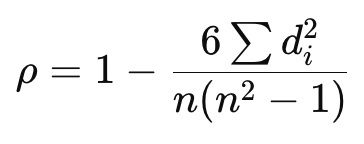
Waarbij:
De Kendall-taucoëfficiënt meet ook monotone relaties met rangen, maar is gebaseerd op het aantal concordante en discordante paren. Hij is robuuster bij gelijke rangen en kleine steekproeven.
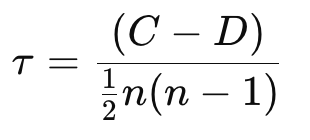
Waarbij:
Ik hoop dat je dit artikel nuttig vond. Zoals je hebt gezien, is correlatie een fundamenteel hulpmiddel in data-analyse om relaties tussen variabelen te begrijpen.
Blijf vooral leren met onze cursussen. Ik raad onze skill track Statistics Fundamentals in Python of onze cursus Introduction to Statistics in R aan als mooie volgende stappen.
Leren met DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

