
Cursus
Generatieve AI-concepten
2 uur
119.7K
Heb je je ooit afgevraagd waarom een paar websites het meeste internetverkeer krijgen? Of waarom een klein deel van de mensen het grootste deel van de wereldwijde rijkdom bezit? Het antwoord ligt in een fascinerend statistisch fenomeen dat bekendstaat als de power law.
Power laws bepalen het gedrag van veel natuurlijke en door mensen gemaakte systemen. Deze verdelingen zijn bijzonder omdat ze niet met schaal veranderen en zware staarten hebben. Deze eigenschappen maken ze ideaal om data te modelleren waarbij kleine gebeurtenissen vaak voorkomen, maar grote, belangrijke gebeurtenissen, hoe zeldzaam ook, niet genegeerd kunnen worden.
Deze tutorial geeft een uitgebreid overzicht van power laws, inclusief hun theorie, wiskunde, toepassingen en hoe je ze schat. We bekijken hoe ze schaalaan invariant zijn en waarom ze opduiken in uiteenlopende vakgebieden zoals geofysica, financiën, biologie en het internet.
Laten we beginnen met wat power laws bijzonder maakt—en waarin ze verschillen van de verdelingen die je tot nu toe misschien hebt gebruikt.
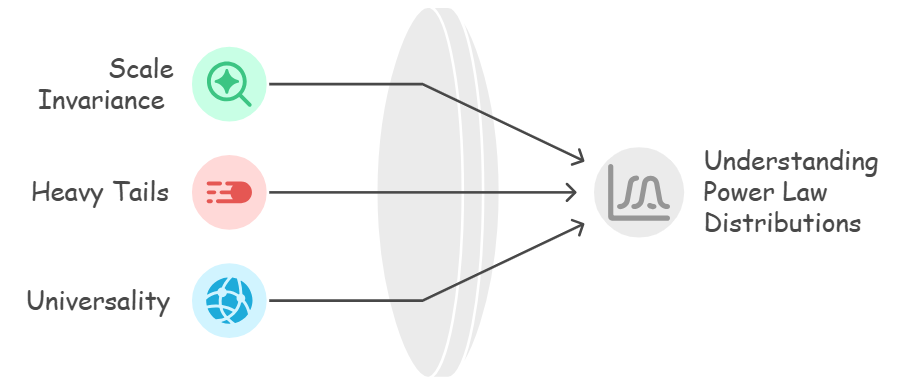
Kenmerken van power laws. Bron: Napkin AI
Simpel gezegd betekent schaalinvariantie dat als je in- of uitzoomt, het patroon in de verdeling hetzelfde blijft.
In statistische termen heeft een powerlaw-verdeling dezelfde functionele vorm, ongeacht de schaal waarop je kijkt. Als een variabele een power law volgt, verandert vermenigvuldigen met een constante de manier waarop hij verdeeld is niet; het verandert alleen de schaal.
Wiskundig betekent dit:
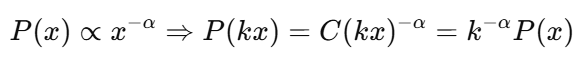
Dit is heel anders dan bij andere veelvoorkomende verdelingen, zoals de normale verdeling, waar de vorm wordt bepaald door bepaalde sleutelparameters zoals het gemiddelde en de standaarddeviatie.
Deze eigenschap lijkt ook op zelfgelijkvormigheid, een kernkenmerk van fractals. Fractals zijn structuren die er hetzelfde uitzien, ongeacht hoe ver je inzoomt. Als je bijvoorbeeld op een willekeurig deel van een sneeuwvlok, varenblad of boomtak inzoomt, zie je een kleinere versie van het geheel.
Een kustlijn ziet er op 10 meter afstand hetzelfde uit als op 10 kilometer afstand.
Power laws laten deze herhalende structuur uitstekend zien. Daarom zijn ze handig bij systemen waar grootte, frequentie of intensiteit sterk varieert, maar toch steeds hetzelfde patroon volgt.
De meeste klassieke verdelingen (zoals Gaussisch of exponentieel) lopen in de staarten snel af. Niet zo bij power laws. Ze hebben zware staarten, wat betekent dat de kans op extreme gebeurtenissen hoger is.
In het echte leven zijn grote aardbevingen, virale tweets en miljardairs voorbeelden van zeldzame gebeurtenissen die toch een kans hebben om voor te komen. Voor sommige waarden van alpha bestaan momenten zoals het gemiddelde of de variantie zelfs niet, en daarom zeggen we dat powerlaw-verdelingen geen schaal hebben.
Een bijzonder aspect van power laws is hun universaliteit; ze komen voor in systemen die ogenschijnlijk niets met elkaar te maken hebben. Voorbeelden zijn: aardbevingsmagnitudes, pieken in neurale activiteit, bedrijfsomvang en woordfrequenties.
Het keerzijde is dat ze ook statistisch onvolledig zijn. Dat betekent dat we wel het gedrag van de staart kunnen modelleren, maar dat het lastig is om een volledige set samenvattende statistieken te schatten, zeker bij kleine steekproeven.
Laten we dieper ingaan op de wiskunde die power laws zowel krachtig als lastig maakt.
De standaardvorm van een power law is:
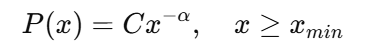
Waarbij:
Als alpha toeneemt, wordt de staart dunner. Een kleine alpha betekent dat gebeurtenissen extremer zijn. Deze schaalsexponent bepaalt alles van ongelijkheid tot ecosysteemgroottes.
De eerste stap is om een log-log-plot te gebruiken om een power law in echte datasets te detecteren.
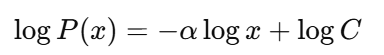
Als de data echt een power law volgt, krijg je een rechte lijn met een helling van −α. Maar pas op: veel verdelingen lijken lineair op een log-log-plot.
Er zijn verschillende belangrijke statistische verdelingen die op power laws lijken.
Soms volgt data in de echte wereld niet oneindig lang een "pure" power law. In zulke situaties zien we exponentiële afkappingen (waarbij zeer grote waarden minder waarschijnlijk worden), gekromde power laws of lognormale staarten. Deze zijn geschikter voor het modelleren van systemen met fysieke of praktische grenzen. Deze hybriden erkennen dat schaalinvariantie voor een deel van het bereik kan werken, maar uiteindelijk ophoudt te gelden.
Power laws zijn niet alleen ideeën uit de wiskunde; ze komen in de echte wereld voor en helpen ons systemen te begrijpen die in eerste instantie willekeurig of chaotisch lijken.
Power laws helpen ons extreme gebeurtenissen in de natuur te begrijpen. Zo stelt de wet van Gutenberg-Richter dat aardbevingsmagnitudes een powerlaw-verdeling volgen. Dat betekent dat kleine bevingen vaak voorkomen, maar dat het aantal bevingen snel afneemt naarmate de magnitude groter wordt. Daarom kan een beving van 2,0 dagelijks voorkomen, maar een beving van 7,0 misschien jaren niet. Beide maken deel uit van hetzelfde statistische verhaal.
Op dezelfde manier vertonen rivierstelsels, kustlijnen en zelfs blikseminslagen zelfgelijkvormige, fractale patronen die powerlaw-schaalgedrag volgen in de segmentgroottes.
Power laws zijn ook toepasbaar op het universum. In de astrofysica zien we dat de grootte van sterren, de verdeling van zwarte gaten en zelfs de clusters van sterrenstelsels allemaal zware staarten hebben. Er zijn miljarden kleine sterren, maar slechts een paar enorme springen eruit in het sterrenstelsel. Het lijkt misschien willekeurig ongelijk, maar zodra we de onderliggende power law begrijpen, zien we dat het bepaalde statistische regels volgt.
Bij het bekijken van ongelijkheid en schaal in menselijke samenlevingen zijn power laws bijzonder nuttig. We hebben de Pareto-verdeling al genoemd in de vorige sectie, die niet alleen een theorie over de economie is; je ziet haar terug in belastinggegevens, bedrijfswinsten en schenkingspatronen.
De top 1% vermogenden volgt de wet van Pareto, niet Gaussische gemiddelden. Deze verdelingen passen niet in een nette klokvorm; ze strekken zich ver naar rechts uit en tonen enkele extreme waarden (zoals miljardairs) die het gemiddelde vertekenen.
Power laws onthullen ook verborgen patronen in de biologie. Zo stelt de wet van Kleiber dat de stofwisselingssnelheid van een dier toeneemt met zijn lichaamsmassa tot de macht 3/4, niet lineair. Dat helpt te begrijpen waarom een olifant niet duizend keer meer eet dan een konijn, hoewel hij duizend keer zo zwaar is.
Power laws zijn ook van toepassing op stadsbevolkingen, groeipercentages van bedrijven, stemgedrag en zelfs doden in conflicten, waar enkele grote zaken of gebeurtenissen een buitenproportioneel effect hebben.
Power laws houden de digitale wereld draaiende en bloeiend. Denk aan hoe internetverkeer werkt: slechts een paar sites (zoals Google, Facebook en YouTube) krijgen het merendeel van de bezoeken, terwijl miljoenen andere pagina's grotendeels onopgemerkt blijven. Dit is typisch longtail-gedrag en is vooral belangrijk in gebieden als SEO, aanbevelingssystemen en digitale marketing.
In AI gaan de omvang en prestaties van modellen vaak hand in hand. Er zijn een paar grote modellen, zoals GPT-4, die toonaangevend zijn, maar honderden kleinere modellen kunnen niet meekomen. Deze concentratie komt deels door feedbacklussen: betere modellen krijgen meer gebruikers, data en geld, waardoor ze nog krachtiger worden.
Dus, het lijkt erop dat je dataset een power law volgt. Het histogram kan een lange staart hebben, of de log-log-plot toont een grotendeels rechte lijn. Dat is een goed begin, maar alleen kijken is niet genoeg, want het is niet zo moeilijk om je door power laws te laten misleiden. Daarom hebben we goede statistische tools nodig om de parameters te schatten en de passing te toetsen.
De schaalsexponent, meestal geschreven als 𝛼, is het eerste wat je nodig hebt om een powerlaw-verdeling correct te modelleren.
Maximum Likelihood Estimation (MLE) is een van de meest gebruikelijke manieren om een schatting van 𝛼 te krijgen. Het is in de statistiek een methode om die parameterwaarden te vinden die de geobserveerde data het meest waarschijnlijk maken.
Voor continue data met een bekende minimale waarde 𝑥min werkt dit als volgt:
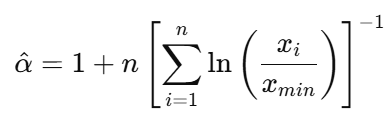
Maar hier zit de lastige kant: het kiezen van de juiste 𝑥 min is heel belangrijk. Is die te laag, dan bevat je model data die eigenlijk geen power law volgt. En als hij te hoog is, verspil je te veel data. Bovendien kunnen MLE-schattingen onbetrouwbaar zijn bij kleine steekproeven.
Nadat je de exponent hebt geschat, is de volgende vraag: hoe goed past het? Je kunt niet volstaan met: "Het lijkt wel een power law." Je hebt statistisch bewijs nodig dat de power law je data beter verklaart dan andere mogelijke verdelingen. Hier komt de Kolmogorov–Smirnov (KS)-toets in beeld. Deze toets zoekt de grootste kloof tussen de cumulatieve verdelingsfunctie (CDF) van je waargenomen data en het theoretische powerlaw-model.
Hoe dichter dit getal bij nul ligt, hoe beter je model past. De KS-toets gebruikt geen binning of histogrammen zoals veel andere toetsen. In plaats daarvan werkt hij direct met de ruwe data, wat hem erg nuttig maakt voor verdelingen met zware staarten.Maar soms is een power law niet de enige plausibele verklaring. Een lognormale of exponentiële verdeling kan je data ook modelleren. Dan zijn likelihood-ratiotoetsen handig. Het idee is eenvoudig: pas met MLE beide modellen op dezelfde data, bepaal de likelihoods en vergelijk ze. Je hebt statistische steun voor het powerlaw-model als de likelihood daarvan veel hoger is.
Het Clauset-Shalizi-Newman (2009)-raamwerk is een van de vele tools die MLE, KS-toetsing en likelihood-ratiotoetsen combineren tot een robuuste aanpak om powerlaw-gedrag te analyseren.
Nu we weten waar power laws in de echte wereld opduiken en hoe we ze statistisch kunnen vinden, is de volgende vraag: waarom verschijnen deze verdelingen überhaupt? Laten we bekijken hoe power laws uit systeemdynamiek kunnen ontstaan.
Het Barabási–Albert-model (1999) introduceerde preferentiële aansluiting, vaak samengevat als het fenomeen "de rijken worden rijker". Het is een van de bekendste en meest toegankelijke manieren waarop power laws ontstaan.
Denk aan het opbouwen van een netwerk, zoals het internet of een socialmediaplatform. Wanneer een nieuwe gebruiker toetreedt, is de kans groter dat die verbinding maakt met populaire knooppunten zoals Facebook of Google, omdat die al bekend zijn.
Na verloop van tijd ontstaat er een feedbacklus: populaire knooppunten krijgen nog meer connecties, terwijl nieuwere of minder verbonden knooppunten klein blijven. Dit creëert een schaalvrij netwerk waarin de knooppuntgraden een power law volgen.
Op vergelijkbare wijze modelleren Yule-processen de groei van biologische geslachten als een uitwerking van dit idee. In dit model hebben soorten die al meer leden hebben een grotere kans om nieuwe soorten voort te brengen. Dit leidt tot een scheve verdeling waarbij een paar geslachten domineren.
Willekeurige groeiprocessen zijn een andere manier waarop power laws kunnen ontstaan. Het kernidee is dat dingen in de tijd groeien door willekeurige vermenigvuldiging in plaats van optelling.
De wet van Gibrat stelt dat het groeipercentage onafhankelijk is van de omvang. De meeste zaken blijven klein, maar enkele groeien heel snel en worden erg groot, wat de zware staart van een power law oplevert.
Markov-processen, vooral die met multiplicatieve ruis, kunnen ook convergeren naar stationaire verdelingen die op power laws lijken—zeker bij reflecterende grenzen.
Er is ook een probabilistische kant aan dit verhaal. Markov-processen kunnen in sommige situaties ook powerlaw-gedrag vertonen. Deze processen modelleren systemen waarbij de volgende toestand alleen afhangt van de huidige, niet van het verleden. Ze zijn gebruikt om onder meer populatiebewegingen en wachtrijen te modelleren.
Deze modellen zijn niet alleen interessante ideeën. Ze helpen ons te begrijpen hoe complexe systemen evolueren, waarom ongelijkheid in stand blijft en hoe netwerkeffecten alles beïnvloeden, van biologie tot blockchain. Met power laws kunnen we de wereld niet alleen beschrijven, maar ook verklaren.
Het begrijpen van de dynamiek van power laws is superbelangrijk en kan grote impact hebben op je voorspellingen en keuzes, of je nu een financieel risicomodel bouwt, internetinfrastructuur beheert of sociaal gedrag bestudeert.
Powerlaw-modellen zijn nuttig voor systemen waar zeldzame maar belangrijke gebeurtenissen voorkomen. In de financiën veranderen prijzen bijvoorbeeld op de meeste dagen in een normaal tempo, maar de "zwarte zwanen"—de zeldzame crashes of pieken—kunnen de grootste impact hebben.
Powerlaw-modellen kunnen dit staart-risico beter vangen dan traditionele modellen, die de kans op zulke gebeurtenissen vaak onderschatten. Dat is cruciaal voor risicobeheer, verzekeringen, cybersecurity en rampenplanning.
Er is ook het voordeel dat ze niet-lineaire groei en rente-op-rente-effecten inzichtelijk maken. Power laws helpen verklaren waarom sommige mensen, bedrijven of knooppunten in een netwerk na verloop van tijd het machtigst kunnen worden, en waarom deze "winner-takes-most"-situaties in dit soort systemen niet uitzonderlijk maar juist normaal zijn.
Maar er zijn ook afruilen bij powerlaw-modellen. Een probleem is dat ze tegen je intuïtie ingaan: ze hebben niet altijd duidelijke gemiddelden of varianties, wat het lastig maakt om gangbare kengetallen zoals "verwachte waarde" of "standaarddeviatie" te bepalen.
Deze modellen werken meestal alleen op de staart van de verdeling, dus ze passen mogelijk niet goed of helemaal niet op het grootste deel van de data. Dat kan een probleem zijn als je niet zorgvuldig bepaalt waar het powerlaw-gedrag daadwerkelijk begint.
Niet alle datasets met lange staarten volgen een echte power law. Sommige verdelingen, zoals lognormaal of stretched exponential, kunnen in een klein bereik op powerlaw-gedrag lijken, vooral op een log-log-plot. Dit leidt vaak tot valse positieven, waarbij we iets als power law bestempelen omdat de grafiek "lineair oogt".Overgeneralisatie is een ander probleem. Mensen denken vaak dat power laws alles in een systeem verklaren, terwijl ze misschien slechts een klein deel verklaren, meestal het extreme uiteinde. Zo kan de inkomensverdeling van de top 1% een power law volgen, maar de rest van de populatie een heel andere.
De wet van de afnemende meeropbrengst is een ander probleem in de echte wereld. Power laws stellen dat extreme uitkomsten mogelijk zijn, maar in sommige domeinen, zoals fysieke limieten of regelgevende omgevingen, zijn er grenzen waarboven het model niet meer werkt. Als je ervan uitgaat dat het staartgedrag eindeloos doorgaat, kun je risico's of beloningen overschatten, vooral in systemen met grenzen.
Power laws helpen ons systemen te begrijpen waarin enkele extreme gebeurtenissen of entiteiten een groot effect hebben, zoals aardbevingen, internetverkeer of de verdeling van inkomens. In deze tutorial hebben we behandeld wat power laws onderscheidt, hun wiskundige eigenschappen en empirische vingerafdrukken, hoe je ze vindt en toetst, en waar ze in de echte wereld voorkomen.
Powerlaw-analyse zal in de toekomst interessante toepassingen hebben in gebieden als AI, economie, netwerkwetenschap en risicobeheer. Met de juiste tools en kennis kunnen we ze gebruiken om een complexe, niet-lineaire wereld beter te begrijpen.
Als je dieper in echte data duikt, vraag jezelf dan altijd af: is het zeldzame wel echt zeldzaam—of is het gewoon krachtig verdeeld?
Wil je meer leren over enkele van de concepten, bekijk dan de volgende bronnen:
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

