
Last chance! 50% off DataCamp Premium
Sale ends in
क्या आपने कभी सोचा है कि कुछ ही वेबसाइटों को इंटरनेट का अधिकांश ट्रैफिक क्यों मिलता है? या दुनिया की ज्यादातर संपत्ति कुछ ही लोगों के हाथों में क्यों होती है? इसका जवाब एक रोचक सांख्यिकीय घटना में छिपा है, जिसे पावर लॉ कहा जाता है।
पावर लॉ कई प्राकृतिक और मानव-निर्मित प्रणालियों को संचालित करते हैं। ये वितरण खास हैं क्योंकि वे स्केल बदलने पर भी नहीं बदलते और इनके टेल भारी होते हैं। ये गुण उन्हें ऐसे डेटा का मॉडल बनाने के लिए उपयुक्त बनाते हैं जहाँ छोटे-छोटे घटनाक्रम बहुत होते हैं, लेकिन बड़े और महत्वपूर्ण घटनाक्रम, भले ही दुर्लभ हों, नज़रअंदाज़ नहीं किए जा सकते।
यह ट्यूटोरियल पावर लॉ का समग्र अवलोकन देगा—उनके सिद्धांत, गणित, उपयोग, और उन्हें कैसे आँका जाए। हम देखेंगे कि वे स्केल-इनवेरिएंट कैसे होते हैं और क्यों भूभौतिकी, वित्त, जीवविज्ञान और इंटरनेट जैसे विविध क्षेत्रों में दिखाई देते हैं।
आइए शुरू करें यह समझने से कि पावर लॉ को खास क्या बनाता है—और वे उन वितरणों से कहाँ अलग हैं जिन्हें आप अब तक इस्तेमाल करते आए होंगे।
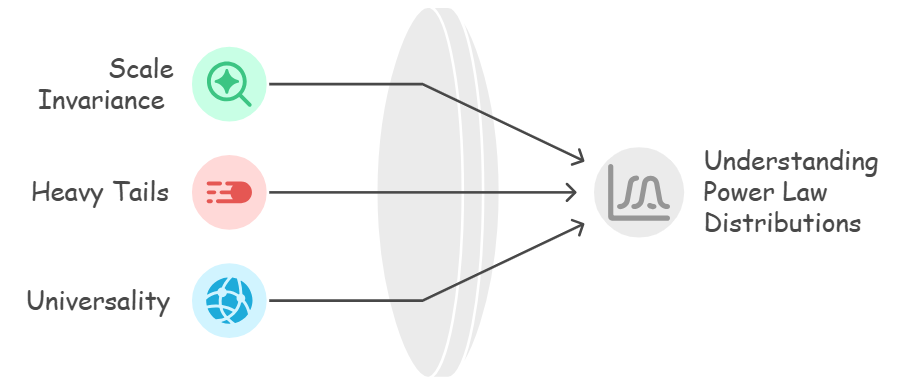
पावर लॉ की विशेषताएँ। स्रोत: Napkin AI
सरल शब्दों में, स्केल इनवेरिएंस का अर्थ है कि आप ज़ूम इन करें या आउट, वितरण में पैटर्न वैसा ही बना रहता है।
सांख्यिकीय दृष्टि से, पावर लॉ वितरण का फंक्शनल फॉर्म हर स्केल पर एक जैसा रहता है। यदि कोई चर पावर लॉ का पालन करता है, तो उसे किसी स्थिरांक से गुणा करने पर उसके वितरण का स्वरूप नहीं बदलता; केवल स्केल बदलता है।
गणितीय रूप से, इसका अर्थ है:
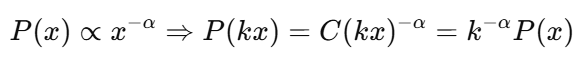
यह अन्य सामान्य वितरणों से बहुत भिन्न है, जैसे नॉर्मल वितरण, जहाँ आकार औसत और मानक विचलन जैसे कुछ प्रमुख पैरामीटरों पर आधारित होता है।
यह गुण स्व-समानता से भी मेल खाता है, जो फ्रैक्टल का एक प्रमुख लक्षण है। फ्रैक्टल वे संरचनाएँ हैं जो किसी भी स्तर के ज़ूम पर एक जैसी दिखती हैं। उदाहरण के लिए, यदि आप हिमपात, फर्न की पत्ती, या पेड़ की शाखा के किसी भी हिस्से पर ज़ूम करें, तो आपको संपूर्ण का छोटा संस्करण दिखेगा।
तटरेखा 10 मीटर से भी वैसी ही दिखती है जैसी 10 किलोमीटर से।
पावर लॉ इस दोहराए जाने वाले ढाँचे को बहुत अच्छी तरह व्यक्त करते हैं। इसलिए वे उन प्रणालियों के अध्ययन में उपयोगी हैं जहाँ आकार, आवृत्ति, या तीव्रता बहुत बदलती है, पर पैटर्न एक जैसा रहता है।
अधिकांश पारंपरिक वितरण (जैसे गौसियन या एक्सपोनेंशियल) टेल में तेजी से पतले हो जाते हैं। पावर लॉ में ऐसा नहीं है। इनके भारी टेल होते हैं, यानी चरम घटनाओं की संभावना अधिक होती है।
वास्तविक जीवन में, बड़े भूकंप, वायरल ट्वीट, और अरबपति—ये सब दुर्लभ होते हुए भी होने की संभावना रखते हैं। वास्तव में, अल्फा के कुछ मानों पर औसत या वैरिएंस जैसे मोमेंट्स मौजूद ही नहीं होते, और इसी कारण हम कहते हैं कि पावर लॉ वितरणों का कोई स्केल नहीं होता।
पावर लॉ की एक अद्भुत बात यह है कि वे सार्वत्रिक हैं; वे उन प्रणालियों में भी मिलते हैं जिनका आपस में कोई स्पष्ट संबंध नहीं दिखता। कुछ उदाहरण हैं: भूकंप की तीव्रताएँ, न्यूरल गतिविधि में स्पाइक्स, कंपनियों का आकार, और शब्द-आवृत्तियाँ।
दूसरी ओर, वे सांख्यिकीय रूप से अपूर्ण भी हैं। यानी, हम टेल के व्यवहार का मॉडल तो बना सकते हैं, पर खासकर छोटे सैंपल से पूर्ण सार-सांख्यिकी का अनुमान लगाना कठिन होता है।
आइए उस गणित में गहराई से उतरें जो पावर लॉ को शक्तिशाली भी बनाता है और पेचीदा भी।
पावर लॉ का मानक रूप यह है:
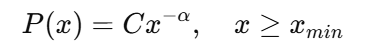
जहाँ:
जैसे-जैसे अल्फा बढ़ता है, टेल पतला होता जाता है। छोटा अल्फा अधिक चरम घटनाओं का संकेत देता है। यह स्केलिंग एक्सपोनेंट असमानता से लेकर पारिस्थितिक तंत्र के आकार तक बहुत कुछ नियंत्रित करता है।
वास्तविक डेटासेट में पावर लॉ का पता लगाने का पहला कदम लॉग-लॉग प्लॉट का उपयोग करना है।
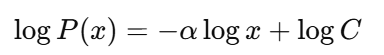
यदि डेटा वास्तव में पावर लॉ का पालन करता है, तो यह आपको −α ढाल वाली सीधी रेखा देगा। लेकिन सावधान रहें, बहुत से वितरण लॉग-लॉग प्लॉट पर रैखिक दिखते हैं।
कई महत्वपूर्ण सांख्यिकीय वितरण पावर लॉ के समान हैं।
कभी-कभी वास्तविक दुनिया का डेटा हमेशा के लिए "शुद्ध" पावर लॉ का पालन नहीं करता। ऐसे में हम एक्सपोनेंशियल कटऑफ़ देखते हैं (जहाँ बहुत बड़े मान कम संभावित हो जाते हैं), वक्रित पावर लॉ, या लॉग-नॉर्मल टेल। ये उन प्रणालियों के मॉडलिंग के लिए बेहतर हैं जिनमें भौतिक या व्यावहारिक सीमाएँ होती हैं। ये हाइब्रिड मानते हैं कि स्केल इनवेरिएंस कुछ रेंज तक काम कर सकता है, पर अंततः रुक जाएगा।
पावर लॉ केवल गणित के विचार नहीं हैं; वे वास्तविक दुनिया में दिखते हैं और पहले-पहल यादृच्छिक या अराजक लगने वाली प्रणालियों को समझने में मदद करते हैं।
पावर लॉ प्रकृति में चरम घटनाओं को समझने में मदद करते हैं। उदाहरण के लिए, गुटेनबर्ग-रिक्टर नियम कहता है कि भूकंप की तीव्रताएँ पावर लॉ वितरण का पालन करती हैं। इसका मतलब है कि छोटे झटके बहुत होते हैं, पर जैसे-जैसे भूकंप की तीव्रता बढ़ती है, भूकंपों की संख्या तेजी से घटती है। इसलिए 2.0 का भूकंप रोज़ हो सकता है, लेकिन 7.0 का सालों तक नहीं होता। दोनों एक ही सांख्यिकीय कहानी का हिस्सा हैं।
इसी तरह, नदी नेटवर्क, तटरेखाएँ, और यहाँ तक कि बिजली गिरने के पैटर्न भी स्व-समान, फ्रैक्टल पैटर्न दिखाते हैं जो उनके खंडों के आकार में पावर लॉ स्केलिंग का पालन करते हैं।
पावर लॉ का उपयोग ब्रह्मांड तक में होता है। खगोल भौतिकी में, हम देखते हैं कि तारों का आकार, ब्लैक होल का वितरण, और यहाँ तक कि आकाशगंगाओं के क्लस्टर भी भारी टेल दिखाते हैं। छोटे तारों की संख्या अरबों में है, पर कुछ ही विशाल तारे आकाशगंगा में अलग से दिखते हैं। यह असमानता यादृच्छिक लग सकती है, पर जब हम अंदर छिपे पावर लॉ को समझ लेते हैं, तो पता चलता है कि यह कुछ सांख्यिकीय नियमों का पालन करती है।
मानव समाजों में असमानता और स्केल को देखते समय पावर लॉ विशेष रूप से उपयोगी हैं। हमने पिछले खंड में परेटो वितरण पर चर्चा की थी, जो केवल अर्थव्यवस्था का सिद्धांत नहीं है; इसे कर रिकॉर्ड, कॉर्पोरेट मुनाफ़े, और डोनेशन पैटर्न में देखा जा सकता है।
धनवान शीर्ष 1% परेटो के नियम का पालन करते हैं, न कि गौसियन औसत का। ये वितरण सुव्यवस्थित घंटी-आकार के कर्व में फिट नहीं होते; बल्कि दाईं ओर बहुत दूर तक खिंच जाते हैं, जहाँ कुछ अत्यधिक मान (जैसे अरबपति) औसत को प्रभावित करते हैं।
जीवविज्ञान में भी पावर लॉ छिपे पैटर्न दिखाते हैं। उदाहरण के लिए, क्लाइबर का नियम कहता है कि किसी जानवर की चयापचय दर उसके शरीर द्रव्यमान के 3/4 घात के साथ बढ़ती है, सीधी रेखा में नहीं। यह समझने में मदद करता है कि एक हाथी खरगोश से हजार गुना भारी होने पर भी हजार गुना नहीं खाता।
पावर लॉ शहरों की जनसंख्या, कंपनियों की विकास दर, मतदान व्यवहार, और यहाँ तक कि संघर्षों में मौतों पर भी लागू होते हैं—जहाँ कुछ बड़े तत्व या घटनाएँ अनुपात से अधिक प्रभाव डालती हैं।
डिजिटल दुनिया को चालित और समृद्ध रखने में पावर लॉ की बड़ी भूमिका है। सोचिए इंटरनेट ट्रैफिक कैसे काम करता है: कुछ ही साइटें (जैसे Google, Facebook, और YouTube) अधिकांश विज़िट प्राप्त करती हैं, जबकि लाखों अन्य पेज़ अधिकांशतः अनदेखे रह जाते हैं। यह विशिष्ट लॉन्ग-टेल व्यवहार है, और SEO, रिकमेंडेशन इंजन, तथा डिजिटल मार्केटिंग जैसे क्षेत्रों में विशेष रूप से महत्वपूर्ण है।
AI में, मॉडलों का आकार और प्रदर्शन प्रायः एक ही दिशा में चलते हैं। कुछ बड़े मॉडल, जैसे GPT-4, क्षेत्र में सर्वश्रेष्ठ होते हैं, जबकि सैकड़ों छोटे मॉडल साथ नहीं दे पाते। यह एकाग्रता आंशिक रूप से फीडबैक लूप्स के कारण है: बेहतर मॉडलों को अधिक उपयोगकर्ता, डेटा, और फंडिंग मिलती है, जिससे वे और सशक्त होते जाते हैं।
मान लीजिए आपका डेटासेट पावर लॉ जैसा दिखता है। हिस्टोग्राम में लंबा टेल हो सकता है, या लॉग-लॉग प्लॉट पर अधिकतर सीधी रेखा दिख सकती है। यह अच्छी शुरुआत है, पर केवल देखकर मान लेना पर्याप्त नहीं, क्योंकि पावर लॉ आसानी से भ्रमित कर सकते हैं। इसलिए हमें पैरामीटर निकालने और फिट जाँचने के लिए ठोस सांख्यिकीय उपकरण चाहिए।
स्केलिंग एक्सपोनेंट, जिसे आमतौर पर 𝛼 लिखा जाता है, पावर लॉ वितरण का सही मॉडल बनाने के लिए पहली आवश्यकता है।
मैक्सिमम लाइकलीहुड एस्टीमेशन (MLE) 𝛼 का अनुमान लगाने के सबसे सामान्य तरीकों में से एक है। यह सांख्यिकी में वह तरीका है जो उन पैरामीटर मानों को ढूँढ़ता है जिनसे देखा गया डेटा सबसे अधिक संभाव्य हो जाता है।
ज्ञात न्यूनतम मान 𝑥min वाले सतत डेटा के लिए यह इस प्रकार काम करता है:
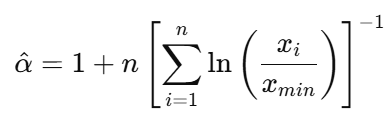
लेकिन मुश्किल यहाँ है: सही 𝑥 min चुनना बेहद महत्वपूर्ण है। यदि यह बहुत कम है, तो आपके मॉडल में ऐसा डेटा आ जाएगा जो वास्तव में पावर लॉ का पालन नहीं करता। और यदि यह बहुत अधिक है, तो आप बहुत सारा डेटा व्यर्थ कर देंगे। साथ ही, छोटे सैंपल आकारों में MLE के अनुमान अविश्वसनीय हो सकते हैं।
एक्सपोनेंट का अनुमान लगाने के बाद अगला प्रश्न है: फिट कितना अच्छा है? आप केवल इतना नहीं कह सकते, "यह कुछ-कुछ पावर लॉ जैसा दिखता है।" आपको सांख्यिकीय प्रमाण चाहिए कि अन्य संभावित वितरणों की तुलना में पावर लॉ आपका डेटा बेहतर समझाता है। यहीं कोल्मोगोरोव–स्मिरनोव (KS) परीक्षण काम आता है। यह परीक्षण आपके देखे गए डेटा के संचयी वितरण फलन (CDF) और सैद्धांतिक पावर लॉ मॉडल के बीच सबसे बड़े अंतर को खोजता है।
यह संख्या जितनी शून्य के करीब होगी, आपका मॉडल डेटा पर उतना ही बेहतर फिट होगा। KS परीक्षण कई अन्य परीक्षणों की तरह बिनिंग या हिस्टोग्राम का उपयोग नहीं करता। यह सीधे कच्चे डेटा पर काम करता है, जो भारी-टेल वितरणों के लिए बहुत उपयोगी है।लेकिन कई बार पावर लॉ ही एकमात्र संभव व्याख्या नहीं होता। लॉग-नॉर्मल या एक्सपोनेंशियल वितरण भी आपके डेटा को मॉडल कर सकता है। ऐसे में लाइकलीहुड रेशियो परीक्षण उपयोगी होते हैं। विचार सरल है: दोनों मॉडलों को एक ही डेटा पर MLE से फिट करें, उनके लाइकलीहुड निकालें, और फिर तुलना करें। यदि पावर लॉ मॉडल का लाइकलीहुड काफी अधिक है, तो आपके पास उसके पक्ष में सांख्यिकीय समर्थन है।
क्लॉज़ेट-शलिज़ी-न्यूमैन (2009) फ्रेमवर्क उन उपकरणों में से एक है जो MLE, KS परीक्षण, और लाइकलीहुड रेशियो परीक्षणों को मिलाकर पावर लॉ व्यवहार की जाँच का सशक्त तरीका प्रदान करता है।
अब जब हम जानते हैं कि पावर लॉ वास्तविक दुनिया में कहाँ दिखते हैं और उन्हें सांख्यिकीय रूप से कैसे खोजते हैं, तो अगला प्रश्न है: ये वितरण शुरू ही क्यों होते हैं? आइए देखें कि पावर लॉ प्रणाली गतिशीलता से कैसे उभर सकते हैं।
बाराबासी–अल्बर्ट मॉडल (1999) ने पसंदीदा संलग्नता (preferential attachment) प्रस्तुत की, जिसे अक्सर "अमीर और अमीर होते जाते हैं" की घटना के रूप में समेटा जाता है। यह पावर लॉ के काम करने के सबसे प्रसिद्ध और आसानी से समझ आने वाले तरीकों में से है।
एक नेटवर्क बनाने के बारे में सोचें, जैसे इंटरनेट या कोई सोशल मीडिया साइट। जब कोई नया उपयोगकर्ता जुड़ता है, तो उसके लोकप्रिय नोड्स, जैसे Facebook या Google, से जुड़ने की संभावना अधिक होती है क्योंकि वे पहले से प्रसिद्ध हैं।
समय के साथ यह एक फीडबैक लूप बना देता है: लोकप्रिय नोड्स को और भी अधिक कनेक्शन मिलते हैं, जबकि नए या कम जुड़े नोड्स छोटे ही रहते हैं। इससे एक स्केल-फ्री नेटवर्क बनता है जहाँ नोड डिग्री पावर लॉ का पालन करती है।
इसी प्रकार, जैविक वंशों (genera) की वृद्धि का मॉडल करने वाली यूल प्रक्रियाएँ इसी विचार का विस्तार हैं। इस मॉडल में जिन प्रजातियों के पहले से अधिक सदस्य होते हैं, उनके नए प्रजाति जन्म देने की संभावना अधिक होती है। इससे ऐसा तिरछा वितरण बनता है जिसमें कुछ वंश हावी हो जाते हैं।
यादृच्छिक विकास प्रक्रियाएँ (random growth processes) भी पावर लॉ के उभरने का एक तरीका हैं। मुख्य विचार यह है कि चीज़ें समय के साथ जोड़कर नहीं, बल्कि यादृच्छिक गुणक (multiplicative) मात्राओं से बढ़ती हैं।
गिब्राट का नियम कहता है कि वृद्धि दर आकार से स्वतंत्र होती है। ज्यादातर चीज़ें छोटी ही रहती हैं, पर कुछ बहुत तेज़ी से बढ़ती हैं और बहुत बड़ी हो जाती हैं—जिससे पावर लॉ का भारी टेल बनता है।
मार्कोव प्रक्रियाएँ, खासकर वे जिनमें गुणक शोर (multiplicative noise) शामिल हो, परावर्ती सीमाओं के अधीन पावर-लॉ जैसे स्टेशनेरी वितरणों तक अभिसरित हो सकती हैं।
इसका प्रायिकतात्मक पक्ष भी है। कुछ परिस्थितियों में मार्कोव प्रक्रियाएँ भी पावर लॉ व्यवहार दिखा सकती हैं। ये प्रक्रियाएँ उन प्रणालियों का मॉडल बनाती हैं जहाँ अगली अवस्था केवल वर्तमान अवस्था पर निर्भर करती है, अतीत पर नहीं। इसका उपयोग जनसंख्या में गतिशीलता और कतारों के व्यवहार जैसी चीज़ों को मॉडल करने में किया गया है।
ये मॉडल केवल रोचक विचार नहीं हैं। ये समझने में मदद करते हैं कि जटिल प्रणालियाँ समय के साथ कैसे बदलती हैं, असमानता क्यों बनी रहती है, और नेटवर्क इफेक्ट्स कैसे जीवविज्ञान से लेकर ब्लॉकचेन तक हर चीज़ को प्रभावित करते हैं। पावर लॉ का उपयोग हम न केवल दुनिया का वर्णन करने के लिए कर सकते हैं, बल्कि उसे समझाने के लिए भी कर सकते हैं।
पावर लॉ की गतिशीलता को समझना अत्यंत महत्वपूर्ण है और आपके पूर्वानुमानों व निर्णयों पर बड़ा प्रभाव डाल सकता है—चाहे आप वित्तीय जोखिम मॉडल बना रहे हों, इंटरनेट इन्फ्रास्ट्रक्चर चला रहे हों, या सामाजिक व्यवहार का अध्ययन कर रहे हों।
पावर लॉ मॉडल उन प्रणालियों के लिए सहायक हैं जहाँ दुर्लभ पर महत्वपूर्ण घटनाएँ घटित होती हैं। उदाहरण के लिए, वित्त में, अधिकांश दिनों में कीमतें सामान्य दर से बदल सकती हैं, लेकिन "ब्लैक स्वान"—दुर्लभ क्रैश या उछाल—सबसे बड़ा प्रभाव डालते हैं।
पावर लॉ मॉडल इस टेल रिस्क को पारंपरिक मॉडलों की तुलना में बेहतर पकड़ सकते हैं, जो अक्सर इन घटनाओं की संभावना को कम आँकते हैं। जोखिम प्रबंधन, बीमा, साइबर सुरक्षा, और आपदा योजना में यह बहुत महत्वपूर्ण है।
इसके अतिरिक्त, गैर-रैखिक वृद्धि और चक्रवृद्धि प्रभावों को समझने का भी लाभ है। पावर लॉ बताते हैं कि क्यों कुछ लोग, कंपनियाँ, या नेटवर्क के नोड समय के साथ सबसे शक्तिशाली बन सकते हैं, और क्यों ये "विनर-टेक्स-मोस्ट" स्थितियाँ असामान्य नहीं बल्कि इन प्रणालियों में सामान्य हैं।
पर पावर लॉ मॉडलों के साथ कुछ समझौते भी हैं। एक समस्या यह है कि वे सहज बोध का विरोध करते हैं—कई बार उनके स्पष्ट औसत या वैरिएंस नहीं होते, जिससे "अपेक्षित मान" या "मानक विचलन" जैसे सामान्य मीट्रिक समझना कठिन हो जाता है।
ये मॉडल आमतौर पर केवल वितरण के टेल पर काम करते हैं, इसलिए हो सकता है कि वे डेटा के मुख्य हिस्से पर अच्छी तरह फिट न हों—या बिल्कुल न हों। यदि आप यह सावधानी नहीं बरतते कि पावर लॉ व्यवहार वास्तव में कहाँ से शुरू होता है, तो यह समस्या बन सकती है।
हर लंबी-टेल वाला डेटासेट वास्तविक पावर लॉ का पालन नहीं करता। कुछ वितरण, जैसे लॉग-नॉर्मल या स्ट्रेच्ड एक्सपोनेंशियल, सीमित रेंज में पावर लॉ जैसे दिख सकते हैं, खासकर लॉग-लॉग प्लॉट पर। इससे अक्सर फॉल्स पॉज़िटिव होते हैं, जहाँ हम केवल इसलिए पावर लॉ मान लेते हैं क्योंकि प्लॉट "रैखिक दिखता" है।अतिसामान्यीकरण एक और समस्या है। लोग अक्सर मान लेते हैं कि पावर लॉ किसी प्रणाली की हर चीज़ समझा देता है, जबकि वह केवल एक छोटे हिस्से—आम तौर पर चरम सिरे—को समझाता है। उदाहरण के लिए, शीर्ष 1% की आय का वितरण पावर लॉ हो सकता है, पर शेष आबादी का वितरण बहुत अलग हो सकता है।
घटते प्रतिफल का नियम वास्तविक प्रणालियों के सामने एक और चुनौती है। पावर लॉ कहते हैं कि चरम परिणाम संभव हैं, पर भौतिक सीमाओं या नियामकीय वातावरण जैसी जगहों पर ऐसी हदें होती हैं जिनके आगे मॉडल काम नहीं करता। यदि आप मान लें कि टेल व्यवहार अनंत तक जारी रहता है, तो आप जोखिमों या लाभों को वास्तविक से बड़ा मान सकते हैं—खासकर सीमाबद्ध प्रणालियों में।
पावर लॉ हमें उन प्रणालियों को समझने में मदद करते हैं जहाँ कुछ चरम घटनाएँ या इकाइयाँ बड़ा प्रभाव डालती हैं—जैसे भूकंप, इंटरनेट ट्रैफिक, या आय का वितरण। इस ट्यूटोरियल में, हमने देखा कि पावर लॉ को अलग क्या बनाता है, उनके गणितीय गुण और प्रायोगिक संकेत, उन्हें कैसे खोजें और जाँचें, और वे वास्तविक दुनिया में कहाँ मिलते हैं।
AI, अर्थशास्त्र, नेटवर्क विज्ञान, और जोखिम प्रबंधन जैसे क्षेत्रों में पावर लॉ विश्लेषण के रोचक भविष्य उपयोग होंगे। सही उपकरणों और समझ के साथ, हम जटिल, गैर-रैखिक दुनिया को बेहतर समझ सकते हैं।
जैसे-जैसे आप वास्तविक दुनिया के डेटा में गहराई से उतरें, हमेशा यह प्रश्न करें: क्या दुर्लभ वास्तव में दुर्लभ है—या वह बस शक्तिशाली ढंग से वितरित है?
यदि आप कुछ अवधारणाओं के बारे में और सीखना चाहते हैं, तो कृपया निम्न संसाधन देखें:
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स
