
Last chance! 50% off DataCamp Premium
Sale ends in
Heb je ooit een pizzafeestje gegeven en iets opvallends gezien? Ik wel. Tijdens mijn laatste bijeenkomst merkte ik dat de meeste mensen een of twee slices pakten, terwijl een handjevol gasten bijna de helft van de pizza’s opat. Terwijl ik dit zag gebeuren, drong het tot me door: ik was getuige van een praktijkvoorbeeld van een van de fascinerendste patronen in data science—de Paretoverdeling.
Ik houd van dit voorbeeld omdat het perfect weergeeft waar de Paretoverdeling om draait: de observatie dat in veel situaties een kleine groep verantwoordelijk is voor een groot deel van het resultaat.
Als data scientist ben ik gaan waarderen hoe deze verdeling ons helpt situaties te begrijpen en te modelleren waarin "the vital few" domineren over "the trivial many". Denk er eens over na: 20% van de klanten van een bedrijf genereert vaak 80% van de omzet, of 20% van de content op een website zorgt voor 80% van het verkeer. Dit patroon komt zo vaak voor dat het bekendstaat als het Paretoprincipe, of de "80/20-regel", al kunnen de exacte verhoudingen variëren.
Maar dit is wat de Paretoverdeling echt bijzonder maakt: het is niet slechts een losse observatie—het is een krachtig wiskundig hulpmiddel dat ons helpt deze scheve patronen in data te modelleren en te voorspellen. Of je nu economische ongelijkheid analyseert, bedrijfsprocessen optimaliseert of natuurverschijnselen bestudeert, inzicht in de Paretoverdeling kan waardevolle inzichten bieden in waarom dingen niet altijd gelijk verdeeld zijn—en wat dat betekent voor onze analyses.
Het unieke vermogen van de Paretoverdeling om scheefheden te benadrukken, maakt haar onmisbaar in vakgebieden van economie tot natuurwetenschappen. Als je soortgelijke statistische patronen wilt verkennen, duik dan in bronnen zoals Foundations of Probability in Python voor een basis in kansrekening, of Multivariate Probability Distributions in R om je analysetoolkit uit te breiden. Voor visuele leerders is de Introduction to Probability Rules Cheat Sheet een uitstekende snelle naslag voor kernprincipes.
Toen de Italiaanse econoom Vilfredo Pareto in 1896 naar zijn tuin keek, viel hem iets eigenaardigs op: 20% van zijn peulen bevatte 80% van de erwten. Deze observatie leidde hem ertoe soortgelijke patronen in landbezit te onderzoeken, waar hij ontdekte dat 80% van het land in Italië in handen was van 20% van de bevolking. Wat begon als een tuinobservatie groeide uit tot een van de meest veelzijdige hulpmiddelen in de statistiek om ongelijke verdelingen te begrijpen.
Aan het eind van de 19e eeuw ging het onderzoek van Vilfredo Pareto veel verder dan peulen en landbezit. Hij analyseerde vermogensverdelingen in verschillende landen en tijdperken en ontdekte een consistent wiskundig verband. De welvarende minderheid, zo vond hij, bezat in elke samenleving die hij bestudeerde het merendeel van de bezittingen. Dit patroon verscheen zo consequent dat andere onderzoekers zijn ideeën begonnen toe te passen in uiteenlopende vakgebieden, van economie tot natuurwetenschappen.
De verdeling kreeg brede bekendheid toen managementconsultant Joseph Juran in 1937 met Pareto’s werk in aanraking kwam. Juran noemde het patroon het "Paretoprincipe" en paste het toe op kwaliteitscontrole, waarbij hij aantoonde dat de meeste productiefouten uit een klein aantal oorzaken voortkwamen. Deze toepassing transformeerde het industriële kwaliteitsmanagement en wakkerde bredere interesse in Pareto’s ideeën aan.
De Paretoverdeling onderscheidt zich van andere statistische verdelingen door verschillende unieke eigenschappen:
Deze eigenschappen maken de Paretoverdeling bijzonder geschikt om situaties te modelleren waarin middelen, effecten of uitkomsten zich concentreren in een kleine subset van een populatie.
Laten we de wiskunde achter de Paretoverdeling in hapklare stukken opdelen. Hoewel de formules in eerste instantie intimiderend kunnen lijken, neem ik je stap voor stap mee door elk onderdeel.
De kansdichtheidsfunctie (PDF) van de Paretoverdeling heeft de volgende vorm:
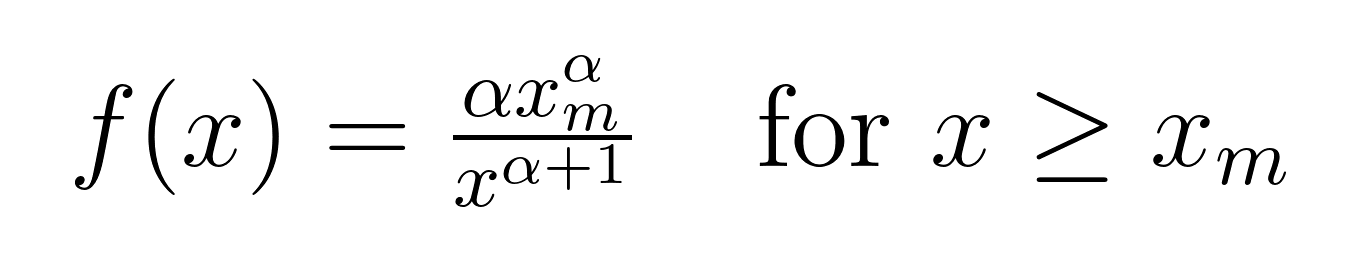
Laten we ontcijferen wat elk symbool betekent:
De cumulatieve verdelingsfunctie (CDF) geeft ons de kans dat een waarde kleiner dan of gelijk aan x is:
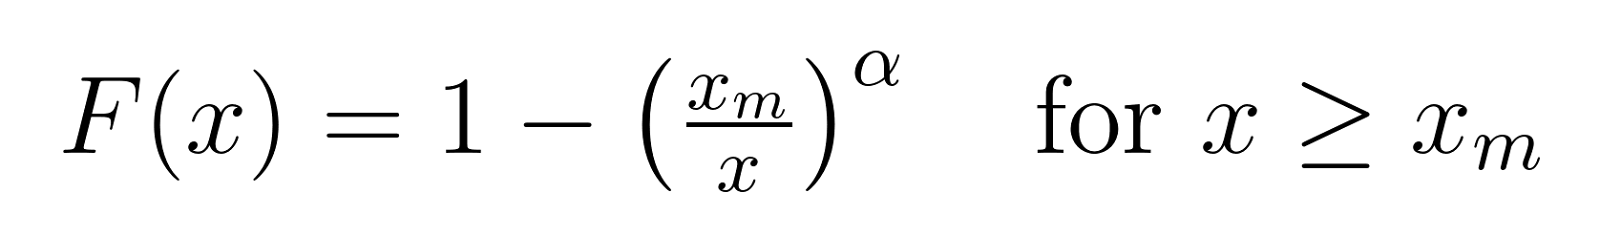
Om deze formules concreter te maken, kijken we naar wat verschillende waarden van α betekenen:
|
Waarde α |
Wat het ons vertelt |
Voorbeeld uit de praktijk |
|
1.5 |
Zeer zware staart - extreme waarden komen vaak voor |
Stedelijke omvang binnen een land |
|
2.5 |
Gemiddeld zware staart |
Vermogensverdeling van personen |
|
3.5 |
Lichtere staart - extreme waarden zijn zeldzaam |
Lengte van volwassenen |
De bekende 80/20-regel komt natuurlijk voort uit de Paretoverdeling wanneer α ≈ 1.16.
In data-analyse helpt dit principe ons om:
Als we bijvoorbeeld klantdata analyseren, kunnen we ontdekken dat:
Deze inzichten helpen bedrijven weloverwogen beslissingen te nemen over waar ze hun inspanningen op moeten richten voor maximaal effect.
Van economisch beleid tot natuurrampen: de Paretoverdeling duikt op verrassende plekken op.
Loop een financieel district in welk land dan ook binnen, en je ziet de Paretoverdeling aan het werk. Banken en economen gebruiken haar om vermogensconcentratie te volgen, inkomensverschillen te modelleren en belastingbeleid te analyseren. Toen economen in 2023 bijvoorbeeld het mondiale vermogen bestudeerden, ontdekten ze dat de rijkste 1% van de volwassenen 44% van ’s werelds rijkdom bezat. Deze verdeling helpt beleidsmakers vermogenskloven te begrijpen en economische interventies te ontwerpen. Als je geïnteresseerd bent in ideeën rond vermogensverdeling, hebben we tutorials over de Gini-coëfficiënt en de Lorenz-curve.
In het bedrijfsleven helpt het Paretoprincipe bedrijven slimmer te werken, niet harder. Neem een e-commercewebsite die zijn klantdata analyseert:
De natuur volgt ook Paretopatronen. Wetenschappers gebruiken deze verdeling om te bestuderen:
Neem aardbevingen—hun verdeling naar magnitude volgt een Paretopatroon, met veel kleine bevingen en zeldzame, verwoestende schokken. Dit inzicht helpt seismologen betere voorspellingsmodellen en risicobeoordelingen te ontwikkelen.
Datavisualisatie brengt de unieke eigenschappen van de Paretoverdeling tot leven. Laten we verkennen hoe deze verdeling er grafisch uitziet en wat de vormen ons vertellen over de data die we analyseren.
De meest gebruikelijke manier om de Paretoverdeling te visualiseren is via de kansdichtheidsfunctie (PDF). Deze laat zien hoe waarden over onze dataset zijn verdeeld.
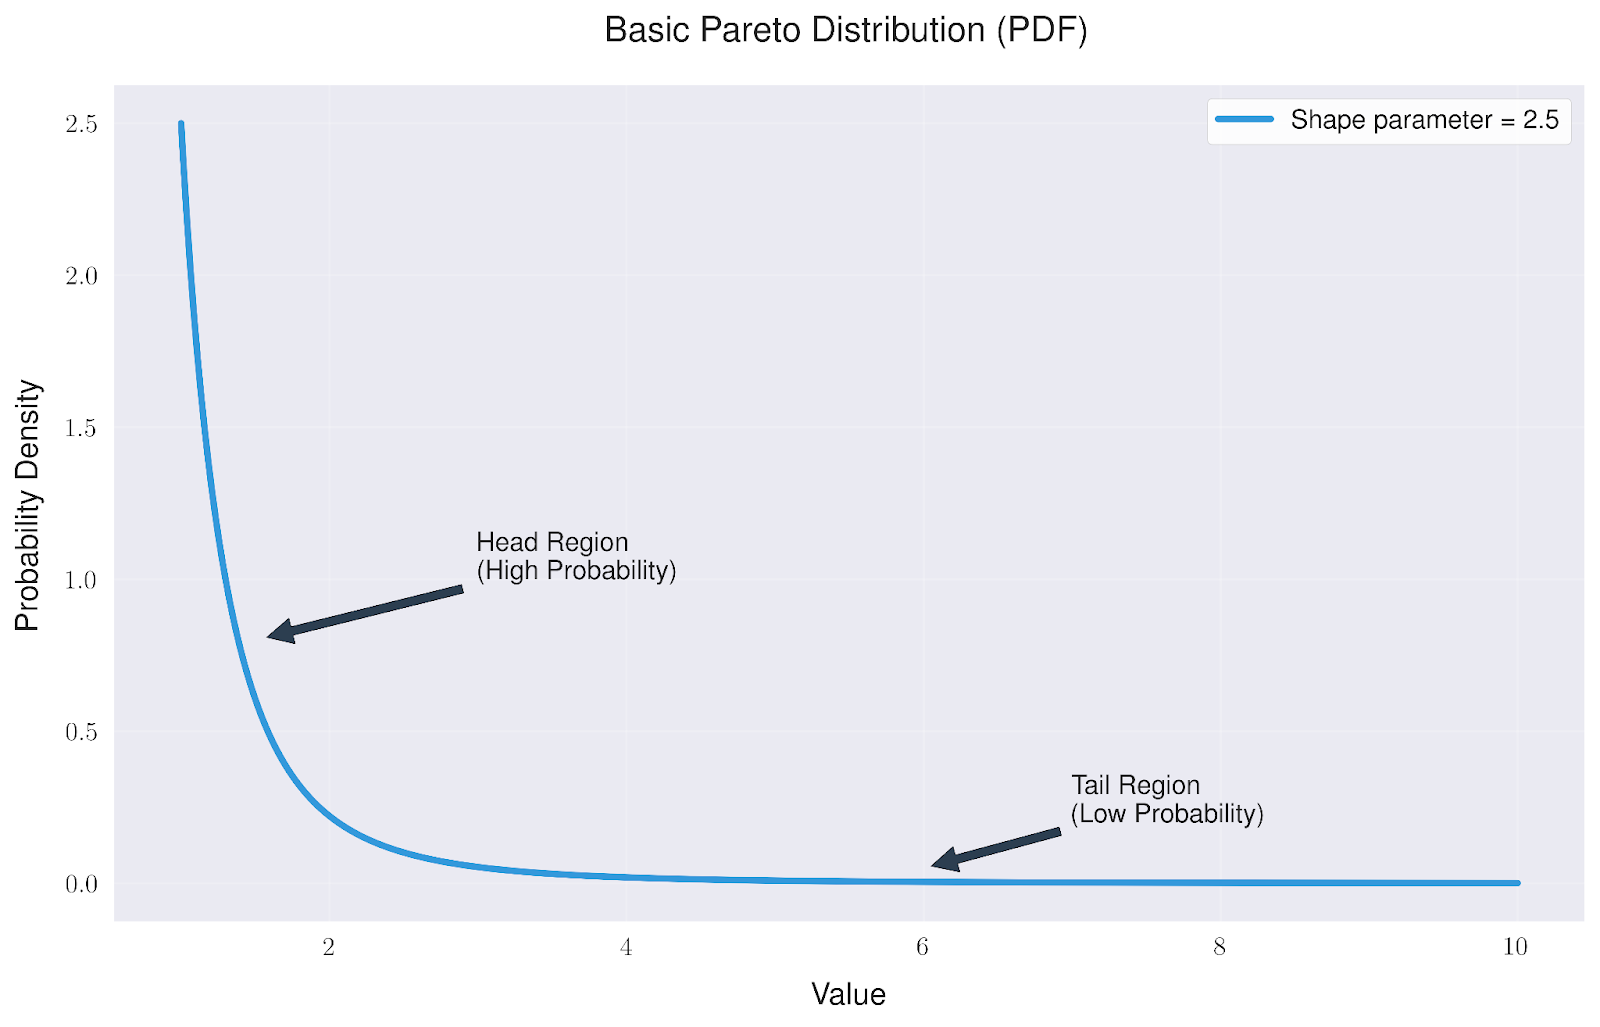
De basis-Paretoverdeling heeft een karakteristieke vorm die ons twee belangrijke dingen vertelt:
Wat de Paretoverdeling bijzonder interessant maakt, is hoe ze verandert bij verschillende vormparameters. Deze parameters beïnvloeden rechtstreeks hoe extreem onze waarden kunnen zijn.
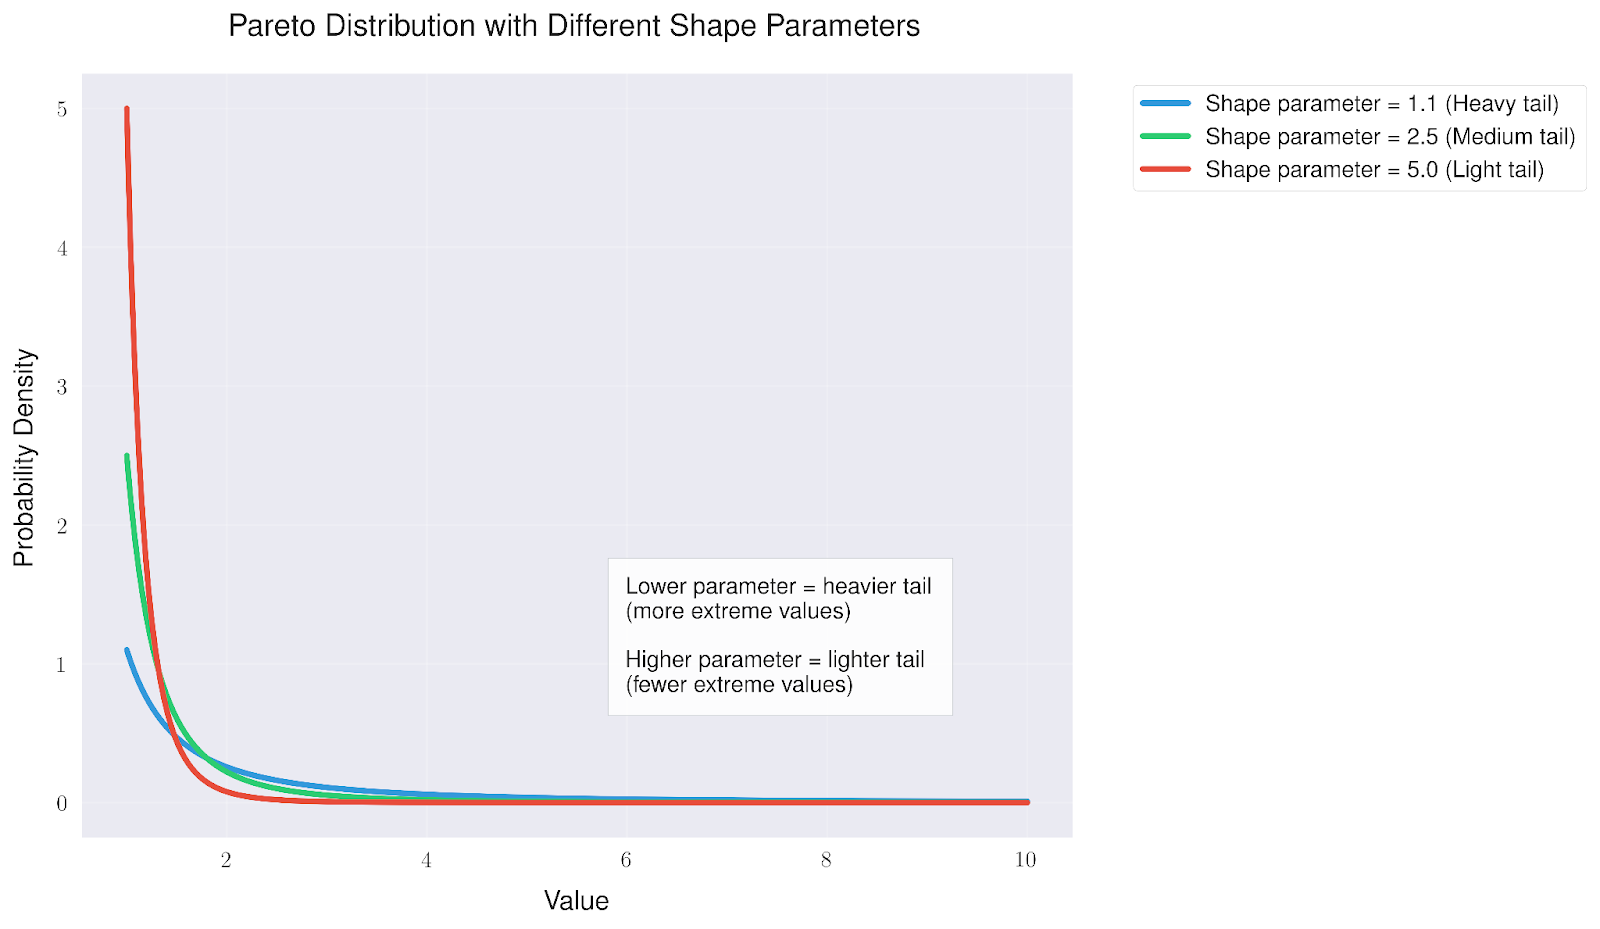
Als we naar verschillende vormparameters kijken, zien we dat:
Deze flexibiliteit maakt de Paretoverdeling nuttig voor het modelleren van uiteenlopende fenomenen uit de echte wereld, van vermogensverdeling (vaak zwaarstaartig) tot productiefouten (meestal lichter staartig).
Vermogensverdelingen zijn vaak zwaarstaartig en dat impliceert een niet-verwaarloosbare kans op extreem grote waarden, waardoor zeldzame maar enorme gebeurtenissen (zoals miljardairs) een grote impact hebben. Dat is logisch, omdat er een rente-op-rente-effect is: mensen met geld kunnen investeren. Lichtstaartige verdelingen (zoals sommige typen productiefouten) nemen sneller af door begrensde, stabiele processen, wat betekent dat extreme waarden veel minder waarschijnlijk zijn omdat grote afwijkingen zeldzaam zijn.
Voor het visualiseren van de Paretoverdeling leunen we vooral op statistische programmeertalen en gespecialiseerde software. Python springt eruit als populaire keuze, met krachtige libraries zoals scipy.stats voor berekeningen, en matplotlib en seaborn voor heldere visualisaties van publicatiekwaliteit. Ook R blinkt hierin uit, met robuuste ingebouwde statistische functies en het veelzijdige ggplot2-pakket voor grafieken.
Hoewel Excel uitstekend is voor het maken van Paretocharts (staafdiagrammen die het 80/20-principe tonen), is het niet het beste hulpmiddel om de Pareto-kansverdeling zelf te visualiseren en ermee te werken. Voor correcte statistische analyse en visualisatie van de Paretoverdeling raden we de hierboven genoemde programmeertools aan.
Om je begrip van het visualiseren van kansverdelingen te versterken, zijn er verschillende nuttige startpunten. De Probability Distributions in Python Tutorial biedt hands-on ervaring met het implementeren van diverse verdelingen, inclusief gedetailleerde voorbeelden met de statistische libraries van Python. Voor wie vooral in de visuele kant is geïnteresseerd, behandelt het artikel Data Visualizations that Capture Distributions technieken die specifiek zijn ontworpen om statistische verdelingen effectief weer te geven. Tot slot is de Data Visualization Cheat Sheet een snelle referentie voor het kiezen en maken van passende visualisaties voor verschillende soorten verdelingsdata. Samen vormen deze bronnen een goede basis om de Paretoverdeling te begrijpen én te visualiseren.
Elk statistisch hulpmiddel heeft zijn grenzen, en de Paretoverdeling is daarop geen uitzondering. Hoewel ze een krachtige lens is om bepaalde soorten data te bekijken, is weten wanneer je haar niet moet gebruiken net zo belangrijk als weten wanneer ze perfect past. Ik deel graag een paar belangrijke aandachtspunten waar ik op let wanneer ik met deze verdeling werk.
Zie de Paretoverdeling als een gespecialiseerde cameralens: ze werkt briljant voor bepaalde shots maar kan andere vertekenen. De basisaanames fungeren als de technische specificaties waaraan we ons moeten houden:
Ten eerste is er de minimale-waardedrempel. In tegenstelling tot sommige andere verdelingen die met elk getal overweg kunnen, heeft de Paretoverdeling een duidelijk startpunt boven nul nodig. Dit is als een minimuminzet in een casino - je kunt niet meedoen met minder dan dat bedrag. Dit wordt extra lastig wanneer je data nullen of negatieve waarden bevat, zoals bij het bijhouden van winst- en verliessituaties.
De verdeling gaat er ook van uit dat elk evenement op zichzelf staat, onafhankelijk van andere. Maar het echte leven werkt zelden zo. Neem vermogensopbouw: geld hebben maakt het vaak makkelijker om meer geld te verdienen. Deze onderlinge verbanden kunnen de Paretoverdeling minder accuraat maken dan we hopen.
Misschien wel het meest intrigerend is dat de verdeling uitgaat van schaalinvariantie—het idee dat relatieve verschillen belangrijker zijn dan absolute. Hoewel dit vaak geldt, doorbreken situaties in de echte wereld soms deze regel. De impact van het verdubbelen van iemands vermogen voelt bijvoorbeeld heel anders op verschillende vermogensniveaus.
Uit mijn ervaring zijn er verschillende valkuilen waar zelfs ervaren analisten bij het werken met de Paretoverdeling in kunnen trappen.
De meest voorkomende is overgeneralisatie. Alleen omdat je een 80/20-achtig patroon ziet, betekent dat niet automatisch dat je met een Paretoverdeling te maken hebt. Het is alsof je aanneemt dat elke vogel die je ziet een adelaar is—de vorm kan vergelijkbaar zijn, maar de details doen ertoe. Test altijd de passing van je verdeling voordat je conclusies trekt.
Parameterinschatting vormt een andere uitdaging. De vormparameter (α) kan bijzonder gevoelig zijn voor uitschieters, vooral bij kleinere datasets. Het is alsof je de gemiddelde lengte van een bevolking probeert te meten—een paar zeer lange of korte personen kunnen je resultaten flink scheeftrekken als je steekproef te klein is.
Als het gaat om het voorspellen van extreme gebeurtenissen, kan de zware staart van de Paretoverdeling zowel een zegen als een vloek zijn. Hoewel ze goed is in het modelleren van de mogelijkheid van extreme uitkomsten, kan ze soms suggereren dat die waarschijnlijker zijn dan ze werkelijk zijn. Dit is vooral belangrijk bij risicobeoordelingen—je wilt zeldzame gebeurtenissen niet over- of onderschatten.
Tot slot is er wat ik "contextblindheid" noem—zo opgaan in de wiskundige elegantie van de verdeling dat we vergeten te vragen of ze wel logisch is voor onze specifieke situatie. Vergeet niet: de kaart is niet het gebied, en de Paretoverdeling is slechts één kaart van velen.
Twijfel je, overweeg dan alternatieve verdelingen en valideer je aannames altijd aan de hand van praktijkkennis van je domein. Statistiek moet immers onze kijk op de werkelijkheid dienen, niet andersom.
In natuurlijke ecosystemen toont het Paretoprincipe zich via het fascinerende concept van sleutelsoorten—die paar organismen die een buitenproportionele invloed op hun omgeving hebben. Denk aan hoe wolven in Yellowstone alles beïnvloeden, van elandenpopulaties tot rivierpatronen, of hoe koraalriffen, die slechts een fractie van de oceaan beslaan, bijna een kwart van alle mariene soorten ondersteunen. Deze natuurlijke 80/20-verdeling komt voor in alles, van de grootte van boomkronen tot de verdeling van neerslag over seizoenen.
Zie vermogensverdeling als een orkestuitvoering, waar een paar sleutelinstrumenten de hoofdmelodie dragen terwijl andere essentiële ondersteuning bieden. Net zoals de eerste-violensectie het orkest vaak leidt, bezit een klein percentage individuen het merendeel van het mondiale vermogen, wat een complexe economische compositie creëert. Dit patroon heeft diepgaande implicaties voor economisch beleid en roept vragen op over hoe je zowel de dynamiek die vermogensconcentratie kan aandrijven als de sociale harmonie die bredere participatie vereist, in stand houdt. Dit muzikale parallel helpt ons zowel de efficiëntie als de uitdagingen van geconcentreerd vermogen te begrijpen.
In de wereld van innovatie manifesteert het Paretoprincipe zich doordat doorbraaksideeën voortkomen uit een verrassend kleine subset van pogingen. Bedrijven als Apple en Google hebben gemerkt dat grofweg 20% van hun producten 80% van hun omzet genereert, terwijl in wetenschappelijk onderzoek een klein deel van de artikelen het merendeel van de citaties binnenhaalt. Dit patroon verschijnt in creatieve industrieën, van hits in muziekcatalogi tot kaskrakers in studioprofielen.
Het Paretoprincipe speelt een rol in hoe informatie zich verspreidt via sociale netwerken. Een selecte groep influencers, wellicht zo’n 20% van de gebruikers, drijft vaak 80% van de betrokkenheid op sociale platforms. Datzelfde patroon zie je bij contentviraliteit, waar een klein percentage berichten het merendeel van de shares en interacties behaalt.
De Paretoverdeling laat zien hoe statistische tools betekenisvolle concentratiepatronen in data kunnen onthullen. Om je begrip van dergelijke concepten te verdiepen, bieden we waardevolle leermogelijkheden. Onze cursus Foundations of Probability in R introduceert kernprincipes, terwijl Introduction to Portfolio Analysis in R laat zien hoe deze ideeën toepasbaar zijn in financiële contexten. Daarnaast biedt onze tutorial Poker Probability and Statistics with Python een unieke manier om kansconcepten in actie te verkennen, zodat leren zowel boeiend als praktisch wordt. Deze bronnen vormen een solide basis om statistische inzichten toe te passen in uiteenlopende praktijkscenario’s.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


