
Corso
Concetti di IA generativa
2 ore
119.8K
Ti sei mai chiesto perché pochi siti web raccolgono la maggior parte del traffico internet? O perché una piccola frazione di individui controlla la maggior parte della ricchezza mondiale? La risposta sta in un affascinante fenomeno statistico noto come legge di potenza.
Le leggi di potenza governano molti sistemi naturali e artificiali. Queste distribuzioni sono speciali perché non cambiano con la scala e hanno code pesanti. Queste caratteristiche le rendono perfette per modellare dati in cui i piccoli eventi accadono spesso, ma gli eventi grandi e importanti, anche se rari, non possono essere ignorati.
Questo tutorial offre una panoramica completa delle leggi di potenza, includendone teoria, matematica, utilizzi e come stimarle. Vedremo come siano invarianti di scala e perché compaiono in campi diversi come geofisica, finanza, biologia e internet.
Partiamo da ciò che rende speciali le leggi di potenza — e in cosa differiscono dalle distribuzioni che potresti aver usato finora.
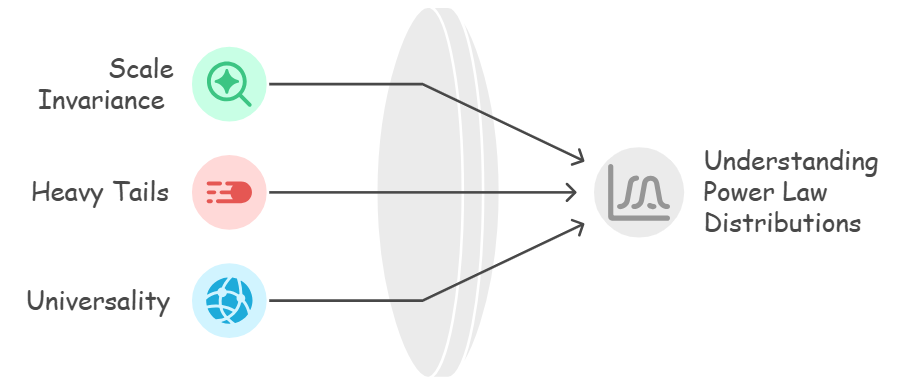
Caratteristiche delle leggi di potenza. Fonte: Napkin AI
In parole semplici, l’invarianza di scala implica che se fai zoom in o out, il pattern della distribuzione resta lo stesso.
In termini statistici, una distribuzione a legge di potenza ha la stessa forma funzionale a qualunque scala la si osservi. Se una variabile segue una legge di potenza, moltiplicarla per una costante non cambia il modo in cui è distribuita; cambia solo la scala.
Matematicamente, questo significa:
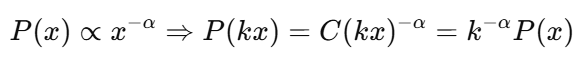
Questo è molto diverso da altre distribuzioni comuni, come la distribuzione normale, dove la forma è definita in base a parametri chiave come media e deviazione standard.
Questa proprietà è simile anche all’autosimilarità, che è una caratteristica chiave dei frattali. I frattali sono strutture che appaiono uguali indipendentemente da quanto ci si avvicini. Per esempio, se fai zoom su qualsiasi parte di un fiocco di neve, di una foglia di felce o di un ramo, vedrai una versione in miniatura dell’intero oggetto.
Una linea costiera appare uguale da 10 metri così come da 10 chilometri di distanza.
Le leggi di potenza descrivono molto bene questa struttura ripetuta. Ecco perché sono utili quando si analizzano sistemi in cui dimensione, frequenza o intensità variano molto ma seguono sempre lo stesso pattern.
La maggior parte delle distribuzioni classiche (come gaussiana o esponenziale) decresce rapidamente nelle code. Non così per le leggi di potenza. Hanno code pesanti, il che significa che la probabilità di eventi estremi è maggiore.
Nella vita reale, grandi terremoti, tweet virali e miliardari sono tutti esempi di eventi rari che hanno comunque una certa probabilità di accadere. Anzi, per alcuni valori di alfa, momenti come media o varianza potrebbero nemmeno esistere, ed è per questo che diciamo che le distribuzioni a legge di potenza non hanno una scala.
Una cosa sorprendente delle leggi di potenza è che sono universali; si trovano in sistemi che non sembrano avere alcuna correlazione tra loro. Alcuni esempi includono: magnitudo dei terremoti, picchi nell’attività neurale, dimensione delle aziende e frequenza delle parole.
Il rovescio della medaglia è che sono anche statisticamente incomplete. Ciò significa che, sebbene possiamo modellare il comportamento della coda, è difficile stimare un set completo di statistiche riassuntive, soprattutto con piccoli campioni di dati.
Approfondiamo la matematica che rende le leggi di potenza sia potenti che insidiose.
La forma standard di una legge di potenza è:
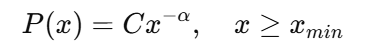
Dove:
All’aumentare di alpha, la coda si assottiglia. Un alpha piccolo implica eventi più estremi. Questo esponente di scala governa tutto, dalle disuguaglianze alle dimensioni degli ecosistemi.
Il primo passo è usare un grafico log-log per rilevare una legge di potenza in dataset reali.
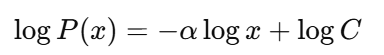
Se i dati seguono davvero una legge di potenza, otterrai una linea retta con pendenza −α. Ma attenzione: molte distribuzioni sembrano lineari su un grafico log-log.
Ci sono diverse distribuzioni statistiche importanti che sono simili alle leggi di potenza.
A volte, i dati reali non seguono una legge di potenza “pura” per sempre. In queste situazioni, vediamo tagli esponenziali (dove valori molto grandi diventano meno probabili), leggi di potenza curve o code log-normali. Queste sono più adatte a modellare sistemi con limiti fisici o pratici. Questi ibridi riconoscono che l’invarianza di scala può valere per una parte dell’intervallo, ma prima o poi smette di funzionare.
Le leggi di potenza non sono solo idee matematiche; compaiono nel mondo reale e ci aiutano a dare senso a sistemi che a prima vista sembrano casuali o caotici.
Le leggi di potenza ci aiutano a comprendere gli eventi estremi in natura. Per esempio, la legge di Gutenberg-Richter afferma che le magnitudo dei terremoti seguono una distribuzione a legge di potenza. Significa che le scosse piccole avvengono spesso, ma all’aumentare della magnitudo il numero di terremoti cala rapidamente. Ecco perché un sisma di magnitudo 2.0 può avvenire ogni giorno, mentre uno di magnitudo 7.0 può non verificarsi per anni. Entrambi fanno parte della stessa storia statistica.
Allo stesso modo, reti fluviali, linee costiere e persino fulmini mostrano pattern autosimili e frattali che seguono una scalatura a legge di potenza nelle dimensioni dei loro segmenti.
Le leggi di potenza sono applicabili anche all’universo. In astrofisica, vediamo che le dimensioni delle stelle, la distribuzione dei buchi neri e persino gli ammassi di galassie hanno code pesanti. Esistono miliardi di stelle piccole, ma solo poche gigantesche spiccano nella galassia. Questa disomogeneità può sembrare casuale, ma una volta compresa la legge di potenza sottostante si vede che segue precise regole statistiche.
Quando si studiano disuguaglianze e scale nelle società umane, le leggi di potenza sono particolarmente utili. Abbiamo già citato la distribuzione di Pareto nella sezione precedente, che non è solo una teoria economica; la si vede nei registri fiscali, nei profitti aziendali e nei modelli di donazione.
L’1% in cima alla distribuzione della ricchezza segue la legge di Pareto, non medie gaussiane. Queste distribuzioni non rientrano in una bella curva a campana; invece si allungano molto a destra, mostrando pochi valori estremi (come i miliardari) che alterano la media.
Le leggi di potenza rivelano pattern nascosti anche in biologia. Per esempio, la legge di Kleiber afferma che il tasso metabolico di un animale cresce con la massa corporea alla potenza 3/4, non in modo lineare. Questo ci aiuta a capire perché un elefante non mangia mille volte più di un coniglio, anche se pesa mille volte di più.
Le leggi di potenza si applicano anche alle popolazioni urbane, ai tassi di crescita delle aziende, ai comportamenti di voto e persino alle vittime dei conflitti, dove pochi eventi o entità di grandi dimensioni hanno un effetto sproporzionato.
Le leggi di potenza sono ciò che fa funzionare e prosperare il mondo digitale. Pensa a come funziona il traffico su internet: solo pochi siti (come Google, Facebook e YouTube) ricevono la maggior parte delle visite, mentre milioni di altre pagine passano perlopiù inosservate. Questo è un tipico comportamento a coda lunga, particolarmente importante in ambiti come SEO, motori di raccomandazione e marketing digitale.
Nell’IA, le dimensioni e le prestazioni dei modelli tendono ad andare di pari passo. Ci sono pochi modelli molto grandi, come GPT-4, che sono i migliori del settore, ma centinaia di modelli più piccoli non riescono a tenere il passo. Questa concentrazione è dovuta in parte a loop di feedback: i modelli migliori ottengono più utenti, dati e fondi, il che li rende ancora più potenti.
Sembra che il tuo dataset segua una legge di potenza. L’istogramma potrebbe avere una lunga coda o il grafico log-log potrebbe mostrare una linea per lo più dritta. È un buon inizio, ma guardare non basta perché è facile lasciarsi ingannare dalle leggi di potenza. Ecco perché servono buoni strumenti statistici per stimarne i parametri e verificarne l’adeguatezza.
L’esponente di scala, di solito indicato con 𝛼, è la prima cosa che ti serve per modellare correttamente una distribuzione a legge di potenza.
La massima verosimiglianza (MLE, Maximum Likelihood Estimation) è uno dei modi più comuni per stimare 𝛼. È un metodo generale per trovare i valori dei parametri che rendono i dati osservati più probabili.
Per dati continui con un valore minimo 𝑥min noto, funziona così:
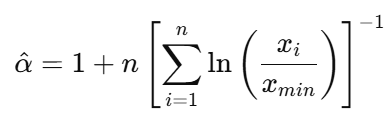
Ma ecco la parte difficile: scegliere il giusto 𝑥min è molto importante. Se è troppo basso, il modello include dati che non seguono davvero la legge di potenza. Se è troppo alto, finisci per scartare troppi dati. Inoltre, con campioni piccoli, le stime MLE possono essere inaffidabili.
Dopo aver stimato l’esponente, la domanda successiva è: quanto si adatta bene? Non puoi limitarti a dire: "Sembra un po’ una legge di potenza". Ti servono prove statistiche che la legge di potenza spieghi i tuoi dati meglio di altre possibili distribuzioni. Qui entra in gioco il test di Kolmogorov–Smirnov (KS). Questo test trova il divario più grande tra la funzione di distribuzione cumulativa (CDF) dei tuoi dati osservati e il modello teorico a legge di potenza.
Più questo numero è vicino a zero, meglio il modello si adatta ai dati. Il test KS non usa raggruppamenti o istogrammi come fanno molti altri test. Lavora invece direttamente sui dati grezzi, il che lo rende molto utile per distribuzioni a coda pesante. Ma a volte una legge di potenza non è l’unica spiegazione plausibile. Una distribuzione lognormale o esponenziale potrebbe modellare i tuoi dati altrettanto bene. In questi casi sono utili i test del rapporto di verosimiglianza. L’idea è semplice: usa MLE per adattare entrambi i modelli agli stessi dati, calcola le verosimiglianze e poi confrontale. Hai supporto statistico per il modello a legge di potenza se la sua verosimiglianza è molto più alta.
Il framework di Clauset–Shalizi–Newman (2009) è uno tra gli strumenti che combinano MLE, test KS e test del rapporto di verosimiglianza in un approccio solido per analizzare il comportamento a legge di potenza.
Ora che sappiamo dove compaiono le leggi di potenza nel mondo reale e come individuarle statisticamente, la domanda successiva è: perché queste distribuzioni emergono? Vediamo come le leggi di potenza possano emergere dalla dinamica dei sistemi.
Il modello di Barabási–Albert (1999) ha introdotto l’attaccamento preferenziale, spesso riassunto come fenomeno "i ricchi diventano più ricchi". È uno dei modi più noti e intuitivi in cui operano le leggi di potenza.
Pensa alla creazione di una rete, come internet o un social network. Quando un nuovo utente arriva, è più probabile che si colleghi a nodi popolari come Facebook o Google perché sono già molto noti.
Col tempo, questo crea un loop di feedback: i nodi popolari ricevono ancora più connessioni, mentre quelli nuovi o meno connessi restano piccoli. Si crea così una rete priva di scala in cui i gradi dei nodi seguono una legge di potenza.
Allo stesso modo, i processi di Yule, che modellano la crescita dei generi biologici, sono un’estensione di questa idea. In questo modello, le specie che hanno già più membri hanno maggiori probabilità di dar vita a nuove specie. Ciò porta a una distribuzione sbilanciata in cui pochi generi dominano.
I processi di crescita casuale sono un altro modo in cui possono emergere le leggi di potenza. L’idea principale è che le cose crescono nel tempo moltiplicando quantità casuali, invece di aggiungerle.
La legge di Gibrat afferma che il tasso di crescita è indipendente dalla dimensione. La maggior parte delle entità resta piccola, ma alcune crescono molto rapidamente e diventano molto grandi, creando la coda pesante di una legge di potenza.
I processi di Markov, soprattutto quelli con rumore moltiplicativo, possono anche convergere a distribuzioni stazionarie simili a leggi di potenza — specialmente con barriere riflettenti.
C’è anche un lato probabilistico. I processi di Markov possono mostrare comportamento a legge di potenza in alcune situazioni. Questi processi modellano sistemi in cui lo stato successivo dipende solo da quello attuale, non dal passato. Sono stati usati per modellare, ad esempio, gli spostamenti delle persone in una popolazione e il funzionamento delle code.
Questi modelli non sono solo idee interessanti. Ci aiutano a capire come i sistemi complessi evolvono nel tempo, perché la disuguaglianza persiste e come gli effetti di rete influenzino tutto, dalla biologia alla blockchain. Le leggi di potenza non solo descrivono il mondo, ma ci aiutano anche a spiegarlo.
Capire la dinamica delle leggi di potenza è fondamentale e può avere un grande impatto su previsioni e decisioni, che tu stia costruendo un modello di rischio finanziario, gestendo un’infrastruttura internet o studiando il comportamento sociale.
I modelli a legge di potenza sono utili per sistemi in cui accadono eventi rari ma importanti. Ad esempio, in finanza, i prezzi possono muoversi a un ritmo normale nella maggior parte dei giorni, ma i "cigni neri" — i crolli o i boom rari — possono avere l’effetto maggiore.
I modelli a legge di potenza riescono a catturare meglio questo rischio di coda rispetto ai modelli tradizionali, che spesso sottostimano la probabilità di tali eventi. Per la gestione del rischio, le assicurazioni, la cybersicurezza e la pianificazione delle emergenze, è un aspetto cruciale.
C’è anche il vantaggio di comprendere la crescita non lineare e gli effetti di capitalizzazione. Le leggi di potenza aiutano a spiegare perché alcune persone, aziende o nodi in una rete possono diventare i più influenti nel tempo e perché queste situazioni "winner-takes-most" non sono eccezioni, ma la norma in questi sistemi.
Ma i modelli a legge di potenza comportano dei compromessi. Un problema è che sfidano l’intuizione — non sempre hanno medie o varianze ben definite, il che rende difficile calcolare metriche comuni come "valore atteso" o "deviazione standard".
Questi modelli di solito funzionano solo sulla coda della distribuzione, quindi potrebbero non descrivere bene — o per nulla — la parte centrale dei dati. Questo può essere un problema se non stai attento a dove inizia effettivamente il comportamento a legge di potenza.
Non tutti i dataset con lunghe code seguono una vera legge di potenza. Alcune distribuzioni, come la lognormale o l’esponenziale stirata, possono sembrare comportarsi come una legge di potenza su un intervallo ristretto, soprattutto su un grafico log-log. Questo porta spesso a falsi positivi, dove etichettiamo come legge di potenza solo perché il grafico "sembra lineare". Un altro problema è la sovrageneralizzazione. Spesso si pensa che le leggi di potenza spieghino tutto di un sistema, ma potrebbero spiegare solo una piccola parte, di solito l’estremo. Per esempio, l’1% più ricco può seguire una legge di potenza per il reddito, ma il resto della popolazione può avere una distribuzione molto diversa.
La legge dei rendimenti decrescenti è un altro problema che i sistemi reali affrontano. Le leggi di potenza affermano che risultati estremi sono possibili, ma in alcuni ambiti, come i limiti fisici o i vincoli regolatori, esistono soglie oltre le quali il modello non funziona più. Se pensi che il comportamento di coda continui all’infinito, potresti sovrastimare rischi o ricompense, soprattutto in sistemi con limiti.
Le leggi di potenza ci aiutano a capire sistemi in cui pochi eventi o entità estremi hanno un grande impatto, come i terremoti, il traffico su internet o la distribuzione del reddito. In questo tutorial abbiamo visto cosa rende diverse le leggi di potenza, le loro proprietà matematiche e impronte empiriche, come individuarle e verificarle, e dove si trovano nel mondo reale.
L’analisi delle leggi di potenza avrà applicazioni interessanti in futuro in aree come IA, economia, scienza delle reti e gestione del rischio. Con gli strumenti e le conoscenze giuste, possiamo usarle per comprendere meglio un mondo complesso e non lineare.
Quando approfondisci i dati reali, chiediti sempre: il raro è davvero raro — o è semplicemente distribuito secondo una potente legge?
Se vuoi approfondire alcuni dei concetti, dai un’occhiata a queste risorse:
Impara con DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



