Curs
Programare asistată de AI pentru dezvoltatori
1 ore 30 min
10.5K
A trecut ceva timp de când am văzut o companie nouă intrând în cursa LLM. Dar pe 3 octombrie, Aleph Alpha și-a publicat noul model Kolibri 1 pe Hugging Face sub licență Apache 2.0 și a cerut Europei să ia în serios ideea de AI suverană.
Argumentul este că guvernele și companiile europene pot rula un model capabil pe propriul hardware, chiar și complet offline, în loc să depindă de API-ul unui furnizor din SUA.
Kolibri 1 este un model mixture-of-experts (MoE) cu 78B parametri în total și 3,46B activi per token, antrenat de la zero de Aleph Alpha Research pe 768 de GPU-uri NVIDIA B200 în centre de date din Germania și Finlanda.
Gestionează doar germană și engleză, suportă o fereastră de context de 1.048.576 tokeni (Aleph Alpha recomandă să rămâi la sau sub 262.144 tokeni pentru eficiența servirii) și este livrat ca disponibil în general, nu ca previzualizare. Pre-antrenarea a acoperit 20 de trilioane de tokeni, urmată de 3,44T în antrenarea de mijloc și 201B pentru extensia de context lung.
În acest articol, trec prin tot ce e nou la Kolibri 1: caracteristicile cheie, reperele de performanță și cât costă, de fapt, să îl rulezi.
Kolibri 1 este modelul mare de limbaj (LLM) bilingv, specializat, al Aleph Alpha, lansat pe 3 octombrie 2026, sub Apache 2.0. Este un singur model disponibil în mod general, fără versiuni mai mici sau mai mari.
Sub capotă, este un transformer mixture-of-experts cu 50 de straturi.
Fiecare strat conține 384 de subrețele mici specializate numite „experți”, iar un router trimite fiecare token la doar 6 dintre ele, plus 1 expert partajat care rulează întotdeauna. Așa ajung 78,1B de parametri totali la 3,46B activi per token (circa 4,4%), deci modelul e construit pentru servire ieftină, nu pentru capacitate maximă.
Încă două alegeri de design îl mențin rapid și econom la memorie:
Rezultatul-vedetă pe care îl evidențiază Aleph Alpha este eficiența, nu capacitatea brută.
Kolibri 1 are o medie de 71% pe suita sa de repere în germană, decodând aproximativ 47.000 de bytes/s de text per GPU, față de 68% la aproximativ 24.000 de bytes/s pentru Nemotron Super A12B.
Modelul are un knowledge cutoff la 18 iunie 2026 pentru ambele limbi și este doar text, fără intrare sau ieșire de imagini, audio sau video.
Dacă vrei să vezi de unde vine, de fapt, capacitatea pe germană, mixul de date publicat este neobișnuit de transparent pentru un release open-weight.
| Domeniu | Pre-antrenare | Antrenare de mijloc | Extensie de context lung |
|---|---|---|---|
| Web și documente în engleză | 43,4% | 1,3% | 15,8% |
| Web și documente în germană | 23,4% | 2,1% | 2,6% |
| Cod | 13,6% | 16,3% | 13,2% |
| Cod agentic și utilizare de unelte | ~0% | 15,4% | 5,6% |
| PDF-uri OCR | 0% | 0% | 33,3% |
Tabelul arată doar rândurile pentru web, cod, agentic și PDF. Cardul modelului listează, de asemenea, date de instrucțiuni și raționament în engleză și germană, documente STEM, QA și date specializate juridice și din sectorul public. Dacă totalizăm toate rândurile în engleză și germană, cardul rezumă mixul de pre-antrenare ca aproximativ 62,5% engleză, 23,9% germană și 13,6% cod.
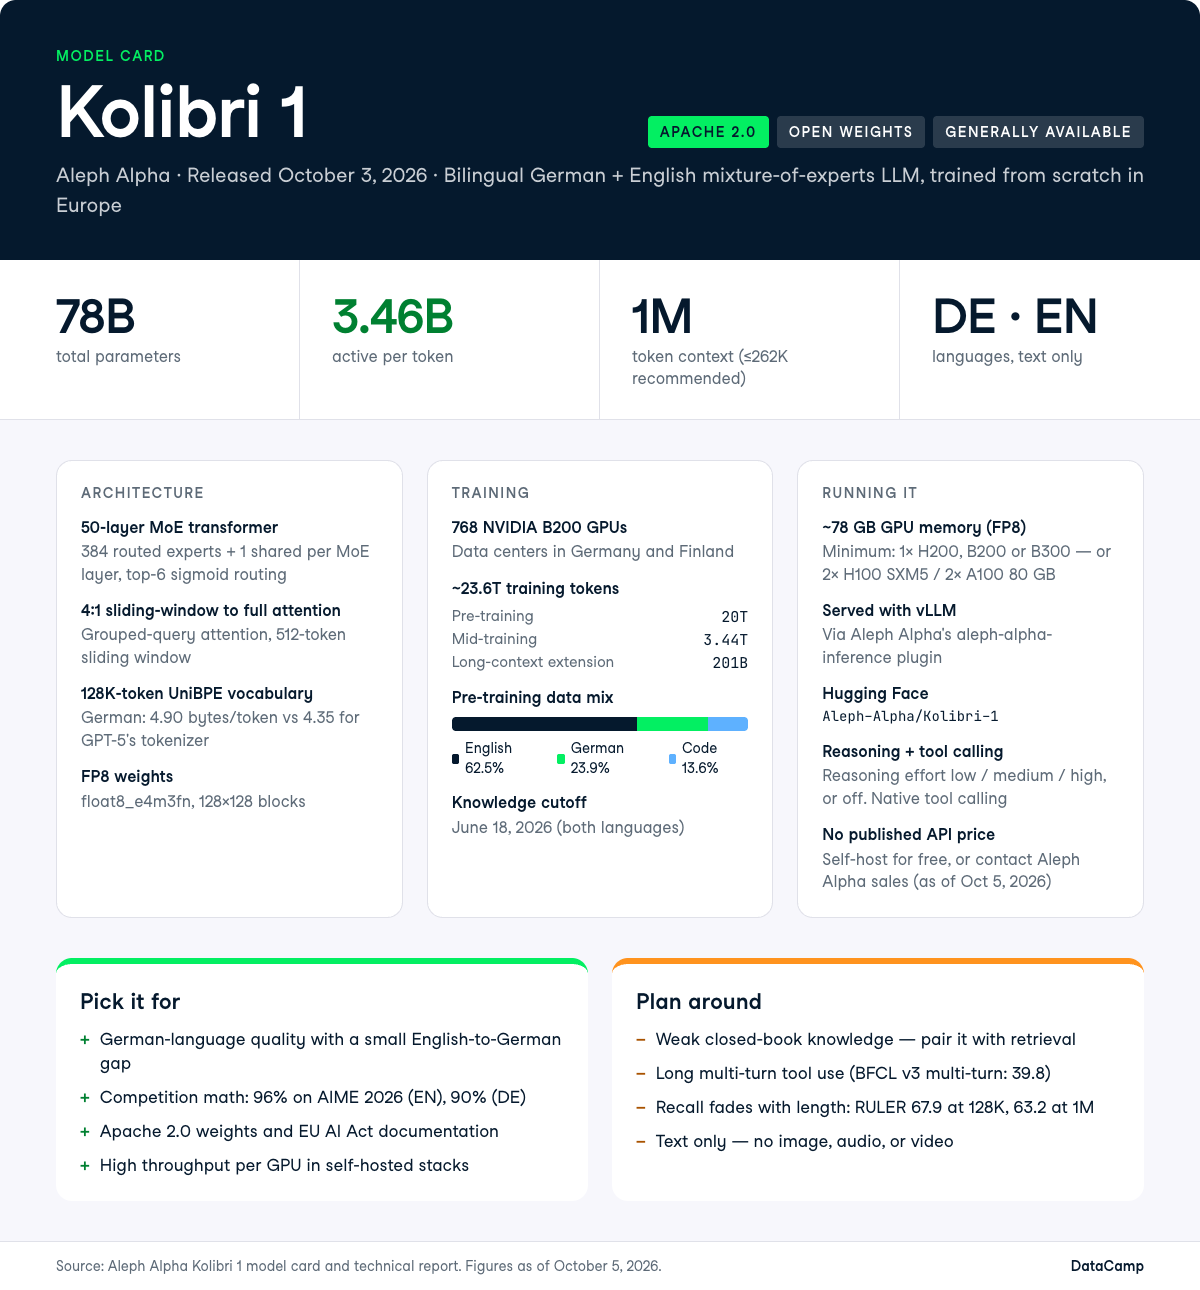
Majoritatea lucrurilor care diferențiază Kolibri 1 se reduc la două decizii: să antreneze corect partea de germană, nu prin traducere, și să mențină numărul de parametri activi suficient de mic încât un singur H200 să poată servi modelul.
Kolibri 1 micșorează mai mult decât te-ai aștepta diferența dintre germană și engleză, ceea ce e neobișnuit pentru un model open-weight de această dimensiune.
Media generală pe repere este 75,5 în engleză și 70,8 în germană.
Aleph Alpha a antrenat un vocabular de 128.000 de tokeni cu un algoritm nou de tokenizare numit UniBPE, care păstrează îmbinările greedy bottom-up ale byte-pair encoding, dar folosește obiectivul Unigram ca să aleagă ce îmbinare intră în vocabular.
Rezultatul declarat este o comprimare în germană de 4,90 bytes/token, față de 4,35 pentru tokenizer-ul lui GPT-5, în timp ce engleza rămâne la 4,58 bytes/token (tokenizer-ul GPT-5 obține 4,67).
Asta contează la cost la fel de mult ca la calitate.
O comprimare mai bună înseamnă mai puțini tokeni pentru același document în germană, deci un Bescheid de 50 de pagini (o înștiințare administrativă oficială germană) costă mai puțin de procesat și lasă mai mult spațiu în context.
Germana a reprezentat 23,4% din mixul de pre-antrenare, față de 43,4% pentru web și documente în engleză, așa că această capacitate este plătită cu date, nu cu un fine-tune adăugat după runda principală de antrenare.
Modelul anunță 1.048.576 de tokeni. Gestionează nativ 262.144 de tokeni după o etapă de antrenare pentru context lung de 201B tokeni și se întinde până la 1M prin extrapolare, ceea ce înseamnă că nu a fost antrenat la acea lungime.
Aleph Alpha însuși recomandă să rămâi la sau sub 262.144 de tokeni pentru eficiența servirii. RULER, un test care măsoară dacă un model poate găsi și folosi detalii specifice îngropate în intrări foarte lungi, arată degradarea pentru modelul de bază: 67,9 la 128K și 63,2 la 1M, față de un rezultat citat de 89,9 la 128K pentru Qwen3.5 35B-A3B Base.
În mod corect, scorul de 1M al lui Kolibri tot îl depășește pe Nemotron 3 Nano (58,5) și Qwen3.5 (57,5) la acea lungime, deci se estompează mai puțin decât ele, pornind însă de la un nivel mai scăzut.
Aș trata cifra de 1M ca un plafon pe care îl poți atinge tehnic, nu ca un buget de lucru.
Dacă pipeline-ul tău de RAG îndeasă 400K de tokeni din PDF-uri scanate convertite în text (OCR) într-un prompt și te aștepți ca modelul să găsească fiabil un detaliu specific, testează înainte să te angajezi. Notabil, 33,3% din mixul pentru extensia de context lung a fost reprezentat de PDF-uri OCR, deci fluxurile cu documente scanate sunt clar cazul de utilizare țintă.
Modul de raționament înseamnă că modelul parcurge o problemă pas cu pas înainte de a răspunde, ceea ce îmbunătățește acuratețea, dar consumă mai mulți tokeni.
În Kolibri 1, e un comutator pe care îl controlezi, nu un nivel separat de model, iar apelarea de unelte (decizia modelului de a apela o funcție sau un API extern, cum ar fi o interogare de bază de date) este nativă.
Aleph Alpha listează raționament în mai mulți pași, RAG, apelare agentică de unelte, programare și asistență bilingvă ca utilizări intenționate, iar mixul de antrenare de mijloc a alocat 15,4% pentru cod agentic și utilizare de unelte, de la practic zero în pre-antrenare.
Un raport anecdotic de la un utilizator, rulând modelul în FP8 pe un singur GPU de workstation RTX Pro 6000, a măsurat în jur de 170 de tokeni pe secundă și a notat o tendință de a petrece mulți tokeni deliberând.
Ține cont de asta în buget dacă lași raționamentul activat implicit pe un traseu sensibil la latență.
Kolibri 1 a fost antrenat de la zero, deci nu este un fine-tune sau o copie a modelului altei companii.
Asta contează pentru licențiere și pentru a ști exact ce a intrat în el.
Combinat cu greutăți Apache 2.0, asta înseamnă că poți rula Kolibri 1 air-gapped (complet deconectat de internet), îl poți fine-tuna și îl poți livra într-un produs comercial fără să ceri permisiunea nimănui.
AI Act al UE și Codul de bune practici pentru GPAI stabilesc regulile UE pentru modelele de uz general, inclusiv documentarea datelor de antrenare.
Aleph Alpha este semnatar al Codului de bune practici și publică un card de model detaliat care acoperă sursele datelor de antrenare, pașii de decontaminare (eliminarea întrebărilor de benchmark din datele de antrenare) și un punct de contact pentru titularii de drepturi — documentația pe care o va solicita o revizuire de conformitate cu AI Act al UE.
Pentru achizitorii din sectorul public din Germania și UE, această documentație este adesea factorul decisiv, nu diferența din benchmark-uri.
Este și partea pe care niciun laborator din SUA nu o poate copia rapid.
Aleph Alpha listează deschis limitările în cardul modelului, iar ele merită citite înainte de o decizie de achiziție:
Pentru orice implementare cu miză mare, Aleph Alpha declară că sunt necesare măsuri suplimentare de protecție și conformitate cu Regulamentul (UE) 2024/1689.
Profilul de benchmark al lui Kolibri 1 este dezechilibrat într-un mod util: conduce setul de comparație declarat la matematică de competiție și raționament în germană și pierde în fața Qwen3.6 35B-A3B la cunoștințe închise, MMLU-Pro și majoritatea suitelor de utilizare a uneltelor.
Aleph Alpha compară cu Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B și Nemotron 3 Super 120B-A12B.
Cardul modelului listează și Qwen3.8 27B, un model dens (care își folosește toți parametrii pentru fiecare token, spre deosebire de un MoE) ce obține scoruri mai mari peste tot (germană per total 79,9 față de 70,8 la Kolibri) cu aproximativ de opt ori mai mulți parametri activi.
Nu l-am inclus în tabelele de mai jos, dar ține-l minte când citești afirmațiile despre eficiență.
În aceste nume de modele, numărul după „A” reprezintă parametrii activi per token, deci 35B-A3B înseamnă 35B total și 3B activi. Iată ce măsoară benchmark-urile din tabelele de mai jos:
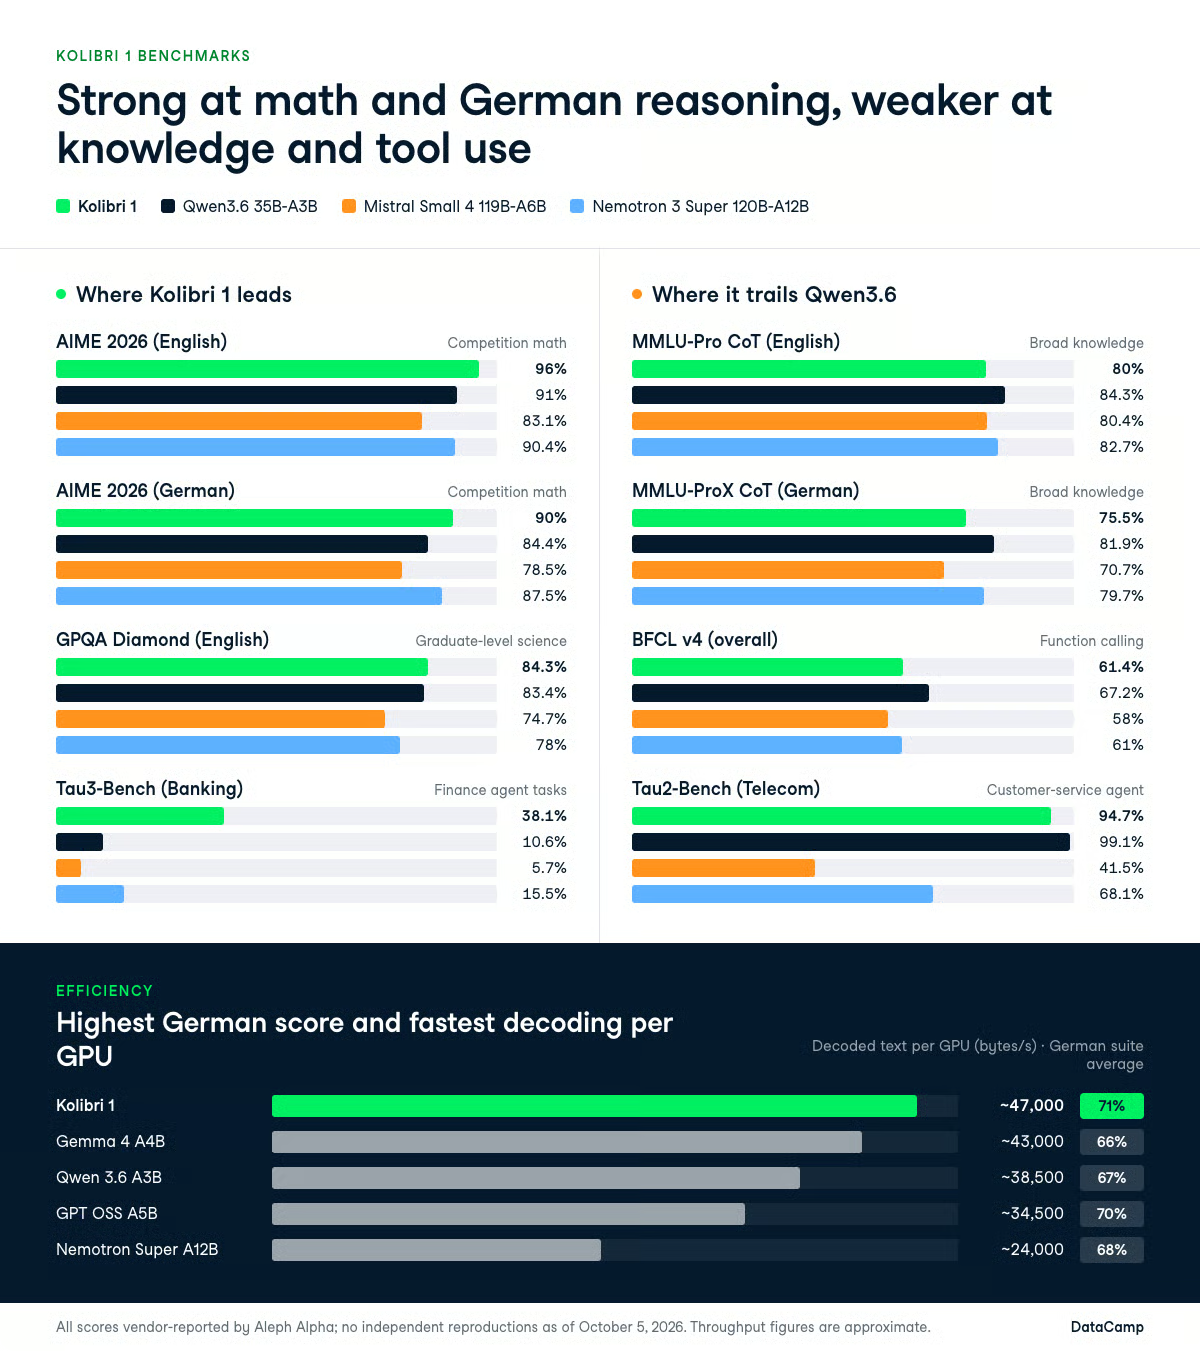
La matematică, Kolibri 1 este clar în față.
Obține 96% la AIME 2026 (EN), față de 91% pentru Qwen3.6 35B-A3B, 90,4% pentru Nemotron 3 Super și 83,1% pentru Mistral Small 4, și 96,9% la AIME 2025 (EN), față de 84,6% pentru Qwen3.6.
La GPQA Diamond (EN) ia 84,3% față de 83,4%, iar la Humanity's Last Exam (EN) 21,5% față de 21,1%, ambele suficient de apropiate cât să le consideri la egalitate.
Punctul slab în același tabel este cunoașterea factuală.
AA-Omniscience Index (set public) este punctat pe o scară unde valorile negative sunt comune, iar mai mare înseamnă mai bine. Kolibri 1 obține -32,8 față de -12,5 pentru Qwen3.6 și -24,0 pentru Mistral Small 4, deși îl depășește pe Nemotron 3 Super, cu -36,5. O valoare separată pentru acuratețea AA-Omniscience este de 14,8%, cea mai joasă dintre cele patru modele.
Rata de non-haluicinație pe același benchmark este mai favorabilă, 44,0%, înaintea lui Nemotron (13,9%) și Mistral (34,7%), dar în urma lui Qwen3.6 (56,7%), ceea ce se potrivește cu antrenarea pe abstinență a Aleph Alpha.
Un model cu 3,46B parametri activi are spațiu limitat să memoreze fapte, așa că asociază-l cu retrieval, nu te baza pe reamintirea fără surse.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83.1% | 90.4% |
| AIME 2025 | 96.9% | 84.6% | 79.8% | 91.7% |
| GPQA Diamond | 84.3% | 83.4% | 74.7% | 78% |
| Humanity's Last Exam | 21.5% | 21.1% | 9.7% | 20.6% |
| MMLU-Pro CoT | 80% | 84.3% | 80.4% | 82.7% |
| AA-Omniscience Index (mai mare este mai bine) | -32.8 | -12.5 | -24.0 | -36.5 |
Kolibri 1 câștigă la benchmark-urile de matematică și științe în germană și pierde la cele de cunoștințe în germană, aceeași configurație ca în profilul său în engleză.
Obține 90% la AIME 2026 (DE) față de 84,4% pentru Qwen3.6 și 81,3% la GPQA Diamond (DE) față de 80,6%. La MMLU-ProX CoT (DE) scade la 75,5%, în timp ce Qwen3.6 ajunge la 81,9% și Nemotron 3 Super la 79,7%, iar la Humanity's Last Exam (DE) reușește 15,9% față de 22,3% pentru Nemotron.
Ceea ce mi se pare cu adevărat interesant este micuța diferență dintre engleză și germană.
Kolibri pierde 6 puncte când mută AIME 2026 din engleză în germană și 3 puncte la GPQA Diamond, o scădere mai mică decât te-ai aștepta de la un model care tratează germana ca o țintă de traducere.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84.4% | 78.5% | 87.5% |
| AIME 2025 | 87.5% | 82.9% | 72.3% | 85.6% |
| GPQA Diamond | 81.3% | 80.6% | 72.9% | 76.6% |
| MMLU-ProX CoT | 75.5% | 81.9% | 70.7% | 79.7% |
| Humanity's Last Exam | 15.9% | 20.5% | 10.5% | 22.3% |
Aceasta este partea cea mai slabă a lansării.
La BFCL v4 per total, Kolibri 1 obține 61,4% față de 67,2% pentru Qwen3.6, iar la Tau2-Bench (Telecom) atinge 94,7% față de 99,1% pentru Qwen3.6. Îl depășește totuși pe Qwen3.6 la Tau2-Bench (Airline), 76,7% la 70,7%.
Un scor separat raportat pentru BFCL v3 multi-turn de 39,8 puncte (53,5 pentru Qwen3.6) arată aceeași slăbiciune: apelurile unice de instrument sunt în regulă, conversațiile lungi cu multe bucle de apeluri nu.
Excepția merge în sens invers.
La Tau3-Bench (Banking), Kolibri 1 obține 38,1%, în timp ce Qwen3.6 are 10,6%, Nemotron 3 Super 15,5% și Mistral Small 4 doar 5,7%. Asta înseamnă cam de 2,5 ori peste următorul cel mai bun model din acest set de comparație (de 3,6 ori peste Qwen3.6) pe un benchmark agentic cu specific financiar și este singurul rezultat din această lansare pe care mi-aș dori cel mai mult să fie reprodus independent.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94.7% | 99.1% | 41.5% | 68.1% |
| Tau2-Bench (Retail) | 69.9% | 71.6% | 62.9% | 67.5% |
| Tau2-Bench (Airline) | 76.7% | 70.7% | 40% | 72.7% |
| Tau3-Bench (Banking) | 38.1% | 10.6% | 5.7% | 15.5% |
| BFCL v4 (per total) | 61.4% | 67.2% | 58% | 61% |
Rezultatele raportate la cod sunt 85,9 pe LiveCodeBench v6, 66,4 pe SWE-bench Verified și 27,7 pe Terminal-Bench 2.1.
Generarea brută de cod arată puternic, ingineria software agentică pare obișnuită, iar scorul de la Terminal-Bench spune că lucrul lung, în mai mulți pași, în terminal nu este punctul forte al acestui model.
Există un avertisment privind contaminarea pe care ar trebui să-l citești înainte de a cita aceste rezultate.
Raportul tehnic notează că 48% din datele de evaluare HumanEval în engleză și 47% în germană au apărut în materiale legate de antrenare, ceea ce umflă scorurile de tip HumanEval.
Câteva dintre suitele din tabelele de comparație sunt proprietare sau create de furnizori, ceea ce face dificil auditul setului complet, iar o comparație verificată, unu-la-unu, cu flagship-urile actuale Claude, GPT sau Gemini nu exista la momentul redactării.
Afirmația despre eficiență este cea care trece cel mai bine de avertismentul privind raportarea de către furnizori, pentru că este o proprietate a arhitecturii, nu un scor.
Aici, debitul înseamnă cât text poate genera modelul per GPU pe secundă. Aleph Alpha îl măsoară în bytes, nu în tokeni, astfel încât modelele cu tokenizatoare diferite să poată fi comparate corect.
Kolibri 1 stă la o medie de 71% pe suita de benchmark-uri în germană a Aleph Alpha, decodând aproximativ 47.000 bytes/s per GPU. GPT OSS A5B ajunge la 70% la circa 34.500 bytes/s, Qwen 3.6 A3B 67% la circa 38.500, Gemma 4 A4B 66% la circa 43.000, iar Nemotron Super A12B 68% la circa 24.000.
A servi aproximativ de 2x mai mult text decodat per GPU decât modelul Nemotron, la o medie germană mai mare, este argumentul practic pentru a alege Kolibri într-un stack self-hosted.
Dacă plătești pentru propriile GPU-uri, nu per token, debitul per GPU este numărul care apare pe factură.
Nu există un preț pe token publicat pentru Kolibri 1.
Aleph Alpha nu a publicat o listă de prețuri pentru API-ul găzduit, iar niciun ID confirmat de model API Kolibri nu apărea în documentația oficială a API-ului la 5 octombrie 2026.
Implementarea pentru enterprise se face prin echipa de vânzări Aleph Alpha, iar identificatorul de repository Aleph-Alpha/Kolibri-1 nu trebuie tratat ca un ID de model API.
Greutățile sunt gratuite sub Apache 2.0, deci costul tău este timpul de GPU.
Amprenta de memorie FP8 este de aproximativ 78 GB, cu un minim declarat de 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200 sau 1x B300, și o configurație recomandată de 2x H100 SXM5, 2x H200, 1x B200 sau 1x B300. Modelul este disponibil în general, nu în preview, fără listă de așteptare sau blocare pe regiune.
Ca reper pentru ce compari, acoperirea noastră despre GPT-6.1 Sol plasează acel model la 2 $ input / 10 $ output per milion de tokeni. Un sumar de prețuri al unei terțe părți listează mai vechiul GPT-5.6 Sol la 5 $ / 30 $ și GPT-5.6 Luna la 0,20 $ / 1,20 $ după reducerea de preț OpenAI din 30 iulie.
Self-hosting-ul iese mai bine la economia unitară abia după ce volumul tău depășește costul fix al unui B200.
Kolibri 1 are greutăți open sub Apache 2.0, ceea ce permite utilizare comercială, modificare și redistribuire fără praguri de utilizatori sau venituri.
Greutățile sunt la Aleph-Alpha/Kolibri-1 pe Hugging Face în float8_e4m3fn. Cardul modelului documentează servirea doar prin vLLM, folosind pluginul aleph-alpha-inference al Aleph Alpha. Build-uri GGUF și MLX din comunitate au apărut în câteva zile, dar Aleph Alpha nu le-a validat, iar eu nu am găsit o intrare Ollama oficială.
Pentru un deployment servit, 1x H200 sau 1x B200 ține ~78 GB de greutăți FP8 pe un singur card. Folosește --tensor-parallel-size 2 pe H100.
Păstrează --max-model-len la sau sub 262.144, dacă nu ai testat în mod specific contexte mai lungi. A merge dincolo necesită un flag suplimentar --hf-overrides, documentat în cardul modelului.
Instalează pluginul și pornește serverul:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Apoi interoghează-l prin API-ul compatibil cu OpenAI, folosind parametrii de sampling recomandați de Aleph Alpha (temperature 1.0, top_p 0,97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Reasoning effort acceptă low, medium și high, și poți opri complet gândirea dacă latenta contează mai mult decât profunzimea.
Rezultatele vor varia în funcție de parametrii de sampling, iar cardul modelului notează că pot diverge ușor chiar și cu sampling dezactivat.
Pentru setări mai avansate privind inferența self-hosted și buclele agent, tutorialul nostru API despre construirea unui agent de migrare acoperă tiparele de permisiuni pentru instrumente și steering care se transferă direct.
Kolibri 1 este, teoretic, o „AI suverană”, adică o țară sau o organizație își poate rula, audita și controla AI-ul pe propria infrastructură și sub propria jurisdicție, fără să depindă de API-ul, prețurile sau termenii de serviciu ai unui furnizor străin. În cazul Kolibri 1, argumentul se sprijină pe greutăți Apache 2.0 pe care le poți rula air-gapped (deconectat de la internet), infrastructură de antrenare europeană și documentație conformă cu EU AI Act.
Totuși, în spatele acestei lansări stau două elemente de context corporativ.
Aleph Alpha a semnat un acord de fuziune obligatoriu cu compania canadiană Cohere pentru a forma ceea ce descriu drept prima soluție transatlantică de AI suverană.
Compania combinată va opera sub numele Cohere, cu sedii duale la Toronto și Berlin, iar Heidelberg va continua ca centru de cercetare. Acordul încă are nevoie de aprobare din partea autorităților.
O propunere de suveranitate depinde de faptul că deținătorul modelului continuă să-l susțină, iar brandul Aleph Alpha urmează să dispară în Cohere odată ce fuziunea se închide, așa că ambele aspecte merită urmărite alături de benchmark-uri.
Aleph Alpha pariază că suveranitatea, licențierea Apache 2.0 și conformitatea documentată cu EU AI Act contează mai mult pentru cumpărătorii din sectorul public european decât câteva puncte la MMLU-Pro.
Pariul pare rezonabil, iar fuziunea companiei cu Cohere sugerează că știe că nu poate câștiga doar prin scală.
Cred că e corect să spunem că Kolibri 1 este cel mai bun model open-weight în limba germană la această dimensiune de parametri activi pe care l-am văzut documentat atât de bine, dar nu este modelul la care aș apela dacă aș avea nevoie de rulări agentice lungi, cu mai multe ture, sau de reamintire factuală fără surse.
Dintre modelele MoE mici, cu parametri activi comparabili, Qwen3.6 35B-A3B încă câștigă. Dacă îți permiți un model dens de 27B, Qwen3.8 27B câștigă detașat.
Dacă vrei să te pui rapid la punct cu rularea și evaluarea unor astfel de modele, începe cu parcursul nostru de competențe AI Fundamentals.
Cursurile de top DataCamp
Curs
Curs
Curs