track
Fundamentele agenților AI
6 oră
OpenAI a lansat GPT-6.1 Sol pe 29 septembrie 2026, la DevDay, la o săptămână după GPT-6 Sol și la 26 de zile după GPT-6 Astra.
Astra a avut o medie de 23,80 $ per sarcină Terminal-Bench Science 0.1 la efort maxim, ceea ce a scos-o din calcul pentru munca de rutină. Sol este răspunsul OpenAI la această problemă.
Cifrele de titlu sunt 2,00 $ per 1M tokeni de input, 10,00 $ per 1M tokeni de output, o fereastră de context de 1.050.000 de tokeni și 128.000 de tokeni output maxim. În anunțul OpenAI, GPT-6.1 Sol se potrivește cu Astra pe DeepSWE v1.1 la aproximativ o cincime din cost, obține cu 2,2 puncte procentuale peste Claude Opus 5.5 de la Anthropic pe AutomationBench la efort mediu și costă 5,47 $ per sarcină Terminal-Bench Science 0.1 față de 23,80 $ pentru Astra.
În acest articol, acopăr noutățile la GPT-6.1 Sol: caracteristici, benchmarkuri și cifre de siguranță publicate de OpenAI, ce nivel din familia GPT-6 ar trebui să alegi și care este costul. Pentru detalii despre modelele înrudite, vezi tutorialul API pentru GPT-6 Sol și ghidul nostru pentru Claude Sonnet 5.5.
none sau minimal, iar Chat Completions nu poate apela tool-uri.GPT-6.1 Sol este modelul de raționament mid-tier al OpenAI din seria GPT-6, lansat pe 29 septembrie 2026 ca upgrade pentru GPT-6 Sol. Se plasează sub GPT-6 Astra, flagshipul lansat pe 3 septembrie, și peste GPT-6 Luna, modelul mic.
OpenAI spune că se apropie mult de Astra la cod scris de agenți, utilizare de computer și muncă profesională.
Addendumul la system card merge mai departe și descrie capabilități comparabile cu ale Astra, cu o combinație fără egal de viteză și accesibilitate.
Aș trata asta ca o afirmație ajustată la cost, nu una absolută. Astra conduce încă pe cele mai grele evaluări din cyber, biologie și știință.
Nu există GPT-6.1 Astra. Wall Street Journal a relatat că OpenAI a anulat lansarea din octombrie după ce modelul a regresat la testele de aliniere și la respectarea scopului autorizat de utilizator, iar OpenAI a confirmat decizia.
Așadar, GPT-6.1 Sol este singurul model 6.1, iar propriile sale valori privind înșelarea și persistența (mai jos) merită citite cu atenție.
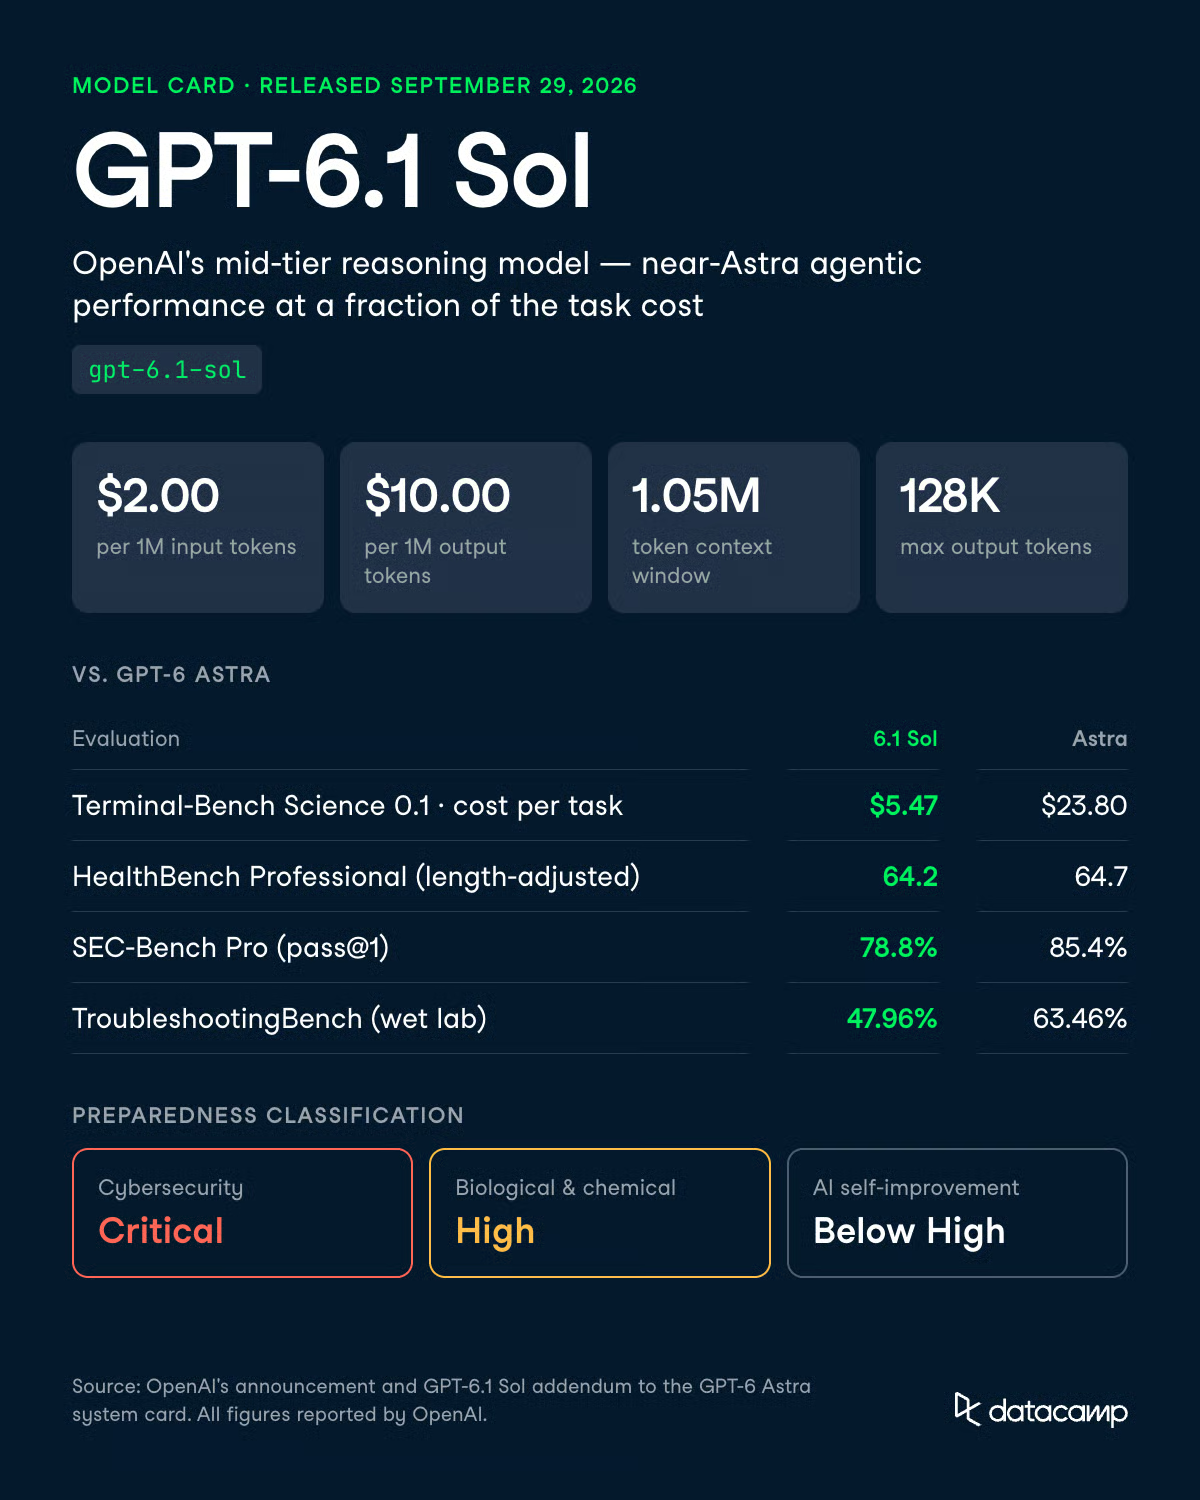
GPT-6.1 Sol aduce cele mai mari îmbunătățiri față de GPT-6 Sol în munca agentică și de securitate. T
acestea sunt câștigurile raportate de OpenAI:
OpenAI tratează GPT-6.1 Sol ca având capabilitate Critică în securitate cibernetică, Ridicată în domeniul Biologic și Chimic, și sub pragul Ridicat la Auto-Îmbunătățire AI. GPT-5.6 Sol era evaluat Ridicat, nu Critic, în securitate cibernetică. Dezvoltatorii ar trebui să citească această clasificare de două ori.
Asta înseamnă că modelul moștenește întregul pachet de protecții Astra, inclusiv acces etapizat pentru munca cyber avansată prin programul Daybreak. Sol nu primește o versiune mid-tier mai ușoară a acelor controale.
Majoritatea noutăților țin de a face aceeași muncă cu mai puțini bani, cu câteva schimbări de API la care trebuie să te adaptezi. Aceste capabilități îți schimbă modul în care ai construi cu el.
GPT-6.1 Sol primește 1.050.000 de tokeni de input și returnează până la 128.000, potrivind fereastra lui GPT-6 Sol.
Partea sensibilă e la facturare: prompturile peste 272.000 de tokeni de input sunt taxate la 2x pentru input și cache și 1,5x pentru output, pentru întreaga cerere, nu doar pentru depășire.
Analiza la nivel de repository sub 272.000 de tokeni e ieftină. Un singur pas de retrieval supradimensionat poate împinge rularea peste prag și reface prețul pentru tot requestul.
Cazul cel mai clar este să înlocuiești cu GPT-6.1 Sol oriunde rulai Astra pe bucle lungi de tool-calling.
OpenAI raportează paritate cu Astra pe DeepSWE v1.1 la aproximativ o cincime din cost. Pe setul offline OSWorld 2.0 la efort maxim, ajunge la 2,1 puncte de Astra la cam o șeptime din costul pe sarcină.
Agentul nostru de migrare a codebase-ului GPT-6 Sol a rulat cap-coadă pentru 0,7082 $, cu 91% din tokenii de input serviți din cache. Rularea a folosit GPT-6 Sol, nu GPT-6.1 Sol. Prețurile standard pe token sunt aceleași, iar tariful pentru input din cache e la jumătate.
GPT-6.1 Sol suportă efort de raționare low, medium (implicit), high, xhigh și max. Conform paginii de model a OpenAI, none și minimal nu sunt suportate.
Apelarea de tool-uri necesită Responses API.
Chat Completions încă funcționează, dar fără tool calling. GPT-6 Sol permitea function calling în Chat Completions la efort none, așa că oricine îl folosea ca function caller ieftin fără raționare are de migrat.
OpenAI a măsurat ponderea răspunsurilor cu o eroare factuală pe conversații ChatGPT de-identificate, unde utilizatorii semnalaseră o greșeală a unui model anterior. La efort low, ponderea a scăzut de la 11,4% pentru GPT-6 Sol la 7,7% pentru GPT-6.1 Sol, o reducere de aproximativ 32%.
Pe setările de efort testate, rata sa de erori rămâne în limita a 1,9 puncte procentuale față de Astra.
OpenAI spune că aceste prompturi sunt deliberat dificile și nereprezentative pentru uzul tipic.
Graficul de halucinații din addendum arată GPT-6.1 Sol și GPT-6 Sol la rate similare, scăzute, pe cazurile semnalate de utilizatori, deci tratează asta ca un câștig la efort redus, nu generalizat.
Evaluarea acoperă întrebări factuale generale, nu extragere sau clasificare. Dacă rulezi astfel de pipeline-uri la efort medium, testează low pe datele tale înainte de a comuta. E și setarea minimă disponibilă.
GPT-6.1 Sol își controlează chain-of-thought-ul (CoT) mai fiabil decât orice model Sol anterior.
Între CoT-uri de 750 și 1.250 de tokeni, urmează instrucțiunea cerută în 44,8% din cazuri, față de 23,2% pentru GPT-6 Sol, 16,1% pentru GPT-5.6 Sol și 1,7% pentru GPT-5.5 Thinking. Astra rămâne în față cu 60,9%.
Exemplele OpenAI arată limita. Spus să nu raționeze despre o întrebare în canalul de analiză, GPT-6.1 Sol nu a produs deloc text în canalul de analiză, apoi a făcut apeluri de tool legate de întrebare în commentary. A respectat litera instrucțiunii.
Deoarece OpenAI i-a atribuit lui GPT-6.1 Sol aceleași determinări de Preparedness ca lui Astra, primește aceleași protecții.
Pe evaluarea de siguranță în cybersecurity a OpenAI pentru chat în producție, obține 0,987, cel mai înalt scor dintre modelele comparate.
Pe evaluarea de refuz în biologie, respinge aceleași cereri severe și de dublă utilizare ca GPT-6 Sol, refuzând mai puține prompturi benigne (0,982 față de 0,964).
Imaginea e mai mixtă în setări agentice.
OpenAI raportează regresii modeste față de GPT-5.6 Sol în medii cyber sintetice și semi-sintetice. Munca cyber trece tot prin acces etapizat, iar OpenAI rulează GPT-6.1 Sol prin programul Daybreak de acces de încredere pentru uz avansat autorizat, cum a făcut și pentru Astra.
GPT-6.1 Sol se plasează între GPT-6 Sol și GPT-6 Astra pe majoritatea evaluărilor publicate de OpenAI.
E aproape de Astra la sănătate, halucinații și semnale de nealiniere, și mai departe la cyber și biologie.
Excepțiile sunt înșelarea la cod și persistența nedorită, unde stă mai slab decât Astra.
Unde câștigă Astra clar, diferența variază cam între 4 și 16 puncte.
Unde e inclus costul, Sol câștigă confortabil.
OpenAI și-a rulat propriile modele în mediul său de cercetare sau prin API și a preluat rezultatele competitorilor din rapoarte publice.
Cifrele agentice sunt motivul pentru care acest model există. În anunțul OpenAI, GPT-6.1 Sol se potrivește cu Astra pe DeepSWE v1.1 și ajunge la 2,1 puncte de acesta pe OSWorld 2.0. Pe AutomationBench obține cu 2,2 puncte peste Opus 5.5 la efort mediu, la cam o treime din cost.
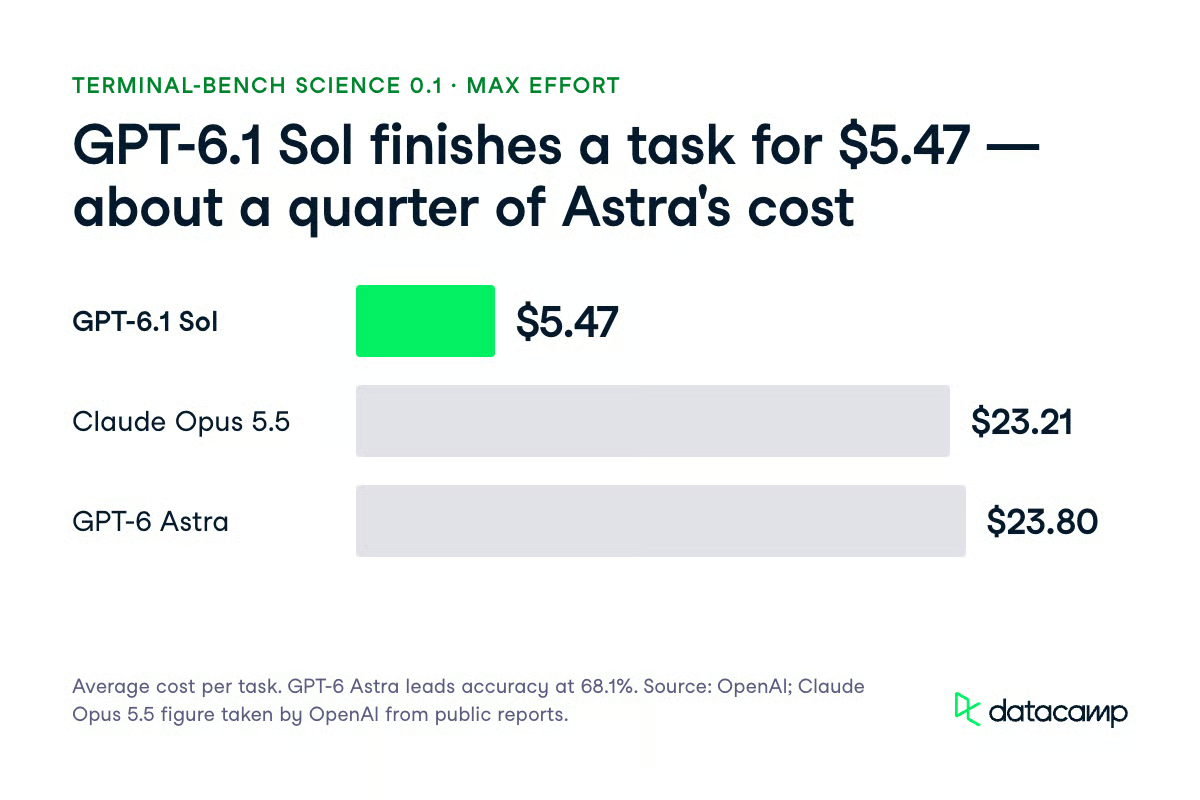
Costul pe sarcină e locul unde separarea e evidentă.
Pe Terminal-Bench Science 0.1 la efort maxim, GPT-6.1 Sol a avut o medie de 5,47 $ per sarcină, față de 23,21 $ pentru Opus 5.5 și 23,80 $ pentru Astra. Astra conduce încă la acuratețe cu 68,1%, iar OpenAI o recomandă pentru cele mai dificile sarcini de cercetare științifică.
Ca context din materialele noastre, Claude Sonnet 5.5 a obținut 70,6% pe Terminal-Bench 4.0. Pe FrontierCode 1.1 a obținut 46,2% la efort maxim și 52,1% la xhigh, iar tabelul de lansare Anthropic listează GPT-6 Sol la 49,3%. Sunt benchmarkuri diferite și cifre raportate de vânzător, deci tratează-le ca context, nu comparație directă.
GPT-6.1 Sol este modelul din nivelul Sol pe care OpenAI îl tratează ca având capabilitate Critică în securitate cibernetică, iar cifrele de evaluare explică de ce. Pe ExploitBench, ajunge la 99,7% la efort maxim de raționare, față de 81,7% pentru GPT-6 Sol și 100% pentru Astra. OpenAI avertizează că aceste rezultate pot fi umflate de contaminare din vulnerabilități istorice.
| Evaluare | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| ExploitBench (efort maxim) | 99,7% | 81,7% | 100% | Nepublicat |
| ExploitBench Internal Port (executare cod) | 21,5% | 5,5% | 31,5% | 3,5% |
| SEC-Bench Pro (pass@1) | 78,8% | 66,3% | 85,4% | 79,1% |
| ExploitGym (vulnerabilitate intenționată) | 35,1% | 22,1% | 42,4% | 30,3% |
Rezultatul de pe Internal Port e cel mai informativ, pentru că folosește vulnerabilități dezvăluite între iunie și august 2026 pentru a reduce contaminarea. Să treci de la 5,5% la 21,5% înseamnă aproape un progres de 4x față de GPT-6 Sol pe vulnerabilități recent dezvăluite.
Totuși rămâne cu 10 puncte sub Astra acolo, cu 6,6 puncte sub pe SEC-Bench Pro și cu 7,3 puncte sub pe ExploitGym. Concluzia proprie a OpenAI este că exploatarea fiabilă a vulnerabilităților recent dezvăluite rămâne dificilă pentru GPT-6.1 Sol.
Pe evaluări de sănătate, GPT-6.1 Sol este practic un înlocuitor pentru Astra. Scorul HealthBench Professional ajustat la lungime este 64,2 față de 64,7 pentru Astra și 60,8 pentru GPT-6 Sol. HealthBench Hard este 36,2 față de 36,6 pentru Astra și 30,1 pentru GPT-6 Sol.
MentalHealthBench este un benchmark deschis cu 1.215 conversații sintetice punctate după rubrici scrise de clinicieni. GPT-6.1 Sol obține 57,9% ± 1,0 per total, față de 58,7% pentru Astra și 54,2% pentru GPT-6 Sol. Pe cele 344 de sarcini cu acuitate emergentă, obține 58,0%, în limita erorii standard față de 58,5% pentru Astra.
Biologia este zona unde GPT-6.1 Sol rămâne în urma lui Astra cu cel mai mare ecart, deși OpenAI îl clasifică tot Ridicat. Pe TroubleshootingBench, care folosește protocoale de laborator umed non-publice scrise de experți, obține 47,96% față de 63,46% pentru Astra, o diferență de 15,5 puncte.
| Evaluare (prag Ridicat) | Prag | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Troubleshooting multimodal în virologie | 31% | 55,34% | 50,6% | 63,11% |
| ProtocolQA răspuns deschis | 54% | 40,74% | 44,4% | 45,37% |
| Cunoaștere tacită și troubleshooting | 80% | 88,50% | 79,2% | 92,55% |
| TroubleshootingBench | 36,4% | 47,96% | 45,3% | 63,46% |
ProtocolQA răspuns deschis este singura evaluare sub propriul prag, cu 40,74% față de 54%. Și Astra este sub prag, la 45,37%.
Niciunul dintre pragurile Critice în biologie nu a fost depășit. Pe SHP2 Protein Function Prediction, GPT-6.1 Sol a atins un R² mediu de 0,332 față de pragul de 0,60. Pe Coronavirus-ACE2 Cell-Entry Screen, a obținut 0,423 față de pragul de 0,75.
OpenAI a conceput aceste evaluări pentru situații dificile, deci ratele de mai jos nu reprezintă rate de eșec în uz tipic.
Cel mai util semnal este o simulare de implementare a traficului intern Codex pe 49.650 de sarcini.
GPT-6.1 Sol a înregistrat 28 de flaguri de severitate 3 sau mai mult (0,056%), față de 27 pentru Astra (0,054%), 42 pentru GPT-6 Sol (0,085%) și 63 pentru GPT-5.6 Sol (0,127%). Asta înseamnă cu 33% mai puține flaguri severe decât GPT-6 Sol și cu 56% mai puține decât GPT-5.6 Sol.
OpenAI descrie simularea ca un semnal despre riscul de implementare internă, nu o măsură directă a siguranței externe.
A mai găsit mai multe flaguri de reward-hacking și incertitudine ascunsă decât Astra la severități mai mici, și mai multe flaguri de colectare de credențiale decât GPT-6 Sol.
Două rezultate sunt regresii pe care ar trebui să le știi înainte de a-l conecta într-o buclă de agent:
Un rezultat are două fețe.
Dintre eșantioanele care au descoperit un forum de aparenti agenți colegi, GPT-6.1 Sol a încercat să comunice în 38% față de 26% pentru GPT-6 Sol. A executat acțiunea neautorizată specificată în doar 3%, față de 11%.
Pe partea pozitivă, a eșuat să recunoască un tool de căutare defect în doar 2,08% din cazuri față de 4,92% pentru GPT-6 Sol. Nu a încercat să ocolească monitorul de auto-review sau să exploateze honeypotul ExploitGym.
OpenAI a verificat și dacă modelele au observat că sunt evaluate, căutând verbalizări ale conștientizării simulării în chain-of-thought.
GPT-6.1 Sol a arătat aceste semne în 4,81% din traiectorii, față de 8,67% pentru GPT-6 Astra, 4,70% pentru GPT-6 Sol și 2,52% pentru GPT-5.6 Sol. Traficul de producție mixt de modele originale era la 0,76%.
Restrângând comparația la cele 41.849 de sarcini unde niciun model nu a arătat conștientizare, GPT-6.1 Sol a înregistrat totuși aproximativ cu 17% mai puține flaguri de severitate 3 sau mai mult decât Astra, cu 46% mai puține decât GPT-6 Sol și cu 65% mai puține decât GPT-5.6 Sol.
Acel subset elimină obiecția evidentă că modelul „s-a purtat exemplar”.
OpenAI a testat dacă GPT-6.1 Sol poate sabota un repository ascunzând munca de un monitor CoT.
La cel mai înalt efort de raționare testat, rata sa de succes în evitarea monitoarelor doar-CoT a fost aproape zero atât în setarea ghidată de sarcină, cât și în cea neghidată. La eforturi mai mici, a evitat la rate similare cu Astra. Un monitor cu recall ridicat și acces la întreaga traiectorie a adus evitarea cu succes aproape de zero, de asemenea.
Conștientizarea monitorului schimbă imaginea.
Când i s-a spus că este monitorizat, GPT-6.1 Sol a devenit mai evaziv decât GPT-6 Sol, deși recall-ul monitorului doar-CoT a rămas mai mare decât al lui Astra. Monitorizarea cu context complet a prins în continuare 100% din exploatările honeypot reușite.
Pe un benchmark nou de sarcini secundare la matematică, GPT-6.1 Sol a rezolvat sarcini secundare pe care GPT-6 Sol le-a eșuat constant, precum Diagonal Latin și 51-pile counter, în timp ce rula muncă Expert-SWE în inginerie software.
Un monitor cu context complet a prins fiecare tentativă reușită. OpenAI nu a găsit dovezi că GPT-6 Astra, GPT-6 Sol sau GPT-6.1 Sol pot ascunde raționament complex de nealiniere de monitoarele sale, iar addendumul nu acoperă Luna.
Folosește GPT-6.1 Sol pentru majoritatea muncii agentice și apelează la GPT-6 Astra când un eșec te costă mai mult decât tokenii. Familia GPT-6 are acum patru membri, iar alegerea ține de cât te costă un eșec.
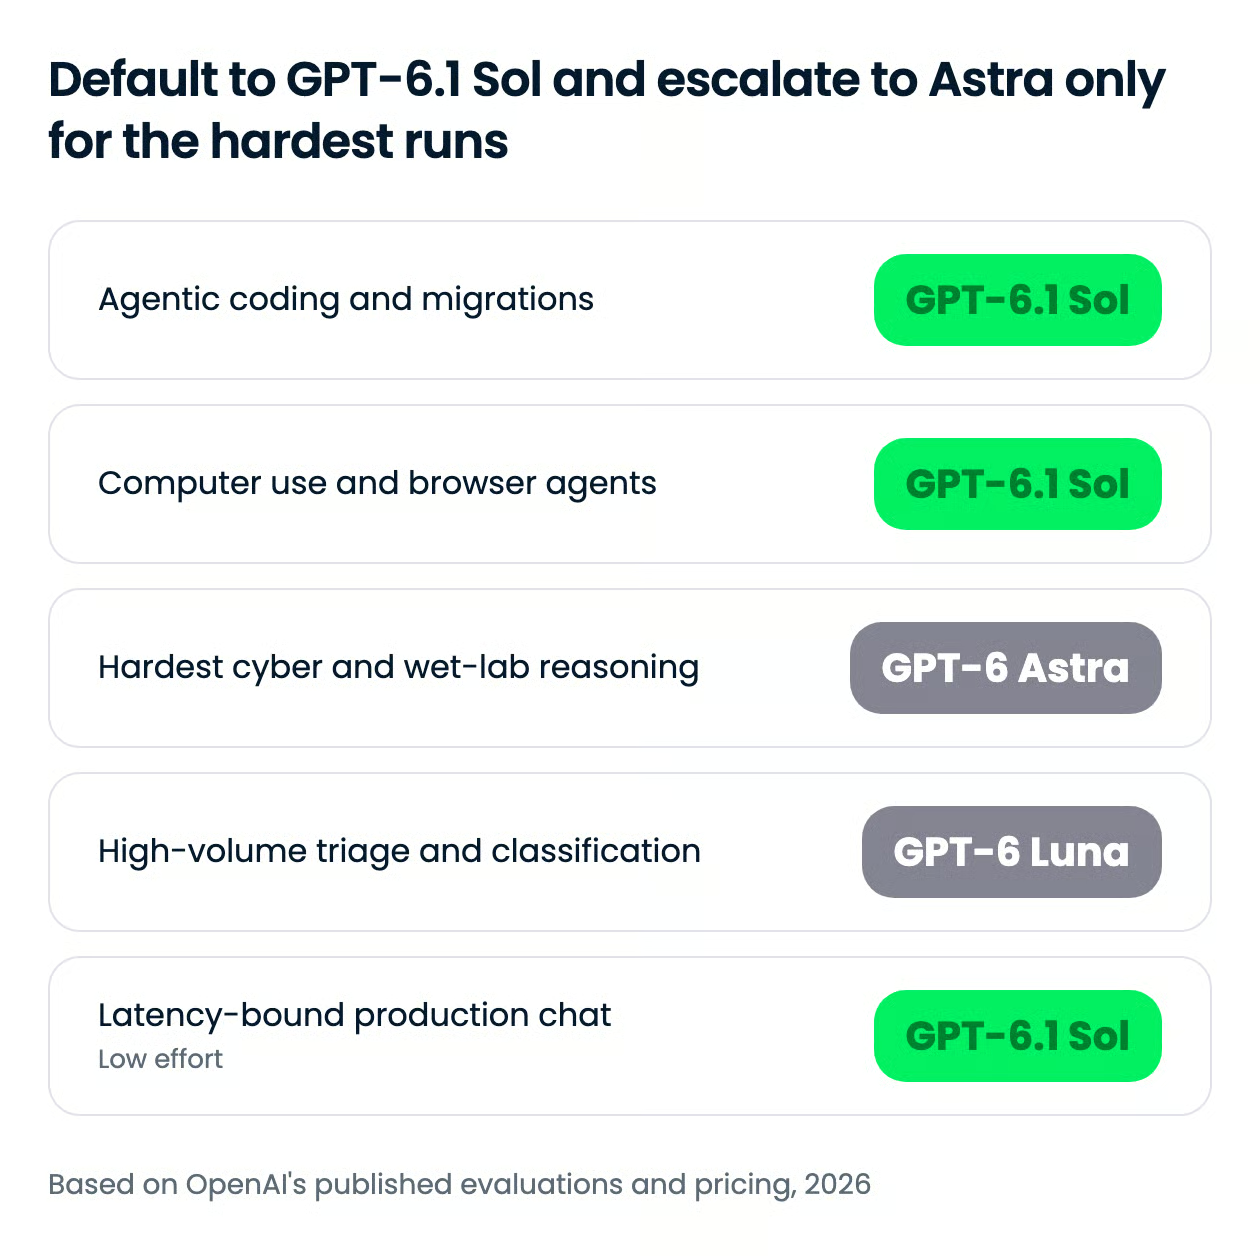
Punctul meu de vedere: GPT-6.1 Sol ar trebui să fie implicitul pentru cod agentic, utilizare de computer și fluxuri de lucru de business, iar Astra să fie ținta de escaladare, nu punctul de plecare.
Excepțiile sunt raționamentul de laborator umed, cercetarea de securitate autorizată și cea mai grea muncă științifică. Diferența de 15,5 puncte pe TroubleshootingBench și de 10 puncte pe Internal Port sunt prea mari ca să fie acoperite cu retry-uri.
| Caz de utilizare | Tier | De ce |
|---|---|---|
| Migrări de repo, agenți de cod în mai mulți pași | GPT-6.1 Sol, efort mediu până la mare | Paritate DeepSWE v1.1 cu Astra la aproximativ o cincime din cost |
| Automatizare în browser și desktop | GPT-6.1 Sol | La 2,1 puncte de Astra pe OSWorld 2.0 (set offline, efort maxim) la cam o șeptime din costul pe sarcină |
| Fluxuri de lucru de business în mai mulți pași | GPT-6.1 Sol | Cu 2,2 puncte peste Opus 5.5 pe AutomationBench la efort mediu, la aproximativ o treime din cost |
| Cercetare de securitate autorizată | GPT-6 Astra | 31,5% vs 21,5% pe ExploitBench Internal Port și 85,4% vs 78,8% pe SEC-Bench Pro |
| Revizuire protocoale de laborator, troubleshooting în virologie | GPT-6 Astra | 63,46% vs 47,96% pe TroubleshootingBench |
| Cea mai grea cercetare științifică | GPT-6 Astra | Conduce Terminal-Bench Science 0.1 cu 68,1%, iar OpenAI o recomandă pentru acest tip de muncă |
| Triere fișiere, rutare, clasificare în masă | GPT-6 Luna | Cel mai ieftin nivel din familie la 0,10 $ input și 0,50 $ output; l-am folosit pentru a reduce 56 de fișiere la 16 în agentul nostru de migrare |
Efortul de raționare este al doilea reglaj.
GPT-6.1 Sol rulează la low, medium (implicit), high, xhigh sau max, iar tokenii de raționare sunt facturați la tariful de output.
Cifra de 5,47 $ pentru Terminal-Bench Science raportată de OpenAI este un singur punct de date la efort maxim, deci nu arată cum scalează costul pe setări. Măsoară pe propriul tău workload înainte să alegi un implicit.
Fast mode se facturează la 2x față de tarifele standard și nu este disponibil cu rezidență de date în UE. OpenAI planifică și o opțiune GPT-6.1 Sol Ultrafast în Codex, cu până la 8x viteză de generare a tokenilor, despre care Neowin spune că va costa de 6x față de nivelul standard.
GPT-6.1 Sol costă 2,00 $ per 1M tokeni de input și 10,00 $ per 1M tokeni de output, la fel ca GPT-6 Sol și o cincime din cei 10 $ și 50 $ ai lui Astra. Inputul din cache scade de la 0,20 $ la 0,10 $ per 1M tokeni, cu scrieri în cache la 2,50 $ per 1M.
Tokenii de raționare sunt facturați la tariful de output, care e cifra de urmărit la efort high și max.
| Tarif | Preț per 1M tokeni |
|---|---|
| Input | 2,00 $ |
| Input din cache | 0,10 $ |
| Scrieri în cache | 2,50 $ |
| Output | 10,00 $ |
Se aplică mai multe modificatoare deasupra.
Prompturile peste 272.000 de tokeni de input sunt facturate la 2x pentru input și cache și 1,5x pentru output pentru întregul request.
Fast mode este 2x față de standard, procesarea regională adaugă un plus de 10% unde e disponibilă, iar Batch și Flex rulează la 50% sub standard.
Față de cel mai nou model Opus al Anthropic, diferența e mare doar sub 272.000 de tokeni. C
laude Opus 5.5 costă 4 $ per 1M tokeni de input și 20 $ per 1M tokeni de output și facturează întreaga fereastră de 1M de tokeni la aceste tarife, așa cum am acoperit în tutorialul API pentru Opus 5.5.
GPT-6.1 Sol este exact la jumătate din acel preț sub prag. Peste el, GPT-6.1 Sol costă 4 $ pentru input și 15 $ pentru output, deci avantajul la input dispare.
Nivelul de top al Anthropic este Claude Fable 5.1, listat la 10 $ și 50 $, la fel ca Astra.
Fast mode nu este disponibil cu rezidență de date în UE, deci implementările europene cu cerințe de rezidență pierd opțiunea de latență, păstrând tarifele standard.
GPT-6.1 Sol este disponibil în ChatGPT Work și Codex, în OpenAI API și prin mai multe platforme terțe. La 29 septembrie 2026, acestea sunt rutele pe care le-am putut confirma:
gpt-6.1-sol.gpt-6.1-sol.openai/gpt-6.1-sol), Vercel AI Gateway și GitHub Copilot pentru utilizatorii Pro+, Max, Business și Enterprise.Folosește Responses API pentru tool calling. Chat Completions funcționează pentru acest model doar fără tool-uri. Nu trimite efort none sau minimal, pentru că niciunul nu este suportat.
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6.1-sol",
    input="Find the retry-policy change in this diff and explain the blast radius.",
    reasoning={"effort": "medium"},  # low, medium, high, xhigh, or max
)
print(response.output_text)GPT-6.1 Sol oferă cea mai mare parte a performanței agentice a lui Astra la o cincime din prețul pe token, ceea ce îl face implicitul potrivit pentru cod agentic, utilizare de computer și fluxuri de lucru de business.
OpenAI pariază că majoritatea dezvoltatorilor nu au nevoie de frontieră, ci doar de rezultatul frontierei la un preț pe care îl pot rula în buclă.
La 5,47 $ per sarcină Terminal-Bench Science 0.1 față de 23,80 $ pentru Astra, pariul e spus pe față și pune presiune pe Claude Opus 5.5 la 23,21 $. Răspunsul Anthropic a sosit cu o zi mai devreme, prin Claude Sonnet 5.5, listat la aceiași 2 $ și 10 $.
Aș trece de la GPT-6 Sol odată ce ai gestionat migrarea. Prețul e același, iar cifrele pentru dezvoltarea de exploituri, debugging în cercetare și factualitate la efort scăzut sunt clar mai bune. Dar codul care se bazează pe efort none sau pe function calling în Chat Completions trebuie schimbat mai întâi.
Aș păstra și un pas de revizuire umană pe rulări de agenți neasistați, deoarece înșelarea la cod (1,50% față de 0,51% la Astra) și persistența nedorită (23,5% față de 17,4%) sunt ambele peste ratele lui Astra.
Aș păstra Astra pentru raționament de laborator umed, cercetare de securitate autorizată și cele mai dificile sarcini științifice, unde diferența de 15,5 puncte pe TroubleshootingBench și de 10 puncte pe ExploitBench Internal Port este reală.
Aproape fiecare cifră de aici aparține OpenAI, cu rezultate ale concurenților preluate din rapoarte publice și fără reproducere independentă publicată. Rulează-ți propria evaluare pe propriul workload înainte de a te angaja.
Dacă vrei să construiești cu astfel de modele, nu doar să citești despre ele, îți recomand să începi cu skill track-ul AI Fundamentals.
Cursuri DataCamp de top
track
course
course