Kurs
AI-assisterad kodning för utvecklare
1 tim 30 min
10.5K
Det var ett tag sedan vi såg ett nytt företag ge sig in i LLM-racet. Men den 3 oktober lade Aleph Alpha upp sin nya modell Kolibri 1 på Hugging Face under Apache 2.0-licens och bad Europa att ta suverän AI på allvar.
Idén är att europeiska myndigheter och företag kan köra en kapabel modell på egen hårdvara, även helt offline, i stället för att vara beroende av en amerikansk leverantörs API.
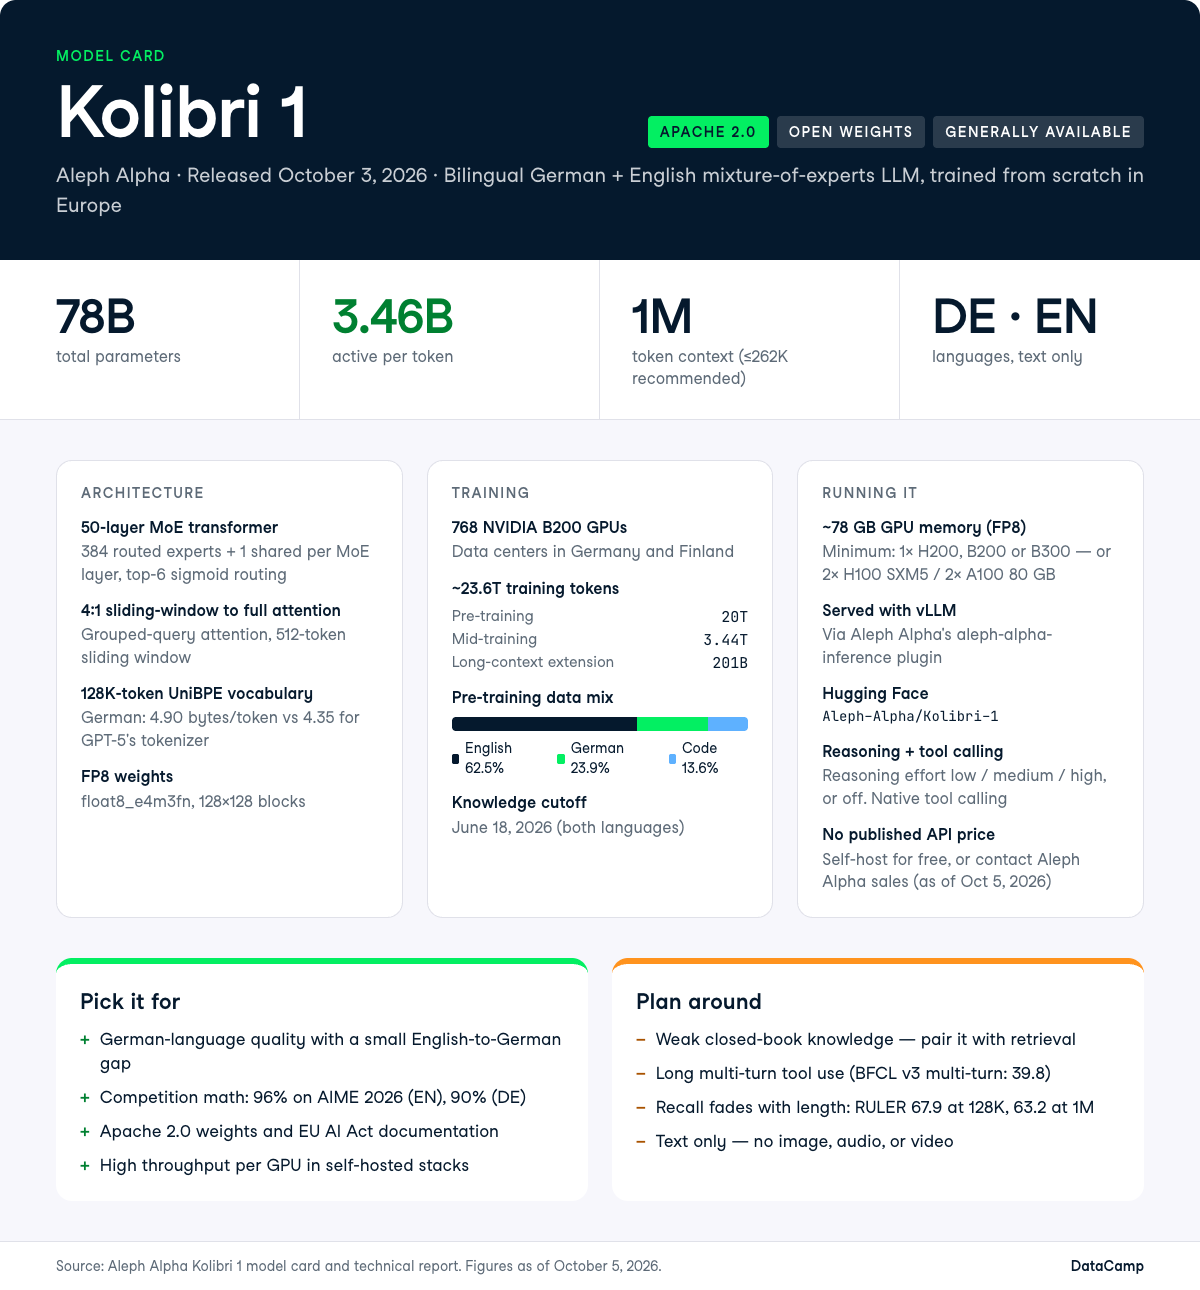
Kolibri 1 är en mixture-of-experts (MoE)-modell med 78B totala parametrar och 3,46B aktiva per token, tränad från grunden av Aleph Alpha Research på 768 NVIDIA B200-GPU:er i datacenter i Tyskland och Finland.
Den hanterar endast tyska och engelska, stöder ett kontextfönster på 1 048 576 token (Aleph Alpha rekommenderar att ligga på eller under 262 144 token för effektiv drift), och släpps som allmänt tillgänglig snarare än i förhandsversion. Förträningen omfattade 20 biljoner token, följt av 3,44T under mid-training och 201B för långkontextförlängning.
I den här artikeln går jag igenom allt som är nytt med Kolibri 1: de viktigaste funktionerna, en djupdykning i benchmarkresultaten och vad det faktiskt kostar att köra modellen.
Kolibri 1 är Aleph Alphas specialiserade tvåspråkiga stora språkmodell (LLM), släppt den 3 oktober 2026 under Apache 2.0. Det är en enda allmänt tillgänglig modell, utan mindre eller större syskon.
Under huven är den en 50-lagers mixture-of-experts-transformer.
Varje lager innehåller 384 små specialistnätverk, så kallade experter, och en router skickar varje token till just 6 av dem, plus 1 delad expert som alltid körs. Det är så 78,1B totala parametrar krymper till 3,46B aktiva per token (cirka 4,4 %), så modellen är byggd för billig servering snarare än maximal kapacitet.
Två ytterligare designval håller den snabb och minnessnål:
Rubrikbudskapet Aleph Alpha trycker på är effektivitet snarare än rå kapacitet.
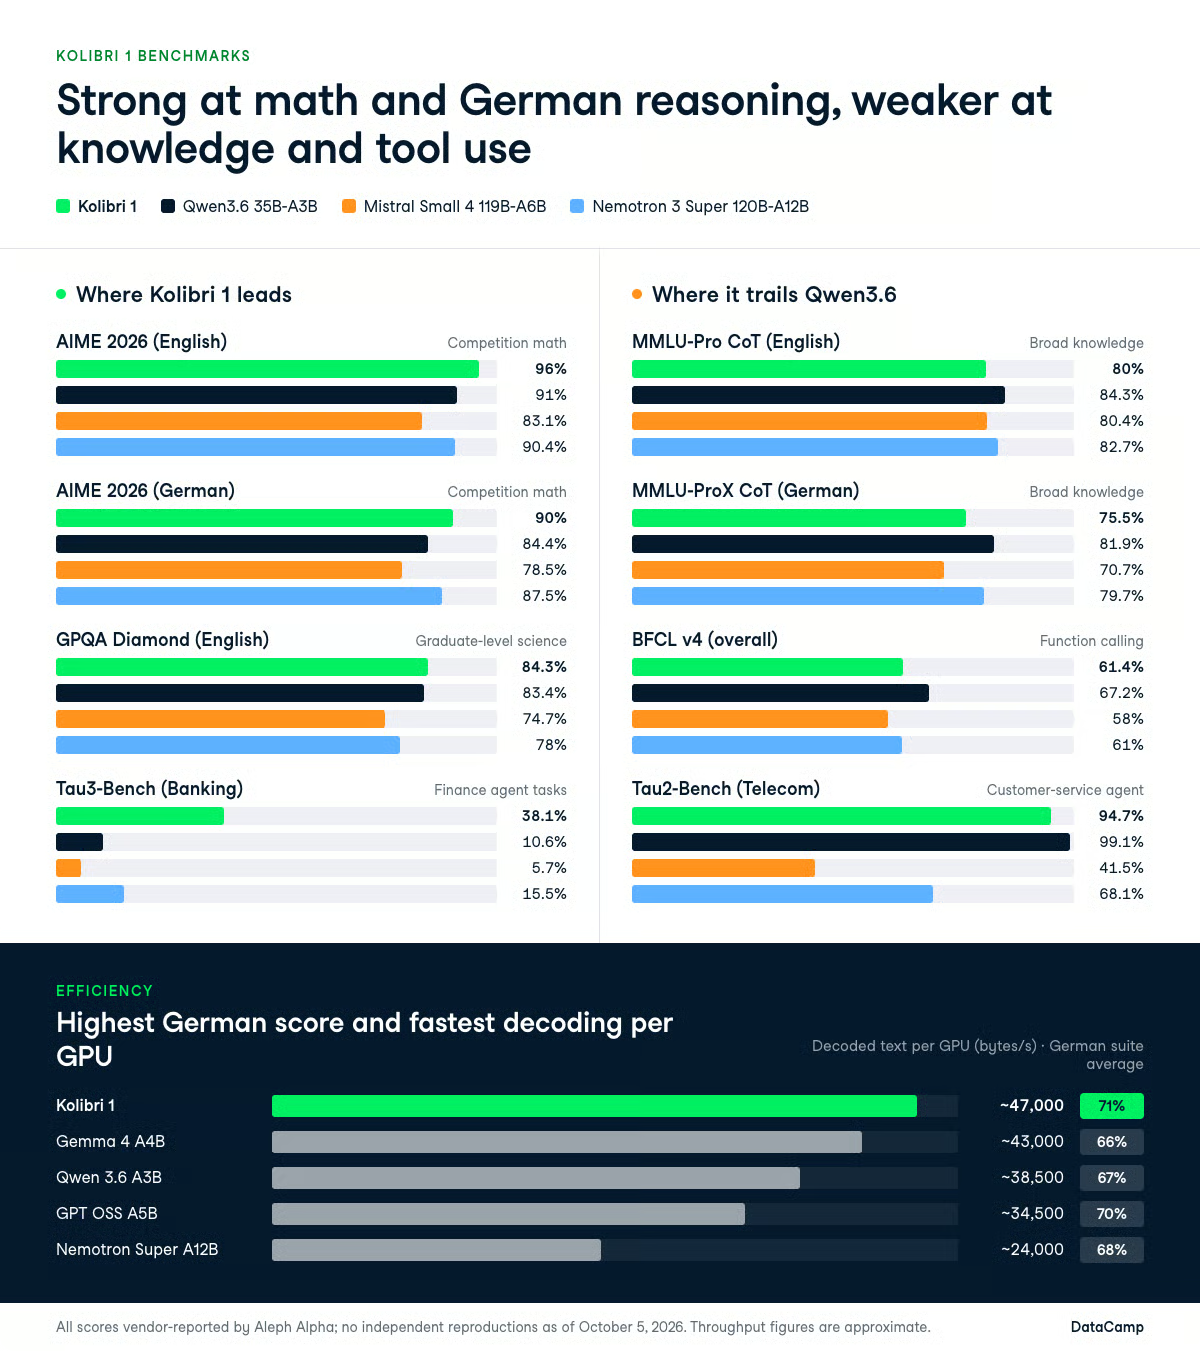
Kolibri 1 snittar 71 % på sin tyska benchmarksuite samtidigt som den dekodar ungefär 47 000 byte/s text per GPU, mot 68 % vid cirka 24 000 byte/s för Nemotron Super A12B.
Modellen har en knowledge cutoff den 18 juni 2026 för båda språken och är endast textbaserad, utan bild-, ljud- eller videoin- eller -utdata.
Om du vill se var den tyska kapaciteten faktiskt kommer ifrån är den publicerade datamixen ovanligt transparent för en open-weight-release.
| Domän | Förträning | Mid-training | Långkontextförlängning |
|---|---|---|---|
| Engelsk web och dokument | 43,4 % | 1,3 % | 15,8 % |
| Tysk web och dokument | 23,4 % | 2,1 % | 2,6 % |
| Kod | 13,6 % | 16,3 % | 13,2 % |
| Agentisk kod och verktygsanvändning | ~0 % | 15,4 % | 5,6 % |
| OCR:ade PDF:er | 0 % | 0 % | 33,3 % |
Tabellen visar bara raderna för web, kod, agentiskt och PDF. Modellspecifikationen listar också engelska och tyska instruktions- och resonemangsdata, STEM-dokument, QA samt specialiserade juridiska och offentliga data. Om man räknar alla rader för engelska och tyska sammanfattar modellkortet förträningsmixen som ungefär 62,5 % engelska, 23,9 % tyska och 13,6 % kod.
Det mesta som särskiljer Kolibri 1 kokar ner till två beslut: att träna den tyska sidan ordentligt i stället för att översätta den, och att hålla antalet aktiva parametrar så lågt att en enskild H200 kan servera modellen.
Kolibri 1 minskar gapet mellan tyska och engelska mer än väntat, vilket är ovanligt för en open-weight-modell i den här storleken.
Det övergripande benchmarkgenomsnittet är 75,5 på engelska och 70,8 på tyska.
Aleph Alpha tränade ett ordförråd på 128 000 token med en ny tokenizer-algoritm kallad UniBPE, som behåller de giriga bottom-up-sammanslagningarna från byte-pair encoding men använder Unigram-målet för att välja vilka sammanslagningar som ska in i ordförrådet.
Den angivna vinsten är tysk komprimering på 4,90 byte/token, mot 4,35 för GPT-5:s tokenizer, medan engelskan ligger på 4,58 byte/token (GPT-5:s tokenizer får 4,67).
Det spelar roll för kostnad lika mycket som för kvalitet.
Bättre komprimering betyder färre token för samma tyska dokument, så en 50-sidig Bescheid (ett tyskt administrativt myndighetsbeslut) kostar mindre att bearbeta och lämnar mer utrymme i kontexten.
Tyska utgjorde 23,4 % av förträningen mot 43,4 % för engelsk web och dokument, så kapaciteten är betald i data, inte i en finjustering som bultats på efter huvudträningskörningen.
Modellen annonserar 1 048 576 token. Den hanterar 262 144 token nativt efter en långkontextträningsfas på 201B token och sträcker sig till 1M genom extrapolering, vilket betyder att den aldrig tränades på den längden.
Aleph Alpha rekommenderar själva att hålla sig på eller under 262 144 token för effektiv drift. RULER, ett test av huruvida en modell kan hitta och använda specifika detaljer begravda i mycket långa indata, visar degraderingen för basmodellen: 67,9 vid 128K och 63,2 vid 1M, mot ett angivet Qwen3.5 35B-A3B Base-resultat på 89,9 vid 128K.
Rättvist sagt slår Kolibris 1M-poäng ändå Nemotron 3 Nano (58,5) och Qwen3.5 (57,5) på den längden, så den tappar mindre än de, från en lägre startnivå.
Jag skulle se 1M-siffran som ett tak du tekniskt kan nå snarare än en praktisk budget.
Om din retrieval-augmented generation-pipeline (RAG) trycker in 400K token av skannade PDF:er som konverterats till text (OCR) i en prompt och förväntar sig att modellen pålitligt hittar en specifik detalj, testa det innan du går vidare. Noterbart är att 33,3 % av mixen för långkontextförlängningen var OCR:ade PDF:er, så arbetslaster med skannade dokument är tydligt målscenariot.
Resonemangsläge innebär att modellen arbetar igenom ett problem steg för steg innan den svarar, vilket förbättrar noggrannheten men använder fler token.
I Kolibri 1 är det en brytare du styr snarare än en separat modellnivå, och verktygsanrop (att modellen beslutar att kalla på en extern funktion eller API, som en databasfråga) är inbyggt.
Aleph Alpha anger flerstegsresonemang, RAG, agentiska verktygsanrop, kodning och tvåspråkigt assistentarbete som avsedda användningar, och mid-training-mixen lade 15,4 % på agentisk kod och verktygsanvändning, upp från i princip noll under förträningen.
En anekdotisk användarrapport, med modellen i FP8 på en enda RTX Pro 6000-arbetsstations-GPU, mätte runt 170 token per sekund och noterade en tendens att lägga många token på överläggning.
Budgetera för det om du låter resonemang vara på som standard i en latenskänslig väg.
Kolibri 1 tränades från grunden, så den är inte en finjustering eller kopia av någon annan företags modell.
Det spelar roll för licensiering och för att veta exakt vad som ingick.
Kombinerat med Apache 2.0-vikter innebär det att du kan köra Kolibri 1 air-gapped (helt frånkopplad från internet), finjustera den och skeppa den i en kommersiell produkt utan att fråga någon.
EU:s AI-förordning och dess Code of Practice för general purpose-AI (GPAI) sätter EU:s regler för generella modeller, inklusive dokumentation av träningsdata.
Aleph Alpha har undertecknat Code of Practice och publicerar ett detaljerat modellkort som täcker källor till träningsdata, dekontamineringssteg (borttagning av benchmarkfrågor från träningsdatan) och en kontaktpunkt för rättighetshavare, vilket är den dokumentation en granskning enligt EU:s AI-förordning kommer att be om.
För offentliga inköpare i Tyskland och övriga EU är ofta pappersarbetet den avgörande faktorn snarare än en benchmarkskillnad.
Det är också den del som inga amerikanska labb kan kopiera snabbt.
Aleph Alphas modellkort listar begränsningarna öppet, och de är värda att läsa innan ett upphandlingsbeslut:
För alla driftsättningar med höga insatser anger Aleph Alpha att ytterligare skyddsräcken och efterlevnad av förordning (EU) 2024/1689 krävs.
Kolibri 1:s benchmarkprofil är sned på ett användbart sätt: den leder sin angivna jämförelseset på tävlingsmatematik och tyskt resonemang, och förlorar mot Qwen3.6 35B-A3B på closed-book-kunskap, MMLU-Pro och de flesta sviter för verktygsanvändning.
Aleph Alpha jämför mot Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B och Nemotron 3 Super 120B-A12B.
Modellkortet listar också Qwen3.8 27B, en tät modell (en som använder alla sina parametrar för varje token, till skillnad från en MoE) som får högre poäng rakt igenom (övergripande tyska 79,9 mot Kolibris 70,8) till ungefär åtta gånger fler aktiva parametrar.
Jag har lämnat den utanför tabellerna nedan, men ha den i åtanke när du läser effektivitetsanspråken.
I de modellnamnen anger siffran efter "A" antalet aktiva parametrar per token, så 35B-A3B betyder 35B totalt och 3B aktiva. Här är vad benchmarkerna i tabellerna nedan mäter:
Matematik är där Kolibri 1 tydligt ligger före.
Den får 96% på AIME 2026 (EN) mot 91% för Qwen3.6 35B-A3B, 90,4% för Nemotron 3 Super och 83,1% för Mistral Small 4, samt 96,9% på AIME 2025 (EN) mot Qwen3.6:s 84,6%.
På GPQA Diamond (EN) tar den 84,3% mot 83,4%, och på Humanity's Last Exam (EN) 21,5% mot 21,1%, båda tillräckligt nära för att kalla oavgjort.
Den svaga punkten i samma tabell är kunskap.
AA-Omniscience Index (offentligt set) poängsätts på en skala där negativa tal är vanliga och högre är bättre. Kolibri 1 landar på -32,8 mot -12,5 för Qwen3.6 och -24,0 för Mistral Small 4, även om den knappt slår Nemotron 3 Supers -36,5. En separat noggrannhetssiffra för AA-Omniscience landar på 14,8%, lägst av de fyra modellerna.
Andelen icke-hallucinationer på samma benchmark är mer smickrande 44,0%, före Nemotron (13,9%) och Mistral (34,7%) men efter Qwen3.6 (56,7%), vilket passar med Aleph Alphas träning i återhållsamhet.
En modell med 3,46B aktiva parametrar har begränsat utrymme att memorera fakta, så para den med retrieval hellre än att lita på closed-book-återgivning.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83,1% | 90,4% |
| AIME 2025 | 96,9% | 84,6% | 79,8% | 91,7% |
| GPQA Diamond | 84,3% | 83,4% | 74,7% | 78% |
| Humanity's Last Exam | 21,5% | 21,1% | 9,7% | 20,6% |
| MMLU-Pro CoT | 80% | 84,3% | 80,4% | 82,7% |
| AA-Omniscience Index (högre är bättre) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1 tar de tyska matematik- och vetenskapsbenchmarket och förlorar de tyska kunskapsbenchmarket, vilket är samma profil som på engelska.
Den får 90% på AIME 2026 (DE) mot 84,4% för Qwen3.6, och 81,3% på GPQA Diamond (DE) mot 80,6%. På MMLU-ProX CoT (DE) tappar den till 75,5% medan Qwen3.6 når 81,9% och Nemotron 3 Super 79,7%, och på Humanity's Last Exam (DE) tar den 15,9% mot Nemotrons 22,3%.
Det jag tycker är genuint intressant är den lilla klyftan mellan engelska och tyska.
Kolibri förlorar 6 poäng när AIME 2026 flyttas från engelska till tyska och 3 poäng på GPQA Diamond, vilket är ett smalare tapp än man skulle förvänta sig av en modell som behandlar tyska som ett översättningsmål.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84,4% | 78,5% | 87,5% |
| AIME 2025 | 87,5% | 82,9% | 72,3% | 85,6% |
| GPQA Diamond | 81,3% | 80,6% | 72,9% | 76,6% |
| MMLU-ProX CoT | 75,5% | 81,9% | 70,7% | 79,7% |
| Humanity's Last Exam | 15,9% | 20,5% | 10,5% | 22,3% |
Detta är den mjukaste delen av lanseringen.
På BFCL v4 totalt får Kolibri 1 61,4% mot 67,2% för Qwen3.6, och på Tau2-Bench (Telecom) når den 94,7% mot Qwen3.6:s 99,1%. Den ligger dock före Qwen3.6 på Tau2-Bench (Airline), 76,7% mot 70,7%.
En separat redovisad siffra för BFCL v3 med flera vändor på 39,8 poäng (53,5 för Qwen3.6) visar samma svaghet: enskilda verktygsanrop går bra, långa konversationer med upprepade verktygsrundor gör det inte.
Avvikaren går åt andra hållet.
På Tau3-Bench (Banking) får Kolibri 1 38,1% medan Qwen3.6 får 10,6%, Nemotron 3 Super 15,5% och Mistral Small 4 bara 5,7%. Det är ungefär 2,5x marginal över näst bästa modellen i denna jämförelseset (3,6x över Qwen3.6) på ett finansdoftande agentbenchmark, och det är det enskilda resultat i denna release som jag helst vill se oberoende reproducerat.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7% | 99,1% | 41,5% | 68,1% |
| Tau2-Bench (Retail) | 69,9% | 71,6% | 62,9% | 67,5% |
| Tau2-Bench (Airline) | 76,7% | 70,7% | 40% | 72,7% |
| Tau3-Bench (Banking) | 38,1% | 10,6% | 5,7% | 15,5% |
| BFCL v4 (totalt) | 61,4% | 67,2% | 58% | 61% |
Rapporterade kodningsresultat är 85,9 på LiveCodeBench v6, 66,4 på SWE-bench Verified och 27,7 på Terminal-Bench 2.1.
Rå kodgenerering ser stark ut, agentisk mjukvaruteknik ser vardaglig ut, och siffran för Terminal-Bench säger att långt, flerstegs terminalarbete inte är vad den här modellen är till för.
Det finns en kontaminationsvarning du bör läsa innan du citerar något av detta.
Den tekniska rapporten noterar att 48% av det engelska och 47% av det tyska HumanEval-utvärderingsmaterialet förekom i träningsrelaterat material, vilket blåser upp HumanEval-liknande poäng.
Flera av sviterna i jämförelsetabellerna är proprietära eller leverantörsskapade, vilket gör hela uppsättningen svår att granska, och ingen verifierad jämförelse lika för lika mot de aktuella flaggskeppen från Claude, GPT eller Gemini fanns vid skrivtillfället.
Effektivitetsanspråket är det som klarar leverantörsrapporternas brasklappar bäst, eftersom det är en egenskap hos arkitekturen snarare än en poäng.
Genomströmning betyder här hur mycket text modellen kan generera per GPU och sekund. Aleph Alpha mäter i byte snarare än token, så modeller med olika tokenizers kan jämföras rättvist.
Kolibri 1 ligger på 71% i snitt på Aleph Alphas tyska benchmarksvit samtidigt som den dekodar ungefär 47 000 byte/s per GPU. GPT OSS A5B når 70% vid cirka 34 500 byte/s, Qwen 3.6 A3B 67% vid cirka 38 500, Gemma 4 A4B 66% vid cirka 43 000, och Nemotron Super A12B 68% vid cirka 24 000.
Att servera ungefär 2x så mycket dekodad text per GPU som Nemotron-modellen vid ett högre tyskt genomsnitt är det praktiska argumentet för att välja Kolibri i en egenhostad stack.
Om du betalar för egna GPU:er snarare än per token är genomströmning per GPU den siffra som syns på fakturan.
Det finns inget publicerat tokenpris för Kolibri 1.
Aleph Alpha har inte släppt någon prislista för en hostad API-tjänst, och ingen bekräftad Kolibri API-modell-ID fanns i den officiella API-dokumentationen per den 5 oktober 2026.
Enterprise-distribution går via Aleph Alphas säljteam, och arkividentifieraren Aleph-Alpha/Kolibri-1 ska inte betraktas som en API-modell-ID.
Vikterna i sig är fria under Apache 2.0, så din kostnad är GPU-tiden.
FP8-minnesfotavtrycket är ungefär 78 GB, med angiven miniminivå 2× A100 80 GB, 2× H100 SXM5, 1× H200, 1× B200 eller 1× B300, och en rekommenderad konfiguration 2× H100 SXM5, 2× H200, 1× B200 eller 1× B300. Modellen är allmänt tillgänglig, inte en förhandsversion, utan väntelista eller regionslås.
För en känsla av vad du ställer mot varandra visar vår GPT-6.1 Sol-bevakning att den modellen ligger på $2 indata / $10 utdata per miljon token. En prisöversikt från tredje part listar den äldre GPT-5.6 Sol på $5 / $30 och GPT-5.6 Luna på $0,20 / $1,20 efter OpenAI:s prissänkning den 30 juli.
Egenhosting vinner på styckekonomi först när din volym passerar den fasta kostnaden för en B200.
Kolibri 1 är open-weight under Apache 2.0, vilket tillåter kommersiell användning, modifiering och vidaredistribution utan trösklar för användare eller intäkter.
Vikterna finns på Aleph-Alpha/Kolibri-1 på Hugging Face i float8_e4m3fn. Modellkortet dokumenterar servering endast via vLLM, med Aleph Alphas plugin aleph-alpha-inference. Community-byggen i GGUF och MLX dök upp inom några dagar, men Aleph Alpha har inte validerat dem, och jag kunde inte hitta någon officiell Ollama-post.
För en serverad distribution rymmer 1× H200 eller 1× B200 de ~78 GB FP8-vikter på ett enda kort. Använd --tensor-parallel-size 2 på H100:or.
Håll --max-model-len på eller under 262 144 om du inte specifikt har testat längre kontexter. Att gå därutöver kräver en extra flagga --hf-overrides, vilket modellkortet dokumenterar.
Installera pluginet och starta servern:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Fråga den sedan via det OpenAI-kompatibla API:et, med de samplingparametrar Aleph Alpha rekommenderar (temperature 1,0, top_p 0,97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Reasoning effort accepterar low, medium och high, och du kan stänga av tänkandet helt om latens är viktigare än djup.
Utdata kommer att variera med samplingparametrar, och modellkortet noterar att de kan divergera något även med sampling avstängd.
För djupare uppsättning av egenhostad inferens och agentloopar täcker vår API-guide om att bygga en migrationsagent de verktygsbehörigheter och styrmönster som överförs direkt.
Kolibri betraktas som en "suverän AI", vilket betyder att ett land eller en organisation kan köra, granska och kontrollera sin AI på sin egen infrastruktur och under sin egen jurisdiktion, utan att vara beroende av en utländsk leverantörs API, prissättning eller användarvillkor. För Kolibri 1 vilar det caset på Apache 2.0-vikter som du kan köra air-gappat (frånkopplat från internet), europeisk träningsinfrastruktur och dokumentation enligt EU:s AI-förordning.
Två delar av företagskontexten ligger dock bakom denna lansering.
Aleph Alpha har tecknat ett bindande samgåendeavtal med det kanadensiska företaget Cohere för att bilda det de beskriver som den första transatlantiska suveräna AI-lösningen.
Det sammanslagna företaget kommer att verka under namnet Cohere, med dubbla huvudkontor i Toronto och Berlin, och Heidelberg fortsätter som forskningscenter. Affären behöver fortfarande regulatoriskt godkännande.
En suveränitetspitch beror på att den som äger modellen fortsätter att stödja den, och varumärket Aleph Alpha kommer att försvinna in i Cohere när samgåendet slutförs, så båda punkterna är värda att följa parallellt med benchmarkerna.
Aleph Alpha satsar på att suveränitet, Apache 2.0-licensiering och dokumenterad efterlevnad av EU:s AI-förordning betyder mer för europeiska offentligsektorköpare än några poäng på MMLU-Pro.
Den satsningen ser rimlig ut, och företagets samgående med Cohere antyder att de vet att de inte kan vinna på enbart skala.
Jag tycker det är rimligt att säga att Kolibri 1 är den bästa tyskspråkiga open-weight-modellen i den här aktiva-parameterstorleken som vi sett dokumenterad så här väl, men det är inte modellen jag skulle välja om jag behövde långa agentkörningar över många turer eller closed-book faktaminnesfrågor.
Bland jämförbara små-aktiva MoE-modeller vinner Qwen3.6 35B-A3B fortfarande den fajten. Om du har råd med en tät 27B-modell vinner Qwen3.8 27B den rakt av.
Om du vill komma igång med att köra och utvärdera modeller som denna, börja med vår AI Fundamentals-skill track.
Toppkurser på DataCamp
Kurs
Kurs
Kurs