Kursus
Pengembangan Kode dengan Bantuan AI untuk Developer
1 jam 30 menit
10.5K
Sudah cukup lama sejak kita melihat perusahaan baru masuk ke persaingan LLM. Namun pada 3 Oktober, Aleph Alpha merilis model barunya, Kolibri 1, di Hugging Face dengan lisensi Apache 2.0 dan mengajak Eropa untuk menanggapi AI berdaulat dengan serius.
Gagasannya adalah pemerintah dan perusahaan di Eropa dapat menjalankan model andal di perangkat keras mereka sendiri, bahkan sepenuhnya offline, alih-alih bergantung pada API penyedia AS.
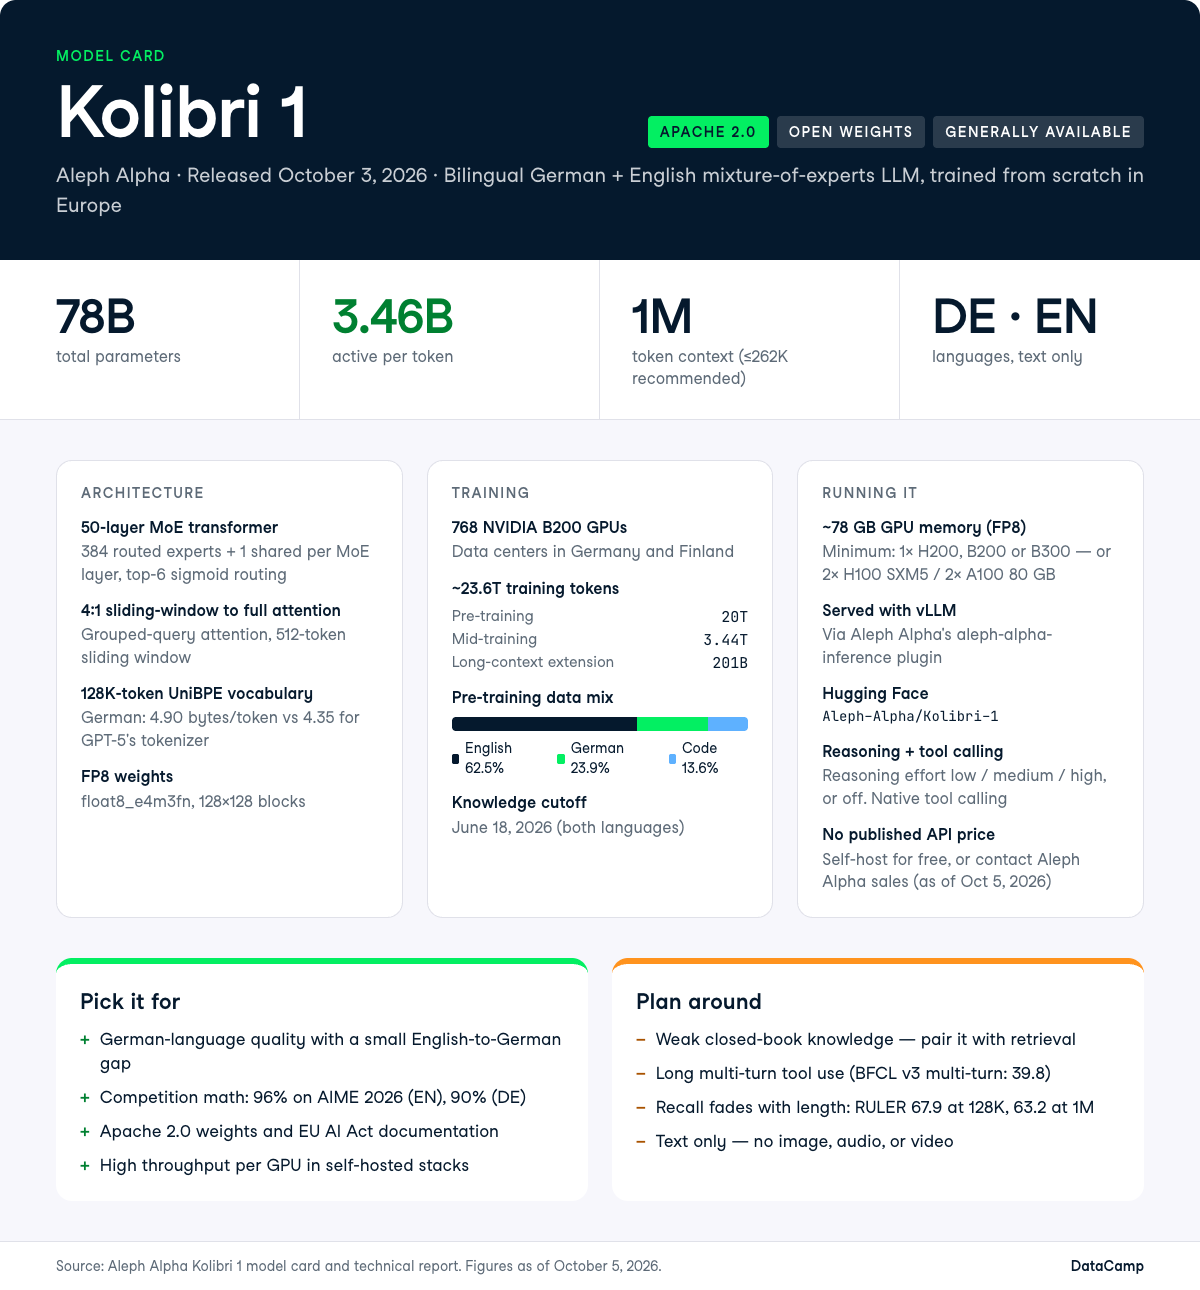
Kolibri 1 adalah model mixture-of-experts (MoE) dengan total 78B parameter dan 3,46B parameter aktif per token, dilatih dari nol oleh Aleph Alpha Research pada 768 GPU NVIDIA B200 di pusat data di Jerman dan Finlandia.
Model ini hanya menangani bahasa Jerman dan Inggris, mendukung jendela konteks 1.048.576 token (Aleph Alpha merekomendasikan tetap di 262.144 token atau kurang demi efisiensi penyajian), dan dirilis sebagai umumnya tersedia, bukan pratinjau. Pra-pelatihan mencakup 20 triliun token, diikuti 3,44T pada tahap mid-training dan 201B untuk perpanjangan konteks panjang.
Dalam artikel ini, saya membahas semua yang baru dari Kolibri 1, menyoroti fitur utama, menelusuri tolok ukur, dan mengulas biaya nyata untuk menjalankannya.
Kolibri 1 adalah model bahasa besar (LLM) dwibahasa khusus dari Aleph Alpha, dirilis pada 3 Oktober 2026 di bawah lisensi Apache 2.0. Ini adalah satu model yang umumnya tersedia, tanpa versi lebih kecil atau lebih besar.
Di balik layar, ini adalah transformer mixture-of-experts 50 lapis.
Setiap lapisan memiliki 384 sub-jaringan spesialis kecil yang disebut expert, dan sebuah router mengirim setiap token hanya ke 6 di antaranya, ditambah 1 expert bersama yang selalu berjalan. Itulah cara 78,1B total parameter menyusut menjadi 3,46B aktif per token (sekitar 4,4%), sehingga model ini dibangun untuk efisiensi penyajian alih-alih kapasitas maksimum.
Dua pilihan desain lainnya membuatnya tetap cepat dan hemat memori:
Hasil utama yang disorot Aleph Alpha adalah efisiensi, bukan kemampuan mentah.
Kolibri 1 rata-rata meraih 71% pada rangkaian tolok ukur bahasa Jermannya sambil mendekode sekitar 47.000 byte/detik teks per GPU, dibanding 68% pada sekitar 24.000 byte/detik untuk Nemotron Super A12B.
Model ini memiliki batas pengetahuan 18 Juni 2026 untuk kedua bahasa, dan hanya teks, tanpa masukan atau keluaran gambar, audio, atau video.
Jika Anda ingin melihat dari mana kemampuan bahasa Jerman itu berasal, campuran data yang dipublikasikan terbilang tidak biasa transparannya untuk rilis open-weight.
| Domain | Pra-pelatihan | Mid-training | Perpanjangan konteks panjang |
|---|---|---|---|
| Web dan dokumen bahasa Inggris | 43,4% | 1,3% | 15,8% |
| Web dan dokumen bahasa Jerman | 23,4% | 2,1% | 2,6% |
| Kode | 13,6% | 16,3% | 13,2% |
| Kode agentic dan penggunaan alat | ~0% | 15,4% | 5,6% |
| PDF hasil OCR | 0% | 0% | 33,3% |
Tabel hanya menampilkan baris web, kode, agentic, dan PDF. Kartu model juga mencantumkan data instruksi dan penalaran dalam bahasa Inggris dan Jerman, dokumen STEM, QA, serta data hukum dan sektor publik yang khusus. Jika menjumlahkan semua baris bahasa Inggris dan Jerman, kartu model merangkum campuran pra-pelatihan sekitar 62,5% Inggris, 23,9% Jerman, dan 13,6% kode.
Kebanyakan hal yang membedakan Kolibri 1 bermuara pada dua keputusan: melatih sisi bahasa Jerman dengan benar alih-alih menerjemahkannya, dan menjaga jumlah parameter aktif cukup rendah agar satu H200 dapat melayaninya.
Kolibri 1 memperkecil jarak antara bahasa Jerman dan Inggris lebih dari yang Anda perkirakan, yang tidak lazim untuk model open-weight sebesar ini.
Rata-rata tolok ukurnya adalah 75,5 dalam bahasa Inggris dan 70,8 dalam bahasa Jerman.
Aleph Alpha melatih kosakata 128.000 token dengan algoritma tokenizer baru bernama UniBPE, yang mempertahankan penggabungan greedy bottom-up dari byte-pair encoding namun menggunakan objektif Unigram untuk memilih penggabungan mana yang masuk kosakata.
Hasil yang diklaim adalah kompresi bahasa Jerman sebesar 4,90 byte/token, dibanding 4,35 untuk tokenizer GPT-5, dengan bahasa Inggris tetap di 4,58 byte/token (tokenizer GPT-5 meraih 4,67).
Itu berdampak pada biaya sama besarnya dengan kualitas.
Kompresi yang lebih baik berarti lebih sedikit token untuk dokumen berbahasa Jerman yang sama, sehingga sebuah Bescheid 50 halaman (surat pemberitahuan administratif resmi dalam bahasa Jerman) lebih murah diproses dan menyisakan lebih banyak ruang dalam konteks.
Bahasa Jerman mencakup 23,4% dari campuran pra-pelatihan dibanding 43,4% untuk web dan dokumen bahasa Inggris, sehingga kemampuannya dibayar dengan data, bukan hasil fine-tune yang ditempel setelah pelatihan utama.
Model ini mengiklankan 1.048.576 token. Model ini menangani 262.144 token secara native setelah tahap pelatihan konteks panjang 201B token, dan melar ke 1M melalui ekstrapolasi, artinya tidak pernah dilatih pada panjang tersebut.
Aleph Alpha sendiri merekomendasikan tetap di 262.144 token atau kurang demi efisiensi penyajian. RULER, sebuah uji apakah model dapat menemukan dan menggunakan detail spesifik yang tersembunyi dalam masukan sangat panjang, menunjukkan degradasi untuk model dasar: 67,9 pada 128K dan 63,2 pada 1M, dibanding hasil Qwen3.5 35B-A3B Base yang dikutip sebesar 89,9 pada 128K.
Sebagai catatan adil, skor 1M Kolibri masih mengungguli Nemotron 3 Nano (58,5) dan Qwen3.5 (57,5) pada panjang tersebut, sehingga penurunannya lebih kecil meski dari titik awal yang lebih rendah.
Saya akan memperlakukan angka 1M sebagai plafon yang secara teknis dapat dicapai, bukan anggaran kerja.
Jika retrieval-augmented generation (RAG) Anda memasukkan 400K token PDF hasil pindai yang dikonversi ke teks (OCR) ke dalam prompt dan mengharapkan model secara andal menemukan satu detail spesifik, uji dulu sebelum berkomitmen. Perlu dicatat, 33,3% dari campuran perpanjangan konteks panjang adalah PDF hasil OCR, sehingga beban kerja dokumen hasil pindai jelas menjadi kasus penggunaan yang ditargetkan.
Mode penalaran berarti model mengurai masalah langkah demi langkah sebelum menjawab, yang meningkatkan akurasi namun menggunakan lebih banyak token.
Di Kolibri 1, ini adalah sebuah sakelar yang Anda kendalikan, bukan tingkatan model terpisah, dan pemanggilan alat (model memutuskan memanggil fungsi atau API eksternal, seperti pencarian basis data) bersifat native.
Aleph Alpha mencantumkan penalaran multi-langkah, RAG, pemanggilan alat agentic, pemrograman, dan asisten dwibahasa sebagai penggunaan yang ditujukan, dan campuran mid-training menempatkan 15,4% pada kode agentic dan penggunaan alat, naik dari nyaris nol saat pra-pelatihan.
Satu laporan pengguna anekdotal, menjalankan model dalam FP8 pada satu GPU workstation RTX Pro 6000, mengukur sekitar 170 token per detik dan mencatat kecenderungan menghabiskan banyak token untuk mempertimbangkan.
Anggarkan untuk itu jika Anda membiarkan penalaran aktif secara bawaan pada jalur yang sensitif terhadap latensi.
Kolibri 1 dilatih dari nol, sehingga bukan fine-tune atau salinan model perusahaan lain.
Itu penting untuk perizinan dan untuk mengetahui persis apa yang masuk ke dalamnya.
Dikombinasikan dengan bobot Apache 2.0, ini berarti Anda dapat menjalankan Kolibri 1 secara air-gapped (sepenuhnya terputus dari internet), melakukan fine-tune, dan mengirimkannya di dalam produk komersial tanpa meminta izin siapa pun.
EU AI Act dan Kode Praktik General-Purpose AI (GPAI) menetapkan aturan UE untuk model tujuan umum, termasuk dokumentasi data pelatihan.
Aleph Alpha menjadi penandatangan Kode Praktik dan menerbitkan kartu model terperinci yang mencakup sumber data pelatihan, langkah dekontaminasi (menghapus soal tolok ukur dari data pelatihan), dan titik kontak bagi pemegang hak, yang merupakan dokumentasi yang akan diminta dalam peninjauan kepatuhan EU AI Act.
Bagi pembeli sektor publik di Jerman dan UE yang lebih luas, dokumen itu sering kali menjadi faktor penentu alih-alih selisih tolok ukur.
Ini juga bagian yang tidak bisa ditiru cepat oleh laboratorium AS.
Kartu model Aleph Alpha menyebutkan keterbatasan secara terbuka, dan layak dibaca sebelum keputusan pengadaan:
Untuk penerapan berisiko tinggi, Aleph Alpha menyatakan bahwa pagar pembatas tambahan dan kepatuhan terhadap Regulasi (UE) 2024/1689 diperlukan.
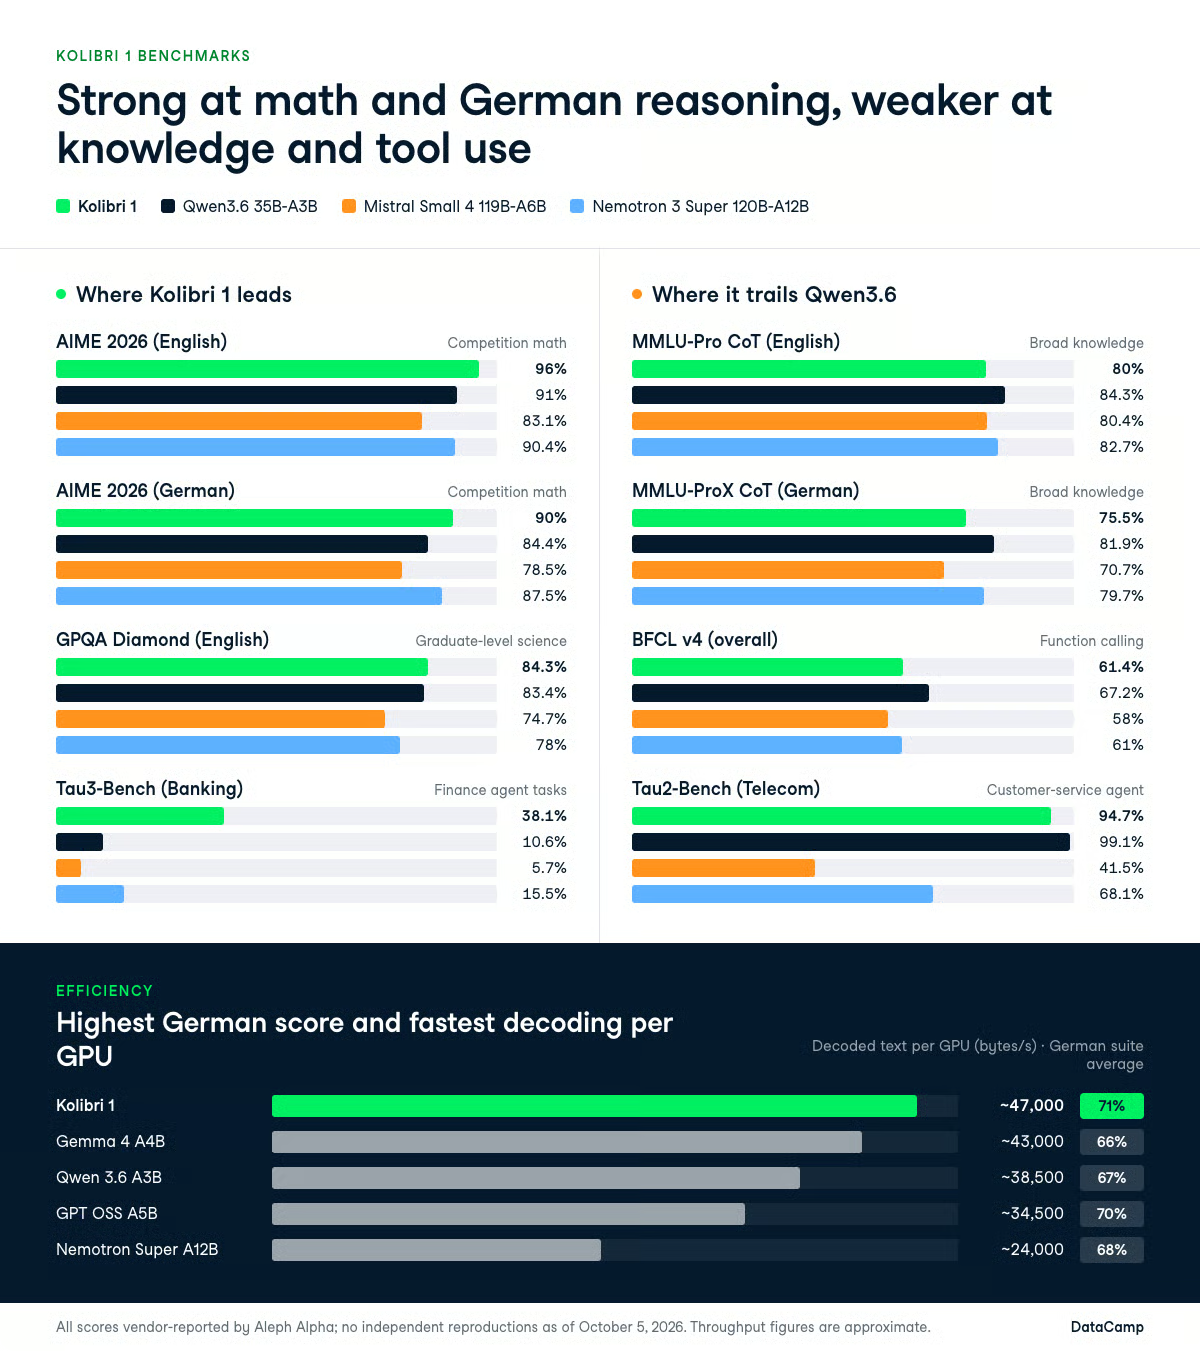
Profil tolok ukur Kolibri 1 timpang dengan cara yang berguna: model ini memimpin set pembanding yang disebutkan pada matematika kompetisi dan penalaran bahasa Jerman, dan kalah dari Qwen3.6 35B-A3B pada pengetahuan closed-book, MMLU-Pro, dan sebagian besar rangkaian penggunaan alat.
Aleph Alpha membandingkan melawan Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B, dan Nemotron 3 Super 120B-A12B.
Kartu model juga mencantumkan Qwen3.8 27B, model dense (yang menggunakan semua parameternya untuk setiap token, tidak seperti MoE) yang mencetak lebih tinggi di seluruh aspek (bahasa Jerman keseluruhan 79,9 dibanding 70,8 milik Kolibri) dengan kira-kira delapan kali parameter aktif.
Saya tidak memasukkannya dalam tabel di bawah, tetapi ingat hal itu saat membaca klaim efisiensi.
Dalam nama-nama model tersebut, angka setelah "A" adalah parameter aktif per token, jadi 35B-A3B berarti total 35B dan 3B aktif. Berikut apa yang diukur oleh tolok ukur dalam tabel di bawah ini:
Matematika adalah area di mana Kolibri 1 jelas unggul.
Skornya 96% pada AIME 2026 (EN) dibandingkan 91% untuk Qwen3.6 35B-A3B, 90,4% untuk Nemotron 3 Super, dan 83,1% untuk Mistral Small 4, serta 96,9% pada AIME 2025 (EN) dibandingkan 84,6% milik Qwen3.6.
Pada GPQA Diamond (EN) skornya 84,3% versus 83,4%, dan pada Humanity's Last Exam (EN) 21,5% versus 21,1%, keduanya cukup dekat untuk disebut seri.
Titik lemah pada tabel yang sama adalah pengetahuan.
AA-Omniscience Index (set publik) dinilai pada skala di mana angka negatif lazim dan makin tinggi makin baik. Kolibri 1 mencatat -32,8 dibanding -12,5 untuk Qwen3.6 dan -24,0 untuk Mistral Small 4, meski unggul tipis atas -36,5 milik Nemotron 3 Super. Angka akurasi AA-Omniscience terpisah berada di 14,8%, terendah dari keempat model.
Tingkat non-halusinasi pada tolok ukur yang sama lebih menggembirakan yakni 44,0%, di depan Nemotron (13,9%) dan Mistral (34,7%) namun di belakang Qwen3.6 (56,7%), yang sejalan dengan pelatihan abstain Aleph Alpha.
Model dengan 3,46B parameter aktif memiliki ruang terbatas untuk menghafal fakta, jadi pasangkan dengan retrieval alih-alih mengandalkan recall buku tertutup.
| Benchmark (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83,1% | 90,4% |
| AIME 2025 | 96,9% | 84,6% | 79,8% | 91,7% |
| GPQA Diamond | 84,3% | 83,4% | 74,7% | 78% |
| Humanity's Last Exam | 21,5% | 21,1% | 9,7% | 20,6% |
| MMLU-Pro CoT | 80% | 84,3% | 80,4% | 82,7% |
| AA-Omniscience Index (lebih tinggi lebih baik) | -32,8 | -12,5 | -24,0 | -36,5 |
Kolibri 1 unggul pada tolok ukur matematika dan sains berbahasa Jerman dan kalah pada tolok ukur pengetahuan berbahasa Jerman, yang polanya sama dengan profil bahasa Inggrisnya.
Skornya 90% pada AIME 2026 (DE) dibanding 84,4% untuk Qwen3.6, dan 81,3% pada GPQA Diamond (DE) dibanding 80,6%. Pada MMLU-ProX CoT (DE) nilainya turun ke 75,5% sementara Qwen3.6 mencapai 81,9% dan Nemotron 3 Super 79,7%, dan pada Humanity's Last Exam (DE) skornya 15,9% dibanding 22,3% milik Nemotron.
Yang menurut saya menarik secara nyata adalah selisih Inggris-ke-Jerman yang kecil.
Kolibri kehilangan 6 poin saat berpindah dari AIME 2026 bahasa Inggris ke bahasa Jerman dan 3 poin pada GPQA Diamond, yang merupakan penurunan lebih sempit daripada yang Anda harapkan dari model yang memperlakukan bahasa Jerman sebagai target terjemahan.
| Benchmark (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84,4% | 78,5% | 87,5% |
| AIME 2025 | 87,5% | 82,9% | 72,3% | 85,6% |
| GPQA Diamond | 81,3% | 80,6% | 72,9% | 76,6% |
| MMLU-ProX CoT | 75,5% | 81,9% | 70,7% | 79,7% |
| Humanity's Last Exam | 15,9% | 20,5% | 10,5% | 22,3% |
Ini adalah bagian yang paling lemah dari rilis ini.
Pada BFCL v4 secara keseluruhan, Kolibri 1 mencatat 61,4% dibanding 67,2% untuk Qwen3.6, dan pada Tau2-Bench (Telecom) skornya 94,7% dibanding 99,1% milik Qwen3.6. Ia unggul tipis atas Qwen3.6 pada Tau2-Bench (Airline), 76,7% versus 70,7%.
Angka multi-turn BFCL v3 yang dilaporkan terpisah sebesar 39,8 poin (53,5 untuk Qwen3.6) menunjukkan kelemahan yang sama: panggilan alat tunggal baik-baik saja, percakapan panjang dengan perjalanan bolak-balik alat berulang tidak.
Pengecualian bergerak ke arah sebaliknya.
Pada Tau3-Bench (Banking), Kolibri 1 mencetak 38,1% sementara Qwen3.6 mendapat 10,6%, Nemotron 3 Super 15,5%, dan Mistral Small 4 hanya 5,7%. Itu kira-kira margin 2,5x atas model terbaik berikutnya dalam set perbandingan ini (3,6x atas Qwen3.6) pada tolok ukur agen bernuansa finansial, dan ini adalah satu hasil dalam rilis ini yang paling ingin saya lihat direproduksi secara independen.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94,7% | 99,1% | 41,5% | 68,1% |
| Tau2-Bench (Retail) | 69,9% | 71,6% | 62,9% | 67,5% |
| Tau2-Bench (Airline) | 76,7% | 70,7% | 40% | 72,7% |
| Tau3-Bench (Banking) | 38,1% | 10,6% | 5,7% | 15,5% |
| BFCL v4 (keseluruhan) | 61,4% | 67,2% | 58% | 61% |
Hasil pemrograman yang dilaporkan adalah 85,9 pada LiveCodeBench v6, 66,4 pada SWE-bench Verified, dan 27,7 pada Terminal-Bench 2.1.
Generasi kode mentah terlihat kuat, rekayasa perangkat lunak berbasis agen terlihat biasa saja, dan angka Terminal-Bench menunjukkan pekerjaan terminal multi-langkah yang panjang bukan tujuan model ini.
Ada catatan kontaminasi yang sebaiknya Anda baca sebelum mengutipnya.
Laporan teknis mencatat bahwa 48% data evaluasi HumanEval bahasa Inggris dan 47% bahasa Jerman muncul dalam materi terkait pelatihan, yang menggelembungkan skor bergaya HumanEval.
Beberapa suite dalam tabel perbandingan bersifat proprieter atau dibuat vendor, yang membuat seluruh set sulit diaudit, dan tidak ada perbandingan terverifikasi apel-dengan-apel terhadap flagship Claude, GPT, atau Gemini saat penulisan.
Klaim efisiensi adalah yang paling bertahan dari catatan kehati-hatian pelaporan vendor, karena ini merupakan sifat arsitektur, bukan skor.
Throughput di sini berarti seberapa banyak teks yang dapat dihasilkan model per GPU per detik. Aleph Alpha mengukurnya dalam byte, bukan token, sehingga model dengan tokenizer berbeda dapat dibandingkan secara adil.
Kolibri 1 berada di rata-rata 71% pada suite tolok ukur bahasa Jerman milik Aleph Alpha sambil melakukan decoding sekitar 47.000 byte/detik per GPU. GPT OSS A5B mencapai 70% pada sekitar 34.500 byte/detik, Qwen 3.6 A3B 67% pada sekitar 38.500, Gemma 4 A4B 66% pada sekitar 43.000, dan Nemotron Super A12B 68% pada sekitar 24.000.
Menyajikan kira-kira 2x teks ter-decoding per GPU dibanding model Nemotron pada rata-rata bahasa Jerman yang lebih tinggi adalah argumen praktis untuk memilih Kolibri dalam tumpukan self-hosted.
Jika Anda membayar GPU sendiri alih-alih per token, throughput per GPU adalah angka yang muncul di tagihan.
Tidak ada harga token yang dipublikasikan untuk Kolibri 1.
Aleph Alpha belum merilis daftar harga API ter-host, dan tidak ada ID model API Kolibri yang terkonfirmasi muncul dalam dokumentasi API resmi per 5 Oktober 2026.
Deploymen tingkat enterprise dilakukan melalui tim penjualan Aleph Alpha, dan pengenal repositori Aleph-Alpha/Kolibri-1 tidak boleh dianggap sebagai ID model API.
Bobotnya sendiri gratis di bawah Apache 2.0, jadi biaya Anda adalah waktu GPU.
Jejak memori FP8 sekitar 78 GB, dengan minimum yang disebutkan 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200, atau 1x B300, dan konfigurasi yang direkomendasikan 2x H100 SXM5, 2x H200, 1x B200, atau 1x B300. Model ini tersedia umum, bukan pratinjau, tanpa daftar tunggu atau kunci wilayah.
Untuk gambaran apa yang Anda bandingkan, liputan GPT-6.1 Sol kami menempatkan model itu pada $2 input / $10 output per satu juta token. Ringkasan harga pihak ketiga mencantumkan GPT-5.6 Sol yang lebih lama pada $5 / $30 dan GPT-5.6 Luna pada $0,20 / $1,20 setelah pemangkasan harga OpenAI tanggal 30 Juli.
Self-hosting unggul secara ekonomi per unit hanya setelah volume Anda melampaui biaya tetap sebuah B200.
Kolibri 1 adalah open-weight di bawah Apache 2.0, yang mengizinkan penggunaan komersial, modifikasi, dan redistribusi tanpa ambang pengguna atau pendapatan.
Bobot tersedia di Aleph-Alpha/Kolibri-1 di Hugging Face dalam float8_e4m3fn. Kartu model mendokumentasikan penyajian melalui vLLM saja, menggunakan plugin aleph-alpha-inference milik Aleph Alpha. Build komunitas GGUF dan MLX muncul dalam hitungan hari, tetapi Aleph Alpha belum memvalidasinya, dan saya tidak menemukan entri Ollama resmi.
Untuk deploymen terlayani, 1x H200 atau 1x B200 menampung ~78 GB bobot FP8 pada satu kartu. Gunakan --tensor-parallel-size 2 pada H100.
Jaga --max-model-len pada atau di bawah 262.144 kecuali Anda telah menguji konteks lebih panjang secara spesifik. Melewati itu memerlukan flag tambahan --hf-overrides, yang didokumentasikan kartu model.
Instal plugin dan jalankan server:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Kemudian ajukan kueri melalui API yang kompatibel dengan OpenAI, menggunakan parameter sampling yang direkomendasikan Aleph Alpha (temperature 1,0, top_p 0,97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Reasoning effort menerima low, medium, dan high, dan Anda dapat mematikan proses berpikir sepenuhnya jika latensi lebih penting daripada kedalaman.
Keluaran akan bervariasi dengan parameter sampling, dan kartu model mencatat bahwa keluaran dapat sedikit menyimpang bahkan ketika sampling dinonaktifkan.
Untuk penyiapan lebih mendalam pada inferensi self-hosted dan loop agen, tutorial API kami tentang membangun agen migrasi membahas pola izin alat dan pengarahan yang dapat langsung ditransfer.
Kolibri one secara nominal adalah 'AI berdaulat', artinya sebuah negara atau organisasi dapat menjalankan, mengaudit, dan mengendalikan AI-nya di infrastruktur sendiri dan di bawah yurisdiksinya sendiri, tanpa bergantung pada API, harga, atau ketentuan layanan penyedia asing. Untuk Kolibri 1, argumen ini bertumpu pada bobot Apache 2.0 yang dapat Anda jalankan secara air-gapped (terputus dari internet), infrastruktur pelatihan Eropa, dan dokumentasi EU AI Act.
Namun, ada dua konteks korporat di balik peluncuran ini.
Aleph Alpha telah menandatangani perjanjian merger yang mengikat dengan perusahaan Kanada, Cohere, untuk membentuk apa yang mereka sebut sebagai solusi AI berdaulat transatlantik pertama.
Perusahaan gabungan akan beroperasi dengan nama Cohere, dengan kantor pusat ganda di Toronto dan Berlin, serta Heidelberg tetap sebagai pusat riset. Kesepakatan ini masih membutuhkan persetujuan regulator.
Pitch kedaulatan bergantung pada pemilik model yang terus mendukungnya, dan merek Aleph Alpha akan dilebur ke Cohere setelah merger ditutup, jadi kedua hal ini layak dipantau bersamaan dengan tolok ukur.
Aleph Alpha bertaruh bahwa kedaulatan, lisensi Apache 2.0, dan kepatuhan EU AI Act yang terdokumentasi lebih penting bagi pembeli sektor publik Eropa daripada selisih beberapa poin pada MMLU-Pro.
Taruhan itu tampak masuk akal, dan merger perusahaan dengan Cohere menunjukkan mereka tahu tidak bisa menang hanya dengan skala.
Menurut saya adil untuk mengatakan bahwa Kolibri 1 adalah model open-weight berbahasa Jerman terbaik pada ukuran parameter aktif ini yang terdokumentasi sebaik ini, namun bukan model yang akan saya pilih jika saya membutuhkan run agen multi-giliran panjang atau recall faktual buku tertutup.
Di antara model MoE parameter-aktif kecil yang sebanding, Qwen3.6 35B-A3B masih unggul. Jika Anda mampu model dens 27B, Qwen3.8 27B menang telak.
Jika Anda ingin cepat mahir menjalankan dan mengevaluasi model seperti ini, mulai dari jalur keterampilan AI Fundamentals kami.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt